


AIエージェントに長大なコードベースを読み込ませると、後半で初期仕様を忘れる「Lost-in-the-Middle」現象が発生する。Claude Codeで複雑なタスクを自動化する場合、会話履歴の増大に伴い推論コストとレイテンシが二次関数的に増大する。
マイルストーンごとに履歴をJSONで「Save-Game」圧縮する手法がある。入力トークンを95%削減し、精度を向上させる。開発で試したコンテキスト管理の最適化手法と、エージェントの自律性を維持するための設計パターンを共有する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
開発現場で実証された「コンテキスト圧縮」の衝撃
AIエージェントの自律的なコーディングにおいて、会話履歴の肥大化と情報の忘却は課題となっている。特に複数のサブタスクを跨ぐ長期的なコーディングでは、全履歴を保持する「累積型コンテキスト」が後半の推論精度を低下させる。
電力グリッド計測パイプラインの改修という3段階のマイルストーンタスクで実験を行った。従来の「全履歴保持」方式と、マイルストーンごとに履歴を破棄し、検証済みの契約やターゲット情報のみを構造化JSONへ要約する「Save-Game圧縮」方式を比較した。
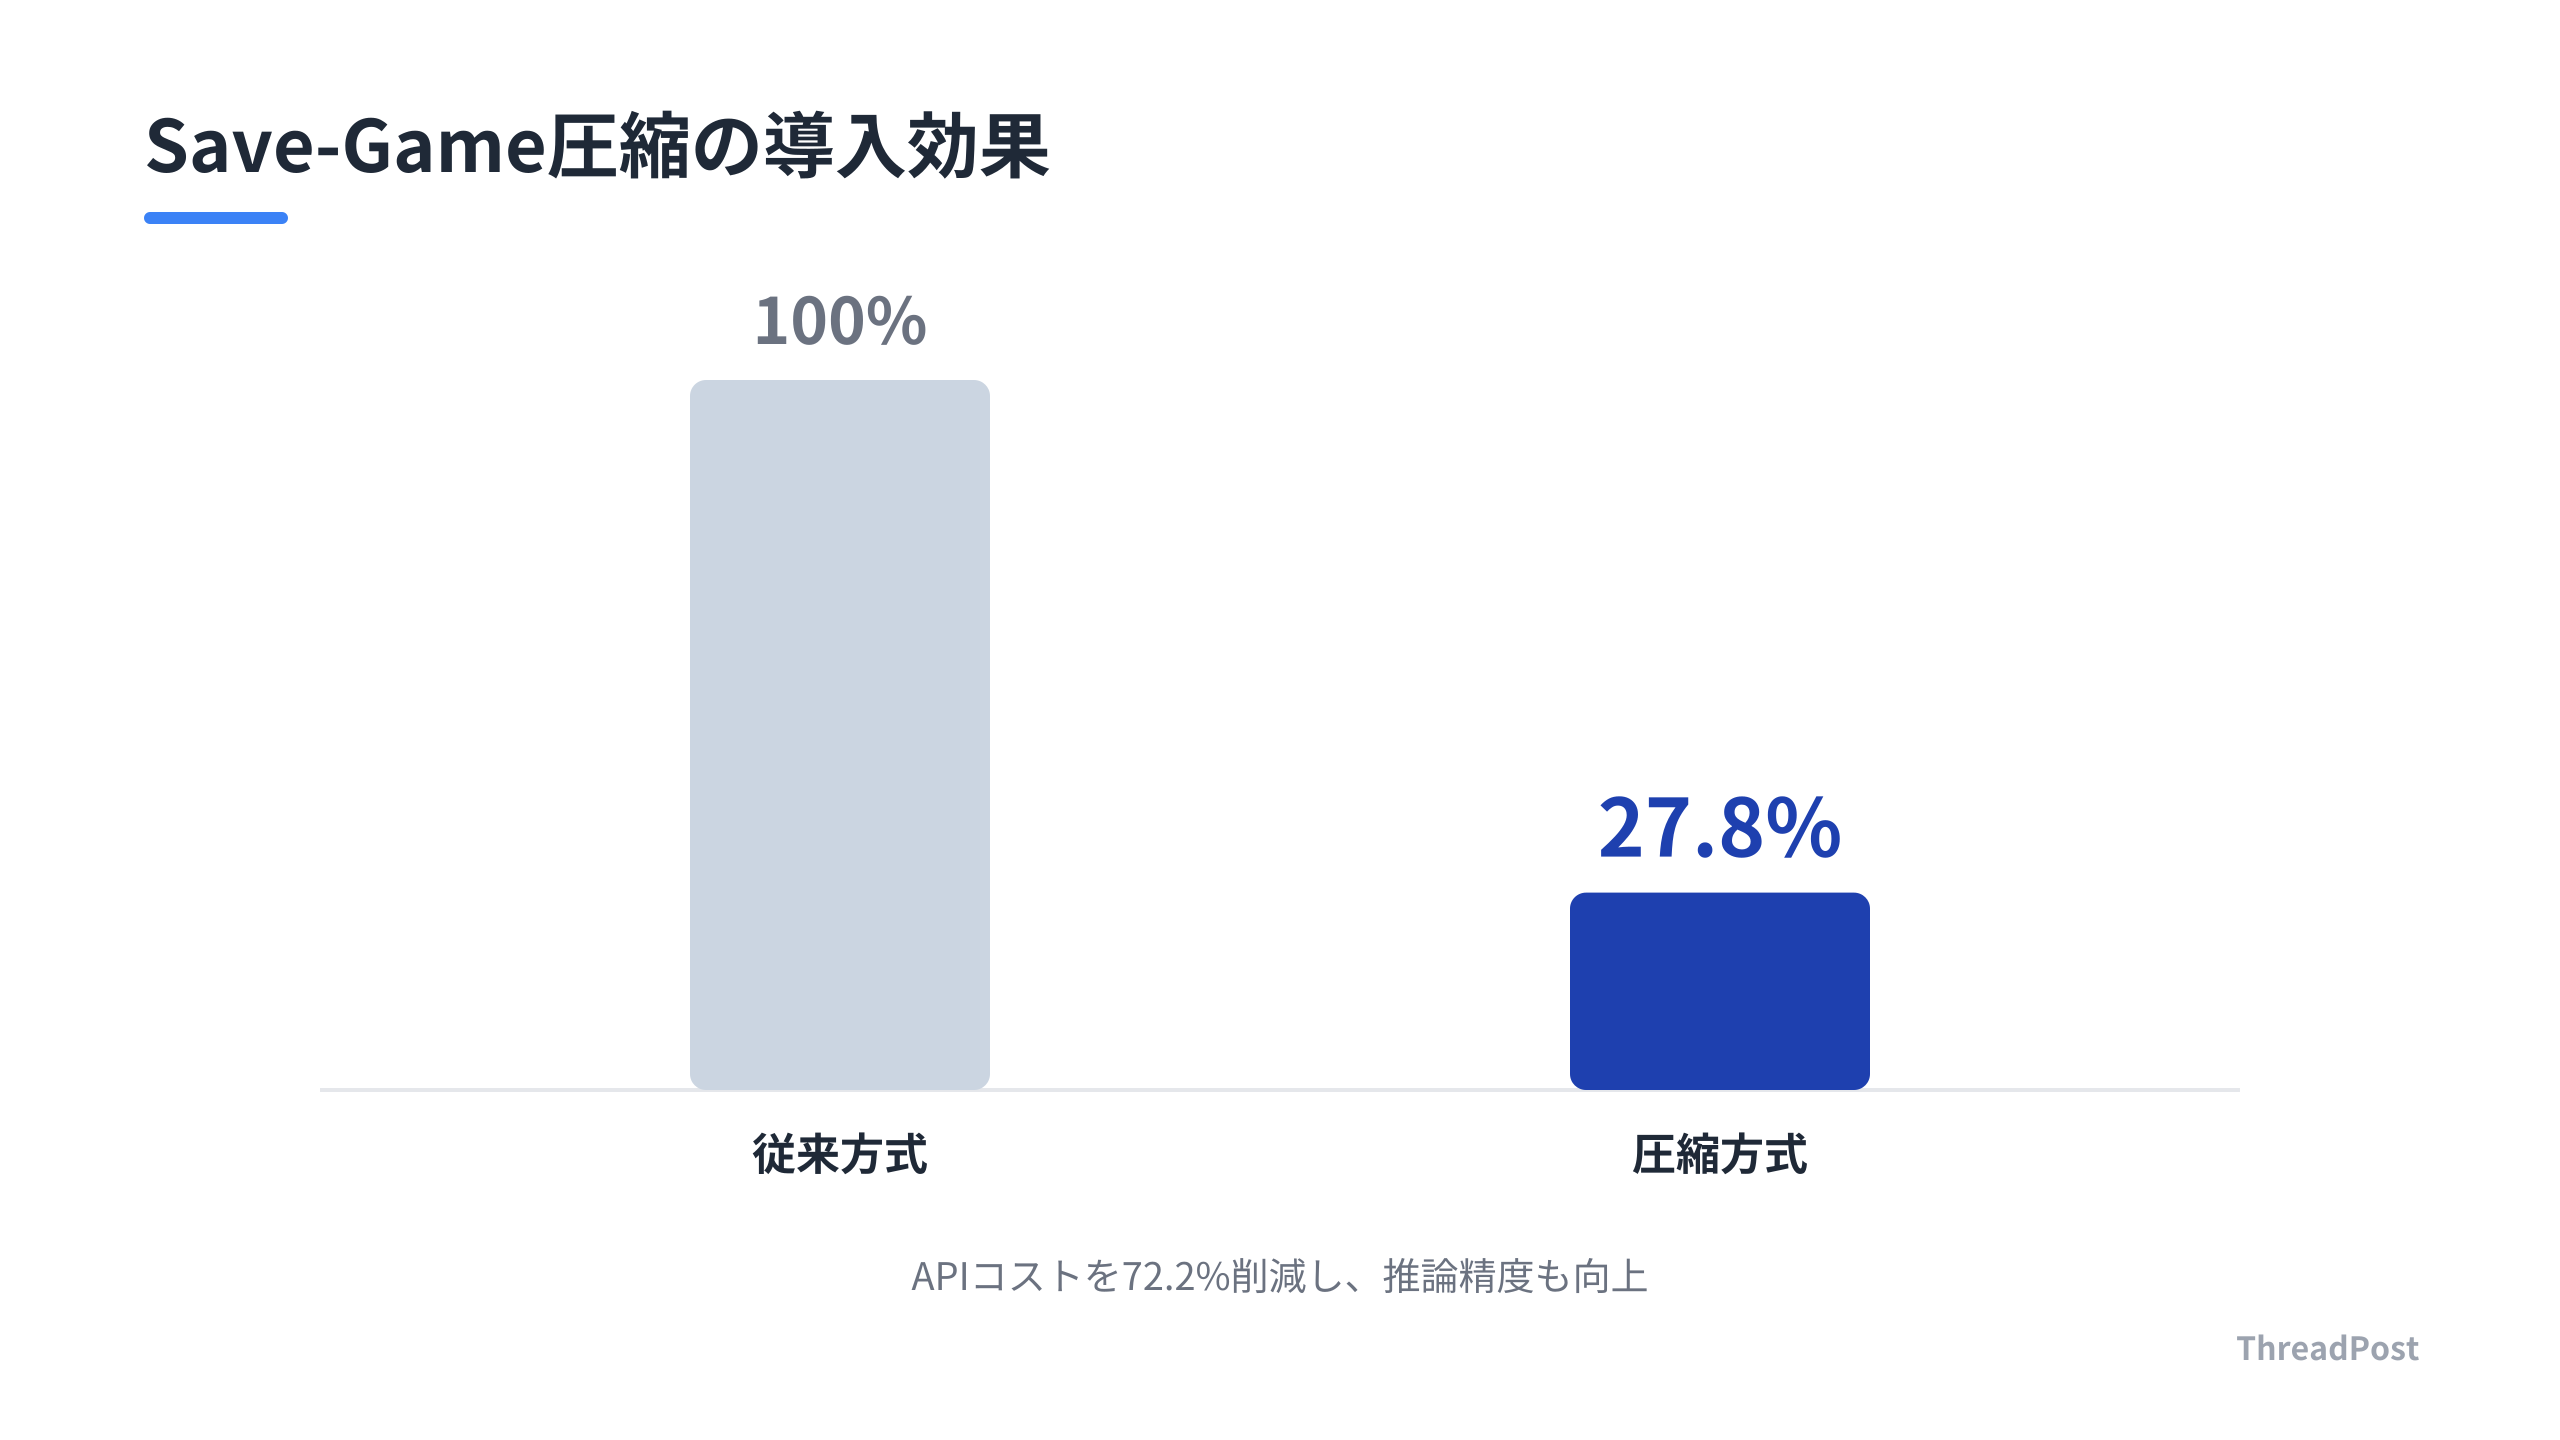
後者の手法では入力トークンが最大95%削減され、APIコストも72.2%のカットを記録した。全履歴を保持したモデルが複雑な正規化処理や境界条件の指定で18/20の不合格を出したのに対し、圧縮方式を用いたモデルは20/20で完全合格を達成した。
長大なコンテキスト管理に対し、「グローバルメモリ」という概念がある。ドキュメント全体を特殊なメモリトークンとして圧縮し、推論時に必要な「手がかり」を生成して検索精度を高める手法だ。ロングコンテキストモデルの性能に頼らず、状態を管理する。
LLMの専門家混合(MoE)モデルにおいても、どのエキスパートをVRAMに常駐させるかを疑似量子アルゴリズムで最適化する研究がある。64のエキスパート候補から最適な16人を選び出す組み合わせ最適化問題を、焼きなまし法を用いて解くことで、従来のキャッシュ置換アルゴリズムよりも高いヒット率を記録した。
しんたろー:
モデルの性能を追いかけるより情報の渡し方を工夫する方がコスパが良い。Claude Codeでバッチ処理を回すと、履歴の整理をサボった瞬間にエージェントの挙動が不安定になる。このJSON圧縮はThreadPost開発でも実装が必要だ。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
開発者目線で紐解く「コンテキスト管理」の現在地
AIのコンテキスト管理は「単なるテキスト要約」を超え、システム設計の「メタレイヤー」となっている。LLMが提供する「100万トークン」の窓口を利用しても、「Lost-in-the-Middle」の壁に突き当たる。
初期の仕様や境界条件が、膨大な中間ログに埋もれて消失する。海外開発コミュニティでは「Save-Game」パターンのような、マイルストーン単位での強制リセットが活用されている。AIに要約させるのではなく、システム側で検証済み契約のみを構造化JSONとして抽出するアプローチだ。
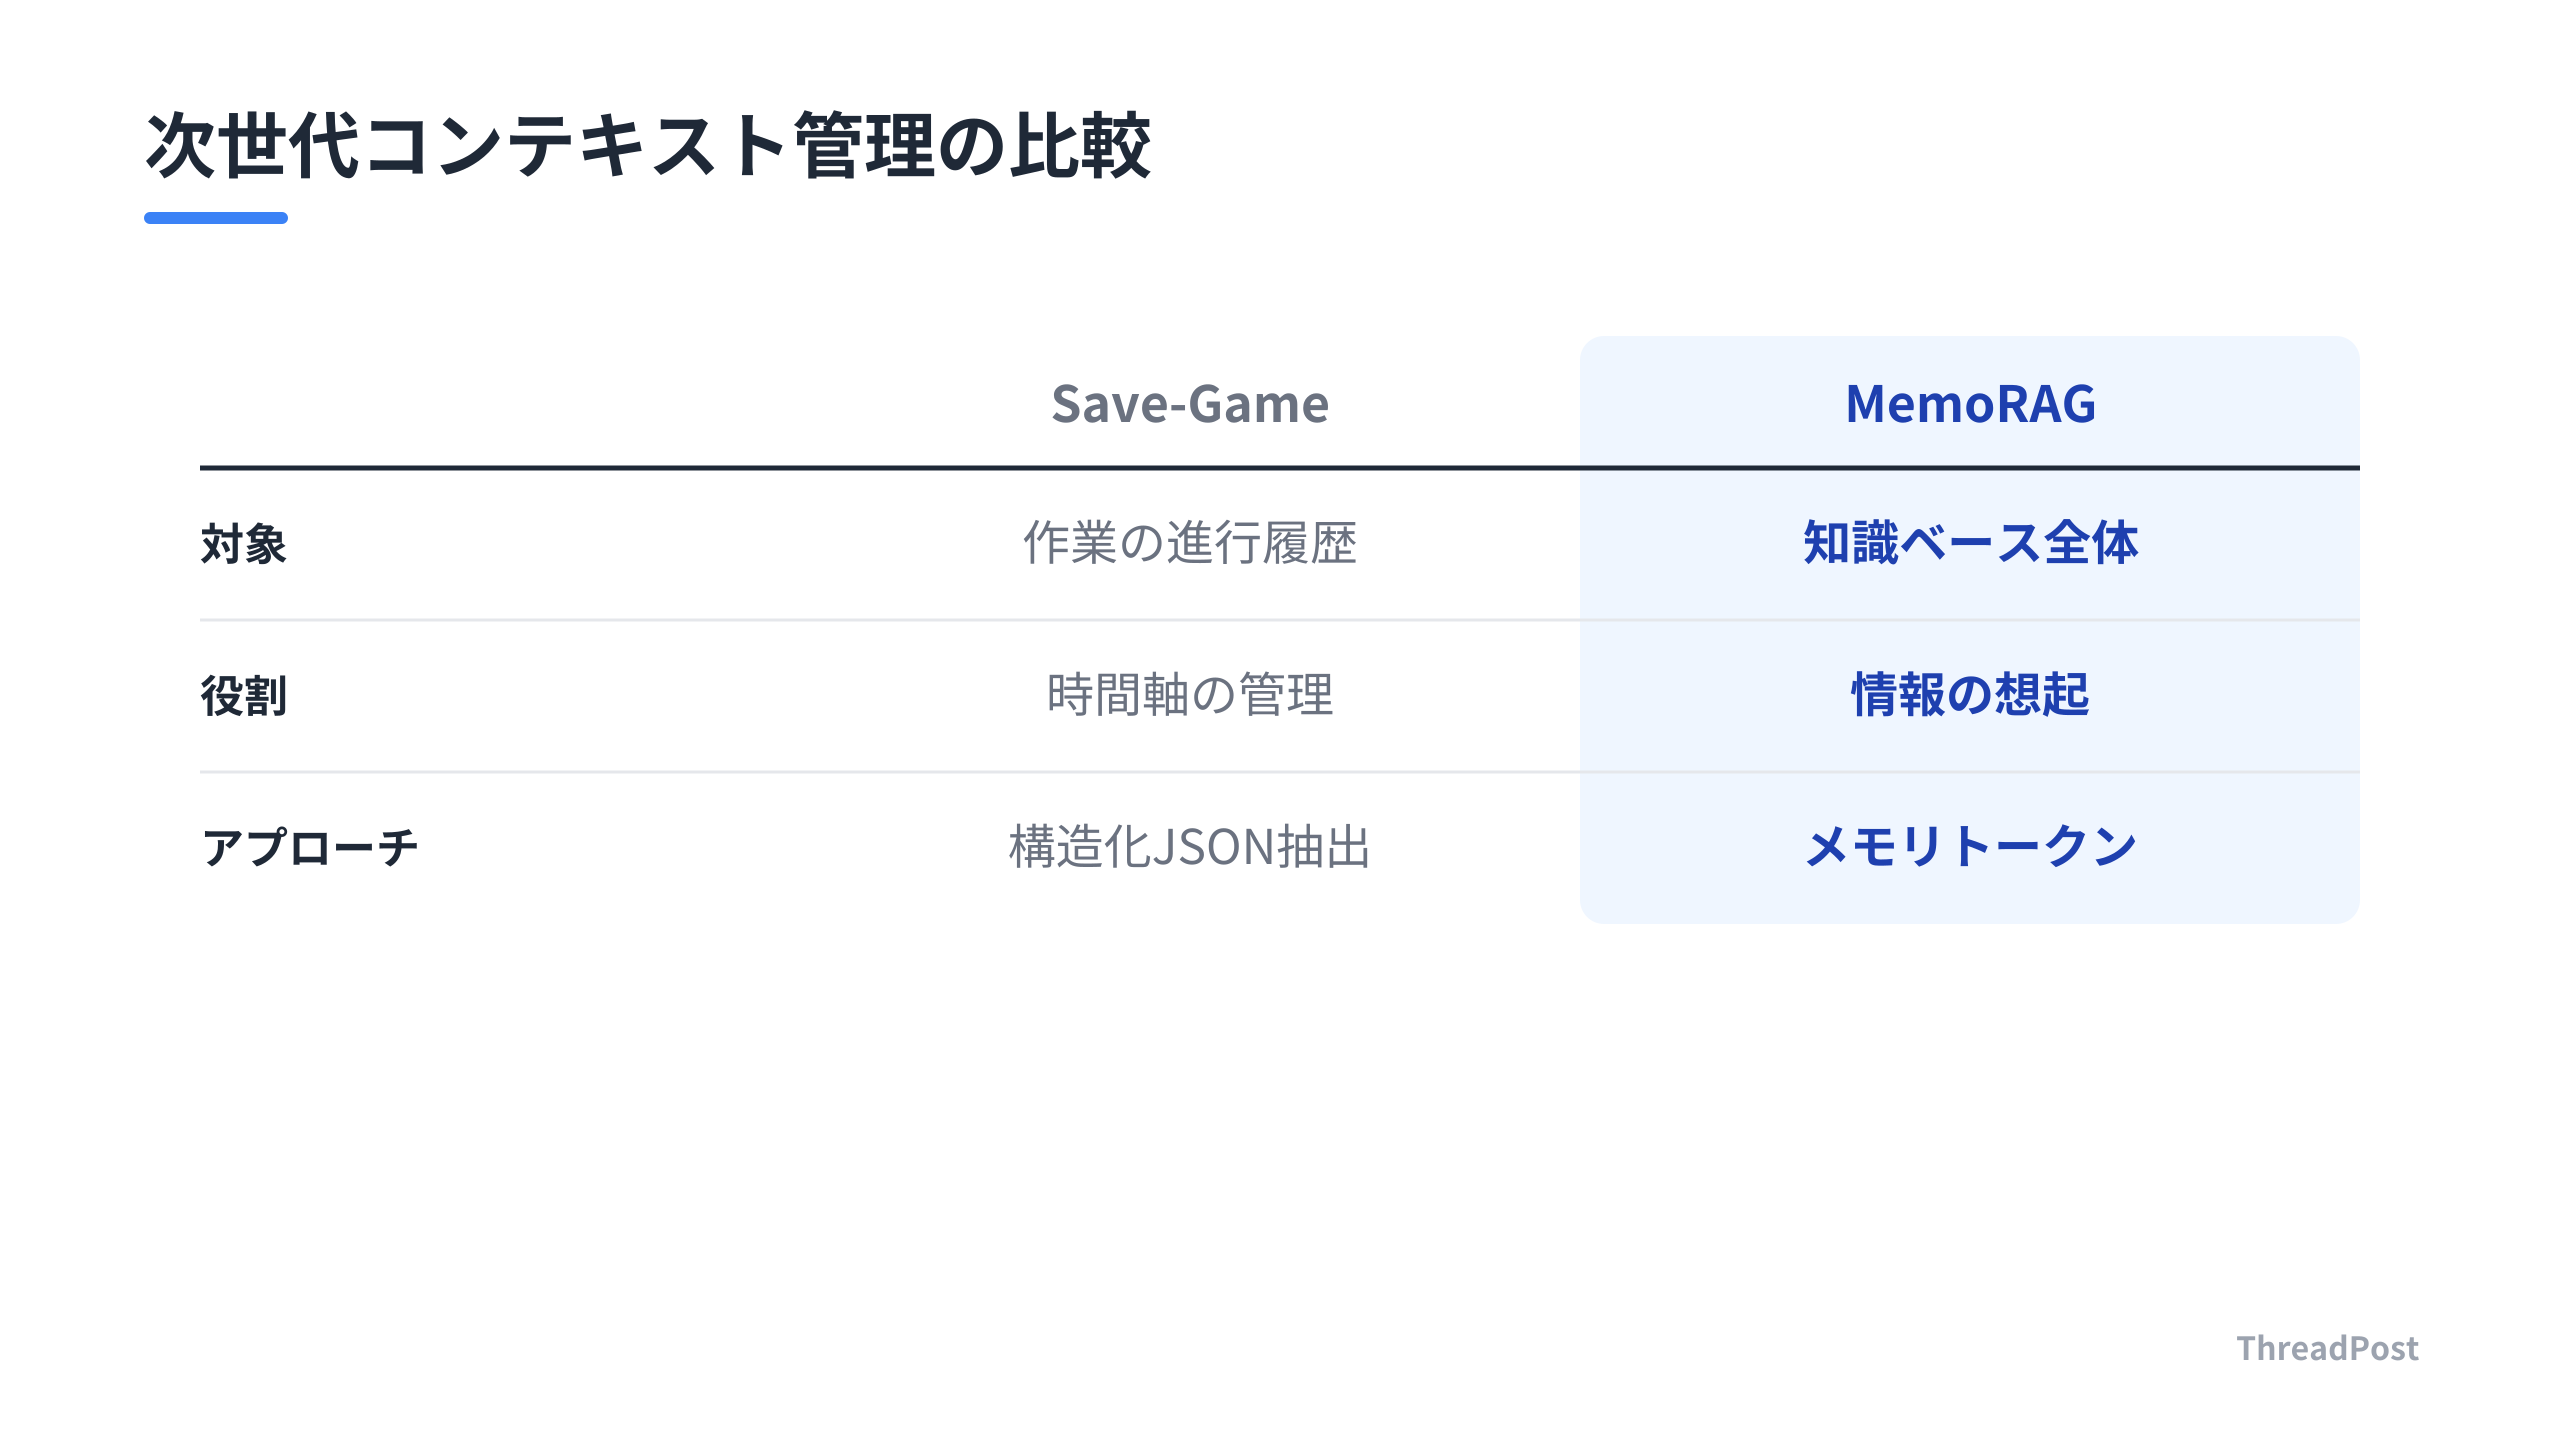
メモリ効率の観点では「MemoRAG」のような、グローバルメモリによる検索最適化がある。全履歴を積み上げるスタック構造に対し、全体像を把握するためのメモリトークンを介在させる手法だ。これら二つの手法は、全量を扱うことの非効率性に対し、アプローチのレイヤーを使い分けている。
Save-Gameパターンはタスクの進行履歴という時間軸の管理に特化している。MemoRAGはドキュメントという広大な知識ベースからの想起に特化している。両者を組み合わせたハイブリッドなアーキテクチャを構築する。エージェントの作業履歴はSave-Gameで圧縮しつつ、外部のリファレンスにはMemoRAGのメモリレイヤーを適用する。
モデルの推論性能を追いかけるより情報の渡し方を工夫する方がコスパが良い。Claude Codeでバッチ処理を回すと、履歴の整理をサボった瞬間にエージェントの挙動が不安定になる。このJSON圧縮はThreadPost開発でも実装が必要だ。
技術的な深掘りでは、MoEモデルにおけるエキスパート配置の最適化研究がある。疑似量子アニーリングを用いて、VRAM上のエキスパートを動的に入れ替える手法は、計算資源の最適配置というメタレイヤーの極致だ。64個のエキスパート候補から最適な16人を選ぶ組み合わせ爆発を、焼きなまし法で解く。
これら全てはLLMのブラックボックス性に依存しない姿勢を示す。モデルが理解してくれると期待するのではなく、モデルが力を発揮できる形に、人間側で情報を構造化し、配置し、整理する。このエンジニアリングが、AIエージェントを実務で使える戦力へと変える。
ThreadPostのような自律型ツールでは、コンテキスト汚染によるコストの増大は死活問題だ。無駄なトークンを投げ続けることは、API代を消費するだけでなく、エージェントの推論精度を低下させる。今回紹介した手法は、捨て去る勇気と要約する知恵を示す。モデルの賢さに期待する時間を、コンテキストを最適化する仕組み作りに割く。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
開発現場に持ち込むべき「コンテキスト最適化」の具体的アクション
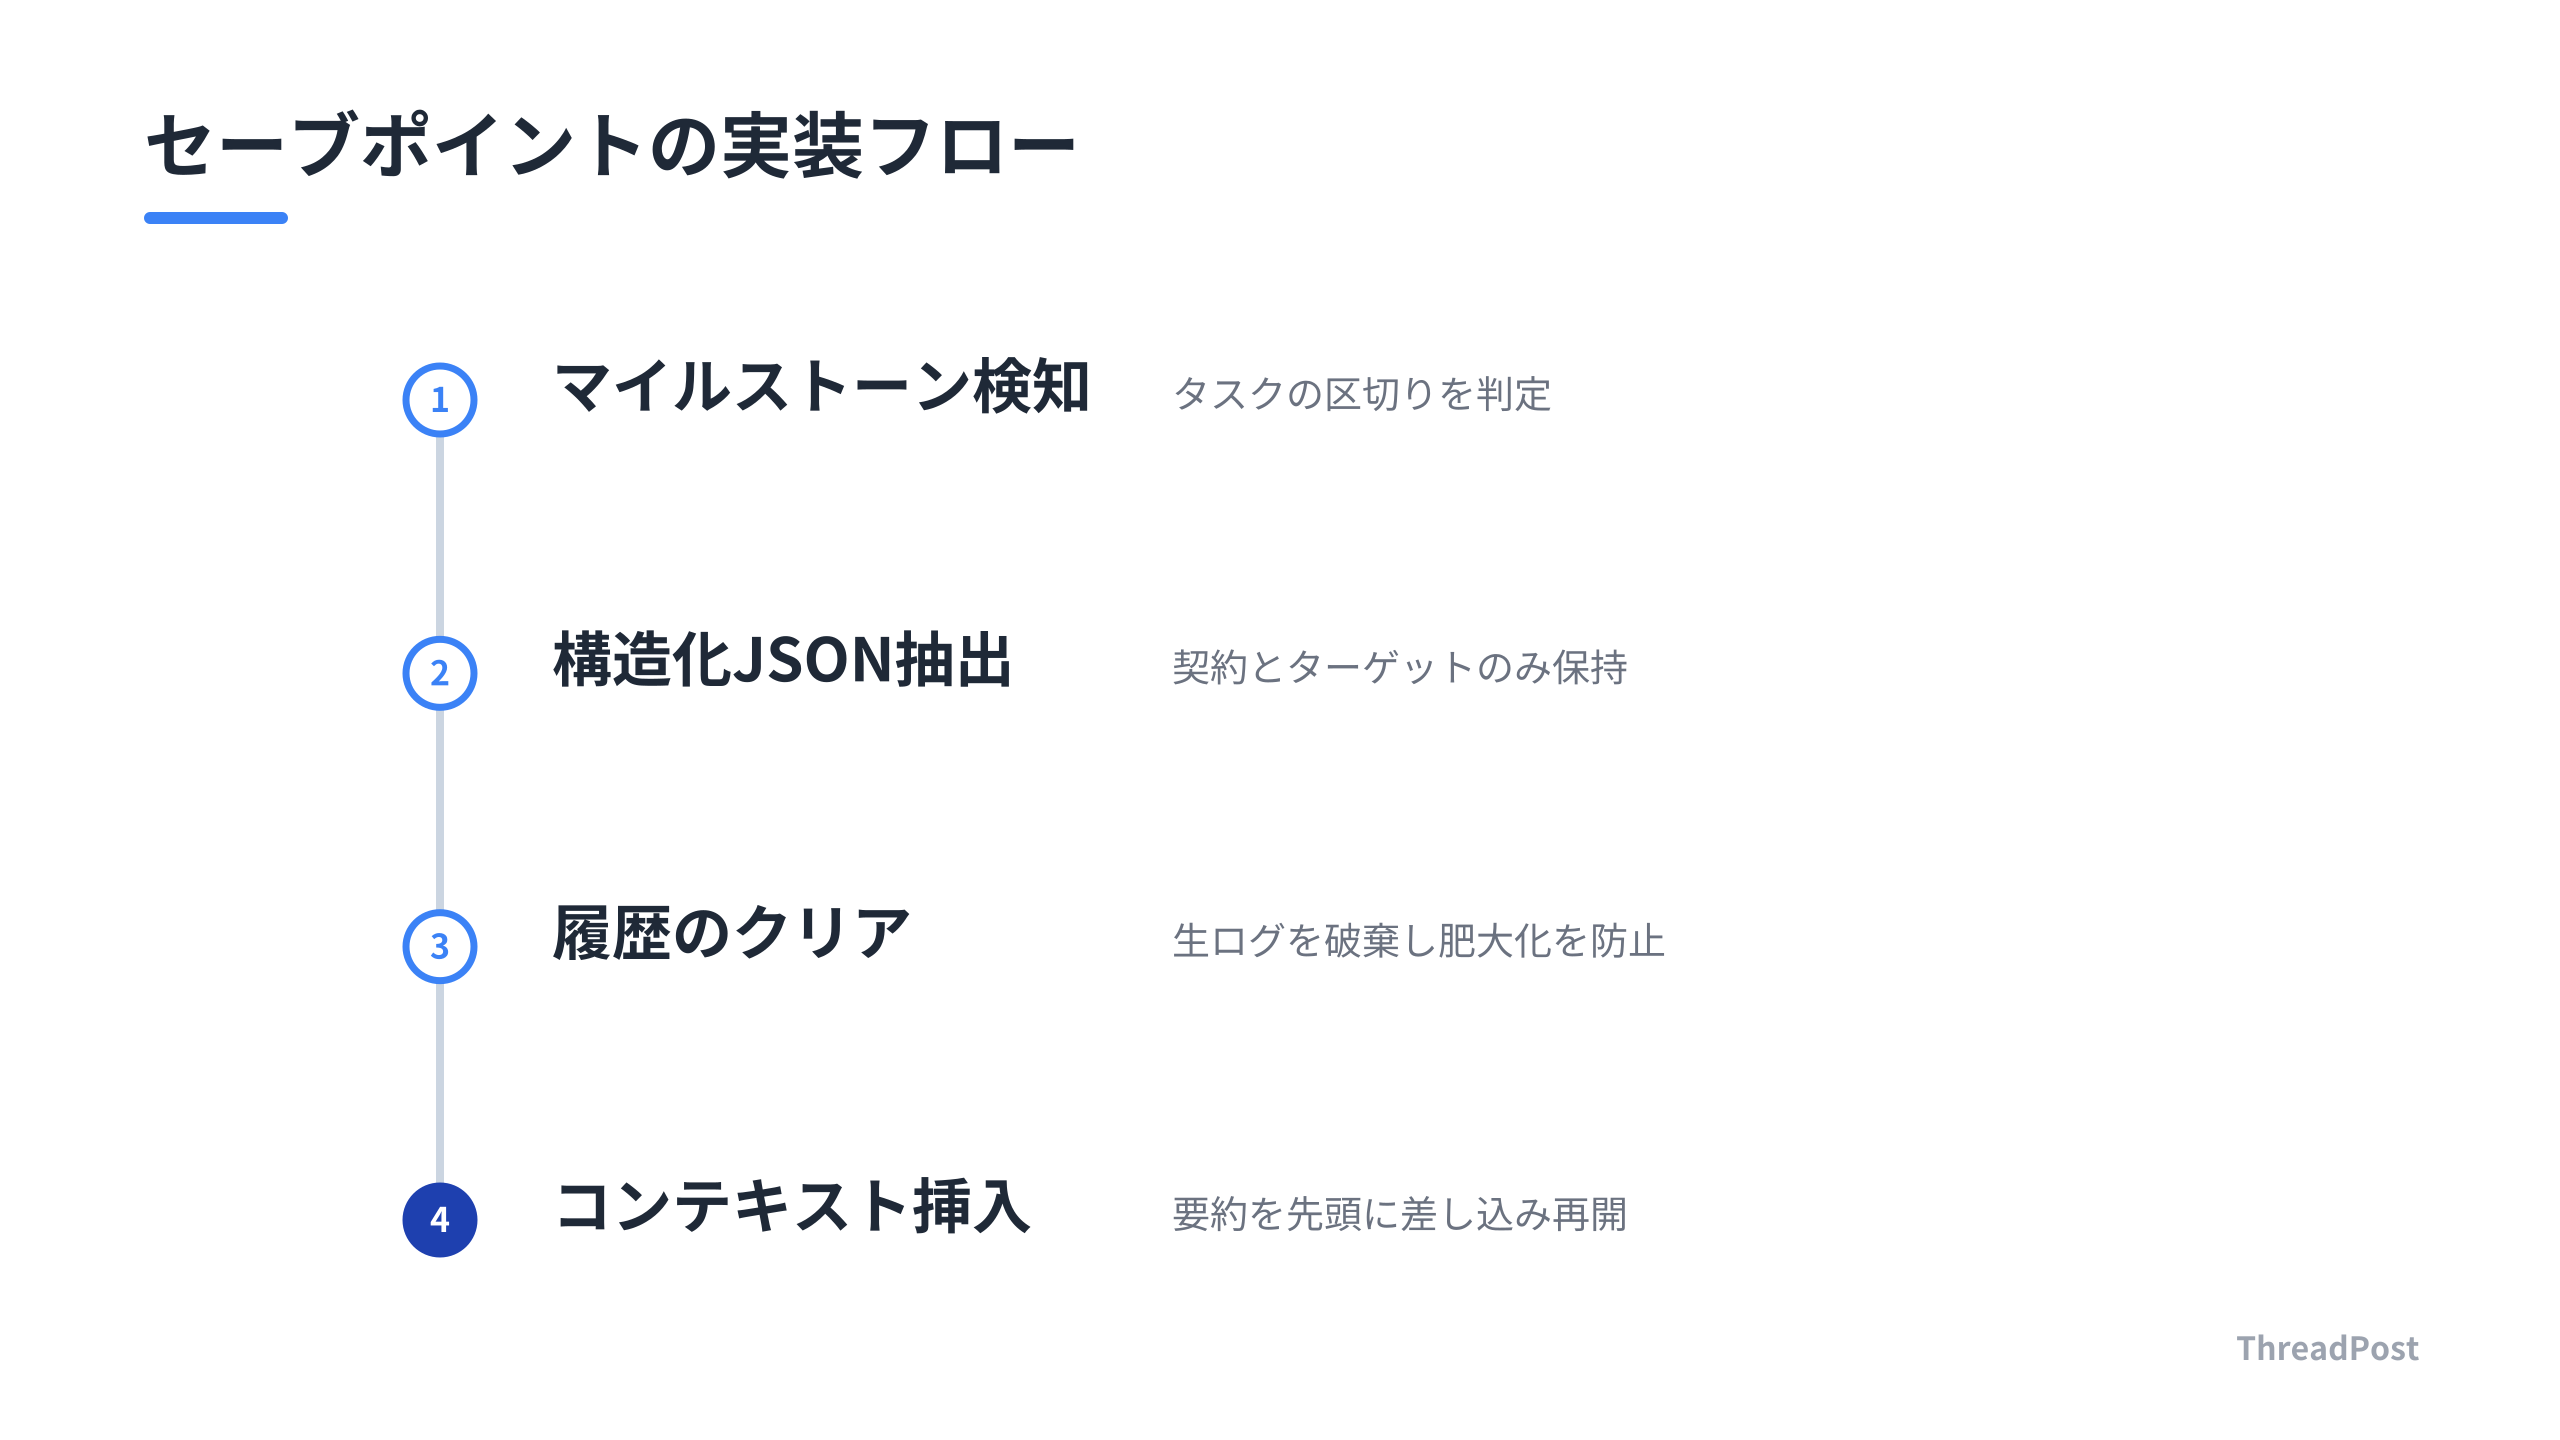
全履歴をモデルに投げるのではなく、タスクの状態管理をシステム側に組み込む。APIの入力トークン数をタスクの進捗状況と紐づけて可視化する。実装中のエージェントが、マイルストーンを通過するたびに会話履歴をクリアするセーブポイントを設ける。
タスク完了時に完了済みインターフェースと次のターゲット課題だけをJSON形式で抽出するルーチンを組み込む。これを会話履歴の先頭に差し込み、過去の生ログを破棄するだけで、コンテキストウィンドウの消費を9割近く削減できる。
MoEモデルを利用している場合は、キャッシュ戦略の再考が必要だ。LRUのような単純なアルゴリズムではなく、直近のトレースから次に呼ばれる可能性が高いエキスパートを予測する仕組みを、軽量なヒューリスティック関数として実装する。
Claude Codeで長丁場のリファクタリングをすると、履歴が溜まりすぎて後半でミスを誘発する。途中で要約JSONを投げて履歴をリセットする運用に変えたら、精度が安定した。モデルの文脈理解力に頼るより、人間が今何を覚えていればいいかを定義するほうがAIは賢く動く。
RAGの設計思想も重要だ。ドキュメント全体をベクトル検索でチャンク単位で引っ張ってくる従来の手法は、全体像の把握が求められるタスクでは限界がある。メモリトークンを活用した手がかり生成のアプローチを取り入れ、検索前に何を探すべきかをモデルに整理させるレイヤーを挟む。
モデルの性能ではなく設計の質にフォーカスする。APIのトークン単価が下がったとしても、コンテキストの肥大化はレイテンシを悪化させる。AIの脳内メモリを綺麗に保つ整理整頓のスキルが、AIエージェントを実務に耐えうるレベルへと引き上げる。
現在開発中のエージェントのログを見返す。後半のターンでモデルが初期仕様を忘れているなら、コンテキストが汚染されている。セーブゲーム設計を試す。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
Q1. ロングコンテキスト対応モデルを使えば、コンテキスト圧縮は不要ではないか?
不要ではありません。100万トークンを扱えるモデルであっても、全履歴を毎回入力に含めることは推論コストの増大とレイテンシの悪化を招きます。情報量が増えるほど「Lost-in-the-Middle」現象により、初期の重要な仕様や境界条件が無視されるリスクが高まります。精度とコストの双方を最適化するためには、開発者側で情報を構造化・圧縮して渡す設計が有効です。
Q2. MemoRAGとSave-Game圧縮は併用できるか?
併用可能です。MemoRAGはドキュメント全体からの検索精度向上に特化しており、Save-Game圧縮はエージェントのタスク進行履歴の管理に特化しています。エージェントが過去のコード修正履歴をSave-Gameで保持しつつ、外部の膨大なドキュメントを参照する際にはMemoRAGのメモリトークンを活用します。この組み合わせにより、効率的な自律エージェントを構築できます。
Q3. QUBOを用いたエキスパート最適化は、小規模な開発環境でも導入できるか?
可能です。OpenJijのようなオープンソースの焼きなまし法ライブラリを活用すれば、専用ハードウェアがなくても手元の環境で動作します。予測器の精度が低いとLRUに負けることもあるため、まずは単純な移動平均から試し、徐々に学習型の予測器へ置き換えていくのが現実的です。限られたVRAMをどう配分するかというゲームは、工夫次第で商用モデルの挙動を上回る可能性があります。
まとめ
AIエージェントの性能は、どれだけ多くの情報を詰め込むかではなく、いかに重要な情報だけを構造化して保持するかで決まる。
コンテキスト圧縮による入力コストの削減と、メモリ管理の最適化を実装に組み込む。Claude Codeで日々開発する中で、Save-Game設計の恩恵を確認している。AIをツールとして使う段階は終わり、エージェントの脳をどうマネジメントするかが開発者の腕の見せ所となる。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
