


Webサイトの学習拒否を巡る動きが標準化へ動いた。OpenAIが発表した「共通シグナル」への対応は、規律作りだ。AIが学習する「公開データ」と、開発者が触れる「ローカル環境」の境界線が分断される。
PerplexityがMac向けに解放したエージェント機能は、ローカルファイルを直接操作する主戦場を示唆する。モデル性能の飽和、データ収集の制限、OSレベルに食い込むエージェント。この三極化するAIトレンドの中で、開発者は軸足を置く。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
AI業界を揺るがす3つの動向
今週、AI業界の勢力図が動く3つの発表があった。まずはOpenAIが表明した「学習拒否シグナルの標準化」だ。今後数ヶ月以内に、robots.txt内で指定された共通シグナルを尊重し、複数のAIプロバイダーへ一括で学習拒否を伝える仕組みを導入する。Web運営者は個別のクローラーごとに設定を維持する手間から解放される。
次に、Metaが発表した新モデル「Muse Wonder」と「Muse Wonder Full」だ。これらは「Muse Code」サブスクリプションユーザー向けに提供される。同社は内部ベンチマークにおいて、他社の最上位モデルと肩を並べる性能を叩き出したと主張する。「Muse」エージェントの中核エンジンとして順次統合される予定だ。
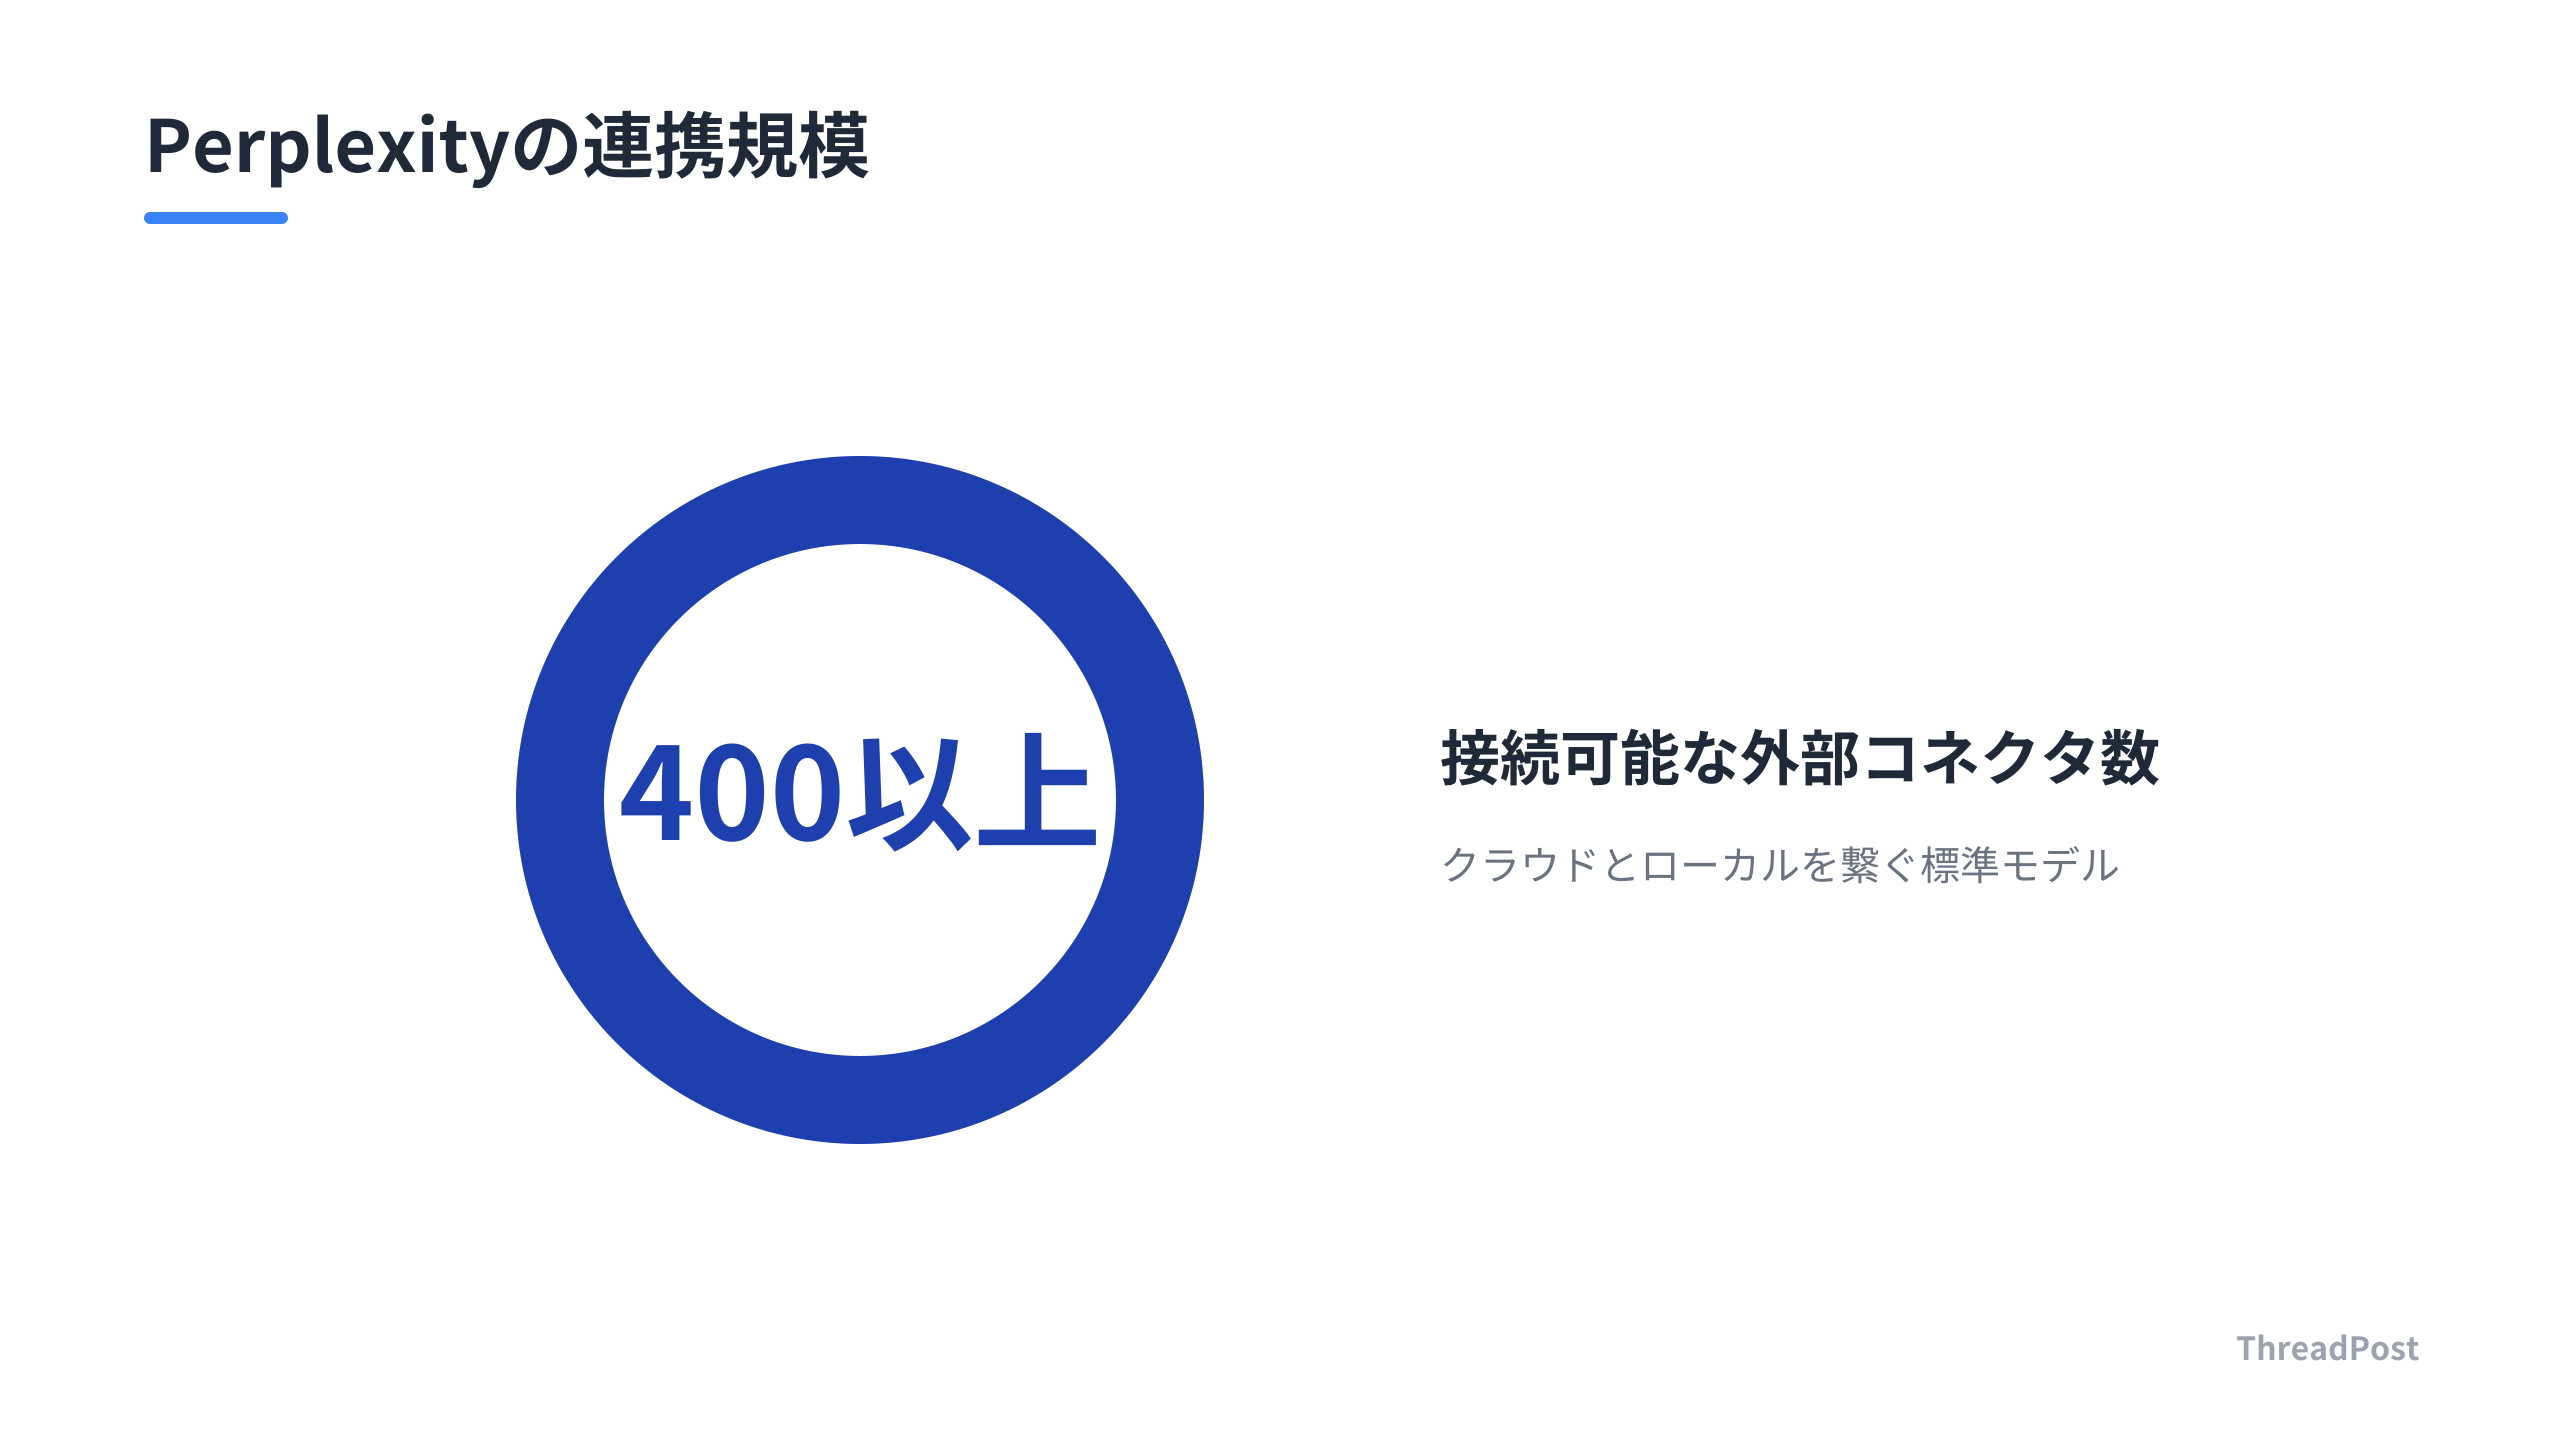
最後がPerplexityによる「Personal Computer」の一般開放だ。Macアプリを通じて全てのPro/Maxユーザーが利用可能となった。このツールはローカルファイルやネイティブアプリ、400以上のコネクタを介した外部ツールを横断的に操作する。クラウド上のモデルがローカル環境の権限を握る、自律型エージェントの実装だ。
しんたろー:
OpenAIが「学習拒否」という守りの規律を整える一方で、Perplexityは「ローカル操作」という攻めの環境を構築している。モデルの性能競争が飽和する中で、どこまで自分のPCの中身をAIに触らせるかが覇権争いになっていると感じる。
これら3つのニュースは、異なるレイヤーでの変化を示す。OpenAIの対応は「Webデータのクローズド化」を加速させ、Metaの動きは「APIベースのモデル競争」の激化を裏付ける。Perplexityの動きは「個人の作業環境」そのものがAIの主戦場へ変貌したことを意味する。
Web上の公開データが学習対象から外れる一方で、AIのアクセス範囲は個人のローカル環境へ拡大している。開発者には、Webサイトのクローラー制御を標準化しつつ、自社ツールをAIエージェントが操作可能な形式で提供するという、相反する二つの対応が求められる。特に、400以上のコネクタを扱うPerplexityのアーキテクチャは、今後のAI連携における標準モデルとなる。各社が競うのは「賢いモデル」よりも、いかに「ユーザーのワークフロー」をOSレベルで乗っ取れるかだ。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
AIエージェント時代のデータ戦略と「ローカル主権」
AIの主戦場は「パブリックなWeb」から「プライベートなローカル環境」へシフトしている。
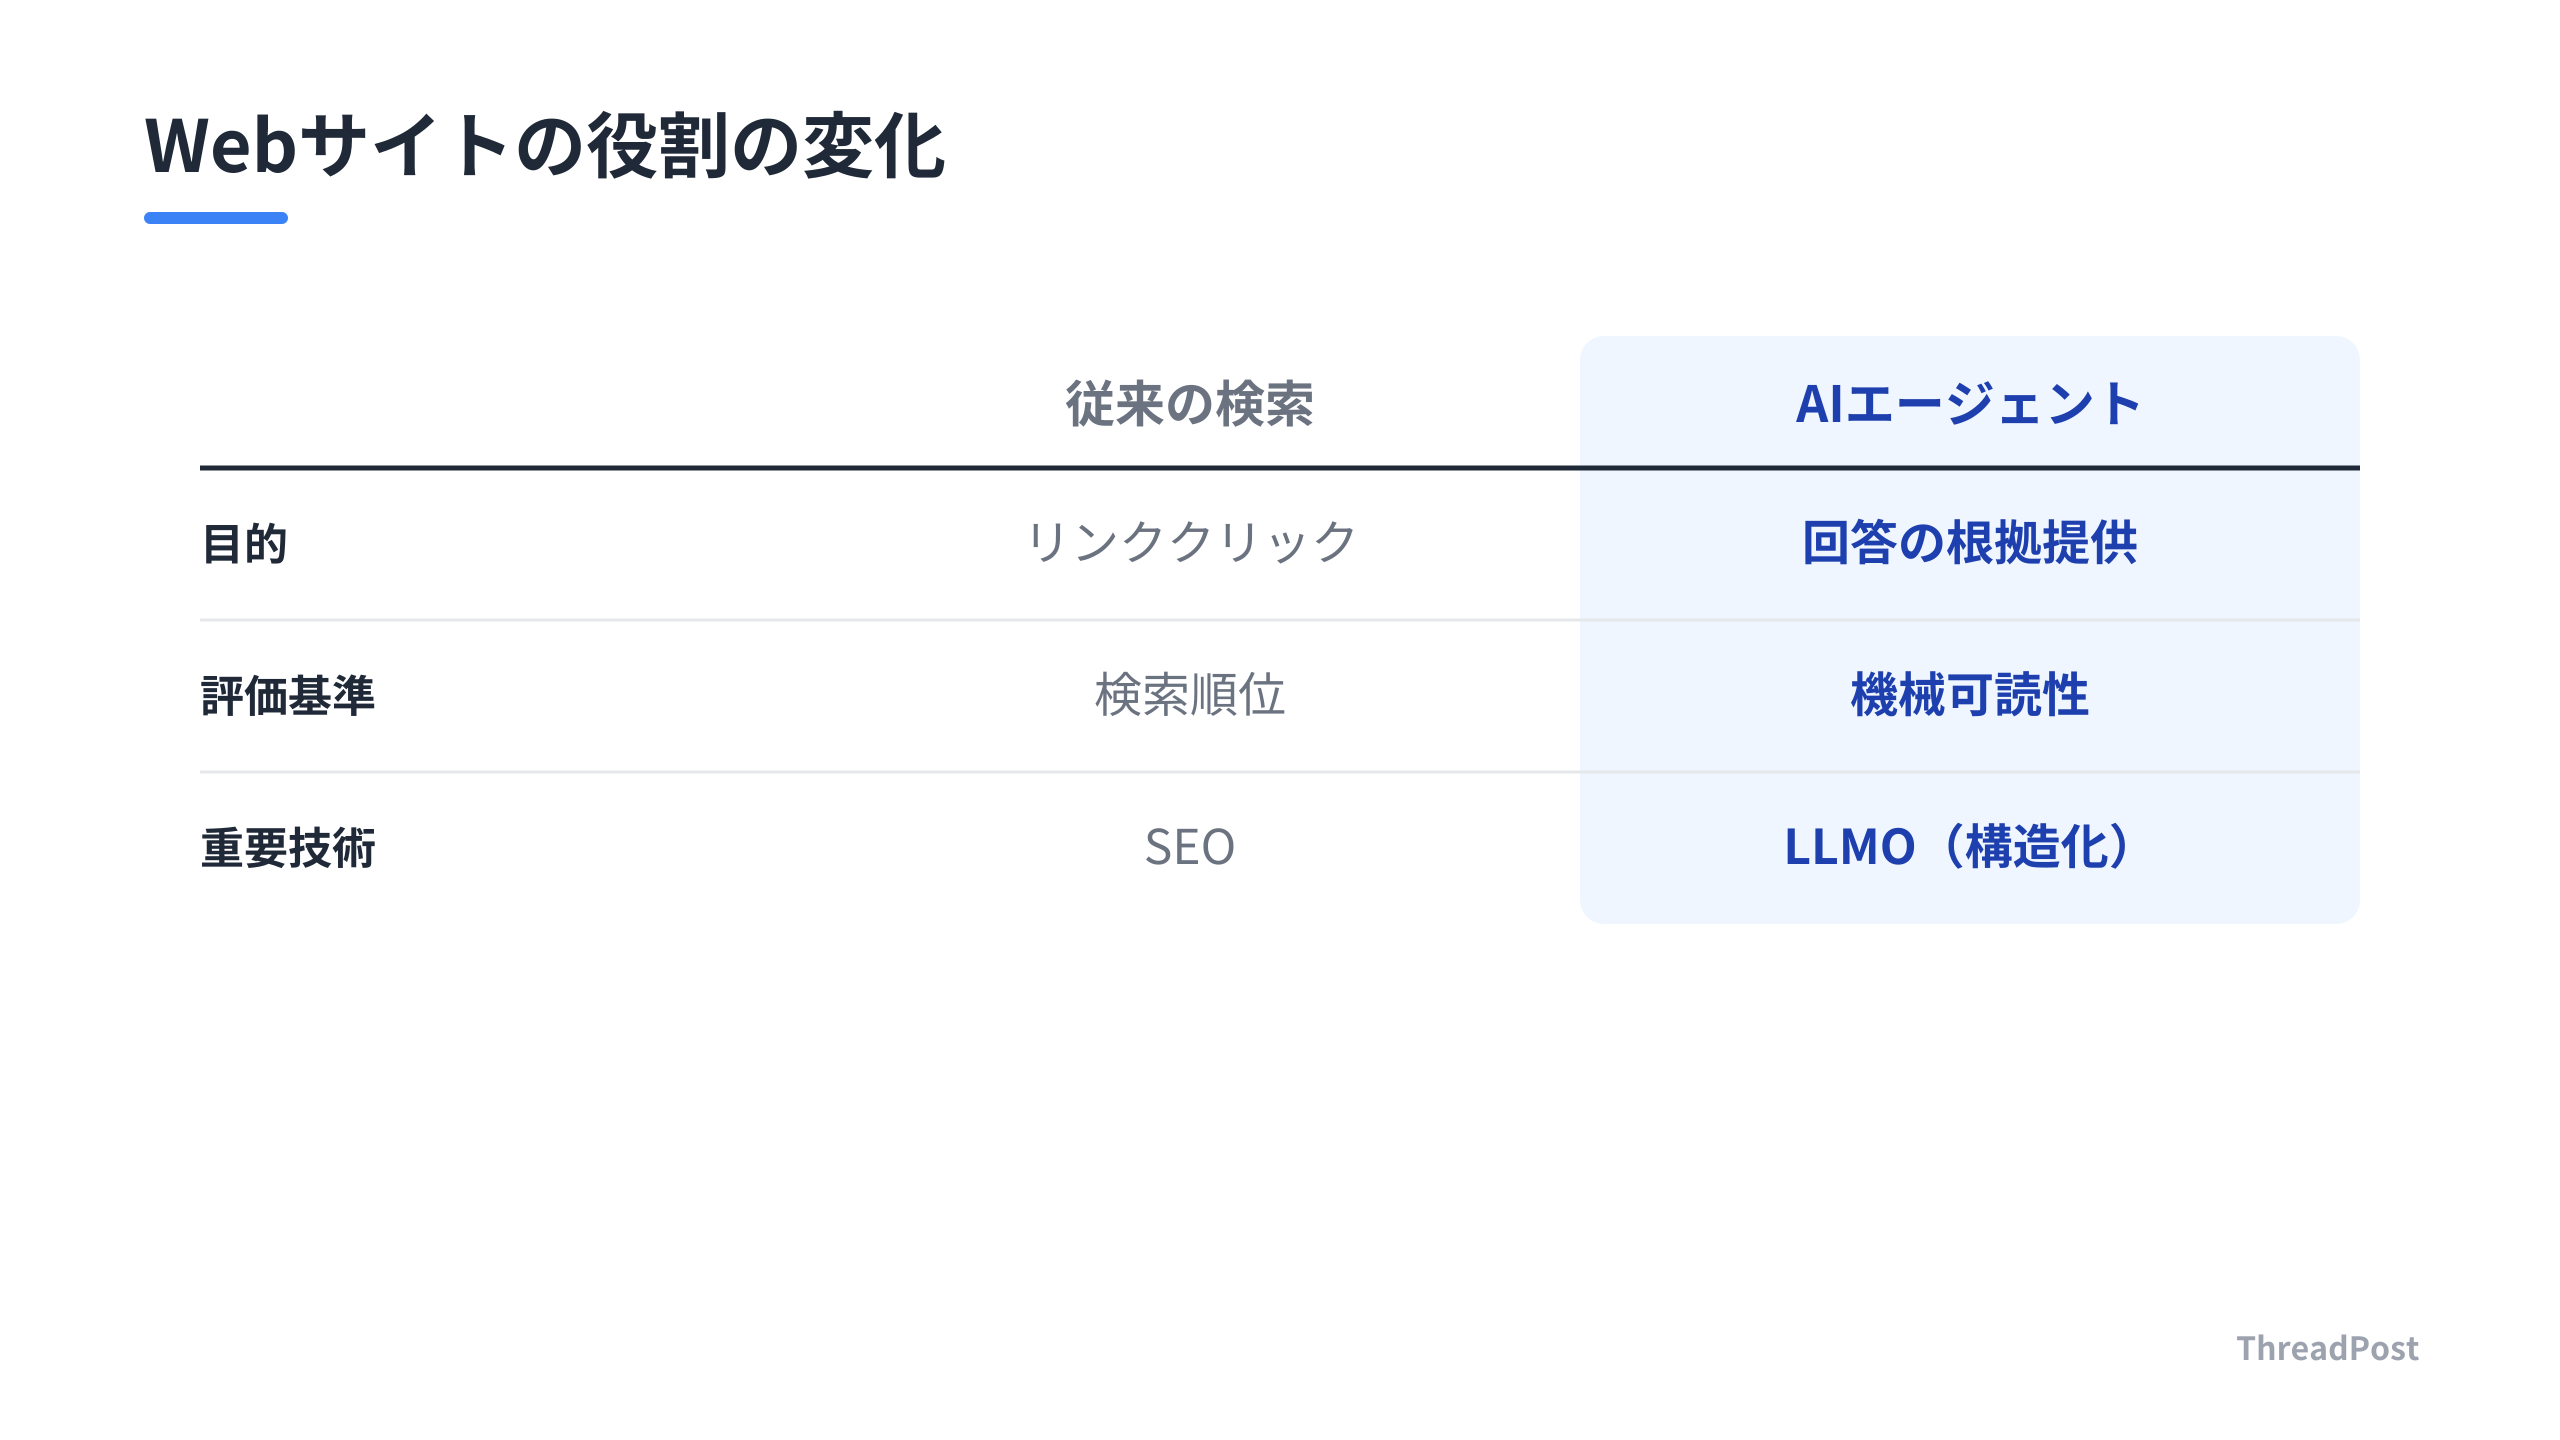
OpenAIがrobots.txtによる一括学習拒否を表明したことは、Webサイト運営者にとっての防衛策だ。AI開発者にとっては「公開データだけでモデルを鍛える時代の終わり」を意味する。これまでクローラーを走らせれば抽出できたデータが、「学習可否のシグナル」というフィルタを通る。インターネットは「AIの学習用リソース」から「AIの実行環境」へ役割を変える。
一方で、Perplexityが推し進めるローカルエージェントの普及は、この流れを決定づける。彼らが提供する環境は、Web上の公開データではなく、ユーザーのデスクトップにある「生データ」を直接操作する。APIを介したクラウド上のモデル性能競争の裏で、AIはユーザーのローカルファイル、アプリ、社内ツールへ直接指を突っ込んでいる。
開発者目線で、この二つの潮流は相反する要求を突きつける。
一つ目は、Webクローラーへの対応コストだ。robots.txtの記述一つで済むとはいえ、自社サイトのデータがどこまで学習に使われ、どこでブロックされるかを管理し続ける必要がある。二つ目は、自社プロダクトの「AI対応」の再定義だ。これまでは「APIを叩く」だけで連携が完結していたが、これからは「AIエージェントが操作しやすいUI/UX」を設計しなければならない。
Claude Codeを毎日使っていると、この「ローカル環境へのアクセス権」こそが武器だと感じる。クラウドAPIの制限にイライラするより、ローカルで完結するエージェントがファイルもアプリも操作してくれる方が、開発速度は上がる。APIの性能競争も大事だが、エージェントが自分のローカル環境でどれだけ暴れられるかが勝負の分かれ目だ。
Metaが強力なモデルを投入し、OpenAIが学習データの規律を整備する。このモデル性能競争の裏で、PerplexityのようなプレイヤーがOSレベルの操作権限を握ろうとしている。どれだけ賢いモデルであっても、ユーザーのワークフローを物理的に完結させられるエージェントには勝てない。
開発者として備えるべきは、「モデルの選定」だけではない。自社プロダクトが「AIエージェントに操作されること」を前提とした設計になっているかだ。AIがローカルファイルやアプリ間でデータを橋渡ししやすいデータ構造や、コネクタの整備が求められる。
AIの学習データがクローズド化する世界で、AIの価値は「どれだけ多くのWebデータを学習したか」から「どれだけユーザーのローカル環境に入り込めるか」へ軸足が移る。この変化を先読みして、自社ツールをエージェントフレンドリーな形式で提供できるかが、次の1年で生き残るための境界線だ。
モデルの性能が飽和しつつある今、競争の軸は「知能」から「実行力」へ移る。ThreadPostの開発においても、外部APIを叩くだけの連携から、ローカルでの自律的なファイル操作を意識した設計への移行を検討する。モデルのパラメータ数に一喜一憂するフェーズは終わり、「どこまでAIに任せて作業を完結させられるか」という実利の時代だ。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
AIエージェント時代に開発者が着手すべき実務
AI業界の動向が「Web学習の規律化」と「ローカル実行の加速」へ進む中、開発者が明日からの開発で意識すべきことは明確だ。それは、「AIエージェントに操作されること」を前提としたプロダクト設計へのシフトである。
まずは「AIフレンドリーなインターフェース」の確保だ。現在、多くのAIエージェントはOSレベルの操作権限を持ち、ローカルアプリやファイルを直接叩き始めている。自社ツールやSaaSを開発する際、AIが外部から操作しやすい「APIの公開」や「コネクタの整備」を軽視してはいけない。GUIだけで完結するツールは、今後AIエージェントのワークフローから孤立する。
次に、Webクローラー対応の標準化だ。OpenAIが導入する共通の学習拒否シグナルは、業界のデファクトスタンダードになる。自社でWebデータを収集するサービスを運用しているなら、robots.txtの記述を最新の仕様に合わせて最適化する。個別のクローラーごとに制御を書き分ける時代は終わり、共通プロトコルへの対応が運用の効率を左右する。
そして、モデル選定基準の再定義も避けて通れない。APIの性能比較だけでなく、そのモデルが「ローカル環境でどれだけ軽量かつセキュアに動作するか」という視点が重要だ。特に、ローカルファイルや機密情報を扱う開発環境においては、クラウドへのデータ送信を最小限に抑えつつ、ローカルで自律的に動くエージェントとの親和性が、開発効率を決定づける。
モデルが賢くなればなるほど、僕らは「AIにどう動いてもらうか」という設計屋に回帰する。Claude Codeでコードを書いていても、AIがローカル環境をどれだけ綺麗に叩けるかで生産性は段違いだ。これからは「AIに使いやすいコードや仕様」を書くスキルが、一番の武器になる。
最後に、セキュリティと利便性のバランスを再考する。Perplexityのローカルエージェントのように、ユーザーのローカル環境に深く入り込むツールは強力だが、セキュリティリスクも増大する。開発者として、AIエージェントからのアクセスを「許可する範囲」と「拒絶する範囲」を明確に定義し、ユーザーへ透明性の高い権限管理を提供することが、信頼を勝ち取る条件だ。
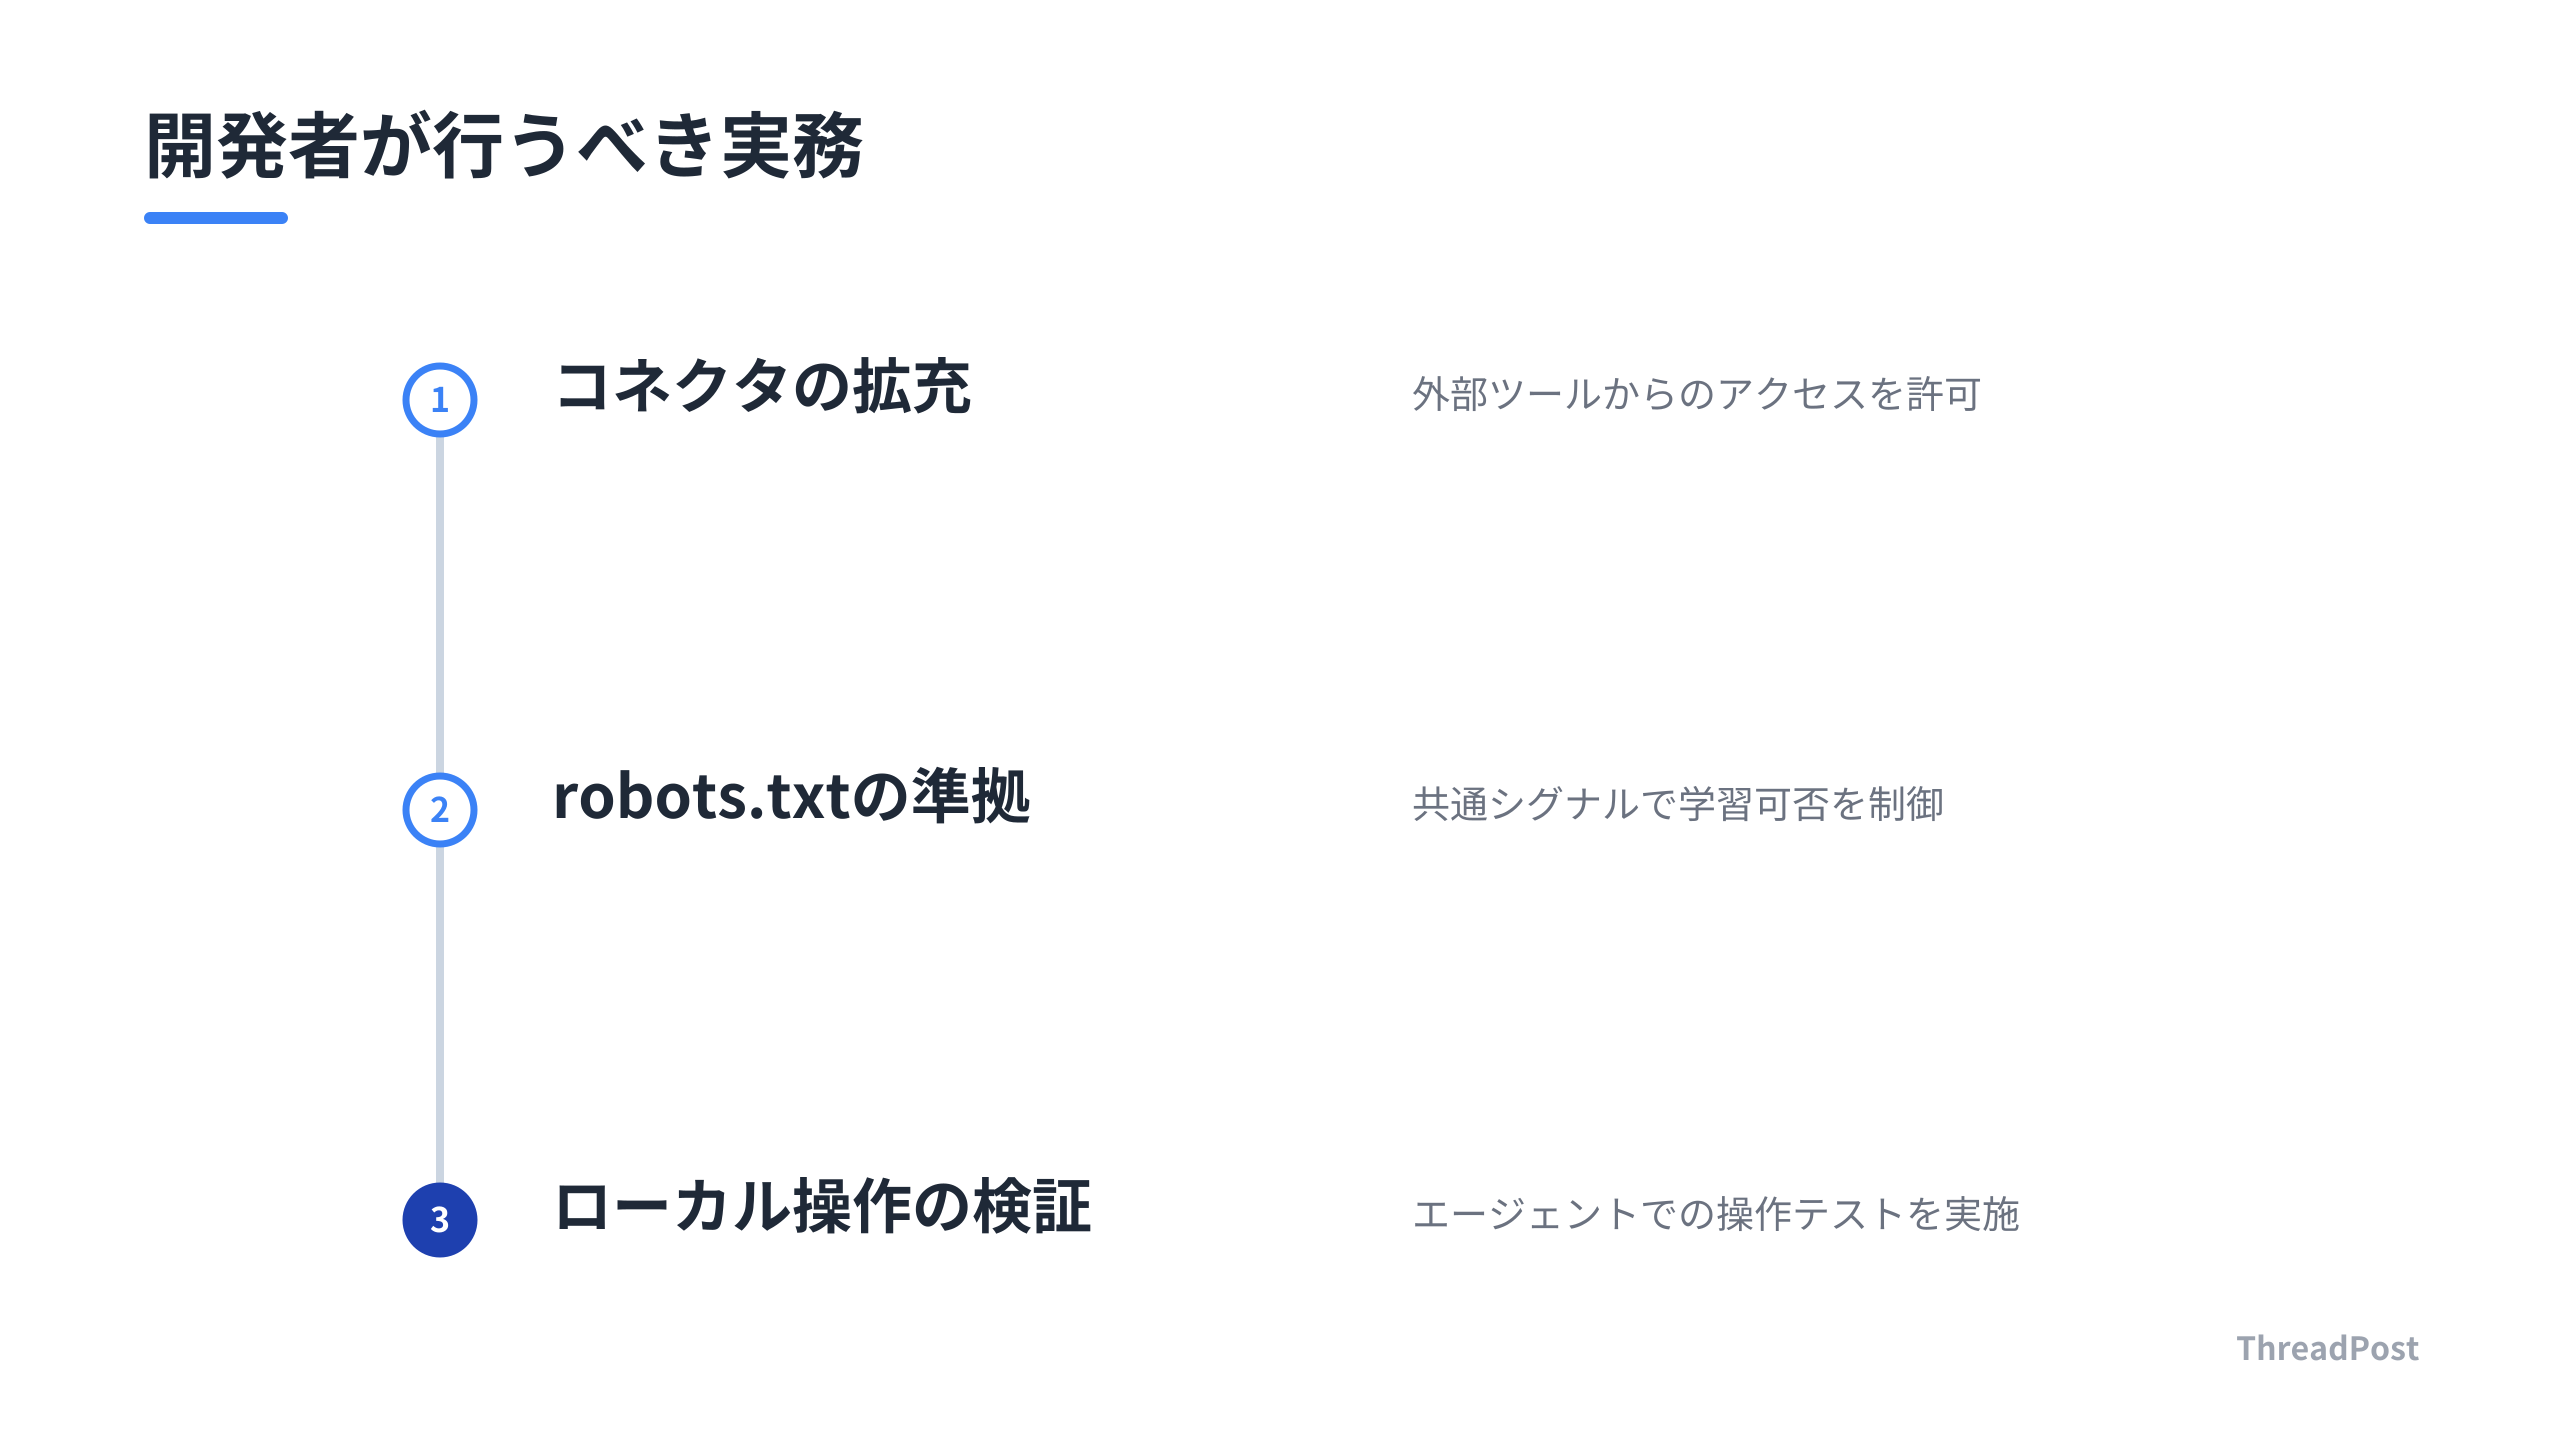
具体的には、以下の3点を意識した開発を推奨する。
- コネクタの拡充: 外部ツールから自社データや機能にアクセスできるコネクタを公開する。
- robots.txtの準拠: AI学習の意図を明確にするためのシグナルを正しく設置する。
- ローカル操作の検証: 自社アプリをAIエージェントで操作した際に、どこで躓くかを一度テストする。
AIの性能競争は激化しているが、最終的に勝つのは「ユーザーの作業を最も効率的に完結させられるエージェント」だ。モデルのパラメータ数やベンチマークのスコアに翻弄されるのではなく、AIが実務に入り込んだ際に「どれだけスムーズに動けるか」という実行環境の最適化こそが、今の開発者に求められている実務だ。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
Q1: Webサイト運営者がOpenAIの学習を拒否するにはどうすればいいですか?
今後実装される共通シグナルに対応したrobots.txtの記述が推奨されます。これにより、個別のクローラーを設定しなくても、OpenAIを含む参加プロバイダーへ一括で学習拒否を伝えられます。既存の制御ルールも維持しておくのが無難です。詳細な仕様は数ヶ月以内に公開されるため、公式のアップデート情報を注視してください。
Q2: PerplexityのPersonal Computerは安全ですか?
従来のローカルエージェントが抱えていたセキュリティリスクを軽減するため、セキュアな開発環境下での動作を前提に設計されています。ローカルファイルやアプリへのアクセス権限を管理し、クラウドとローカルを橋渡しする仕組みですが、機密性の高いデータを扱う場合は自社のセキュリティポリシーとの整合性を確認してください。利便性は高いですが、AIにどこまで権限を委譲するかはユーザー側の判断に委ねられています。
Q3: 開発者が今すぐ取り組むべきAIへの具体的な備えはありますか?
自社ツールがAIエージェントから操作しやすい「APIやコネクタ」を備えているか見直してください。また、AIが学習に使う公開データと、ローカルで実行される業務データの境界を明確に設計します。モデルの性能を追いかけるよりも、自身の開発環境やアプリがAIエージェントの操作フローにどれだけ対応できているか、Claude Codeなどのツールを使ってテストするのが現実的なアクションです。
まとめ
AI業界はモデルの性能競争から「データと実行環境の主導権争い」へフェーズを変えています。Webデータがクローズド化する一方で、ローカル環境にはAIエージェントが入り込み、日常的なワークフローを書き換えようとしています。
モデルの性能差を一喜一憂して追うよりも、自分の開発環境やプロダクトがこの「エージェントによる操作」にどれだけ最適化されているかが勝負どころです。AIが学習する側か、それともAIに操作される側か。この境界線上で、自分の手元にある環境をどう守り、どう拡張していくか。
Claude Codeを使い倒して、自分の開発フローをエージェント時代仕様にアップデートしていきましょう。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
