


AIエージェントを業務で活用する機会が増えている。コード生成の速度向上は劇的だが、セキュリティ面での不安を抱える現場も多い。AIは人間が気づかない脆弱性を一瞬で見抜く一方で、設定次第では意図しない情報漏洩を招くリスクも孕んでいる。今回は、AIエージェントを安全に運用するための具体的な対策を7つ紹介する。これらを実施することで、業務利用の信頼性は高まる。
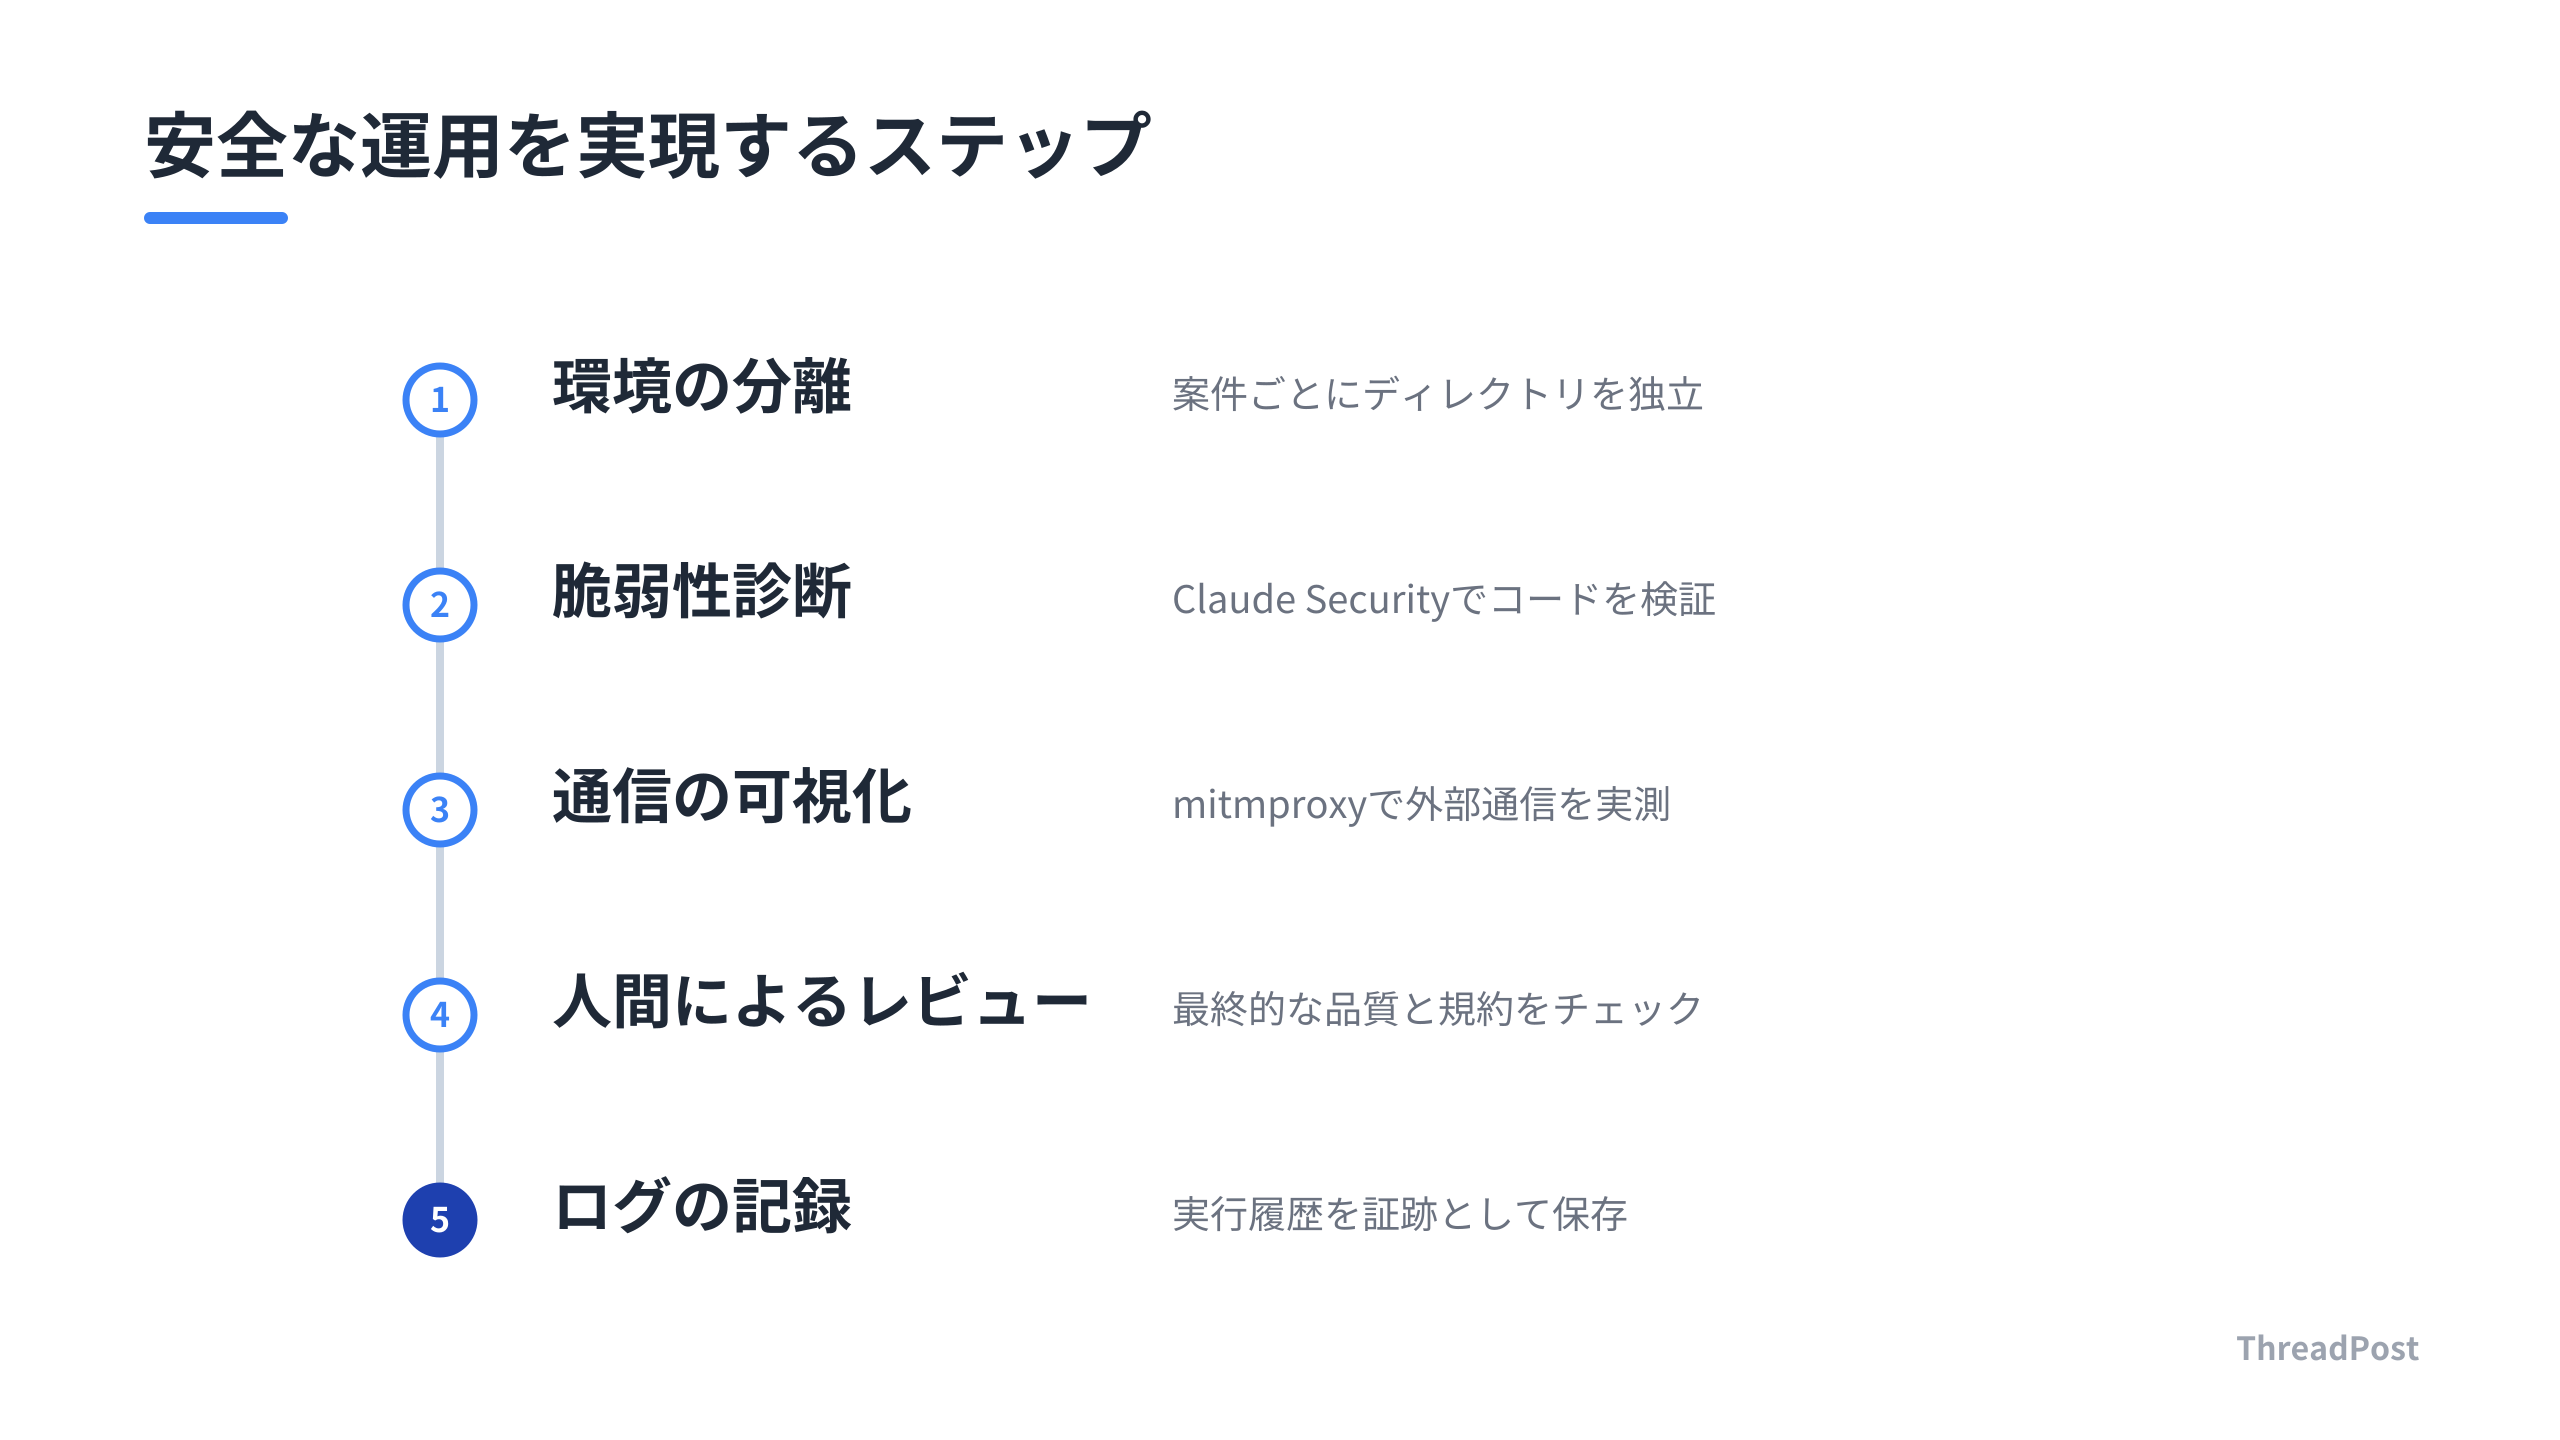
1. Claude Securityプラグインによる診断
Anthropic公式の脆弱性診断ツールであるClaude Securityは、AI開発の現場において有用だ。このツールは複数のエージェントが連携し、脅威モデルの構築から脆弱性の検証までを自動で行う。コード全体を網羅的に調べる「Scan codebase」と、差分のみをチェックする「Scan changes」を使い分けるのが効率的だ。
このプラグインの特徴は、多重検証による誤検知の抑制にある。AIが指摘した内容を別の検証エージェントが反証し、確実な問題のみをレポートする仕組みだ。導入はコマンドひとつで完了する。
2. Git Bundleによるアップロードリスクの回避
AIエージェントの権限設定は、モデルへの入力を制限するものに過ぎない。CLIプロセスがバックグラウンドでリポジトリ全体をアップロードするリスクは別個に考える必要がある。特に注意すべきは、意図しないデータ流出だ。
通信をmitmproxyなどで実測し、不審な通信が発生していないか確認する運用が有効だ。ブラックボックスな通信を可視化することで、エージェントが何を送っているかを把握できる。
3. ワークスペースの物理的分離
複数のクライアント案件を並行する場合、コンテキストの混入は守秘義務違反を招く。ある案件の知見が別の案件の提案に混ざる事態は避けなければならない。
プロジェクトごとに作業ディレクトリを物理的に分離し、知見の持ち越しを遮断する。これはツール設定以上に重要な運用ルールだ。案件ごとに環境を独立させ、クリーンな状態で作業を開始する。
4. 機密ファイルのアクセス隔離
認証トークンや環境変数、顧客の実データサンプルは、エージェントのアクセス範囲外に配置するのが鉄則だ。これらを直接作業ディレクトリに置くと、AIが意図せず読み込んでしまうリスクがある。
必要な操作のみスクリプトを経由して実行し、機密ファイルには直接触れさせない境界線を引く。AIに触れさせるデータとそうでないデータを明確に分ける運用が、安全性を担保する。
5. 人間による最終レビューの義務化
AIの提案は参考であり、最終的な責任は人間が負う。コードの動作確認だけでなく、契約上の制約や社内セキュリティ規約に抵触していないかを人間が必ずレビューするプロセスを組み込む。
AIは稀に間違える。この前提を忘れず、レビューを品質保証の要として位置づける。
6. 実行ログの記録と説明責任
AIがいつ、どのファイルを読み、どのような変更を加えたかのログを残す運用は重要だ。万が一のトラブルが発生した際、原因を即座に特定できる。
また、クライアントへの説明責任を果たすための証跡にもなる。ログ管理は手間がかかるが、信頼性を担保するためには不可欠なコストだ。
7. Auto Modeの利用制限とサンドボックス
Auto Modeは確認プロンプトを省略できる便利な機能だが、リスクも高い。信頼できる自身のプロジェクト以外では使用を控えるのが賢明だ。
サードパーティのリポジトリや、素性の分からないコードを調査する場合は、必ずサンドボックス環境下で実行する。ホスト環境を汚染させないための防波堤として、隔離された実行環境を活用する。
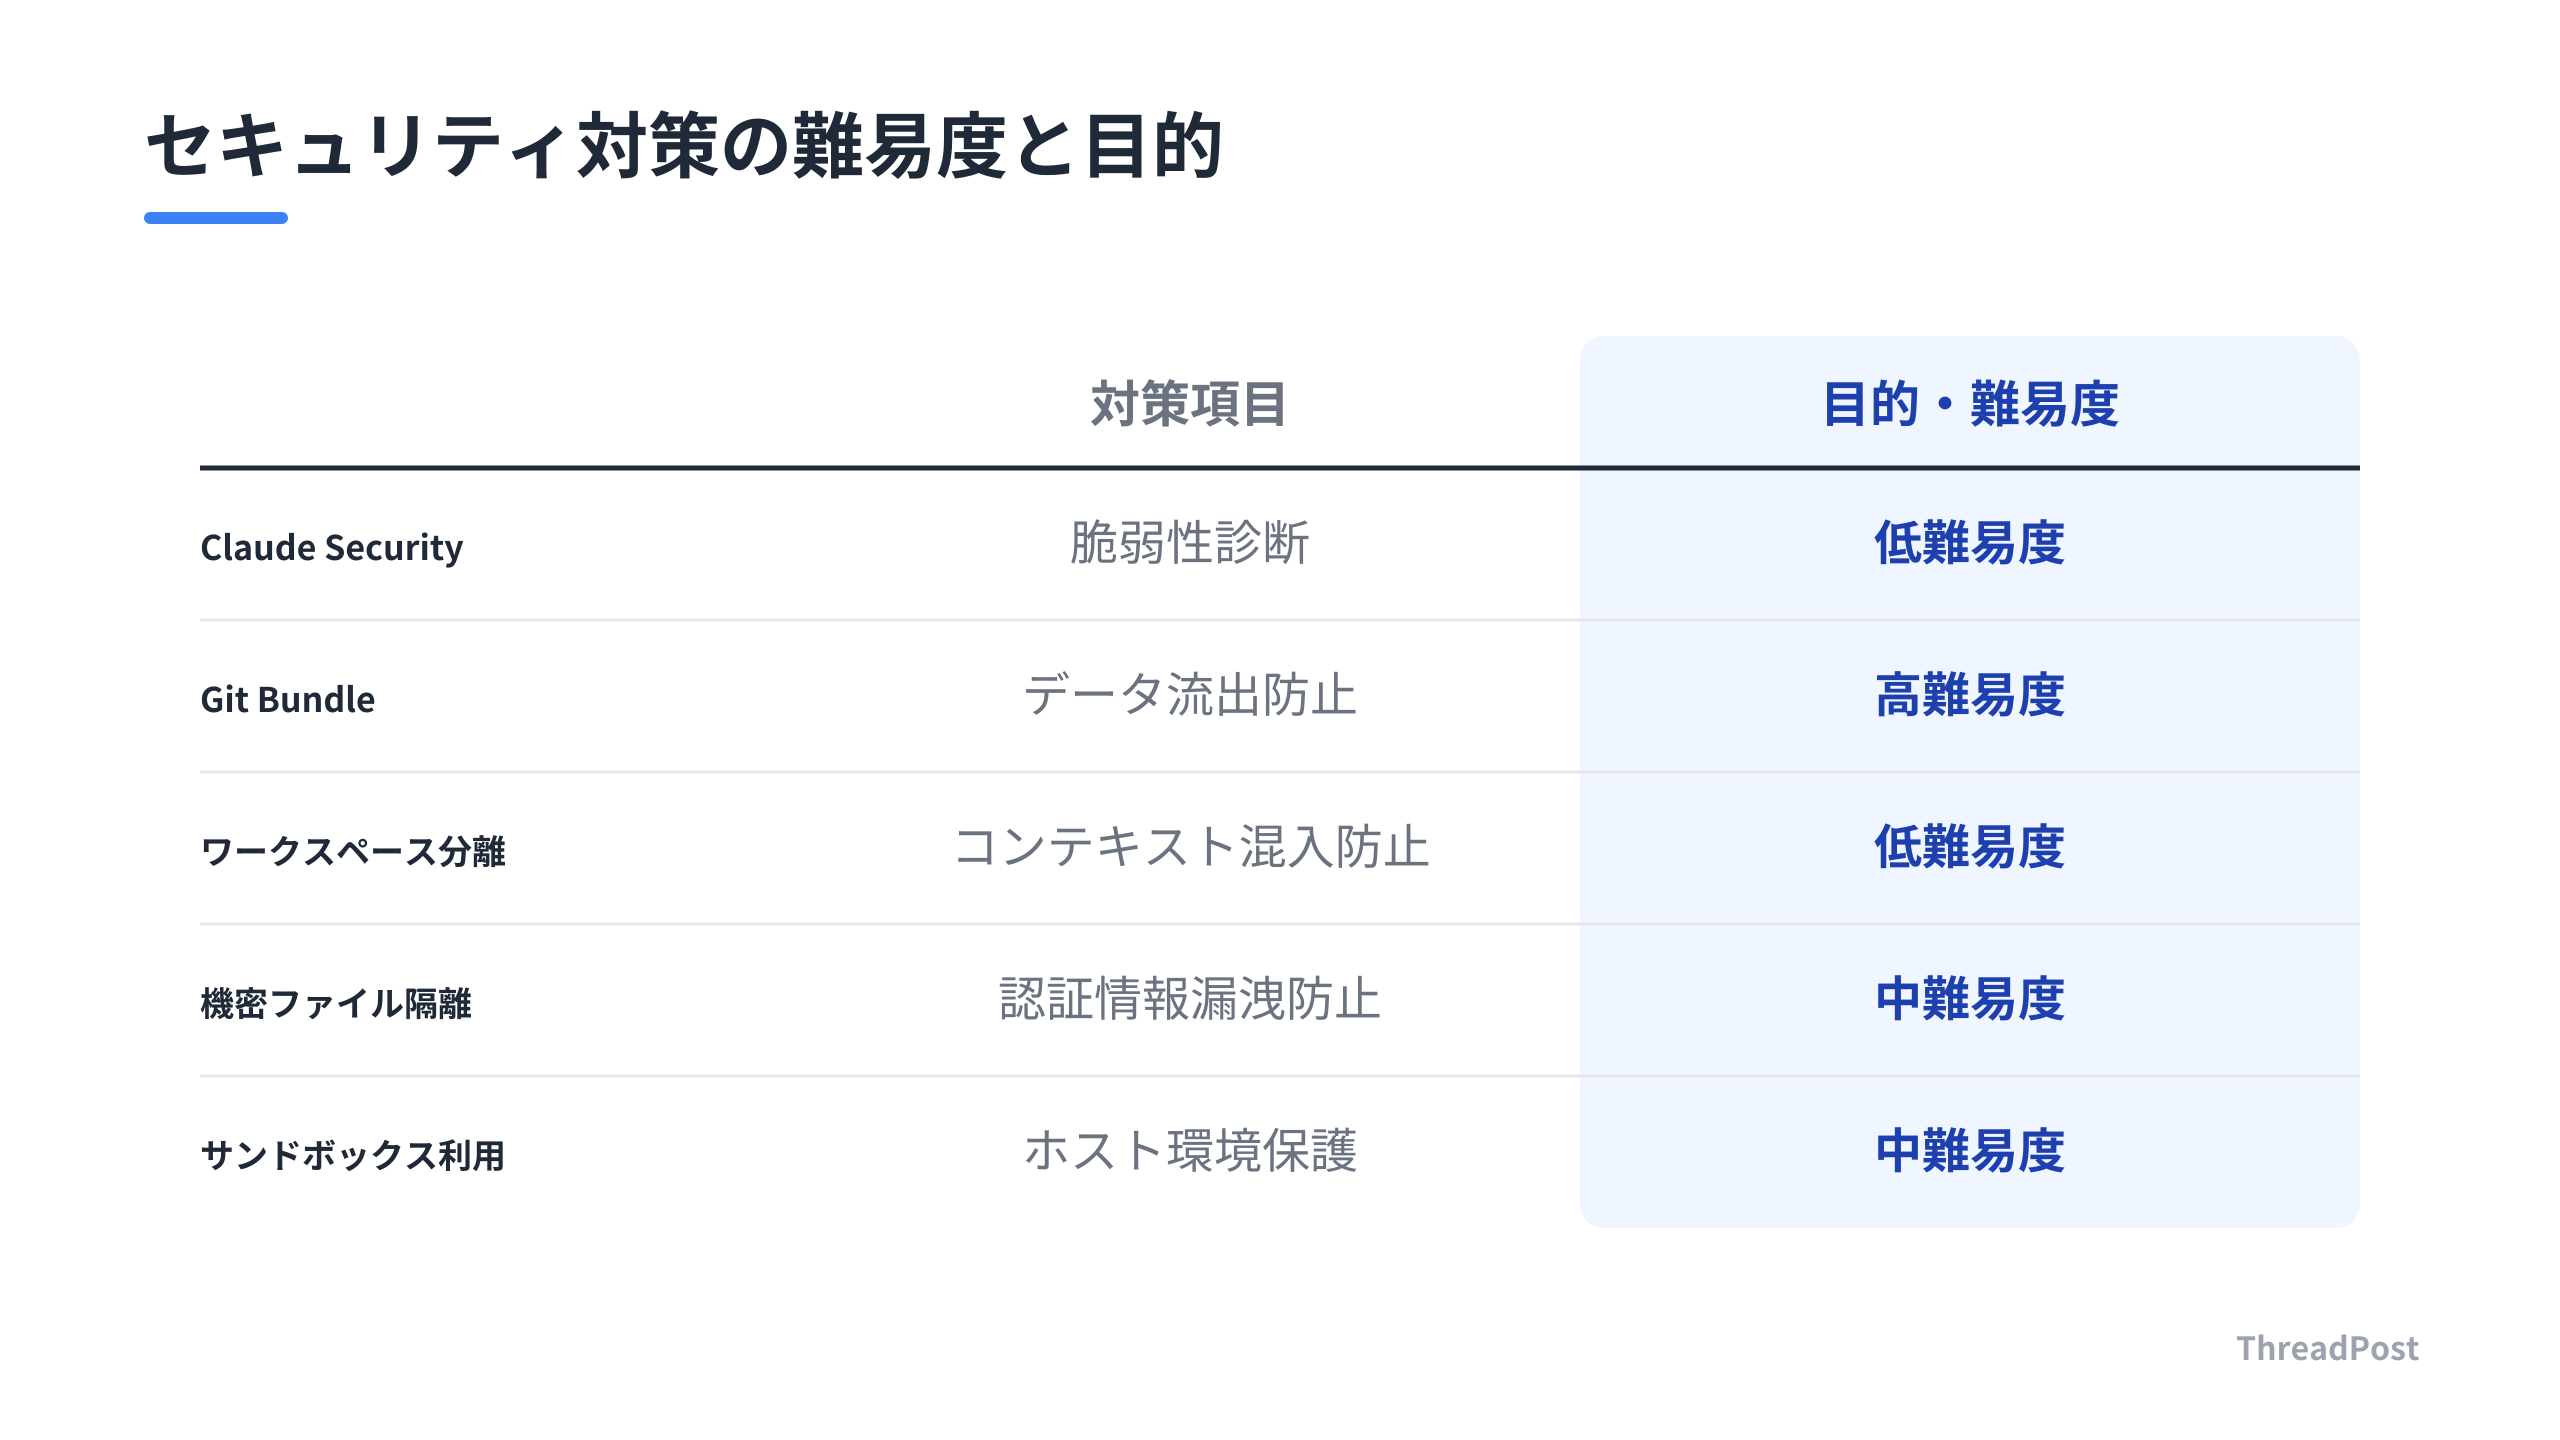
| 対策項目 | 目的 | 難易度 |
|---|---|---|
| Claude Security導入 | 脆弱性診断の自動化 | 低 |
| Git Bundle対策 | データ流出の防止 | 高 |
| ワークスペース分離 | コンテキスト混入防止 | 低 |
| 機密ファイル隔離 | 認証情報漏洩の防止 | 中 |
| 人間によるレビュー | 最終品質の保証 | 中 |
| 実行ログの保存 | 説明責任の担保 | 低 |
| サンドボックス利用 | ホスト環境の保護 | 中 |
しんたろー:
Claude Codeを日常的に使う身からすると、セキュリティ対策はツール任せにしないのが一番だ。特にClaude SecurityプラグインのScan changesは、日々の開発フローに組み込みやすく、脆弱性を見逃さないための強力な相棒になる。
複数の案件を抱える開発者にとって、ワークスペースの分離は基本だ。プロジェクトごとに完全にディレクトリを分けて管理することで、コンテキストの混入というヒューマンエラーを物理的に防ぐことができる。
FAQ
Q1: AIエージェントの権限設定をすれば安全か。
A1: 権限設定だけでは不十分だ。多くの設定はモデルへの入力を制限するものであり、エージェントがバックグラウンドで外部へデータを送信する挙動までは止められない場合がある。通信の実測や、機密ファイルをエージェントの作業ディレクトリに置かないといった、物理的な隔離が不可欠だ。
Q2: Claude Securityプラグインは自動でコードを修正できるか。
A2: プラグインは脆弱性の指摘と修正案の生成までを行うが、自動で適用やコミットはしない。必ず人間が内容を確認し、適用するかどうかを判断する必要がある。AIの提案を盲信せず、最終的な責任は人間が持つ。
Q3: 複数の案件を抱えているが、どう使い分けるべきか。
A3: 案件ごとにワークスペースを完全に分離する。ある案件のコンテキストが別の案件に混入すると、守秘義務違反のリスクが高まる。共有環境ではなく、プロジェクトごとに独立した環境でエージェントを起動することを徹底する。
Q4: Auto Modeはなぜ危険なのか。
A4: Auto Modeはユーザーの確認なしにファイル読み取りやコマンド実行を繰り返すためだ。もしリポジトリ内に悪意のあるコードや脆弱性が仕込まれていた場合、意図せずシステムが操作される恐れがある。信頼できる自分のコード以外では使用を避けるのが鉄則だ。
Q5: 脆弱性診断の結果、誤検知が多い場合はどうすべきか。
A5: Claude Securityのような多段エージェント型ツールは、独立した検証者による反証プロセスを経て誤検知を減らす設計になっている。それでも指摘が出る場合は、フレームワークの仕様や防御策の有無を人間が再確認し、ツール側の判定根拠と照らし合わせて判断する。
AIエージェントを安全に使いこなすためのセキュリティ対策は、開発環境を守るための投資だ。まずは公式プラグインの導入から始め、安全な開発フローを確立する。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
