


AIが高度な分析を行い、グラフを作成する。参照できるデータソースの数は300を超える。一瞬で文脈を理解し、回答を生成する。
ここに落とし穴がある。AIの精度が上がるほど、人間は中身を見ずに承認ボタンを押す。人間の確認作業の形骸化だ。
事故が起きたとき、最後にボタンを押した人間だけに責任を押し付けるのか。それともAIの推論プロセスを追跡できる設計をシステムに仕込むのか。Claude Codeでプロダクトを組む僕が、AIエージェント時代に必要な責任可視化の設計について書く。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
分析判断を行うAIの登場と「責任の形骸化」という新たなリスク
AIによるデータ分析の現場で変化が起きている。GPT-6 Astraが搭載されたデータ基盤では、数値がビジネスの目的に沿っているかをAI自身が検証する分析判断力が備わった。
地理空間データの変換や、複数チャネルの売上トレンドを自動でダッシュボードにする。技術的に正しいコードを動かすだけでなく、ユーザーが求めている回答かをモデル自ら吟味する仕組みだ。
情報収集や知識管理の環境も変化している。チャットAIと資料理解AIの統合により、取り扱えるデータソースの数は最大で300個に拡大した。スマホでメモした思考の断片が同期され、ドキュメントやスライド、音声データまで横断分析できる。
ノートブックのソースをもとに2人のAIが対談する音声解説機能や、短時間の動画を自動作成するCinematic Video Overviewsといったマルチメディア機能も登場した。思考の壁打ちから可視化、共有までのスピードが上がっている。
しんたろー:
データ分析からダッシュボード作成までAIが一瞬でやってくれるのは助かる。グラフがそれっぽすぎるせいで、中身のロジックを誰も疑わずに承認ボタンを押す未来が見える。
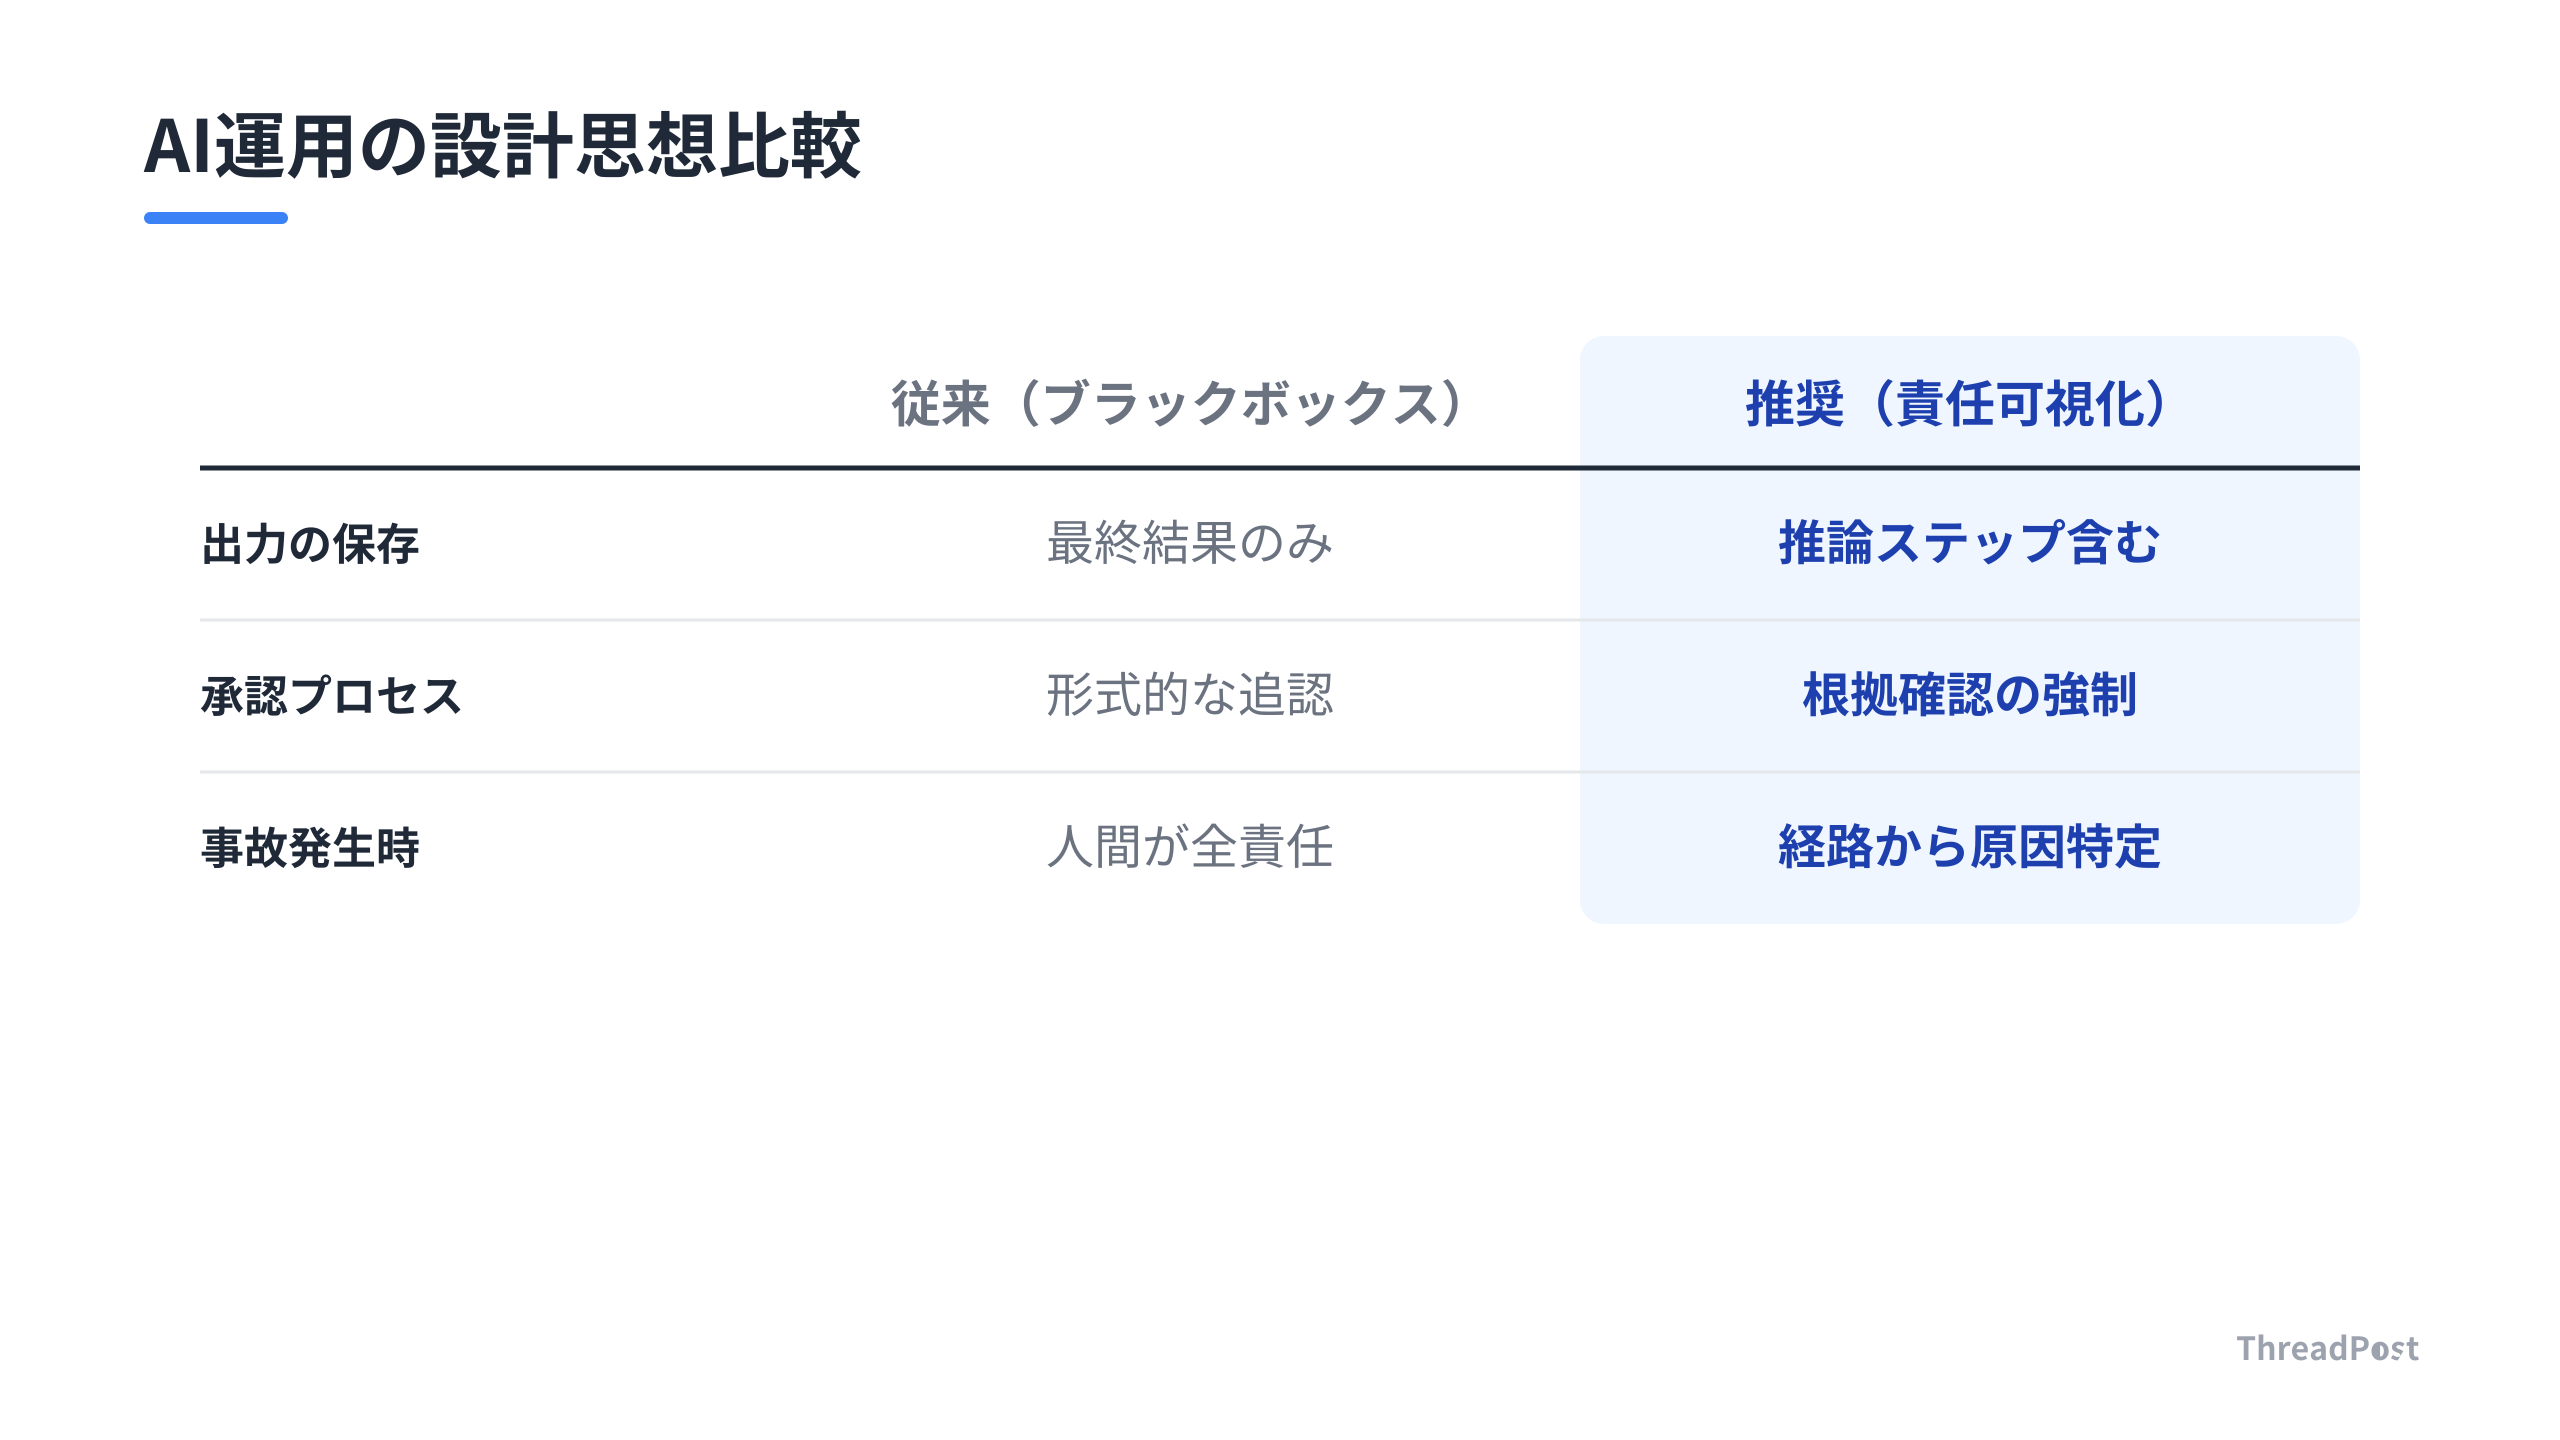
AIの分析能力向上と知識統合の進化は、開発現場に課題を突きつけている。AIの出力精度が高くなるほど、確認役である人間のチェックが形式的な「追認」に変わる。HITL(Human-in-the-loop)の形骸化だ。
処理件数が増えるにつれて、人間はAIが提示した結果を深く確認せず承認ボタンを押す。計算ミスや運用事故が発生した際、システム設計の欠陥には触れず「最後に承認ボタンを押した人間」に全責任が押し付けられる構造がある。
人間が介在しているフリをする設計ではなく、AIがどのようなデータからどう推論したのかという責任経路を可視化するシステム構築が必要だ。AIが下した判断の根拠とプロセスのログを残さなければ、運用事故が起きた際の改善は不可能になる。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
高度化するAIエージェントと人間が陥る「全自動の罠」
AIの進化スピードは速い。高度な分析判断力を持つモデルが登場し、複数のツールや膨大なデータソースが統合される環境が整った。
データ統合の進化を象徴するのが、同時参照できるソースの多さだ。300個以上の資料を同時に読み込ませて横断的なデータ分析を行わせたり、地理空間データの変換処理から視覚的なレポート作成までをAIが一括して担う世界が現実にある。
かつて人間が数日かけて行っていたデータ整形や可視化、文脈の解釈までもが、一瞬で完了する。開発者にとって、この波に乗る選択肢がある。
ツール間の移動コストが減り、自分の思考データや収集した一次資料をAIへ投げ込むだけで、即座に実用的な成果物が返ってくる。
ここに構造的な罠が存在する。AIの分析精度が高くなり、出力されるアウトプットが魅力的になるほど、人間は「AIの出す結果は正しい」と無意識に信じ込む。
Claude CodeにTerminalで指示を出していると、提案されたコードが綺麗すぎて全部採用したくなる。裏でAPIの仕様変更を無視していることに気づかず、後から冷や汗をかいたことがある。
AIが賢くなるほど、人間による確認作業は形式的になる。人間がチェックして最終決定を下すべき場面でも、画面に表示された承認ボタンを内容も見ずに押すだけの作業になる。
この現象は、開発するシステム内部でも発生する。AIエージェントを業務システムに組み込んだ際、精度の向上ばかりに目を奪われると、事故が起きたときに「誰がどの段階で間違えたのか」を誰も追跡できないブラックボックスが完成する。
実装すべきなのは、単にAIに処理を任せる仕組みではない。AIがどのようにデータを参照し、どのような推論を経てその結論に達したのかという責任経路(Responsibility Pathway)を可視化するログ設計だ。
AIの出力結果だけを保存するのではなく、あらかじめ定義した3つの要素をセットで保持するデータ構造を設計する。
- 入力されたプロンプトと文脈データ
- 参照したデータソースの識別情報
- AIが判断に至るまでに通過した中間推論ステップ
このデータが残っていれば、人間がチェックを怠って誤った判断が実行されたとしても、事後的に検証してどこで判断が狂ったのかを特定できる。システム設計の欠陥なのか、参照データの不備なのか、AIの誤認なのかを追跡できる。
自律型AIを活用してコードを書く場合でも、この考え方は当てはまる。AIが書き換えたコード差分だけでなく、AIが提示した判断根拠をコミットメッセージや開発ログへ自動的に記録させる設計が欠かせない。
AIの精度を追求することと、AIの責任経路を可視化することは相反しない。AIに高度な判断を委ねるほど、その裏側に強固な追跡可能性を仕込んでおくことが、開発者に求められる設計力だ。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
明日のシステム設計で僕らが意識すべき3つの具体的な実装変更
AIの分析力や自動化能力が高まっても、システムのコードを書くのは開発者だ。AIの精度向上を前提とした上で、明日からの開発実務で意識したい変更点は3つある。
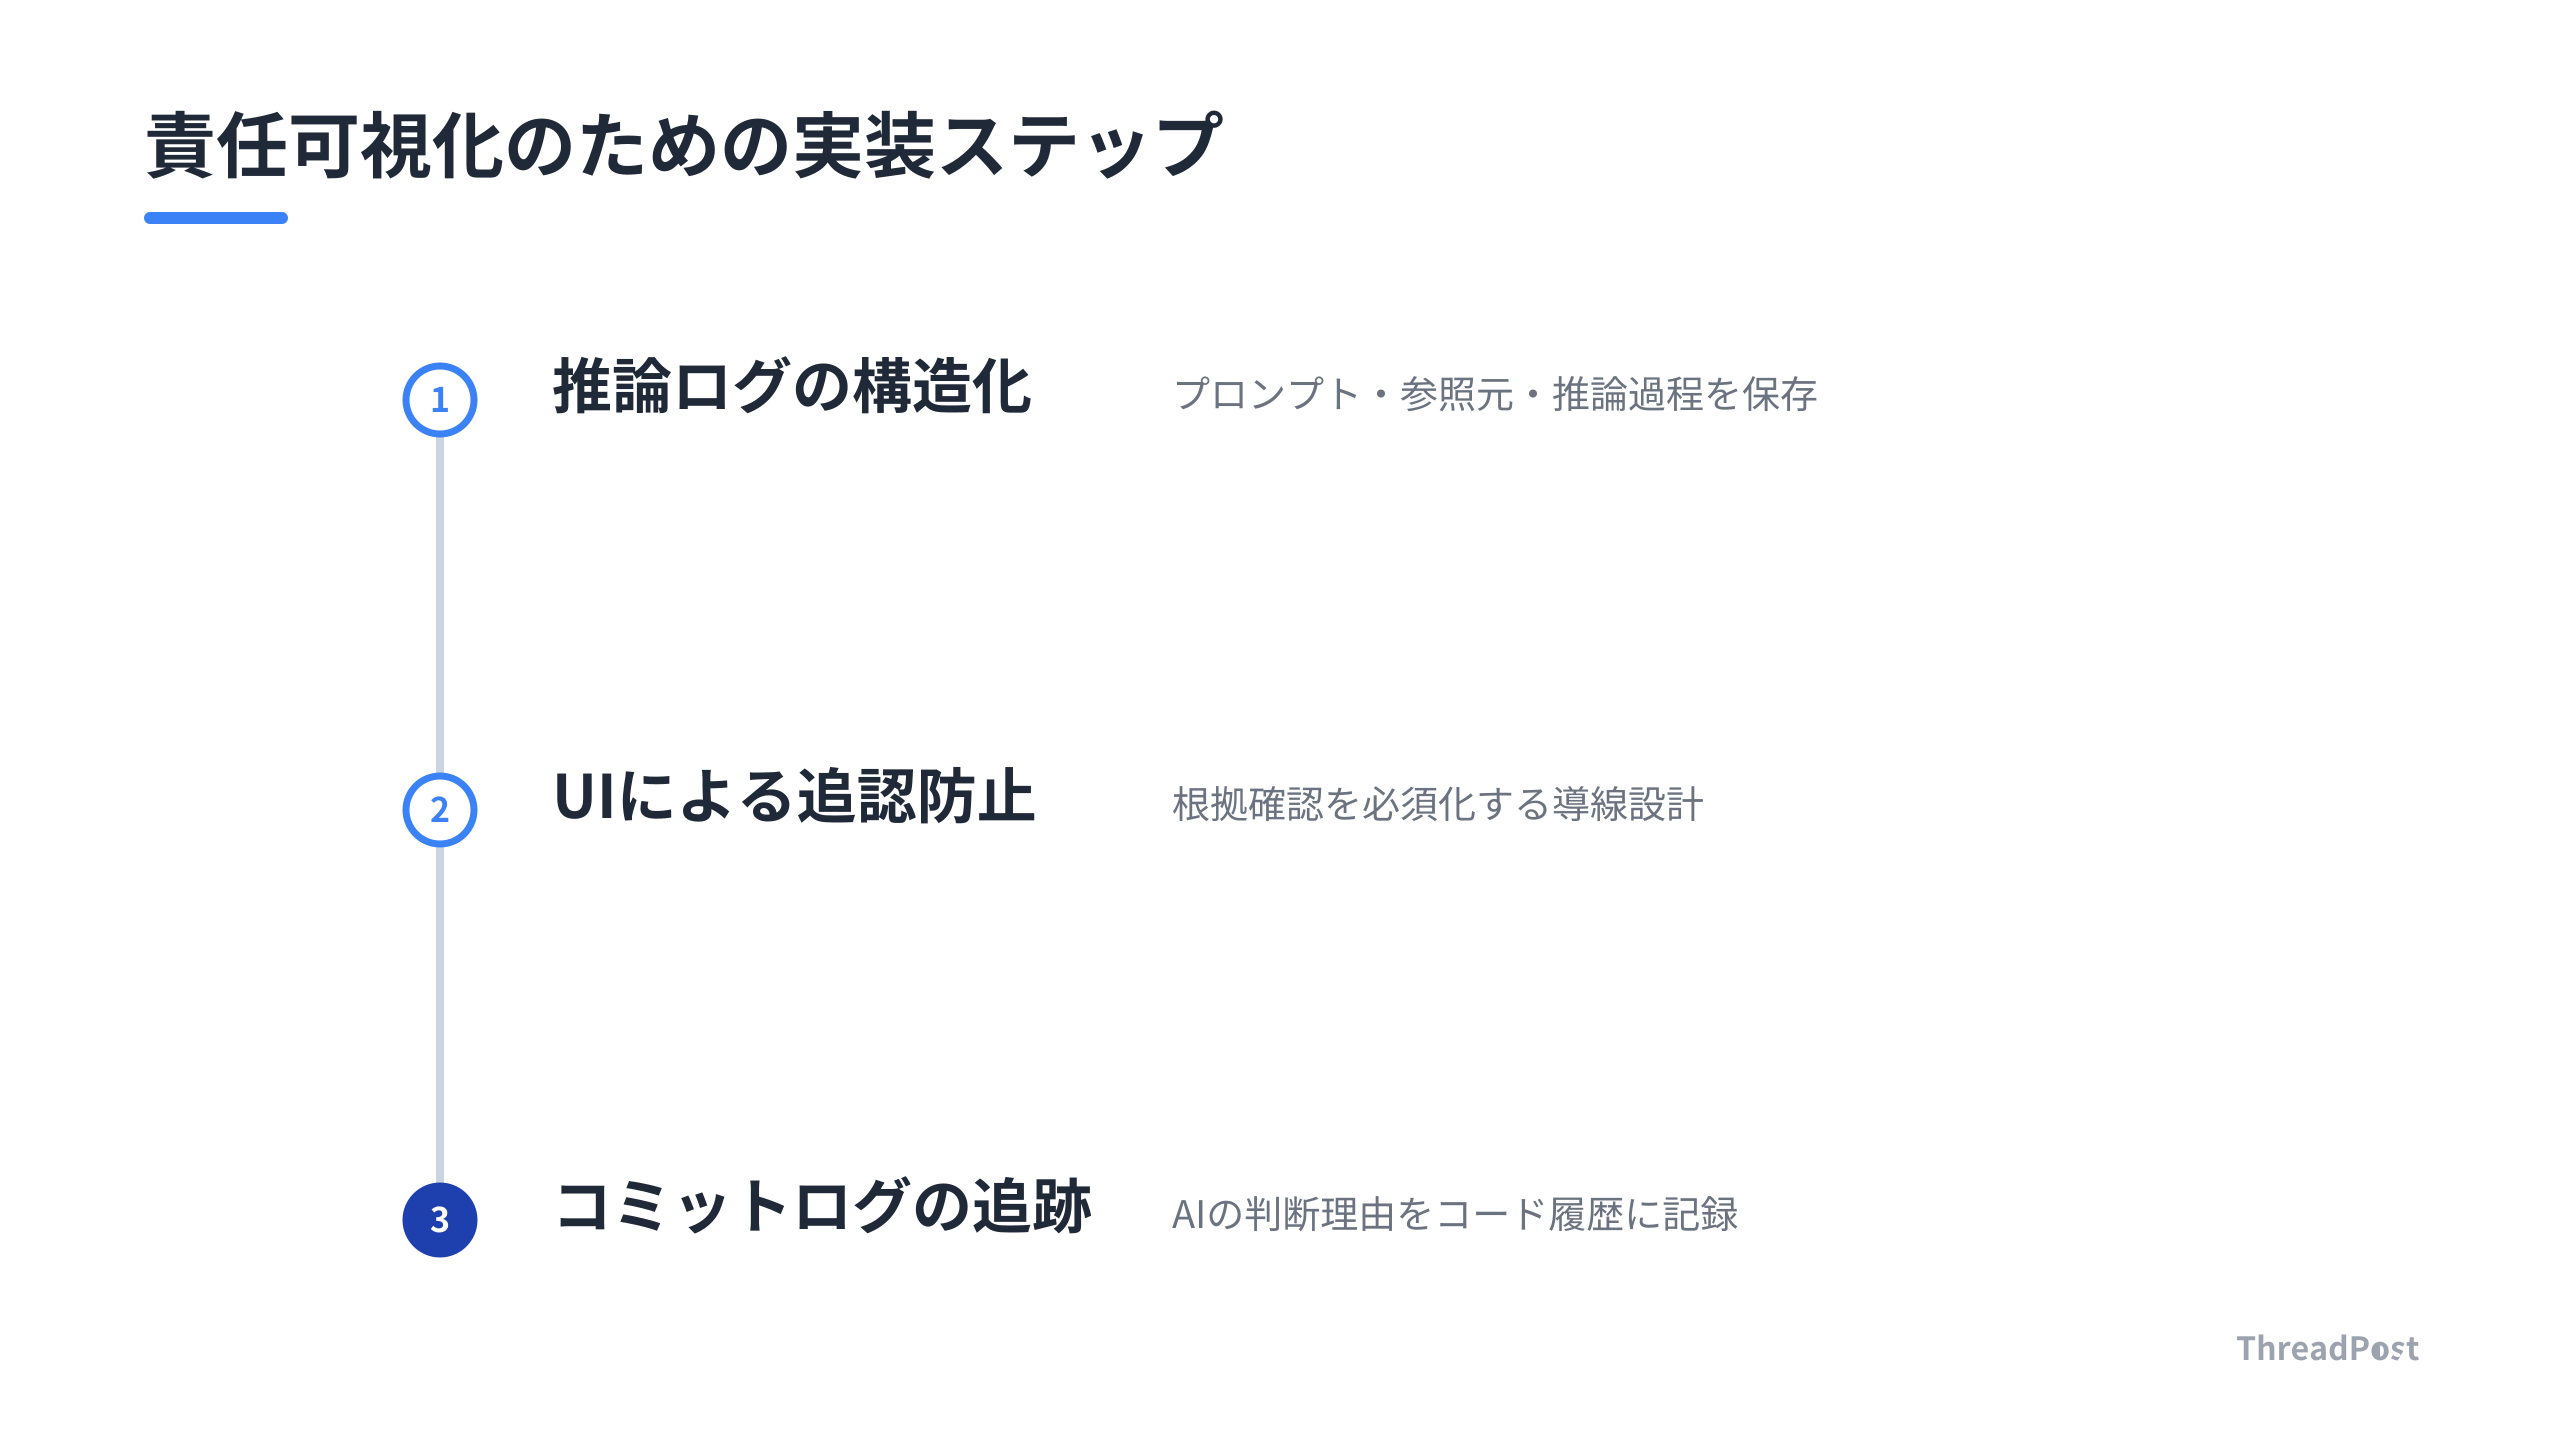
1つ目は、AI応答の保存データ構造に推論過程のメタデータを必須化することだ。
AIが返してきた最終結果のテキストだけをデータベースに格納する設計は、運用リスクが高い。プロンプト、参照した元データ、AIが思考した中間推論ステップの3つの要素をセットでログテーブルに保持するスキーマに変更する。
2つ目は、管理画面などのUI設計において追認を物理的に防ぐ仕組みを入れることだ。
画面上にAIの生成結果と承認ボタンだけを配置すると、運用者はボタンを連打する機械になる。承認ボタンを押す手前に参照データの確認チェックを挟んだり、AIが挙げた判断根拠の要約を表示させたりするUI設計が有効だ。人間が思考をスキップできない導線を作ることが、事故を防ぐ防波堤になる。
3つ目は、開発環境で自律型AIを使う際のコミットログ追跡性の向上だ。
Claude Codeのようなツールを使う際、AIが自動生成したコードの変更差分だけを見て承認すると、後からなぜその実装になったのか追えなくなる。コミットメッセージやPRの概要欄に、AIに対して与えた指示とAIが選択した実装方針の理由を自動で流し込む設定を仕込む。
承認ボタンを連打してしまう気持ちはわかる。AIが提示するコードやデータが完璧に見えると、人間側の脳みそは停止する。システム側で嫌でも思考させる仕組みを組んでおかないと、障害が起きた時に全員で首をかしげることになる。
具体的なアクションとして、既存のAI連携モジュールのレスポンス処理部分を見直す。AIのAPI呼び出しロジックで、単にコンテンツを取り出すだけでなく、レスポンスに含まれるメタデータやシステムプロンプトのバージョンをJSON形式でログストレージに書き出す処理を1文追加するだけで、運用の安全性は向上する。
また、社内ツールや自社サービスにAI機能を組み込む際は、責任経路の定義を仕様書に明記する。AIの誤判断によってユーザーに不利益が生じた際、どのログを追えば原因を特定できるかをチーム内で共有しておくことで、運用トラブル時の復旧速度は数十倍の差になる。
AIを「優秀な作業員」として扱うフェーズは終わった。これからは「高度な判断を下すが、時に勘違いもするパートナー」として扱い、その判断の軌跡を透明化する設計を標準装備していくことが、開発者に求められる実務だ。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
AIの分析結果を人間がチェックする際、確認作業の形骸化を防ぐ具体的な方法はありますか?
承認ボタンを押させる画面設計をやめることだ。AIが提示した最終結果だけでなく、参照したデータソースや推論の分岐プロセスを同時に表示する検証用UIを構築する。
人間が結論の根拠を数秒で追跡できる情報配置にすることで、形だけの追認を防止する。判断に使われたプロンプトのバージョンや入力パラメータの履歴を可視化し、後から第三者が検証できる仕組みを作ることが責任可視化の第一歩だ。
高度なAIや複数ソース参照ツールを導入する際、セキュリティで気をつけるべき点は?
アクセスコントロールの境界線がAIの参照によって壊れる点だ。複数の社内資料をAIに読み込ませると、本来閲覧権限のないユーザーに対しても機密情報を含んだ回答が出力されるリスクがある。
導入の際は、AIがアクセスできるデータソースの権限設定を事前に確認する。また、誤ったデータが混入した際の影響を抑えるため、参照範囲をプロジェクト単位に限定するルール化を社内で徹底する。
責任経路のログを全て保存すると、ストレージ費用やトークンコストが膨らみませんか?
AIとのやり取りをテキストのまま全件保存すると、コストは爆発する。実務ではメタデータのみを構造化して残す工夫が効く。
生のログを丸ごと抱えるのではなく、実行時のプロンプトIDや参照データのハッシュ値、選択された分岐ロジックだけを軽量なJSON形式で記録する。障害発生時だけ当時の文脈を復元できる状態を作っておけば、コストを抑えながら強力な監査ラインを維持できる。
まとめ
AIの分析精度が上がるほど、人間の確認作業は形骸化する。GPT-6 Astraのような高度な分析や知識統合が進む中で開発者がやるべきは、精度の向上に喜ぶことではない。「誰がどこで判断を引き受けたか」という責任経路をコードに刻むことだ。
AIに丸投げする自動化ではなく、責任の通過点が見える自動化へ。自身のプロダクト開発で、この設計と格闘している。AI時代の責任設計やSNS運用の自動化について、議論する。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
