


AIエージェント開発で「指示を聞かない」「文脈を忘れる」といった問題に悩む人は多い。長大なプロンプトを書いて解決しようとするのは、実は逆効果だ。AIの性能を最大限に引き出すためには、情報を詰め込む足し算ではなく、不要な情報を削ぎ落とす引き算のコンテキスト管理が不可欠だ。本記事では、最新のモデルで成果を出すための実践的なテクニックをまとめる。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
ルール全書きからの脱却
行動を細かく縛る長大なシステムプロンプトは、モデルの推論能力を低下させる。これからは「禁止事項」を並べるのではなく、判断基準を渡し、状況に応じて適切な行動を選ばせる設計へシフトする。具体的な行動を一つずつ指定すると、ユーザーの依頼や既存コードの方針と衝突するリスクがある。判断基準を言語化して渡すことで、AIは状況に合わせた柔軟な回答を選択できる。
情報のモジュール化とオンデマンド読み込み
全ての情報を常に読み込ませるのは非効率だ。プロジェクト固有の注意点は専用のマークダウンファイルにまとめ、作業手順は「スキル」として切り出す。必要な時にだけ読み込ませる構造を作ることで、コンテキストのノイズが減り、精度が向上する。必要な情報へ到達する手段を用意することが、エージェントの賢さを支える基盤だ。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
Few-shotは末尾が支配する
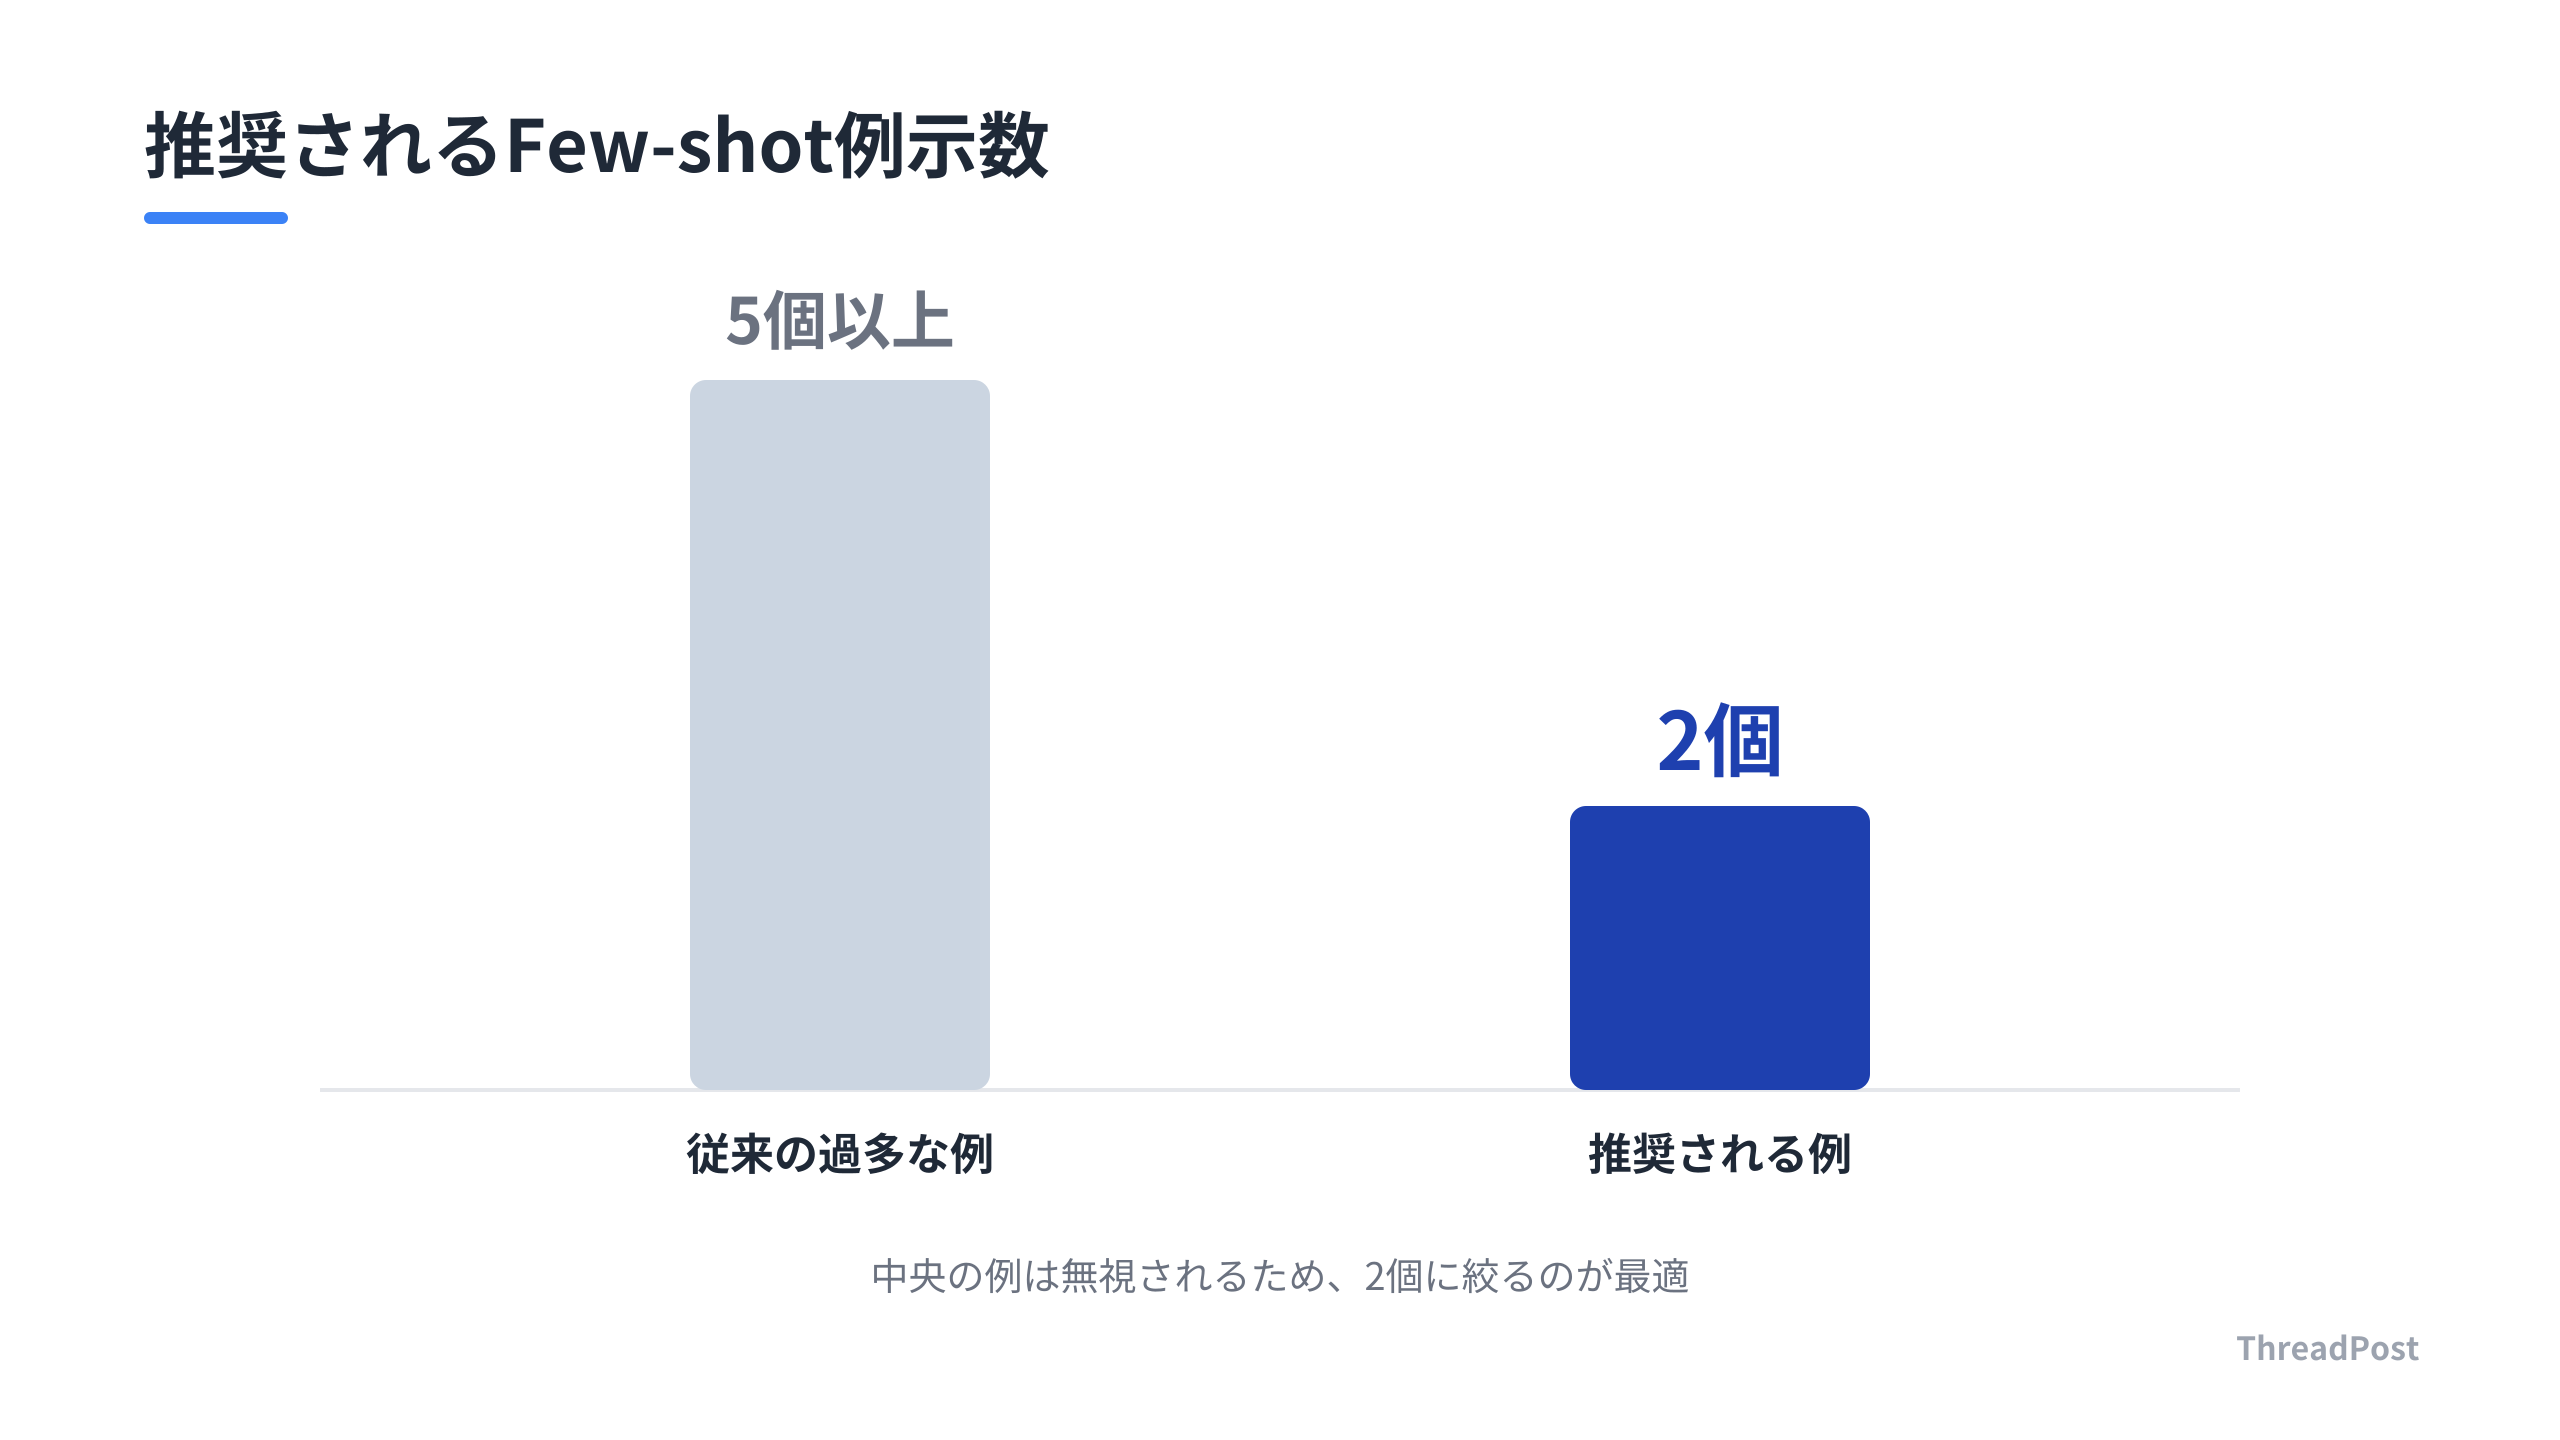
LLMには「直近の情報を強く模倣する」という位置バイアスがある。Few-shotの例を並べると、末尾の1個が結果を支配する。多様なパターンを混ぜるより、末尾に最も反映させたい例を配置するのが鉄則だ。中央の例は無視されやすいため、多くの例を並べる労力は無駄になる。
Few-shotは2個で十分
多くの例を渡しても、中央の例は無視される現象が起きる。3個以上の例は無駄になりやすいため、2個程度に絞り、その分トークンを実際の指示や参考コードに割り当てる。厳選した2個の例を適切に配置する方が、AIの出力は安定する。
KVキャッシュを意識した順序設計
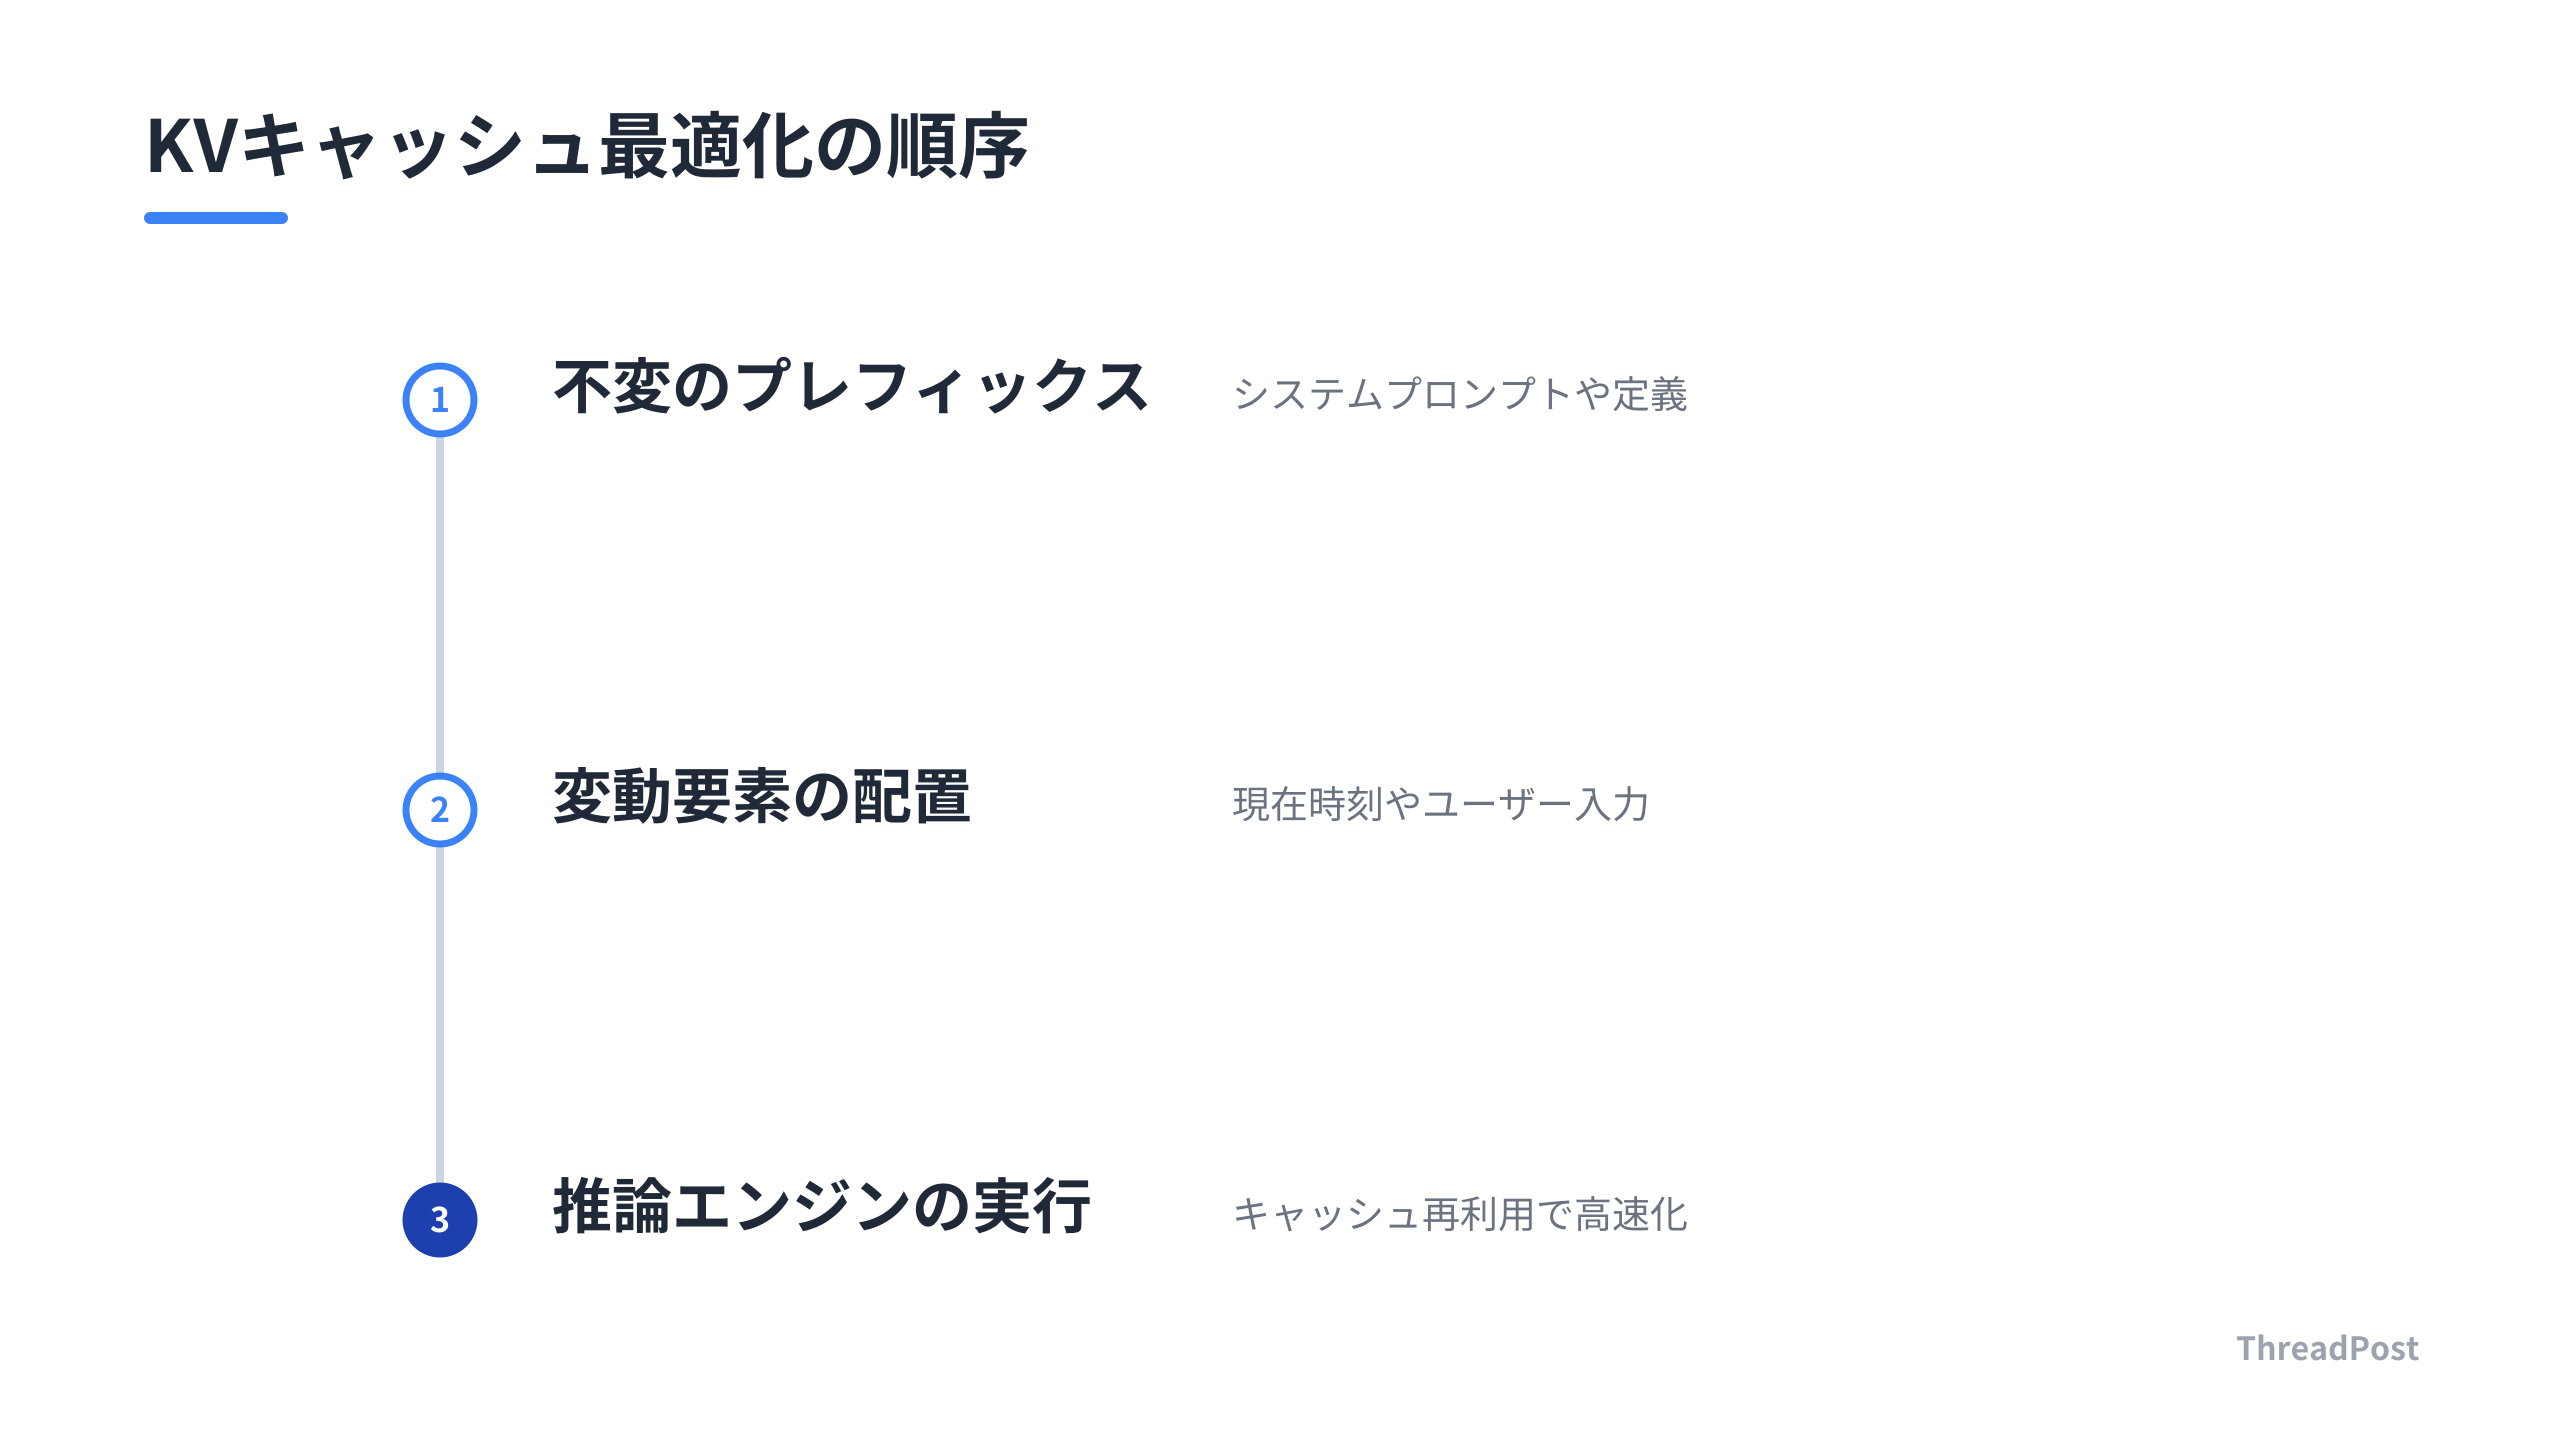
LLMの推論エンジンは「不変のプレフィックス」をキャッシュする。システムプロンプトに現在時刻のような変動要素を入れるとキャッシュが全滅し、速度とコストが悪化する。変動要素は必ず末尾に配置する。推論速度の向上とAPIコストの最適化には、プロンプトの構成順序が重要だ。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
ルールファイルのサイズ上限設定
ルールファイルに上限を設け、溢れたら他所へ退避させる。この1行は毎セッション払う価値があるかという基準で、常に読ませる情報量を最小限に絞り込む。重要な指示の重み付けを明確にすることが、エージェントの挙動を安定させる。
文書より機械による強制
AIにルールを守らせるには、長文の指示よりもシステム的な制限が有効だ。白黒つくルールはコードやバリデーションで強制し、AIには判断が必要な文脈のみを委ねる役割分担を行う。ルール違反を物理的に防ぐ仕組みが、開発効率を高める。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
ルールの失効トリガーを設ける
ルールは放置すると必ず腐る。手順書の末尾に条件に当たったら見直すという失効トリガーを書き込み、運用しながらルール自体を更新し続ける仕組みを構築する。ドキュメントの陳腐化を防ぐ習慣が、長期的な開発を支える。
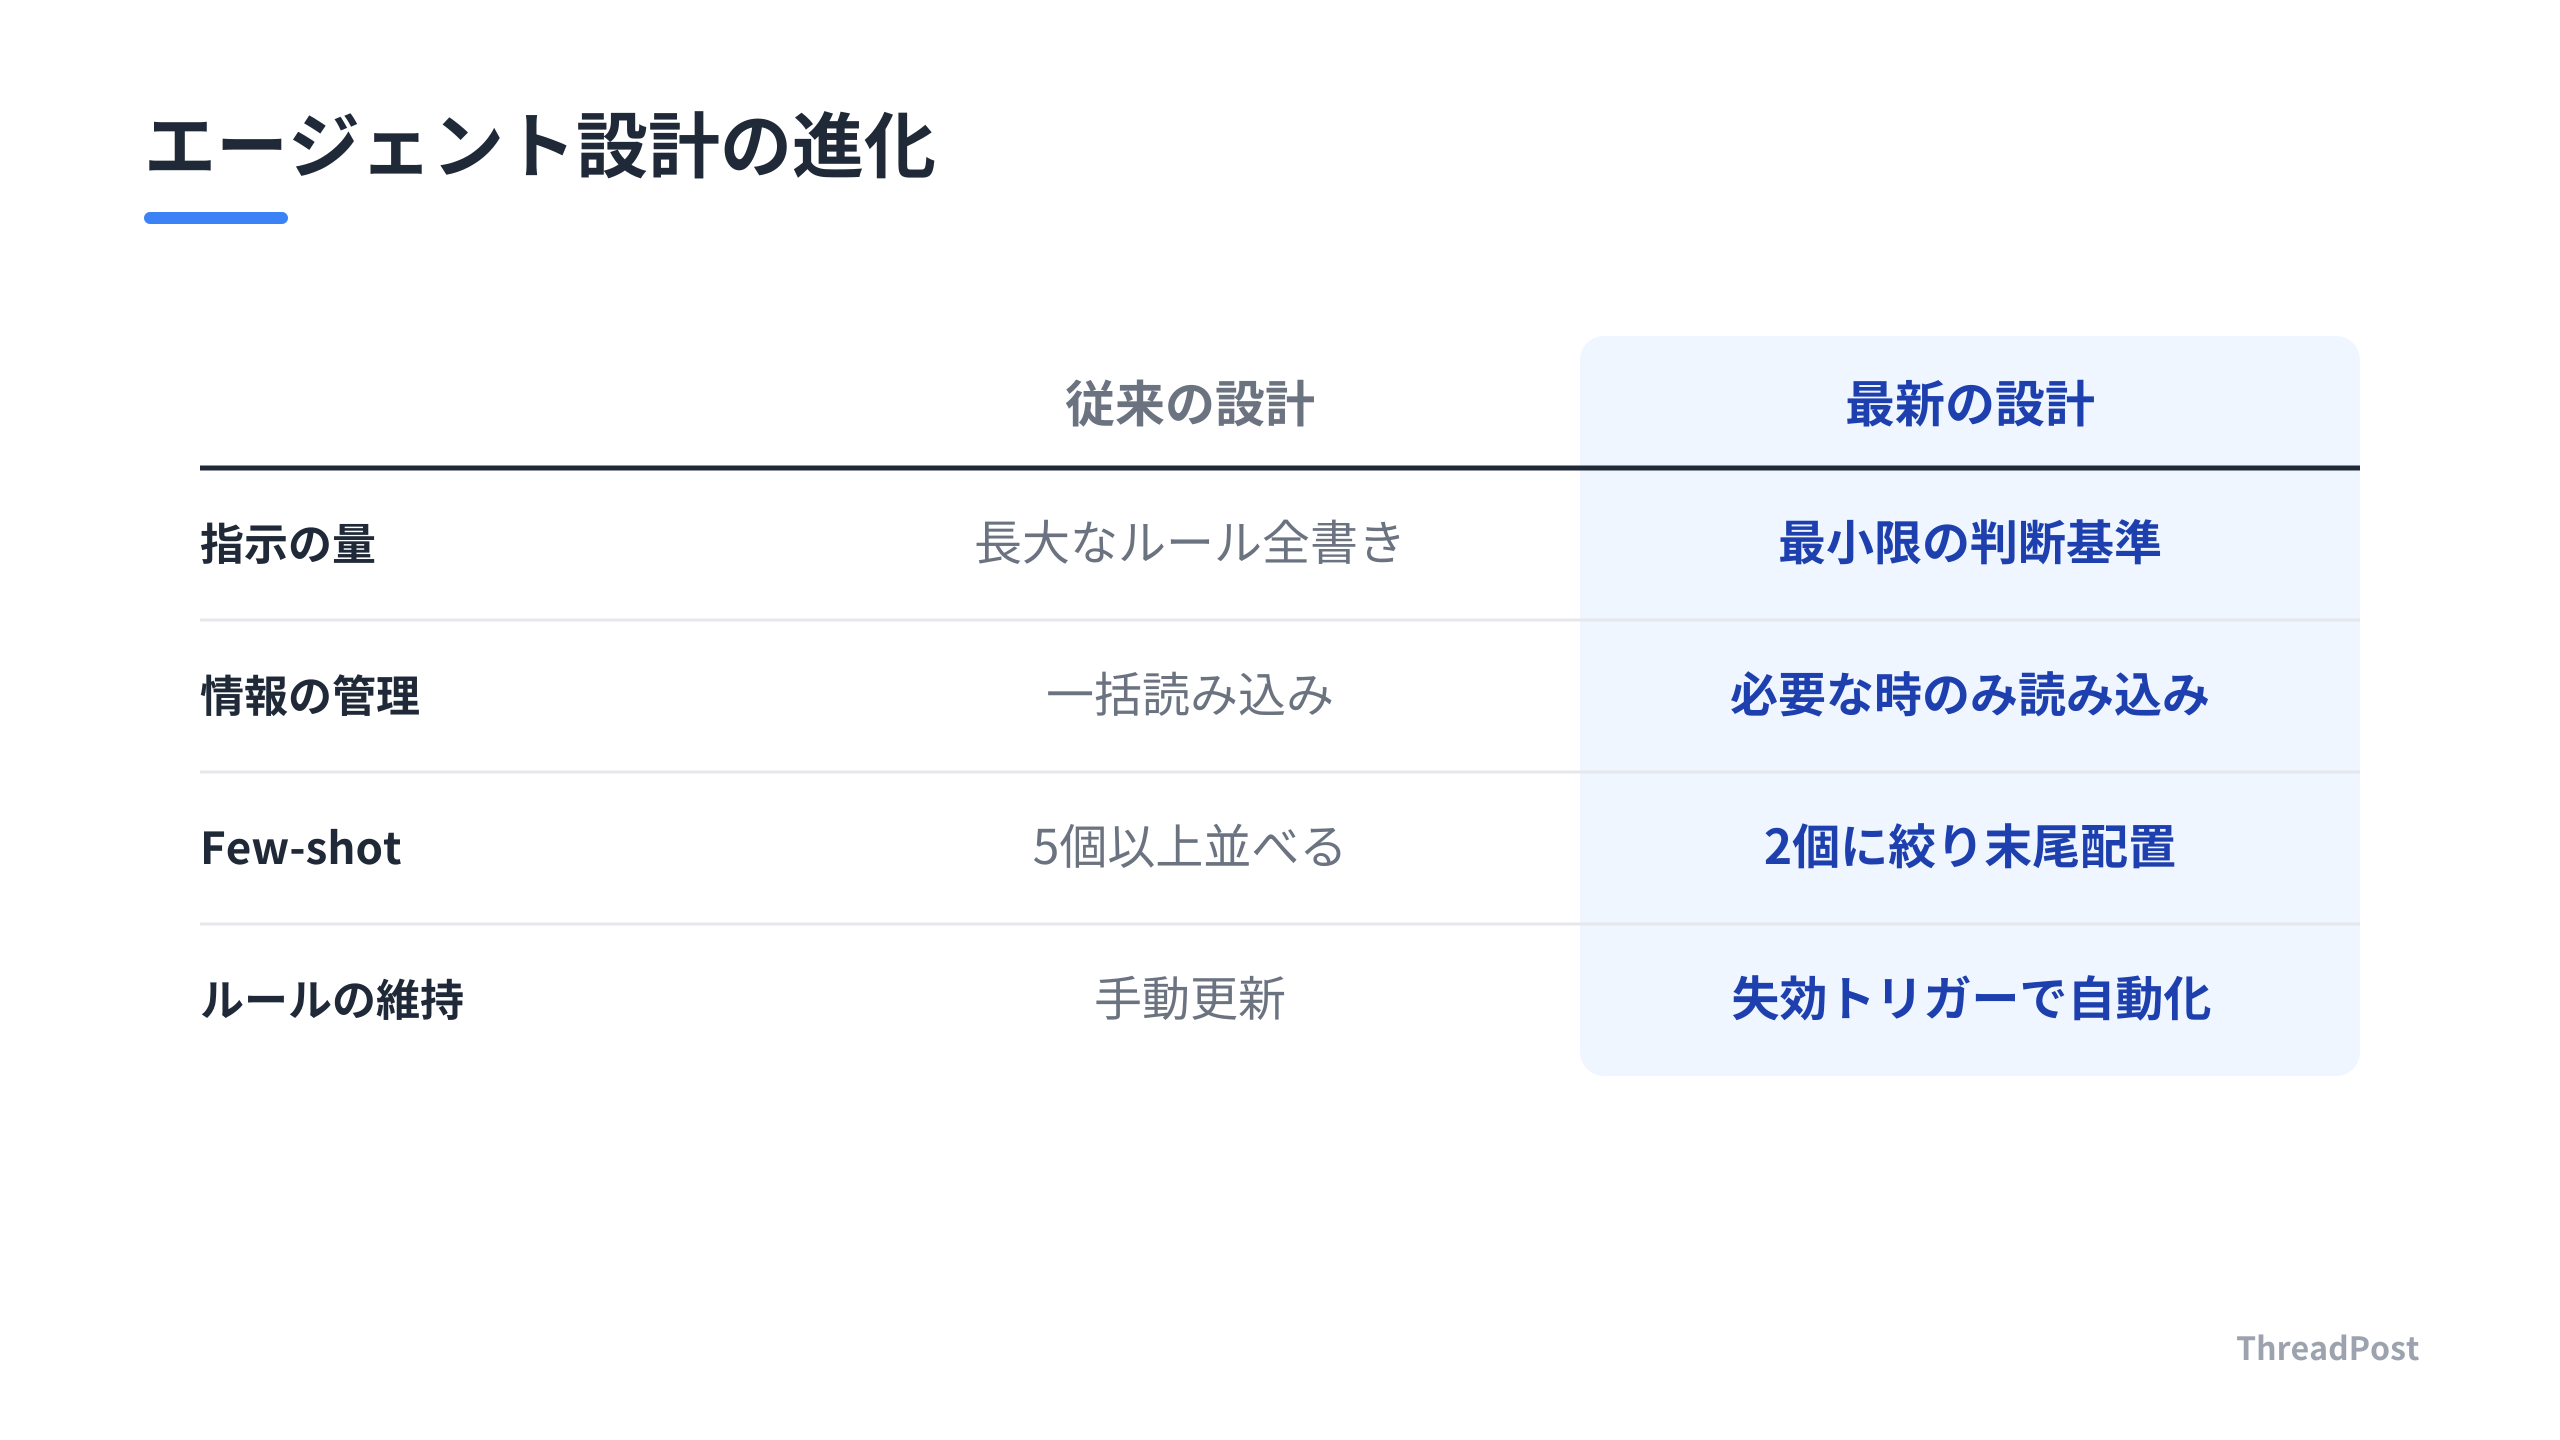
| 項目 | 従来の設計 | 最新の設計 |
|---|---|---|
| 指示の量 | 長大なルール全書き | 最小限の判断基準 |
| 情報の管理 | 一括読み込み | 必要な時のみ読み込み |
| 例示(Few-shot) | 5個以上並べる | 2個に絞り末尾配置 |
| ルールの維持 | 手動更新 | 失効トリガーによる自動棚卸し |
しんたろー:
Claude Codeでコードを書く際、コンテキストの整理は重要だ。以前はルールファイルに何でも書いていたが、今は「今すぐ必要な情報か」を基準にファイルを分割している。これだけでAIの迷いが減り、コーディングの速度が向上する。
Few-shotの順序も重要だ。末尾の例が結果を支配する事実は大きい。順序を工夫するだけで、プロンプトを長くしなくてもAIの口調や形式を制御できる。
FAQ
Q1: AIが指示を無視するのはプロンプトが弱いからか
A1: 必ずしもそうではない。多くの場合はコンテキストの過負荷が原因だ。人間と同じでAIも一度に大量の情報を渡されると、重要な指示がノイズに埋もれてしまう。指示を強くするのではなく、不要な情報を削除し、重要な指示を末尾に配置するなどの情報の整理を優先する。
Q2: Few-shotの例は何個渡すのがベストか
A2: 結論から言うと2個で十分だ。5個以上渡しても、AIは末尾の1個しか重視しない位置バイアスの影響を強く受ける。多様なパターンを教えたい場合は、それらを混ぜた合成例を1つ作成し、それを末尾に配置するのが最も効率的で確実な制御方法だ。
Q3: KVキャッシュを意識したプロンプトとは何か
A3: 変わらない情報を先頭に、変わる情報を末尾に配置するプロンプトのことだ。システムプロンプトやツール定義などの固定情報は先頭に置き、時刻やユーザーの入力など毎ターン変わる情報は末尾に置くことで、推論エンジンがキャッシュを再利用でき、応答速度とコストが改善される。
Q4: ルールファイルが長くなってきたらどうすべきか
A4: まずは全セッションで読むべきかを自問し、不要なものを削除する。それでも長い場合は、機能や作業単位でファイルを分割し、必要な時だけ読み込むスキル形式に移行する。また、機械的に強制できるルールはコード側に移すことで、プロンプトの負荷を下げられる。
Q5: AIエージェント開発で一番重要なスキルは何か
A5: 情報の構造化能力だ。AIに何を渡すかだけでなく、どの順番で、どの単位で渡せばAIが最も判断しやすいかを設計する力が求められる。プロンプトエンジニアリングは呪文を唱えることから、AIの視界を整理するエンジニアリングへと進化している。
まとめ
AIエージェントの精度向上には、情報を詰め込むのではなく、いかにAIの視界を整理するかが重要だ。ルールを減らし、必要な情報を適切なタイミングで渡す設計を心がける。まずはルールファイルのダイエットから始めて、AIの反応の変化を確認する。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
