


Claude Codeのコードレビュー機能に「深さ」設定が追加されました。Deepを選択すると、精度の向上ではなく指摘コストの増大を招きます。AIの自動化でチームのレビュー負荷が増加するケースが散見されます。
この記事では、AIの深さ設定を運用コストの制御として捉え直す方法を解説します。開発現場で直面するAIの忘却やモデルごとの出力の癖を制御し、堅牢な自動化ワークフローを構築します。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
AI自動化の「深さ」と「外部知識」を巡るアップデート
Claude Codeのバージョンv2.1.304で、レビューの深さ設定(Quick / Standard / Deep)が導入されました。開発者はリポジトリやタスクの重要度に応じて、AIが差分と周辺コードを読み込む徹底度を調整可能です。
ドキュメント上の定義では、深さは徹底度(thoroughness)のつまみであり、深いほどコストと時間がかかります。GitHubのマネージドなレビュー環境では偽陽性が排除されますが、ローカル実行時は深さを増すほど確度の低い指摘まで拾い上げます。
しんたろー:
全部DeepにするとGitHubの通知欄がAIの指摘で埋め尽くされます。生成コストは低くても、人間が読む脳のメモリと時間は有限です。
AIの忘却問題に対しては、外部ナレッジベース(KB)の活用が進んでいます。Claude Codeはセッションが切れると文脈をリセットするため、Notionなどの外部ツールを「外部脳」として構築し、Pythonスクリプトでローカルと同期させる手法が実践されています。
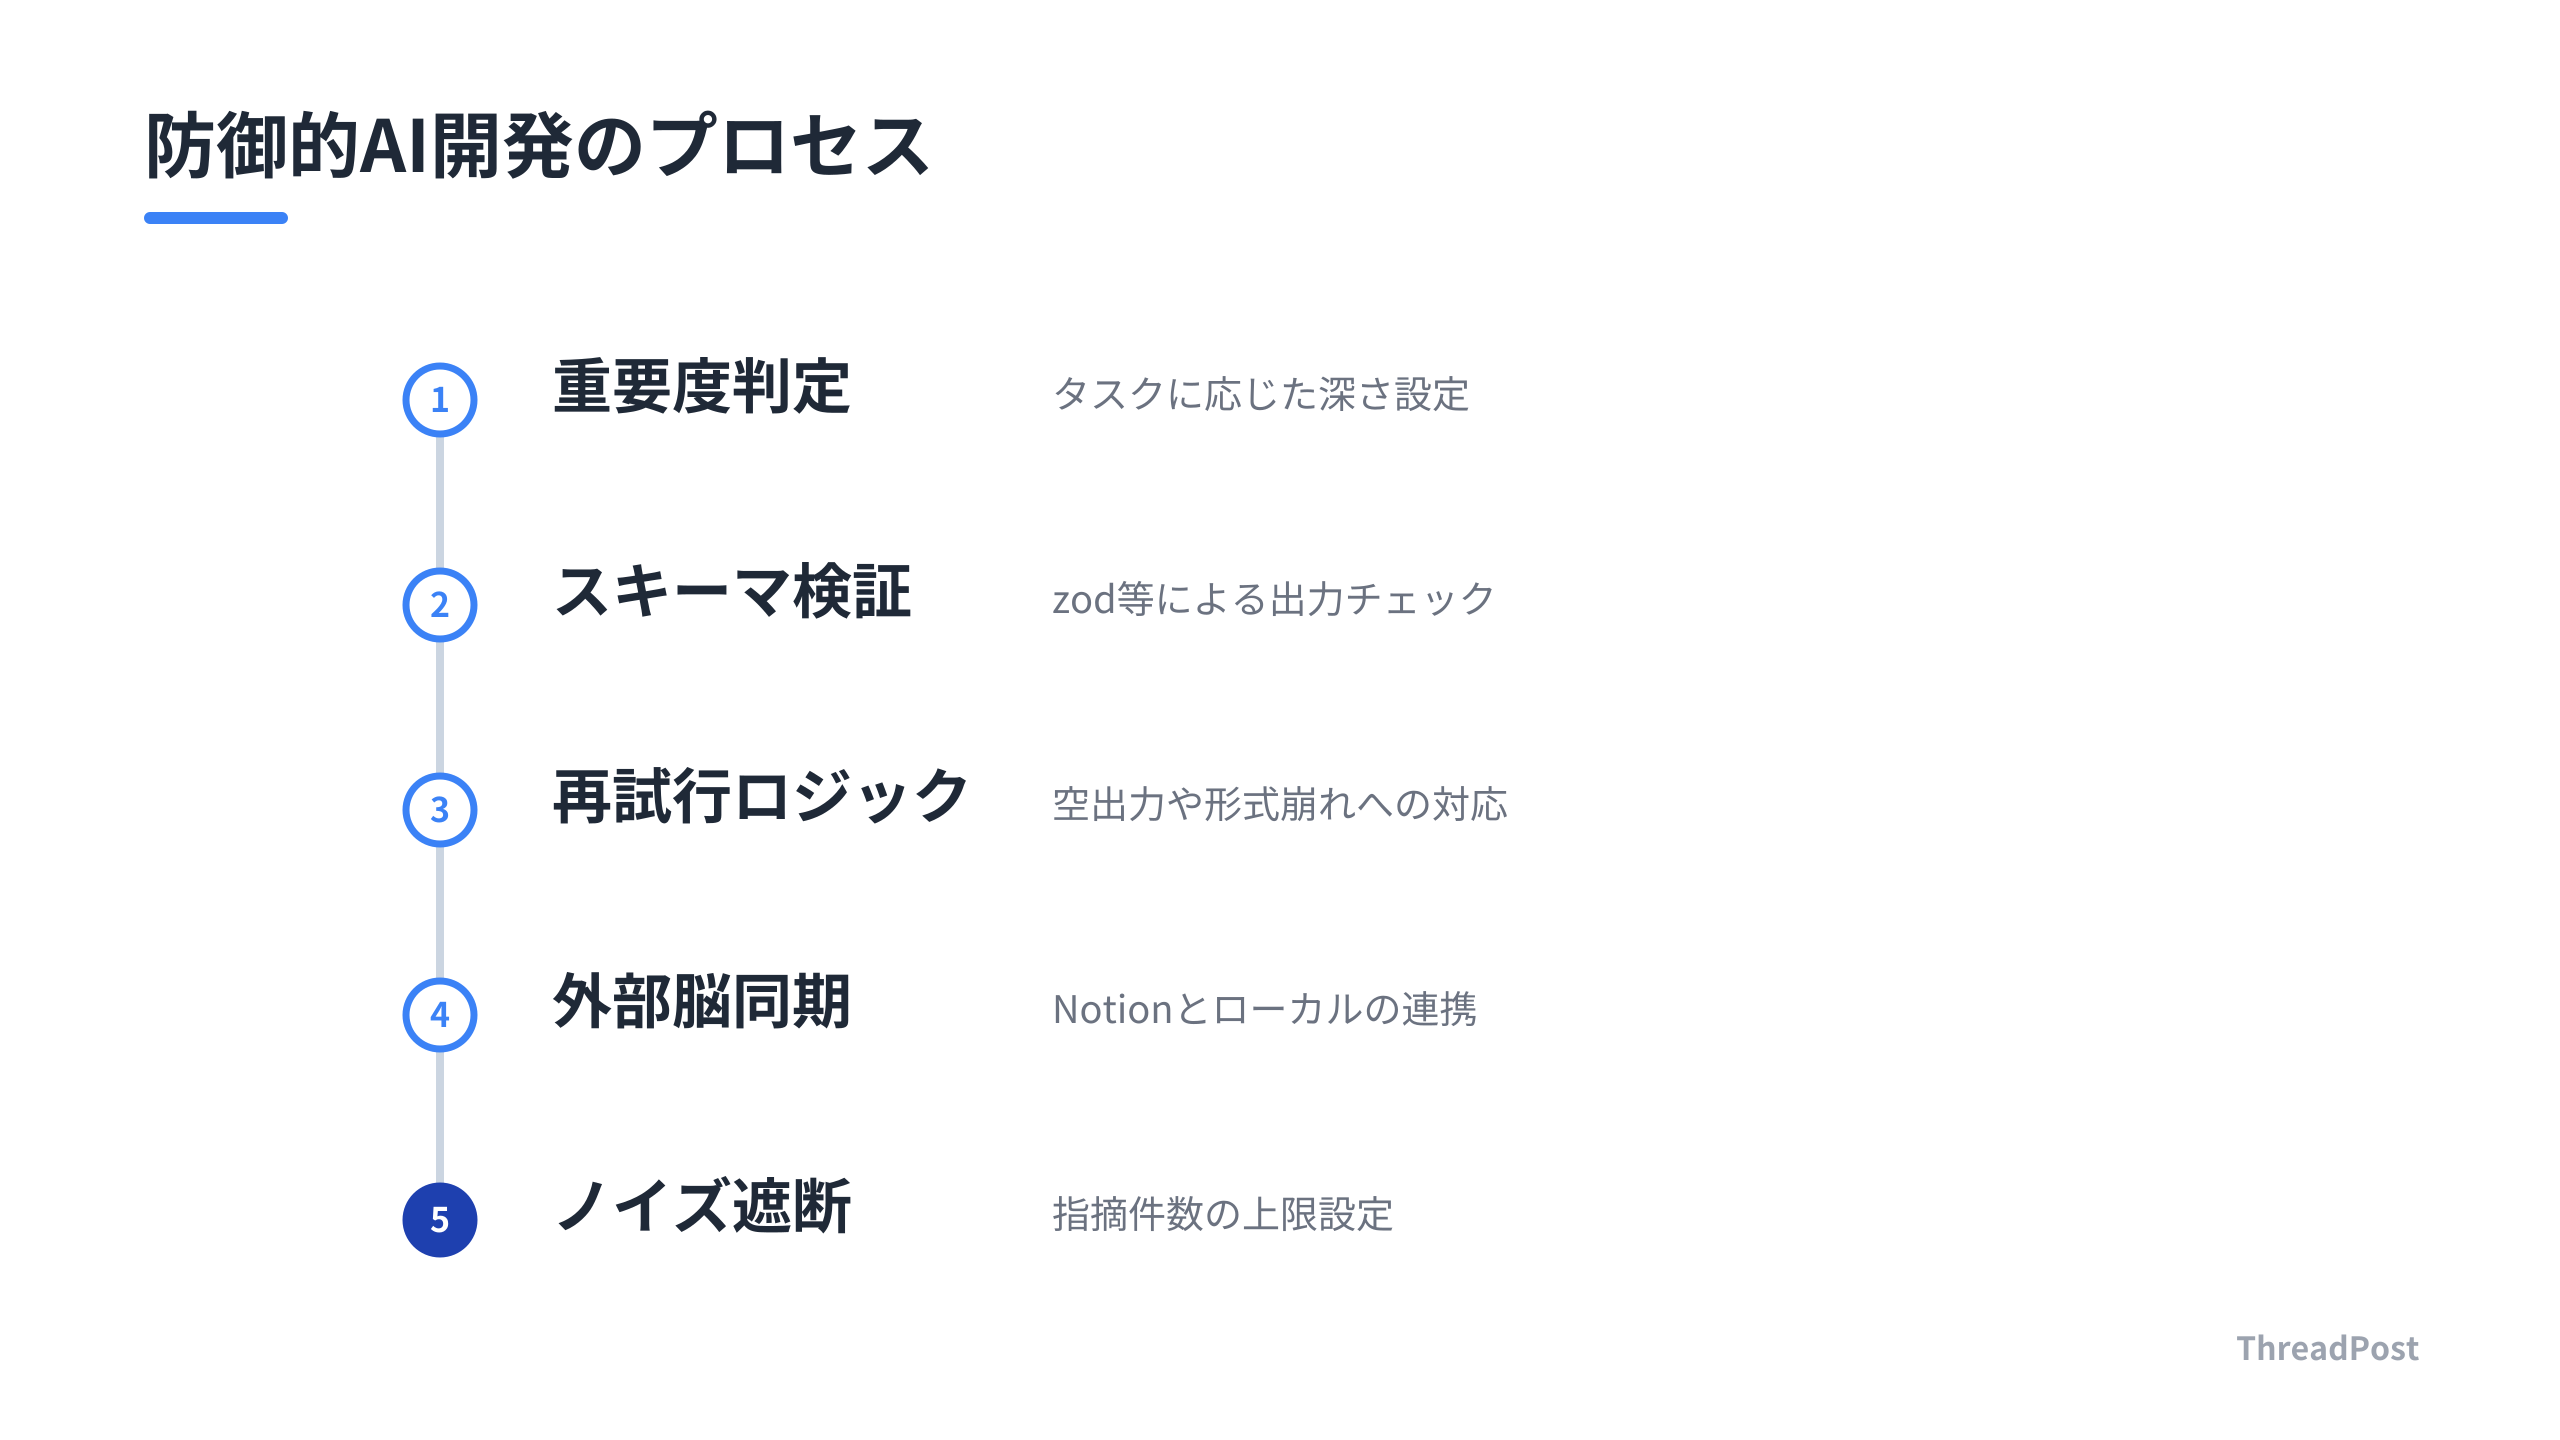
国内で完結するAI利用環境として、さくらのAI EngineのようにAnthropic互換APIを提供する環境も整いました。gpt-oss-120bやQwen3.6といったモデルは、メッセージのやり取りは互換でも、構造化出力(JSONスキーマ)の挙動は異なります。zod等を用いたスキーマ検証や、出力が空の場合の再試行ロジックを実装する防御的AI開発が不可欠です。
 あわせて読みたいClaude Codeの使い方完全ガイド|インストールから実践まで2年運用の開発者が解説 →
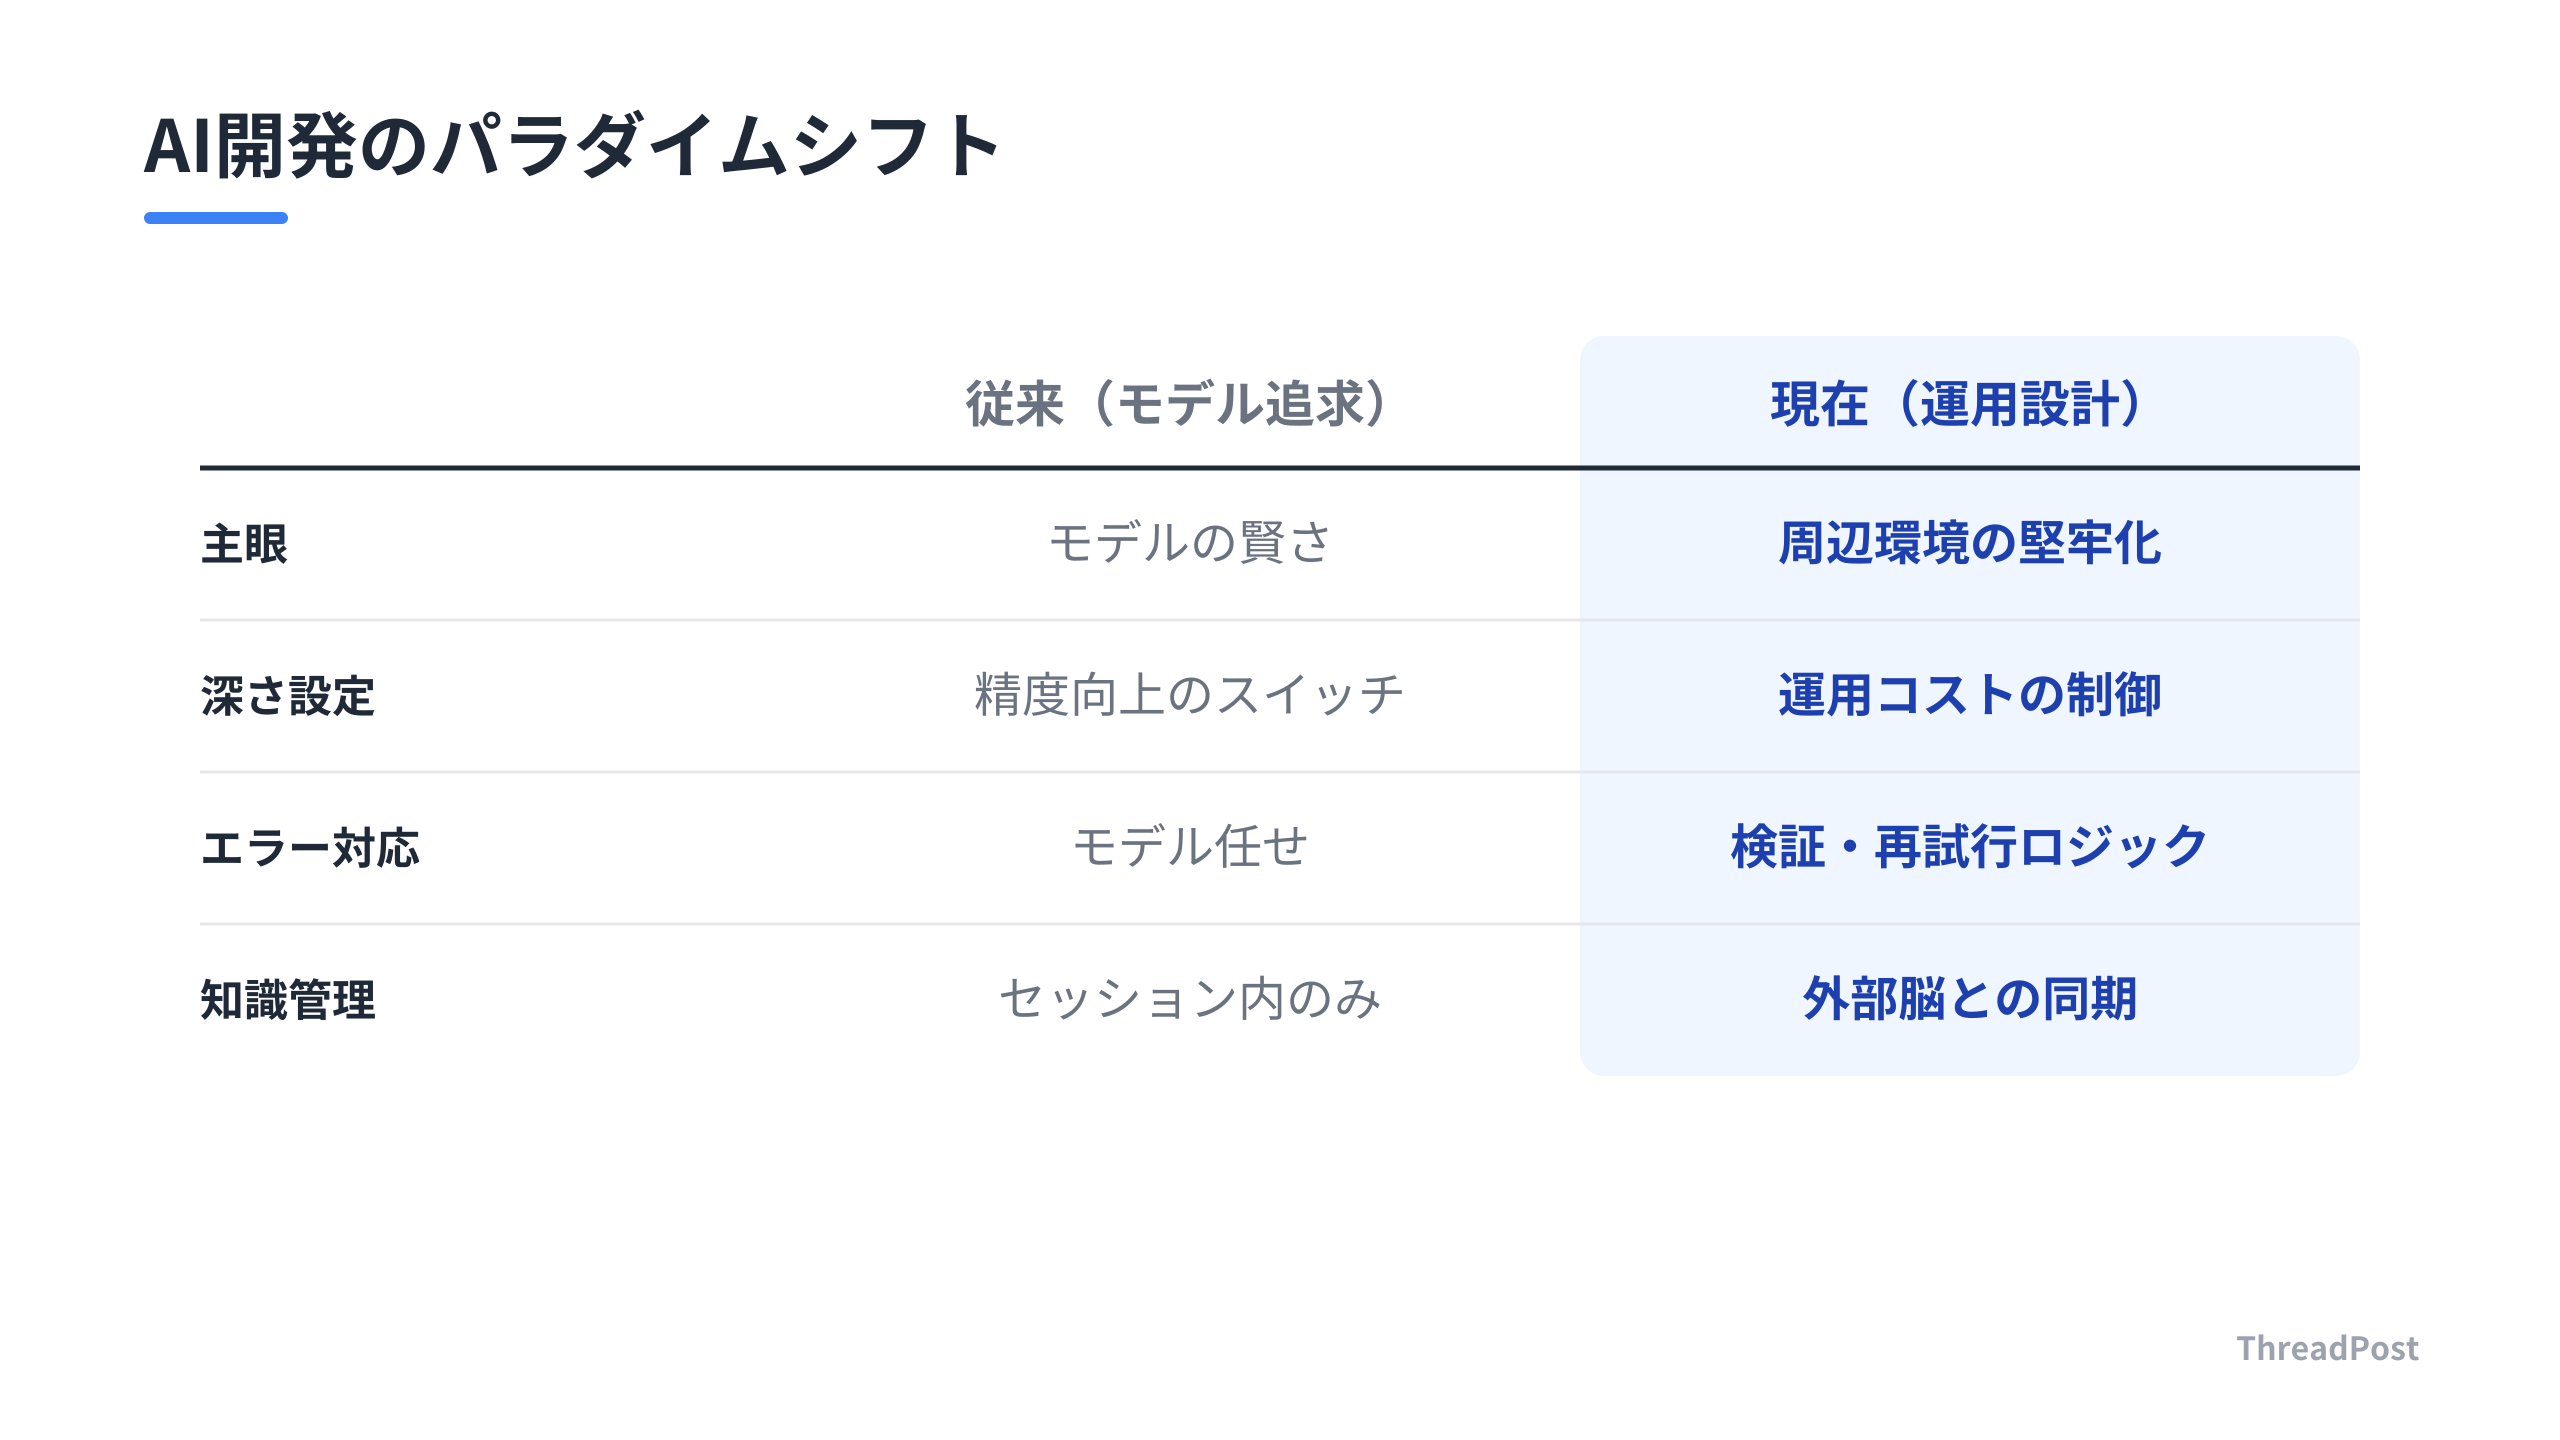
AI開発の本質は「モデルの選定」から「運用設計」へ
AIの深さやモデルというパラメータは、単なる精度向上のスイッチではなく、システム全体の運用設計そのものです。深さを最大に設定すると、開発者が捌ききれないほどの確度の低い指摘が押し寄せます。
ローカルのコードレビューを深さのつまみで制御し、組織の重要なリポジトリにはクラウドの検証ロジックを当てます。重い検査は本当に必要な箇所にだけ寄せるアプローチが有効です。
AIに全部任せると、結局レビューの山に埋もれて自分が一番キツくなります。チームが捌ける指摘の限界値を見極めるのがエンジニアリングです。
Anthropic互換APIの普及でgpt-oss-120bやQwen3.6も選択肢に入りました。しかし、構造化出力の厳密さはモデルごとに異なります。Claudeならプロンプトで守れるルールも、他モデルでは無視されるケースがあります。
出力が空だったり形式が崩れたりする事態を防ぐため、zodのようなライブラリで機械的な検査を挟みます。AI開発の主戦場はモデルの賢さから、出力をどう検証し、どう再試行させ、どう知識として永続化させるかという周辺環境の堅牢化に移っています。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
AI自動化を「導入」から「運用」へ昇華させるために
AIの自動化設定をとりあえず最高レベルにするのは、ノイズ生成機を動かすのと同義です。以下のアクションが開発現場の定着を左右します。
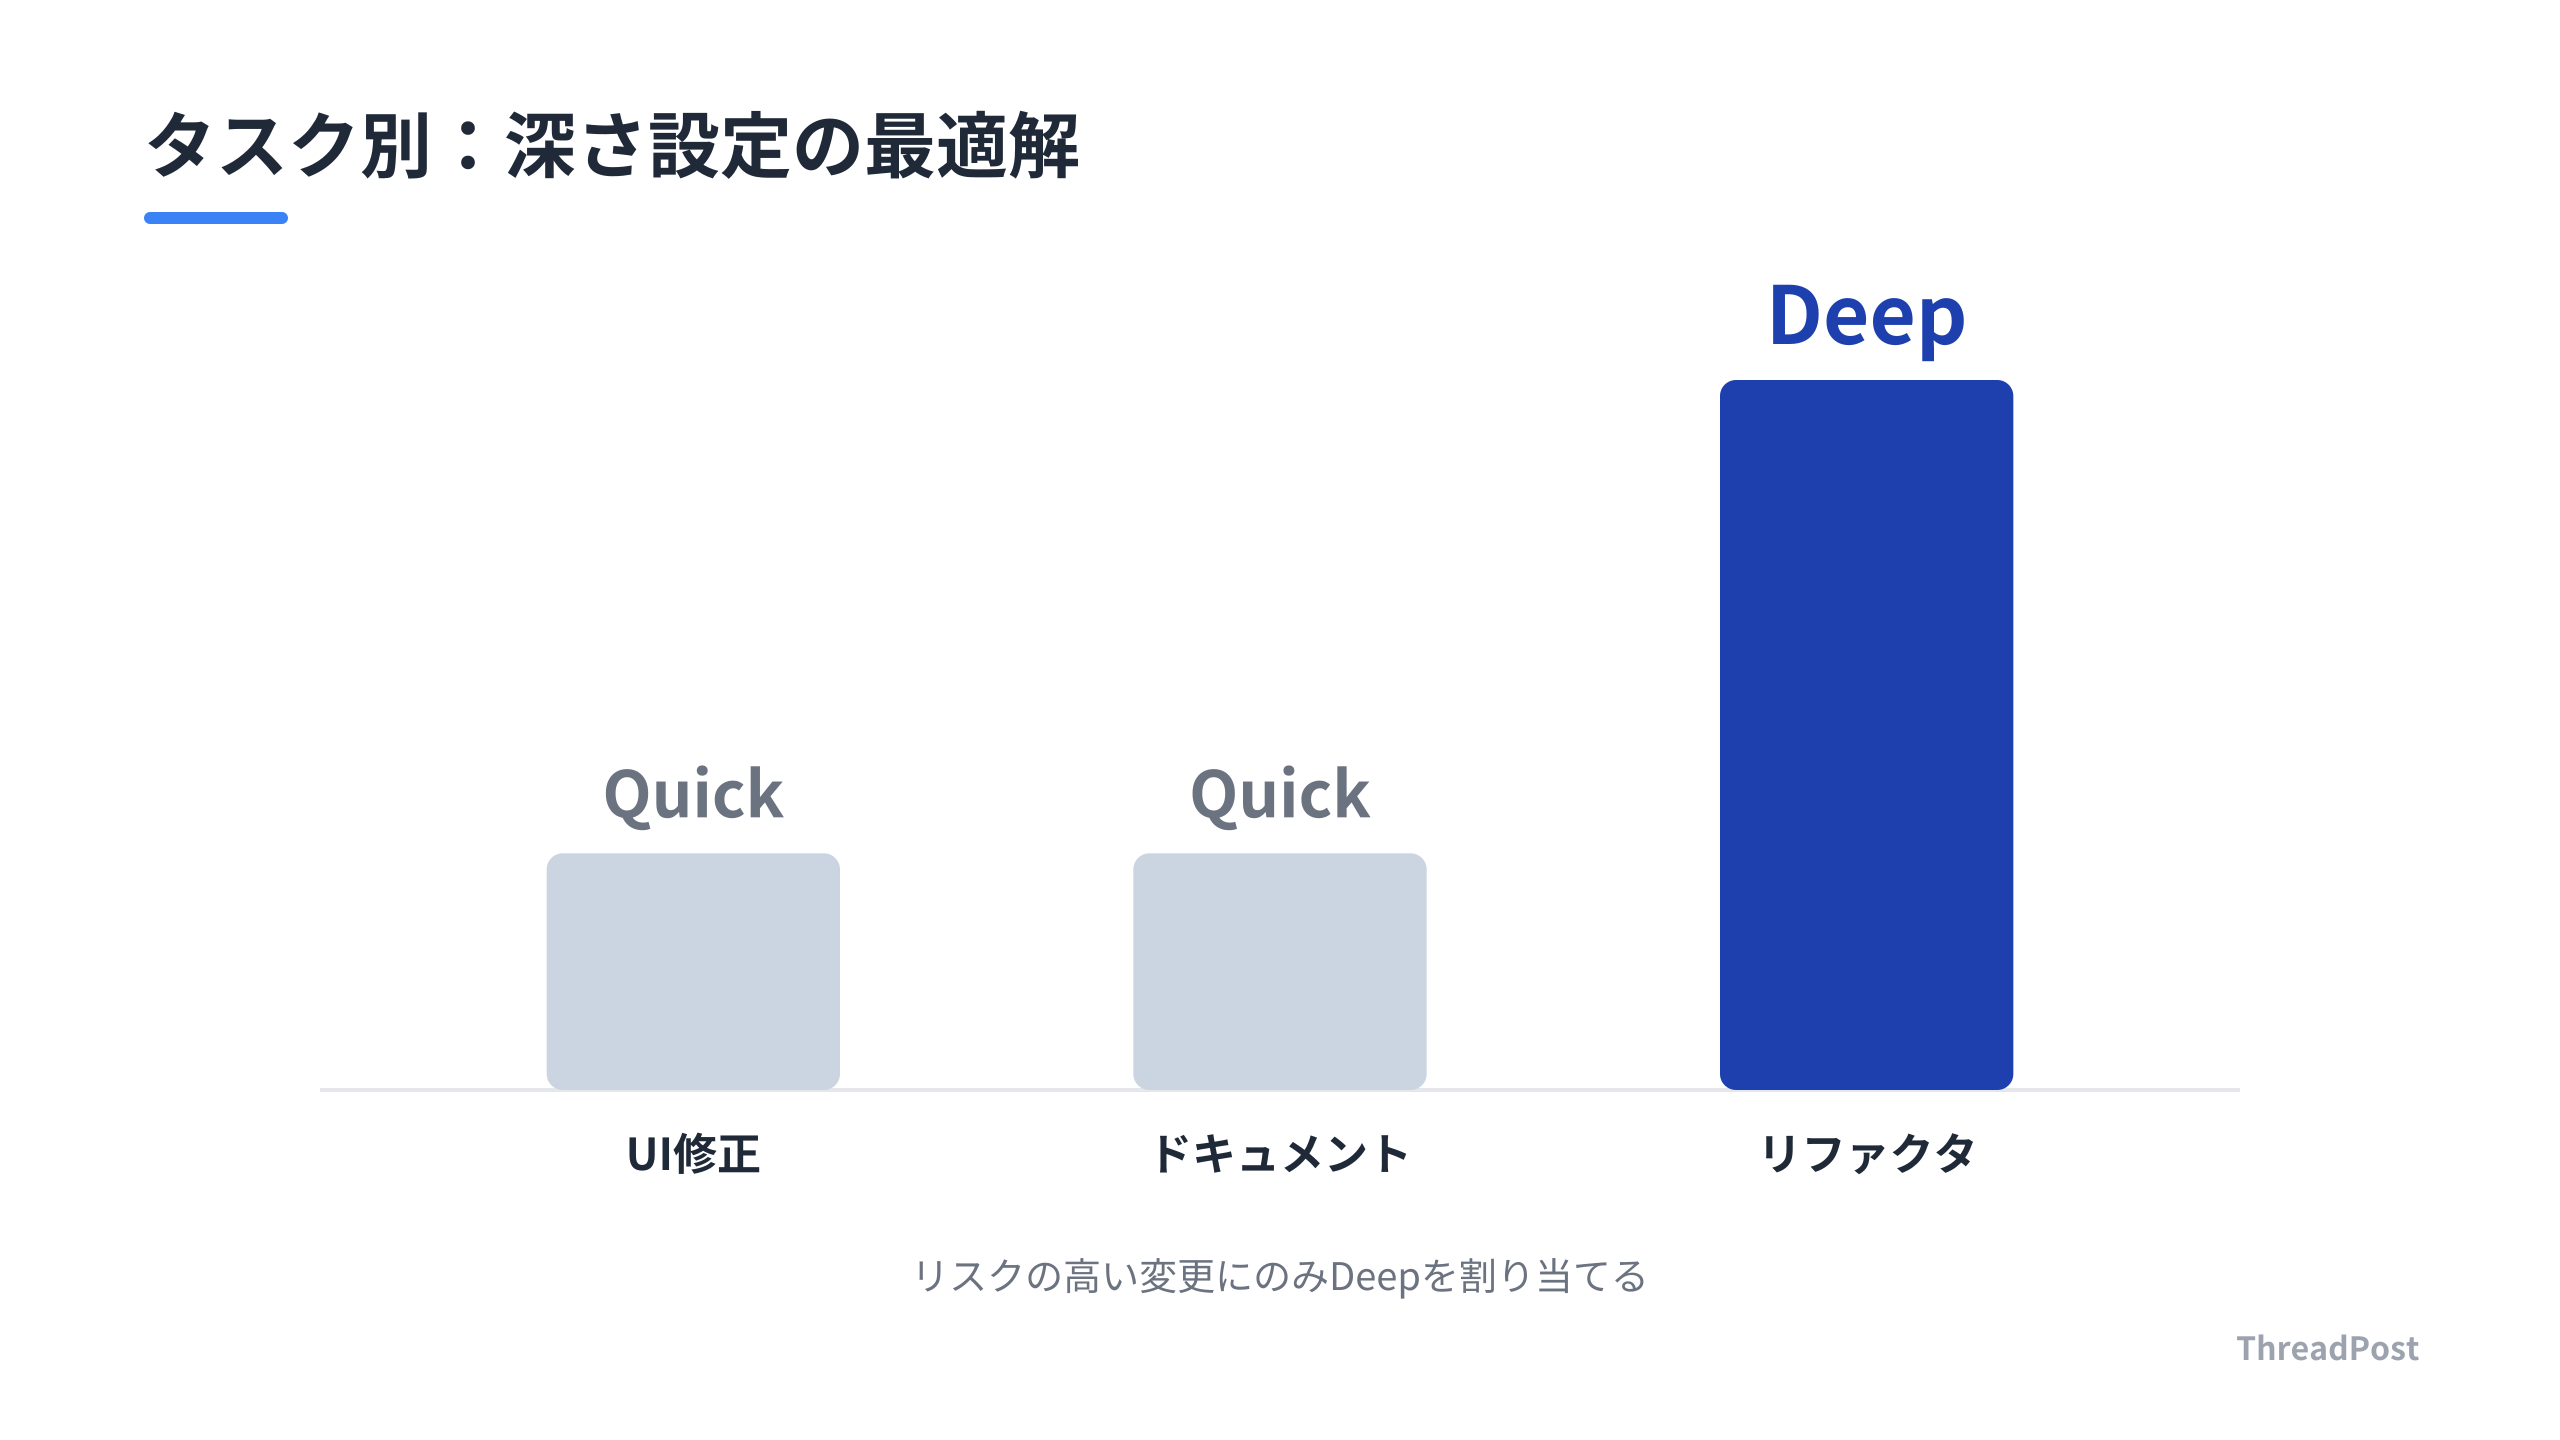
深さの調整をタスクの重要度と同期させます。リファクタリングのようなリスクの高い変更にはDeepを割り当て、軽微なUI修正ならQuickを選びます。
AIの出力を信頼せず、検証するパイプラインを構築します。Anthropic以外のAPIを併用する場合、JSONスキーマによるチェックに加え、再試行ロジックを噛ませます。
Claude Codeで生成したコードをそのまま流し込んだらエラーで止まりました。zodでスキーマチェックを厳格化するコードを先に書くのが鉄則です。
外部脳との同期プロセスを自動化します。スマホでメモした内容をスクリプトでローカルのMarkdownに同期し、Claude Codeがそれを参照できる状態を維持します。
指摘件数の上限設定(--max-findings)を忘れません。一度に大量の指摘を受けても人間は上から数件しか見ないため、AI側で優先順位をつけさせ、上位数件だけを確実に処理します。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
Q1: AIのレビュー設定を「Deep」にすれば見逃しは減りますか?
必ずしも減りません。深さを増すと確度の低い指摘(偽陽性)も増えるためです。見逃しを減らすには、深さを上げるのではなく、指摘の件数制限(--max-findings)を併用し、特定のルールに絞った検証ロジックを組み合わせます。
Q2: Claude Codeがセッションごとに情報を忘れて困っています。
セッションの枠を超えた外部脳の構築が有効です。スマホ等で収集した情報をNotionに蓄積し、ローカルの同期スクリプトを介してClaude Codeが参照する設計にします。AIに記憶を求めるのではなく、外部ストレージと同期させる仕組みを作ります。
Q3: Anthropic互換APIなら、どのモデルでも同じコードで動きますか?
いいえ。メッセージのやり取りは互換でも、構造化出力の挙動はモデルやAPI基盤で異なります。スキーマの厳格化や、出力が空の場合の再試行ロジックなど、モデルごとの補完的な検証層を実装することが本番運用の鍵です。
まとめ
AI開発の主戦場は、モデルの賢さから周辺環境の堅牢化へと移っています。深さの設定やモデルの切り替えは、チームのレビュー負荷やシステムの安定性を左右する運用設計です。
検証層を自前で構築し、AIの出力を制御します。こうした防御的なワークフローが、自動化を実験から実務へ昇華させます。Claude Codeを自分専用の堅牢な開発基盤へと育て上げます。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
