


プロンプトの1行を書き直した直後、別のテストで新しい不具合が出た。修正を繰り返すほど挙動がブレる。プロンプトの微調整は「もぐらたたき」の沼に過ぎない。
投資すべきは指示文のこねくり回しではない。
Claude Codeでの開発において、重要なのはプロンプトの修正ではない。LangGraphで処理フローを構造化し、MLflowなどの実行ログから正解データを蓄積する。プロンプト調整をやめ、AIエージェントの精度をシステム側で改善していくワークフロー構築の最適解を紐解く。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
AIエージェント開発における「工程分業」の終焉と新たな標準
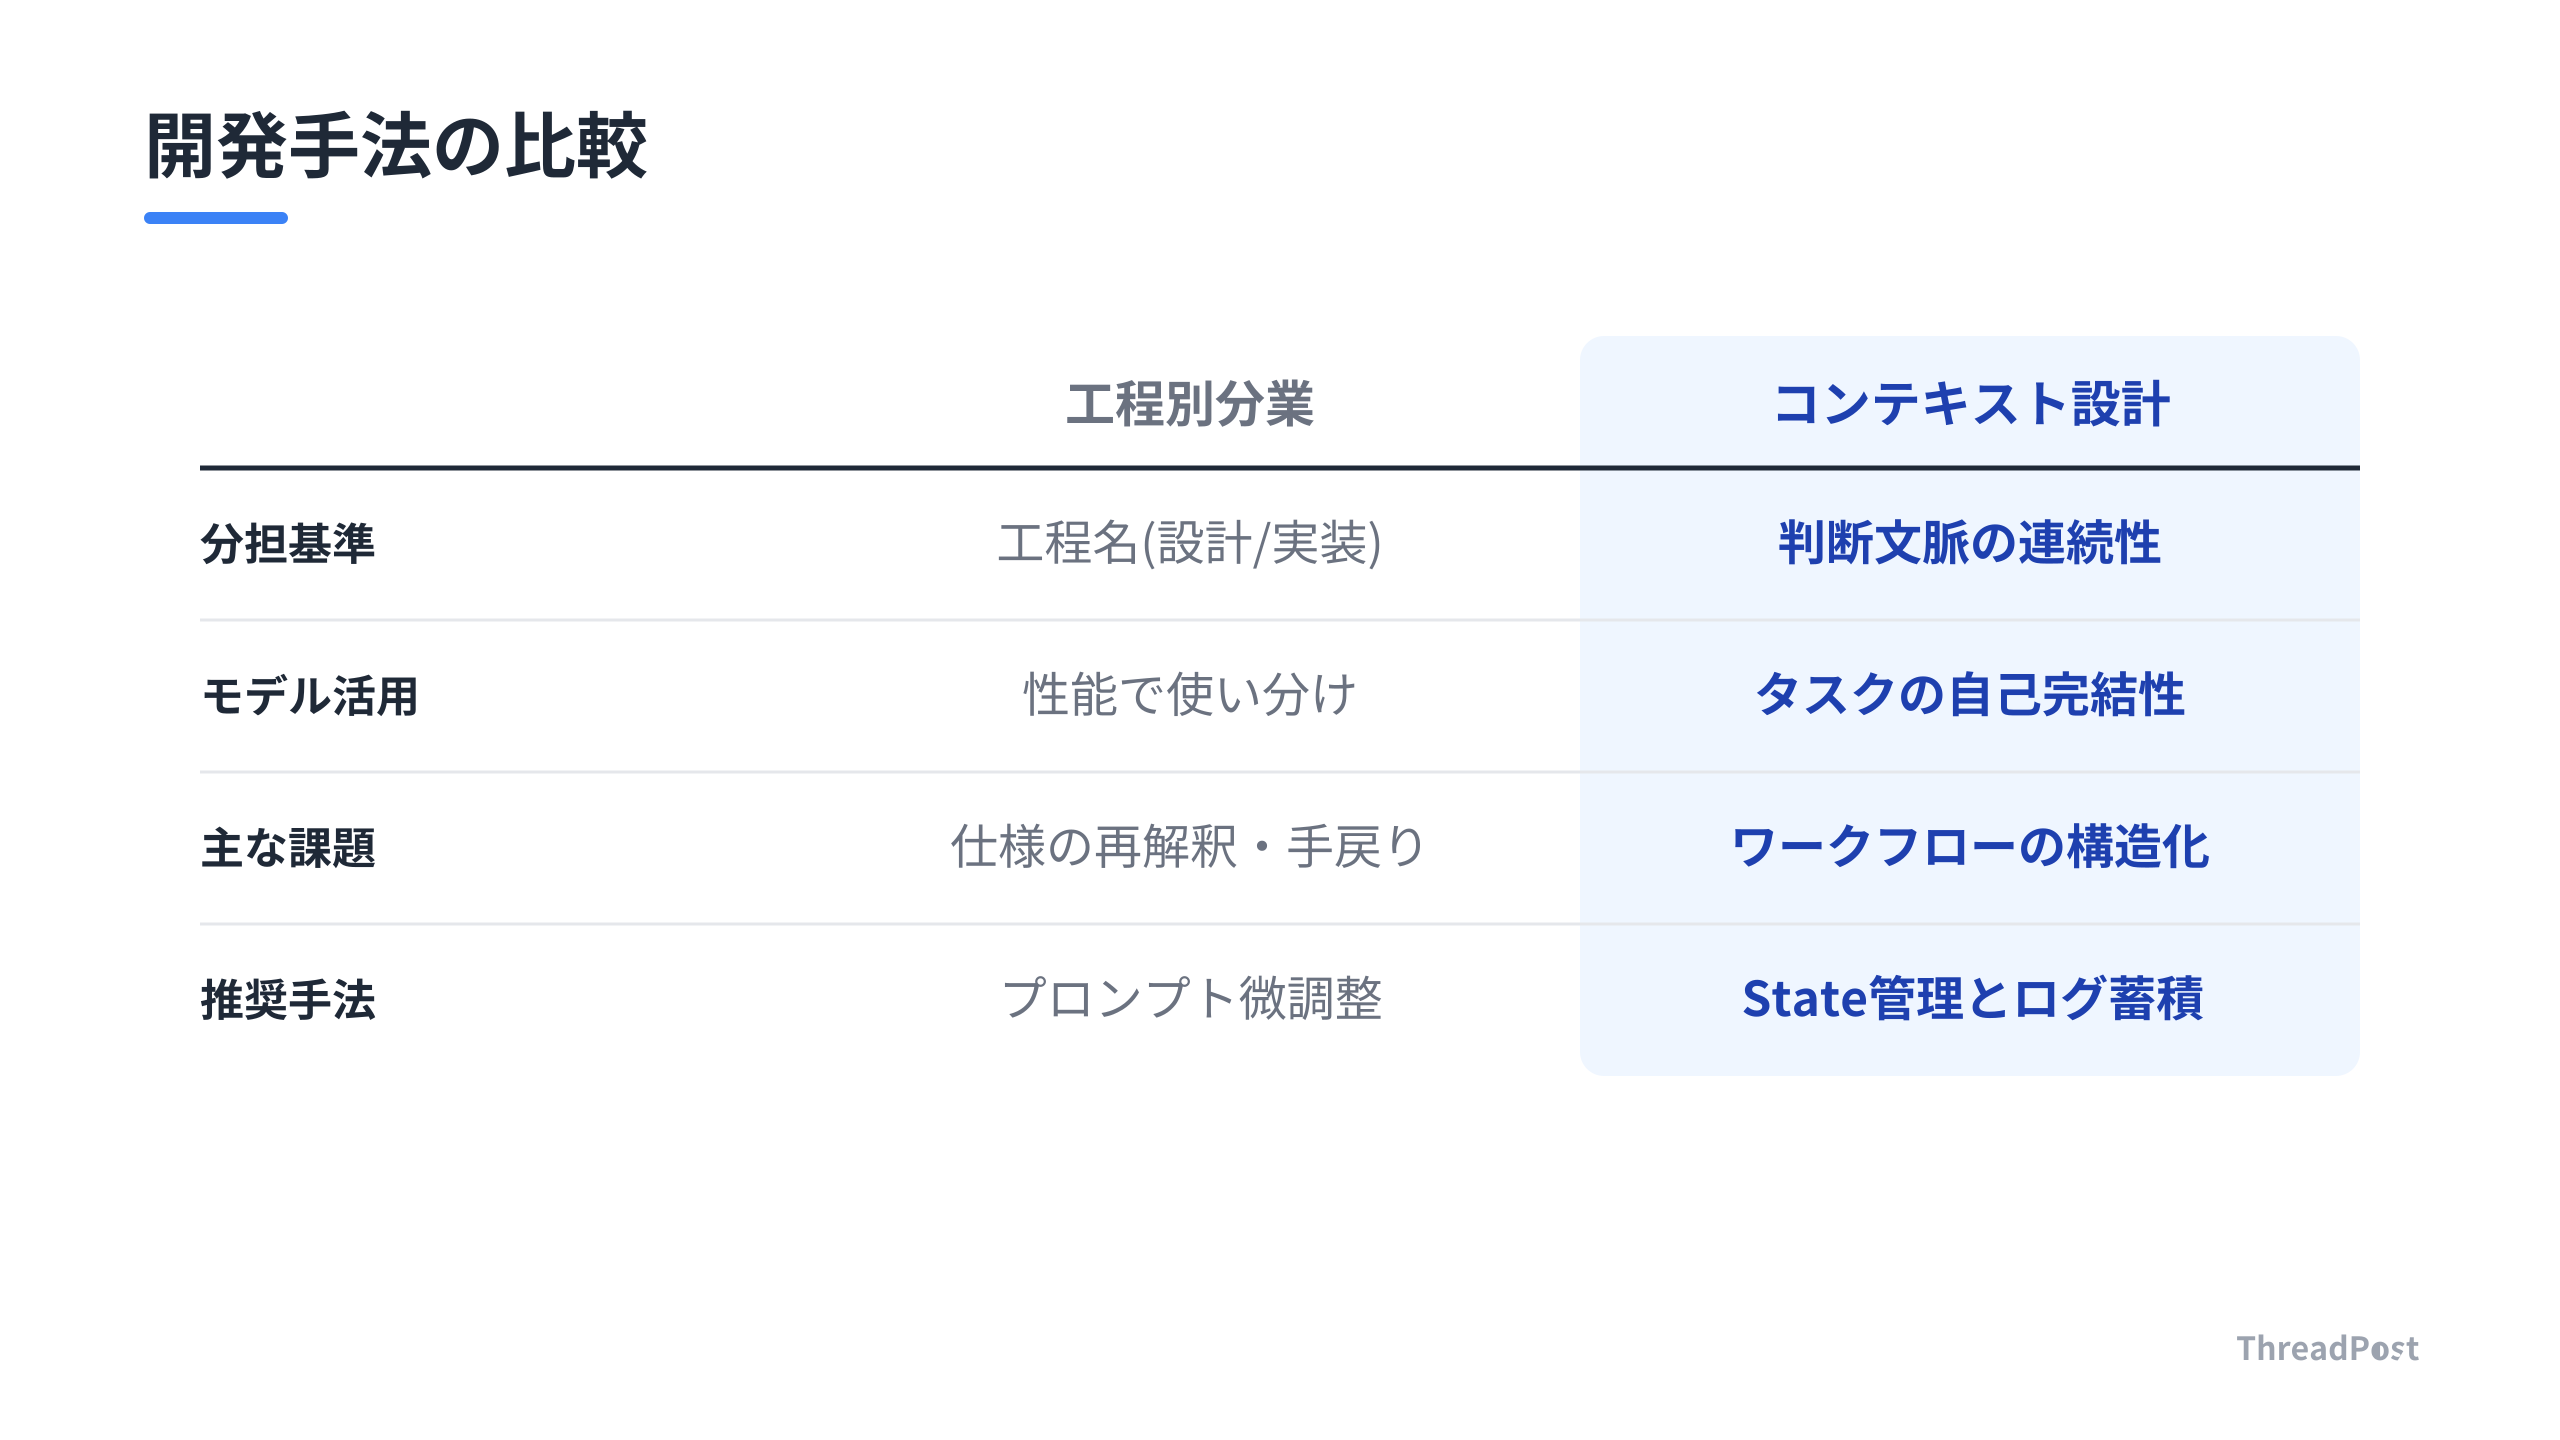
AIを使った開発では、「高性能なモデルが設計し、安価なモデルが実装する」という工程ごとの役割分担が合理的とされてきた。しかし、この従来の「工程別分業」に対する見直しが進んでいる。
最新のAIコーディングツールにおける共通認識は、「工程名で分ける」のではなく「判断文脈(コンテキスト)を維持できるか」で切り分けるという考え方だ。
計画から実装、テストまでの工程が密接に絡み合う作業では、メインのAIエージェントが同じコンテキストを保持し続ける構成が採用される。一方で、調査やログ解析のように、作業結果を短い要約として戻せるタスクだけをサブエージェントへ隔離する手法が標準化している。
1つの大きな変更を独立した作業に切り分ける場合、5から30個の隔離環境(worktree)へタスクを割り振るアプローチが用いられる。コードの書き込み競合を避けつつ、自己完結した成果物として統合する運用が現実的だ。
しんたろー:
プロンプトをどれだけいじっても「1つ直したら別の場所が壊れる」問題に悩まされる。工程ごとにモデルを切り替えて伝言ゲームさせるより、文脈を維持したままログを取る方に舵を切るほうが開発のストレスは減ると思う。
プロンプトを手動で微調整する「もぐらたたき」からの脱却も加速している。
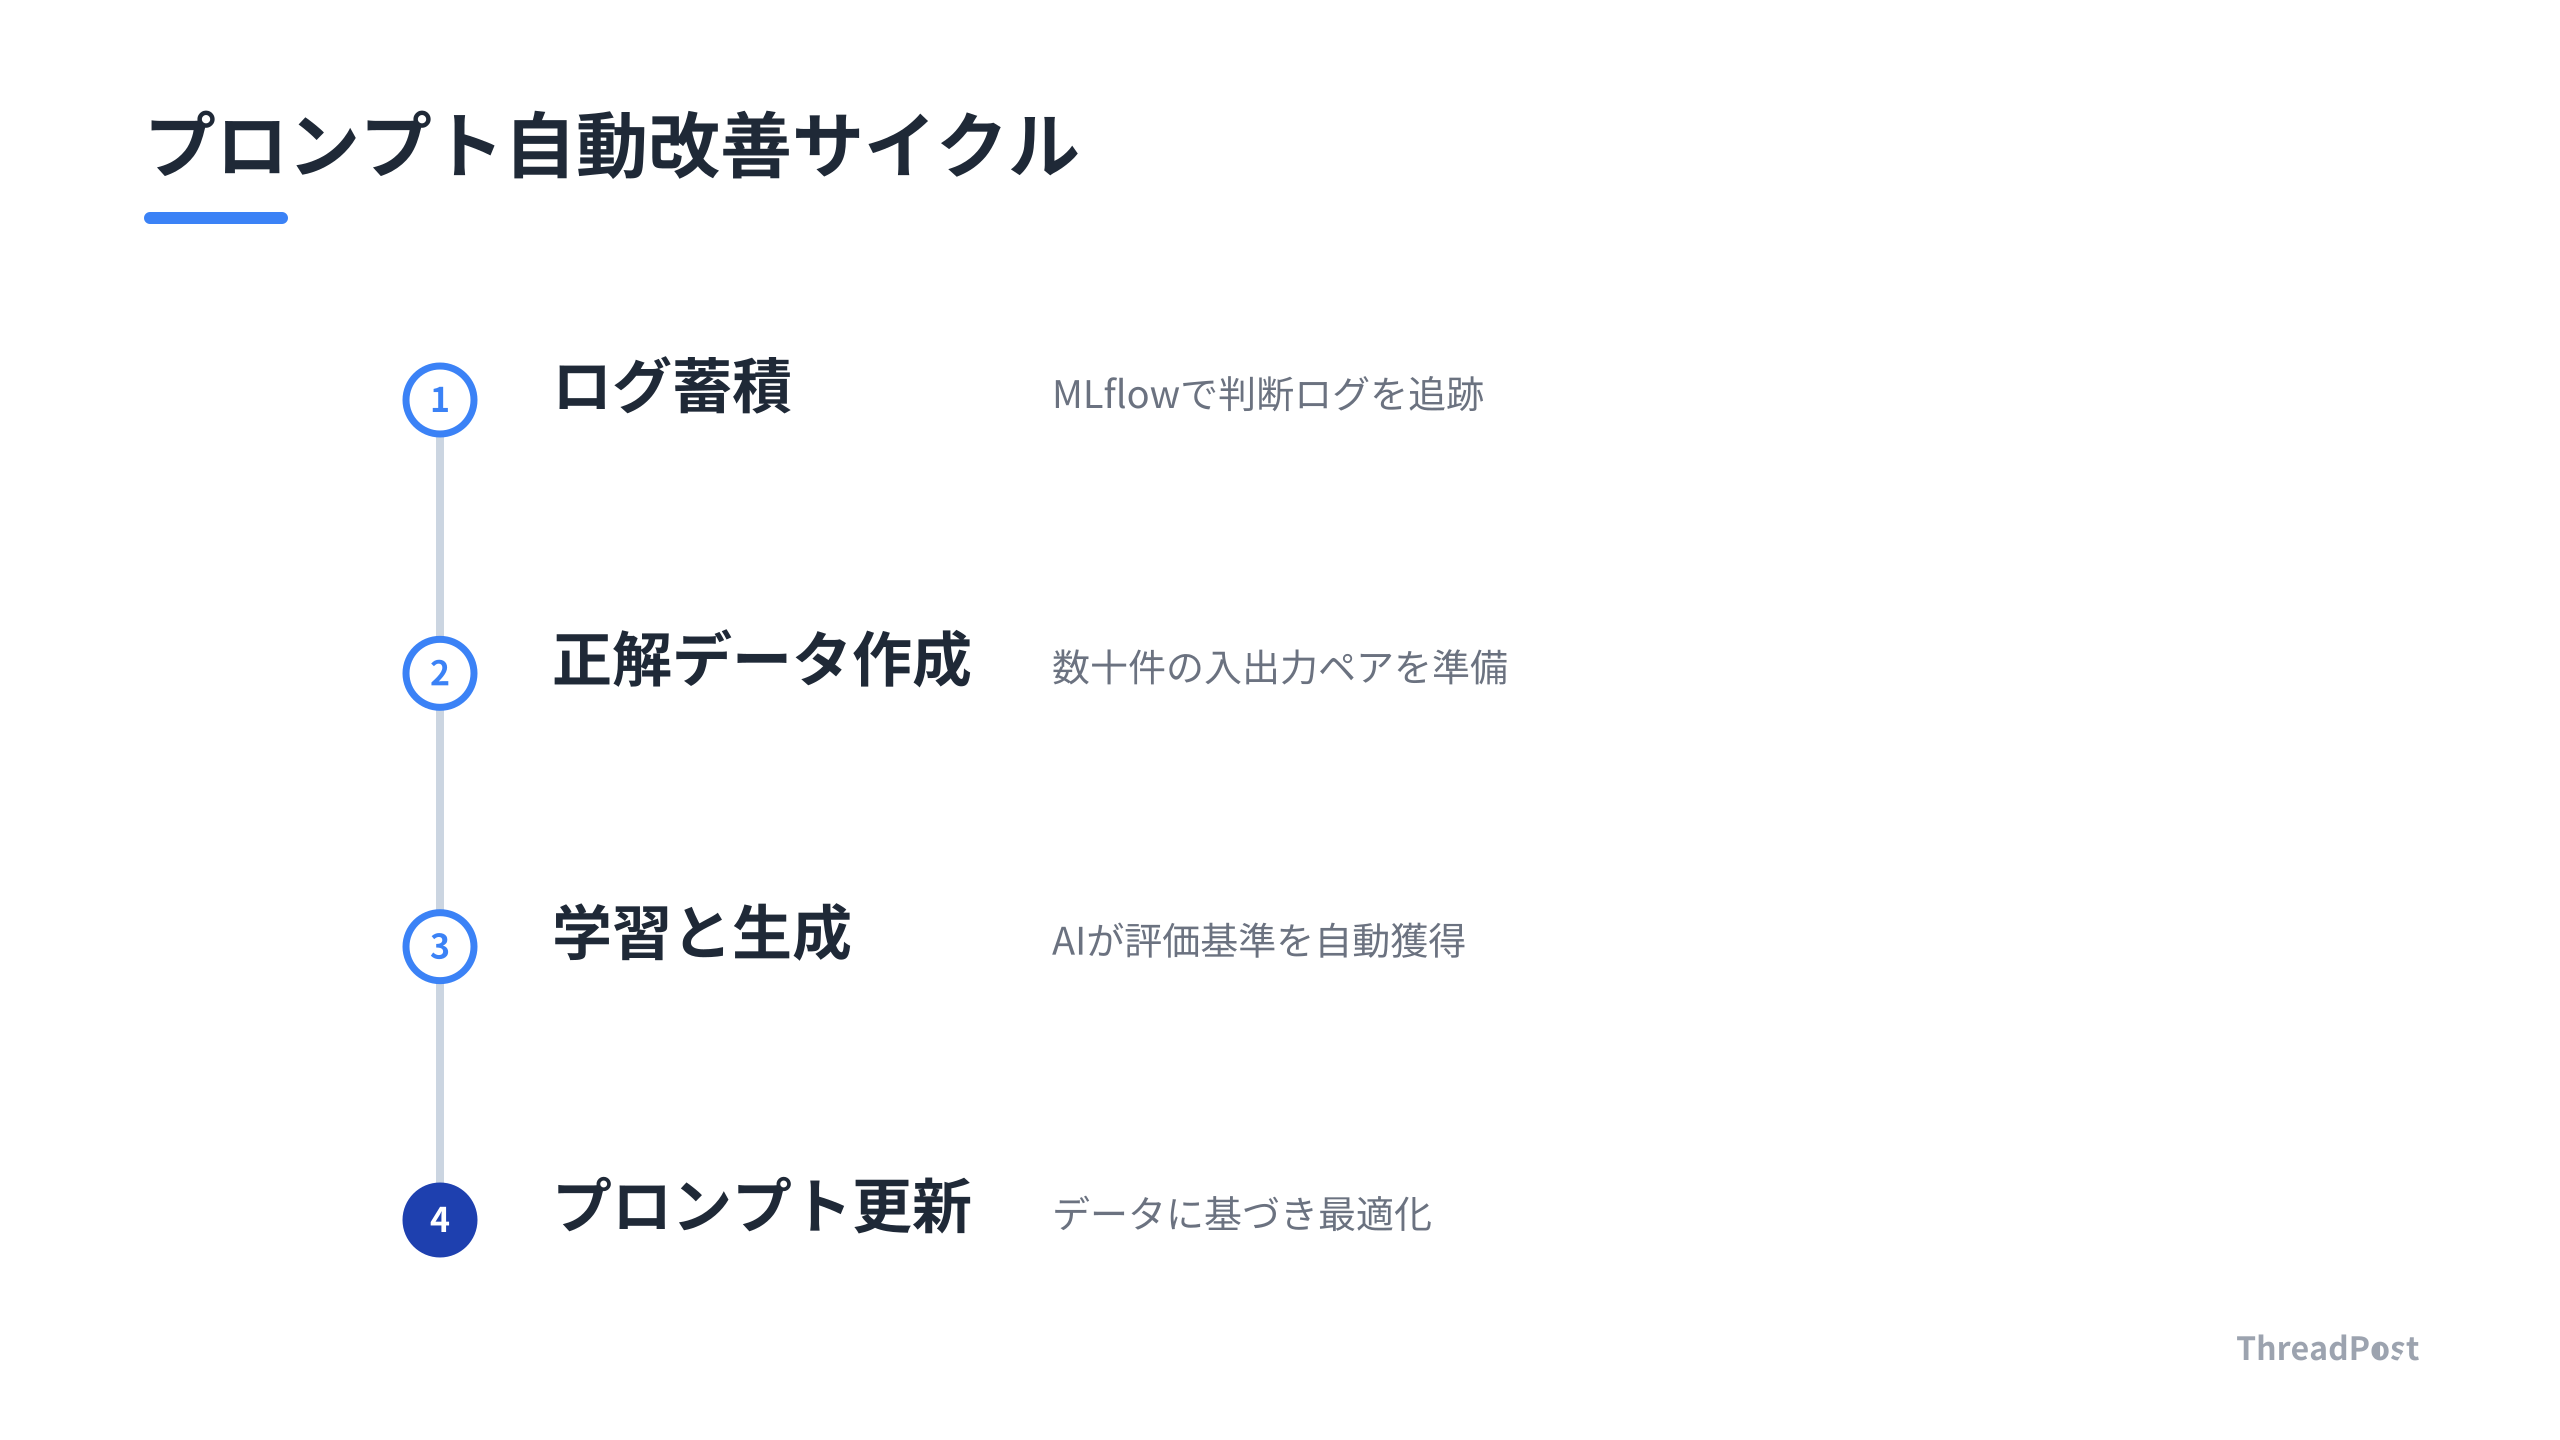
開発現場では、LangGraphを用いてエージェント間の状態(State)を構造化し、MLflowで処理の実行ログを可視化・追跡する構成が注目されている。不具合が発生した際も、プロンプトを人間の感覚で修正するのではなく、入力と出力のセットとして用意した数十件の正解データからAIに評価基準を学習させ、最適なプロンプトを自動生成するサイクルが実用化されている。
システム全体の構築においてFastAPIやReact 19、gemini-3.1-flash-liteのような軽量APIを組み合わせ、デプロイ基盤に月額20ドルから利用できる簡略化されたインフラ環境を採用する事例が増えている。
AI開発は、単にプロンプトでコードを書かせる段階を終えた。これからは、判断の文脈をいかにデータとして保持・改善していくかという「コンテキスト・エンジニアリング」の設計精度が問われるフェーズだ。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
プロンプトの微調整を捨ててコンテキストを設計する
AI開発の現場で、多くの開発者がプロンプト調整の泥沼にハマっている。
「1つの不具合を直そうとプロンプトをいじったら、別の場所で予期せぬエラーが出た」
こんなもぐらたたきを繰り返した経験は、誰にでもある。
僕自身、1人SaaSのThreadPostを開発する中で、プロンプトの文言調整に何時間も奪われる虚しさを味わった。
最新の知見が示しているのは、このプロンプトの最適化に固執する開発手法そのものが、すでに時代遅れになりつつあるという事実だ。
今起きているのは、単なる「指示の出し方」から、判断の文脈(コンテキスト)をどう保持して巡回させるかというコンテキスト・エンジニアリングへのシフトだ。
なぜ「設計は高級AI、実装は格安AI」という工程分業が失敗するのか
これまで定番とされてきた「強いモデルで設計し、安いモデルで実装させる」という役割分担は、実務において罠を抱えている。
設計と実装を別のコンテキストに分断すると、実装の途中で発生する仕様の再解釈や微修正の文脈が共有されない。
結果として、安価なAIが生成したコードの整合性が崩れ、それを修正するために高級なAIや開発者自身が何倍もの手戻りコストを払うことになる。
公式なドキュメントや最新の開発ノウハウでも、工程名(設計・実装・テスト)での切り分けは推奨されていない。
切り分けるべきなのは工程ではなく、作業の自己完結性とコンテキストの連続性だ。
調査やログ解析のように「大量の情報を要約して短く返せる作業」だけを隔離し、設計から実装、テストまでの判断が連続するプロセスは、同一のメインコンテキストで走らせるのが最適解だ。
Claude Codeで毎日コードを書いているが、サブエージェントにコード探索やログの要約を任せるのは快適だ。でも、中核の実装を安易に別文脈へ投げると、前提を忘れて変なコードを出してくる。メインの文脈を維持するか、完全に独立したworktreeで成果物ごと渡すのが安定すると思った。
ワークフローの構造化と「工程分業」の真の境界線
「AIにワークフローを組ませる事例がある」という疑問があるかもしれない。
一見すると「工程ごとの分業」に見えるが、成功しているワークフローと失敗する工程分業には決定的な違いがある。
それは、ノード間で「判断の境界と状態(State)」が明確に定義されているかどうかだ。
LangGraphのようなフレームワークを使ってワークフローを構造化する場合、単にタスクを丸投げするのではなく、どのノードがどのような状態(State)を受け取り、何を更新して次へ引き継ぐかがコードとして厳密に管理されている。
「設計と実装をなんとなく分ける」のは失敗するが、「リスクの評価結果という構造化された状態を保持したまま次の生成ノードへ渡す」手法は強力だ。
分業の成否を分けるのは、工程の名称ではなく、判断文脈のデータ化だ。
暗黙知をデータ化し、プロンプトを自動改善するサイクル
プロンプトの調整作業から脱出するための鍵が、評価ログの蓄積とプロンプトの動的生成だ。
人間が頭の中で考えている「なんかこの出力は違う」「もっとこうしてほしい」というニュアンスは、ドキュメント化されていない暗黙知だ。
これを手動でプロンプトの文言に落とし込もうとするからもぐらたたきが始まる。
解決策は、MLflowのような観測ツールを導入してAIの判断ログをすべて追跡し、評価基準として準備した数十件の正解データを用意することだ。
入力と期待する出力のペアさえ揃えば、そのデータセットからAI自身に暗黙の評価基準を学習させ、プロンプトを自動で生成・改善させる仕組みが構築できる。
システム全体のインフラに関しても、個人開発で維持しやすい月額20ドル程度で導入可能なVM環境などを活用し、デプロイの手離れを良くする設計がトレンドだ。
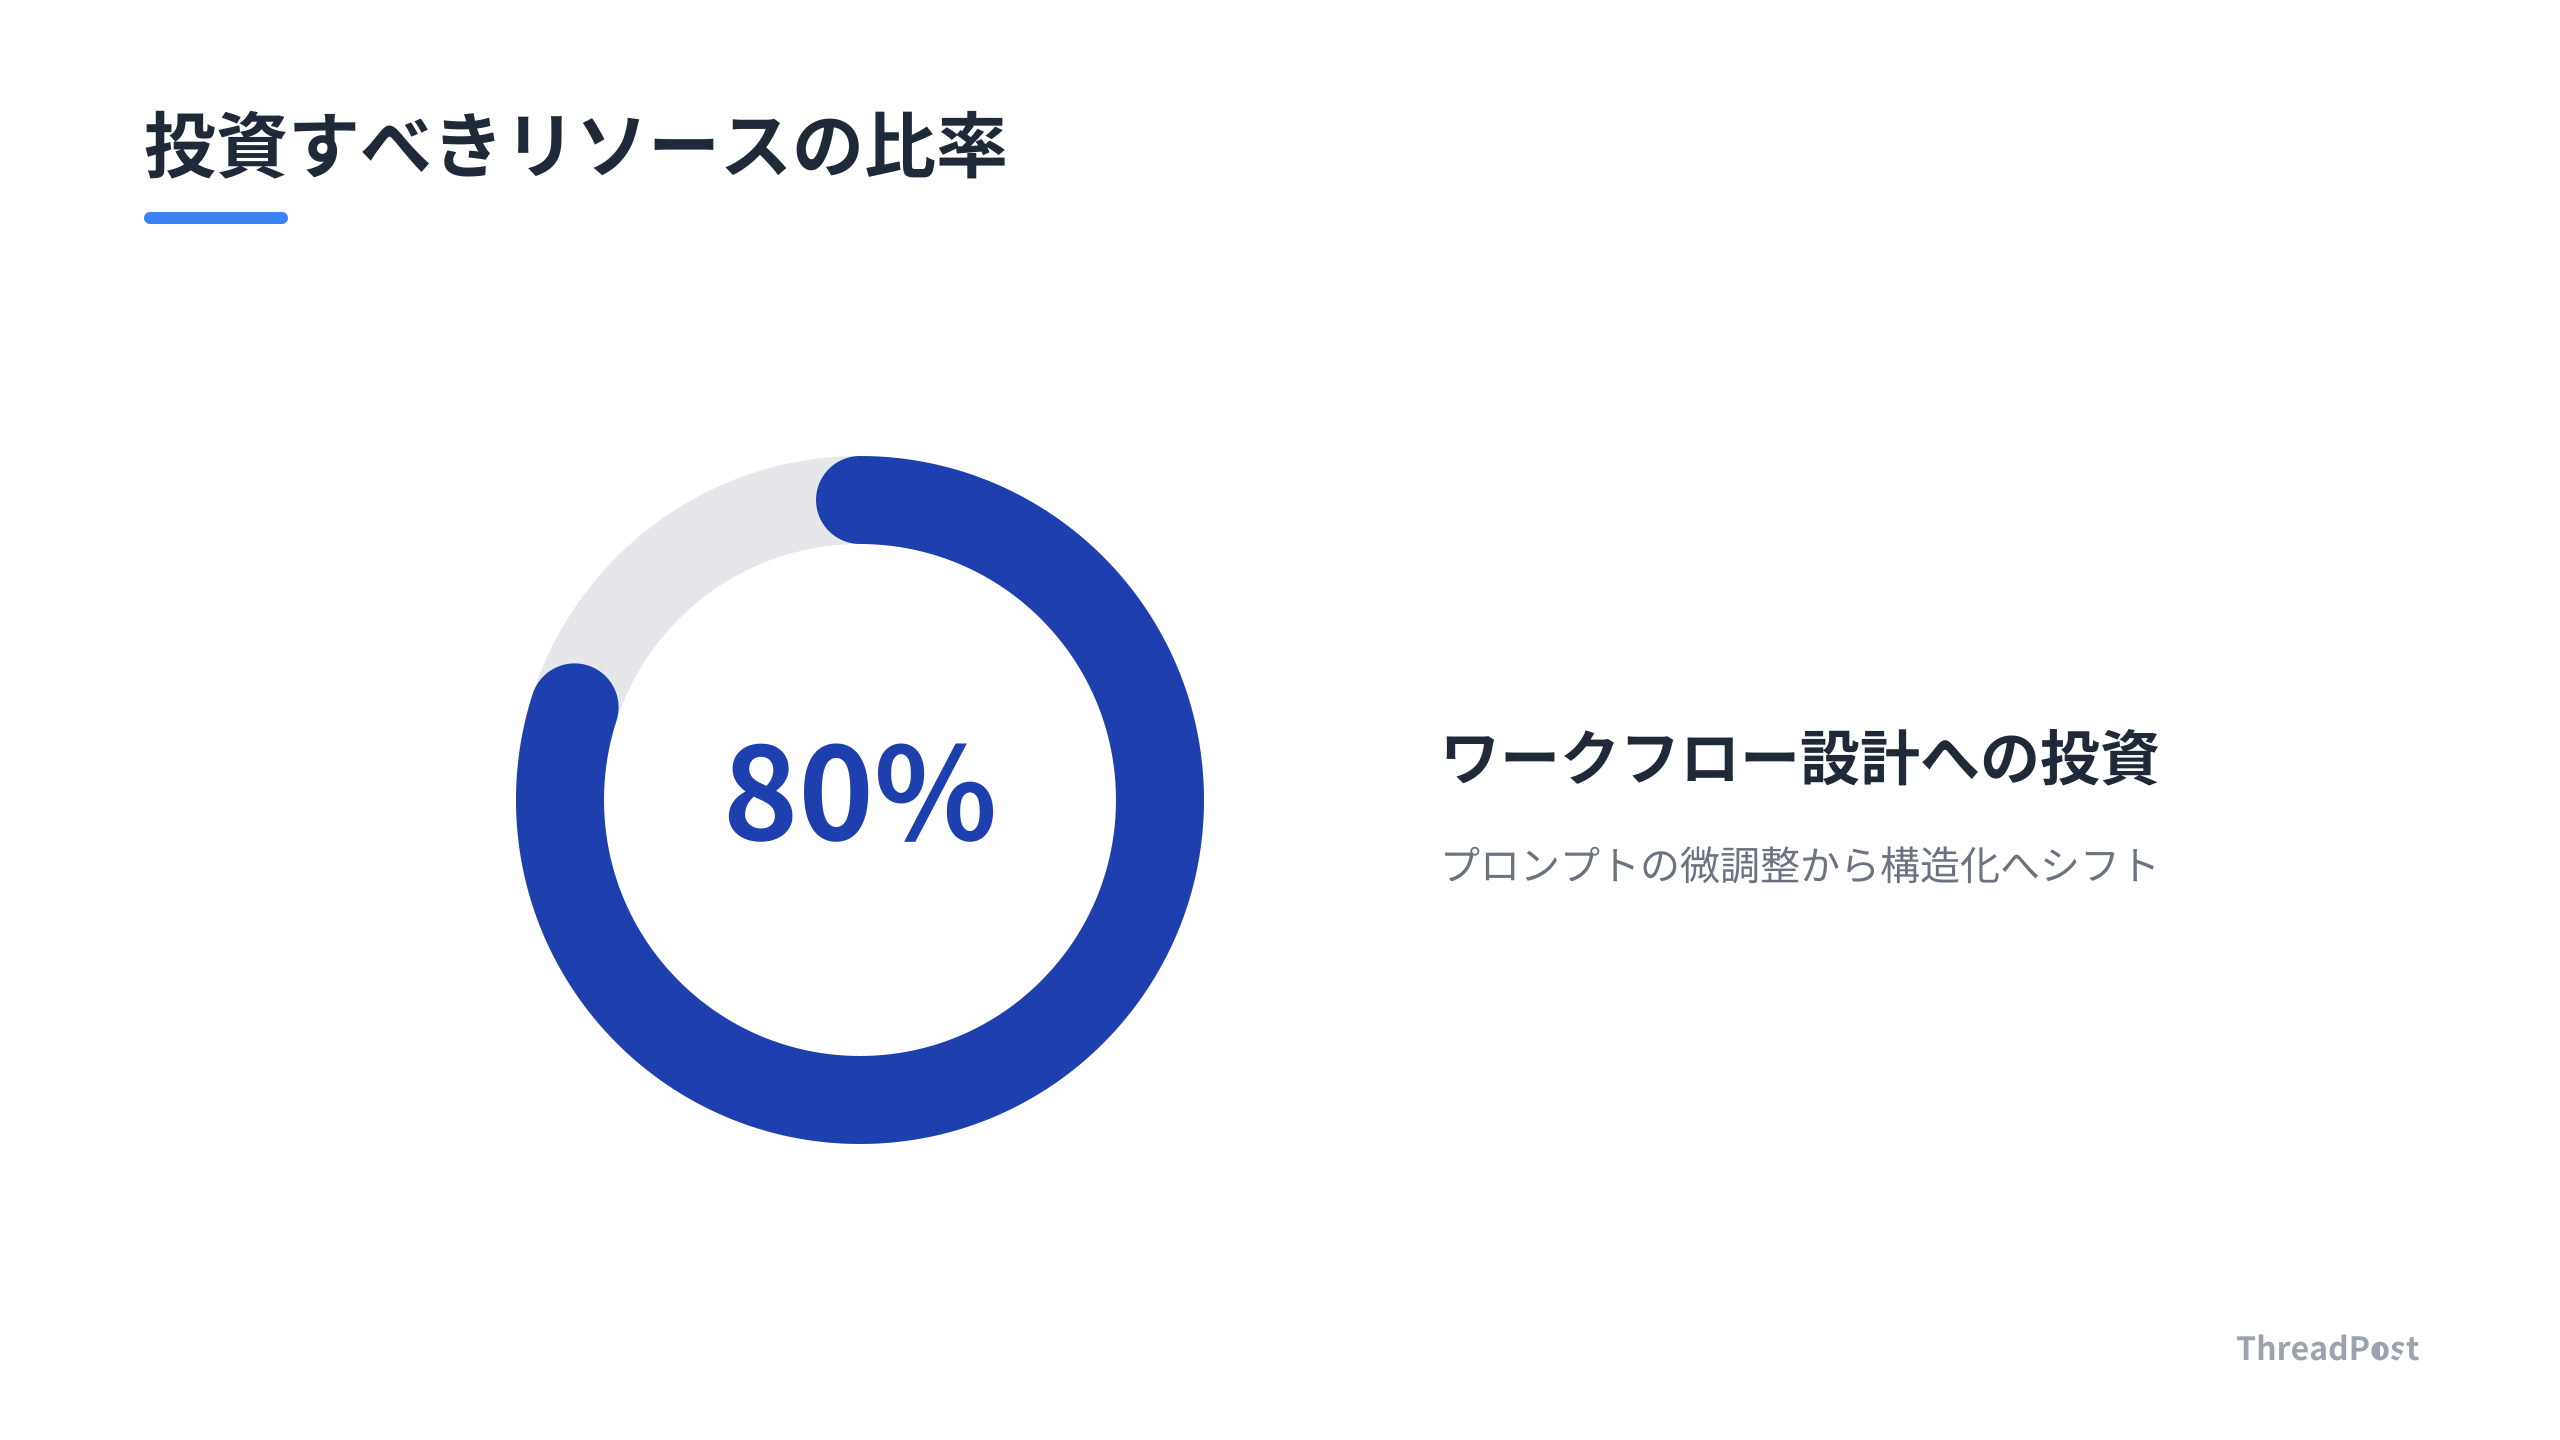
僕らが投資すべきなのは「プロンプトを1文字ずつ推敲する時間」ではない。
「ワークフローの構造化」と「評価用データの蓄積」に時間を使うことこそが、1人開発や少人数開発における生産性を爆発させる真の最適解だ。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
今日から開発プロセスで切り替えるべき3つの実務アクション
明日からの開発で変えるべきはプロンプトの調整作業ではない。
変えるべきなのは、AIへのタスクの切り出し方と時間の使い所だ。
1. 「工程分業」を捨てて「成果単位」で委譲する
「設計は強力なモデル、実装は安価なモデル」という工程別の分業スタイルは終わりにすべきだ。
仕様の再解釈や設計判断の文脈が途切れてしまい、手戻りの嵐になるからだ。
* メインコンテキスト:要求の解釈、全体の設計、中核となる実装、テスト修正までを一気通貫で担当させる
* サブエージェント:ログ解析、コード検索、テスト実行などの読み取り専用タスクやノイズの隔離に限定する
もし実装を別エージェントに任せたいなら、工程で切るのではなく機能単位で切り出す。
Claude Codeを使っているなら、worktreeで作業環境を分離し、独立した1つの機能を端から端まで完遂させるのが最も効率的な運用だ。
2. プロンプトの修正を止め、評価データを作る
出力の精度が低かったときに、プロンプトへ指示を書き足していくのは悪手だ。
1つの不具合を消しても、別の場所で新しい不具合が発生する泥沼に入る。
* AIが間違えた入出力のログを追跡・保存する
* 判断基準を含めた正解のデータセットを20〜30件用意する
* そのデータセットからAIに暗黙の評価ルールを学習させ、プロンプトを自動更新させる
僕らが手動でテキストを調整するのではなく、データでAIの挙動を改善する仕組みに切り替える。
ThreadPostのロジックを組んでるとき、プロンプトに制約を10個以上書いて自爆した。「〜は出力するな」を増やすたびに別の挙動がおかしくなる。ログを残して状態管理に切り替えたら、驚くほど一発で安定した。あのプロンプトと格闘した時間は何だったのかと思った。
3. 判断文脈を「State」として構造化する
処理の全体像は、テキストでの指示ではなくLangGraphなどのツールでワークフローとしてコード化する。
エージェント間で引き継ぐデータは、あやふやな文章ではなくState(状態)として定義する。
* 各ノードが受け取る入力と、更新して返す出力のデータ構造を厳密に固定する
* 判断に必要な文脈をState経由で確実に伝搬させる
* MLflowなどでログを監視し、どのノードで判断が狂ったかを特定できるようにする
プロンプト調整に費やしていた1日3時間を、ワークフローの設計と評価データの作成に充てる。
これだけで、開発効率は別次元に進化する。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
AIエージェントに実装を任せると設計とコードの整合性が崩れるのはなぜ?
設計と実装で別々のエージェントに仕事を引き継ぐ構成は、手戻りが発生しやすいパターンだ。実装の途中で起きる仕様の再解釈が共有されず、全体で辻褄が合わなくなる。
解決策は、設計とコード生成を同じメインコンテキストで維持するか、LangGraphを使って設計判断をState(状態)としてノード間に引き継がせることだ。単に工程で区切るのではなく、判断の文脈を共有できる構造を作り込む必要がある。
プロンプトを修正しても別の不具合が出ます。どう抜け出せばいい?
指示文の微調整で挙動を制御しようとするのは、典型的な「もぐらたたき」だ。制約フレーズを1行増やすたびに、別の箇所の出力精度が落ちる悪循環に陥る。
まずはLangGraphでノードごとの入出力を構造化し、MLflowなどの観測ツールでログを蓄積する。失敗した入力と理想の出力をデータ化し、プロンプトを動的に生成・最適化する仕組みへ切り替えるのが確実な脱出ルートだ。
「設計は高級モデル、実装は格安モデル」の分業はコスト削減になりますか?
工程だけを基準にした安易な分業は、手戻りによるやり直しでトークン消費が2倍以上に跳ね上がるリスクがある。実装時の文脈が欠落し、誤った修正を繰り返すためだ。
コストを抑えたいなら、工程ではなく「コードベースの探索」や「テストログの解析」など、結果を要約して返せる自己完結したタスクだけをサブエージェントに切り出すのが鉄則だ。
まとめ
プロンプトの微調整で夜更かしするのはやめる。僕もClaude Codeで開発しながら「指示文の1行追加」に時間を溶かしていたが、勝負の分け目はそこではなかった。
大切なのは、AIに渡す判断文脈をどう構造化してログに残すかだ。工程で切るのをやめて、ワークフローを正しく組む。これだけで開発のストレスは減る。
AI開発の「もぐらたたき」から卒業し、判断文脈をコード化する次世代のワークフロー構築術をThreadPostで深掘りする。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
