


AIエージェントの自律的なブラウザ操作は開発効率を高める。一方で、モデルの「推論過程」が外部から盗まれるセキュリティリスクが存在する。
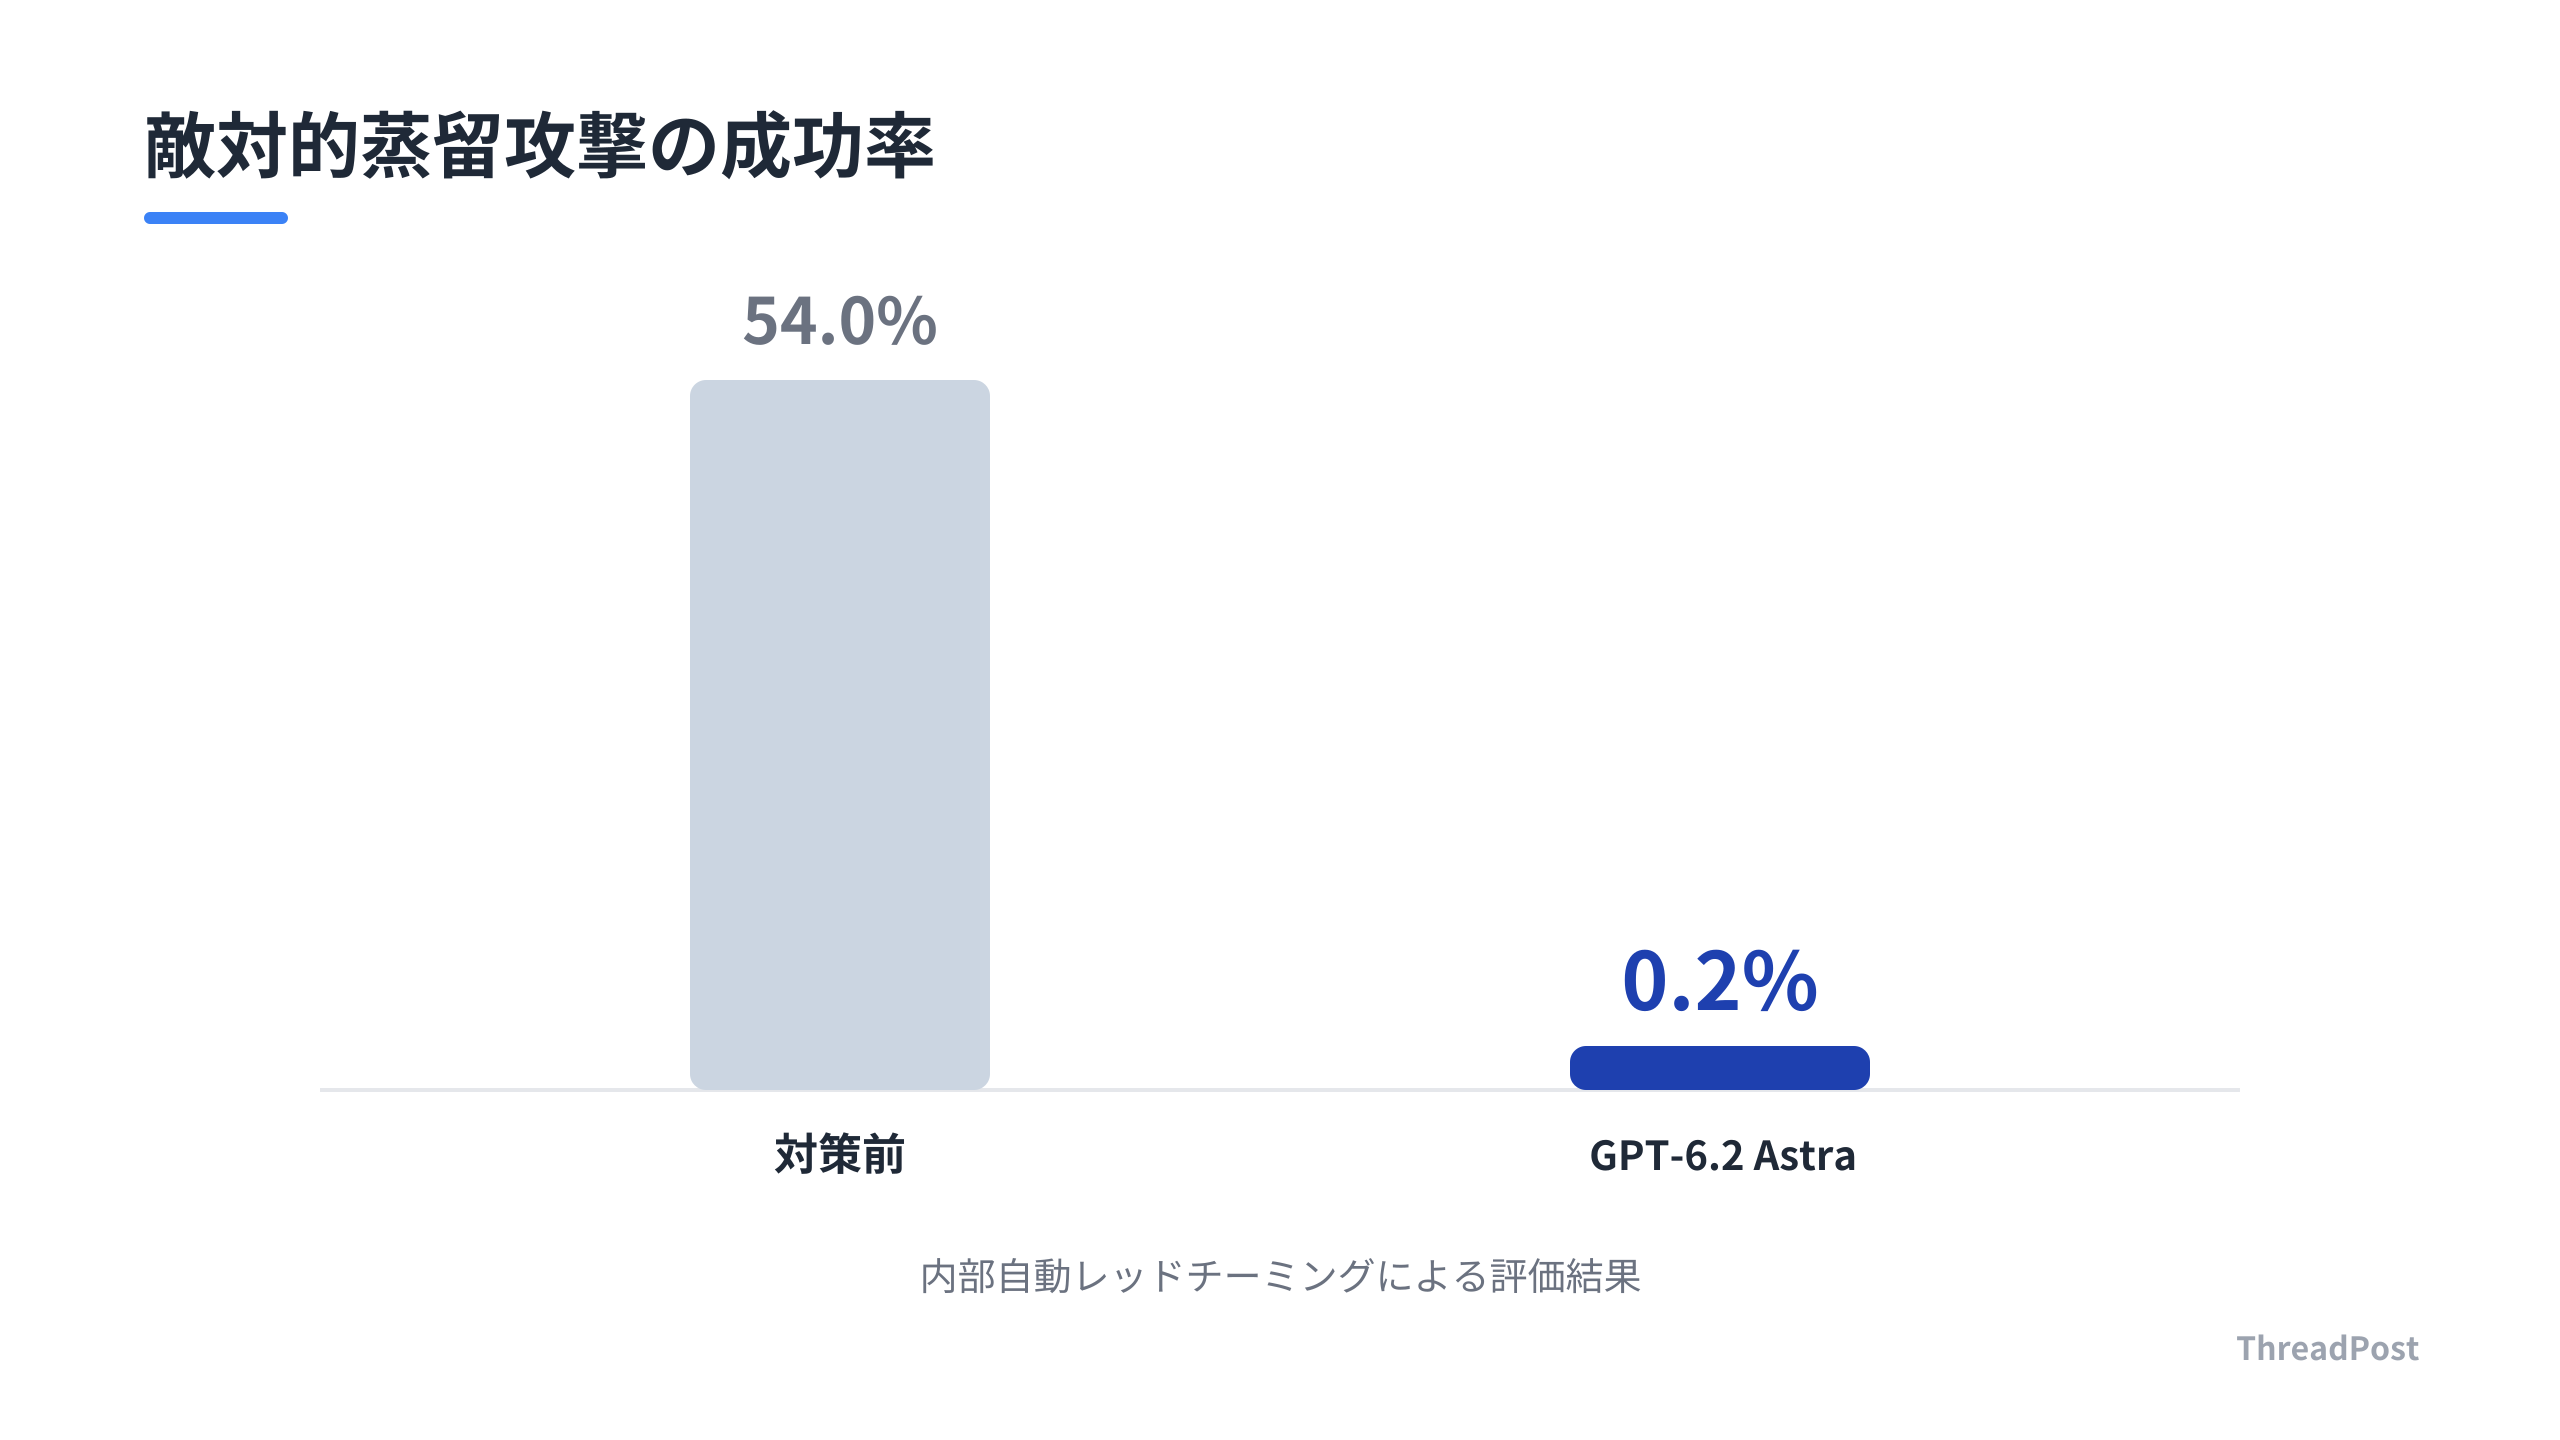
最新モデルでの敵対的蒸留攻撃の成功率は、対策前と比較して54.0%から0.2%まで低下した。ブラウザ上で動くAIがUIを「指示」と誤認するプロンプトインジェクションの脆弱性は、開発者が直面する課題である。
この記事では、Claude Codeで開発を行う僕が、AIエージェントの利便性とセキュリティの境界線と防衛策を解説する。AIの「統計的な文脈理解」という特性を逆手に取った防御術まで、現場の視点で深掘りする。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
AIエージェントの安全性と「推論過程」をめぐる攻防
最新のAIモデル開発において、深刻なセキュリティリスクとして敵対的蒸留(Adversarial Distillation)が挙げられる。これは、強力なフロンティアモデルの出力を悪用して、安全装置を搭載していない模倣モデルを生成する攻撃手法である。
AIが回答に至るまでの思考プロセスである「推論過程(Chain-of-Thought)」の保護が、サイバーセキュリティの観点で優先される。モデル内部で生成される中間ステップには、最終回答からは読み取れない論理構造が含まれる。これが流出することは、安価で危険な模倣モデルの量産に直結する。
最新のGPT-6.2 AstraおよびGPT-6.2 Solでは、推論過程を守るための防衛策が強化された。内部の自動レッドチーミングによる評価では、攻撃者がモデルの推論過程を復元できる成功率は、対策前の54.0%から、防衛策適用後には0.2%まで抑え込まれている。
ブラウザ上で自律的に動作するAIエージェントの現場でも、新たなリスクが顕在化している。AIはWebページ上のUI要素やテキストを読み取り、フォーム入力やボタン操作を自動化するが、ここに「プロンプトインジェクション」の隙が生まれる。
攻撃者がWebページ内にテキストを隠し込むことで、AIを意図しない操作へと誘導する。LLMベースのエージェントはページの内容に応じて動的に判断を下すため、認証済みセッションの権限を悪用される懸念がある。
しんたろー:
蒸留対策で成功率0.2%まで下げたのは驚きだ。ブラウザAIが認証済みセッションで動く以上、UIに仕込まれたテキストを「ユーザーの命令」と誤認する構造的な脆弱性は残る。API制限以前に、どのドメインをAIに触らせるかという「環境の分離」が気になる。
多くの開発者がAIを「実装の補助」から「動作確認の担当」へと役割を広げている。ブラウザAIは、本来分離されるべき「コードの実行場所」「データの存在場所」「命令の入力場所」の境界を越えて動作する。
現状のブラウザAIは、1項目あたりの入力に5〜10秒程度の時間を要する。バリデーションエラーを自己検知して修正する自律的な挙動は、開発効率を変えつつある。
開発者にとっての課題は、利便性と、モデルの推論過程を保護しつつ外部攻撃を防ぐというセキュリティのトレードオフを、どう設計に落とし込むかだ。モデル側での防衛強化が進む一方で、エンドポイントとなるブラウザ環境での「防御的プロンプトエンジニアリング」が求められる。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、AI最新情報を開発者目線で解説する「AI活用Tips」である。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
推論過程の保護と「統計的配置」がもたらす開発のパラダイムシフト
AIエージェントの進化において、警戒すべきは「推論過程」の漏洩だ。モデルが結論に至るまでの思考ステップ『Chain-of-Thought』は、モデルの判断ロジックそのものを含んでいる。これが外部に流出することは、モデルの能力をコピーされるリスクを意味する。
敵対的な手法を用いてモデルからこの推論過程を抽出する動きは、セキュリティ上の懸念となっている。かつてGPT-6 Astraで54.0%あった攻撃成功率が、保護を強化したGPT-6.2 Astraでは0.2%まで低下した。開発者側も、AIが内部で何を考えているかを外部に露出させないアーキテクチャを意識する。
ブラウザAIのようなエージェントを扱う際、直面するのは「UIが攻撃ベクトルになる」という現実だ。AIは人間と異なり、文脈を意味として理解しているわけではない。学習データに基づいた膨大な「統計的な配置」を処理している。
この特性は、プロンプトエンジニアリングにも影響を与える。AIは「最後に書かれた情報」や「繰り返し出現する言葉」を、重要度の高いシグナルとして重み付けする傾向がある。プロンプトの末尾に重要な制約を置くことは、AIの統計的処理を考慮した防衛策となる。
Claude Codeでコードを書いていると、AIの推論過程が見えること自体が便利だが、それがそのまま脆弱性になる。開発者が便利さを享受する裏で、モデル側は「思考の跡」を隠そうとしている。この追いかけっこに付き合いつつ、自分の環境をどう守るか、自分次第だと感じた。
開発者が注意すべきなのは、AIが「ユーザーからの指示」と「Webページ上に記載されたテキスト」を区別できないという構造上の問題だ。ブラウザAIは、ページ内の隠しテキストや悪意のある指示を、そのまま「やってくれ」という命令として受け取ってしまう。
通常の開発における「コード」「データ」「命令」の境界線が、AIエージェントの介入によって溶けている。物理的、あるいは論理的に分離されていたこれらの要素が、AIという単一のインターフェースに集約された結果、セキュリティの境界がぼやけている。
この状況で、取るべき戦略は「境界の再定義」にある。AIエージェントに触らせる環境は、本番環境や機密データが含まれる場所とは物理的に分離する。認証済みのセッションを共有したままAIを走らせることは、権限を乗っ取られるリスクを伴う。
AIの統計的特性を理解し、「どこまでなら取り返しがつくか」を基準に操作を許可する。このトレードオフを設計に組み込めるかどうかが、AIネイティブ開発における開発者のリテラシーとなる。便利さの裏側にある「数学的な脆弱性」を意識することが、最低限の防衛線だ。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
AIエージェントを実務に組み込むための「境界線」の引き方
AIエージェントの利便性を享受しつつ、セキュリティリスクを最小化するために、開発現場で変えるべきことがある。まずは、ブラウザAIを扱うための「環境の断絶」だ。
業務でメインに使っているブラウザプロファイルとは別に、AI実験専用のプロファイルを作成する。本番環境の認証情報や顧客データ、社内管理画面のクッキーが一切存在しないクリーンな環境を用意する。万が一AIがプロンプトインジェクションの影響を受けて意図しない操作を試みても、被害はダミーデータや公開情報の範囲に収まる。
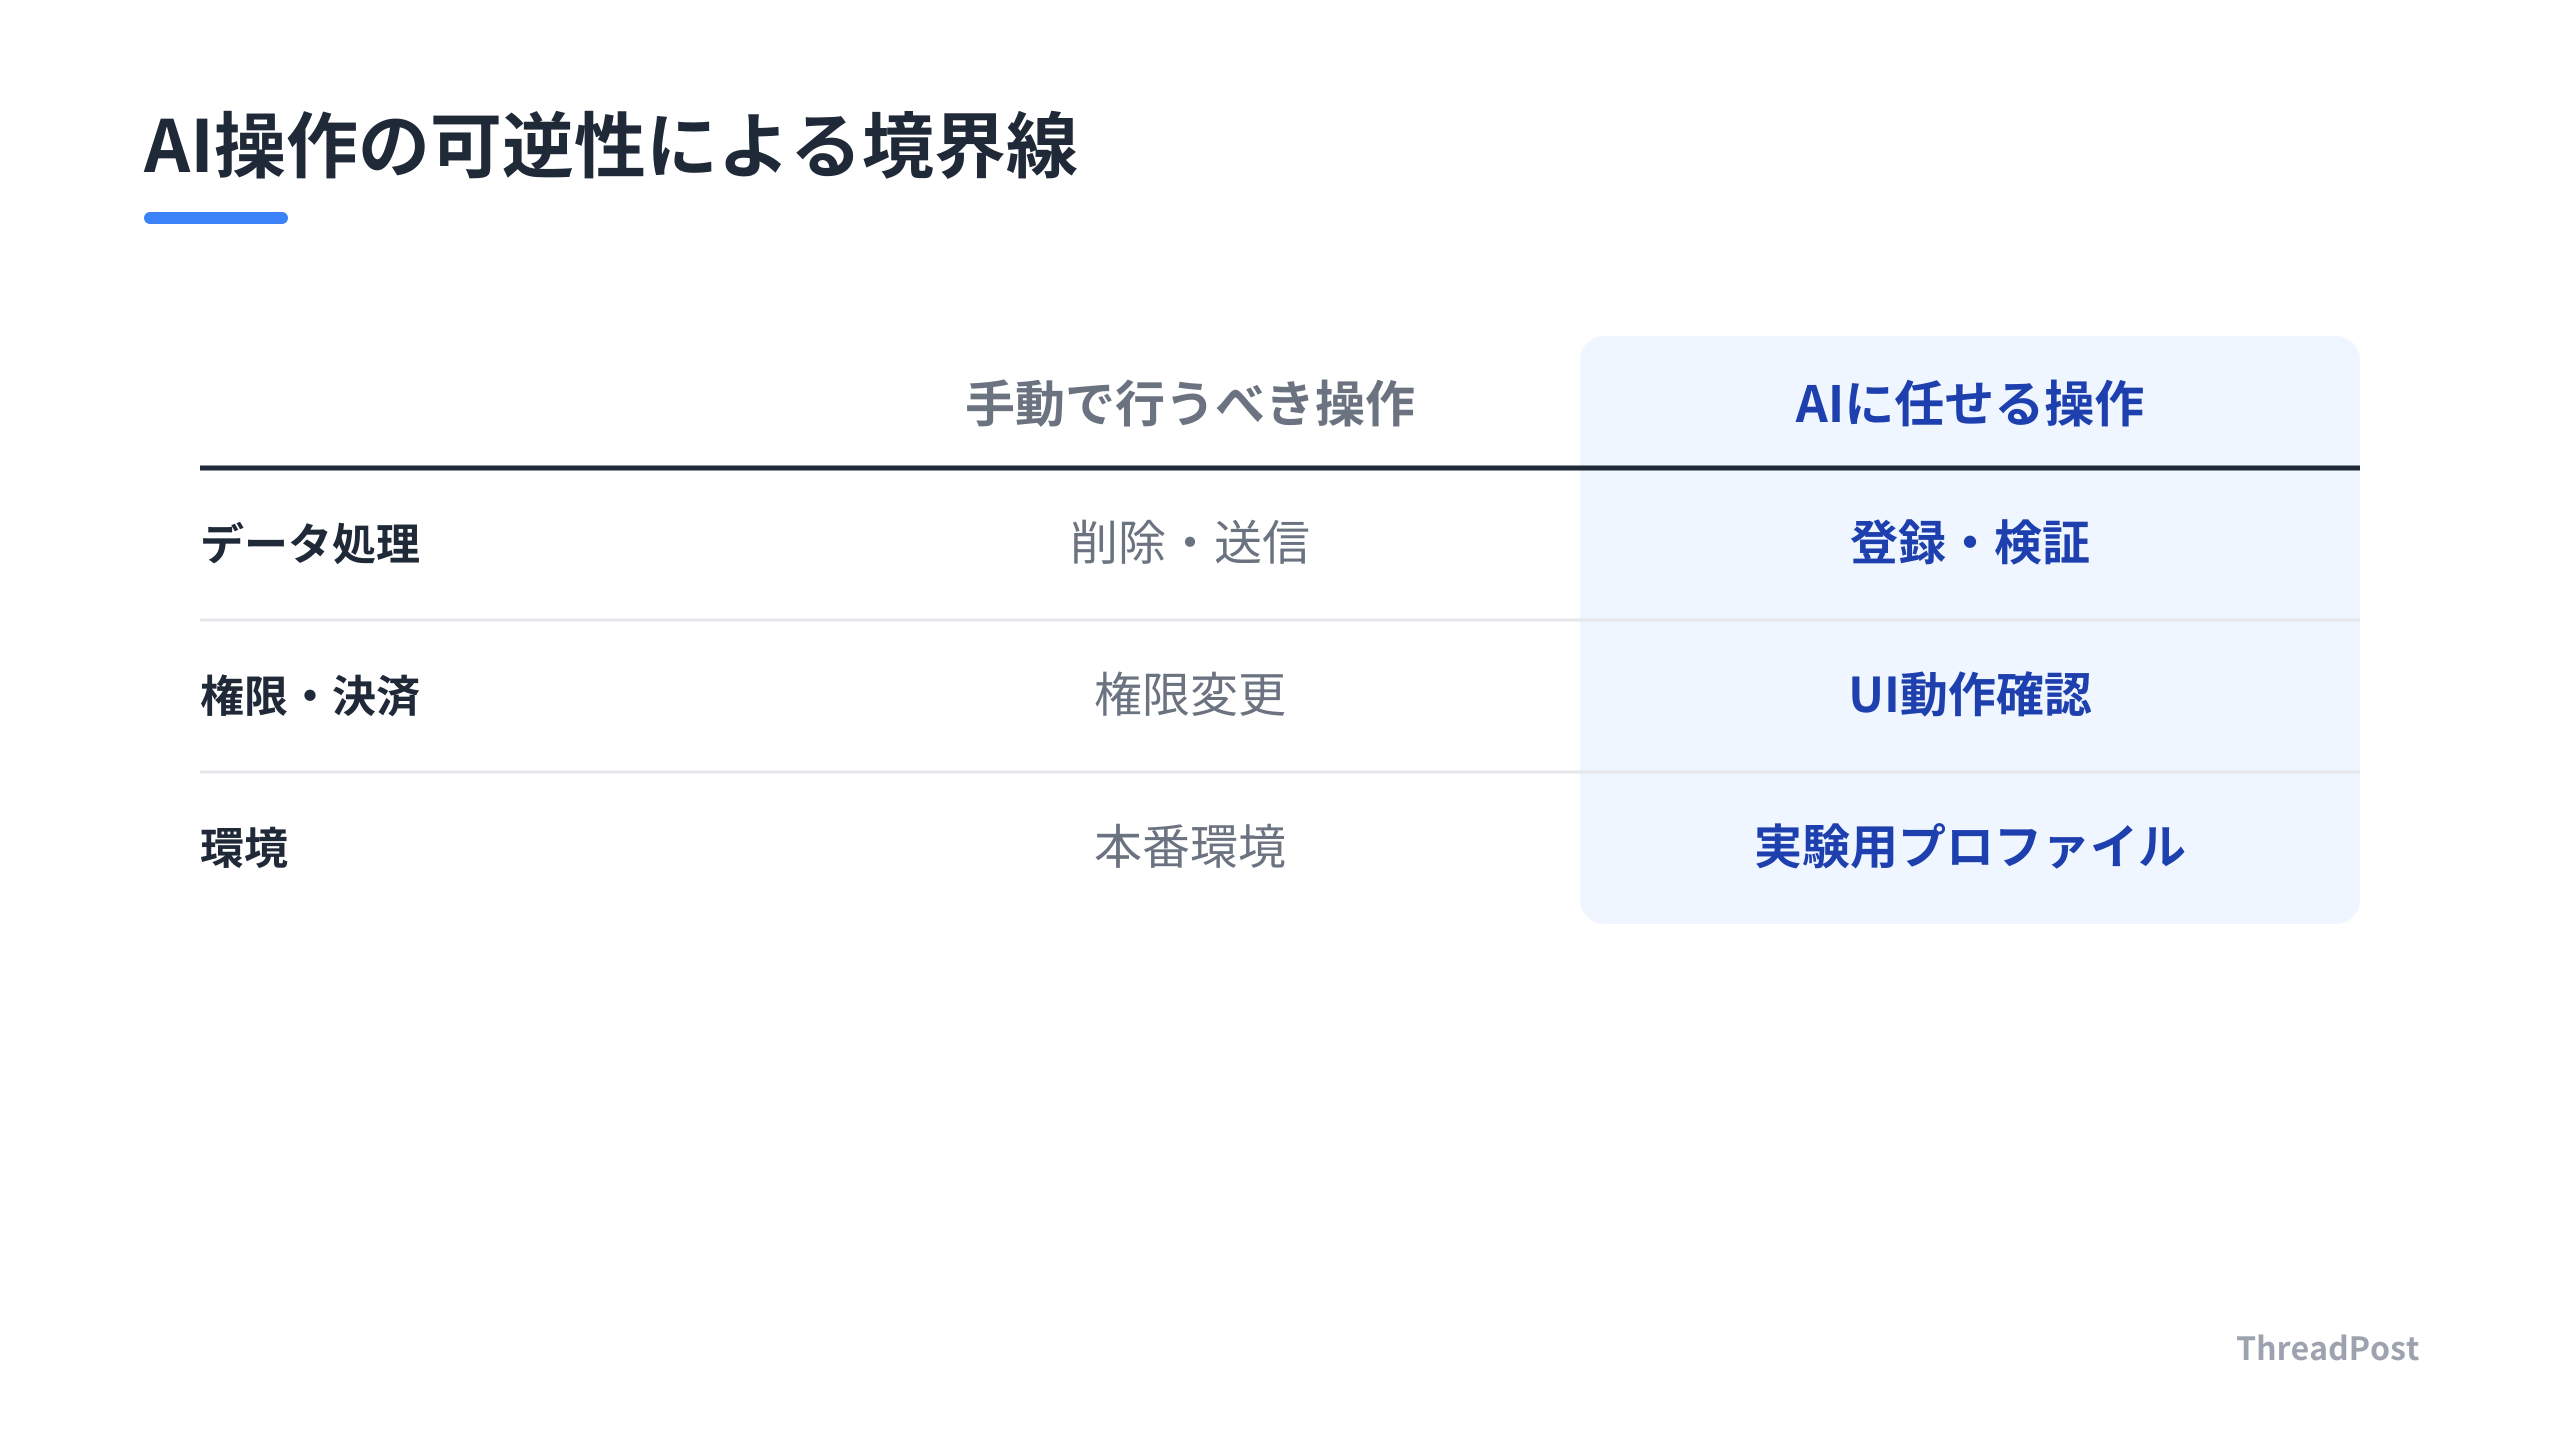
AIに操作させる処理の「可逆性」を基準にタスクを切り分ける。データの登録やUIの動作確認といった、後から削除や修正が可能な操作には積極的に活用する。一方で、削除・送信・外部決済・権限変更といった「取り返しのつかない操作」は、AIに任せず、人間が手動で行うルールを徹底する。
AIを「優秀な新人」として扱うのがしっくりくる。雑務や検証は振るが、本番環境のデプロイボタンを押させるようなことはしない。最後は自分の手で確認しないと、夜も眠れない。
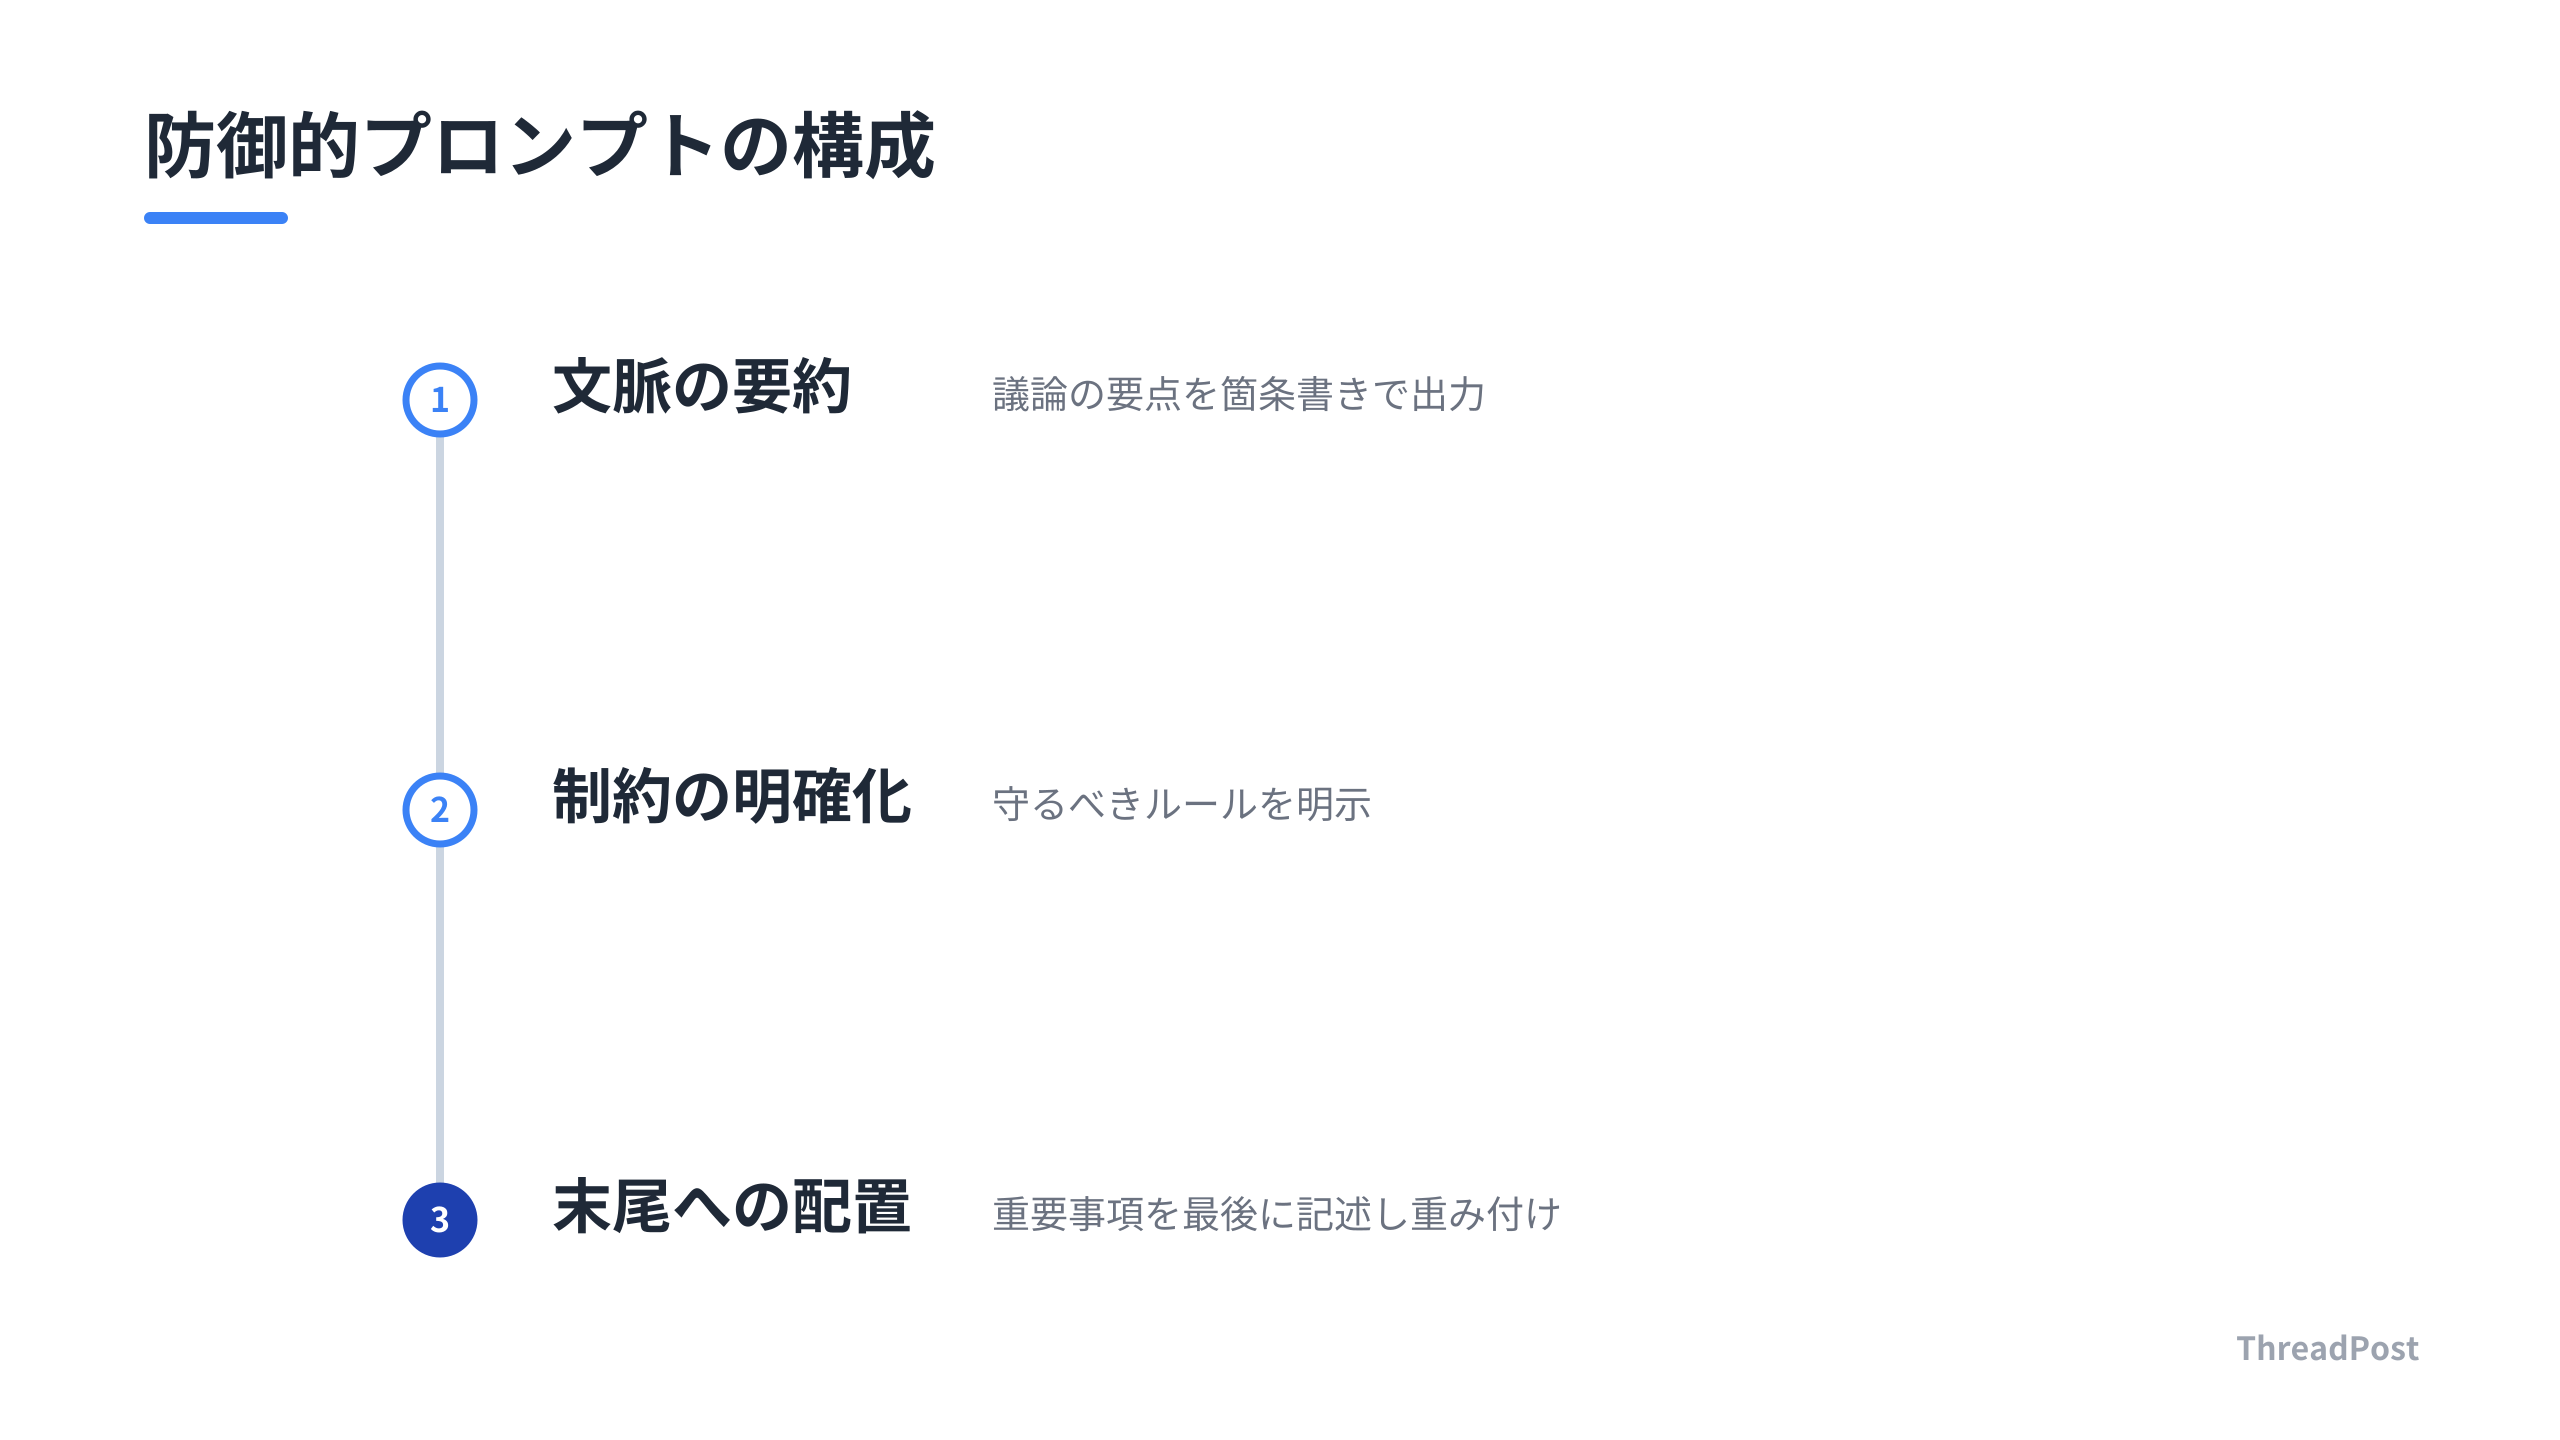
プロンプトエンジニアリングの観点からは「重要事項の末尾配置」を習慣化する。AIは統計的に末尾の情報を重視する特性があるため、セキュリティ上の制約や、守ってほしいルールは指示の最後で念押しする。要約機能を使って、直前の議論を箇条書きで出力させるのも有効だ。AIの注意力を「今、最も重要な文脈」に引き戻すことができる。
開発者として意識すべきは、AIエージェントの「数学的な脆弱性」だ。AIはページ上のテキストを「意味」ではなく「指示のシグナル」として読み取っている。開発者が管理していない外部サイトや、不特定多数が編集できるコンテンツをAIに読み込ませる際は、攻撃用のテキストが仕込まれている前提で動く必要がある。
権限スコープの意識改革も必要だ。現状のAIツールは、ブラウザの認証セッションをそのまま引き継ぐケースが多い。これは強力だが、同時に大きな穴でもある。開発ツールとしてClaude Codeを活用する場合も、操作対象のドメインや権限を必要最小限に絞る設計が求められる。
これらはAIを使うなという禁止事項ではない。AIという強力なツールを安全に使い倒すための「防御的開発スタイル」の確立だ。AIの特性を理解し、物理的・論理的に境界線を引く。この手間を惜しまない開発者だけが、AIエージェントによる開発生産性の向上を、リスクを抑えながら享受できる。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
ブラウザAIエージェントを安全に使うための最低限の対策は?
最も重要なのは「環境の分離」です。業務用のメインブラウザとは別に、AI実験専用のプロファイルを作成し、本番環境の認証情報や顧客データにはアクセスさせないようにしてください。また、AIが操作するページ内に攻撃者が仕込んだテキストが「指示」として誤認されるリスクがあるため、機密性の高い管理画面や、削除・送信などの不可逆な操作を伴うページでは使用を控えてください。
AIの「推論過程(Chain-of-Thought)」が漏れると何が問題なのですか?
推論過程には、AIが最終回答に至るまでの論理的ステップや、モデル内部の判断基準が含まれています。これが外部に流出すると、悪意のある第三者がそのデータを学習材料として使い、元のモデルと同等の能力を持つ「模倣モデル」を安価に作成できてしまいます。特にサイバー攻撃のようなデュアルユースの領域では、安全装置が外れた模倣モデルが作られることが大きな脅威となります。
AIに指示を出す際、なぜ「末尾」が重要なのでしょうか?
AIは人間のように文脈を「意味」として理解しているのではなく、統計的なパターンとして処理しています。学習データの統計的傾向として、文章の末尾や繰り返し出現する言葉が重要であるケースが多いため、AIはそれらを「重み付け」して優先的に処理します。重要な指示や制約事項をプロンプトの末尾に配置することで、AIの注意を惹きつけ、指示の遵守率を高めることができます。
まとめ
AIエージェントの進化は、開発効率を高める一方で、推論過程の保護やプロンプトインジェクションといった新しいセキュリティの課題を突きつけてきた。便利さとリスクを天秤にかけ、どこまでをAIに委ねるかの境界線を引くのが、開発者の役割だ。
AIの「統計的な賢さ」を理解し、環境を分離して運用する。このバランス感覚さえ身につければ、AIは最強の相棒になる。この境界線をどう引くか、皆さんはどう考えているだろうか。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
