


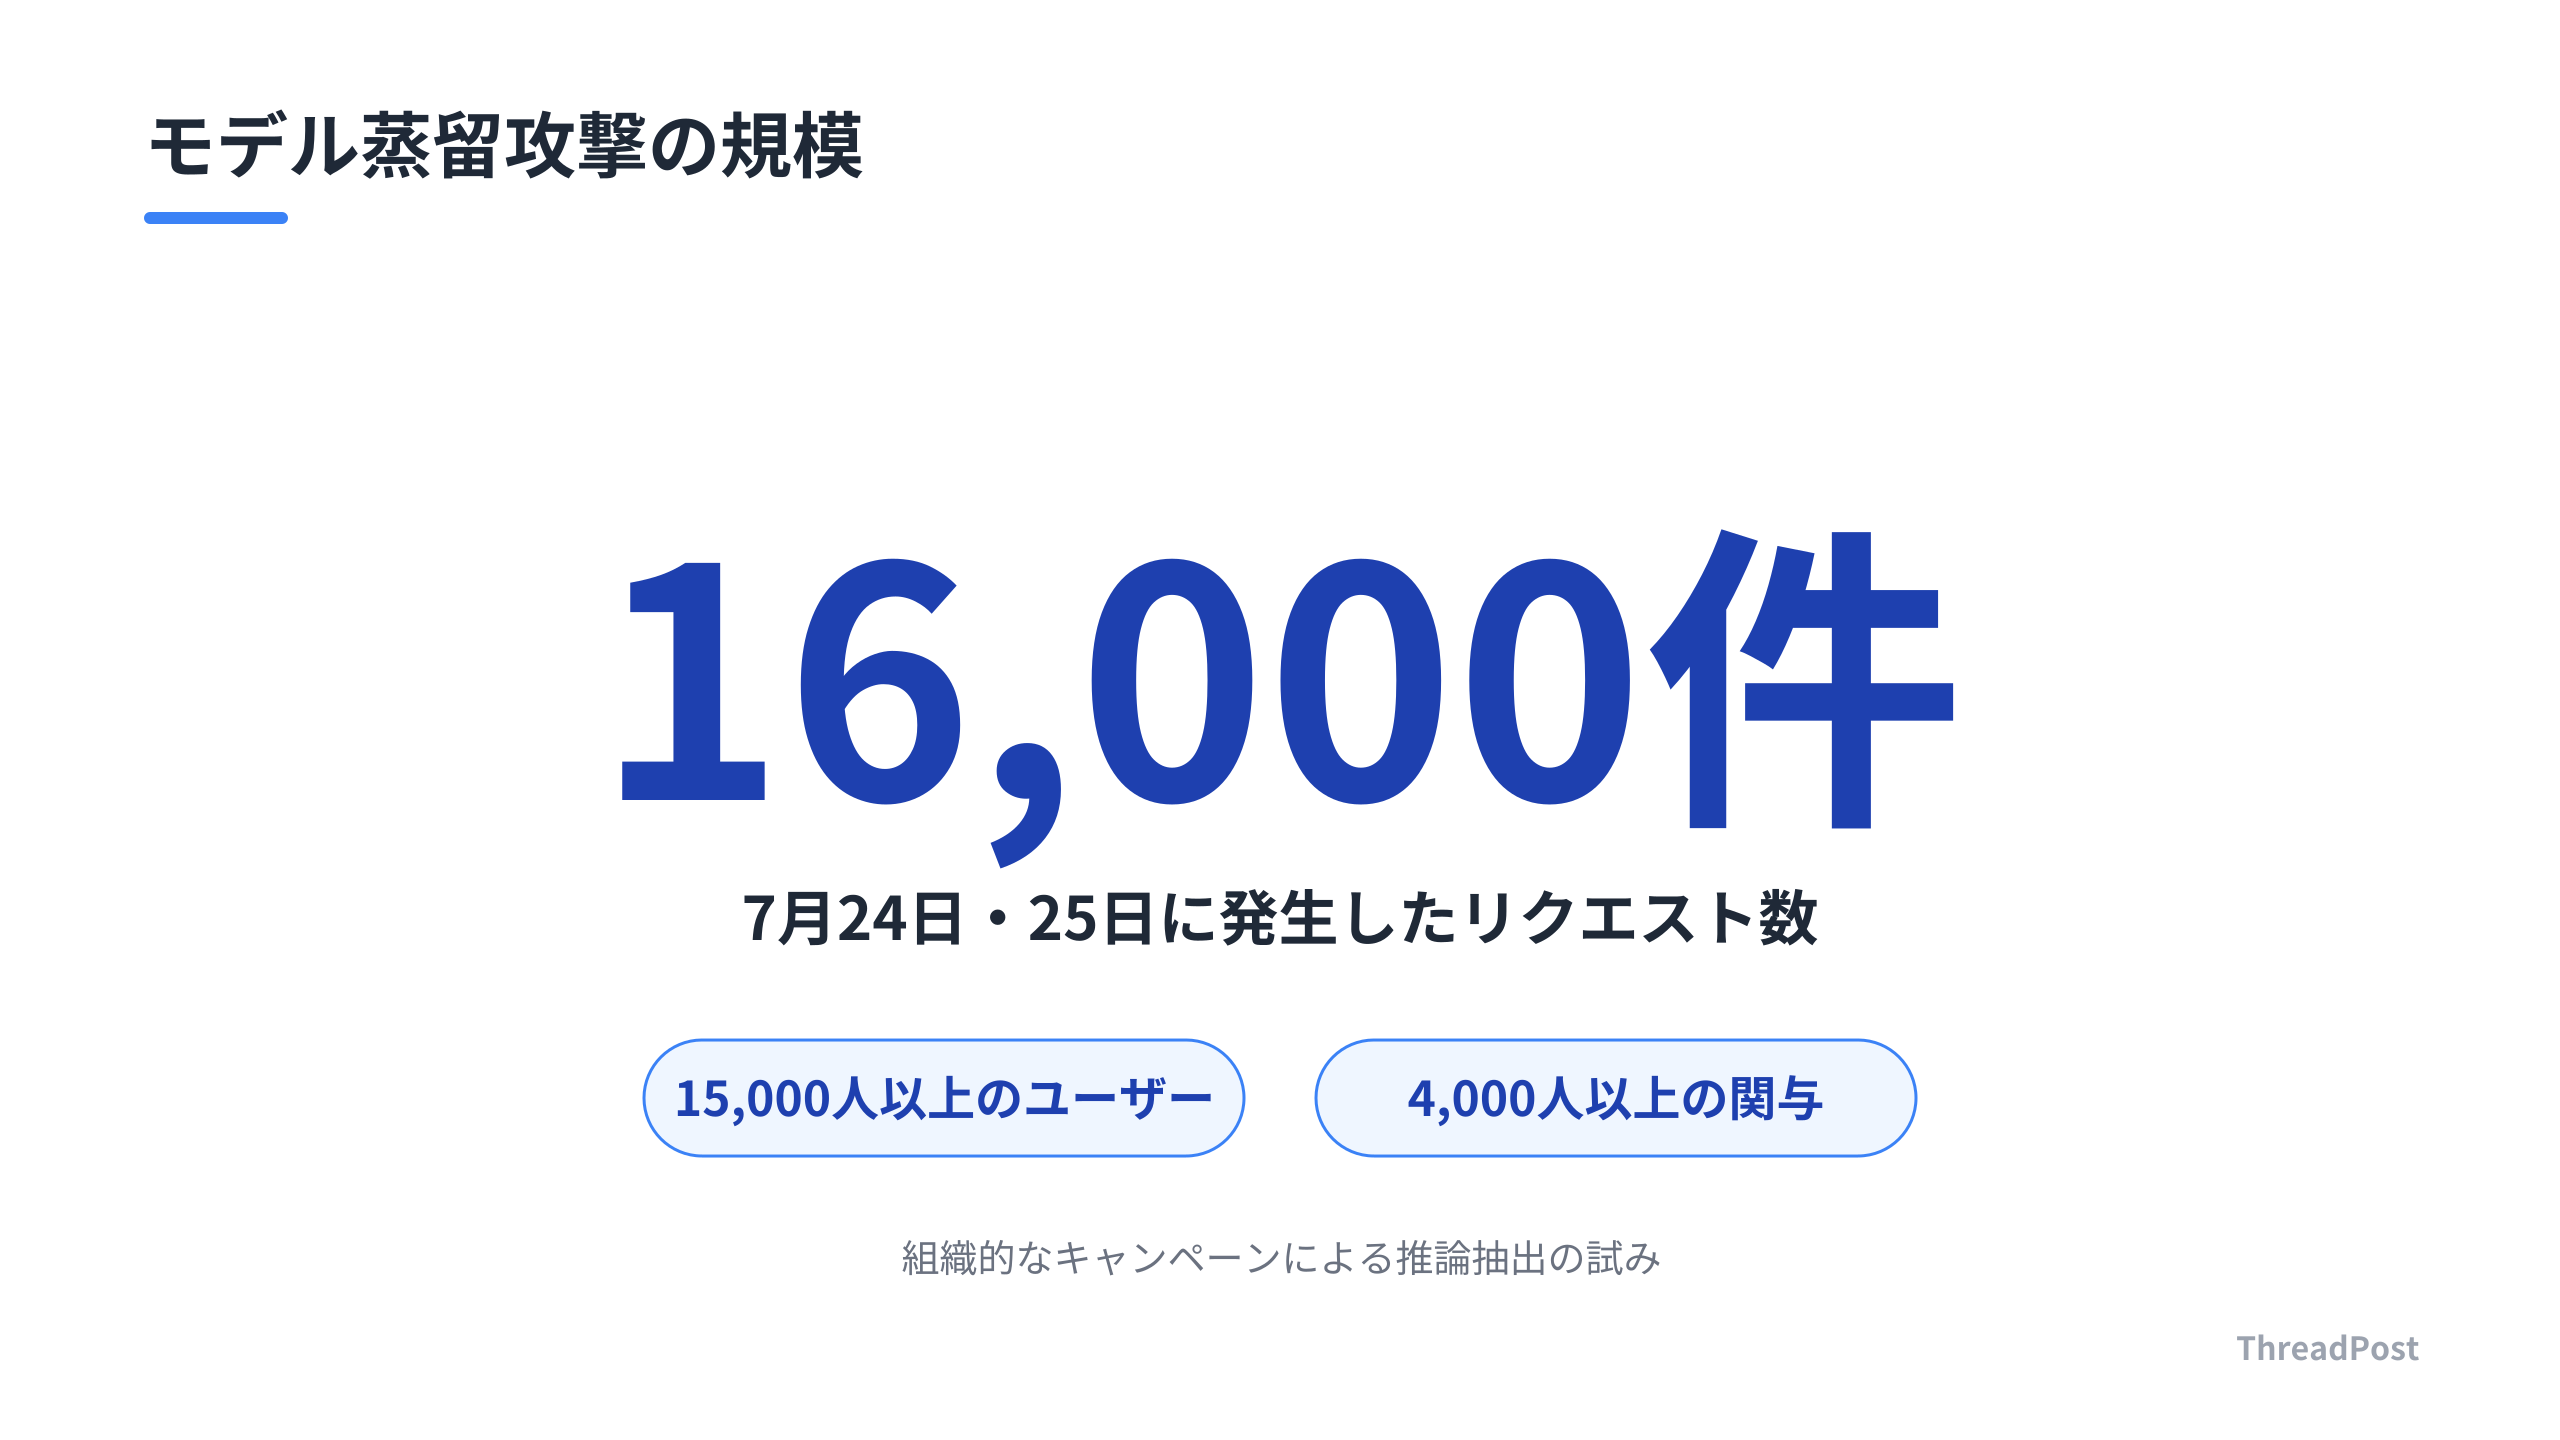
AIの「推論プロセス」が狙われている。OpenAIの公表データによると、高性能モデルの思考過程を抽出する「蒸留攻撃」が、1万5,000人以上のユーザーを巻き込む規模で発生した。
これは単なるハッキングではない。Claude Codeで実装する「Self-reflection(自己反省)」のような高度な推論ロジックが、攻撃者の標的となった。モデルの推論を守る防御の最前線を解説する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
狙われた「思考のプロセス」:OpenAIが直面した大規模蒸留攻撃の全貌
攻撃者が狙ったのは、モデルが最終回答に至るまでの「保護された推論(Protected Reasoning)」だ。
7月上旬、特定のプロンプトパターンを使い、モデルの内部思考を外部に出力させる手法が確認された。OpenAIの調査では、7月24日と25日に攻撃が急増し、2日間で1万6,000件の抽出リクエストが記録されている。7月28日までに、1万5,000人以上のユーザーが関与するクラスタを特定し、遮断した。
攻撃者は暗号化された推論過程を別の会話に持ち込み、別のモデルを使って「解読・書き起こし」をさせた。複数のモデルと会話を跨いで推論を再構築する、組織的なアプローチが取られた。
しんたろー:
暗号化された推論を別のモデルで解読させる手法が気になる。Claude Codeでローカル推論を回す際、自前での難読化が必要だと感じた。
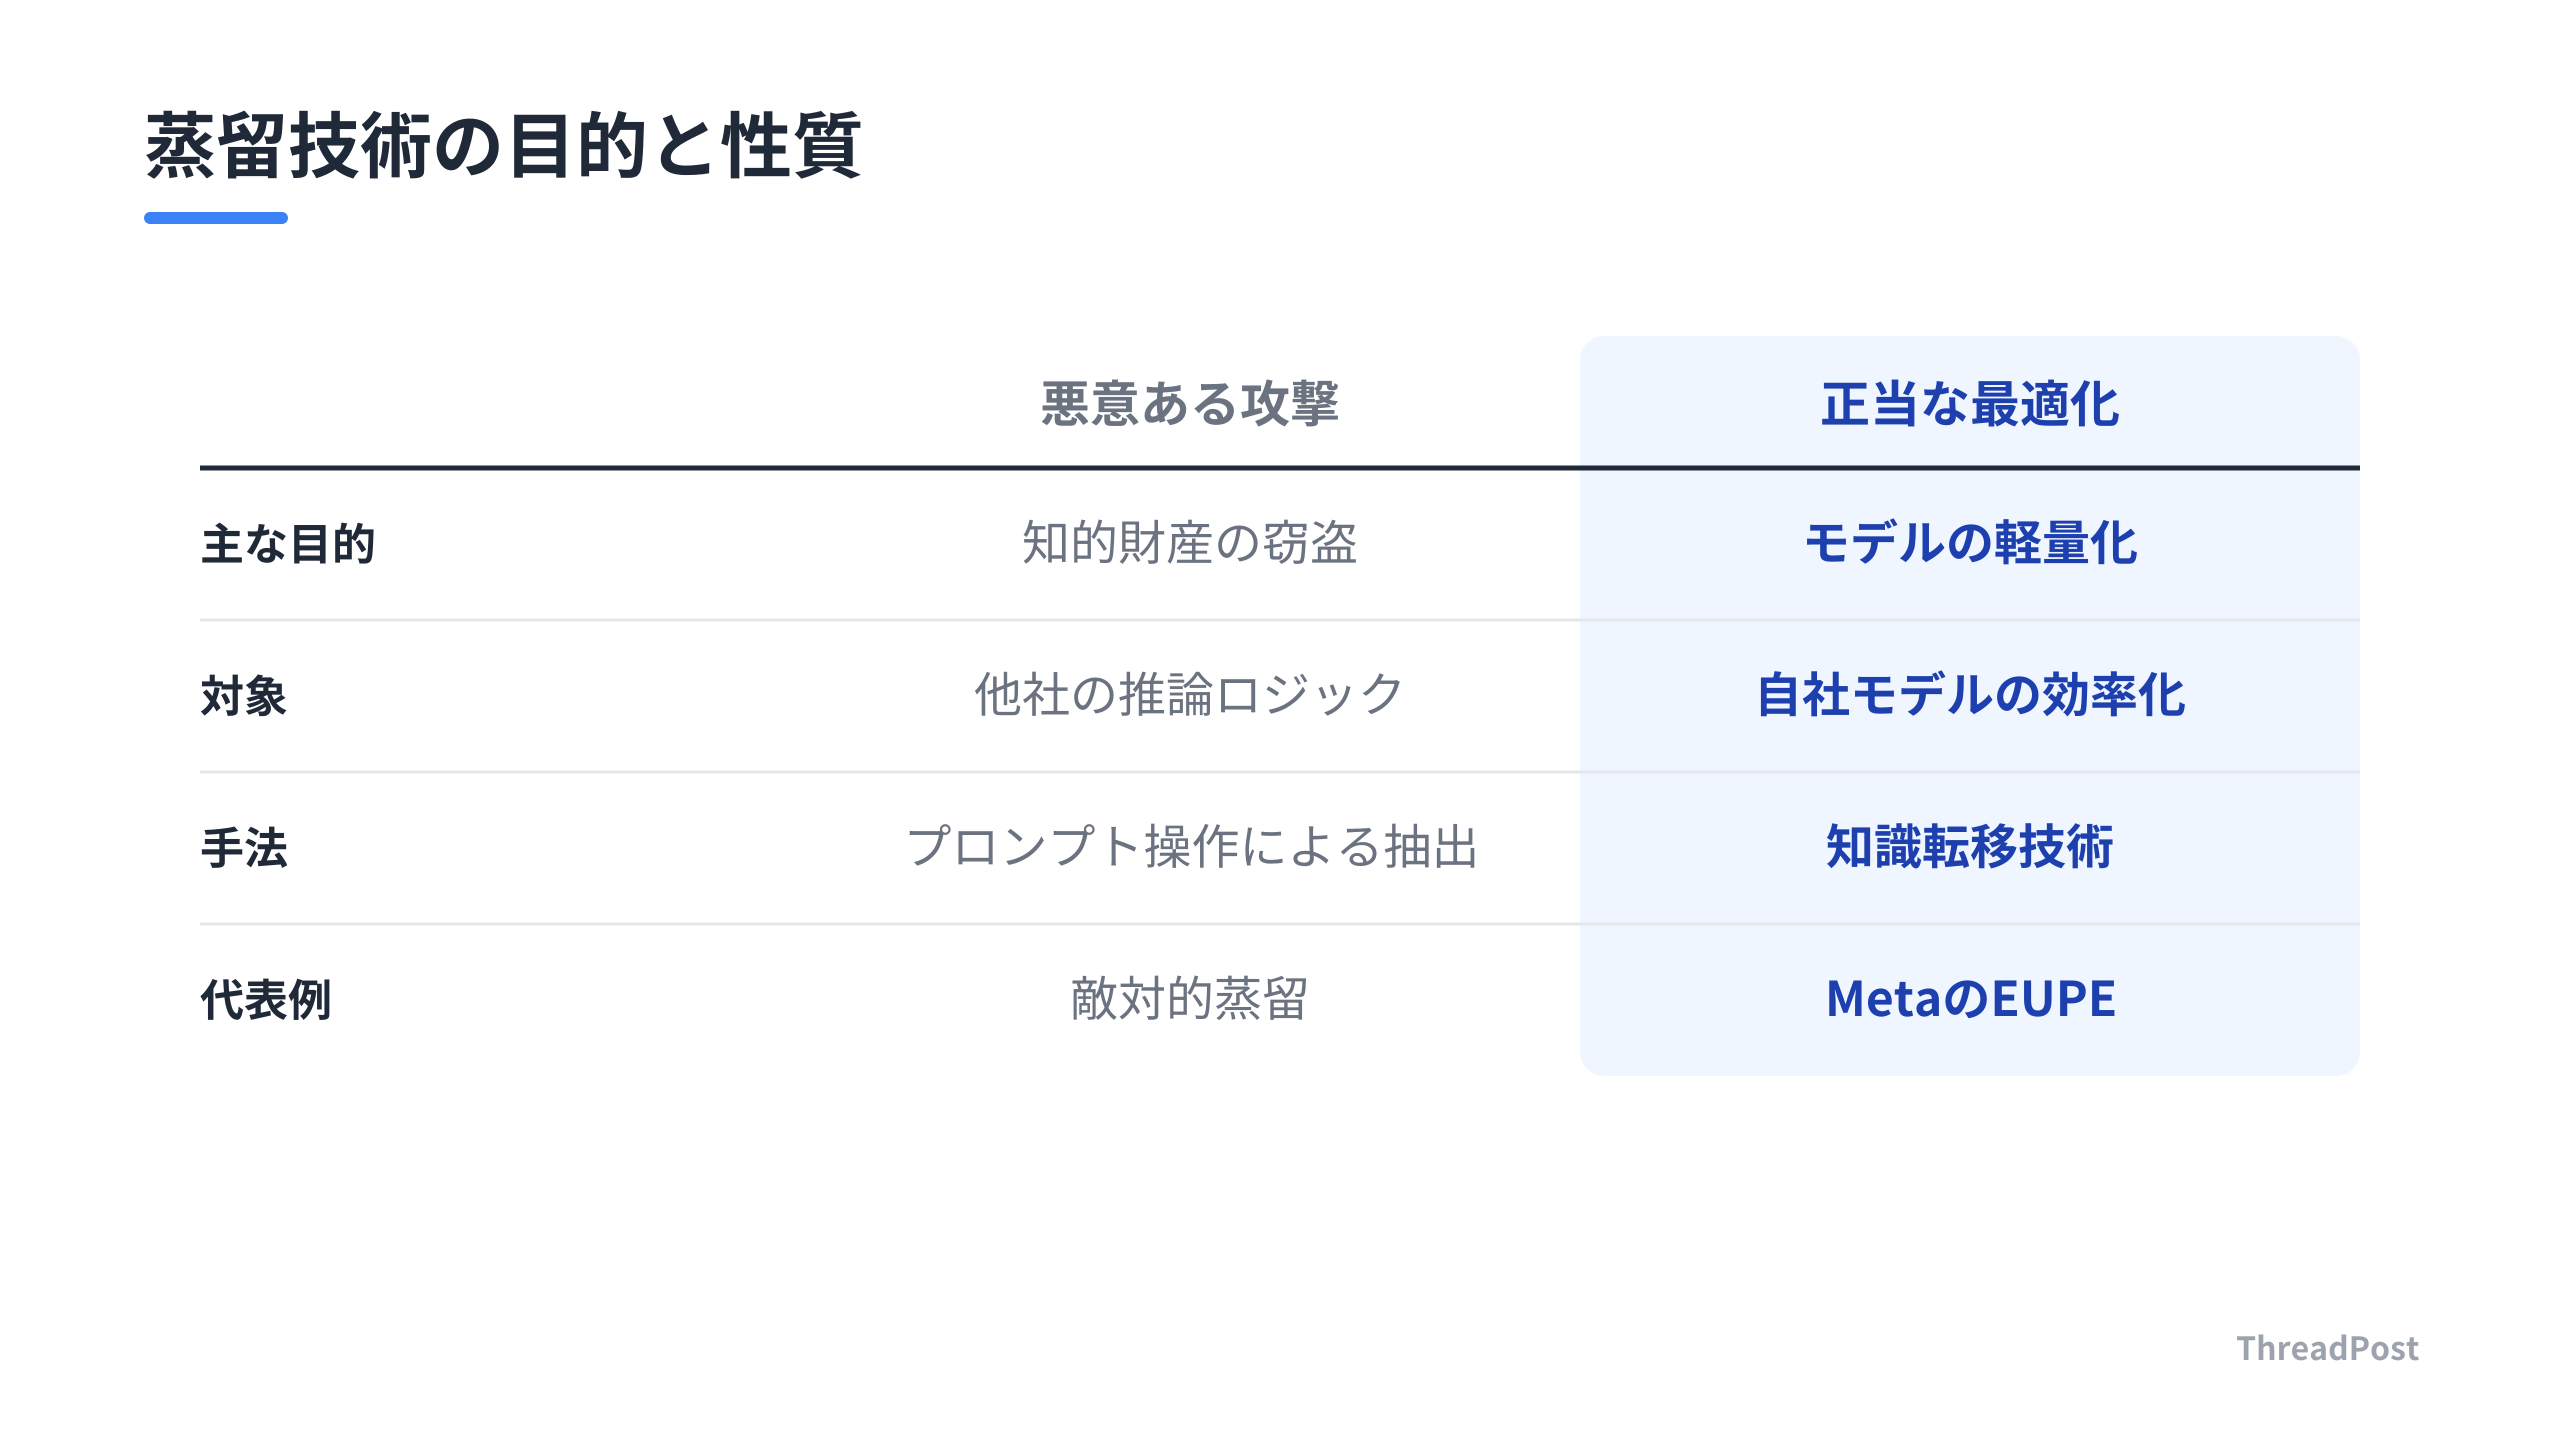
OpenAIは「モデルの暗号化やDBを破ったわけではない」と明言している。規約違反の方法でモデルと対話し、本来見えないはずの推論ロジックを「見える形式」に変換させたことが問題だ。
この脅威はOpenAI固有ではない。開発者が自社で「推論モデル」や「エージェント」を構築する際、推論の盗難は避けられないリスクとして浮上した。推論過程をクライアント側でどう管理し、外部から隔離するかが重要だ。
 あわせて読みたいClaude Codeの使い方完全ガイド|インストールから実践まで2年運用の開発者が解説 →
推論という名の「知的財産」をどう守るか
攻撃者はモデルの「重み」ではなく、モデルが内部で構築した「推論のプロセス(システム2)」を抽出して再現した。
LLMの性能競争において、各社は「いかに深く熟考できるか」という推論能力を競っている。これが流出することは、数千億円規模の投資で培った「AIの脳の動き」がコピーされることを意味する。
個人開発者やSaaS事業者は、自社構築した「AIエージェントの思考ロジック」が盗まれるリスクに直面している。Claude Codeのようにローカルで推論を回すツールでは、推論の痕跡がクライアント側の端末に残る。
メルカリの「端末・設定層」による防御戦略は、この文脈で有効だ。MDMで「特定のディレクトリやプロセスを読み取らせない」「MCPサーバーのホワイトリストを厳格化する」といった対策は、自社の「推論資産」を守る防波堤となる。
モデルの推論を賢くしても、受け取るクライアント側が脆弱なら意味がない。ThreadPostのAI生成ログをどう難読化するか、アーキテクチャの見直しを検討している。
「人間のようなシステム2(熟考)の実装」は開発者にとって諸刃の剣だ。Self-reflectionを実装すればハルシネーションは減るが、「AIが自分の思考を言語化する回数」が増える。思考のログを詳細に出せば、攻撃者に「パンくずリスト」を撒くことになる。
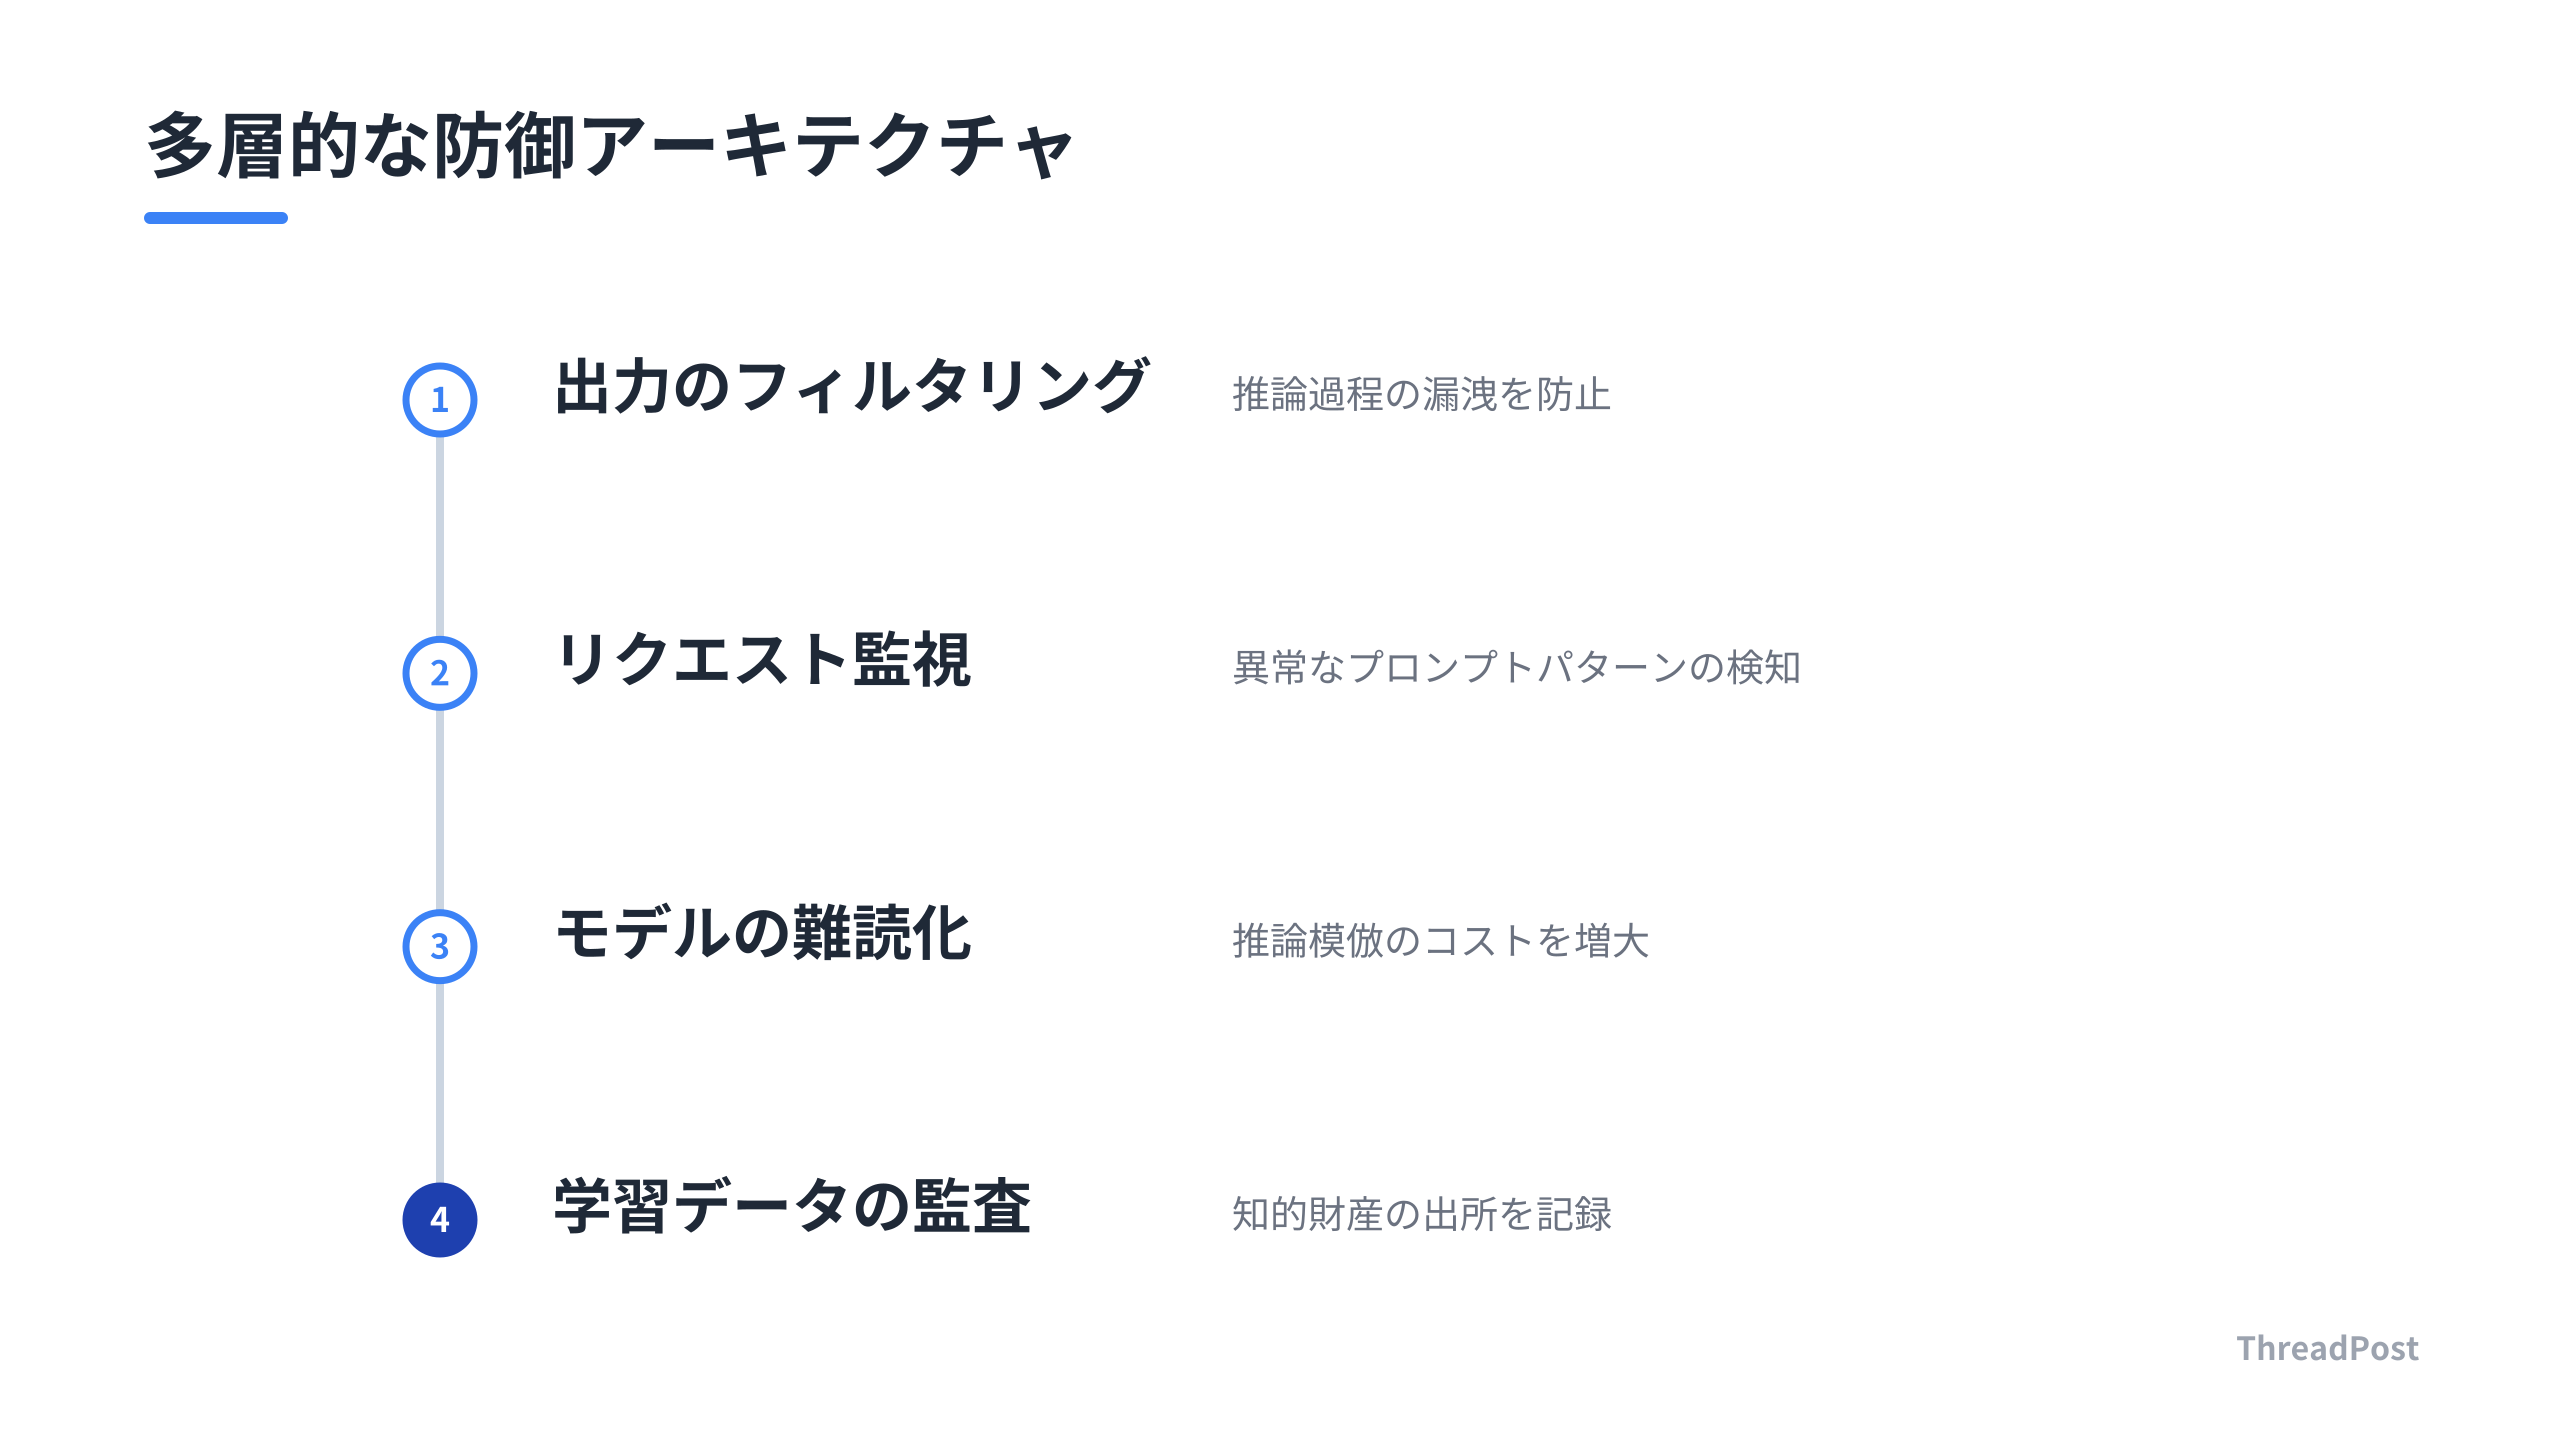
今後は「AIの思考過程をいかに不可視化するか」という設計が求められる。API経由でモデルを利用する場合、システムプロンプトや推論の痕跡を抽出させないための入出力フィルタリングは、必須のセキュリティ要件だ。
OpenAIの対応を見ると、暗号化やデータベース保護では防げなかった。攻撃者は「別のモデルに解読させる」というプロンプトの連鎖を利用した。これは従来のWAFやファイアウォールでは検知できない、LLM特有の「論理的なハッキング」だ。
開発者はAIの出力を鵜呑みにせず、出力が「どのような思考過程を経て生成されたか」を疑う必要がある。推論の透明性を確保しつつ、外部から抽出させないための「守りのアーキテクチャ」を設計図に組み込む。
Claude Codeのような自律型ツールを組織で使う場合、個々の開発者の端末が「推論抽出の踏み台」にされるリスクを考慮する。金融機関がAWS Bedrock経由で利用を限定するのは、AWSの監視網を噛ませることで、不審な推論パターンの抽出試行をリアルタイムで検知するガバナンス戦略だ。
LLMの競争優位性は「モデルの性能」と「それを守り抜くセキュリティ」の掛け算で決まる。推論が盗まれれば、その価値はゼロだ。開発者はAI機能を実装する際、自分のAIの推論がどこで盗まれるかを自問自答する。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
開発者が明日から意識すべき「推論を守る」ための3つのアクション
AIの「推論過程」をブラックボックス化しつつ、実行環境を固める必要がある。以下の3つのポイントを実装の優先リストに追加する。
一つ目は、「思考過程の分離」だ。AIエージェントに複雑なタスクをさせる際、ユーザーの画面にChain of Thoughtを垂れ流さない。推論の痕跡は内部ログとして保存し、ユーザーには最終的な回答だけを返すインターフェースにする。
二つ目は、「入出力フィルタリングの多層化」だ。API経由でモデルを叩く際、推論結果を再帰的に生成させる不審なリクエストパターンを検知するゲートウェイを挟む。Claude Codeをチーム導入しているなら、MDMによる設定配布は前提条件だ。
三つ目は、「セルフリフレクションの検証」だ。自己反省プロセスはハルシネーションを減らすが、モデルの修正ロジックを攻撃者に教える側面もある。重要なビジネスロジックを扱うAIには、LLM内部の自己反省だけでなく、外部のバリデーターによる「客観的なチェック」を通す。
Claude Codeで思考過程を全部見たくなるが、それが「AIの脳みその抜き取りマニュアル」になる可能性がある。便利さとセキュリティのトレードオフを設計する必要がある。
AIアプリの価値は「推論の質」だ。心臓部を保護するのはモデル提供側の責任だけではない。APIを利用する開発者が、どのような実行環境でAIを走らせ、どのようなデータを外に漏らさないかという「守りのアーキテクチャ」が、今後の差別化要因になる。
まずは、自分のプロジェクトのプロンプト構成を見直し、思考の痕跡が外部から容易に抽出できる状態になっていないかチェックする。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
Q1: モデルの蒸留攻撃とは具体的に何が起きているのですか?
高性能なAIの出力や推論プロセスを悪用して、別の安価なモデルを訓練し、元のモデルの能力を模倣・再現する行為です。モデル内部の論理的な思考過程までを抽出して学習に利用するため、元のモデルが多額の投資と安全対策を施して構築した「知的な資産」が盗まれるのが脅威です。
Q2: 自社でAIエージェントを開発する際、推論の盗難を防ぐための具体的な対策はありますか?
「推論過程(Chain of Thought)」をユーザーへ直接表示しない設計が基本です。API経由でモデルを利用する場合、プロンプトインジェクション対策を強化し、システムプロンプトや推論の痕跡を抽出させない入出力フィルタリングを実装してください。クライアント側の実行環境で権限を制限し、不審なリクエストパターンを監視する「多層防御」を組み合わせます。
Q3: Self-reflection(自己反省)を実装すればハルシネーションは完全に消えますか?
完全に消えるわけではありません。Self-reflectionは論理的な矛盾を指摘するプロセスですが、ベースとなる「直感的な次トークン予測」が誤情報を持っている場合、自己反省自体が「もっともらしい嘘」を補強する可能性があるからです。定規となる外部ツールやRAGを併用し、客観的な事実と照らし合わせる仕組みを組み込みます。
まとめ
AIの「推論」はモデルの性能を左右する最大の資産であり、攻撃者にとって最も価値のある標的です。
Claude Codeのようなツールで自律的なエージェントを開発する場合、「推論プロセス」という知的財産をどう守り、制御するかという課題があります。開発者として、モデルの進化を追うだけでなく、実行環境のガバナンスまで含めた「守りのアーキテクチャ」を設計することが必須スキルです。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
