


モデルの性能を追いかける時代は終わった。開発者の主戦場はAPIコストの抑制とレイテンシの削減というインフラ設計に移っている。
AnthropicやOpenAIの最新動向は一つの答えを提示している。巨大モデルを無闇に叩くのではなく、プロンプトキャッシュとコンパクションを駆使して推論の質とコストを最適化するアーキテクチャだ。
この記事では、Claude Codeで1人SaaSを開発する中で見つけた、GPT-6 Astraを実務で使い倒すための戦略を共有する。APIコストを95%削減し、自律エージェントの精度を最大化する設計の全貌を数字と事実で解説する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
GPT-6 Astraが提示する推論コストの最適解
GPT-6シリーズのガイドラインは開発者の推論コストに対する考え方を一変させた。次世代のAI開発におけるスタンダードは、モデルの賢さよりもプロンプトキャッシュとコンパクションを駆使したインフラ設計にある。
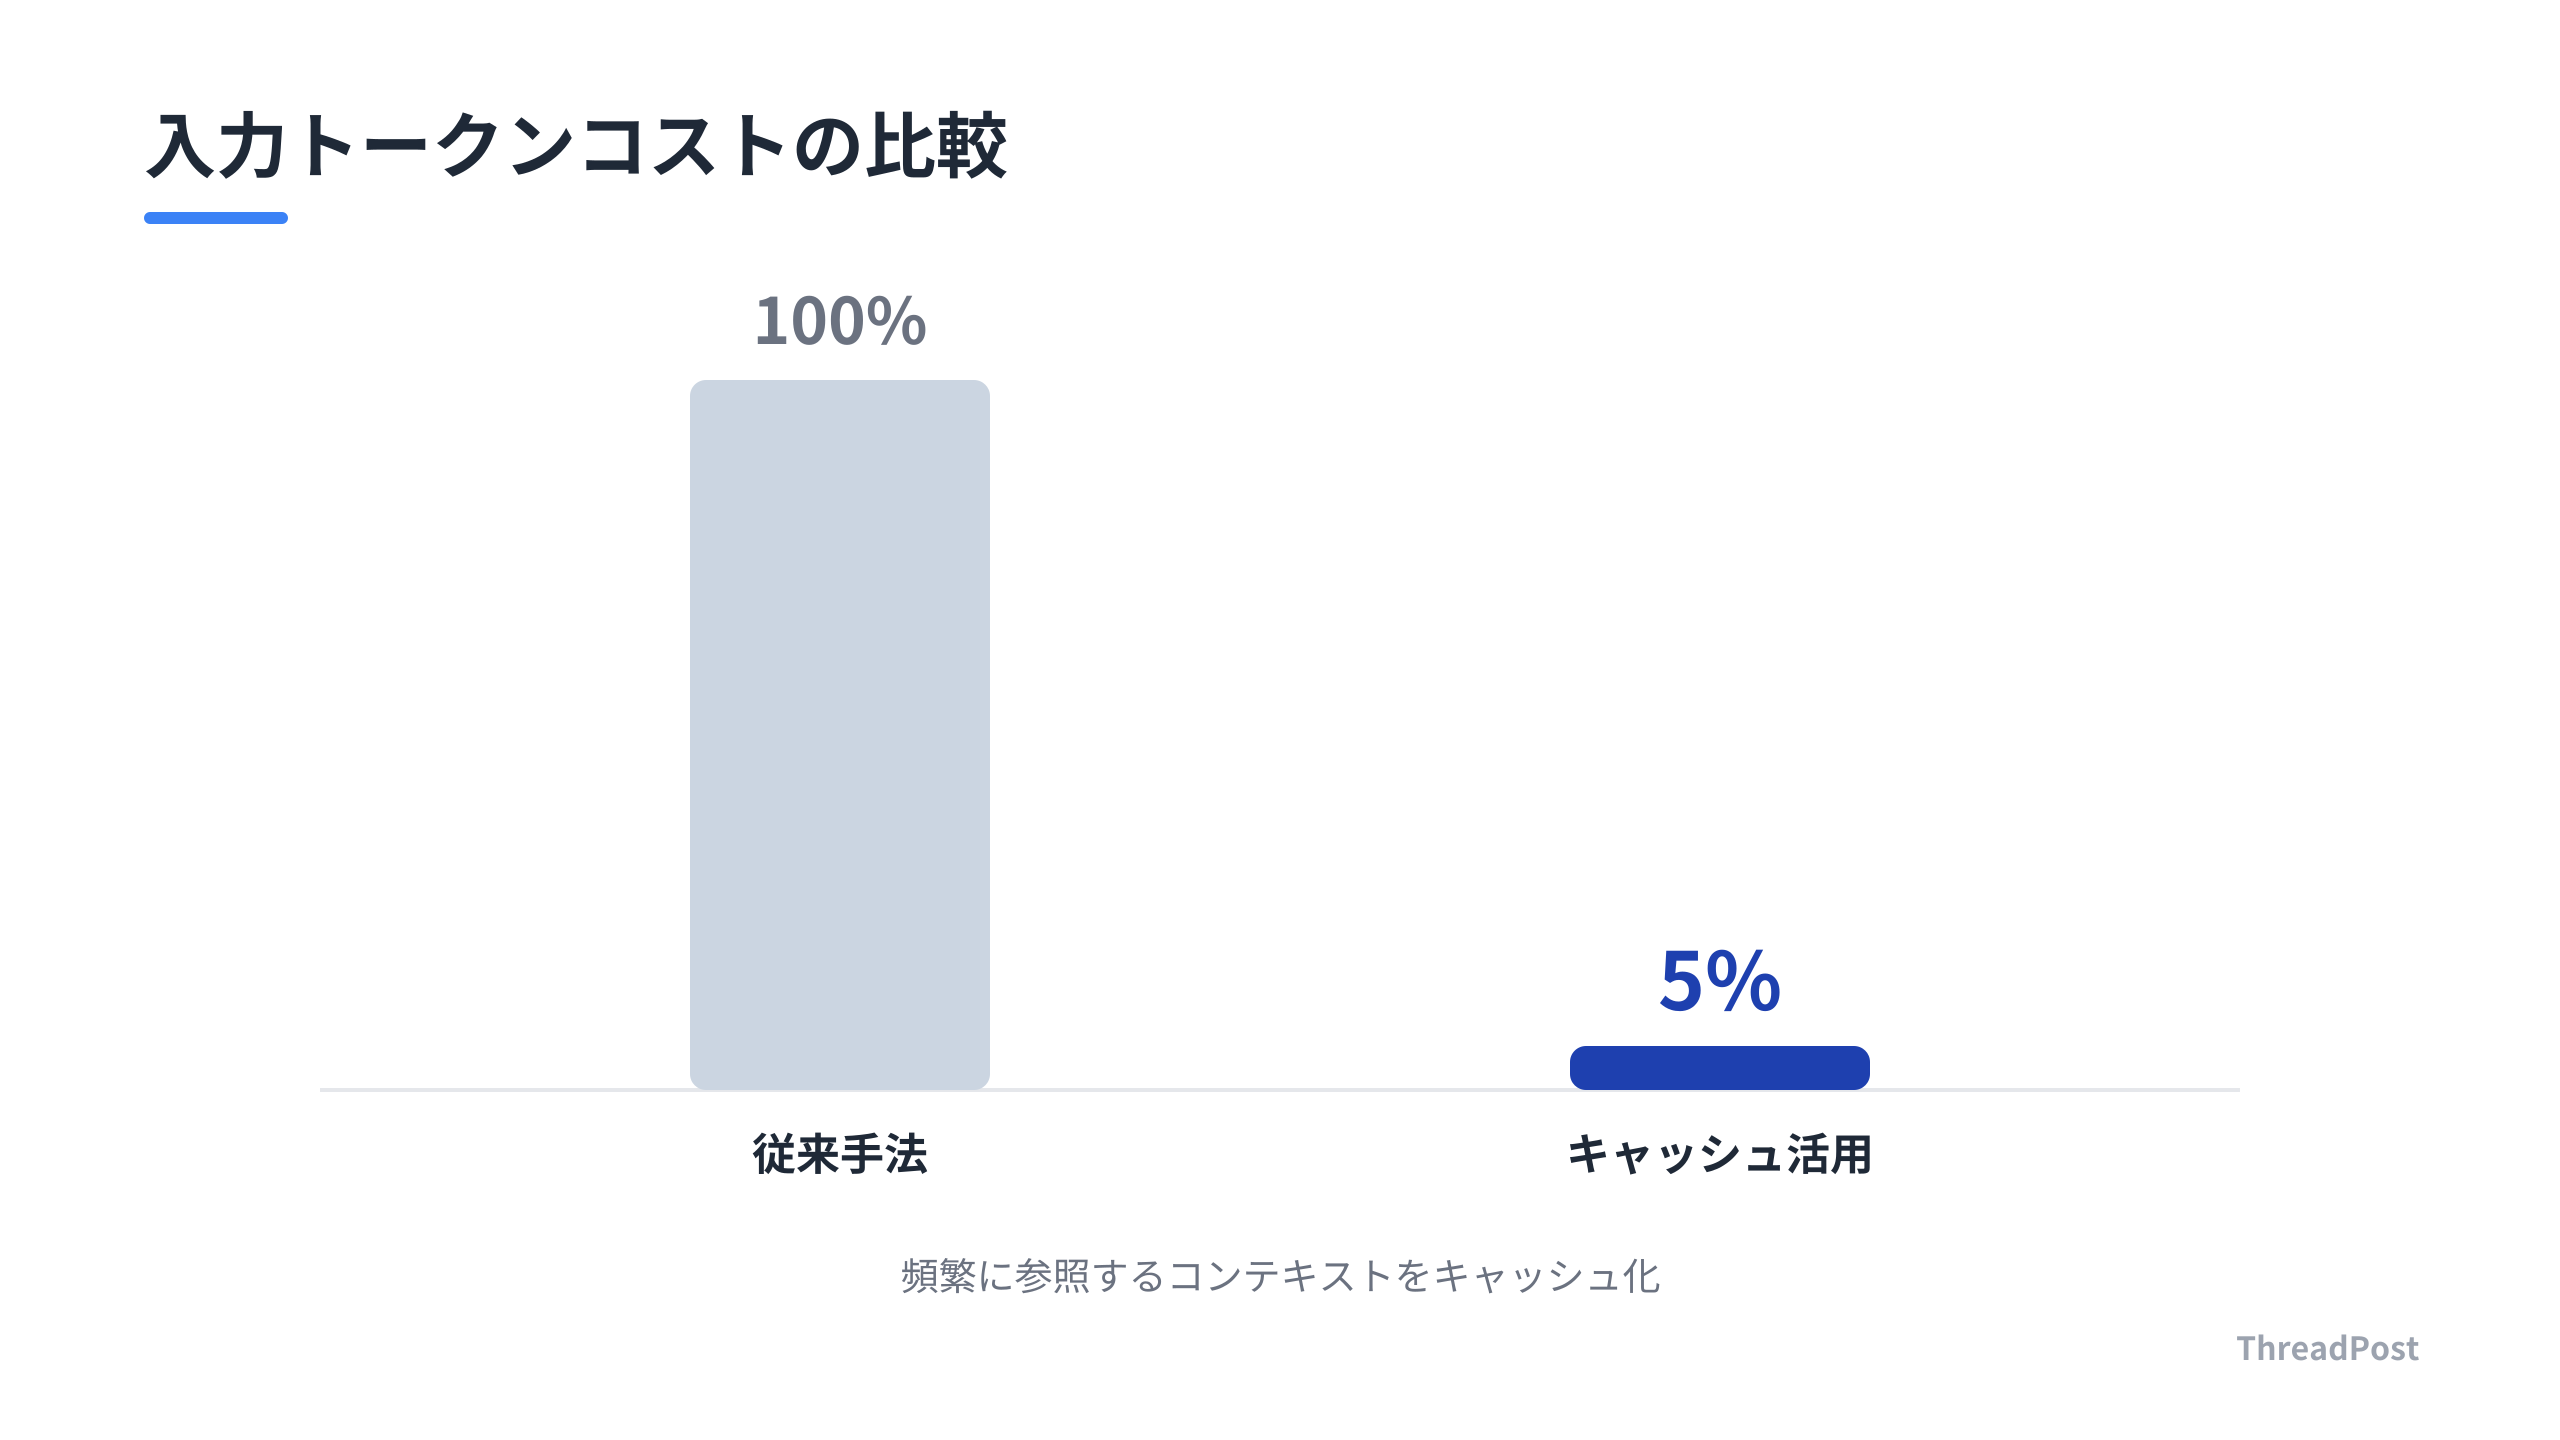
プロンプトキャッシュの活用はコスト削減に直結する。頻繁に参照するシステムプロンプトや長大なリポジトリ情報をキャッシュすることで、入力トークンのコストを最大95%削減できる。APIを叩くたびに全コンテキストを再送していた従来の手法から、運用コストを大幅に下げる技術だ。
ワークフローの効率化においてコンパクションも重要だ。タスクに不要なコンテキストを削ぎ落とし、モデルが必要な情報だけを抽出して推論を行うことでレイテンシを最小化する。独立したタスクを並列で実行させる並列処理アーキテクチャと組み合わせることで、複雑なマルチステップのワークフローを効率的に捌くことが可能だ。
しんたろー:
95%削減はインパクトが大きい。Claude Codeでリポジトリ全体を読み込ませる際、毎回フルでトークン消費すると財布が厳しい。キャッシュの管理をアーキテクチャの優先事項にしないと、SaaSの利益率が溶ける未来が待っている。
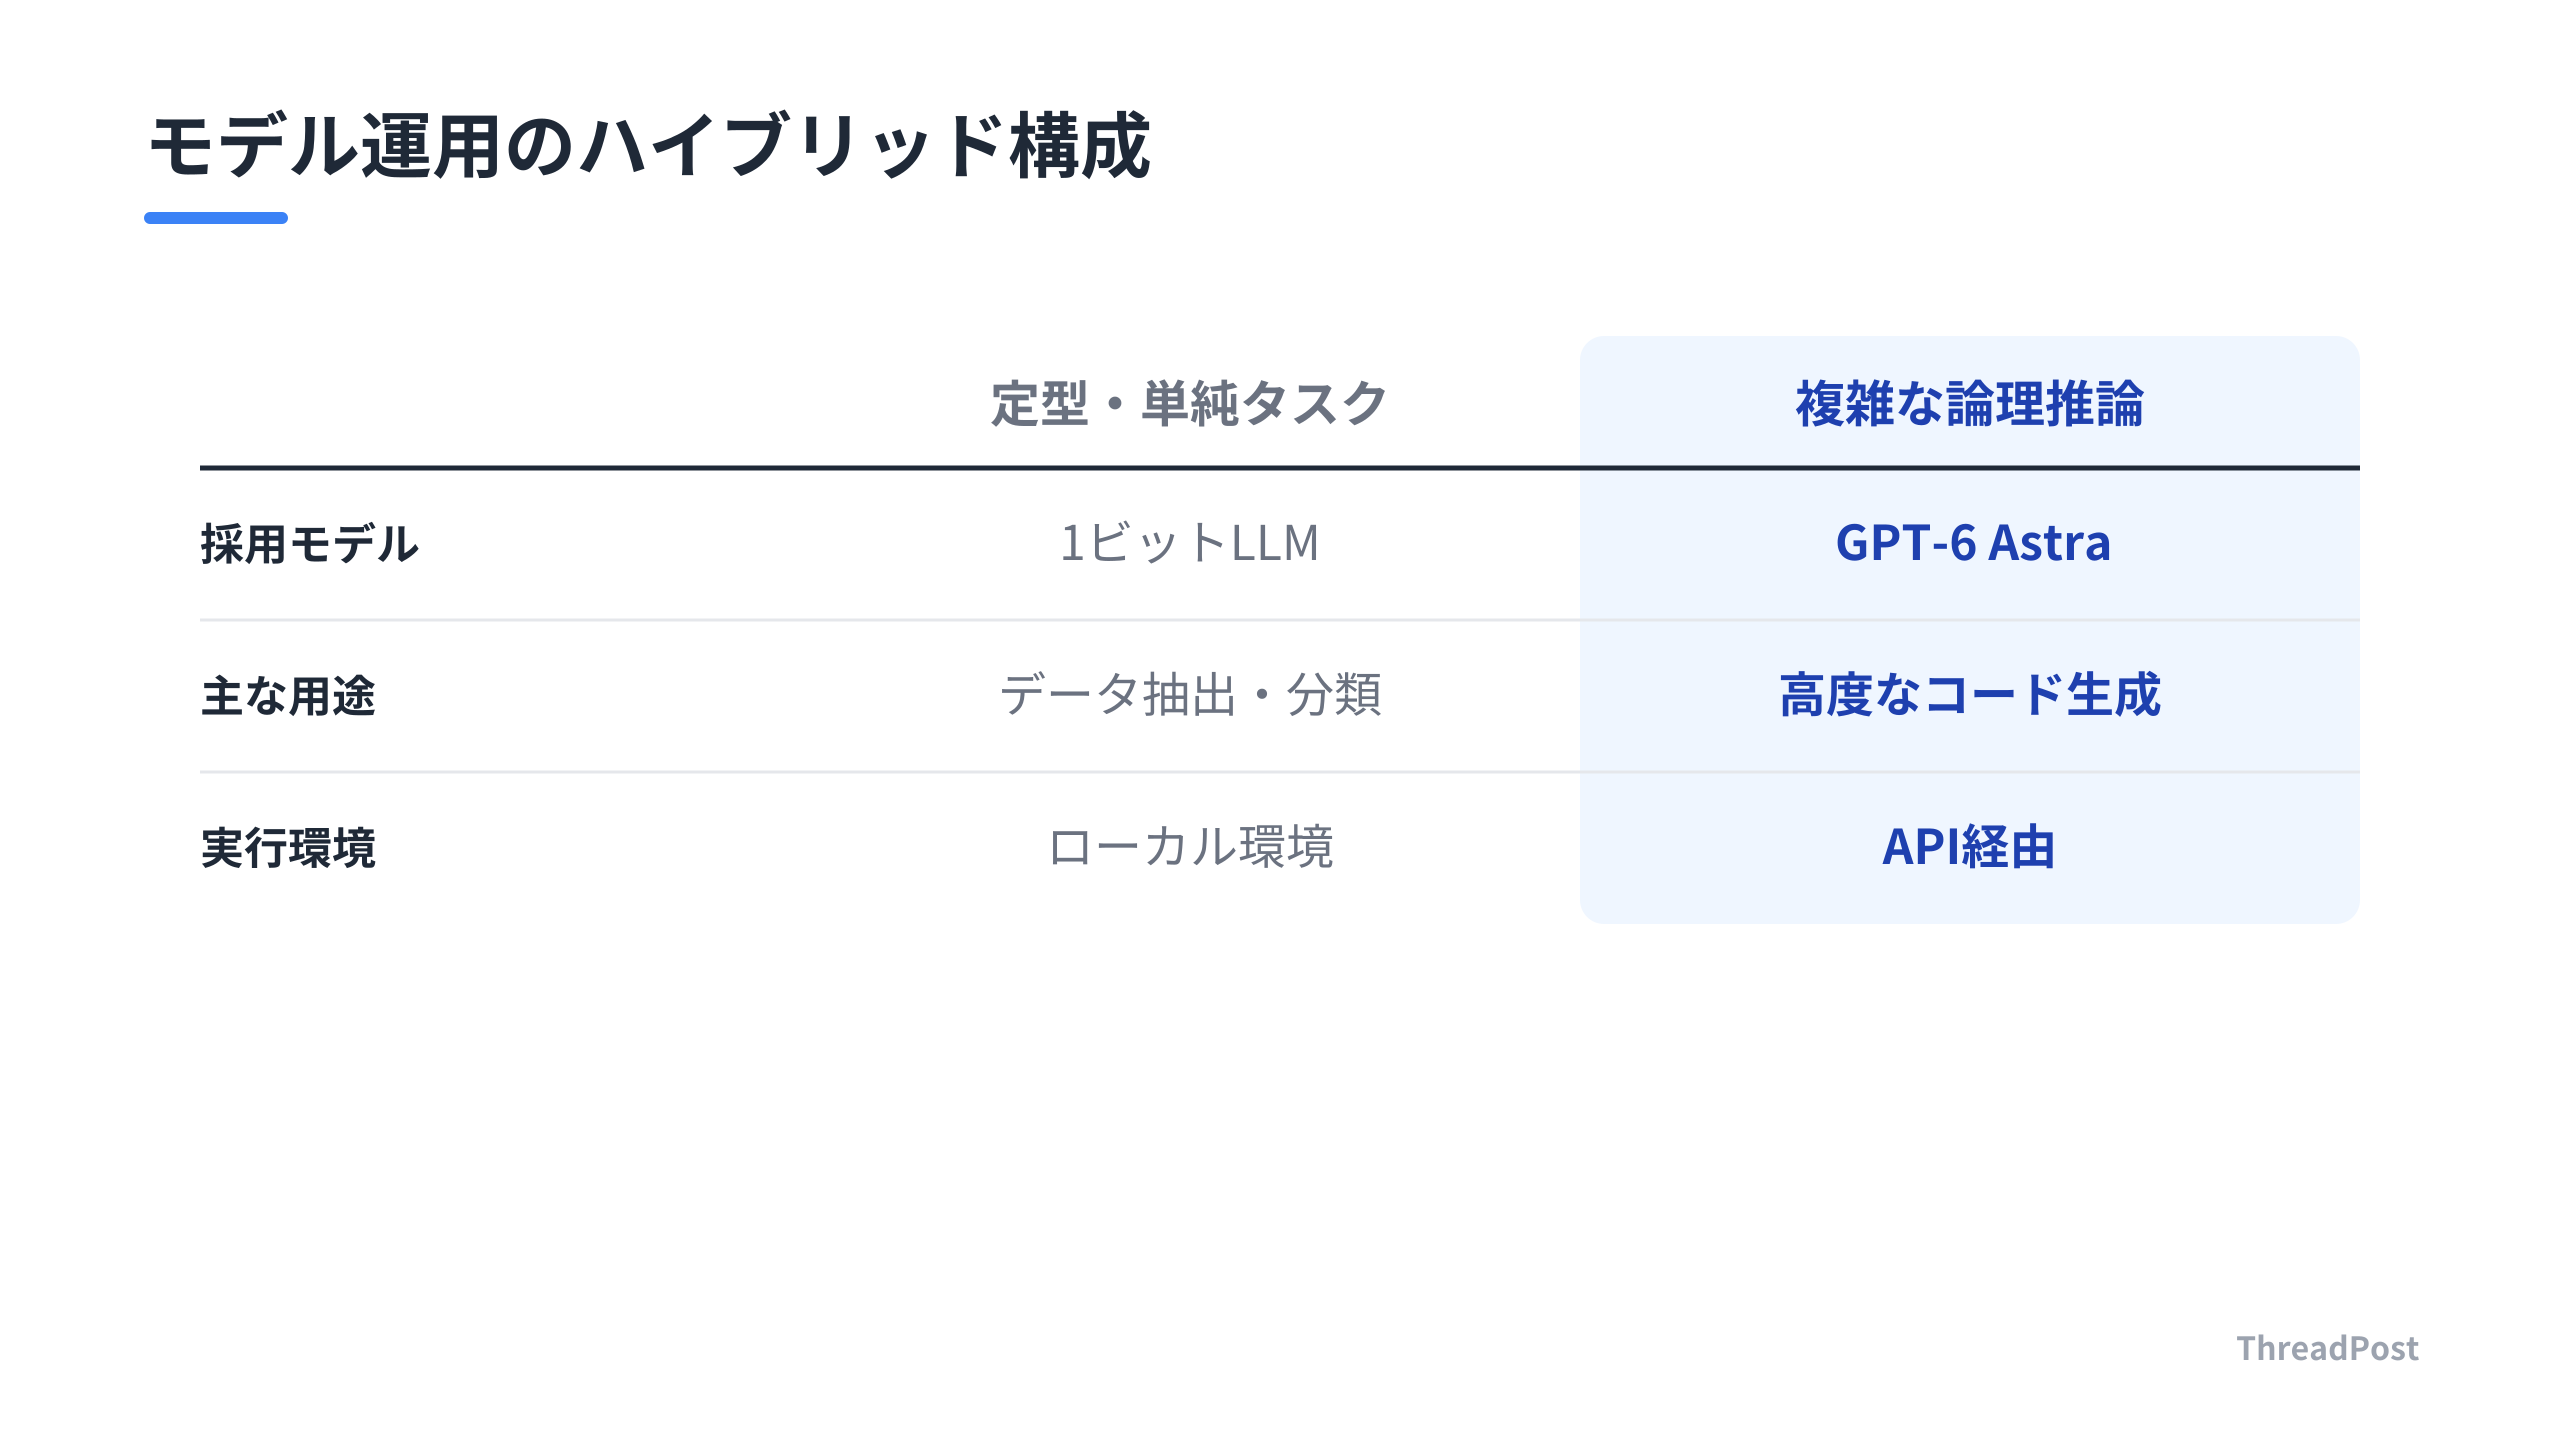
モデル選択の指針も明確化された。複雑な推論を要するタスクにはGPT-6 Astraを採用し、定型的なデータ処理やバッチ処理には、軽量かつ高速なGPT-6 Lunaを割り当てるハイブリッド構成が推奨されている。推論の質とコストをタスク単位で制御するアプローチだ。
AI開発はプロンプトエンジニアリングから、キャッシュとツール呼び出しを制御するエンジニアリングへと成熟した。モデルの性能を追いかけるだけでなく、いかに効率よくキャッシュを回し、コストを抑えて自律エージェントを走らせるかがプロダクトの生存戦略となる。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
インフラとしてのAI:コスト最適化と自律制御への転換
GPT-6 Astraが提示したプロンプトキャッシュとコンパクションの仕組みは、開発の焦点を「モデル選び」から「キャッシュの使い回しとコンテキストの圧縮」というインフラエンジニアリングの視点へ移行させた。
キャッシュされた入力トークンのコストが最大で95%削減される点は、1人SaaS開発者にとって利益率を改善するレバレッジポイントだ。APIコストを恐れて断念していた長期的なコード解析や、リポジトリ全体を横断するような自律エージェントの運用が現実的なコスト感で実行可能になる。
複雑な論理推論はAPIに投げ、構造化データの抽出や単純なフィルタリングは軽量モデルで処理する。このハイブリッド構成が次世代のAI開発における標準アーキテクチャだ。
Claude Codeでリポジトリ全体を走らせるとトークン消費が跳ね上がる。キャッシュを賢く回してAPI代を95%カットできれば、その分をサーバー代や別のツールへの投資に回せる。モデルの性能を追うのもいいが、地味な最適化の積み重ねが長く生き残るコツだ。
モデルに何でも考えさせるのではなく、タグベースで外部ツールを叩かせるアプローチも現場を変える。モデルの出力を信頼しすぎず、いかにツールとキャッシュでガードレールを敷くか。大規模なモデルを単体で動かす時代は終わり、モデル、キャッシュ、ツールをどう組み合わせるかというシステム設計のセンスが問われるフェーズに入った。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
実務への影響:コスト意識とアーキテクチャの再定義
GPT-6のような高性能モデルをフル稼働させることは、APIコストの観点から見て非効率的だ。タスクの複雑さに応じてモデルの使い分けとキャッシュ戦略を徹底することが、プロダクトの利益率に直結する。
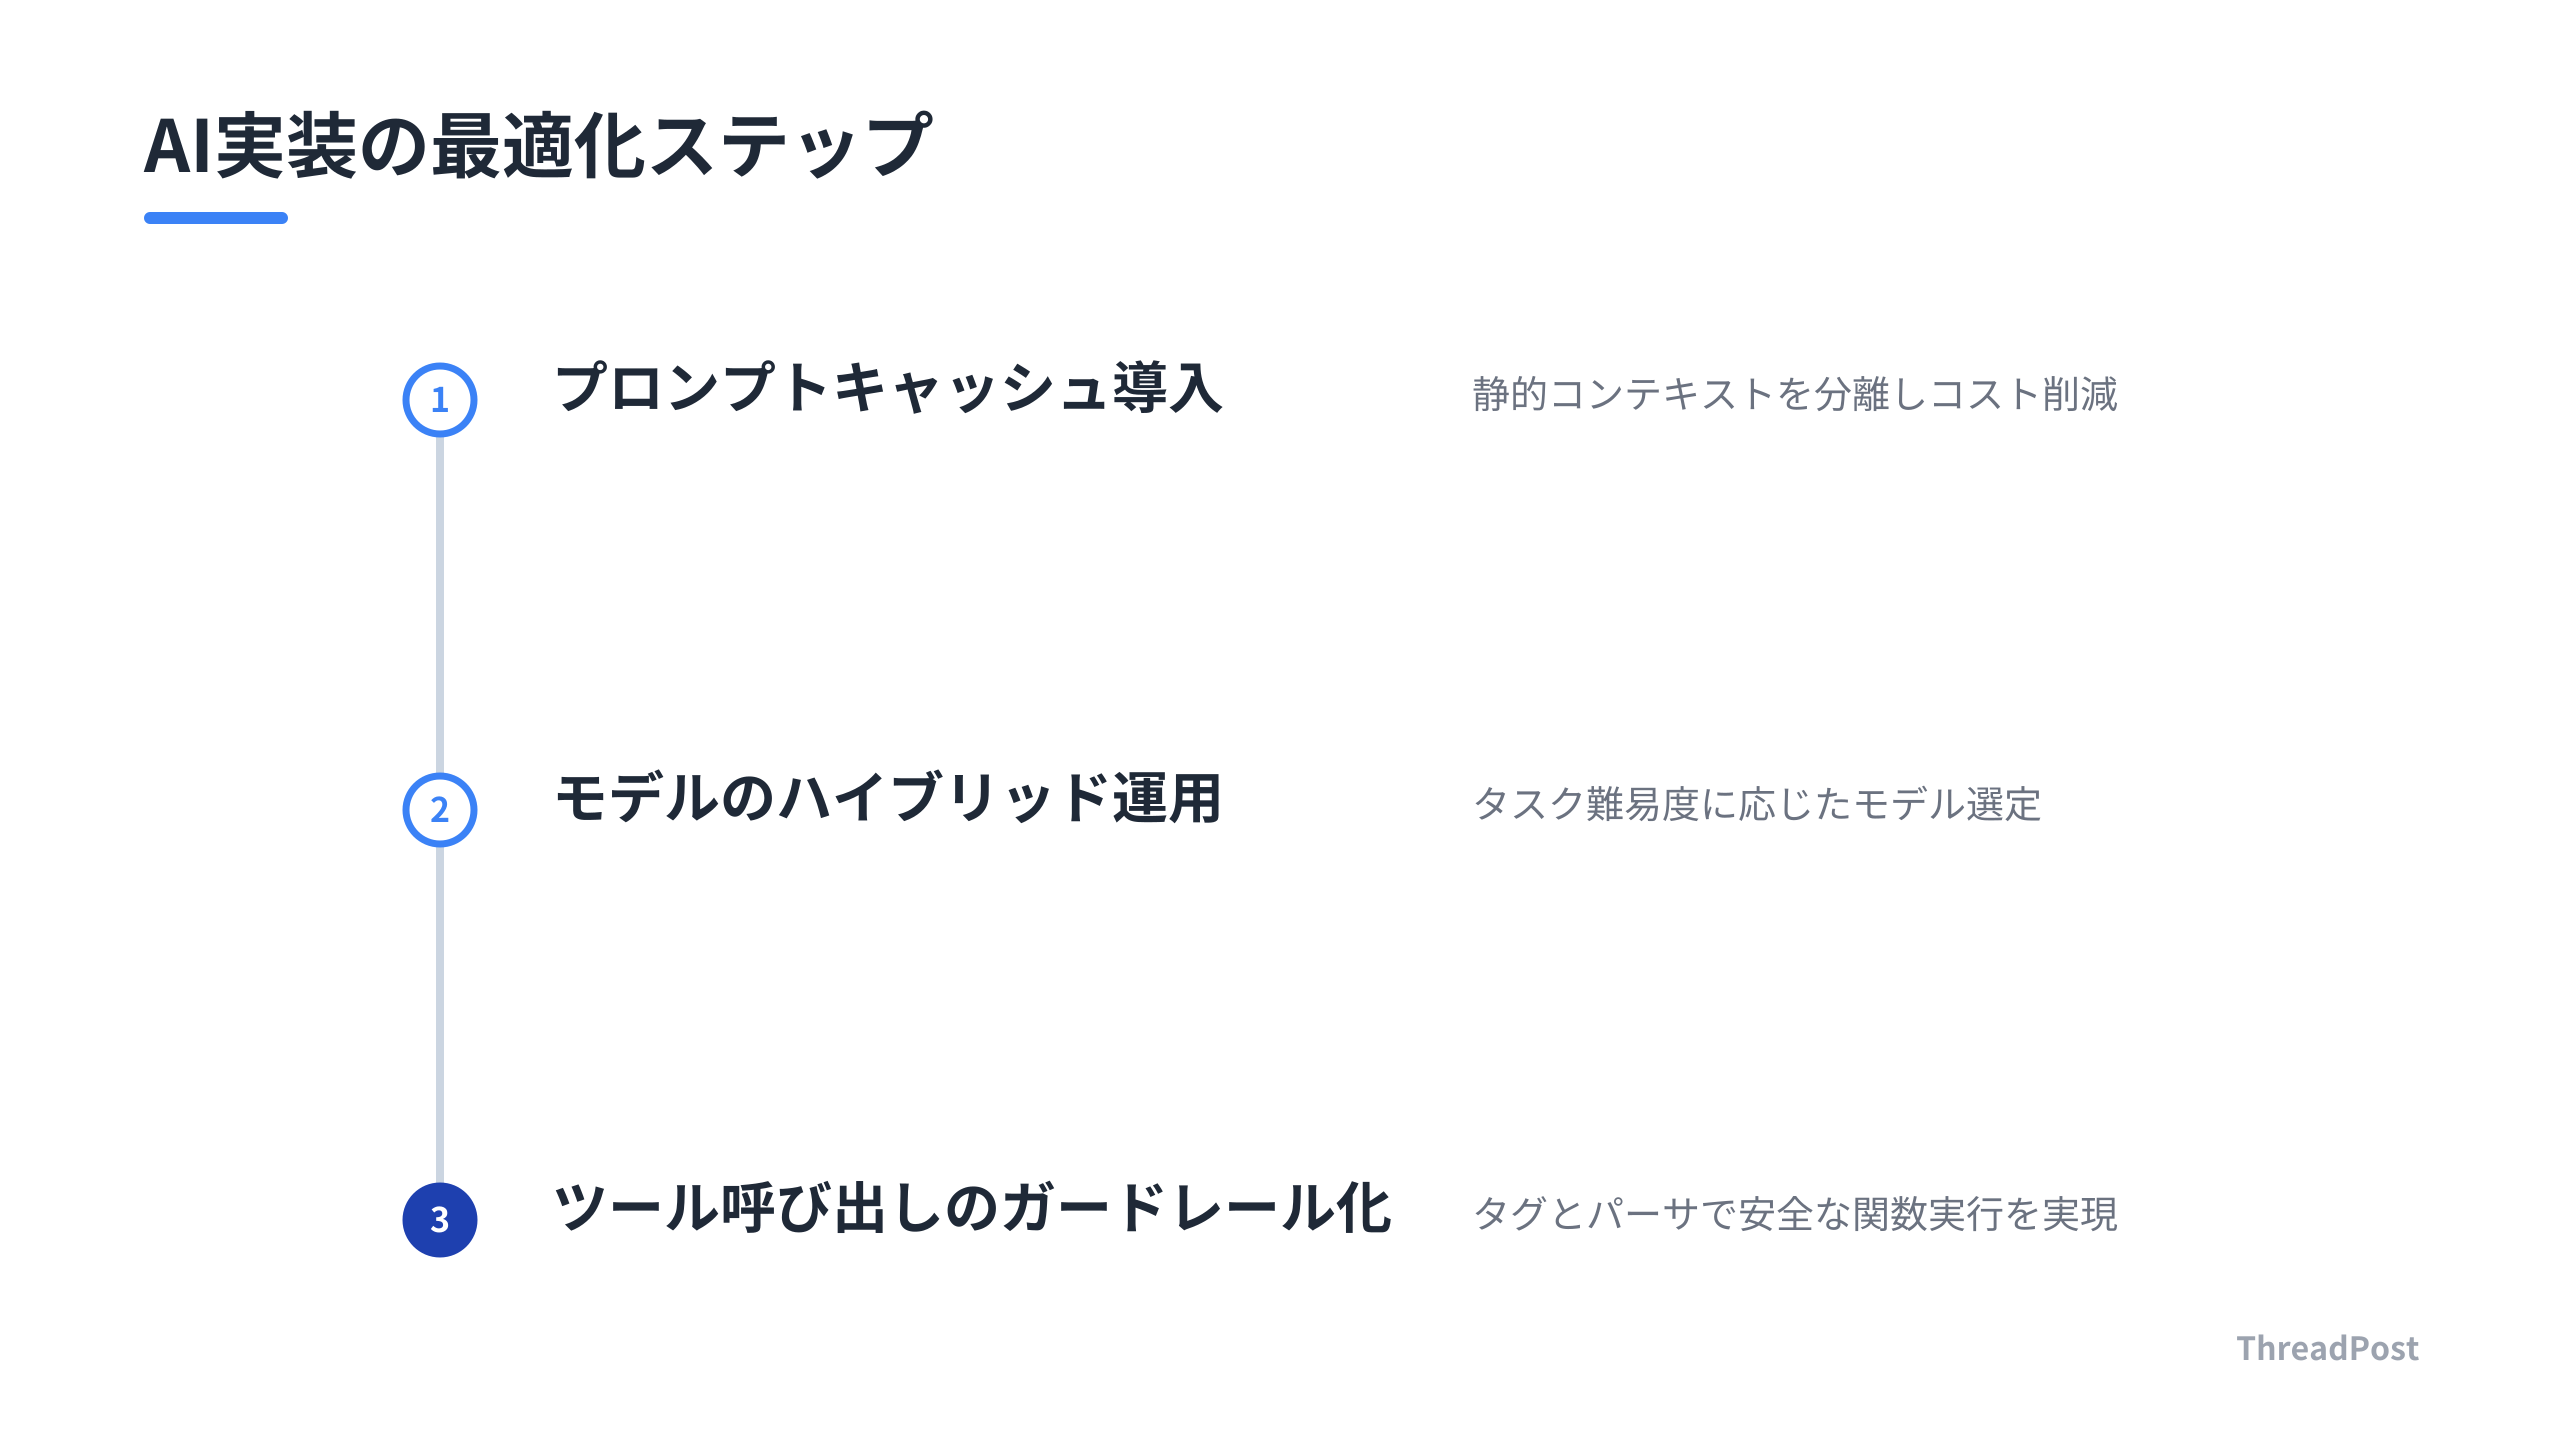
以下の3つのアクションが実務の標準となる。
第一に、プロンプトキャッシュの導入だ。繰り返し発生するAPIリクエストやシステムプロンプト、頻繁に参照するドキュメントをキャッシュに載せることで、入力コストを最大95%削減できる。レイテンシの改善にも直結する。
第二に、モデルのハイブリッド運用の構造化だ。複雑なロジック判断にはGPT-6 Astraを割り当て、単純なデータ抽出やフォーマット変換には軽量モデルを走らせる。すべてをクラウドの高性能モデルに投げる設計は避けるべきだ。
第三に、ツール呼び出しのガードレール化である。モデルには特定のタグを介してツールを提案させ、Python側のパーサで引数を検証してから実行する。モデルを信用しすぎない設計がプロダクトの安定稼働を実現する。
最近、Claude Codeでリポジトリの修正ログを吐かせているが、全部モデルに書かせるとAPI代が効いてくる。定型的なログ生成はローカルの軽量モデルに任せて、構造化が必要な部分だけGPT-6を叩くように書き換えた。この切り分けを自動化する仕組みをThreadPostに組み込むのが今の楽しみだ。
AIを魔法の杖として扱うのではなく、システムの一部品としてどう組み込み、どう制限するかというエンジニアリングの基本に立ち返る。キャッシュとコンパクションを使いこなすことで、低コストで高精度なAIアプリケーションを構築できる環境は既に整っている。
 あわせて読みたい【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録 →
よくある質問
GPT-6のモデル選択はどのように判断すべきですか?
タスクの推論の深さとコスト許容度で判断する。複雑なコード生成や論理的思考が必要なタスクには『GPT-6 Astra』を、定型的なデータ処理や大規模なバッチ処理には『GPT-6 Luna』を選択する。プロンプトの冒頭やドキュメントなど、繰り返し参照する静的な情報はキャッシュを活用し、入力コストを最小化する設計を優先する。
軽量モデルは実務で使えますか?
軽量モデルはエッジデバイスやコストを抑えたいローカル推論環境に適している。汎用的な推論能力はGPT-6に劣るため、特定のタスクに特化させて運用する。分類や簡易的なRAG、構造化データの抽出などを軽量モデルで処理し、複雑な判断が必要な箇所だけAPI経由でGPT-6を呼び出すハイブリッド構成を推奨する。
ツール呼び出しを実装する際の注意点は?
LLMにツールを自由に使わせると、誤った引数や存在しない関数を呼び出すリスクがある。タグベースのパーサを導入し、モデルの出力から特定のタグのみを抽出して安全なPython関数へ渡す仕組みから始める。モデルの推論結果を確実に制御しつつ、外部ツールとの連携を自動化できる。安全な実行環境を確保してから、徐々に自律性を高める手順をとる。
まとめ
GPT-6 Astraの登場で、AI開発の主戦場はモデルの賢さからコストを削りインフラとして制御する方向へシフトした。プロンプトキャッシュやコンパクトなモデル活用は、プロダクトの利益率を左右する設計項目だ。
高性能なAPIを叩くだけではスケーラブルなシステムは作れない。自律制御とローカル推論を組み合わせ、自分たちの手でAIの挙動をハンドリングする感覚。この泥臭いアーキテクチャ設計が今の開発者の醍醐味だ。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
