


AIモデルは指示通りに動く。開発者は「なぜその判断を下したのか」というブラックボックス問題に直面している。OpenAIが公開した最新の指針は、モデルの内部状態を観測し、失敗を言語化して蓄積する運用を示唆している。
モデルの重みを触らずにエージェントの精度を高める。Claude Codeで実装を繰り返す中で得た、AIの判断を可視化・検証するためのエンジニアリング手法を解説する。AIをブラックボックスとして扱うフェーズは終わった。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
進化したAIの羅針盤:OpenAIが提示した「5つの価値」
OpenAIが公開した「Model Spec」は、AIモデルが人間が意図する価値観を理解し、未知の状況でも判断を下すための指針だ。今回のアップデートで、モデルが守るべき基準は5つの核となる価値に再編された。
「人間が意図する結果への忠実性」、「危害の最小化」、「誠実さと透明性」、「人間の主体性」、「配慮」が挙げられている。モデルは自らの判断において「なぜその行動をとるのか」というコンテキストを重視する。
この指針は、OpenAIがモデルを訓練する際の境界線を定義する。開発者がアプリケーションを構築する際の「安全な運用範囲」も示す。モデルは明確な指示がない場面でも、これらの価値観を指針として判断を導き出す。
技術的なトレンドとして、モデルの重みを直接更新するのではなく、外部的な検証メカニズムを組み合わせるアプローチが主流だ。モデルの内部状態を観測する「監査ヘッド」や、推論の失敗を自己反省させる「Reflexion」のような手法が、AIの動作を検証・改善するための標準的な技術として注目されている。
しんたろー:
「意図への忠実性」か。実装する側は、その意図をどうモデルに定着させるかが気になる。プロンプトの調整だけでなく、システムレベルで監査や反省のループを組み込む手法が現実的だ。
これまで「外部ログ」というブラックボックス越しにAIの挙動を追っていた。今回の指針は転換点となる。AIの判断プロセスを「観測」し、失敗を「言語化」して蓄積する。モデルの重みを触らずにエージェントの精度を向上させる。これが現代の開発現場が取り組む新しい勝ち筋だ。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
モデルの内部を「観測」するエンジニアリングの台頭
これまでのAI開発は、モデルに対してプロンプトを投げ、出力を外部から監視する「ブラックボックス型」が主流だった。OpenAIが示した指針と近年の技術トレンドは、その開発手法を塗り替える。
モデルの重みを直接触る「学習」に頼らず、AIの判断プロセスを「可視化」し、信頼性を担保する。モデルの最終層から出力される「隠れ状態(hidden state)」を覗き見る「監査ヘッド」の導入と、推論結果を再帰的に評価する「反省(Reflexion)」の組み合わせが、今後の開発における武器になる。
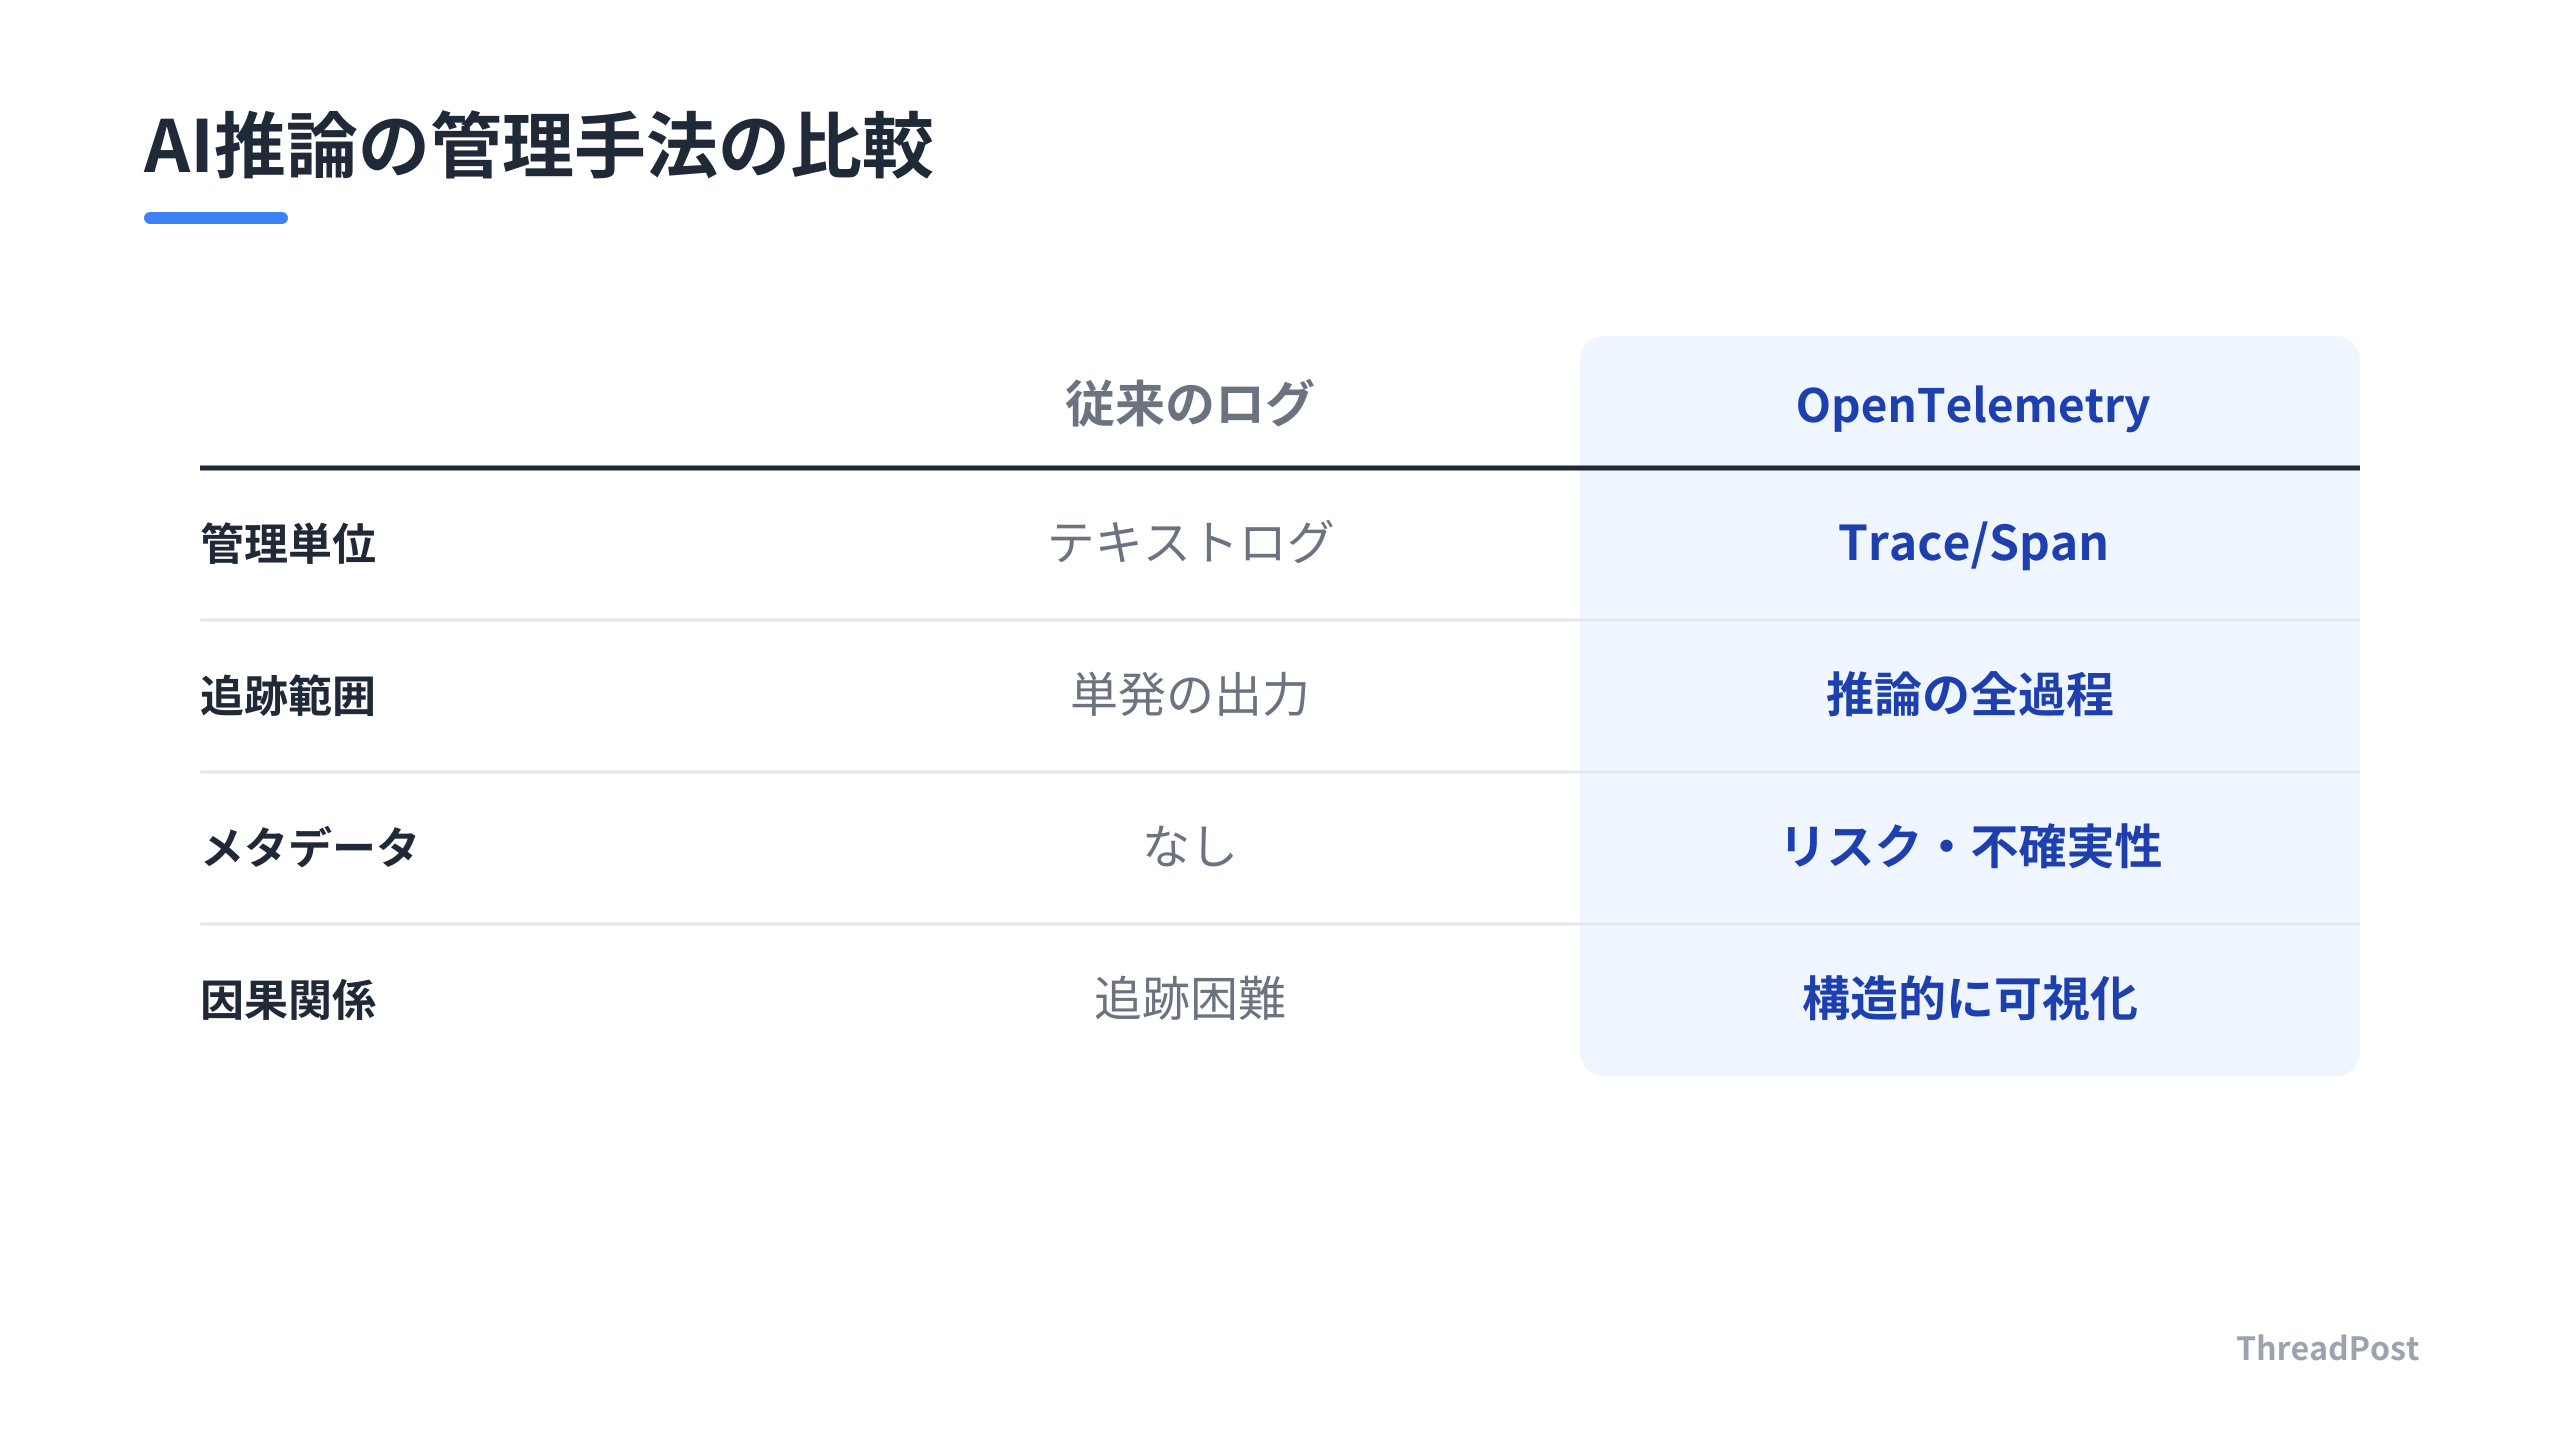
外部ログは「何が出力されたか」という結果しか示さない。内部状態を観測すれば「モデルがどのトークンに注目し、文脈をどう解釈したか」という判断の根拠を数値として追跡できる。これは、AIがなぜその結論に至ったのかを証明する「検証可能性」の確保に直結する。
現場レベルでは「監査ヘッドを自作する手間」と「モデルの振る舞いを修正する効率」のトレードオフが発生する。すべての推論に対して監査を走らせれば、APIコストとレイテンシは増加する。重要な推論プロセスだけに絞って監査と反省のループを組み込む。これがAIエージェントの品質を左右するエンジニアの腕の見せ所だ。
AIの「意図」はブラックボックスの中で魔法のように生まれるわけではない。ThreadPostでClaude Codeを回していても思うが、結局は「失敗のログ」をどれだけ言語化して、次のプロンプトのコンテキストに詰め込めるかという泥臭い蓄積が全てだ。透明性を求めるなら、AIの思考プロセスを自分でログとして叩き出す仕組みを組むしかないと思った。
OpenAIの文書には「意図への忠実性」という言葉が並ぶ。これを抽象論で終わらせるか、具体的な監視システムとして実装するかで開発者の価値は二分される。今後は、「モデルをどう賢くするか」という問い以上に、「モデルの判断をどう記録し、異常をどう検知するか」というガバナンス設計の比重が高まる。
「モデルの重みを触らない」というアプローチが標準になりつつある。LoRAのような重み更新型の微調整は、一度適用すると元の挙動に戻すのが難しい。対して、監査ヘッドやReflexionによる制御は、推論の「外側」で動くため、いつでも取り外せるし、ルールを書き換えれば即座に反映できる。
これは1人SaaS開発者にとって都合がいい。モデルを再学習させるコストを支払うことなく、特定の意図に沿った挙動を維持し続けられるからだ。Claude Codeでコードを書く際も、生成されたコードの「根拠」や「反省点」を併せて出力させ、次のイテレーションで検証する。この自律的なループをシステム化することこそが、次世代のAI開発における勝ち筋だ。
AIは「信じるもの」ではなく「観測し、制御するもの」だ。今回のOpenAIの指針は、その技術的な道筋を開発者に突きつけている。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
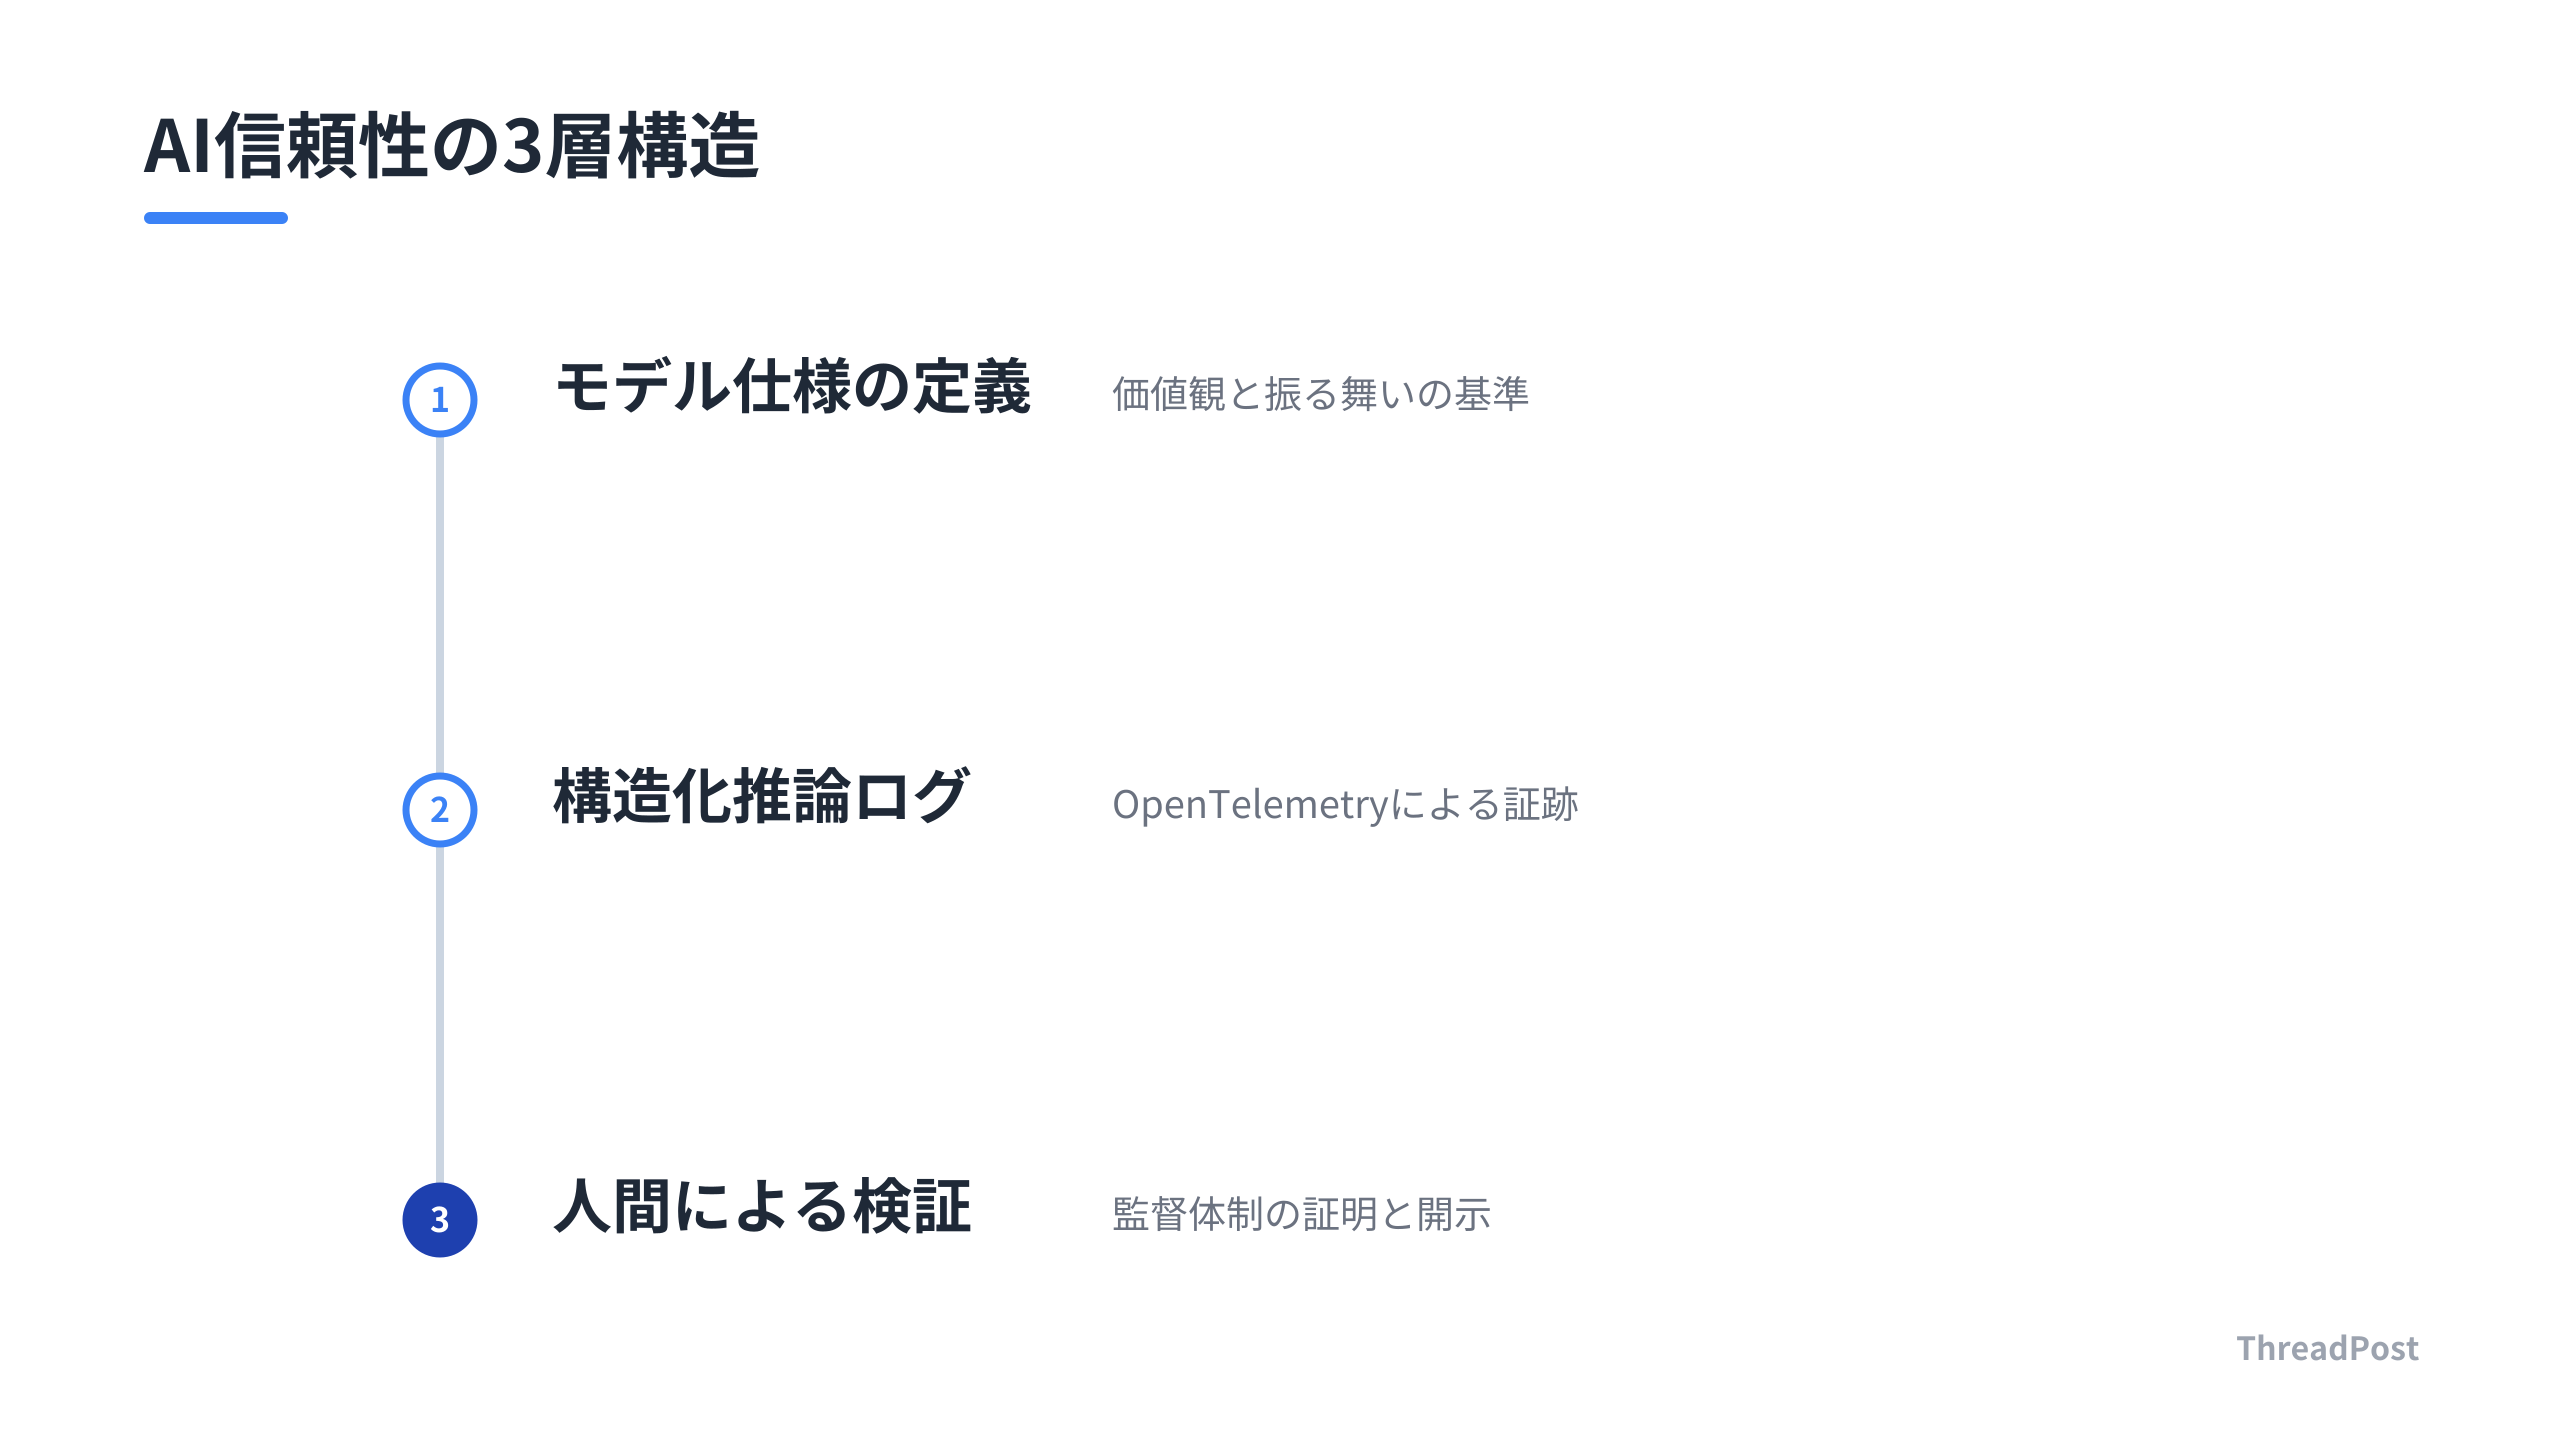
現場レベルで明日から変えるべき「3つの観測」
今回の動きを受けて、実務は変わる。プロンプトをいじって精度を追いかけるだけの「ガチャ」は終わる。明日からは、AIの出力を「検証可能なデータ」として扱うためのエンジニアリングが必要になる。
以下の3つのポイントを今の開発フローに組み込む。
1. 思考プロセスの「ログ化」を標準にする
AIが回答を出す際、結論だけを返させてはならない。モデルが「なぜその結論に至ったか」という思考の断片を、隠れ層の出力やChain of Thoughtとして必ず残す。これを外部ログに書き出し、後から「どの文脈で誤ったか」を遡れるようにするだけで、デバッグの質が変わる。
2. 自動判定による「反省ループ」の導入
ThreadPostのようなツール開発でも同じだ。AIにコードを書かせて終わりにしてはならない。生成直後に「静的解析ツール」や「テストスクリプト」を自動実行し、エラーが出ればその内容をAIにフィードバックする。この「実行→失敗→反省→再生成」のサイクルを、人間が介在せずに回す仕組みが、プロダクトの信頼性を支える。
3. 「監査ヘッド」的なモニタリングの実験
モデルの内部状態を全て追うのはハードルが高い。特定タスクにおいて「モデルがどのトークンに注意を払っているか」を確認するだけでも十分だ。例えば、重要なAPI呼び出しの前で、モデルが「どのコンテキストを重視したか」を簡易的なアダプターで抽出しておく。これだけで、AIが意図せぬパラメータを渡そうとした瞬間に検知できる。
Claude Codeでコードを書かせる時も、最近は「思考プロセスを出せ」と指示している。自分で書いたコードの怪しい箇所をAI自身に指摘させるだけで、バグの混入率は半分以下になった。優秀なペアプロ相手を見つけるより、優秀な「反省するAI」を育てる方がSaaS開発は加速すると感じた。
これらの取り組みは、最初は実装コストがかかる。しかし、一度「検証可能なパイプライン」を構築してしまえば、その後はモデルがアップデートされても、同じ枠組みで制御し続けられる。
「モデルの性能」に依存するのではなく、「モデルを制御する側のエンジニアリング」に投資する。これが、今後のAI開発で生き残るための現実的なアプローチだ。
まずは、自分の開発環境で「AIが生成した結果を、その場で別のAIがチェックする」というシンプルなループから試す。そのフィードバックの質が、そのままプロダクトの品質に直結する。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
AIの「意図への忠実性」を開発者が実装するにはどうすればいいですか?
ゴールを指示するだけでなく、モデルが「なぜその判断を下したか」という推論プロセスを言語化させる。失敗した際に「なぜ間違えたか」を自己反省させる「反省ループ」を組み込み、その内容を次のプロンプトへコンテキストとして継承させる。これにより、モデルは意図を深く解釈し、指示の行間を埋めるような自律的な調整が可能になる。
モデルの内部状態を可視化するメリットは何ですか?
外部ログだけでは「何が出力されたか」という結果しか追えない。内部状態(hidden state)を観測することで「モデルがどのトークンを重視し、どう文脈を理解したか」という判断プロセスを検証できる。これにより、AIが誤った回答をした際の原因特定が早まる。ブラックボックスな挙動を数値として証明できるため、安全性を担保したい場面で強力な武器になる。
反省ループを導入すると、コストや速度に影響はありますか?
複数回の推論を繰り返すため、APIの利用コストと応答時間は増加する。しかし、複雑なコーディングや推論タスクにおいては、1回の推論で失敗して手動で直すコストを考えれば、トータルでの開発効率は高まる。全てのタスクに適用するのではなく、バグが混入しやすい難易度の高い処理だけに限定して導入する。
まとめ
AIのモデルスペックが更新され、「意図への忠実性」という概念が、エンジニアリングによって証明可能な領域へと踏み込んだ。やるべきことは、モデルの重みをいじることではなく、出力結果を「監査」し、失敗を言語化して「反省」させるループをシステムに組み込むことだ。
AIをブラックボックスとして扱う時代は終わった。内部状態を観測し、自律的な改善プロセスを実装して初めて、信頼できるエージェントが完成する。
あなたの開発しているAIの判断プロセス、可視化できているか。ThreadPostで、その堅牢なエージェント開発の知見を共有する。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
