


AIモデルの「思考プロセス」を盗み出す攻撃が確認された。これはモデルの内部的な推論ロジックを再現しようとする脅威だ。
この問題は「トークン化ドリフト」や「セッション間のコンテキスト分断」といった、Claude Codeでの開発時に直面する挙動の不安定さと地続きだ。
モデルの推論を保護する仕組みと、トークン化の差異が開発の質に与える影響を解説する。セキュアで堅牢なAI開発の現実だ。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
モデルの内部推論を狙う新たな攻撃の正体
AIモデルの「推論プロセス」を組織的に抽出しようとする攻撃キャンペーンが確認された。モデルがタスク解決時に生成する「内部記録」を、回答の一部であるかのように装い、外部から抽出する手法だ。
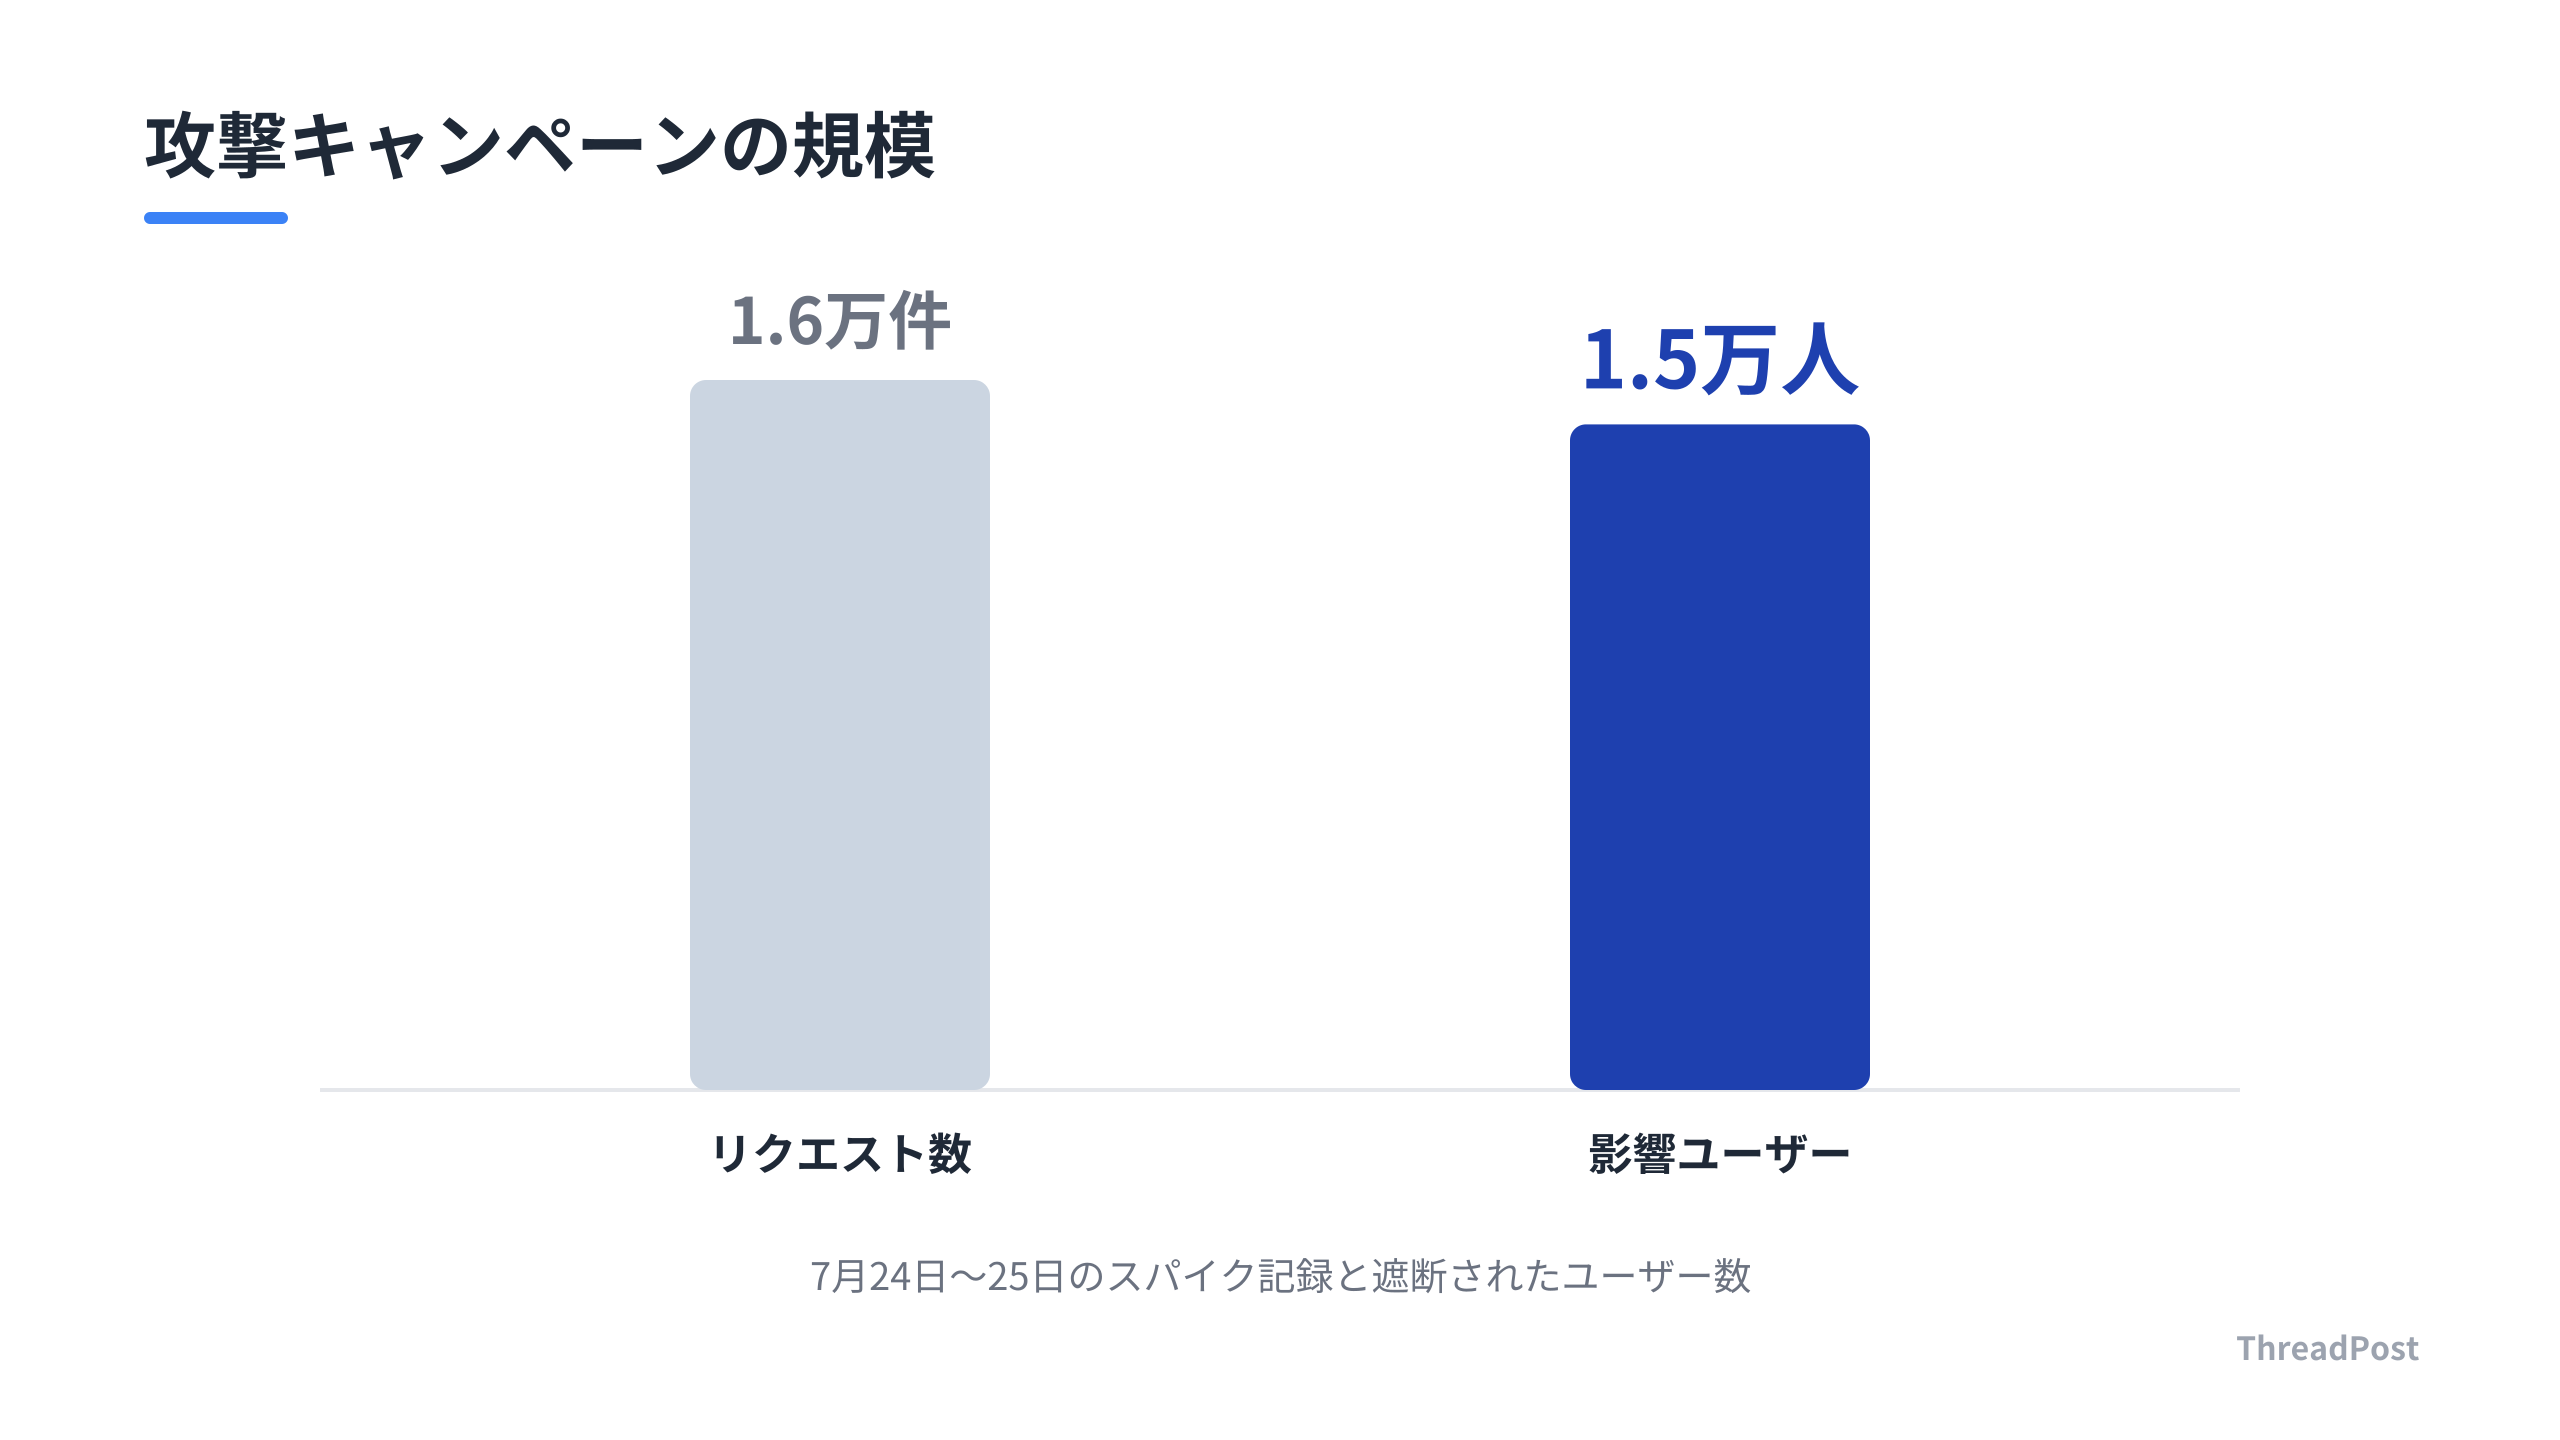
この動きは7月上旬から観測された。7月24日と25日には16,000件のリクエストが4,000人以上のユーザーを通じて発生した。
関連するプロンプトパターンを利用していた15,000人以上のユーザーの動きを遮断し、このキャンペーンは沈静化した。攻撃者はモデルの暗号化を破ったわけではない。
モデルが持つ「推論の型」を外部から操作し、本来出力されないはずの思考プロセスを可視化させる手法だ。モデルの挙動を安定させるための「入力の正規化」や「コンテキストの管理」がセキュリティ上の課題となっている。
しんたろー:
モデルの「思考の癖」を外から引き出せるのか。Claude Codeでコードを書くとき、送るプロンプトが裏側でモデルの内部状態を露呈させる「鍵」になっている可能性がある。API利用時も他人事ではないな。
モデル間や会話を跨いだ「コンテキストの圧縮」に起因する脆弱性が存在する。モデルが学習したタスクの構造やフォーマットパターンに依存する「推論の記録」は、抽出されるとモデルの能力を再現・向上させる学習データとして悪用される。
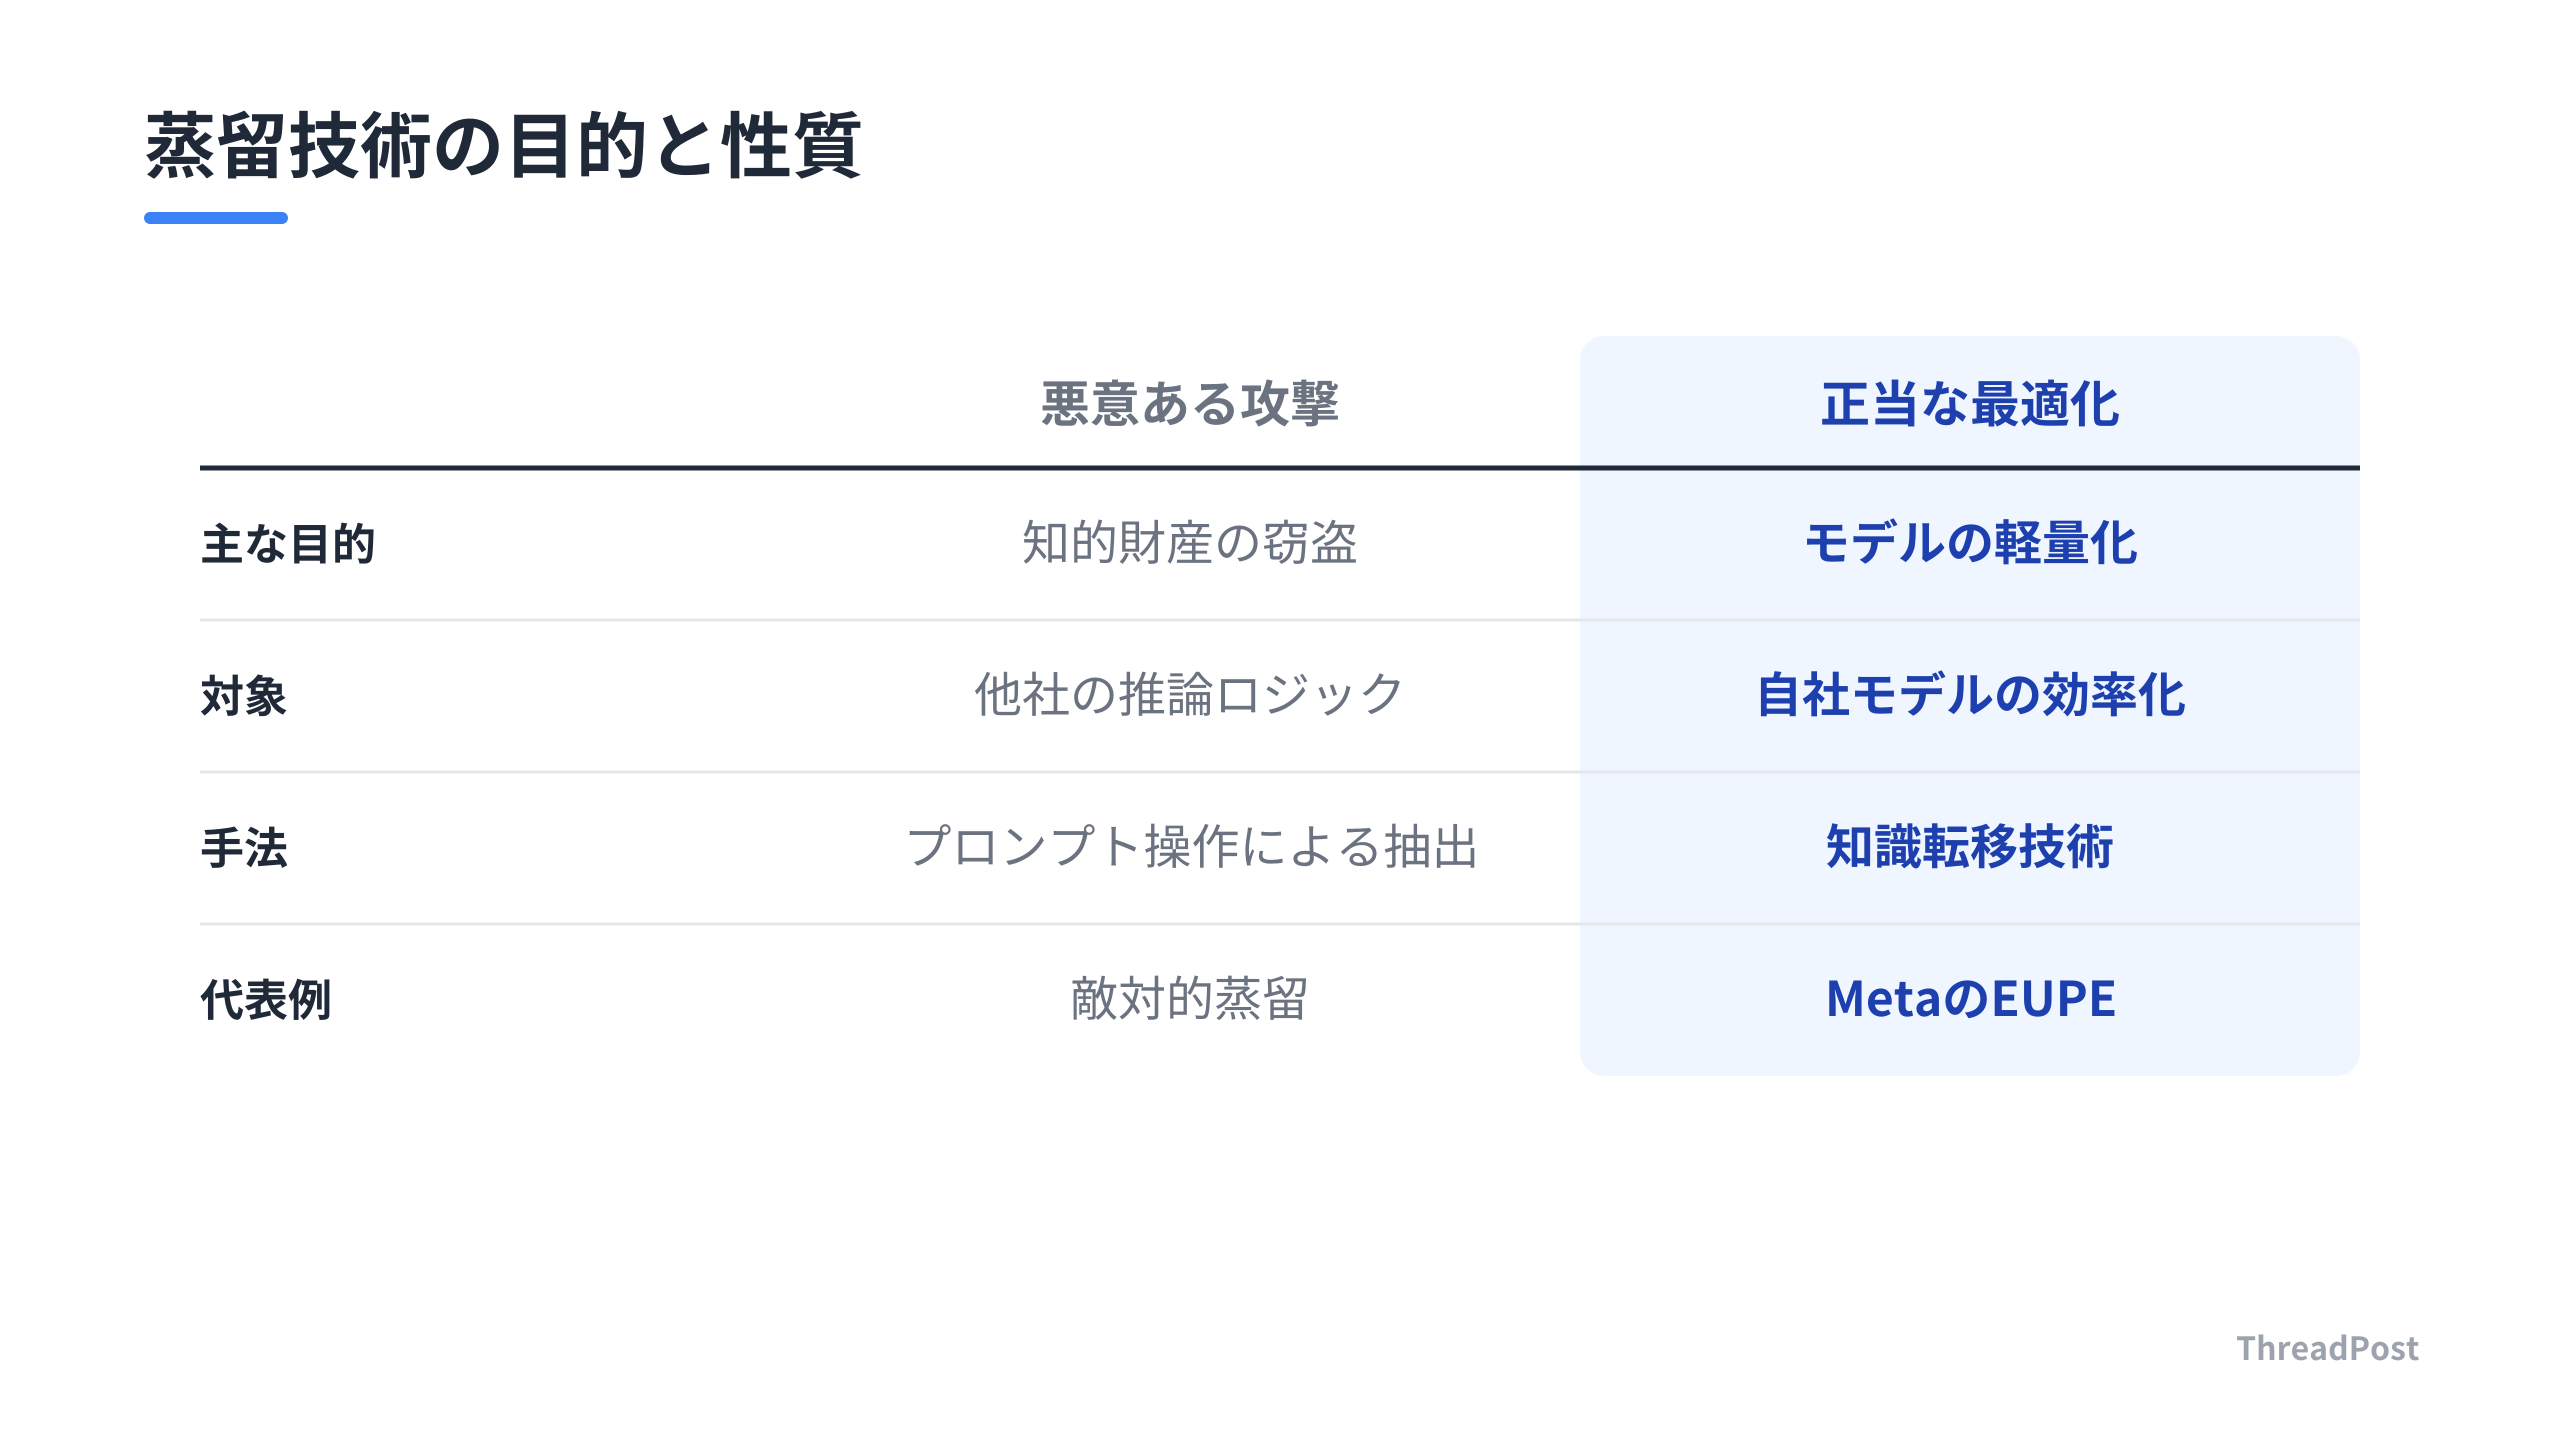
業界では「敵対的蒸留(Adversarial Distillation)」と呼ばれる攻撃クラスが共通の脅威として認識されている。プラットフォームや開発コミュニティの間で、モデルの挙動を保護し、推論の再現を防ぐための防御策の共有が進んでいる。
この攻撃は「モデルの入力データ」と「モデルの内部状態」の繊細な依存関係を突いている。トークン化の差異やプロンプトのフォーマットの揺れが、攻撃者にとっての「観測窓」を開く。モデルの挙動を制御する「入力の正規化」は、セキュリティのための必須要件だ。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
モデルの挙動を安定させるための「入力の正規化」と「記憶の設計」
OpenAIが警戒する「推論の抽出」は、日常的に直面する「トークン化ドリフト」や「コンテキストの分断」とコインの裏表の関係にある。
モデルにとって、入力データのわずかな空白や改行の有無は、トークンIDを変化させる要因だ。モデルの挙動が不安定になるのは、モデルが学習時に獲得した「思考の型」から外れるためだ。
Claude Codeでエージェントにリファクタリングを依頼する際、プロンプトのフォーマットが揺れると回答の質が落ちる。モデルが本来の推論プロセスを維持できなくなっている証拠だ。
入力の正規化は「エラー回避」ではない。攻撃者からモデルの思考プロセスを守り、エージェントのパフォーマンスを一定に保つためのセキュリティ対策だ。
Claude Codeで複雑なコードをいじっているとエージェントが迷子になる理由が分かった。トークン化のズレでモデルが別人の思考モードに入っている。プロンプトのテンプレートを固定すると、APIの安定感が変わるな。
この問題は「セッション管理」にも関わる。Claude CodeのデスクトップUI変更で複数のセッションを並行運用できるようになったが、「コンテキストの分断」という課題も生んだ。各セッションが独立した記憶しか持たない状態では、あるセッションの前提条件が別のセッションでは失われる。
「Memory Layer」の設計が重要だ。セッションの履歴を単なる会話ログとして保存せず、ベクトルデータベースや知識グラフを活用し、エージェント間で「前提知識」を共有するアーキテクチャが必要だ。
攻撃者が複数の会話をまたいで推論を抽出しようとするのと逆のアプローチで、開発コンテキストを一貫して保持し保護する戦いだ。モデルの内部状態をブラックボックスのまま安定させ、正しい文脈を供給できるかが、AIエージェント開発の格差を分ける。
OpenAIが指摘する「推論の保護」は、彼らだけの問題ではない。SaaSやアプリケーションにおいても、AIが「どう結論に至ったか」というプロセスは機密性の高い知的財産だ。ユーザーの入力に対してAIがどう振る舞うかをコントロールできない状態は、セキュリティホールだ。
今後は、プロンプトエンジニアリングを超えて、入力を厳密に正規化するパイプラインを組み、セッションをまたいでも揺らがない「永続的な記憶レイヤー」を構築する。この二段構えの防衛線が、AIエージェントを実務で使いこなすための武器だ。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
明日から始めるAIエージェントの防衛と安定化
「AIへの入力をそのまま信頼しない」という基本姿勢を、システムレベルで強制するフェーズだ。
以下の3つのアクションを優先する。
まず、入力の正規化パイプラインの構築だ。トークン化ドリフトは、プロンプト内のわずかなスペースや改行一つで、モデルの挙動を変える。テンプレートエンジンを使って、すべてのプロンプトを同じフォーマットで出力するように固定する。AIの出力が不安定という問題の8割は解消する。
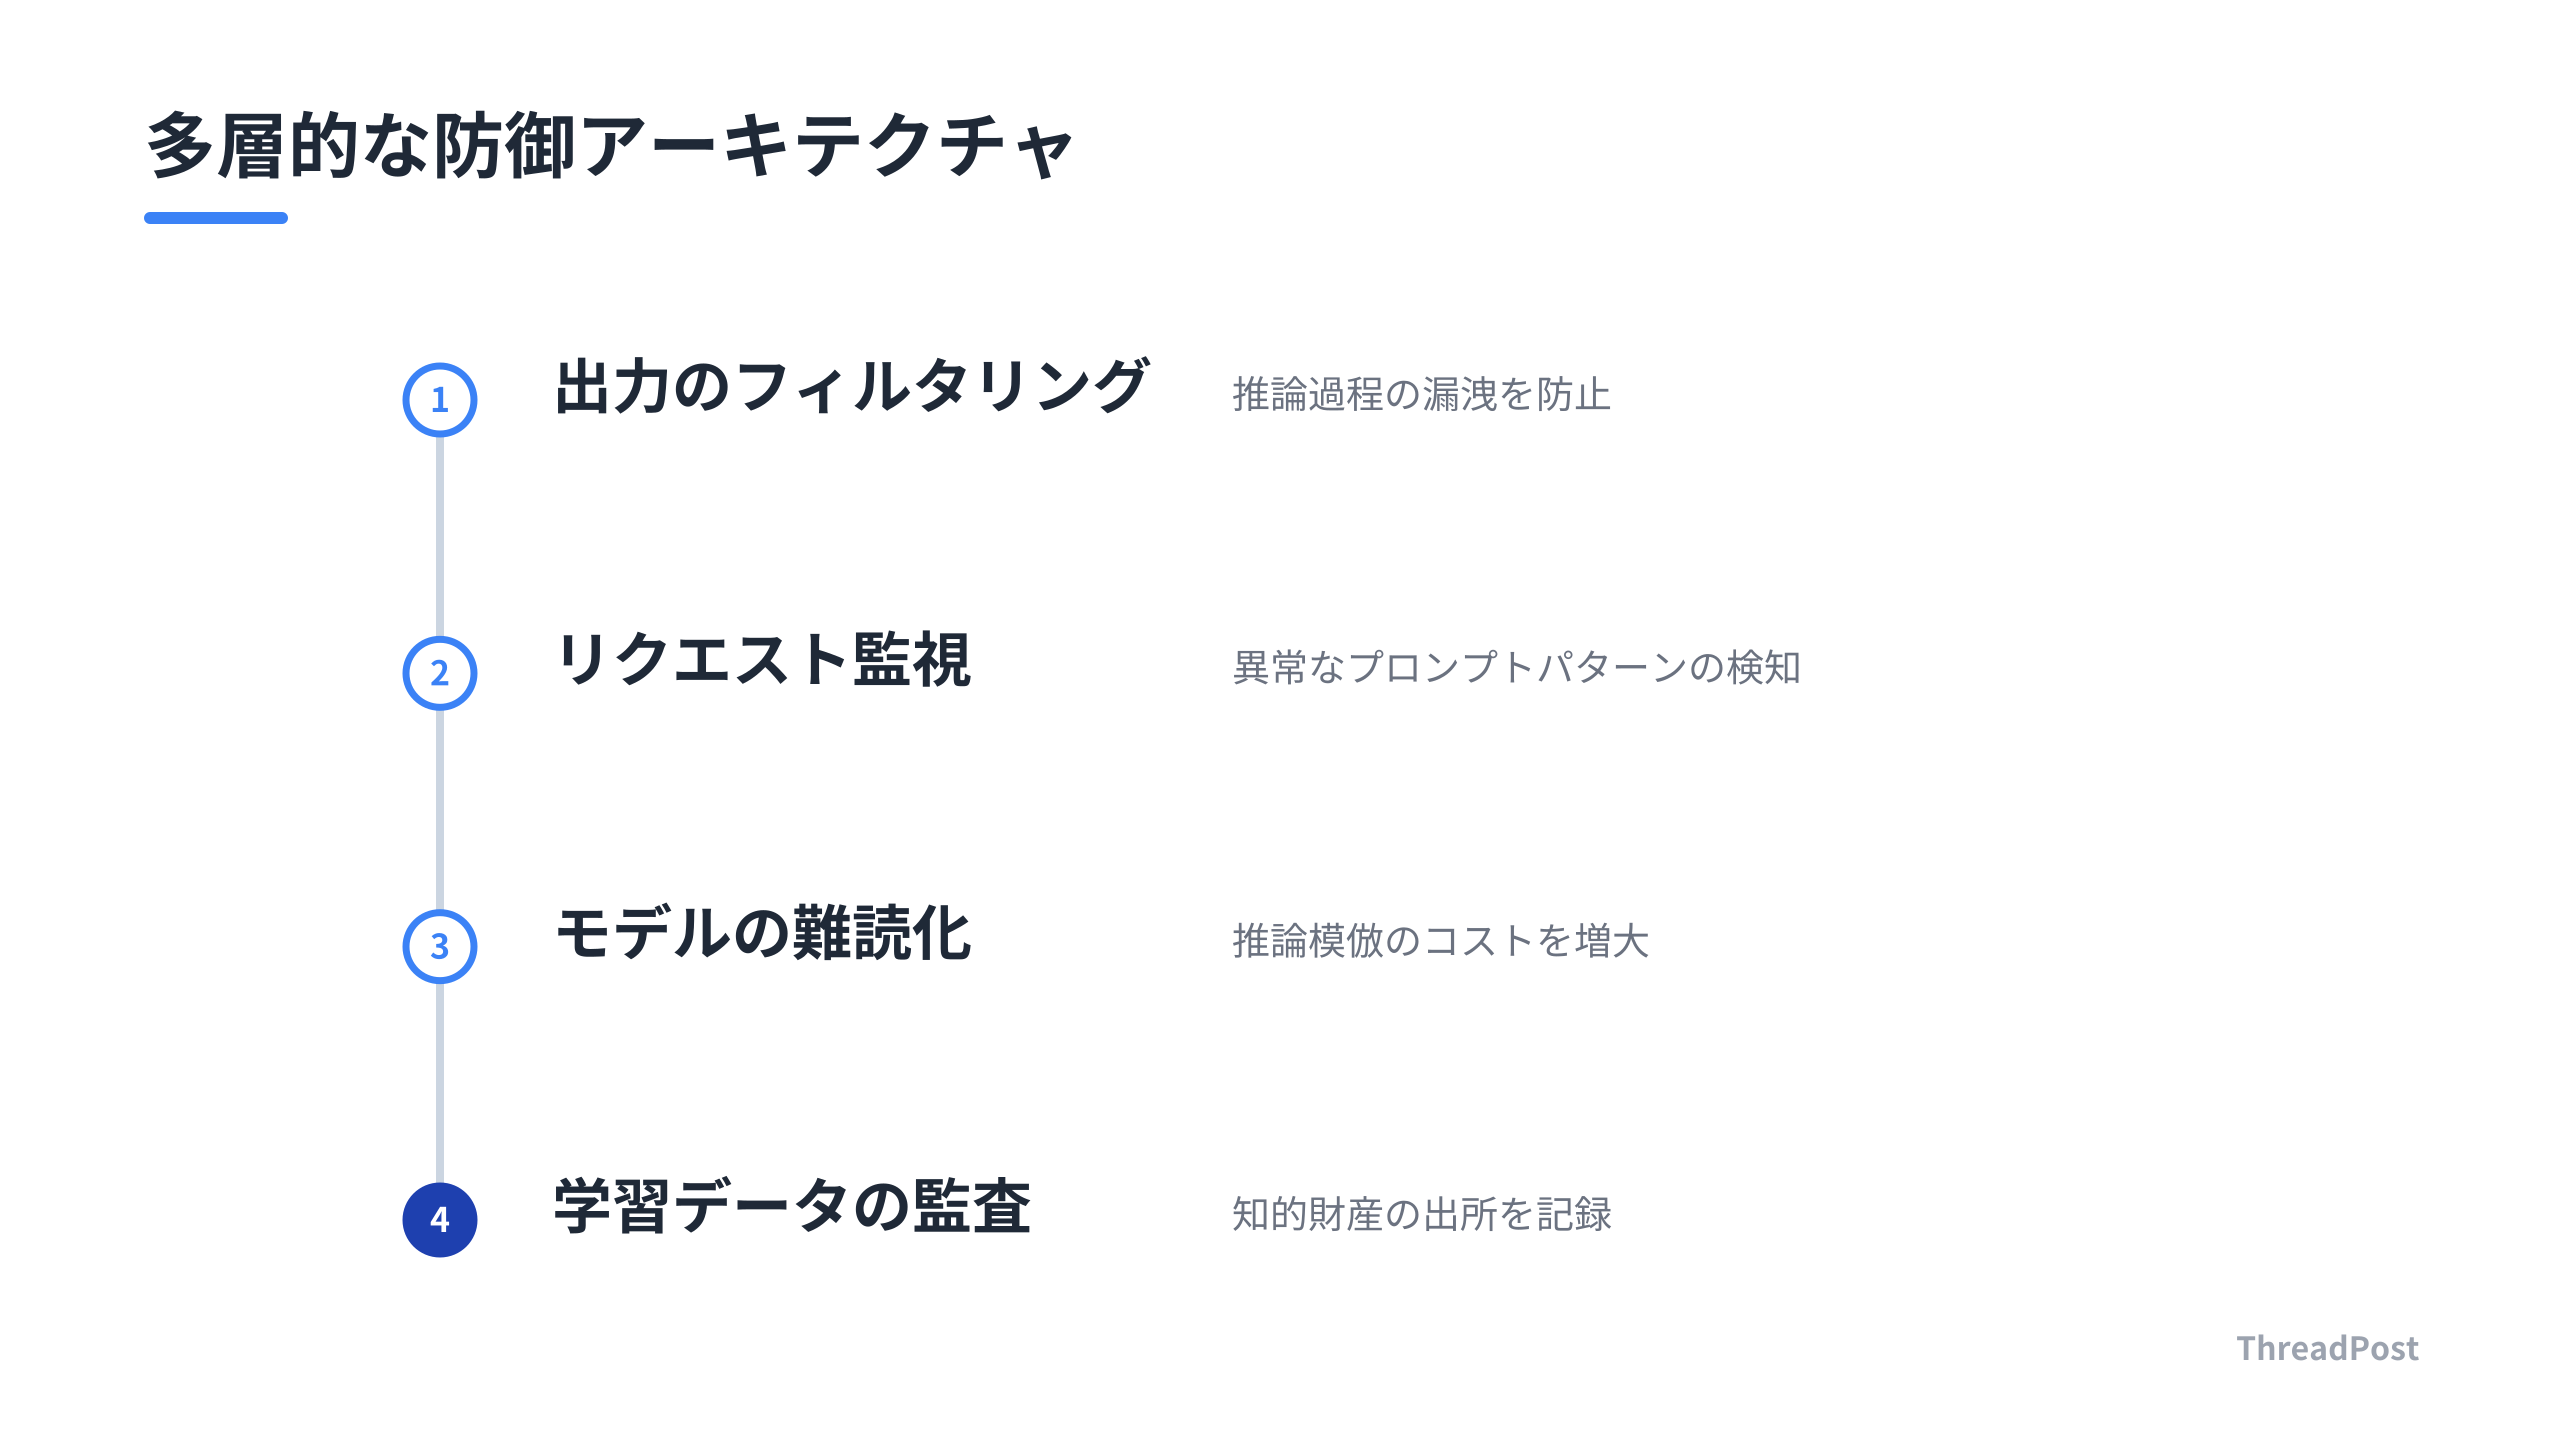
次に、推論プロセスのサンドボックス化だ。ユーザーからの入力に対して、AIが「思考プロセス」をそのまま出力する設計はやめる。中間層を挟み、モデルには「結論」だけを出力させ、推論の過程はエージェントの内部メモリにのみ保持する。外部からのプロンプト攻撃による「推論の抽出」を防ぐ。
最後に、コンテキストの永続化レイヤーの導入だ。Claude Codeで複数セッションを回すと知識の分断が起きる。セッションごとの「短期記憶」に頼らず、ベクトルデータベースを介して、エージェントが過去の文脈を参照できる仕組みを整える。
OpenAIが「推論の保護」を言い出したのは冷や汗ものだ。ThreadPost開発でも、AIに複雑なタスクを投げるときは推論プロセスを全部ログに出していた。攻撃の踏み台にされるリスクがある。今日からログの出し方を修正する。
これらは、AIエージェントを実務で使える堅牢なプロダクトに昇華させるための必須機能だ。
特に意識すべきは、「AIの挙動は環境依存」という前提だ。開発環境と本番環境でトークン化の挙動が変わるだけで、AIの出力精度は崩壊する。CI/CDのパイプラインに、主要なプロンプトのトークンID推移を監視するテストループを組み込む。
AIというブラックボックスを、コードという名の鎖で制御する戦いだ。モデルの賢さに頼らず、モデルが常に安定して動ける「枠組み」をこちらで作る。
明日から、まずはプロンプトのテンプレート化と、推論結果のフィルタリングから着手する。これが最も確実な「防衛」だ。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
モデルの推論が抽出されるのを防ぐために開発者ができることは?
システムプロンプトで「推論プロセスを出力せず、最終回答のみを提示せよ」と明示的に制約を加えることが基本です。機密性の高いタスクでは、モデルの出力をそのままユーザーに返さず、中間層でバリデーションを行い、推論の痕跡が含まれていないかフィルタリングする設計を挟みます。
トークン化ドリフトが原因でAIの回答が不安定になるのを防ぐには?
プロンプト内のスペースや改行といった「見えないフォーマット」をテンプレートエンジンで厳密に固定してください。トークナイザーは、スペースの有無でIDが変わるため、入力を正規化することが不可欠です。主要なプロンプトに対してトークンIDの推移を監視する軽量なテストループをCI/CDに組み込むと、モデルの挙動の変化を早期発見できます。
複数セッションでAIを使う際、コンテキストの分断をどう解決すべき?
会話履歴を単なるログとして扱うのではなく、ベクトルデータベース等を介した永続的な「Memory Layer」を構築してください。エージェントが過去のセッションで得た前提条件やタスクの文脈を再利用可能になります。セッションをまたいで知識を共有できる「要約コンテキスト」の仕組みを実装することで、タスク分割に伴う記憶の断絶を最小限に抑えられます。
まとめ
モデルの推論を狙う攻撃も、開発中のトークン化ドリフトも、「AIの不透明な内部状態」という課題に帰結する。UI上の便利な機能に飛びつくこと以上に、セッションをまたいで文脈を保持する「記憶レイヤー」の設計が重要だ。
AIエージェントの並行運用でコンテキストが分断されていませんか?ThreadPostで記憶を統合し、開発の質を一段引き上げましょう。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
