


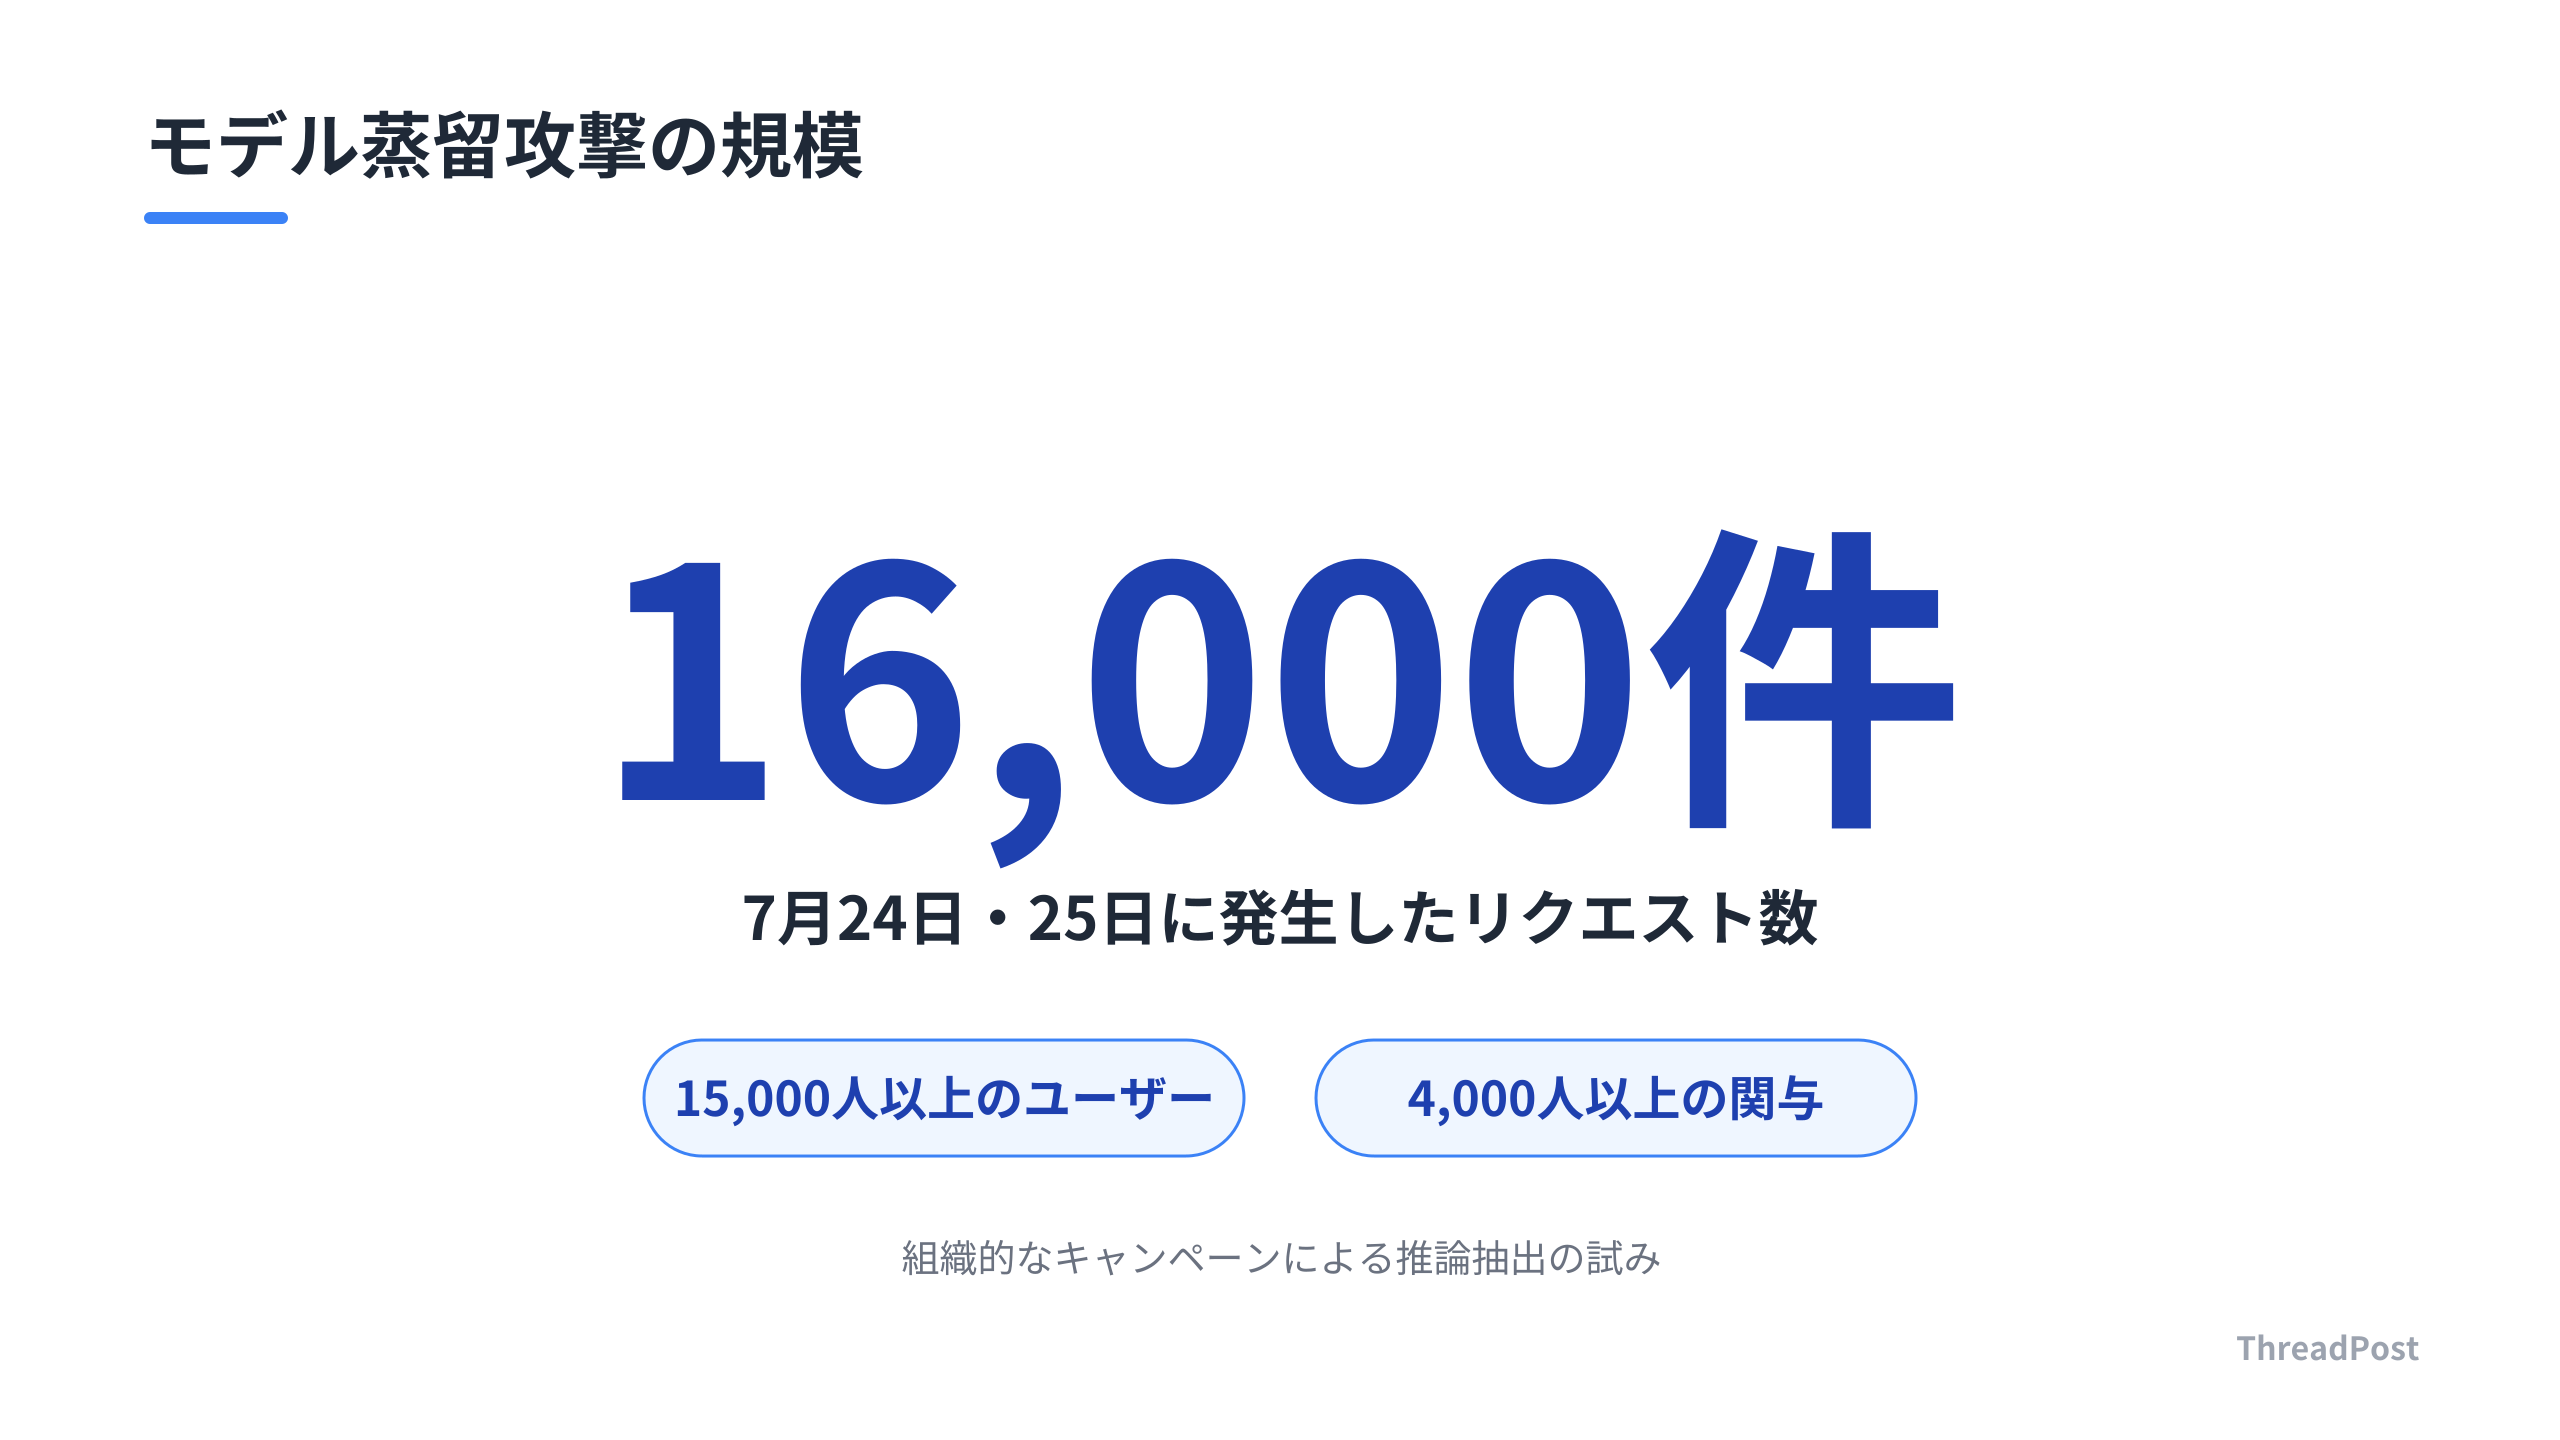
OpenAIが、モデルの「思考の型」を盗み出す敵対的蒸留キャンペーンを摘発した。7月24日から25日にかけて16,000件以上の不正なリクエストが確認されている。
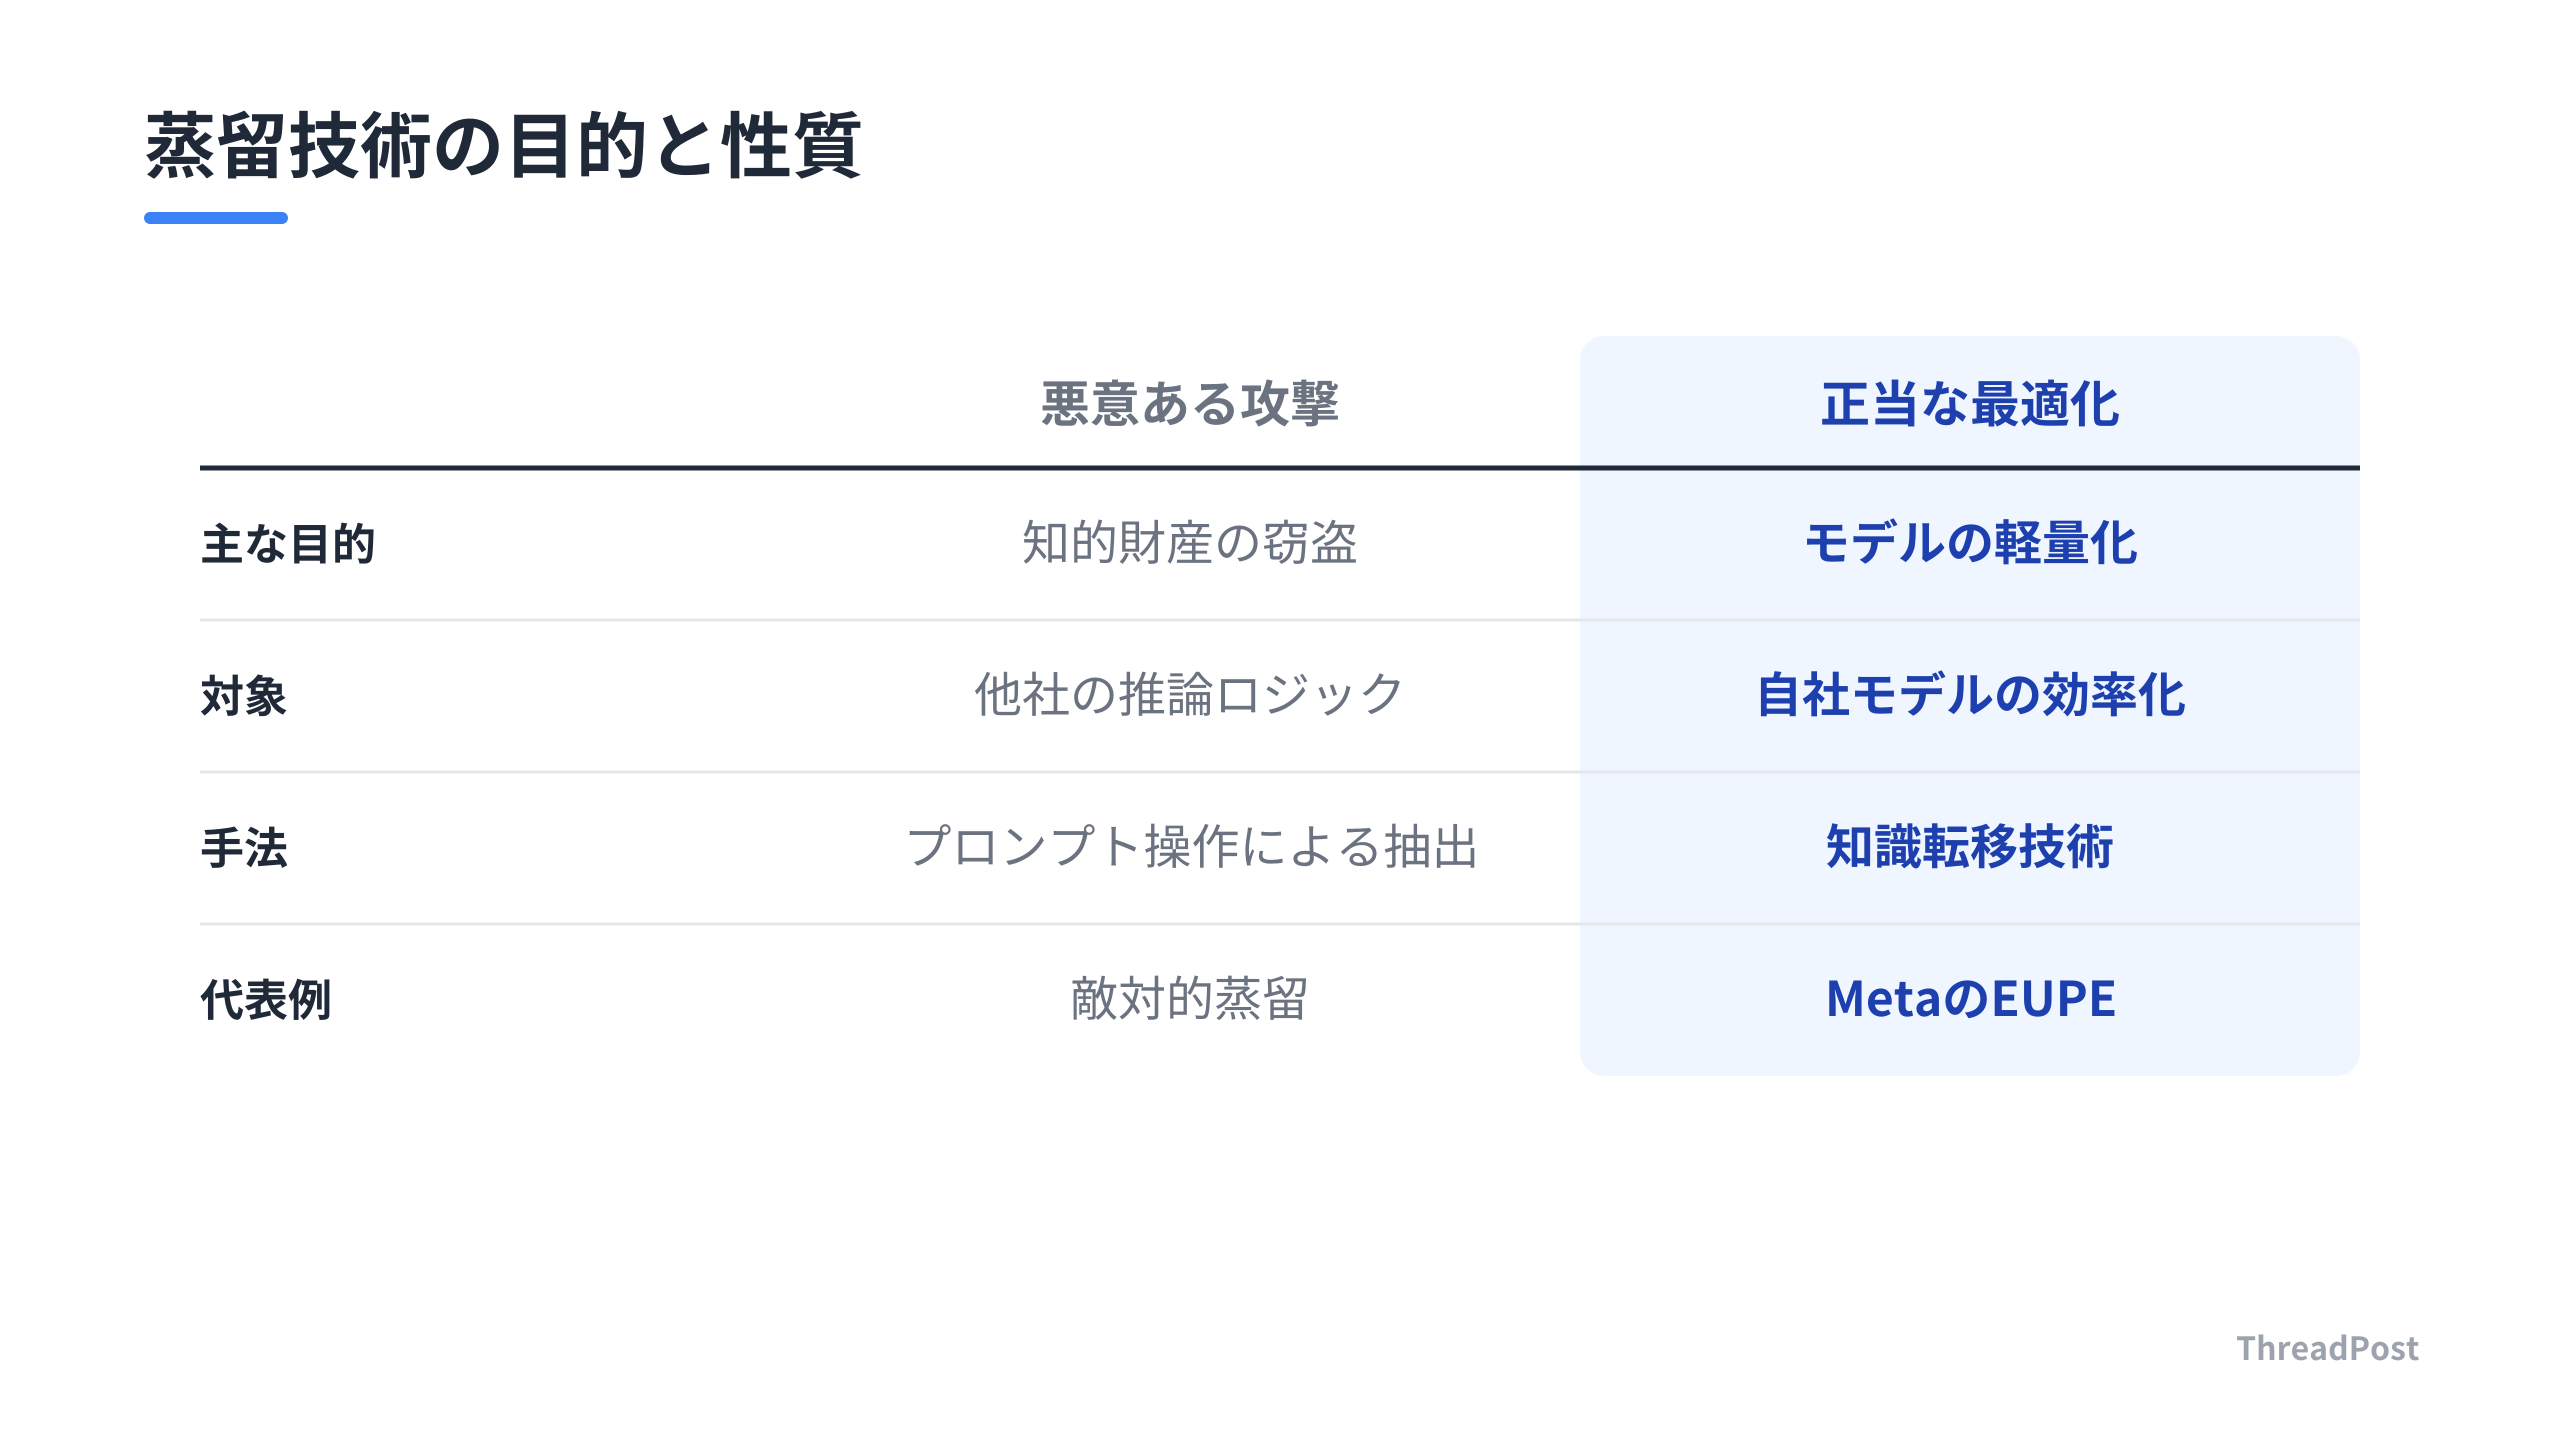
「モデルを軽量化する技術」と「モデルを盗む攻撃」の境界線は紙一重だ。開発者はAPIの境界を設計し、知的財産を隠蔽する。
この記事では、Claude Codeで1人SaaSを回す視点から、この「モデル抽出」の現実と、今日からできる防御策を構造化して解説する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
敵対的蒸留によるモデル盗用とOpenAIの対応
OpenAIは、自社のAIモデルから「保護された推論」を不正に抽出する、組織的な敵対的蒸留キャンペーンを摘発した。7月1日に活動が確認され、7月24日から25日にかけて16,000件もの不正リクエストが集中した。
最終的に15,000人以上のユーザーが関与したクラスターを特定し、7月28日までに遮断した。攻撃者は暗号化された推論内容をコピーし、別の対話セッションでモデルに「復号」させる手法を用いた。
OpenAIは、データベースのハッキングや暗号化の突破ではないと説明する。モデルとの対話を操作し、本来は隠されている内部推論を強制的に出力させる「敵対的蒸留」という攻撃手法だ。
この脅威はOpenAI単体の問題ではない。モデルの圧縮や軽量化技術の進展に伴い、モデルの重要な重みや推論能力を抽出する技術は研究コミュニティや産業界で共有されている。
しんたろー:
16,000件のリクエストでモデルの思考を盗む執念を感じる。Claude Codeでコードを書く際、効率化のためにモデルを小さくしたくなる気持ちは理解できる。その技術が攻撃に直結するのは皮肉だ。APIの境界線でどこまで情報を出すか、真剣に考える必要がある。
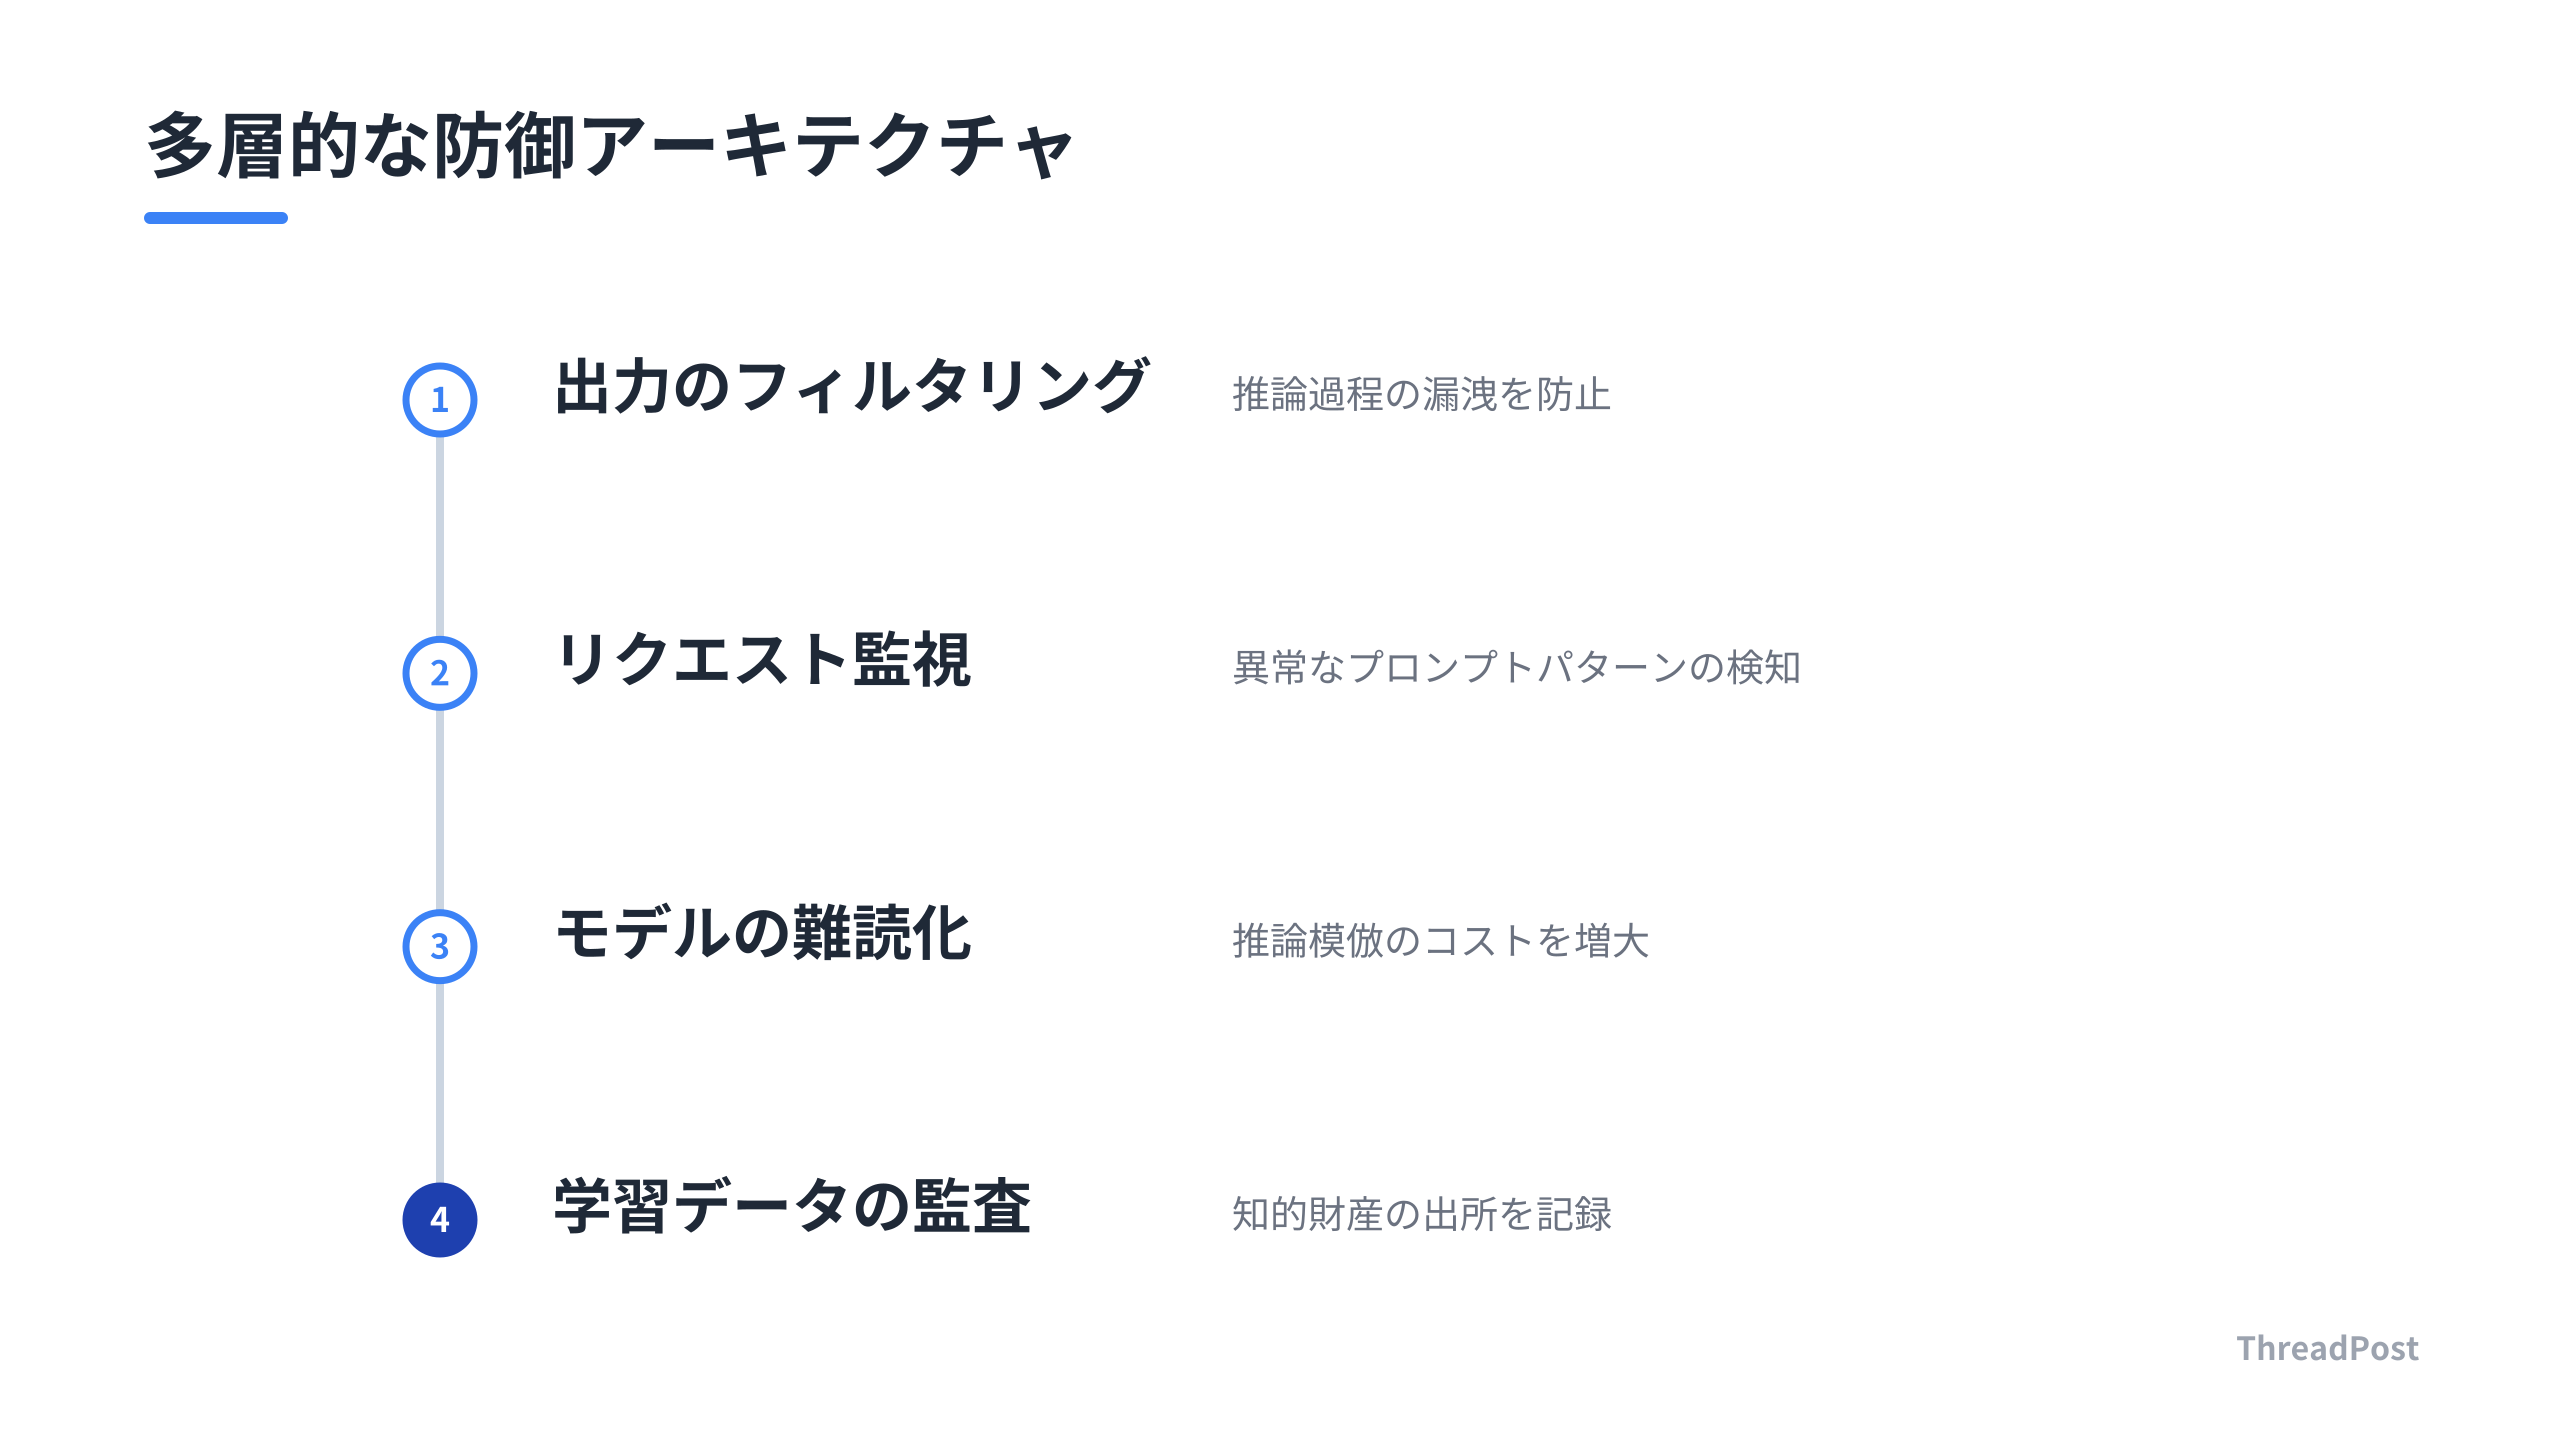
OpenAIはこの摘発を受け、Frontier Model Forumを通じて業界パートナーと防御策を共有した。今後は、単なる暗号化やバリデーションだけでなく、適応型の防御レイヤーを構築することがAI開発の基準となる。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
開発者が直面する「公開」と「保護」のジレンマ
AIモデルを「効率化する技術」と「盗用する技術」は紙一重だ。モデルの推論プロセスを軽量化し、エッジデバイスで動作させる手法が、そのまま敵対的蒸留のツールとして悪用されている。
開発者はモデルの軽量化を追求するほど、攻撃者に「抽出ポイント」を提示する可能性がある。NVIDIAが発表したStar Elasticのように、単一のチェックポイントに複数のサブモデルを入れ子状に格納する手法は推論の最適化としては美しい。
しかし、この「入れ子構造」の解明そのものが、敵対的蒸留のターゲットになり得る。推論の精度を上げ、コストを最適化するために実装しているアーキテクチャが、モデルの知的財産を脆弱にしている事実は無視できない。
Claude Codeでコードベースを読み込ませると、AIがいかに「文脈」をハックするのが得意か痛感する。便利に使うための構造化が、そのまま攻撃者の「推論抽出」のガイドラインになっている気がする。公開する情報と、隠すべきロジックの境界線をセキュリティ設計の一部として考える。
APIのレスポンスから推論の痕跡を排除する。推論過程を複数のステップに分割し、単一のプロンプトでは全体像が見えないようにする「アーキテクチャの分離」が開発者の必須スキルとなる。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
開発現場で今すぐ見直すべき「防御と公開」の戦略
今回の摘発事例は、個人開発者や小規模チームにとっても遠い世界の話ではない。AIエージェントがコードベースを読み込み、API経由で推論を繰り返す現代の開発環境において、プロダクトが「蒸留の標的」になるリスクは高まっている。
API利用における「入力バリデーション」の考え方を変える。ユーザーからのプロンプトが、モデルの内部思考を誘発するような特殊なパターンを含んでいないか監視する仕組みだ。
技術ドキュメントの公開戦略も再考する。情報を網羅的に書くことは、AIに「推論のヒント」を過剰に与えるリスクと隣り合わせだ。
ライブラリの仕様を公開する際は、その背後にあるアルゴリズムの核心部分をモジュールとして切り離す。推論過程からそのロジックが漏洩しないように配慮する。
Claude Codeでコードベースを読み込ませるとき、「AIに見せてもいい思考」と「隠すべきロジック」の境界を意識する。APIのレスポンスも、詳細な推論過程を返すと他人のモデルの教師データにされる。出力のチューニングも立派なセキュリティ対策だ。
AIが進化し、モデルの構造が透明化していく中で、自分たちにしか出せない価値を保護し続ける。そのためのアーキテクチャの分離と、情報の出し方の最適化がこれからのAI開発の実務となる。
 あわせて読みたい【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録 →
よくある質問
Q1: モデルの「保護された推論」とは具体的に何を指すのか?
モデルが最終的な回答を出力するまでの過程で行われる、内部的な論理ステップや思考プロセスのことです。これらはユーザーの目に直接触れませんが、モデルの推論能力そのものを支える知的財産です。敵対的蒸留とは、この隠れた思考の型を外部から強制的に引き出し、他者のモデルを学習させるための教師データとして悪用する攻撃手法です。
Q2: NVIDIAのStar Elasticのような技術は、モデルの盗用を容易にするのか?
技術的にはその側面を否定できません。Star Elasticはモデル内の重要な重みを効率的に抽出する手法であり、軽量化や運用の最適化を目的としています。しかし、この抽出技術が悪用されれば、大規模モデルから推論の核となる部分だけを抜き出すことが容易になります。OpenAIが警戒する敵対的蒸留の脅威は、こうしたモデル圧縮技術のリスクを現実のものとして示しています。
Q3: AEO対策としてllms.txtを設置するのは無意味か?
AI検索エンジンが直接の引用源として参照する効果は限定的です。しかし、CursorやContinueといった開発者向けAIツールはllms.txtを読み込むため、AIエージェントに自社のライブラリや規約を正しく理解させる目的であれば設置する価値があります。AI検索の順位向上ではなく、エージェントとの対話精度を高めるDX向上ツールとして活用するのが賢明です。
まとめ
モデルの推論プロセスを狙う「敵対的蒸留」の摘発は、AI開発が新たな防衛フェーズに入ったことを示している。モデルを軽量化する技術は進化する一方、それが盗用の武器にもなり得る現実に開発者は向き合う必要がある。
技術を公開してエージェントに正しく理解させるか、内部ロジックを分離して守り抜くか。この境界線を見極める力が、これからの開発者には不可欠だ。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
