


AIに実装や執筆を任せると、一瞬でそれらしい成果物が出てくる。しかし、その「もっともらしさ」に潜む間違いに気づくのは至難の業だ。AIは文脈に強く影響を受けるため、自分で書いた内容を自分で見直しても、先入観からミスを追認してしまう。品質を最大化するためには、執筆と検収の役割を分離し、厳格なレビュー体制を敷くことが不可欠だ。
この記事では、AIエージェントの成果物品質を担保するための具体的な構築術をまとめる。現場のAI運用を変えるヒントにする。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
1. 執筆と検収の別人格化
AIエージェントに実装や執筆をさせた後、同じ会話履歴でレビューさせるのは避けるべきだ。実装時の会話には、設計理由や試行錯誤といった文脈が大量に含まれている。この文脈を持つAIは、自分の実装を正当化するバイアスがかかりやすい。
実装担当と検収担当を別エージェントとして定義し、独立したコンテキストで評価させるのが鉄則だ。これにより、自己正当化を防ぎ、客観的な指摘が可能になる。検収エージェントには、「執筆の経緯を知らない第三者」として振る舞わせる設定が有効だ。
2. Claude Codeの3パス独立レビュー
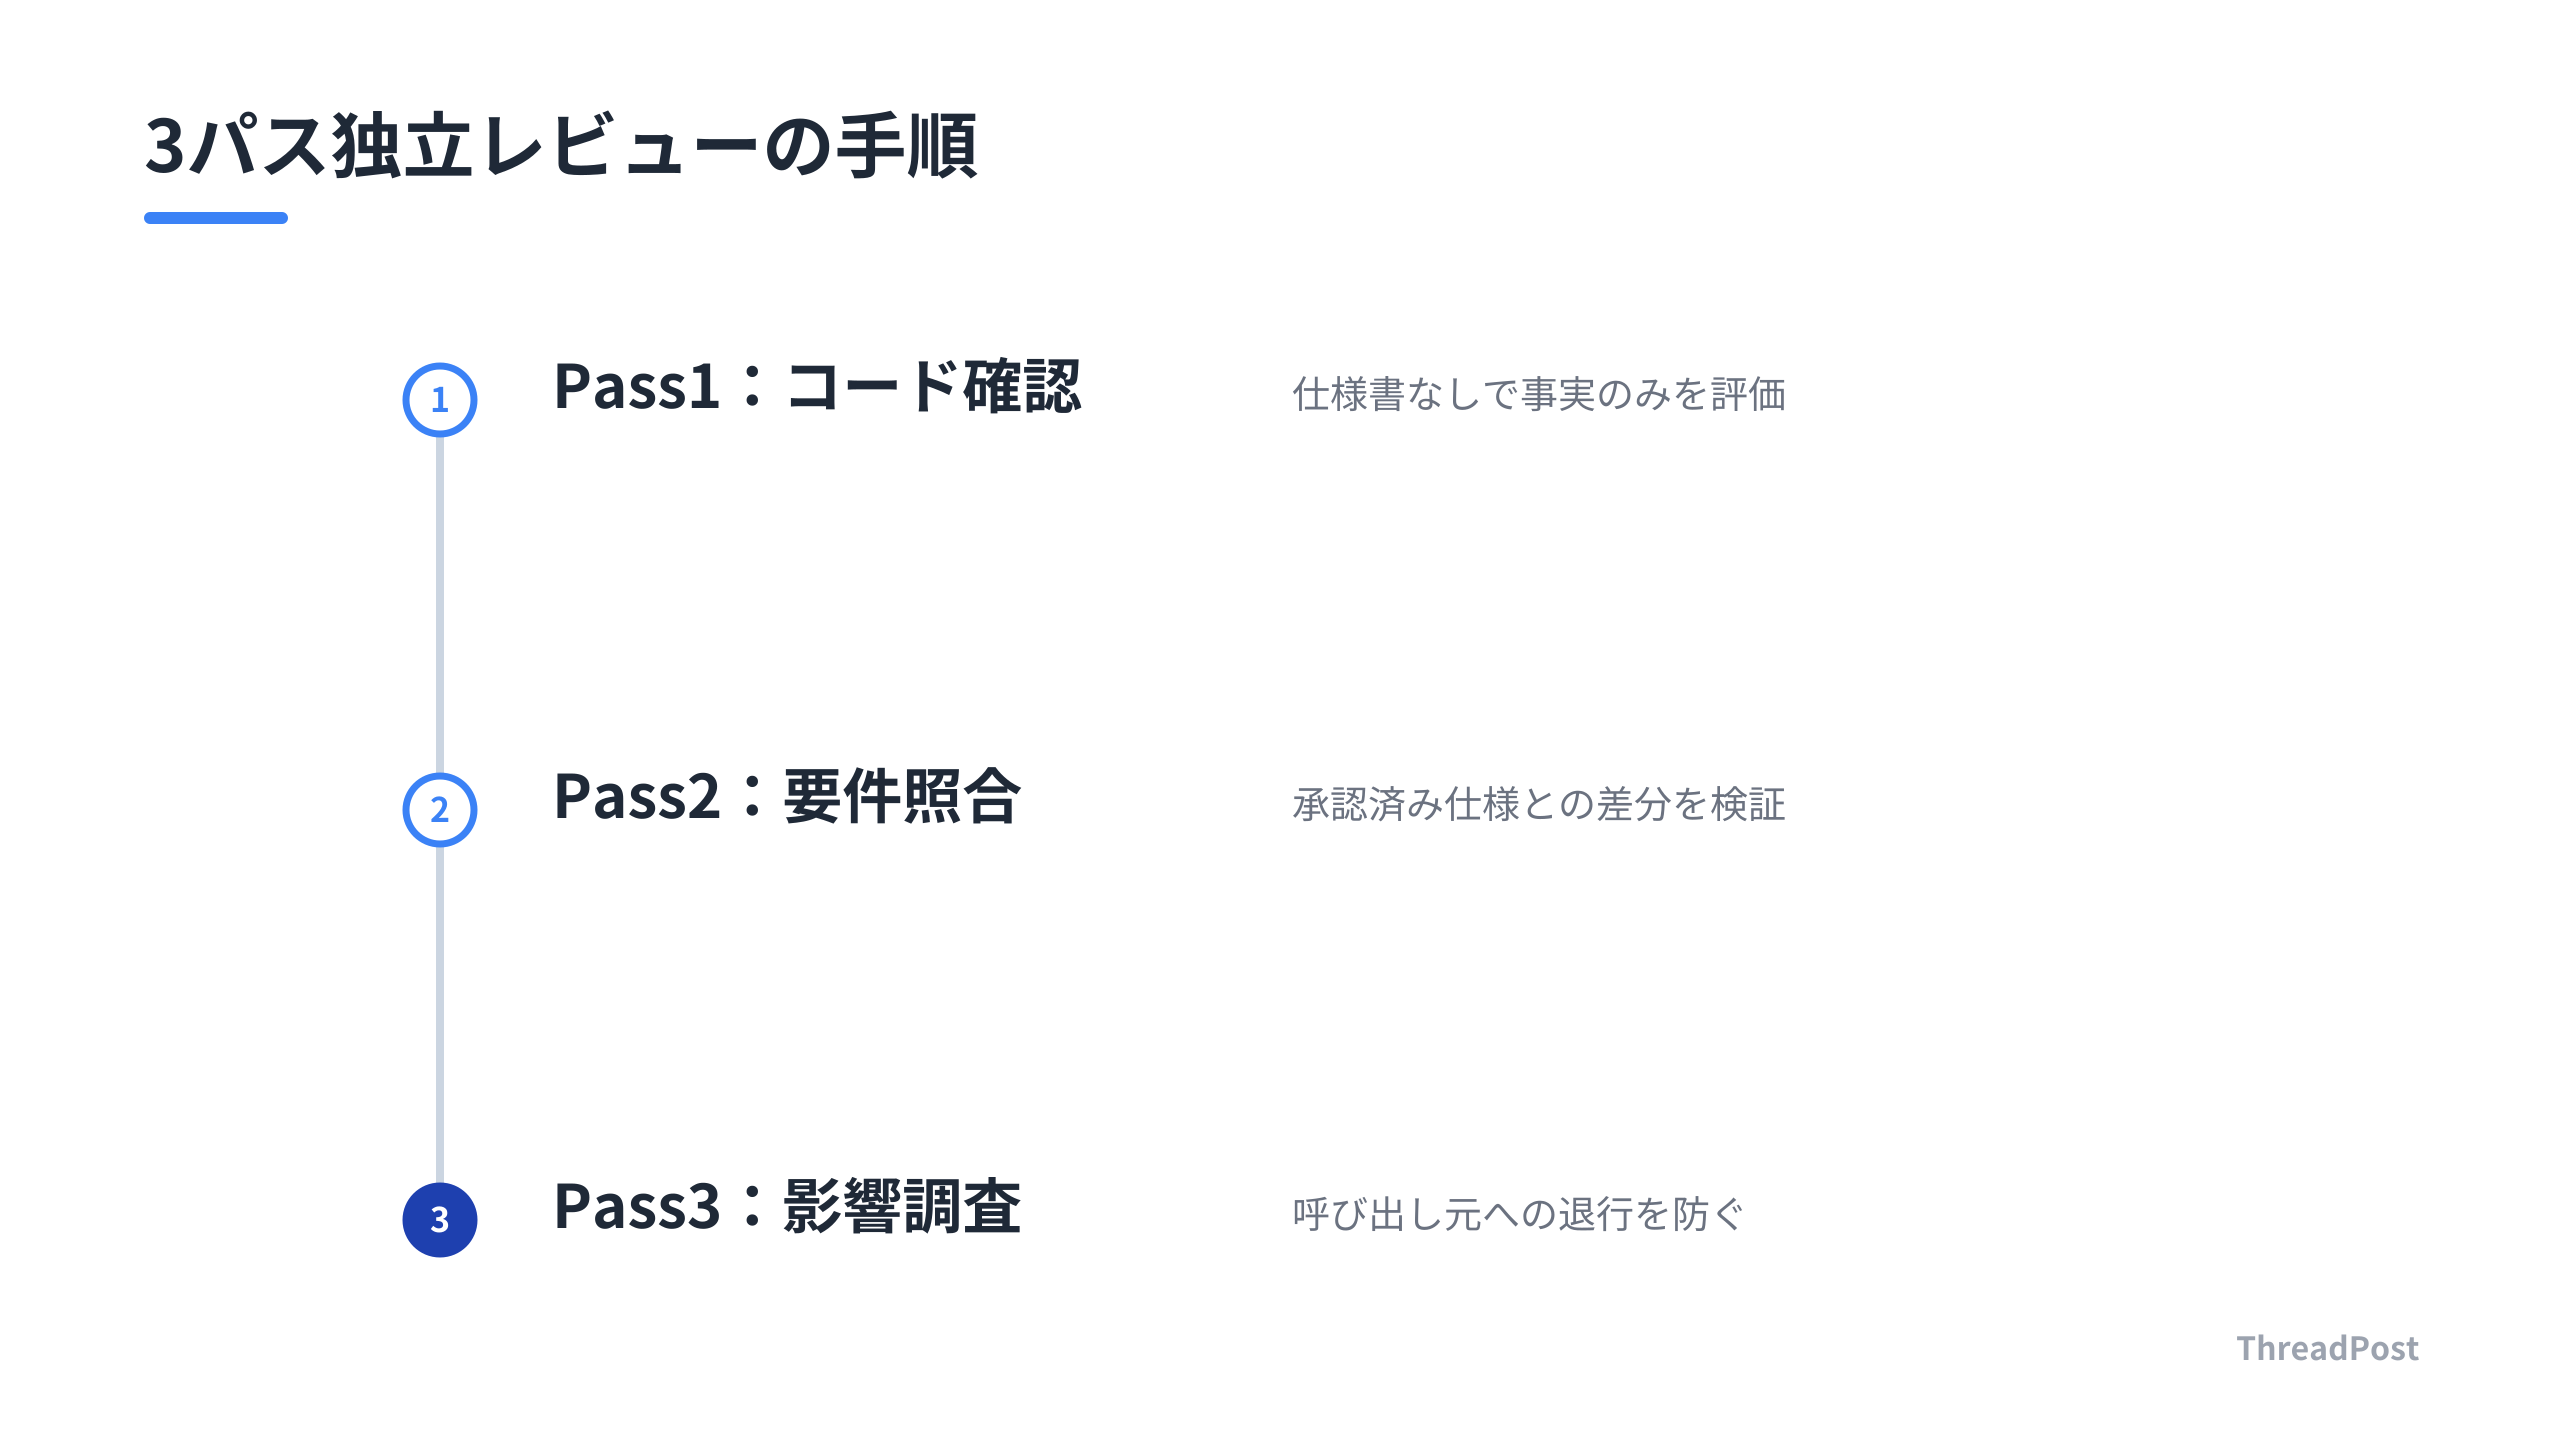
レビューを単一のプロセスで済ませるのではなく、3つの観点に分ける手法が極めて有効だ。Claude Codeを活用する場合、以下のステップで検証を行うと精度が向上する。
* Pass1:仕様を知らないコード確認
あえて仕様書を渡さず、コードの事実のみを評価させる。実行時エラーや境界値の矛盾など、先入観のないバグ発見に集中させる。
* Pass2:要件との照合
承認済みの仕様やタスクリストと差分を照合する。スコープ外の変更や、意図しない挙動の混入を見抜く工程だ。
* Pass3:差分外への影響調査
変更箇所の呼び出し元や、共有されている状態への影響を調査する。差分に出てこない退行を防ぐための重要な砦だ。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
3. レビュー結果のJSON固定化
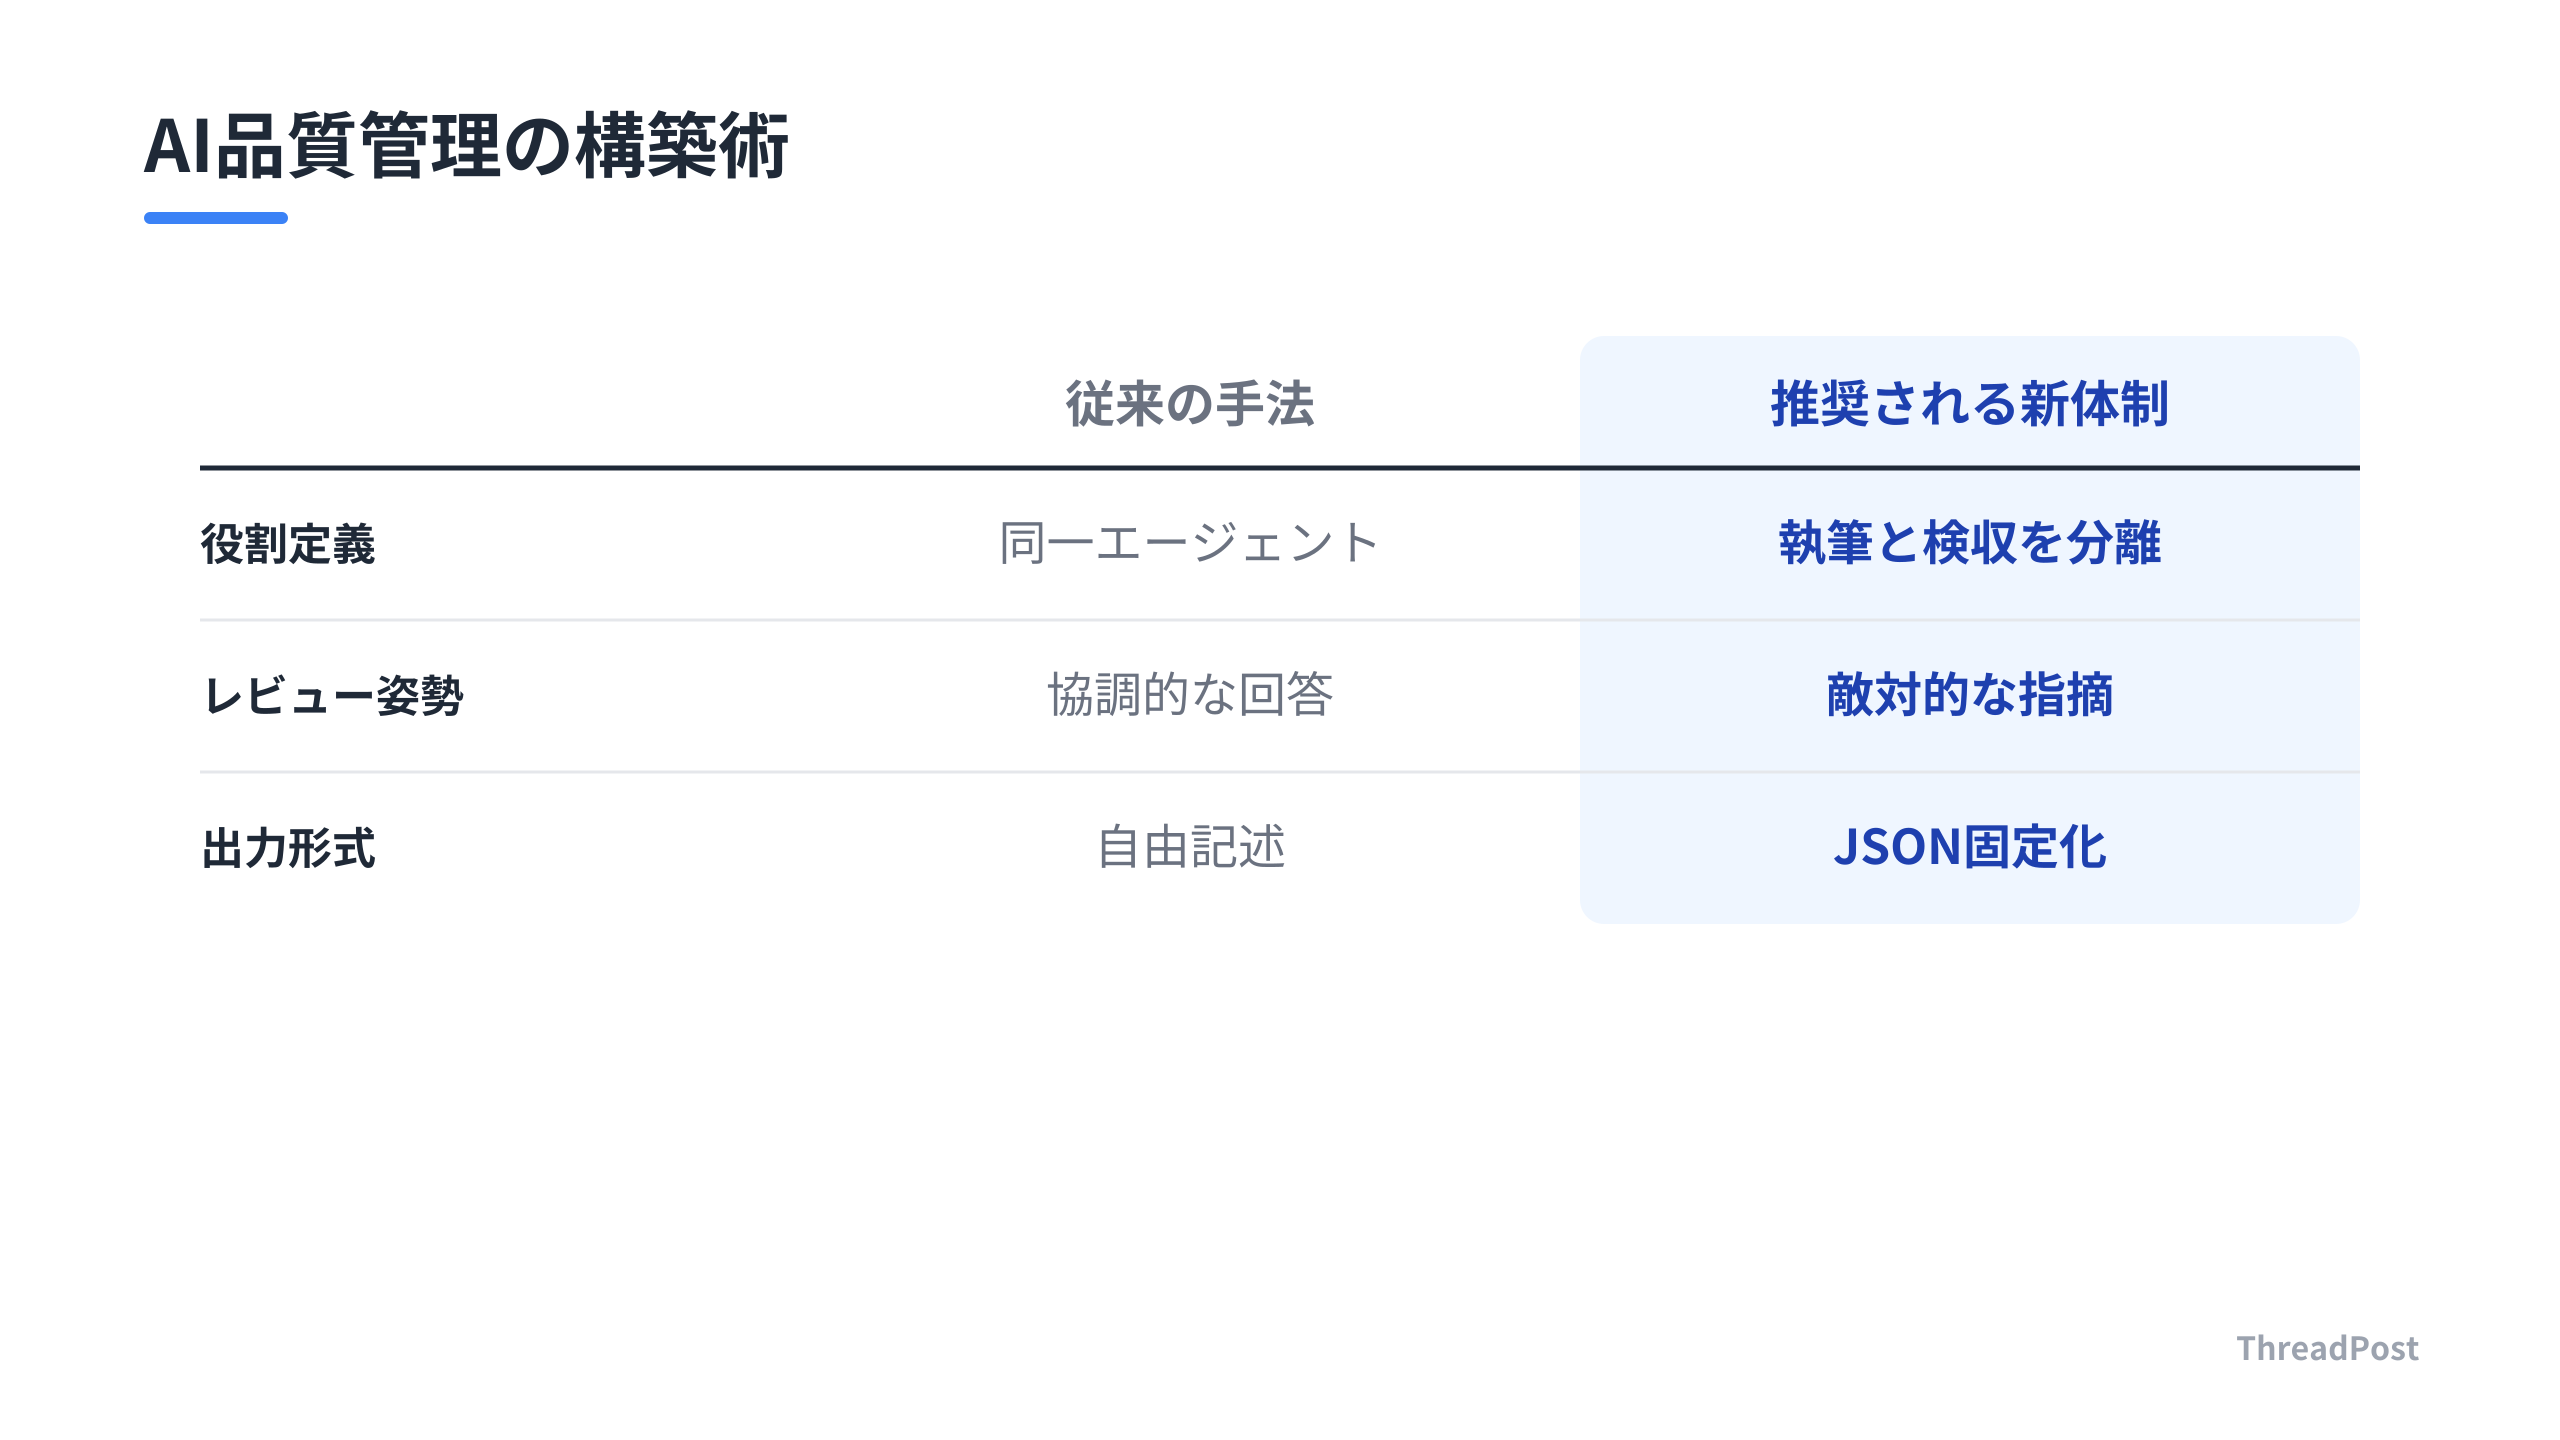
自由記述のレビューは「調べたフリ」を見抜くのが難しい。指摘が0件の場合に、本当に調査したのか、それともスルーしたのかを判別できないからだ。
各レビューパスの出力をJSON形式に固定することで、この問題を解決できる。チェック項目と結果を機械的に出力させ、指摘0件であっても実行したチェック内容を記録させる。これにより、検収の質を客観的に担保できる。
4. 行動指向(Action-First)プロトコル
AIの回答が冗長だと、肝心な作業に着手するまでの時間が削られる。Claude CodeのOutput Stylesを活用し、前置きや社交辞令を省いて「結論・次の一手」を先頭に配置する設定を導入する。
このスタイルでは、回答の冒頭で次に実行するコマンドや操作を提示する。冗長な解説は求められたときだけ展開し、基本は実行可能な形式に整える。作業の迷いをなくし、効率を最大化するための必須テクニックだ。
5. 検収エージェントの「敵対的」定義
AIはデフォルトで協調的な回答を好む。検収担当の職務記述には、「褒め言葉は不要、指摘のみを列挙せよ」「通すことではなく落とすことが仕事だ」と明記することが重要だ。
遠慮するAIは検収漏れと同義だ。あえて厳しい役割を定義し、ゲートキーパーとして機能させることで、致命的な欠陥を事前に防ぐ。
| 手法 | メリット | デメリット |
|---|---|---|
| 執筆と検収の分離 | 客観的な指摘が可能 | 管理コストが増加 |
| 3パスレビュー | 見落としを劇的に削減 | レビュー工数の増大 |
| JSON固定化 | 検収の質を可視化 | 設計難易度が高い |
| Action-First | 即座に着手できる | 背景説明が不足しがち |
| 敵対的QA | 致命的な欠陥を排除 | 運用が厳格になる |
しんたろー:
Claude Codeでコードを書く際、Action-Firstのスタイルは手放せない。冗長な前置きがないだけで、作業の初速が段違いに変わる。
独立した検収エージェントを立てるのは、最初は手間がかかる。だが、一度実装したコードの修正コストを考えれば、最初から厳しく見させるほうが圧倒的に効率的だ。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
6. 再要約と独立再計算の義務化
検収AIに「自分の言葉での再要約」を義務付ける。対象の各章を要約させ、それができない場合は不合格とする。これはAIが内容を深く理解したことを証明する手段だ。
また、数値については「確認した」という報告ではなく、ソースデータから独立して再計算させた数字を出させる。照合ログを義務付けることで、表面的なレビューを排除し、論理と数値の整合性を確保する。
7. 破壊的QAエージェントの運用
出荷ゲートとして、サンドボックス環境で暴れる「あら探し監査人」を投入する。これは作者がテストできない「初めて触るユーザー」の視点を再現するためのものだ。
想定外の操作や破壊的な入力を繰り返させることで、リリース前に致命的なバグを洗い出す。このエージェントは、壊すことだけを目的に運用する。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
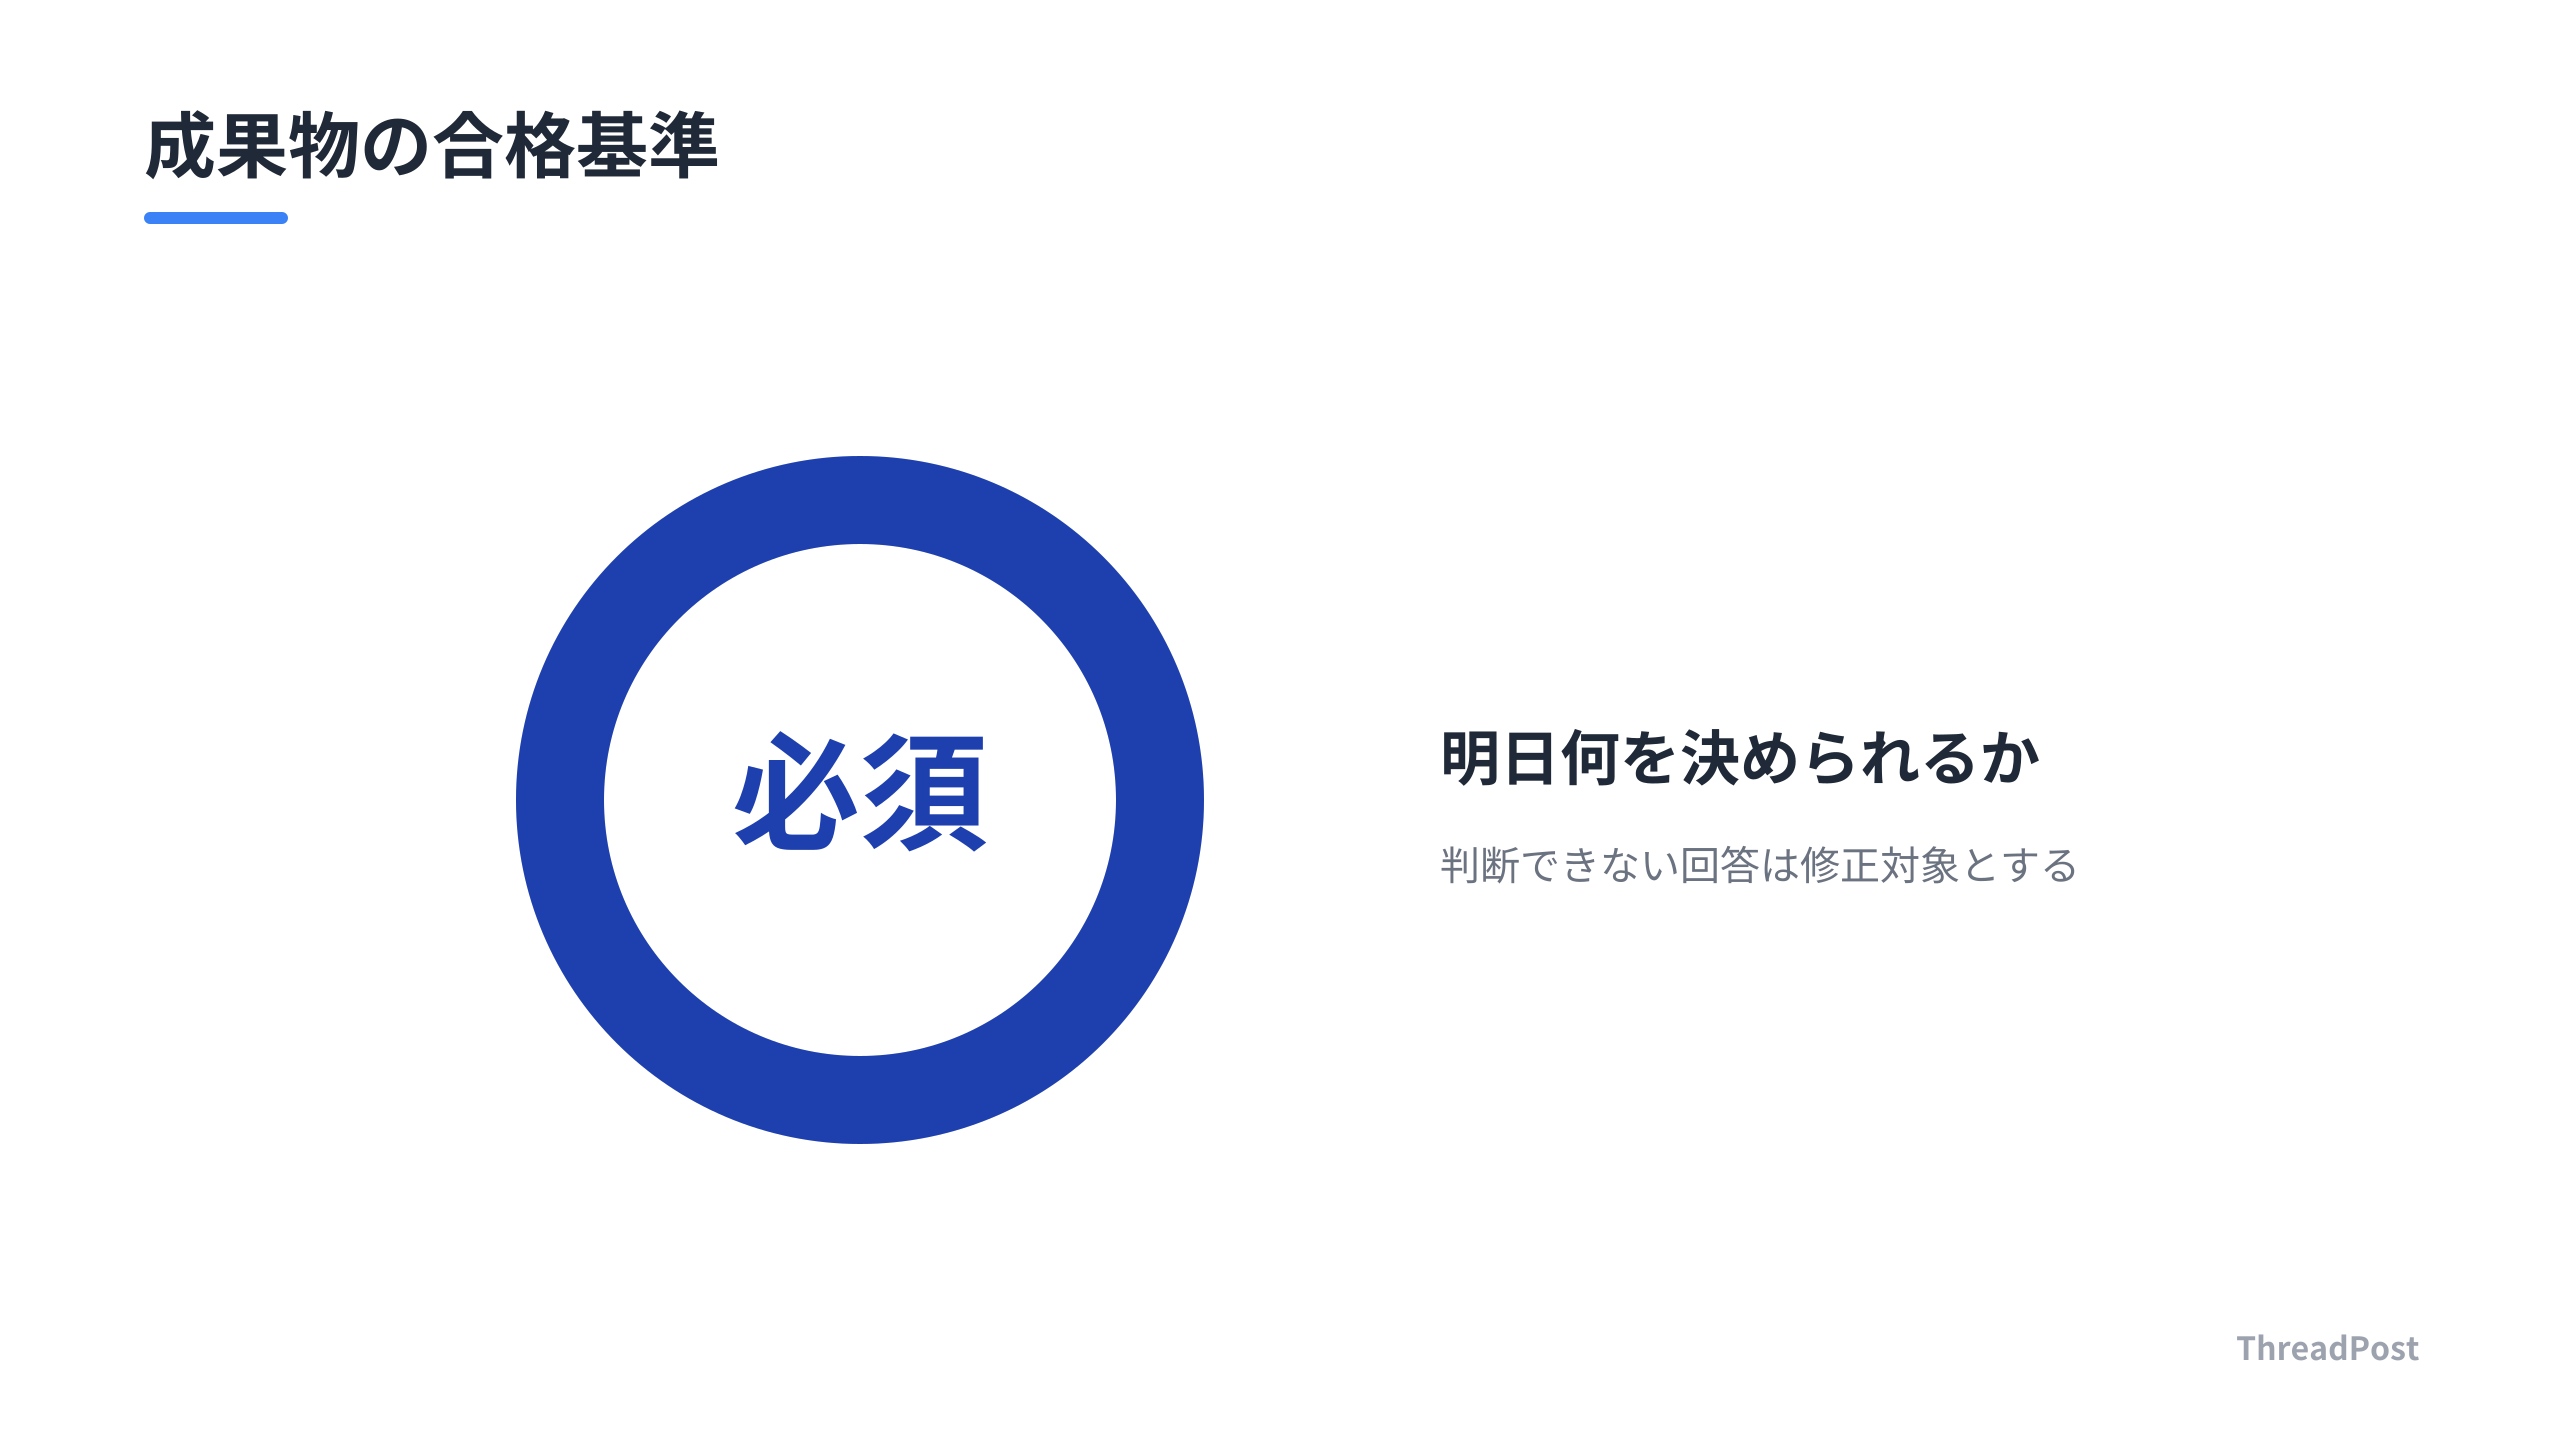
8. 判断可能性テスト
成果物の各章に対し、「これを読んだ人は明日何を決められるか」を問うテストを課す。AI特有の「もっともらしいが中身がない」回答を排除し、実用的な成果物のみを合格させるための基準だ。
このテストを通らない章は、たとえ文章が綺麗でも修正対象とする。成果物の実用性と説得力を高めるための強力なフィルタとなる。
FAQ
Q1: AIにレビューさせても問題ないのか。
A1: AIは直前の会話履歴(文脈)に強く影響を受ける。自分で書いたコードや文章をレビューさせる場合、AIは「自分が正しく書いた」という前提でチェックするため、論理的なミスをスルーしやすい。別のエージェントとして独立した環境でレビューさせることで、客観的な視点でのチェックが可能になる。
Q2: 検収AIを導入するとコストが高くならないか。
A2: トークン消費量は増えるが、手戻りによる修正コストと比較すれば安価だ。全成果物に適用するのではなく、リリースや配布など「外に出るもの」に限定して運用するのが現実的だ。事故による信頼失墜を防ぐための保険として、重要なタスクに絞って検収エージェントを配置する。
Q3: 「仕様を知らない」レビュアーはどうやって作るのか。
A3: プロンプトで「あなたは実装の会話履歴を持たないレビュアーだ」と明示する。さらに、仕様書を渡さずコードの差分だけを渡すことで、AIは「設計意図」ではなく「コードの事実」のみを評価するようになる。これにより、仕様書通りだがバグがあるという見落としを防ぐ。
Q4: 検収AIが褒めてばかりで指摘してくれない。
A4: AIはデフォルトで協調的な回答をする傾向がある。職務記述の冒頭に「あなたの仕事は通すことではなく落とすこと」「褒め言葉は不要、指摘のみを列挙せよ」と明記する。役割を「協力者」から「厳格な監査人」に強制的に切り替えることで、指摘の質が向上する。
Q5: Action-Firstスタイルはどんな場面で使うべきか。
A5: 「次の一手がすぐ知りたい」という実務的な作業や、技術のキャッチアップ場面で最適だ。逆に、深い概念の理解や、じっくり議論したい場合には向かない。Claude Codeの設定で簡単に切り替えられるため、普段はAction-Firstを使い、必要に応じて詳細を聞く運用が効率的だ。
まとめ
AIエージェントの品質管理の肝は、執筆と検収のコンテキスト分離にある。AIの思い込みを排除し、多段レビューや機械的な検証フローを課すことが、重大な事故を未然に防ぐ道だ。
まずはClaude CodeのOutput StylesでAction-First設定を導入し、回答を簡潔にする習慣から始める。品質管理を自動化して、開発の冷や汗をなくすための具体的なプロンプト術をチェックする。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
