


AIエージェント開発の現場で「自動化」という言葉が踊る。高性能モデルさえあれば、AIが自律的に判断してすべてを解決するという幻想がある。
最新のGPT-6 Astraは推論コストを半減させ、研究タスクの効率を高めた。Claude Codeで実装を繰り返す中で、真の効率化は「自動化を詰め込むこと」ではなく「AIの迷いを削ぎ落とすこと」にある。
なぜ今、自動化を疑い、明示的な制御へ回帰するのか。高性能モデルを使いこなし、無駄なトークン消費を防ぐための設計指針を、開発者の視点から解説する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
新モデルGPT-6 Astraがもたらした開発現場のリアル
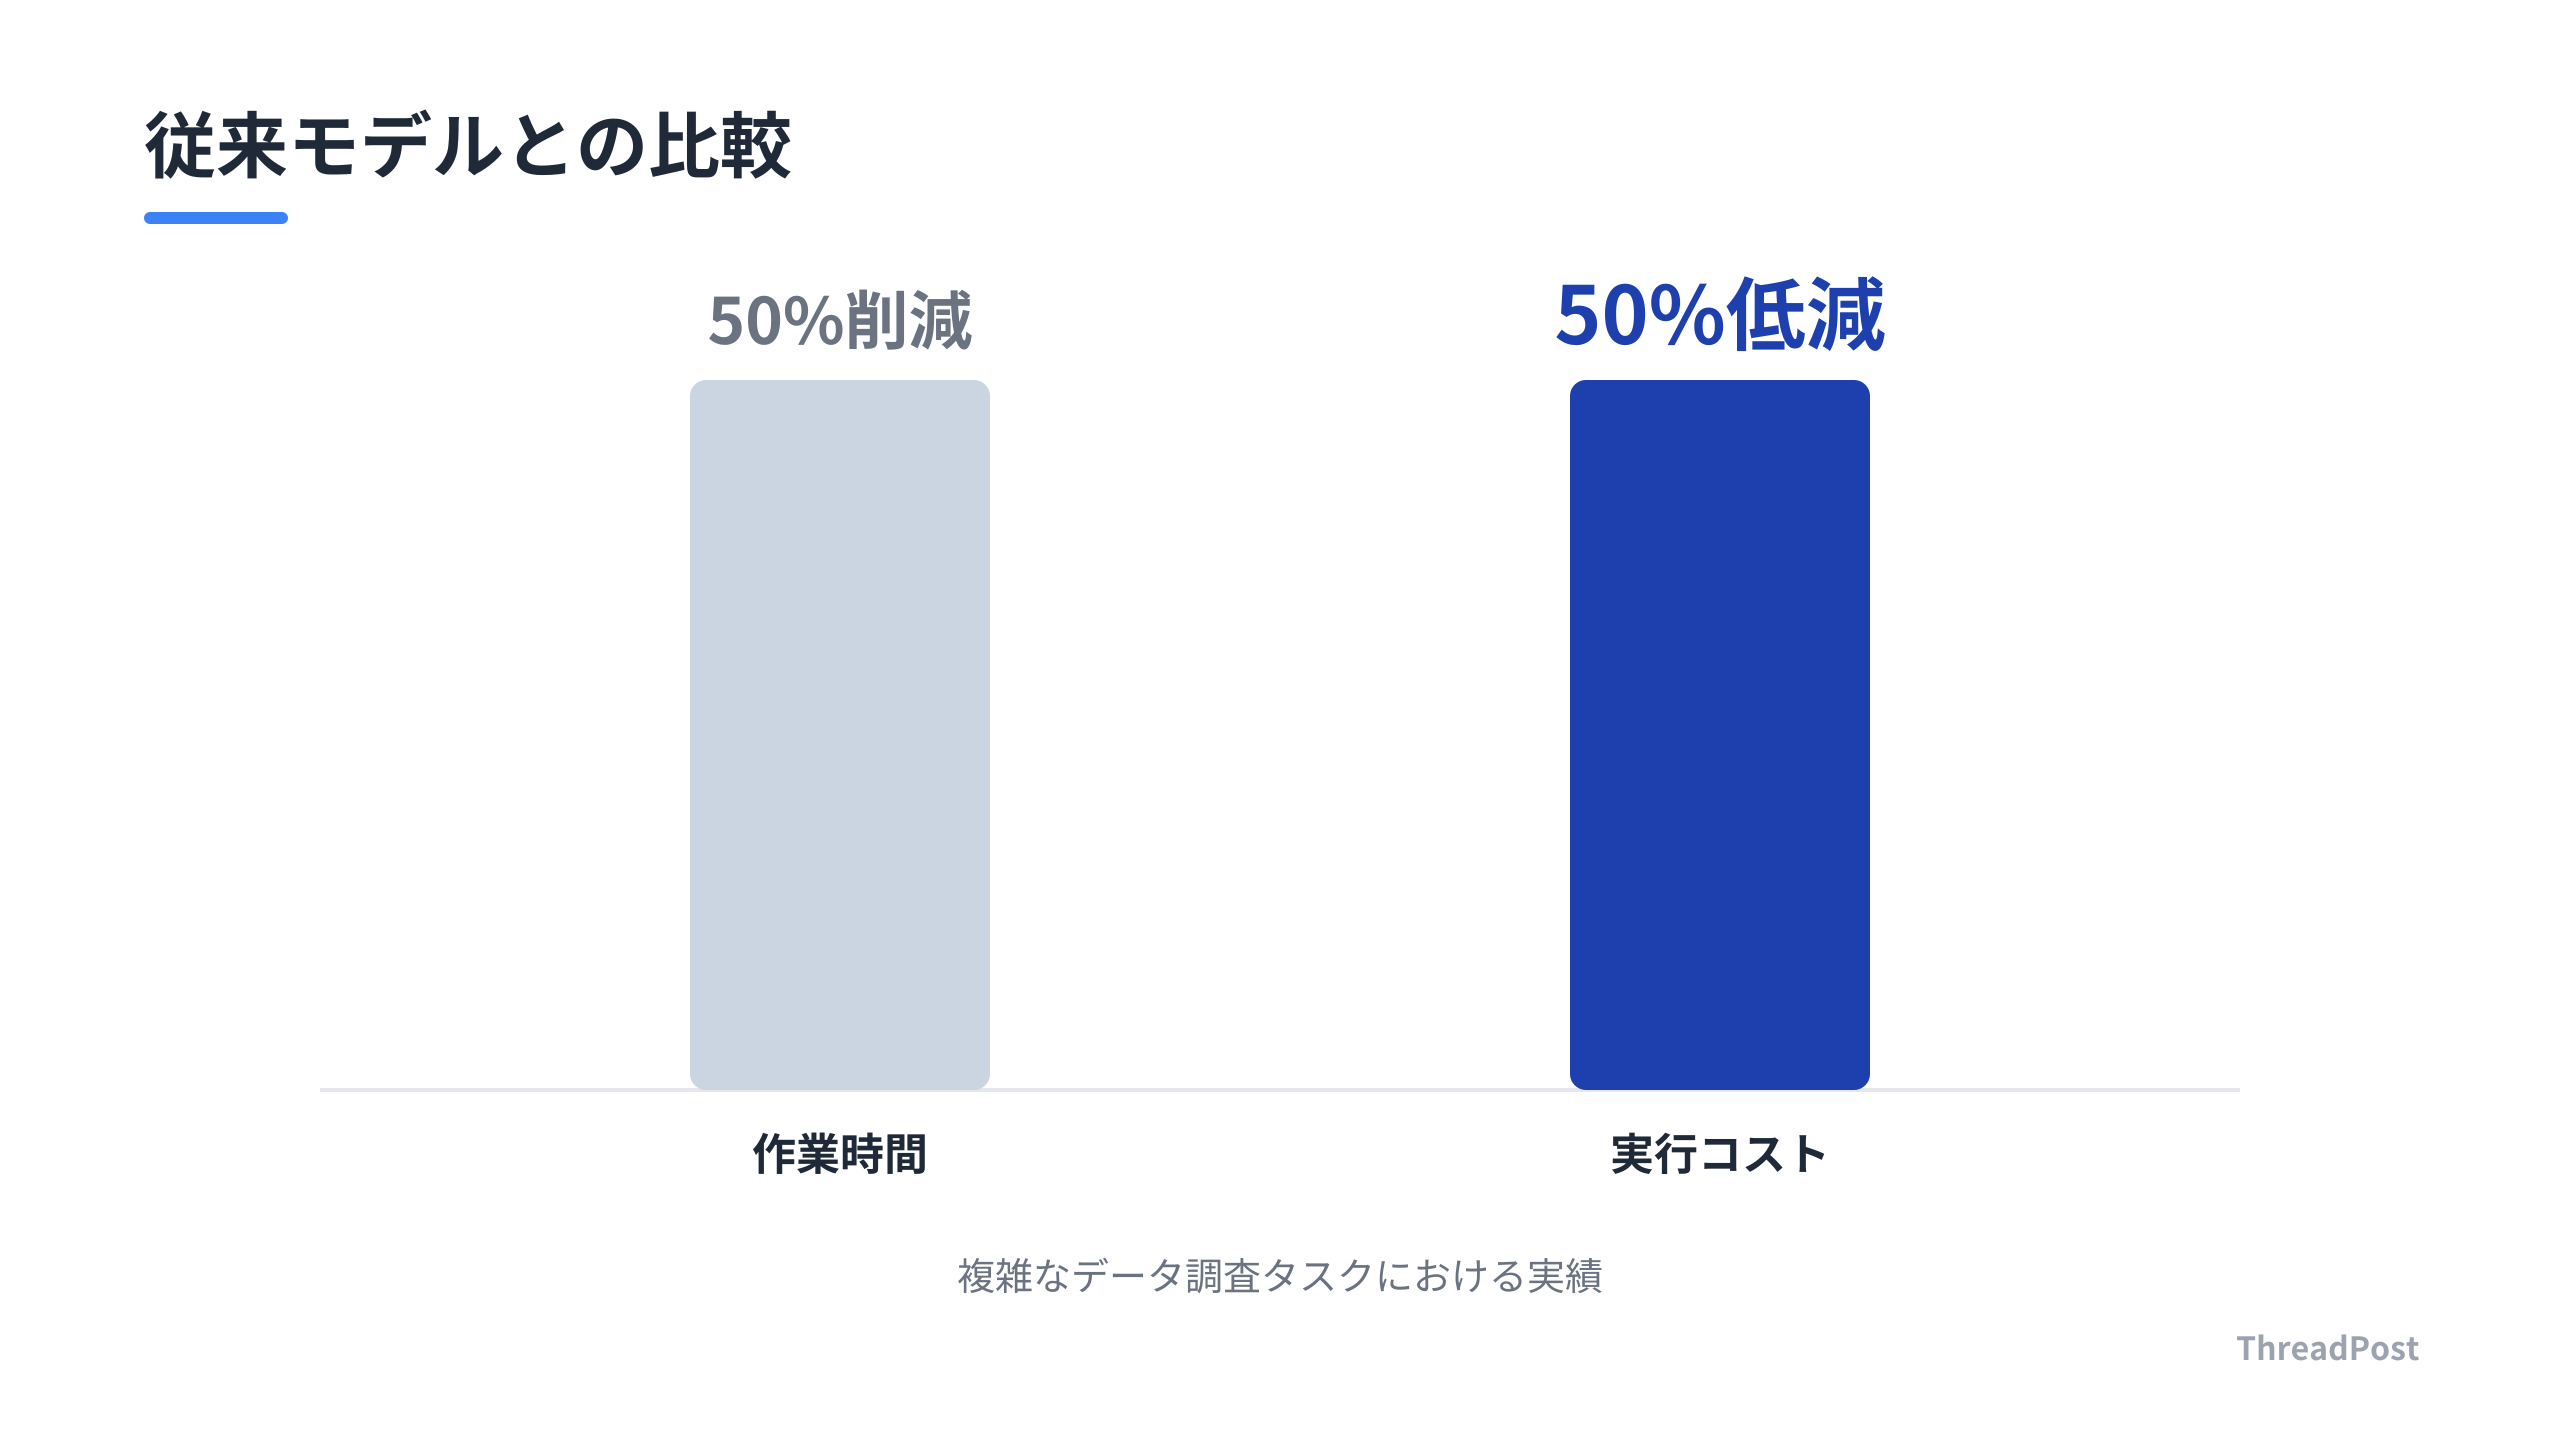
OpenAIが発表したGPT-6 Astraは、AIエージェント開発のコスト構造を書き換えた。実際にこのモデルを導入したスタートアップの事例では、労働市場データの調査において、以前のモデルと比較して作業時間を50%削減し、コード実行コストも50%低減した。
GPT-6 Astraは、従来モデルよりも的確な検索クエリを発行し、最小限のステップで目標に到達する。無駄な推論プロセスが減り、エージェントが「迷う」時間が短縮された。
一方で、AIエージェント開発のインフラ環境は二極化が進む。Prime Intellectが1億3,000万ドル(約190億円規模)のシリーズA調達を完了した事実は、開発者が「汎用モデルへの依存」から脱却しつつある現状を示す。この企業は10億ドルの評価額をつけ、自社専用のAIエージェントを構築するための「フルスタック基盤」を提供する。
多くの企業がOpenAIやAnthropicといったフロンティアラボへの依存にリスクを感じる。モデルの仕様変更やAPIの停止、機密データの取り扱いに対する懸念から、「自社で制御可能なAI基盤」を持つことが経営上の要件となる。
しんたろー:
50%のコスト削減という数字が気になる。エージェントが「何回検索を叩いたか」という行動ログの質が上がっただけではないか。高性能モデルで自動化できる範囲が広がった分、僕らが書くコードの「制御のしやすさ」が重要になる。
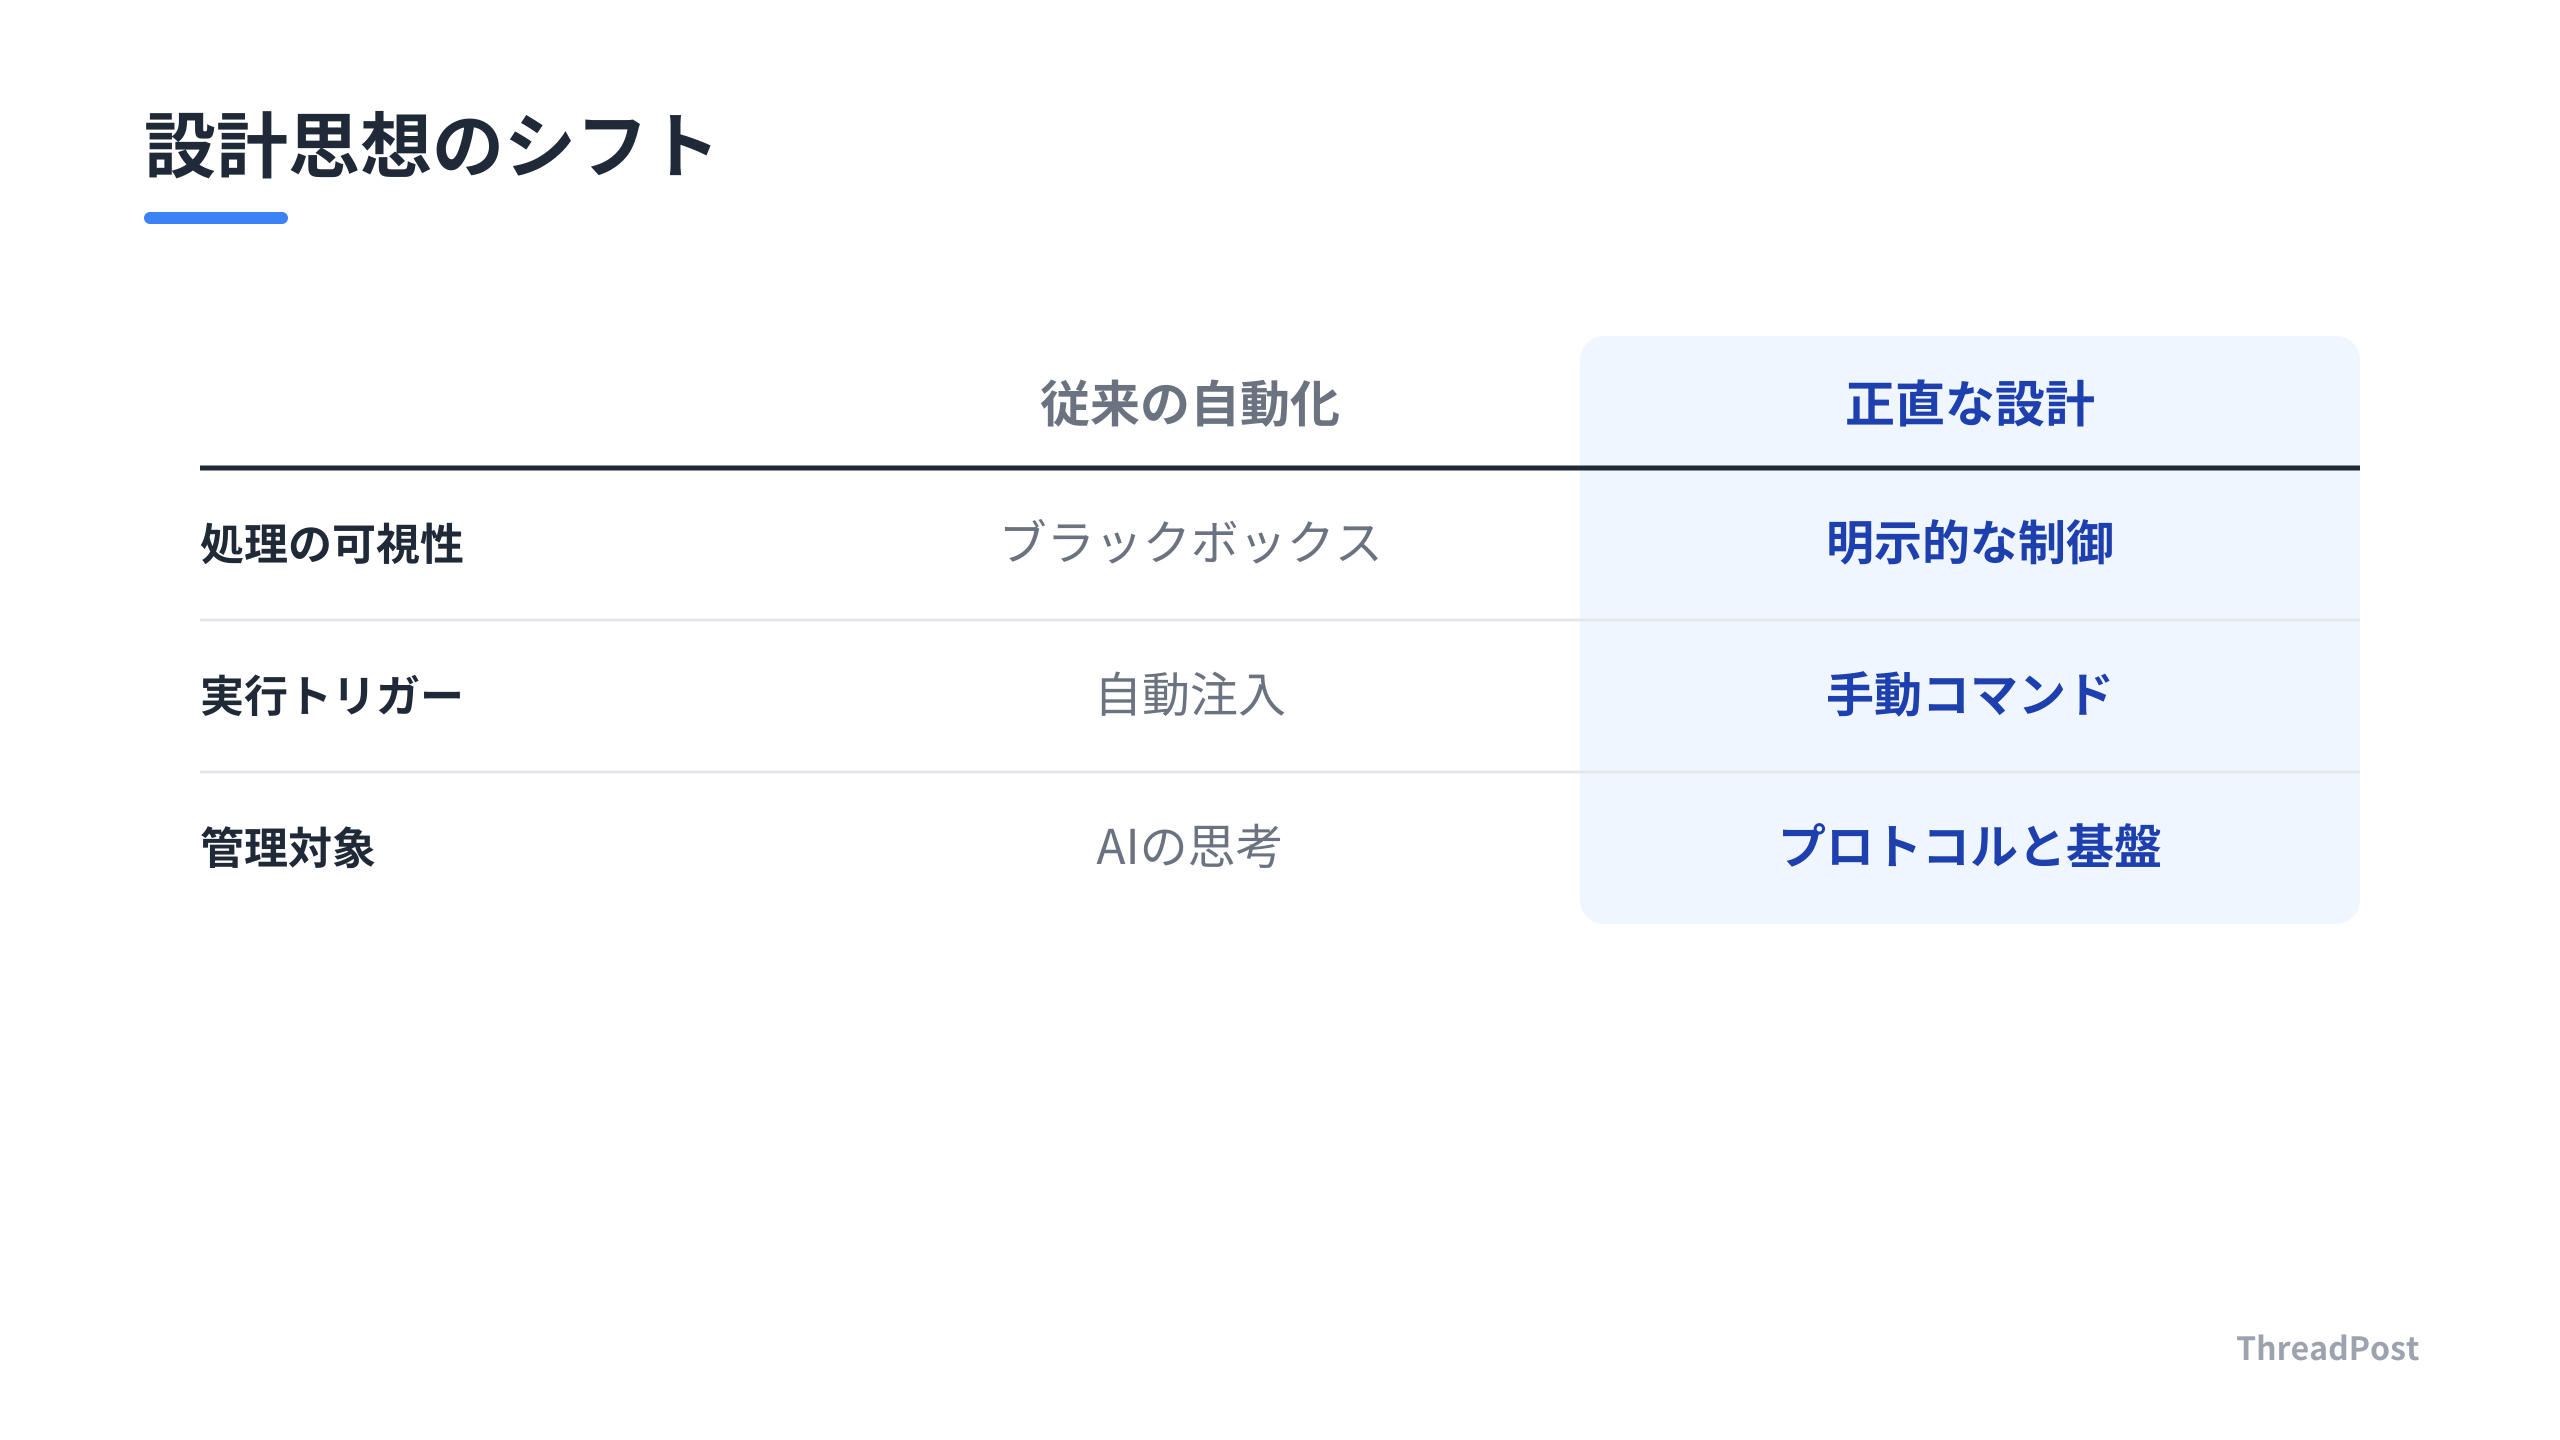
技術的な側面では、開発現場の空気感も変化する。これまで「自動化=正義」とされ、hookで隠れた処理を詰め込む設計が好まれていたが、現在は「正直な動作」を重視する設計へ回帰する動きがある。複雑な自動化を排し、ユーザーがコマンドを明示的に実行するプロセスを好む開発者が増えている。
特にClaude Codeの運用において、セッション開始時に自動でタスクを注入するような「隠れた自動化」を廃止し、「/init-session」を手動で叩く設計へ切り替えた事例がある。自動化というブラックボックスを疑い、AIが実行するステップをユーザーが可視化・制御できる状態に保つことが、GPT-6 Astraのような強力なモデルを使いこなすためのプロトコルとなる。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
モデルの自律性と「正直な設計」の狭間で
GPT-6 Astraのような高性能モデルが登場すると、「AIが勝手に推論して、勝手にコードを書き換えてくれる」という完全自動化の夢が語られる。研究タスクのコストが半減し、複雑なクエリを少ないステップで処理できるのは進歩である。しかし、開発現場の最前線では「AIの自律判断を過信しない」という慎重な設計への回帰が起きている。
OpenAIが提示する「モデルが自律的に効率化する」方向性と、現場の開発者が求める「挙動の安定性と透明性」の間には、責任分界点のズレが存在する。AIが裏側で気を利かせる自動化は、一見便利である。だが、その結果が予期せぬトークン消費を招いたり、意図しないコンテキストを注入してプロンプトを汚染したりする事態がClaude Codeの運用で発生する。
AIが「よかれと思って」やってくれる自動化ほど、デバッグが面倒なものはない。何が起きたか追跡できないブラックボックスは、SaaS開発におけるボトルネックになる。
今の開発トレンドは、エージェントに「賢さ」を求めることよりも、「何をしたか」を明示させることにシフトしている。例えば、セッション開始時に自動で過去のタスクを読み込むような機能は、実際にはAIが「いつ、何を読んだか」をユーザーが制御できない。これを手動コマンドの実行に切り替えるだけで、エージェントの挙動は安定する。
これは単なる「手動への逆戻り」ではない。AIの性能向上に伴い、管理すべきは「AIが何を考えているか」ではなく、「AIがどのタイミングでどの基盤データを参照するか」というプロトコルの設計である。
企業が「自社でエージェント基盤を持つ」動きが加速しているのも、この文脈と無関係ではない。GPT-6 Astraのような汎用モデルは強力だが、特定の業務フローや機密性の高いデータに対しては、モデルのAPIに依存しすぎるリスクがある。自社でモデルや評価基盤を管理し、「自分たちのエージェントに何を実行させるか」をコントロールできる能力が、開発者に求められるスキルセットとなる。
効率化の本質は「AIをどれだけ自律させるか」ではなく、「人間がどれだけAIを透明に制御できるか」にある。複雑な自動化を積み重ねるよりも、シンプルで正直なコマンドを積み重ねる方が、開発スピードは上がり、運用コストは下がる。Claude Codeで1人SaaSを回していると、この「自動化を削ぎ落とす」作業の重要性を実感する。高性能なモデルが使える今、僕らはその力をどう「制御」するか、その設計思想を磨く。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
明日から取り入れるべきエージェント設計のリアリティ
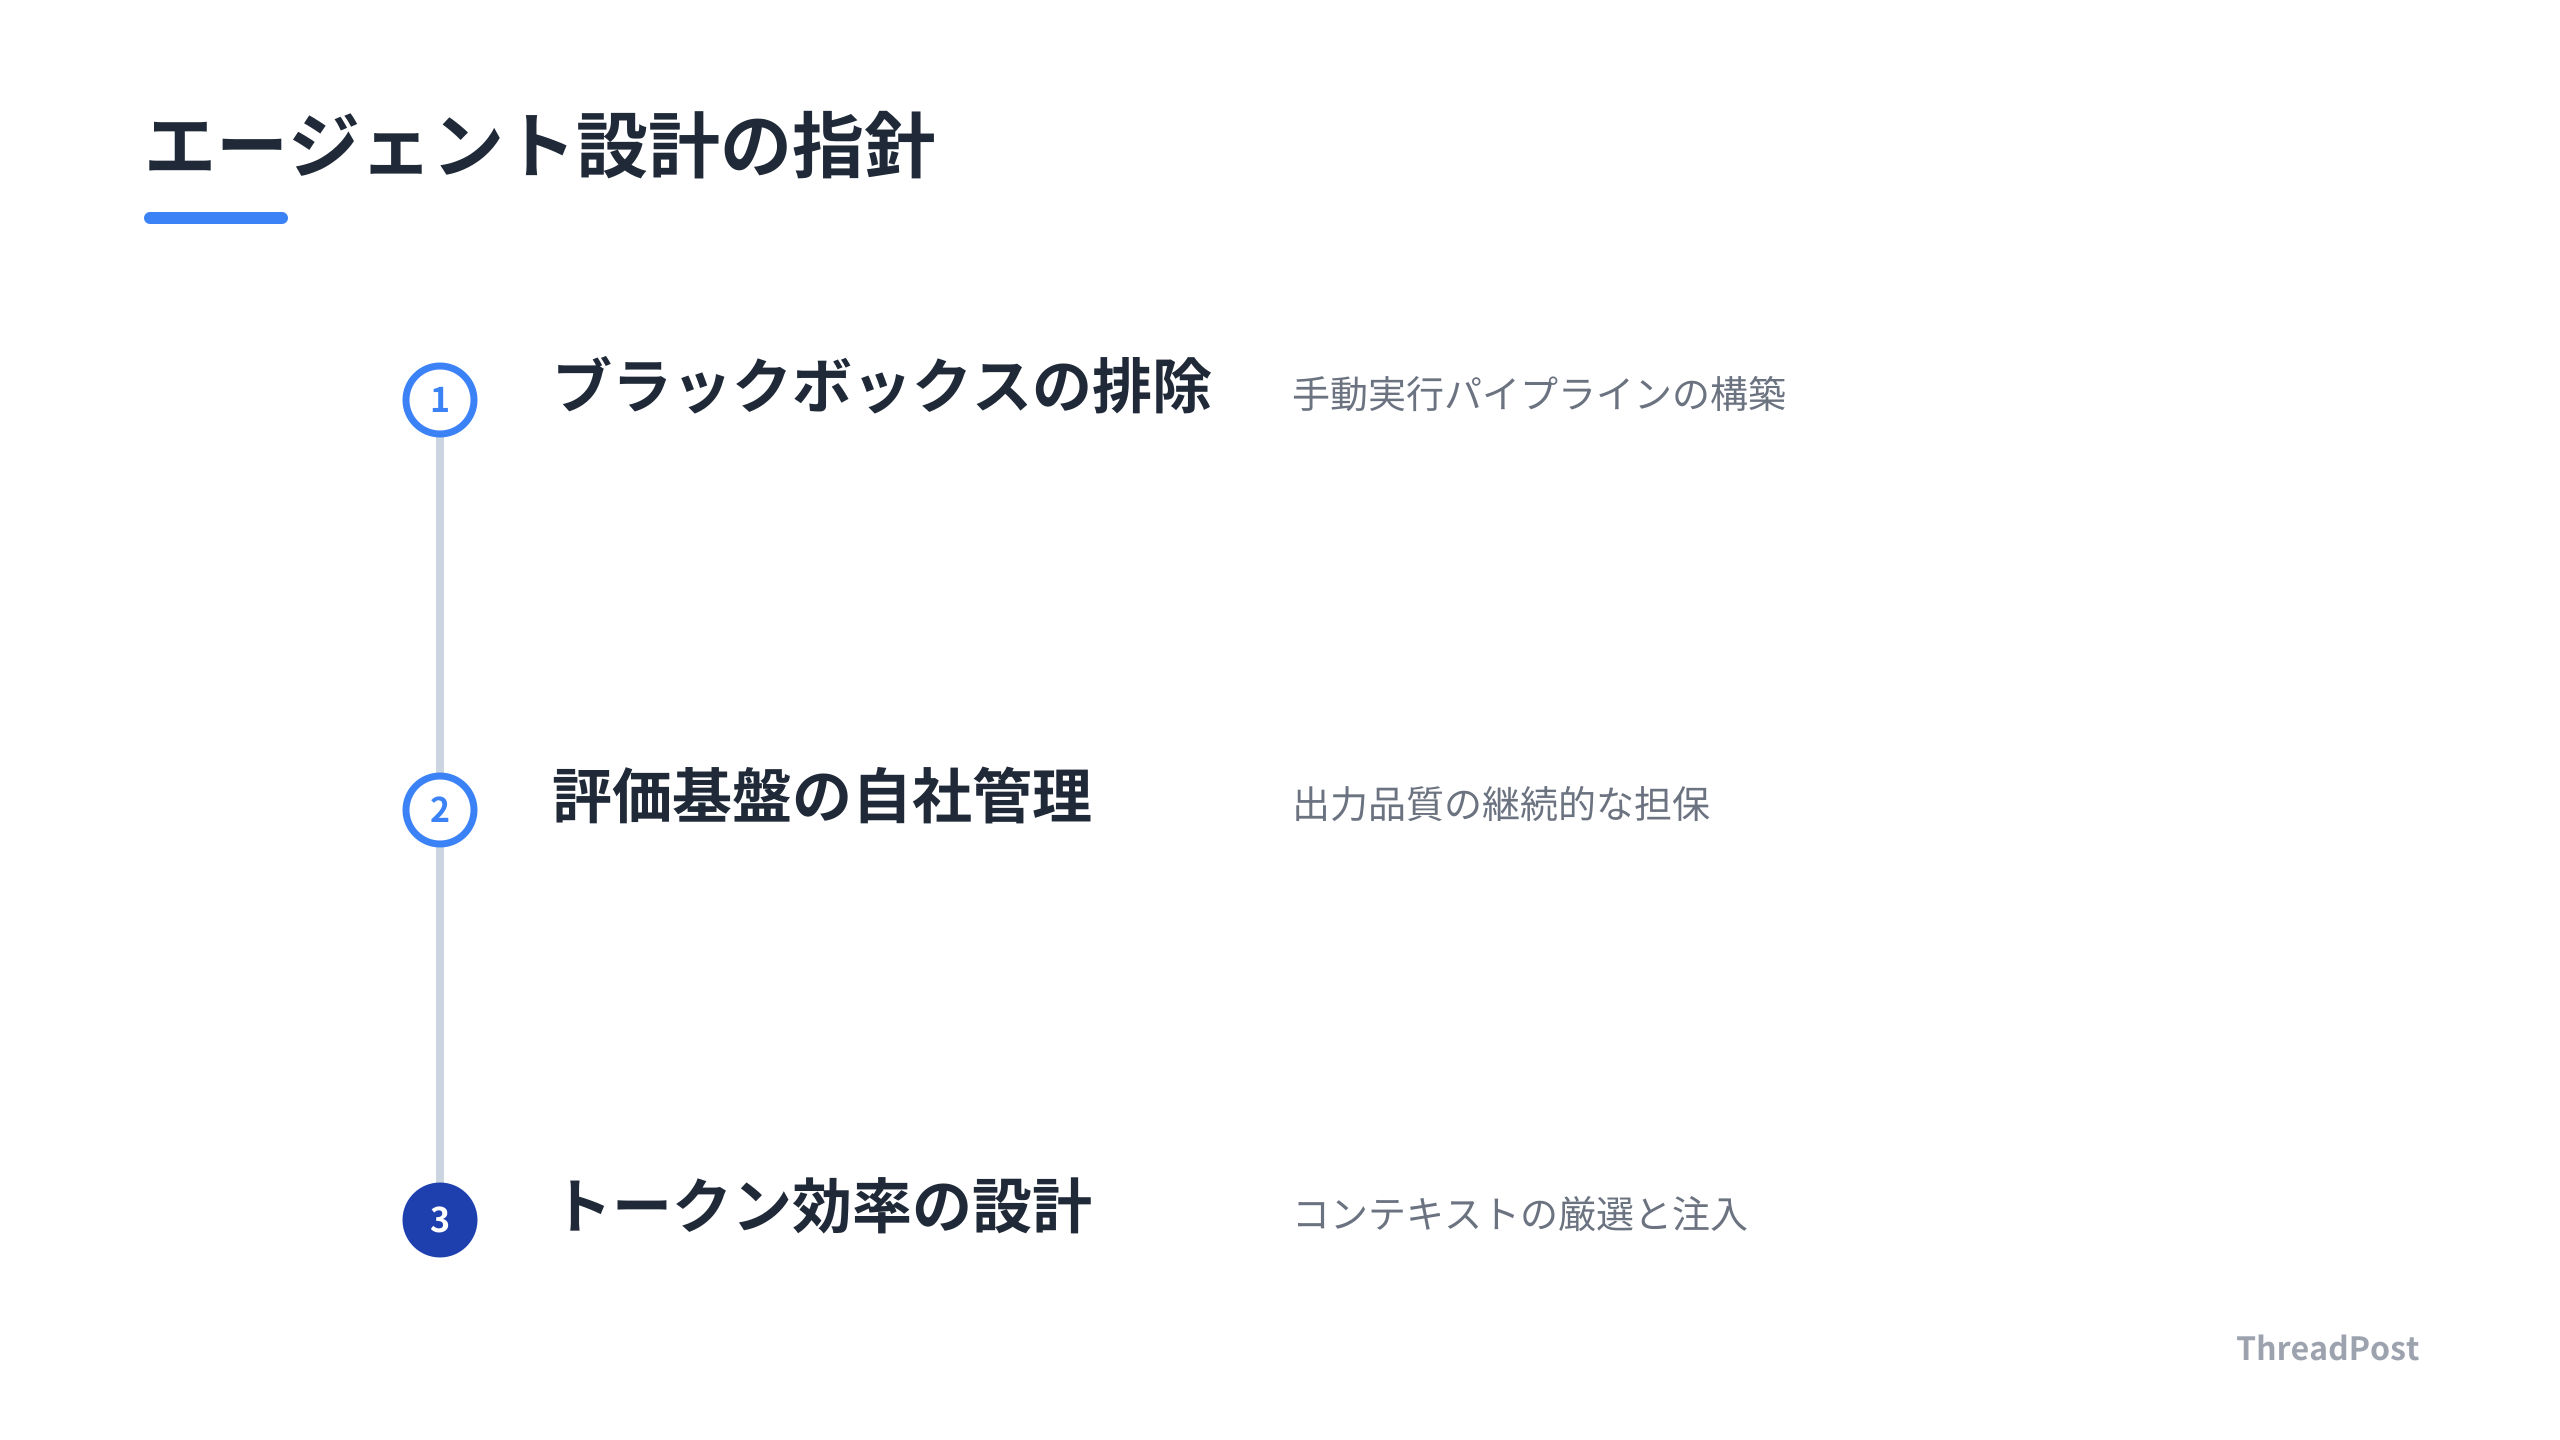
高性能なモデルをただ叩く時代は終わった。GPT-6 Astraのような強力なモデルが登場した今、実務で意識すべきは「自動化の密度」を調整し、制御可能なインターフェースを設計することである。以下の3つのアクションが開発の質を左右する。
まず一つ目は、「ブラックボックスな自動化」を排除することである。エージェントが裏側で勝手に推論を重ねるフローは、トークン消費の予測が立たず、デバッグも困難になる。重要な処理は、あえて「手動実行のコマンド」として切り出し、AIにはその結果を処理させる「人間が介在するパイプライン」を残す。
二つ目は、「評価基盤」の自社管理である。API経由でモデルを利用する場合でも、その出力が期待通りかを自動判定するテストコードや、特定の業務フローにおける正解データを自社で持つ。これがあれば、モデルの仕様変更やAPIの挙動変化があっても、自社エージェントの品質を担保できる。Prime Intellectのようなツールが選ばれるのも、この「自分たちでコントロールできる基盤」を求めているからである。
三つ目は、トークン効率を「設計」の最優先事項に据えることである。モデルが賢くなればなるほど、プロンプトに含める情報の取捨選択が重要になる。不要なJSONブロックや過去のセッション履歴を注入せず、必要な情報だけを厳選して渡す仕組みを作る。Claude Codeの運用で学んだ「セッション開始時に最小限のコンテキストだけを渡す」というアプローチは、どんなエージェント開発にも応用できる。
コードを書き散らすより「どの情報を渡して、どのコマンドを叩かせるか」という設計に時間を割いたほうが、バグも減りAPI代も安く済む。自動化に頼りきらず、エージェントを「賢い部下」として扱うためのプロトコル作りが、今の開発者の腕の見せ所だ。
明日からの開発では、新しいエージェントを作る前に、「どこまでをAIに委ねて、どこからをコマンドで制御するか」を書き出す。自動化のコードを書く前に、そのフローを人間が手動で回すステップを描く。そこで無駄だと感じた部分を削ぎ落としてから、初めてAIに実装させる。この「引き算の設計」が、高性能なAIモデルを使いこなすための最短距離である。
また、機密情報を扱う業務であれば、APIの利用範囲を限定し、自社で構築した評価基盤と組み合わせる「ハイブリッド構成」の準備も進める。モデルのAPIだけに依存した開発は、基盤が揺らぐリスクと隣り合わせである。自社で制御可能な「エージェントの制御層」を持っているか。この一点が、長期的な開発効率の差となって現れる。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
AIエージェントの自動化をどこまで進めるべきか?
「ユーザーが意図を制御できる範囲」に留めるのが最適である。過度な自動化は、モデルが意図しない挙動をとるリスクや、不要なトークン消費を招く。エージェントには「何をしたか」を明示させ、ユーザーがコマンドで介入できる余地を残す設計が、長期的な運用コストと信頼性を向上させる。自動化は「魔法」ではなく「プロトコル」である。
GPT-6 Astraを使えば、自社でエージェントを構築する必要はなくなるのか?
むしろ逆である。GPT-6 Astraのような高性能モデルは「汎用的な研究」には強力だが、企業独自のデータや特定の業務フローに最適化されたエージェントには、専門的な基盤を用いた「自社構築」が重要である。特にデータプライバシーや、モデルの突然の仕様変更を避けたい企業にとって、自社で制御可能なエージェント基盤を持つことはリスク管理上の要件である。モデルの性能は借りるもの、制御基盤は持つものと割り切るのが戦略である。
開発コストを抑えつつエージェントの精度を上げるコツは?
「推論ステップの削減」と「情報の選別」である。高性能なモデルであっても、無駄な情報をプロンプトに詰め込めばトークン代は嵩む。エージェントが迷走する原因の多くは、文脈の肥大化である。セッション終了時に不要なJSONブロックを削ったり、初期化コマンドを明示的に叩くことで、モデルが「本来やるべきタスク」に集中できる環境を作る。高機能なモデルを導入する前に、今ある環境で「AIが判断に迷うノイズ」を徹底的に取り除くことから始める。
まとめ
GPT-6 Astraのような高性能モデルは強力な武器であるが、エージェント開発の本質は「自動化の魔法」ではなく「制御の解像度」にある。モデルにすべてを委ねるのではなく、必要な情報を削ぎ落とし、実行ステップを可視化する。この「正直な設計」が、コストを抑えつつ安定した成果を出す道である。
AIに依存しすぎない開発体制を組んでいるチームほど、最新モデルを使いこなして高速に成果を出している。複雑な自動化という罠を避け、自分たちの手で制御可能な基盤を構築する。このバランス感覚を磨くことが、これからのAI開発を生き抜く鍵である。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
