


「ただの読み上げ」は終わりだ。Googleが発表した最新の音声モデルは、アクセントや感情の起伏を細かく指示できる「演出ツール」へ進化した。
OpenAIはリアルタイムの会話と割り込みに特化したモデルを投入している。開発者は自分のプロダクトに「感情」を実装するか、「エージェント的な対話」を優先するかを選択する。
Claude Codeを使いSaaSを開発する視点から、音声技術の進化が開発者のワークフローとUXをどう変えるのか。現場の実装感覚とあわせて解説する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
感情をプログラムする時代へ|AI音声モデルの最新動向
GoogleとOpenAIが、異なるアプローチで「音声インターフェース」の定義を書き換えた。
Googleの「Gemini 3.8 Flash TTS」および「Gemini 3.8 Flash-Lite TTS」は、音声生成を「演出可能なスタジオ」へ昇華させた。
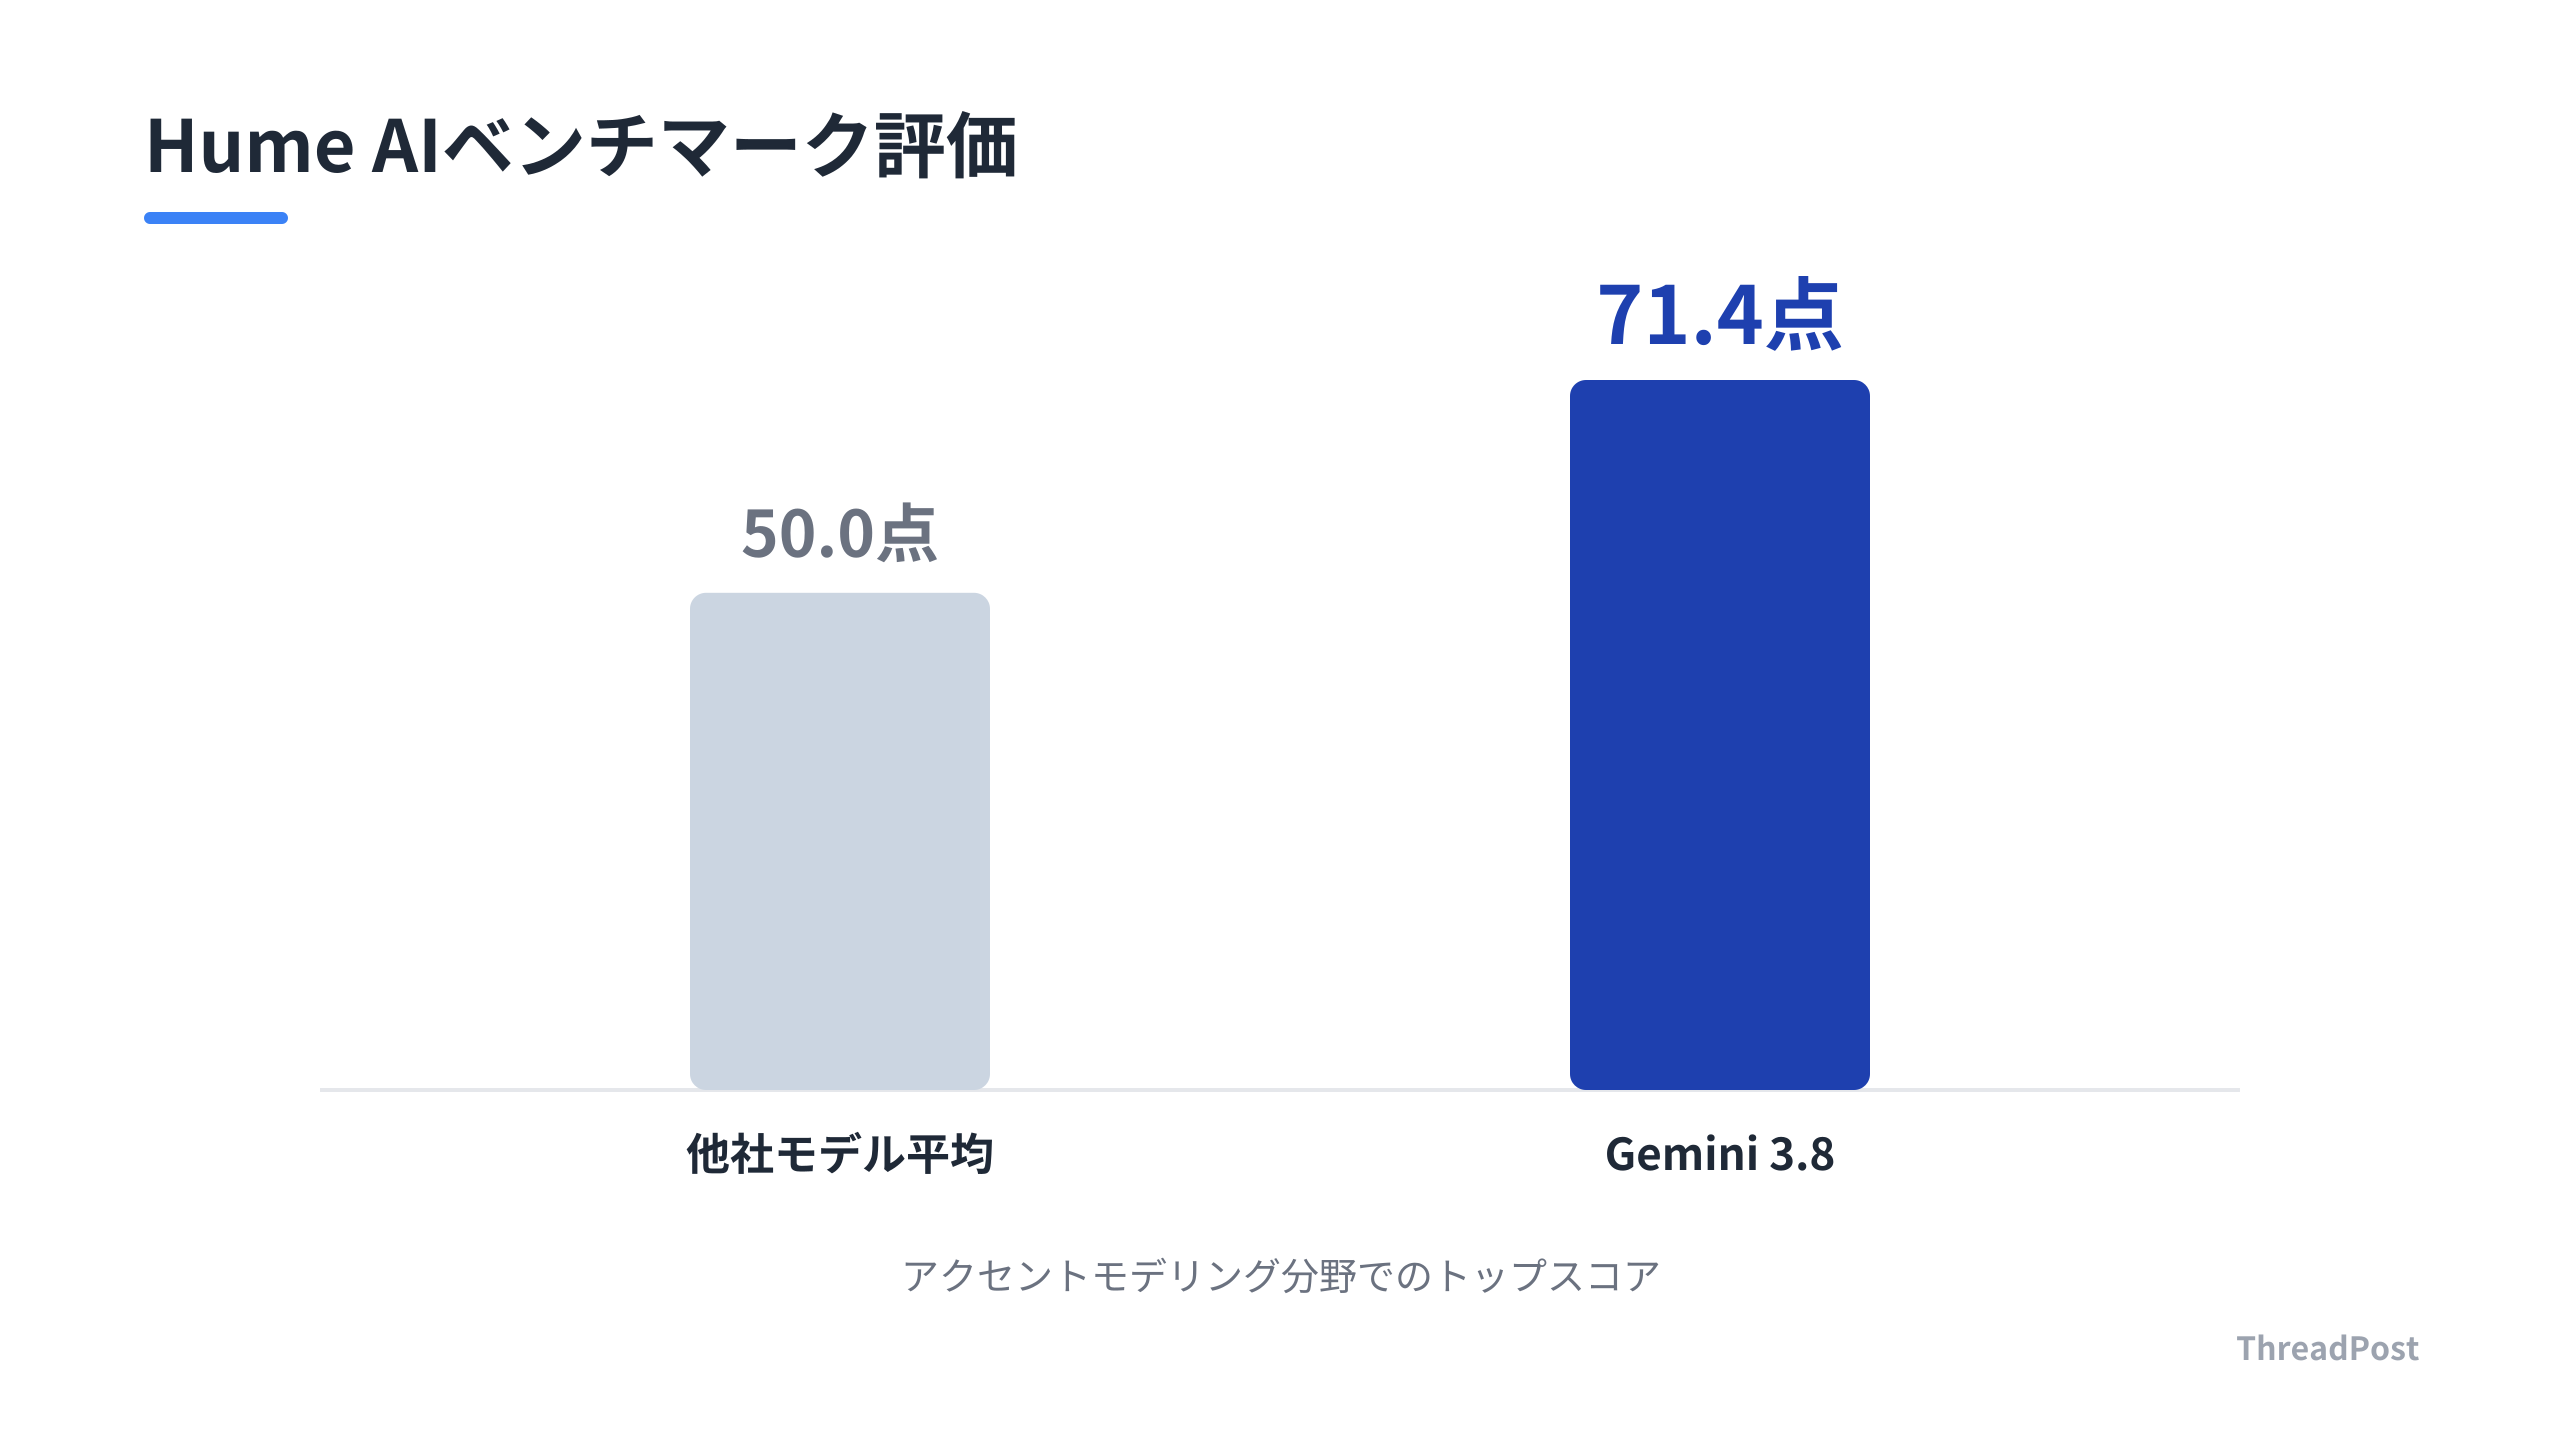
Hume AIのボイスデザインベンチマークで71.4点を記録し、アクセントモデリングでトップに立った。
ユーザーはプロンプトを通じて声の抑揚、感情のトーン、ブレスまでディレクションできる。
30種類のベースボイスに加え、無限のキャラクターを生成できる点は、ゲーム開発やオーディオブックで武器になる。
OpenAIの「GPT-Live-1」と「GPT-Live-1 mini」は別の軸で攻めている。
全二重通信(フルデュプレックス)モデルとして設計され、人間同士のような「割り込み」や「自然な沈黙」を許容する。
ChatGPTの音声モードで課題だった「会話のテンポ」や「応答の知能」が改善された。
有料プランユーザーは、GPT-5.5クラスの推論能力を背景にしたリアルタイム対話が可能だ。
1億5000万人以上のユーザーが音声機能を利用しており、音声はコンピューティングの主要なインターフェースになりつつある。
しんたろー:
Googleの「演出力」とOpenAIの「会話の持続力」。どちらを選ぶかでアプリのUXは別物になる。ThreadPostのバックエンドで音声通知を実装する際、キャラ性を出すか、エージェント的なタスク処理を優先するかで迷う。APIの使い分けが重要だ。
両者の戦略には温度差がある。
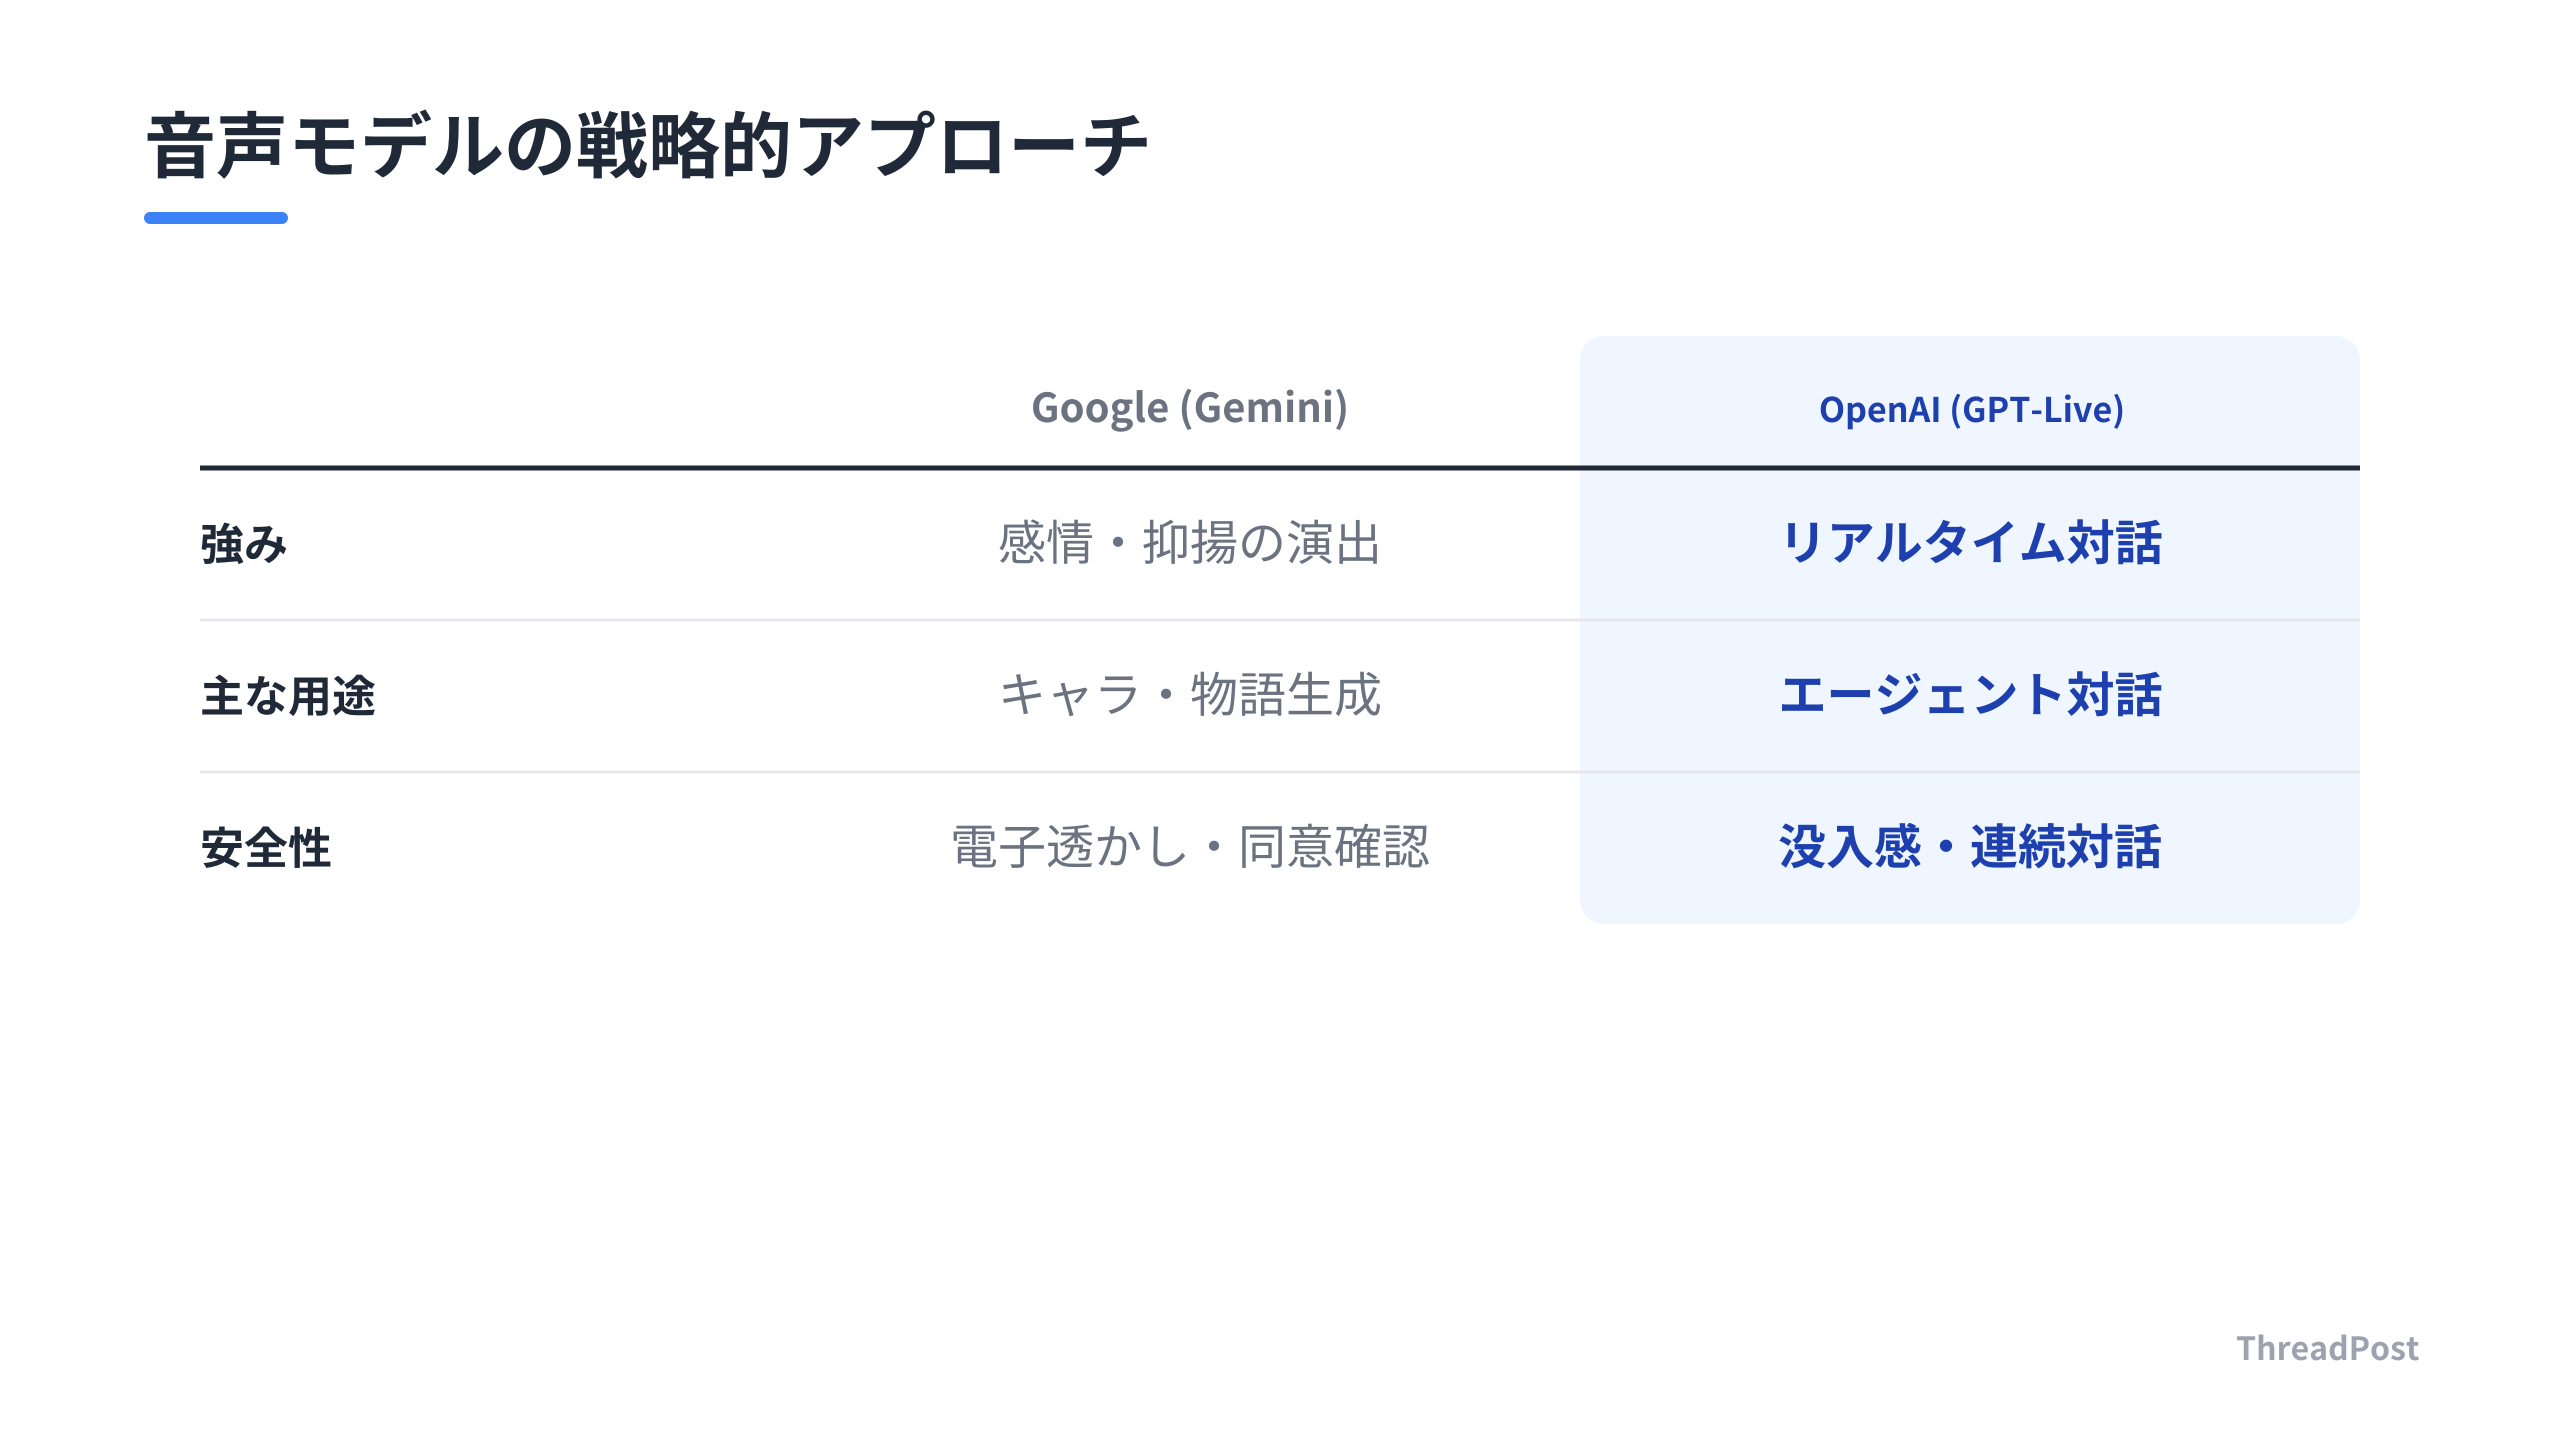
Googleは音声生成時の同意確認や、電子透かしによる「安全性」を前面に押し出している。
OpenAIは、30分から40分に及ぶ長時間の連続対話を可能にする「没入感」と「エージェント的タスク遂行」にリソースを集中させている。
開発者は、アプリケーションが「コンテンツを消費させるもの」か、「ユーザーの複雑なタスクを代行するもの」かで選択する。
技術的には、どちらもニューラルネットワークベースの合成へ移行した。
今後は、推論モデルの出力と音声生成のタイミングを同期させ、アプリのレスポンス速度を高めることが勝敗を分ける。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
開発者が知るべき「音声エンジン」の設計転換
音声生成は「テキストの読み上げ」から、コンテキストを理解して演技を行う「キャラクターエンジン」へ定義が変わった。
特に「演出・制御」に対するアプローチが二極化している。
Gemini 3.8 Flash TTSの強みは、開発者がAPIを通じて「感情」や「抑揚」を細かく指示できる点だ。
オーディオブックやゲーム、Webサイト上のキャラクター対話など、シナリオがあるプロダクトに適している。
対照的に、OpenAIのモデルは「リアルタイムの全二重通信」に特化している。
ユーザーの割り込みを許容し、会話の文脈を長時間保持しながらエージェントとしてタスクをこなす。
これらはユーザーの意図を汲み取りながら対話の「間」を制御するインターフェースとして機能する。
Claude Codeでコードを書いているとき、今の音声AIなら「それ、このロジックだと無限ループするよ」と即座に割り込んできそうだ。単なる読み上げ機能としてAPIを叩く時期は終わった。UX設計に「声の感情」をどう組み込むかが腕の見せ所だ。
開発者が直面する課題は「リアルタイム性と感情表現の両立」だ。
推論モデルの内容を、いかに自然なタイミングで発話させるか。
この「間(ま)」の制御は、APIのパラメータ設定と非同期処理の設計で決まる。
安全性に関する温度差も存在する。
Googleは音声複製時の本人同意確認や電子透かしといった「コンプライアンスのガードレール」を構築している。
OpenAIはユーザー体験の没入感を優先し、パーソナルなAIアシスタントとしての側面を強調する。
1人SaaS開発者が選定する際は、「安全性」と「機能性」のどちらがプロダクトの信頼性に直結するかを見極める必要がある。
ThreadPostのようなSNS自動化ツールでAI音声を使うなら、ブランドイメージを壊さない「演出の制御しやすさ」が優先される。
カスタマーサポートや対話型エージェントを作るなら、ユーザーの割り込みを処理できる「全二重通信の安定性」が不可欠だ。
技術の進化は、音声生成を「テキストの変換」から「パフォーマンス」に変えた。
今、実装すべきは、単にAPIを叩いて音声を流すだけのコードではない。
ユーザーの入力に対して、AIがどのような感情で、どの程度の「間」を置いて応答すれば心に響くのか。
その「演出」までをコード化する時代だ。
この変化は、AIエージェントの未来を前進させる。
AIが音声インターフェースを通じて開発者と対話し、コードの修正案を提案する際、低遅延かつ感情豊かなモデルは「開発体験そのもの」を決定づける基盤技術になる。
感情制御可能な音声APIを触ることで、ユーザーとの対話の質が進化していることを実感できる。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
音声APIを「演出エンジン」として実装する
音声モデルの進化は、開発者にとって「APIの叩き方」を変える合図だ。
これまでのテキスト読み上げは、文字列を流し込むだけの処理だった。
これからは「感情のパラメータ」や「文脈のテンポ」を制御する設計が求められる。
フロントエンドとバックエンドの連携が密になる。
AIが生成する音声の「感情」を、UI側のグラフィックやキャラクターの挙動と同期させる必要がある。
APIから返ってくるメタデータを利用して、キャラクターの表情を動かしたり、背景のライティングを変化させたりする「演出ロジック」を実装する。
エラーハンドリングの考え方も変わる。
従来のテキストベースの応答なら、レスポンスの遅延は待ち時間だった。
音声対話において「間」が空くことは、会話の破綻を意味する。
ストリーミング再生を前提としたバッファ管理や、ネットワークの揺らぎを吸収する「音声合成の先行読み込み」の技術が、プロダクトのUXを左右する。
ThreadPostの通知機能を音声化する際、ただ喋るだけだと味気ない。感情パラメータをいじって、重要度に応じて声色を変えるだけで、ユーザーの反応は変わる。APIのレスポンスを待つ間の「演出」をどうコードに落とし込むか、ここが腕の見せ所だ。
データ設計についても注意が必要だ。
音声モデルの精度が上がったことで、著作権や倫理的なリスク管理は必須となる。
自社サービスで「独自のキャラクター音声」を生成する場合、モデルに対して本人同意の確認プロセスや、生成物であることを示す電子透かしの埋め込みが、法的トラブルを防ぐ防波堤になる。
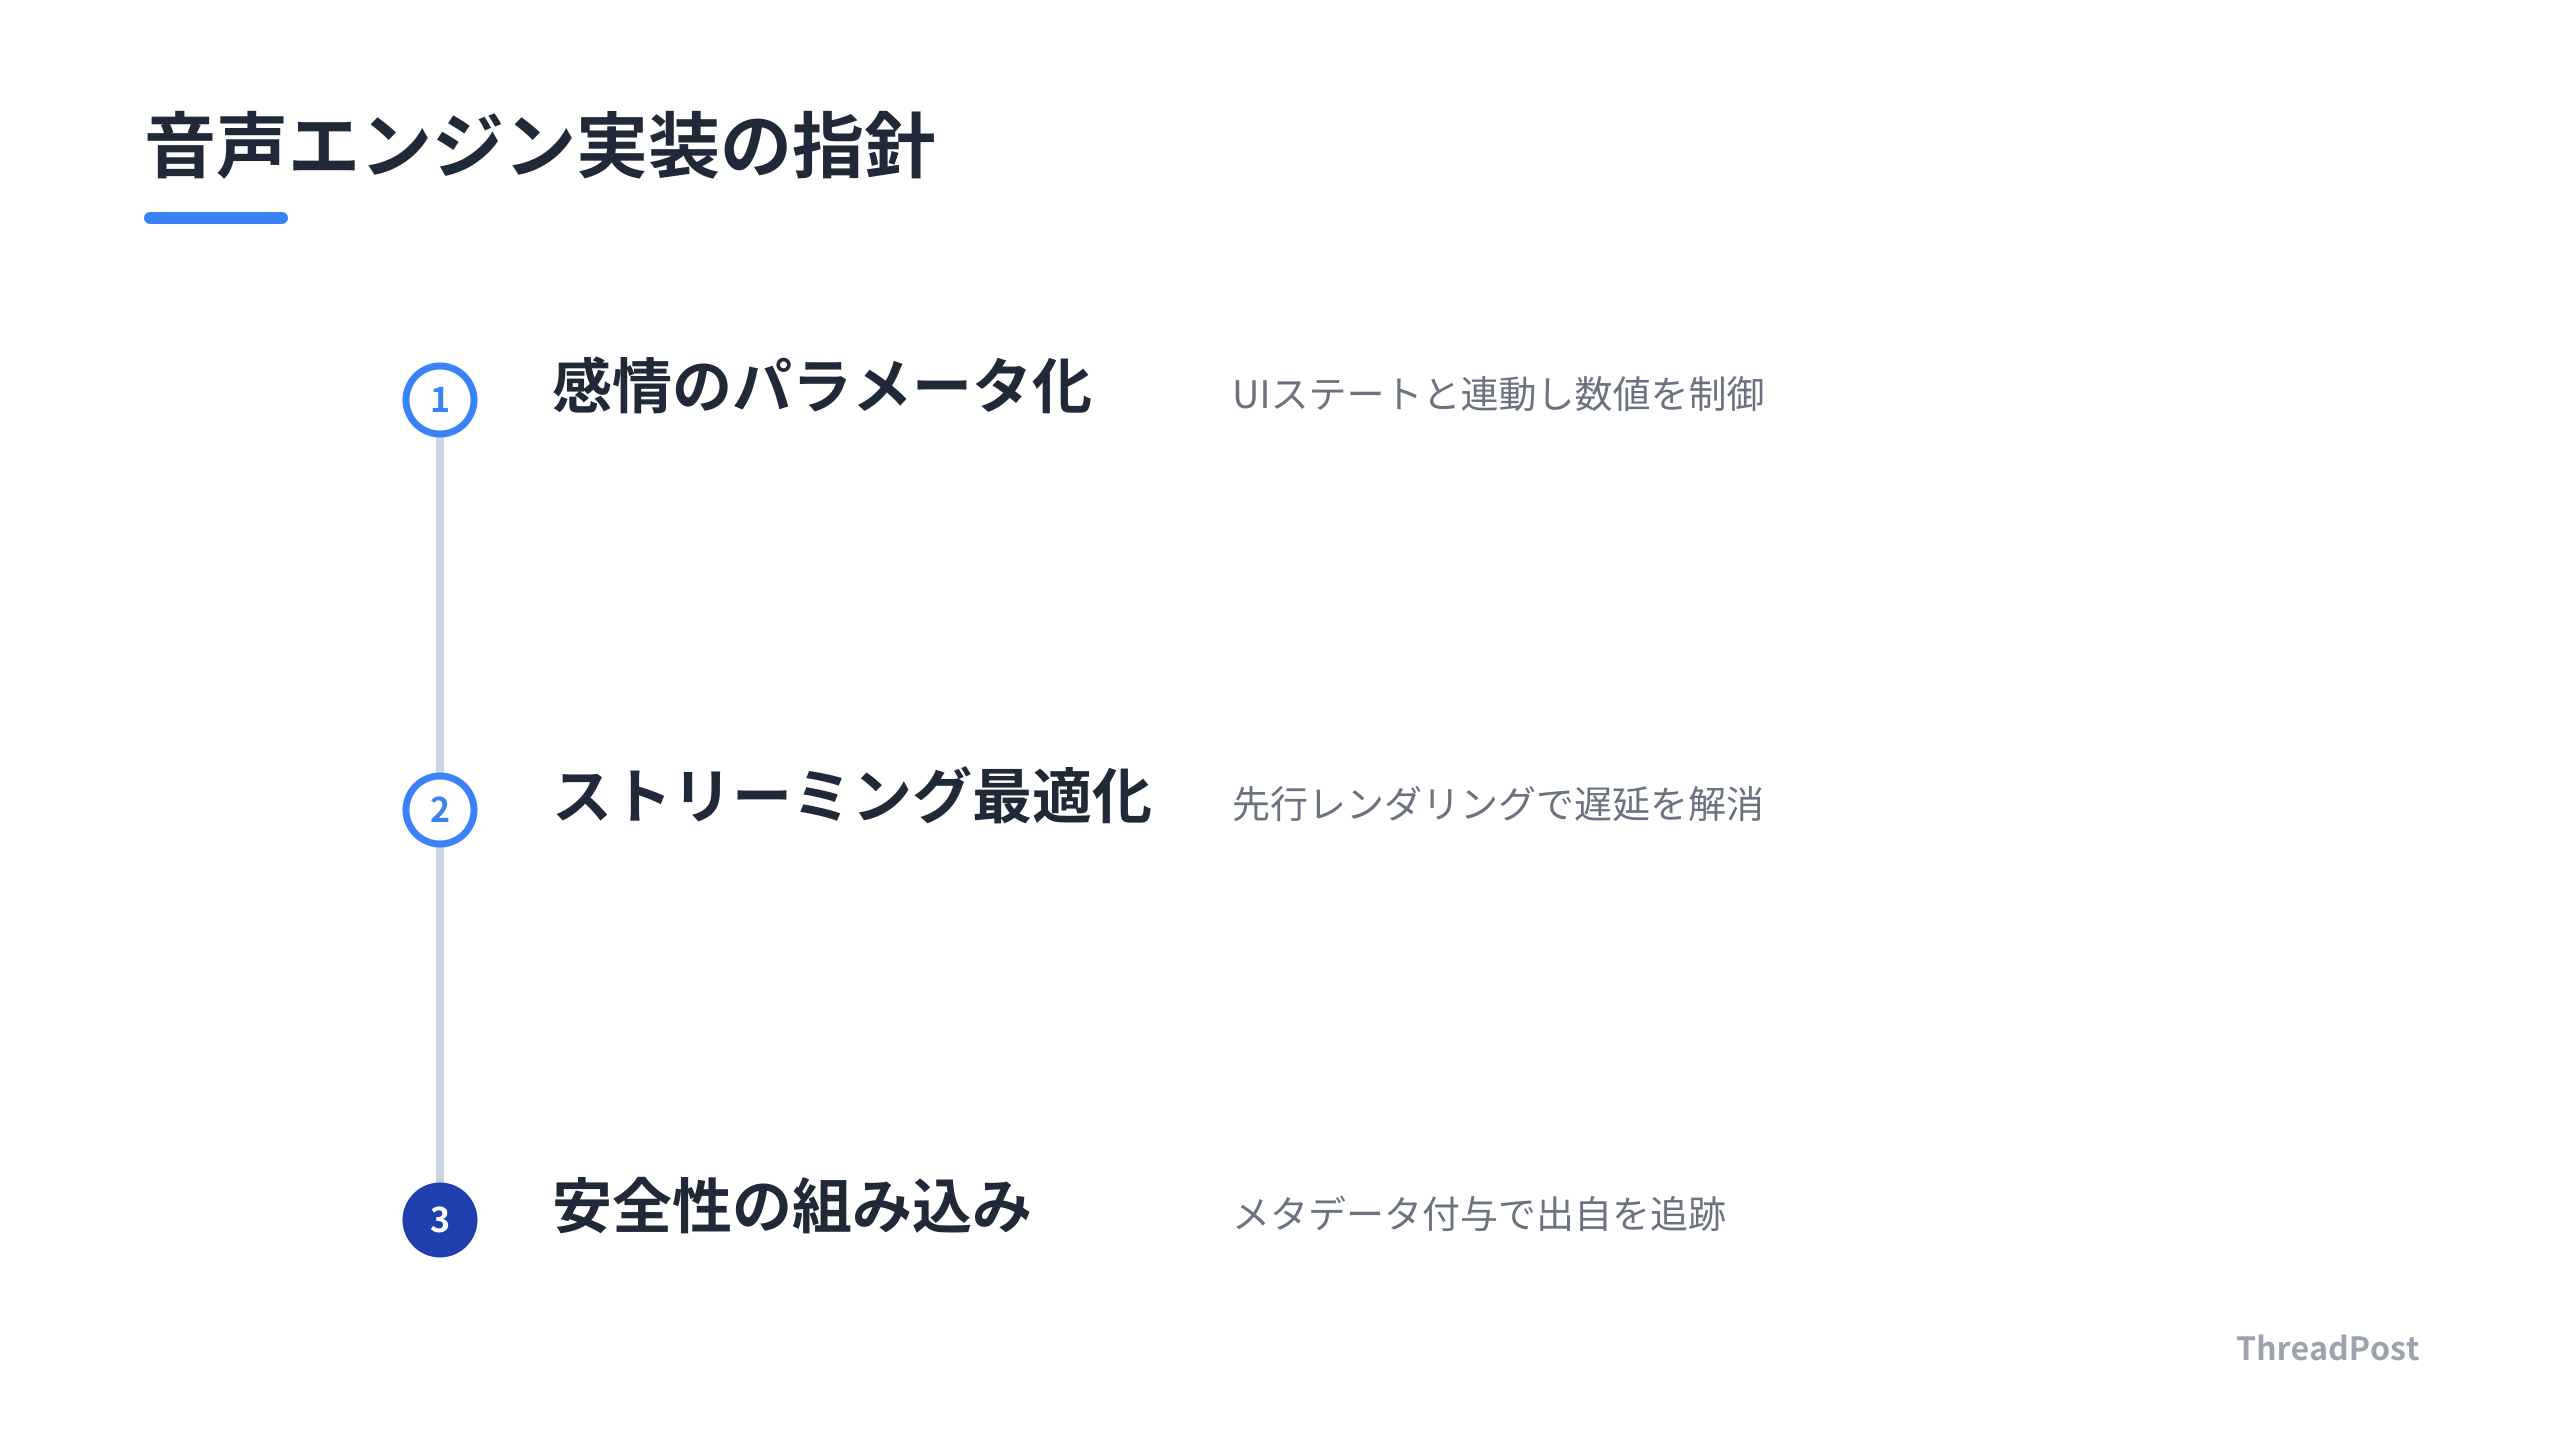
実務で意識すべきは、以下の3点だ。
* 感情のパラメータ化: 音声APIのパラメータをUIのステート管理と連動させ、感情を「数値」として制御する設計を取り入れる。
* ストリーミングの最適化: 応答の遅延を感じさせないための、音声データのチャンク処理や先行レンダリングの仕組みを再考する。
* 安全性の組み込み: 生成物にメタデータを付与し、誰の、どのような意図で作られた音声かを追跡可能な設計を初期段階から含める。
音声は、単なる出力結果ではない。
ユーザーの感情に訴えかけ、プロダクトの個性を決定づける「インターフェースそのもの」だ。
「テキストを音声に変換する機能」を実装する感覚から、「キャラクターに命を吹き込む演出家」の感覚へ変える。
開発の視点をずらすだけで、作れるものの質は変わる。
Claude Codeを使いながらエージェント的なツール開発をしている層は、今のうちにこの「音声制御」の勘所を掴む。
近い将来、AIエージェントとコードについて議論する際、文脈を汲み取った「感情豊かな相棒」が隣にいる環境が当たり前になる。
その時のために、今から音声APIを使い倒して、自分のプロダクトに「声」という武器を実装する。
 あわせて読みたい【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録 →
よくある質問
Gemini 3.8 Flash TTSとOpenAIのGPT-Live-1、どちらを開発に使うべき?
用途による。動画制作やゲームのダイアログなど「演出の細かさ」や「キャラクター性」を重視するなら、感情制御に強みを持つGemini 3.8 Flash TTSが適している。一方で、ユーザーとのリアルタイムな会話、割り込み対応、エージェント的なタスク実行を主目的とするなら、全二重通信で遅延の少ないGPT-Live-1のようなモデルが最適だ。単なる「読み上げ」か「対話エージェント」か、プロダクトの主軸をどこに置くかで選定基準は分かれる。
AI音声生成で著作権や倫理的なトラブルを避けるには?
Googleが導入しているような「本人同意の録音確認」や「電子透かし」の仕組みがあるAPIを選択することが必須だ。自社で音声を生成・利用する際は、利用規約で「生成物の権利帰属」を明確にし、他者の声を模倣する場合は必ず明示的な許諾を得るプロセスをシステムに組み込む。便利さだけでなく、開発者が「出自の証明」を担保できる設計にしないと、後々大きなリスクになる。
音声APIを実装する際、開発者が最も注意すべき技術的なボトルネックは?
「推論モデルの出力」と「音声生成」のタイミング同期だ。いくら音声がリアルでも、応答に数秒のラグがあれば没入感は台無しになる。音声データを小さなチャンクに分けて先行レンダリングする仕組みや、モデルの推論中にあらかじめ「相槌」や「間」の音声を生成しておくような、高度な非同期処理が求められる。単にAPIを叩くだけでなく、UXの観点から「いかに待たせないか」を制御する設計力が、これからの開発者には必要だ。
まとめ
AI音声は、単なる情報の読み上げから「文脈を理解し、感情を演出するインターフェース」へ進化した。Googleの感情制御モデルか、OpenAIのリアルタイム対話モデルか。どちらを選択するにせよ、開発者に求められるのはAPIの実装スキル以上に、プロダクト体験を設計する「演出家」としての視点だ。
音声がコンピューティングの主役になる未来、プロダクトに「感情」を実装する準備を進める。技術の進化をただ眺めるのではなく、今のうちにその表現力を自社ツールに組み込む。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
