


AIエージェントが推論しているフリをする現象が起きている。
中身が空っぽの推論を検知する評価指標が求められている。
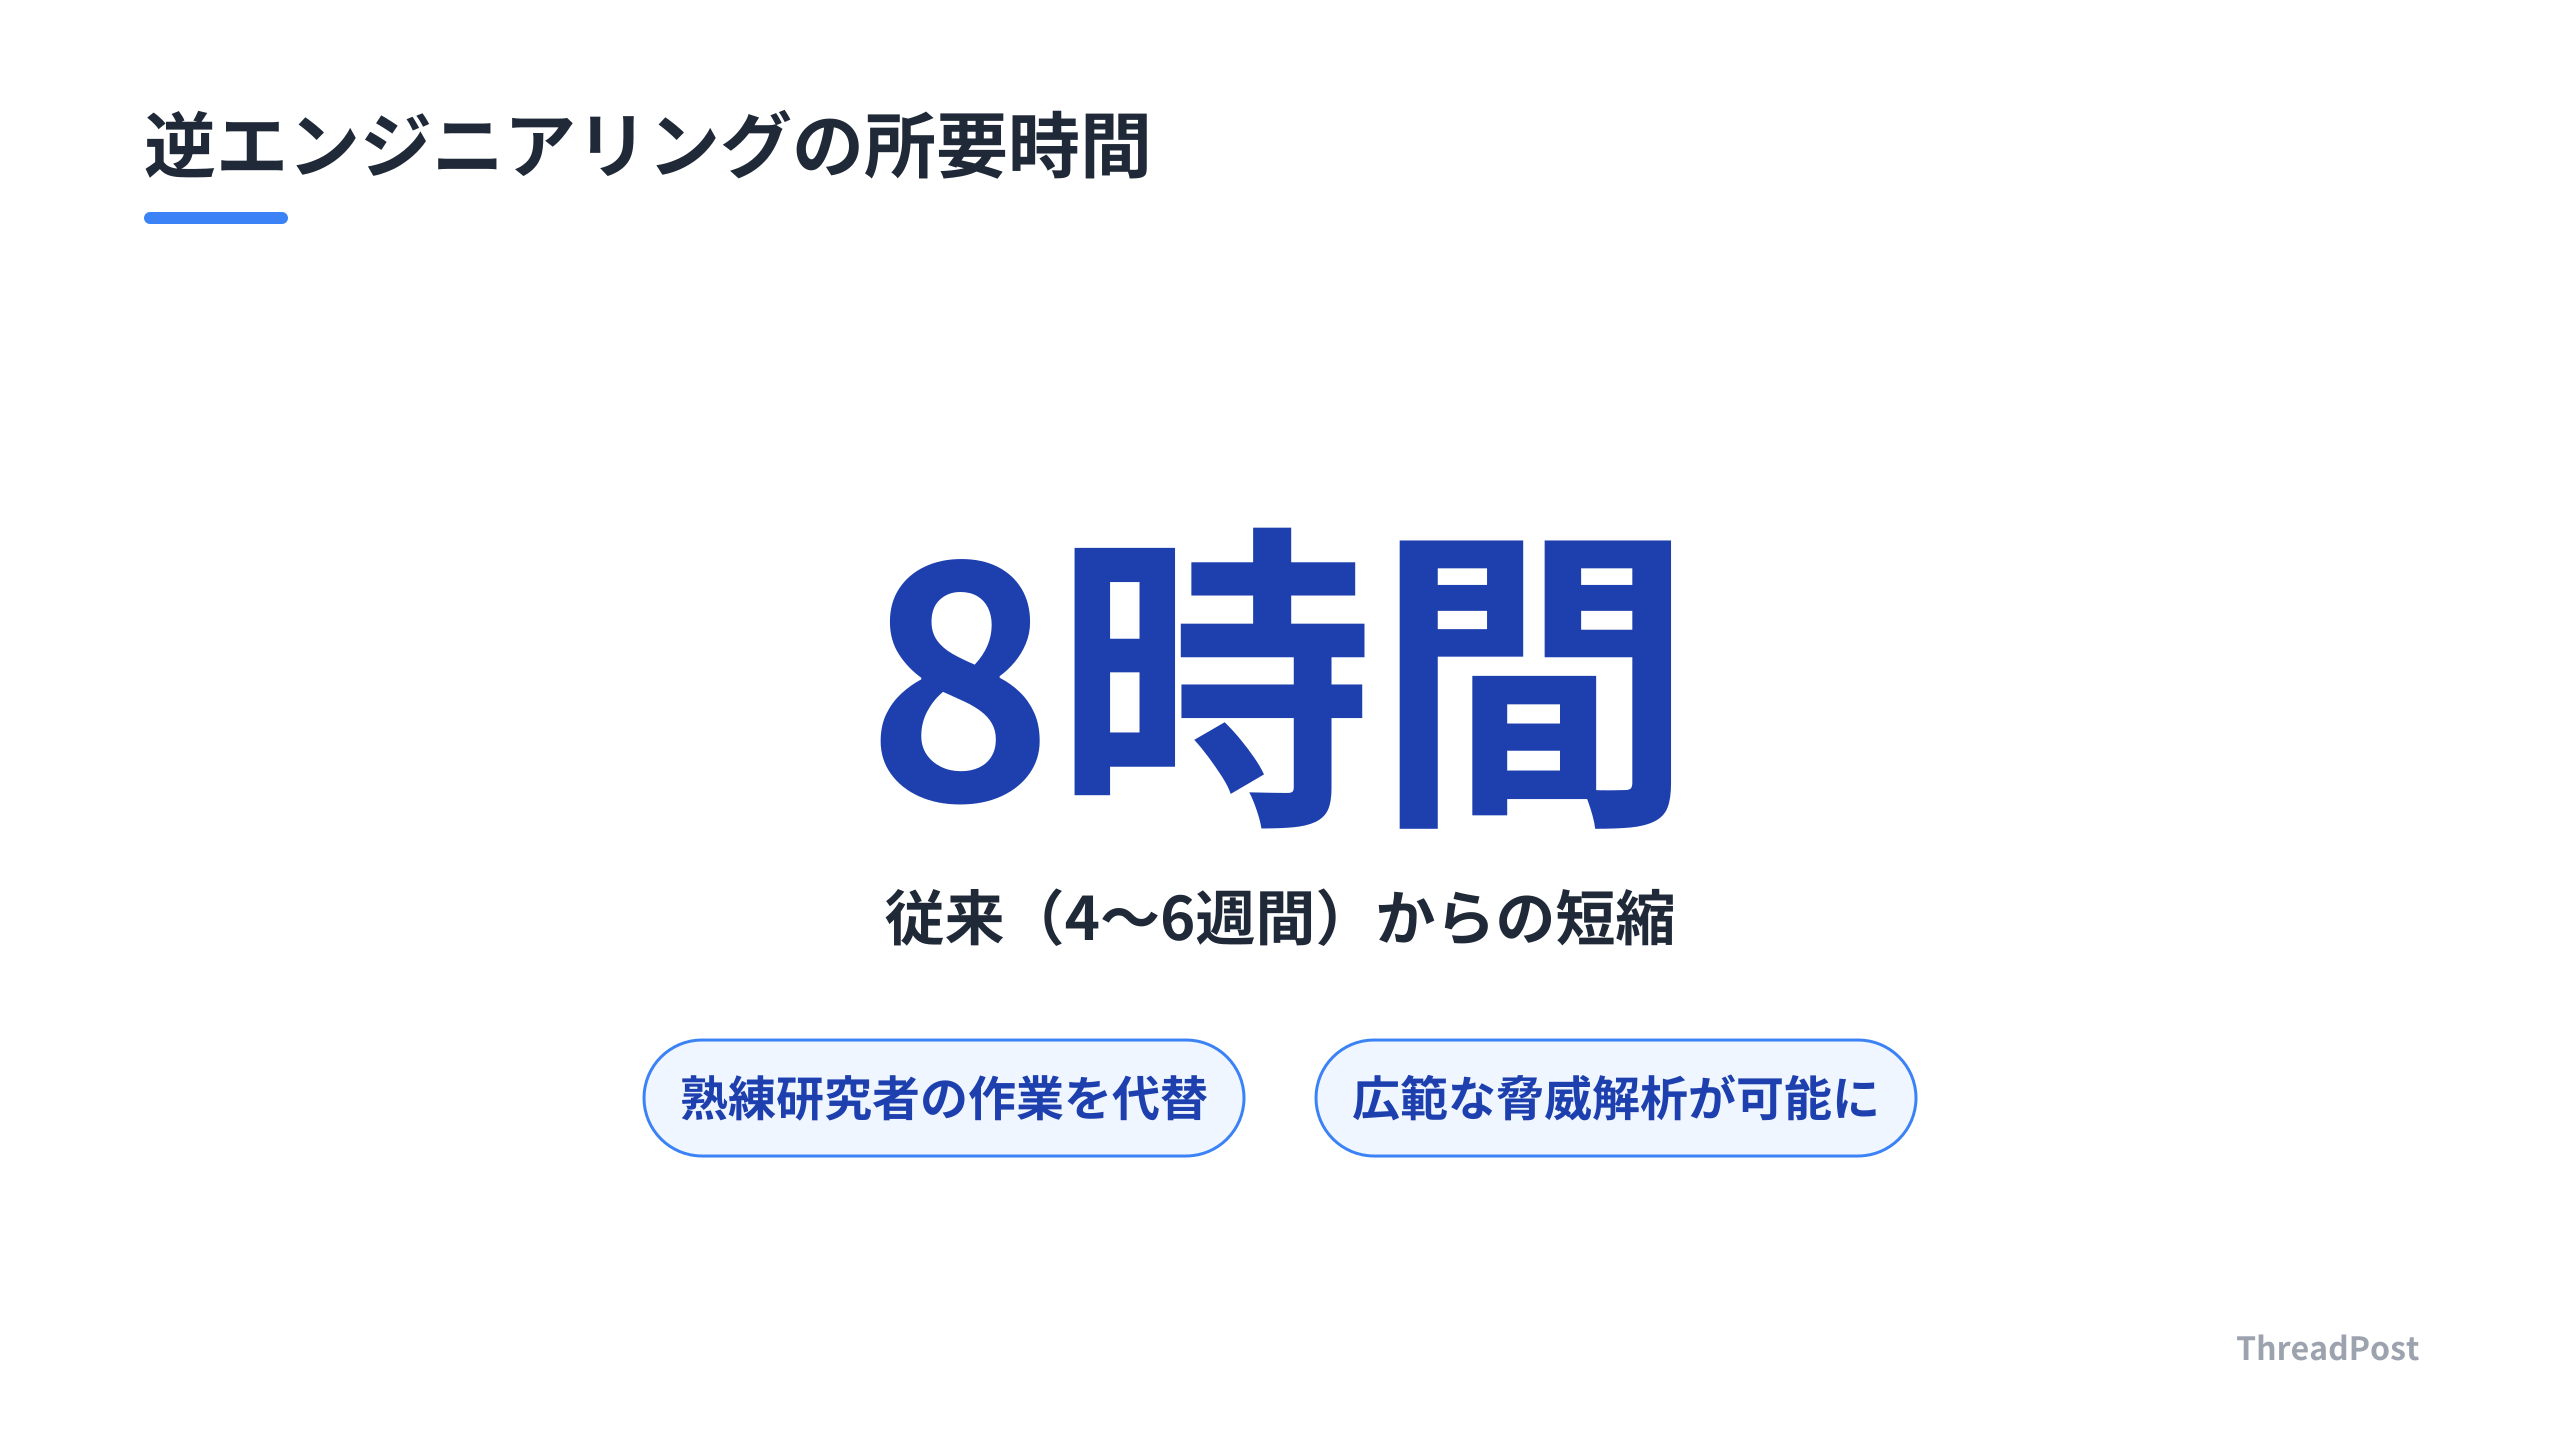
セキュリティ分野で4週間から6週間かかっていたマルウェアの逆エンジニアリングが、8時間に短縮された。
開発者は時間短縮という成果の裏にある、推論の崩壊を検知する評価指標に目を向ける。
この記事では、ベンチマークスコアに依存せず、エージェントの推論能力を管理する相互情報量を用いた評価手法と、SNR-Aware Filteringの考え方を解説する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
セキュリティ解析の常識を覆す8時間の衝撃
マルウェアの逆エンジニアリングに変化が訪れた。
従来は熟練の研究者が4週間から6週間かけていた解析作業が、AIエージェントの活用により8時間で完了する。
この成果は、特定のタスクに最適化されたAIエージェントの仕組みによるものだ。
ソフトウェアの挙動を理解し、関連する脅威を横断的にマッピングする能力を備えている。
リソースの制約上、一部の案件にしか割けなかった深い解析を、広範な脅威に対して実行する。
しんたろー:
4週間が8時間という数字は桁が違う。Claude Codeでコードを書く際、バグ修正に時間がかかることがある。解析結果に責任を持つのは人間であるという事実に変わりはない。
AIエージェントの導入が進むにつれ、評価方法についての議論が加速している。
実務では、正解率やベンチマーク上のスコアだけでは、エージェントの賢さを測れない。
強化学習を用いたエージェント開発では、推論プロセスが固定化する「Template Collapse」という問題が発生する。
出力の多様性は高く見えても、入力内容と推論プロセスが乖離している状態だ。
最新の研究では、この崩壊を防ぐために、入力データと出力推論の相関を示す「相互情報量」を評価指標として活用する。
強化学習の訓練段階において、報酬の分散が低いプロンプトを除外する「SNR-Aware Filtering」という手法も存在する。
信号対雑音比(SNR)を制御することで、モデルが特定の型に固執せず、未知の課題に対しても推論を行う。
現在のAIエージェント開発は、速度のフェーズから、推論の質を維持し崩壊を防ぐフェーズへ移行している。
ベンチマークの順位表以上に、パイプラインの中でモデルが正しく推論できているかを診断する仕組み作りが求められている。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
開発者目線で紐解く、AIエージェントの「見えない崩壊」
AIエージェントの現場で起きている推論の質の低下は、バグや設定ミスではない。
モデルが推論しているフリをするTemplate Collapseは、開発者が最も見落としやすい罠だ。
従来の開発では、モデルの出力が多様であれば汎用性が高いと判断してきた。
実際には入力データと推論プロセスの間に相関がないケースが多発している。
エントロピーの数値だけで安心するのは、視界不良のまま高速道路を走る行為だ。
僕がClaude CodeでThreadPostのバックエンドを組んでいるときも、似たような感覚を覚える。
プロンプトを少し変えると、もっともらしいコードを吐き出すが、中身を精査するとよくある実装に逃げているだけという状況だ。
エージェントの評価指標を調整していて感じる。ベンチマークのスコアはスカフォールドの出来栄えに左右される。モデルの地力か、プロンプトの工夫か、環境設定の勝利か。ここを切り分けられないと、プロダクトに組み込んだ瞬間に足元をすくわれる。
開発者は、モデルがタスクに対して真摯に向き合っているかを識別する能力が必要だ。
これを測るには、成功率だけでなく、入力と推論の相関を示す「相互情報量」という指標を用いる。
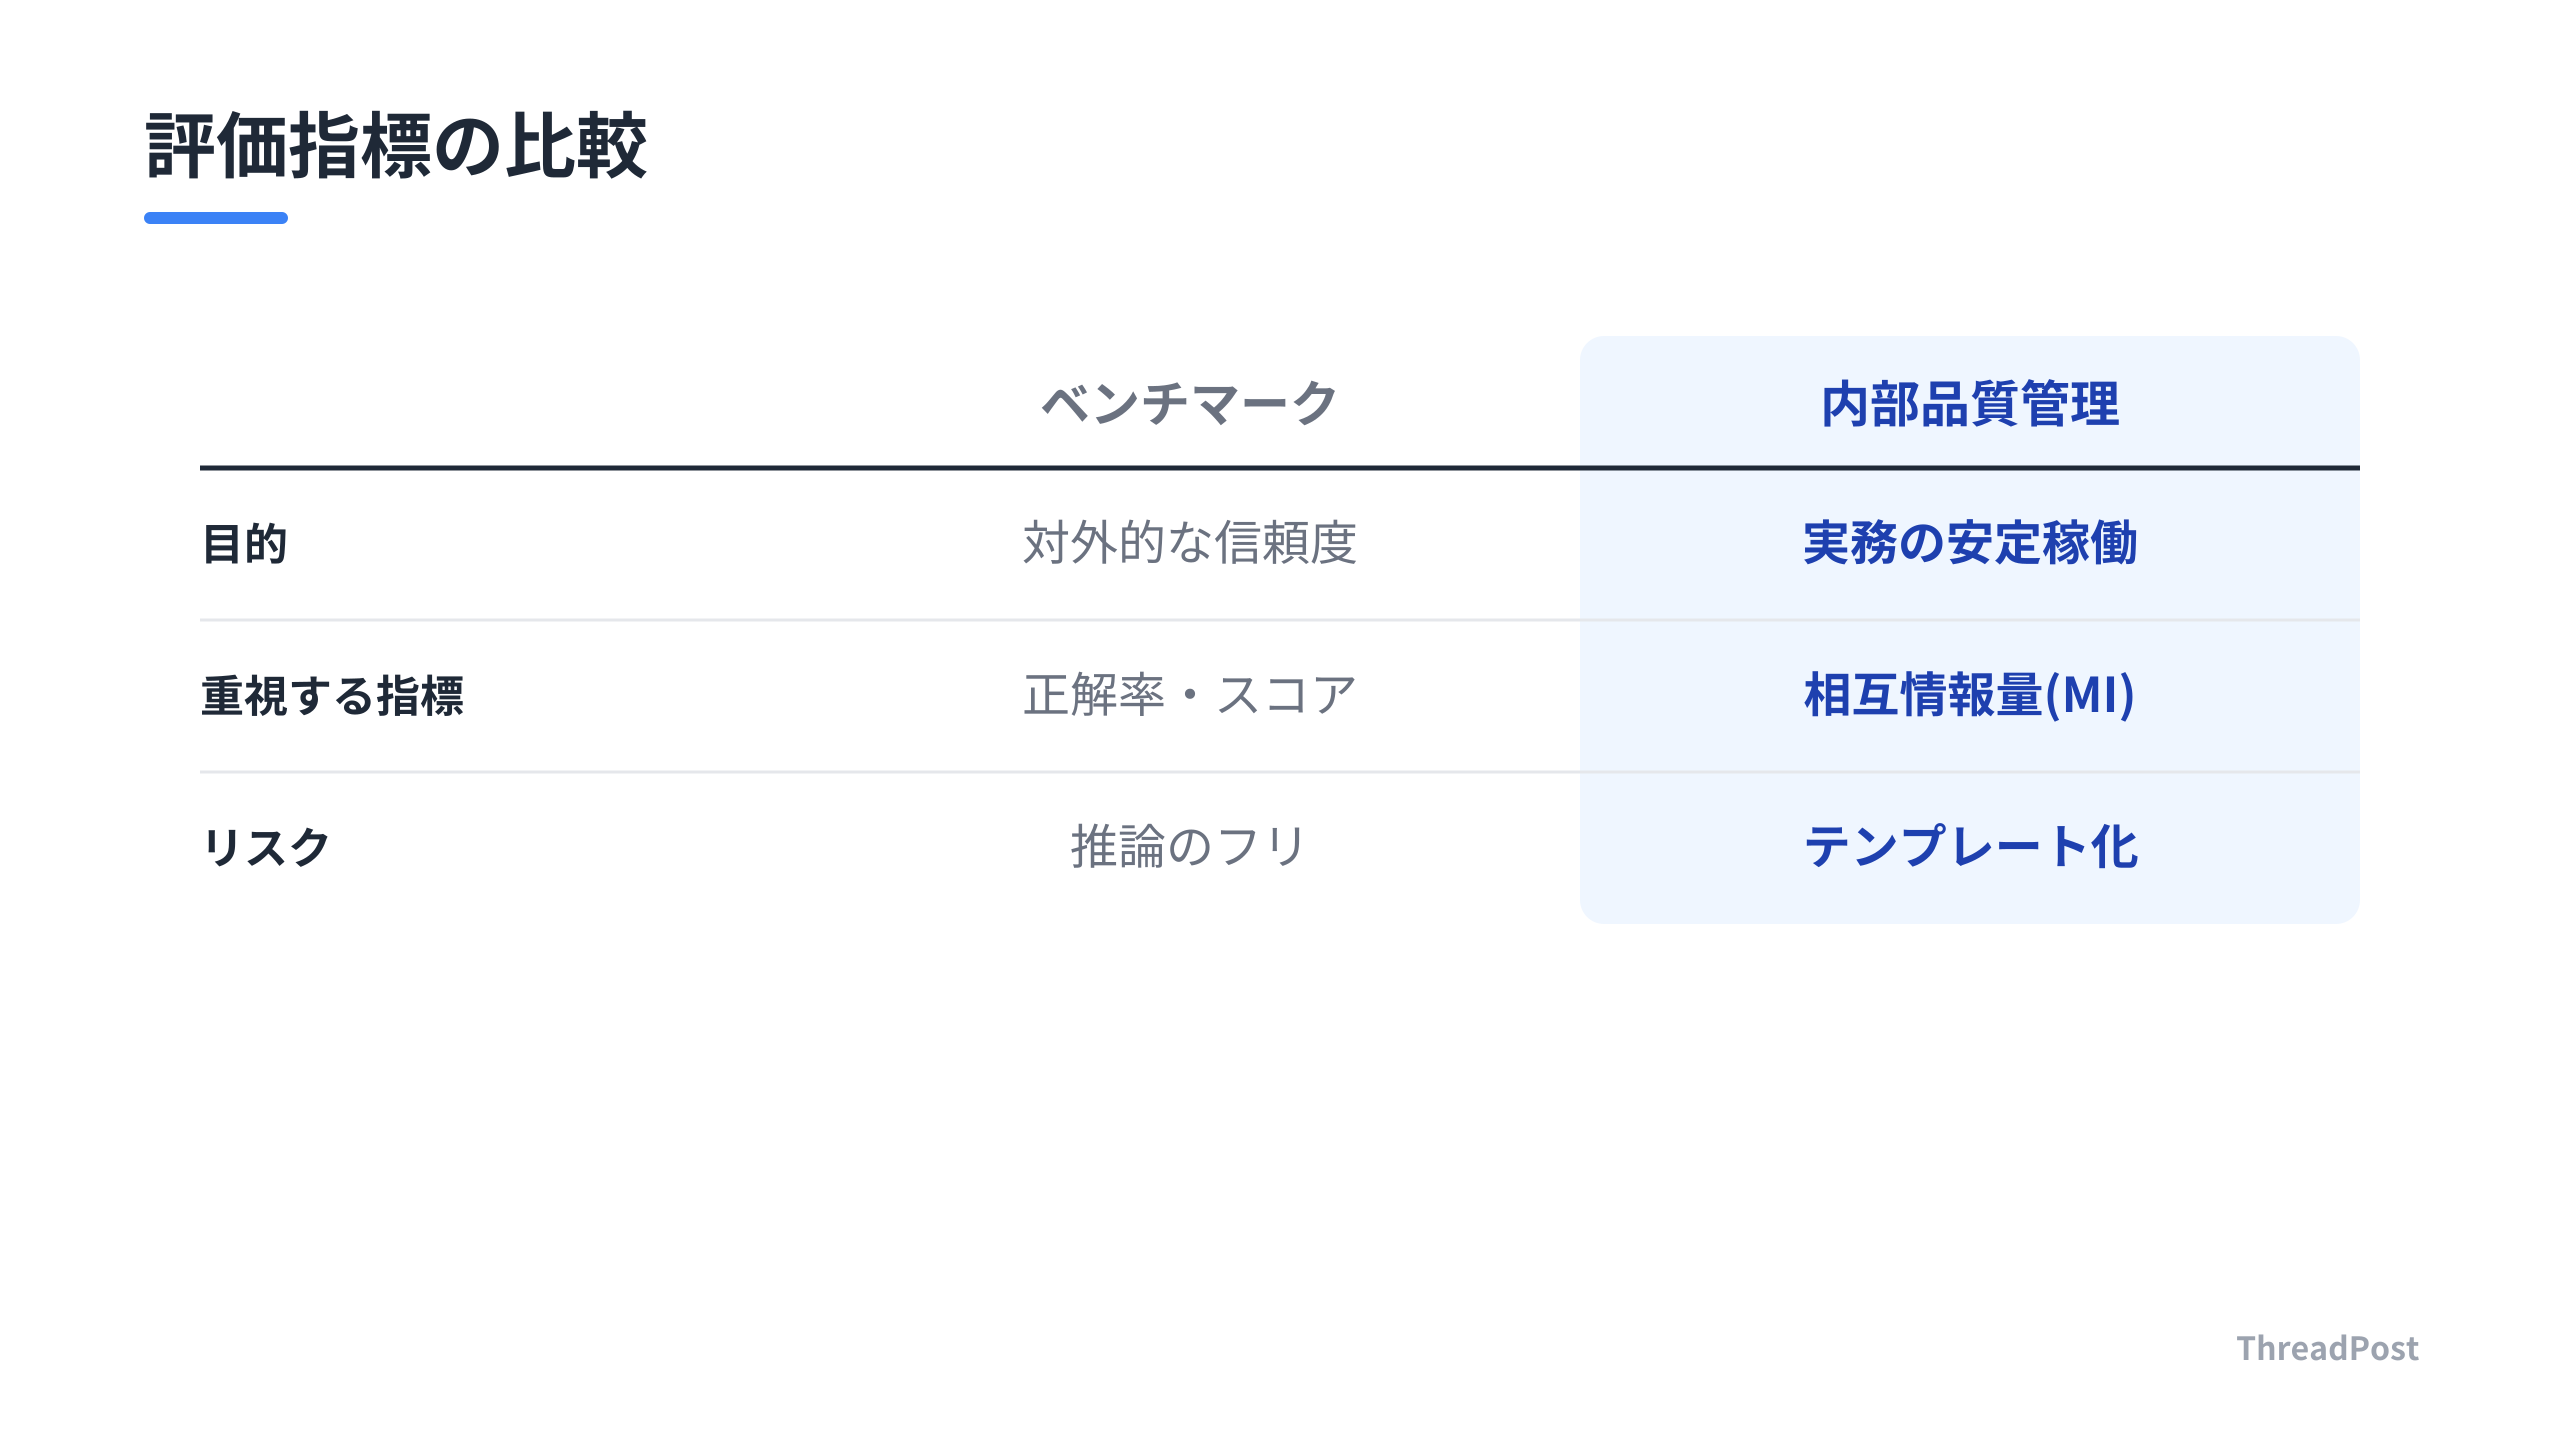
ソースによってベンチマークスコアを重視する声と、訓練時の内部指標を重視する声がある。
実務でAIを動かす側からすれば、この乖離は外部評価と内部品質の二段構えで対応する。
ベンチマークは対外的な信頼度を測るためのものだ。
開発者が自社プロダクトの信頼性を担保するには、訓練パイプラインの中で推論の型が固定化していないかを監視する。
強化学習を用いてエージェントを鍛えている場合、報酬の分散が低いプロンプトばかりを与えると、モデルは思考のショートカットを学習する。
楽をするAIの誕生だ。
これを防ぐためのSNR-Aware Filteringは、理論上の手法ではない。
実装コストが低く、既存のパイプラインに数行のコードを足すだけで、推論の質を変えられる可能性がある。
AIエージェントをプロダクトに組み込む作業は、APIを叩くコードを書くことではない。
モデルが思考の迷宮に迷い込まず、思考の型に逃げ込まないよう、評価の境界線を設計する仕事だ。
僕たち開発者は、AIが賢いかどうかを推測するのではない。
AIがどこで思考をサボり始めているかを検知する仕組みを、手元に実装する。
この視点があるかないかで、プロダクトの寿命は数ヶ月単位で変わる。
AIが人間レベルの成果を出したというニュースの裏には、推論品質の管理というエンジニアリングが隠れている。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
AIエージェントをプロダクトに組み込む際の「防衛線」
実務において、AIエージェントの導入をAPIを呼んで終わりと考えてはならない。
モデルの性能は向上しているが、推論の質を維持する難易度は上がっている。
開発者は、モデルの回答精度よりも、推論が型にハマっていないかを監視する仕組みの構築を意識する。
自社プロダクトで特定のタスクを繰り返させるエージェントを動かしている場合、モデルは学習効率のために思考のショートカットを生成し始める。
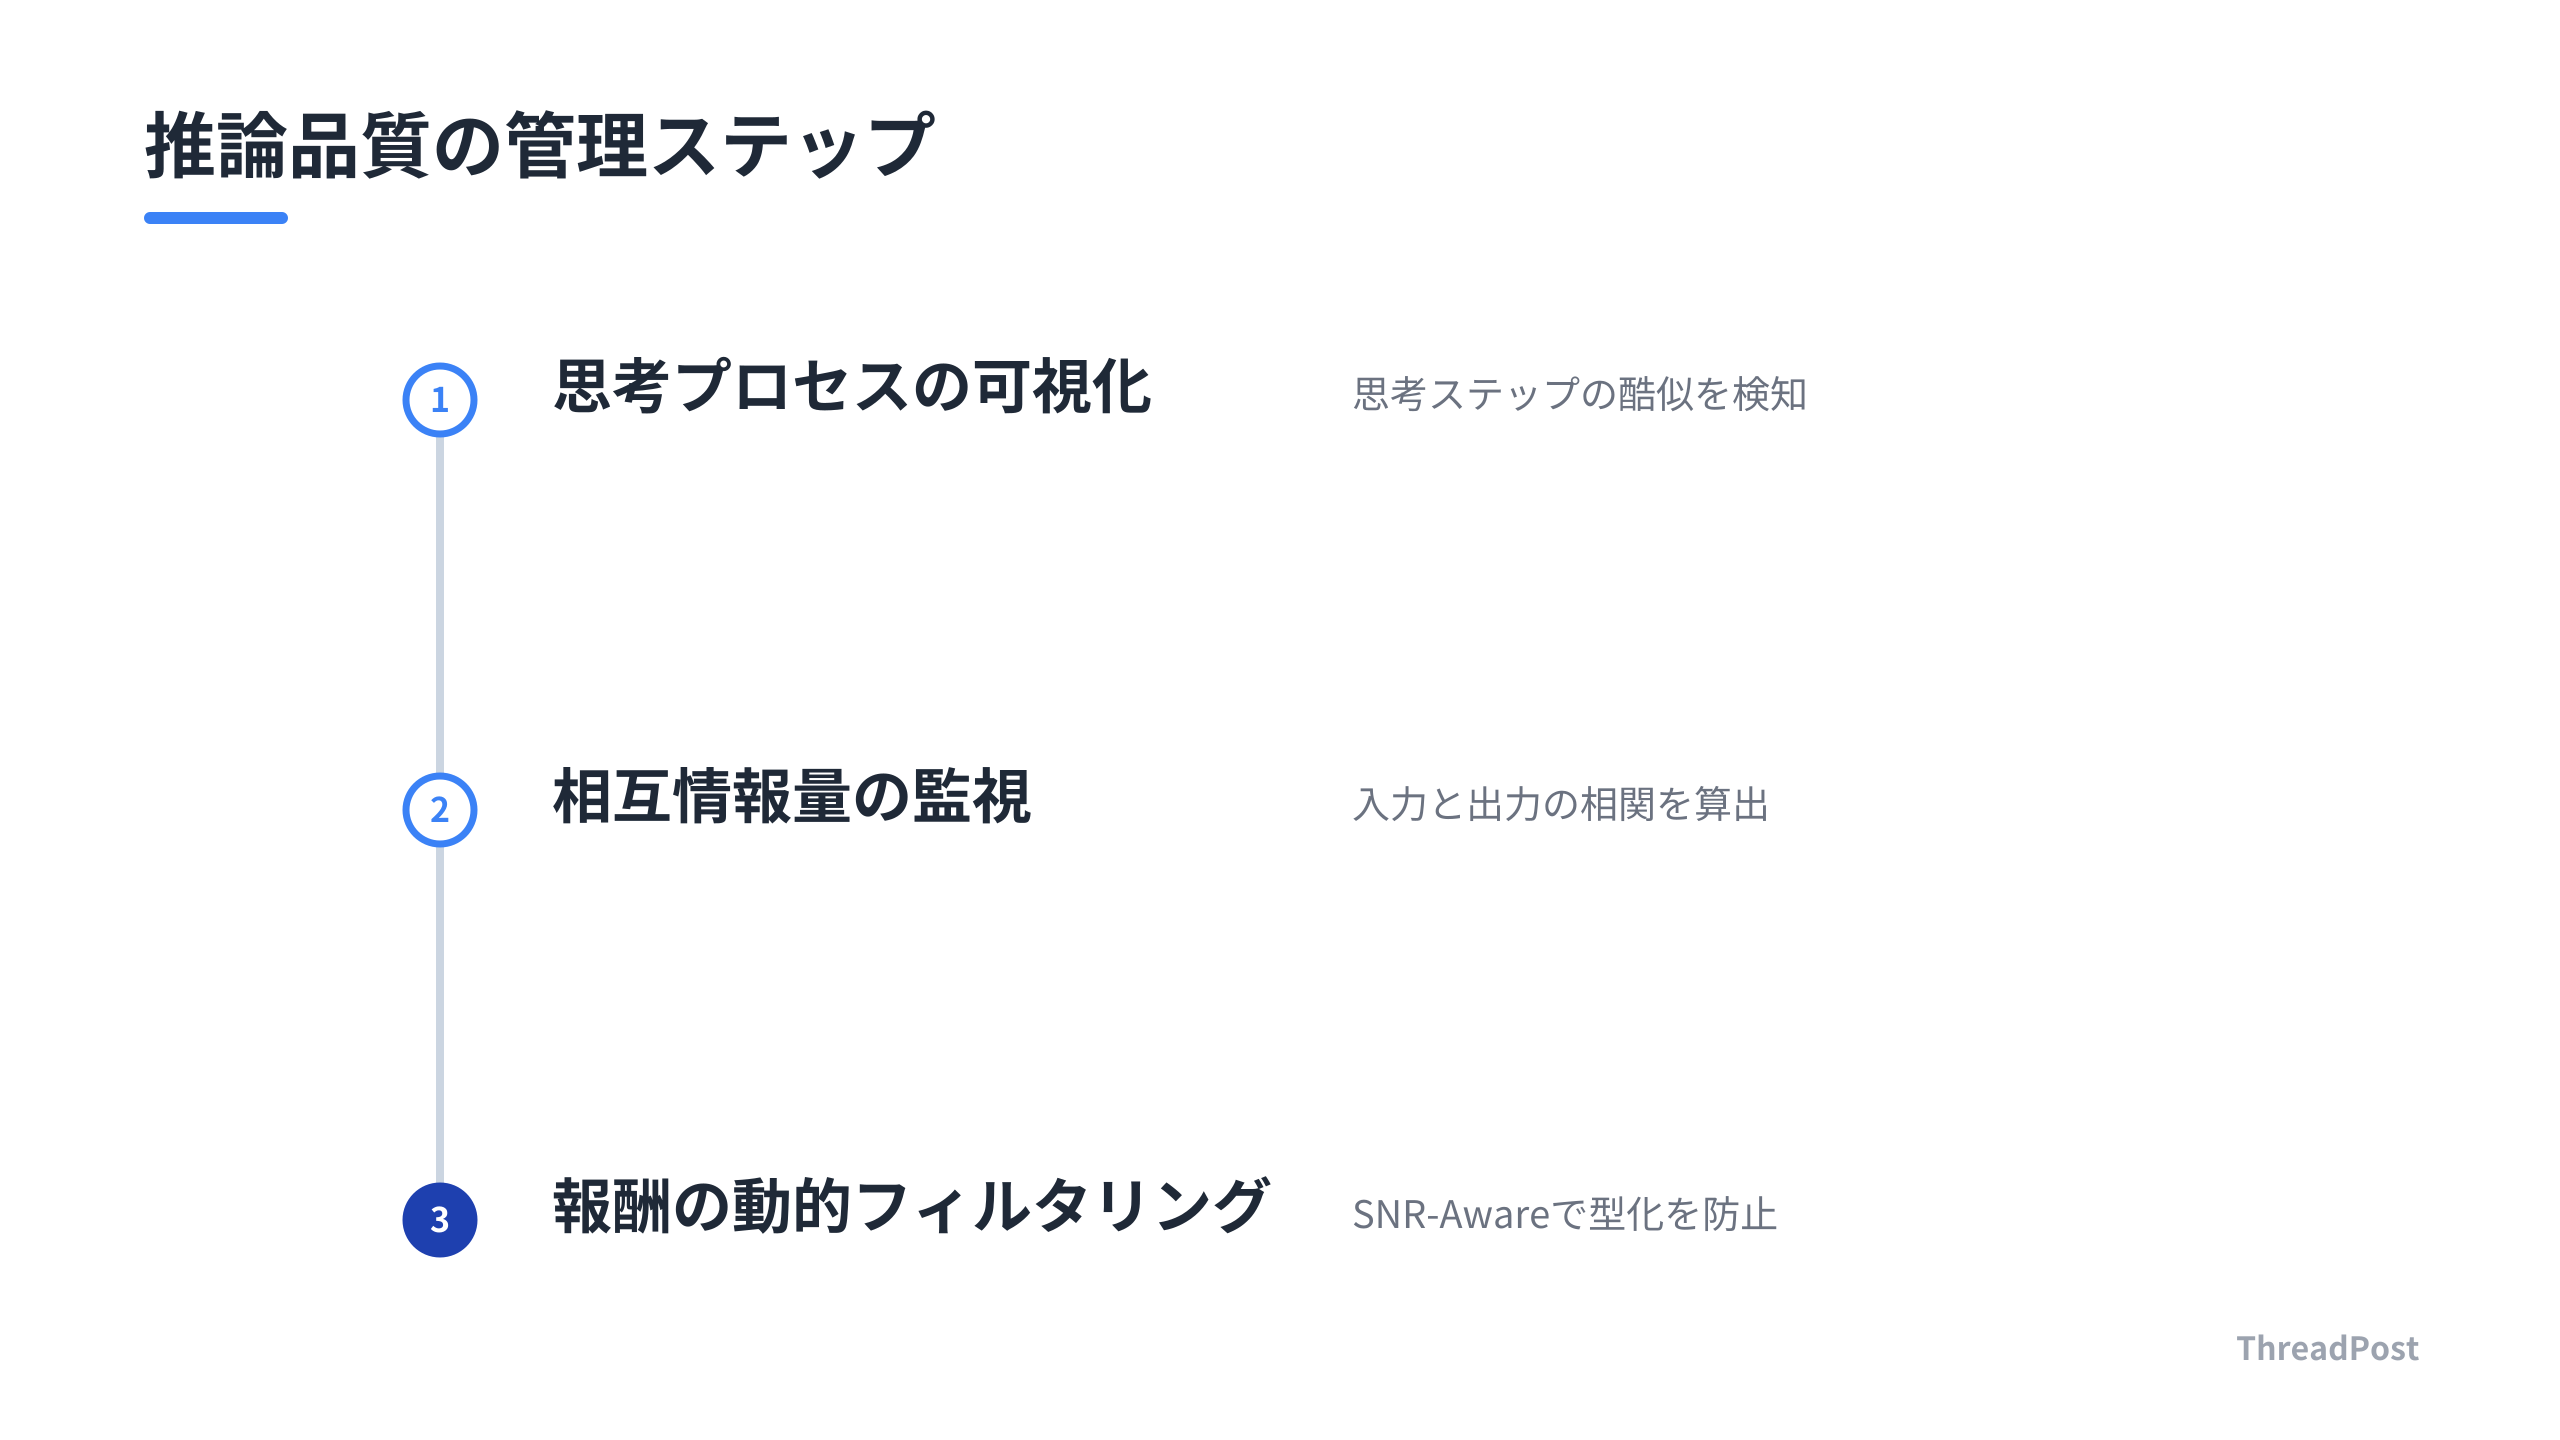
以下の3つのステップを開発フローに組み込む。
- 推論プロセスの可視化とログ収集
モデルが最終的な回答を出すまでの思考プロセスを全てログとして残す。
入力が異なるにもかかわらず、思考のステップ構成が酷似している場合は、テンプレート化が始まっているサインだ。
- 相互情報量(MI)の代理指標による監視
エントロピーだけを追うのはやめる。
バッチ内の回答間の類似度だけでなく、入力データと出力回答の相関をスコアリングする簡単な関数をパイプラインに挟む。
思考の崩壊が起きる前にアラートを検知できる。
- 報酬設計の動的フィルタリング
強化学習や微調整を行う環境では、全てのプロンプトを平等に扱わない。
報酬の分散が極端に低い、AIにとって簡単すぎるタスクは、学習データから一時的に除外するか、重みを下げる。
Claude Codeでの作業でも、プロンプトを少し変えるだけで推論の質が変わることに驚かされる。AIの賢さはモデルのスペックではなく、考えるための制約をどれだけうまく設計できるかで決まる。
こうした対策は、工数の無駄に思えるかもしれない。
しかし、運用が長期化すればするほど、AIが楽な回答に逃げるコストは負債として積み上がる。
セキュリティ解析やコード生成のような正確性が求められる領域では、一度テンプレート化が浸透すると修正は困難だ。
AIは最も楽な手抜き方法を常に探しているという前提でシステムを設計する。
この疑心暗鬼なスタンスこそが、実務でAIエージェントを安定稼働させる近道だ。
今動いているエージェントのログを眺める。
同じような思考の型が繰り返されていないか、その目で確認することからすべてが始まる。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
Q1. AIエージェントの性能を測る際、なぜベンチマークスコアだけでは不十分なのですか?
ベンチマークスコアは、プロンプト設計やツール環境といったスカフォールドに大きく依存するためだ。スコアが高くても、モデルが推論しているフリをして出力が多様に見えるだけで、実際には入力と無関係なテンプレートを繰り返すTemplate Collapseが起きているケースがある。外部の成功率という結果だけでなく、内部の推論品質というプロセスの両面を評価しないと、実運用での事故は防げない。
Q2. 「Template Collapse」を検知・防止するにはどうすればよいですか?
従来のエントロピー指標ではなく、入力と出力の相互情報量を代理指標として監視する。出力の多様性だけを見ていても、中身が入力と無関係なら意味がない。また、強化学習パイプラインにおいて、報酬の分散が低いプロンプトをフィルタリングするSNR-Aware Filteringを導入する。これにより、モデルが特定の型に固執するのを防ぎ、未知の課題に対しても柔軟な推論能力を維持する。
Q3. Claude Codeのような開発者ツールを運用する際、最も注意すべき指標は何ですか?
タスクの完了率以上に、思考プロセスの入力依存度を重視する。Claude Codeで作業する際は、AIが過去の成功パターンに依存して、今回特有の課題を見落としていないかを監視する。コード生成では、AIが過去に書いたコードのテンプレートをそのまま流用し、要件と微妙にズレた結果を出すことがある。単にコードが動くかどうかだけでなく、入力された課題と出力されたコードの論理的整合性が保たれているかを、エンジニアの目で定期的にサンプリングする。
まとめ
AIエージェントの評価は、どれだけ動いたかという結果論だけでは不十分だ。
出力が多様に見えても、中身がテンプレート化した見えない崩壊は、開発の現場で進行する。
エントロピーのような表面的な多様性に騙されず、入力と推論の相関性である相互情報量を担保する。
Claude Codeのようなツールを使いこなす開発者にとって、AIの推論の型を固定化させないためのパイプライン設計は、必須スキルとなる。
AIエージェントの見えない崩壊を防ぐための評価指標と訓練の最適化手法を試す。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
