


Googleが発表したGemini Omni 1.1 Flashは、動画生成の連続性を強化した。10秒のコンテキストを保持し、映画のような連続性を実現する。
開発者はAPIを通じて、過去の文脈を理解するエージェントを構築する。Google Photosとの連携やロボティクス領域での「空間認識」の強化を含め、システム設計における「AIの記憶管理」が変化する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
動画生成からロボティクスまで、Googleが進める「文脈保持」の全貌
Google DeepMindは、Gemini Omni 1.1 Flashを軸に、動画生成、ロボティクス、パーソナルデータ連携の3領域を強化した。
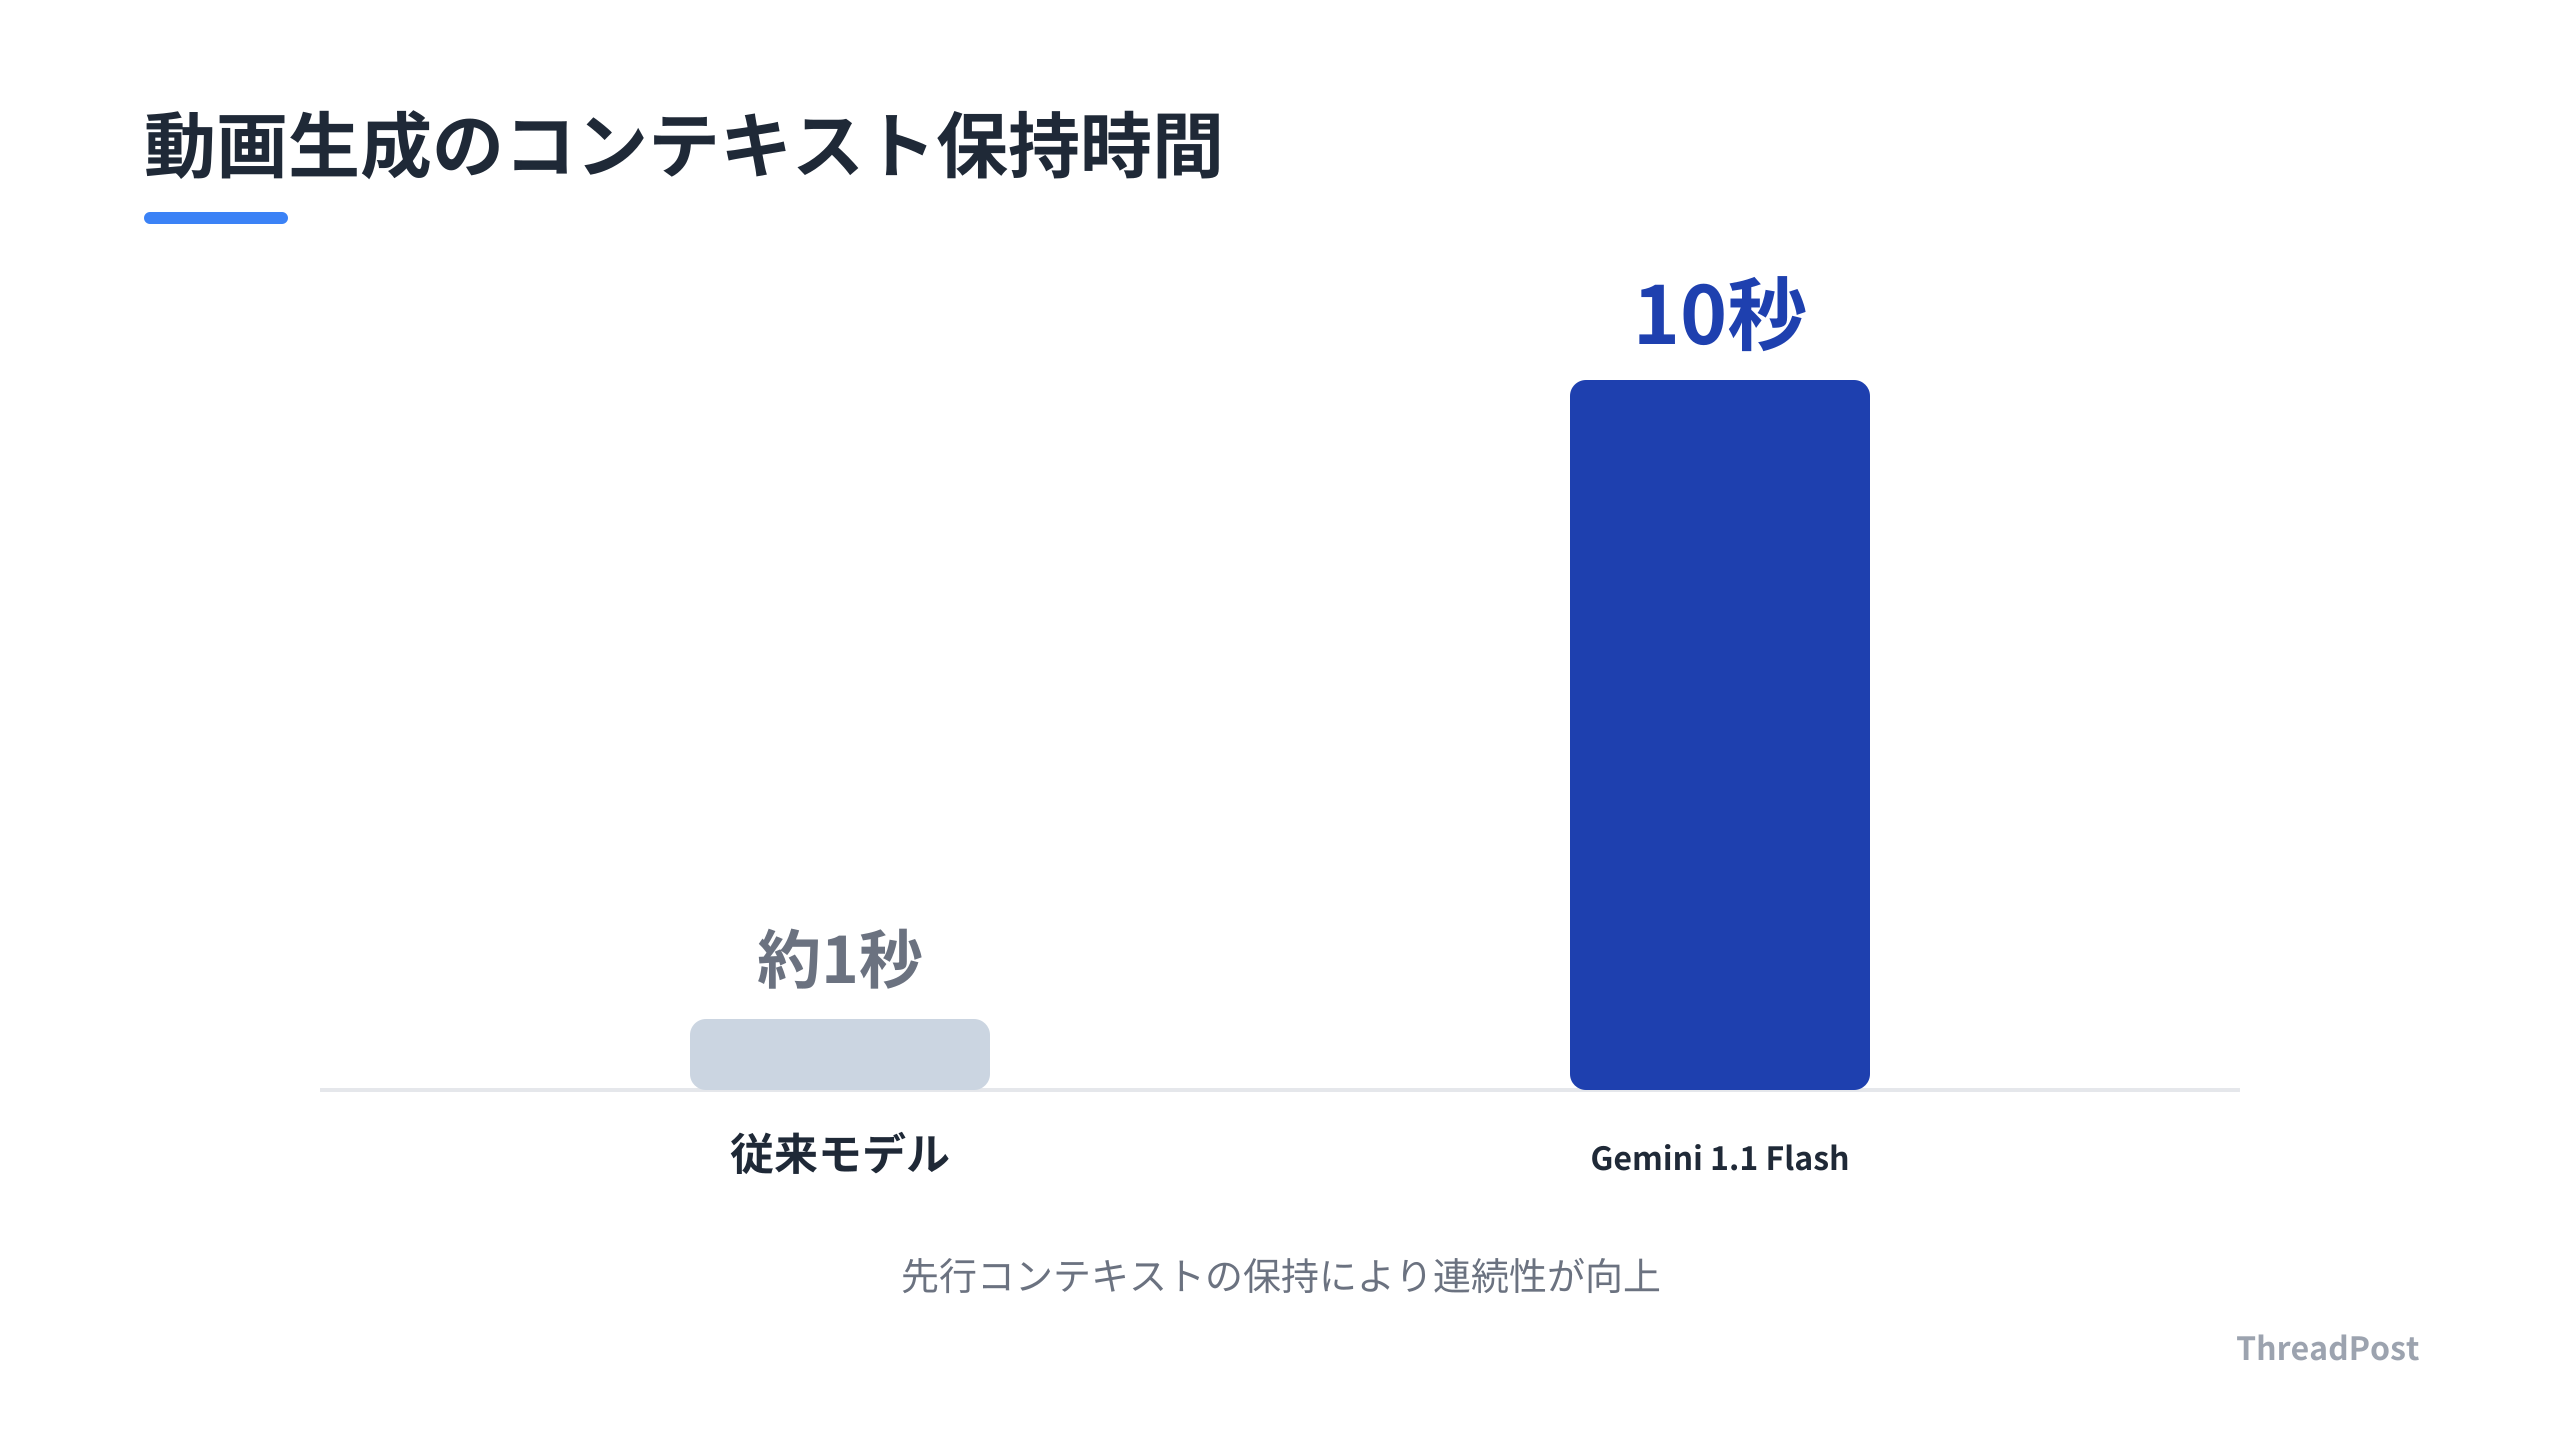
動画生成において、Gemini Omni 1.1 Flashは最大10秒の先行コンテキストを保持する。シーン延長や開始・終了フレームの指定が可能になり、40秒までの連続した動画生成を実現する。
ロボティクス分野では、Gemini Robotics-ER 1.6が投入された。Boston Dynamicsのロボット「Spot」によるシステム点検などで、圧力計や計器の数値をコード実行と組み合わせて読み取る。
パーソナルインテリジェンス機能と新モデルNano Banana 2の組み合わせにより、ユーザーがGoogle Photosと連携させることで、個人のライフスタイルを反映した画像を生成する。この機能は、ユーザーのライブラリにあるラベル情報を活用する。
しんたろー:
10秒のコンテキスト保持は動画編集の現場で活用できる。APIを叩くたびに動画のキャラが変わる事故を防ぎ、実用レベルのワークフローを組める。ロボティクスの数値認識も、Googleが「AIの記憶」をAPIに乗せることに注力していると見受けられる。
これらのアップデートは、Google AI StudioやGemini APIを通じて利用できる。単発のタスク生成から、長期的な文脈や物理環境を考慮したエージェント構築へ移行する。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
なぜ今、Googleは「コンテキストの保持」に執着するのか
今回のアップデートでは、動画生成における10秒間のコンテキスト参照が鍵となる。従来のモデルは直前の数フレームしか参照できず、動画が長くなると一貫性が崩れた。
Gemini Omni 1.1 Flashは、先行する10秒分をAPI側で保持する。開発者がプロンプトで制御しきれなかった物語の連続性やカメラワークを、モデルの推論エンジン側で処理する。
ロボティクス向けモデルの進化も同様だ。Gemini Robotics-ER 1.6は、視覚情報とコード実行を連携させ、計器の数値を読み取る論理的な推論プロセスを組み込んでいる。
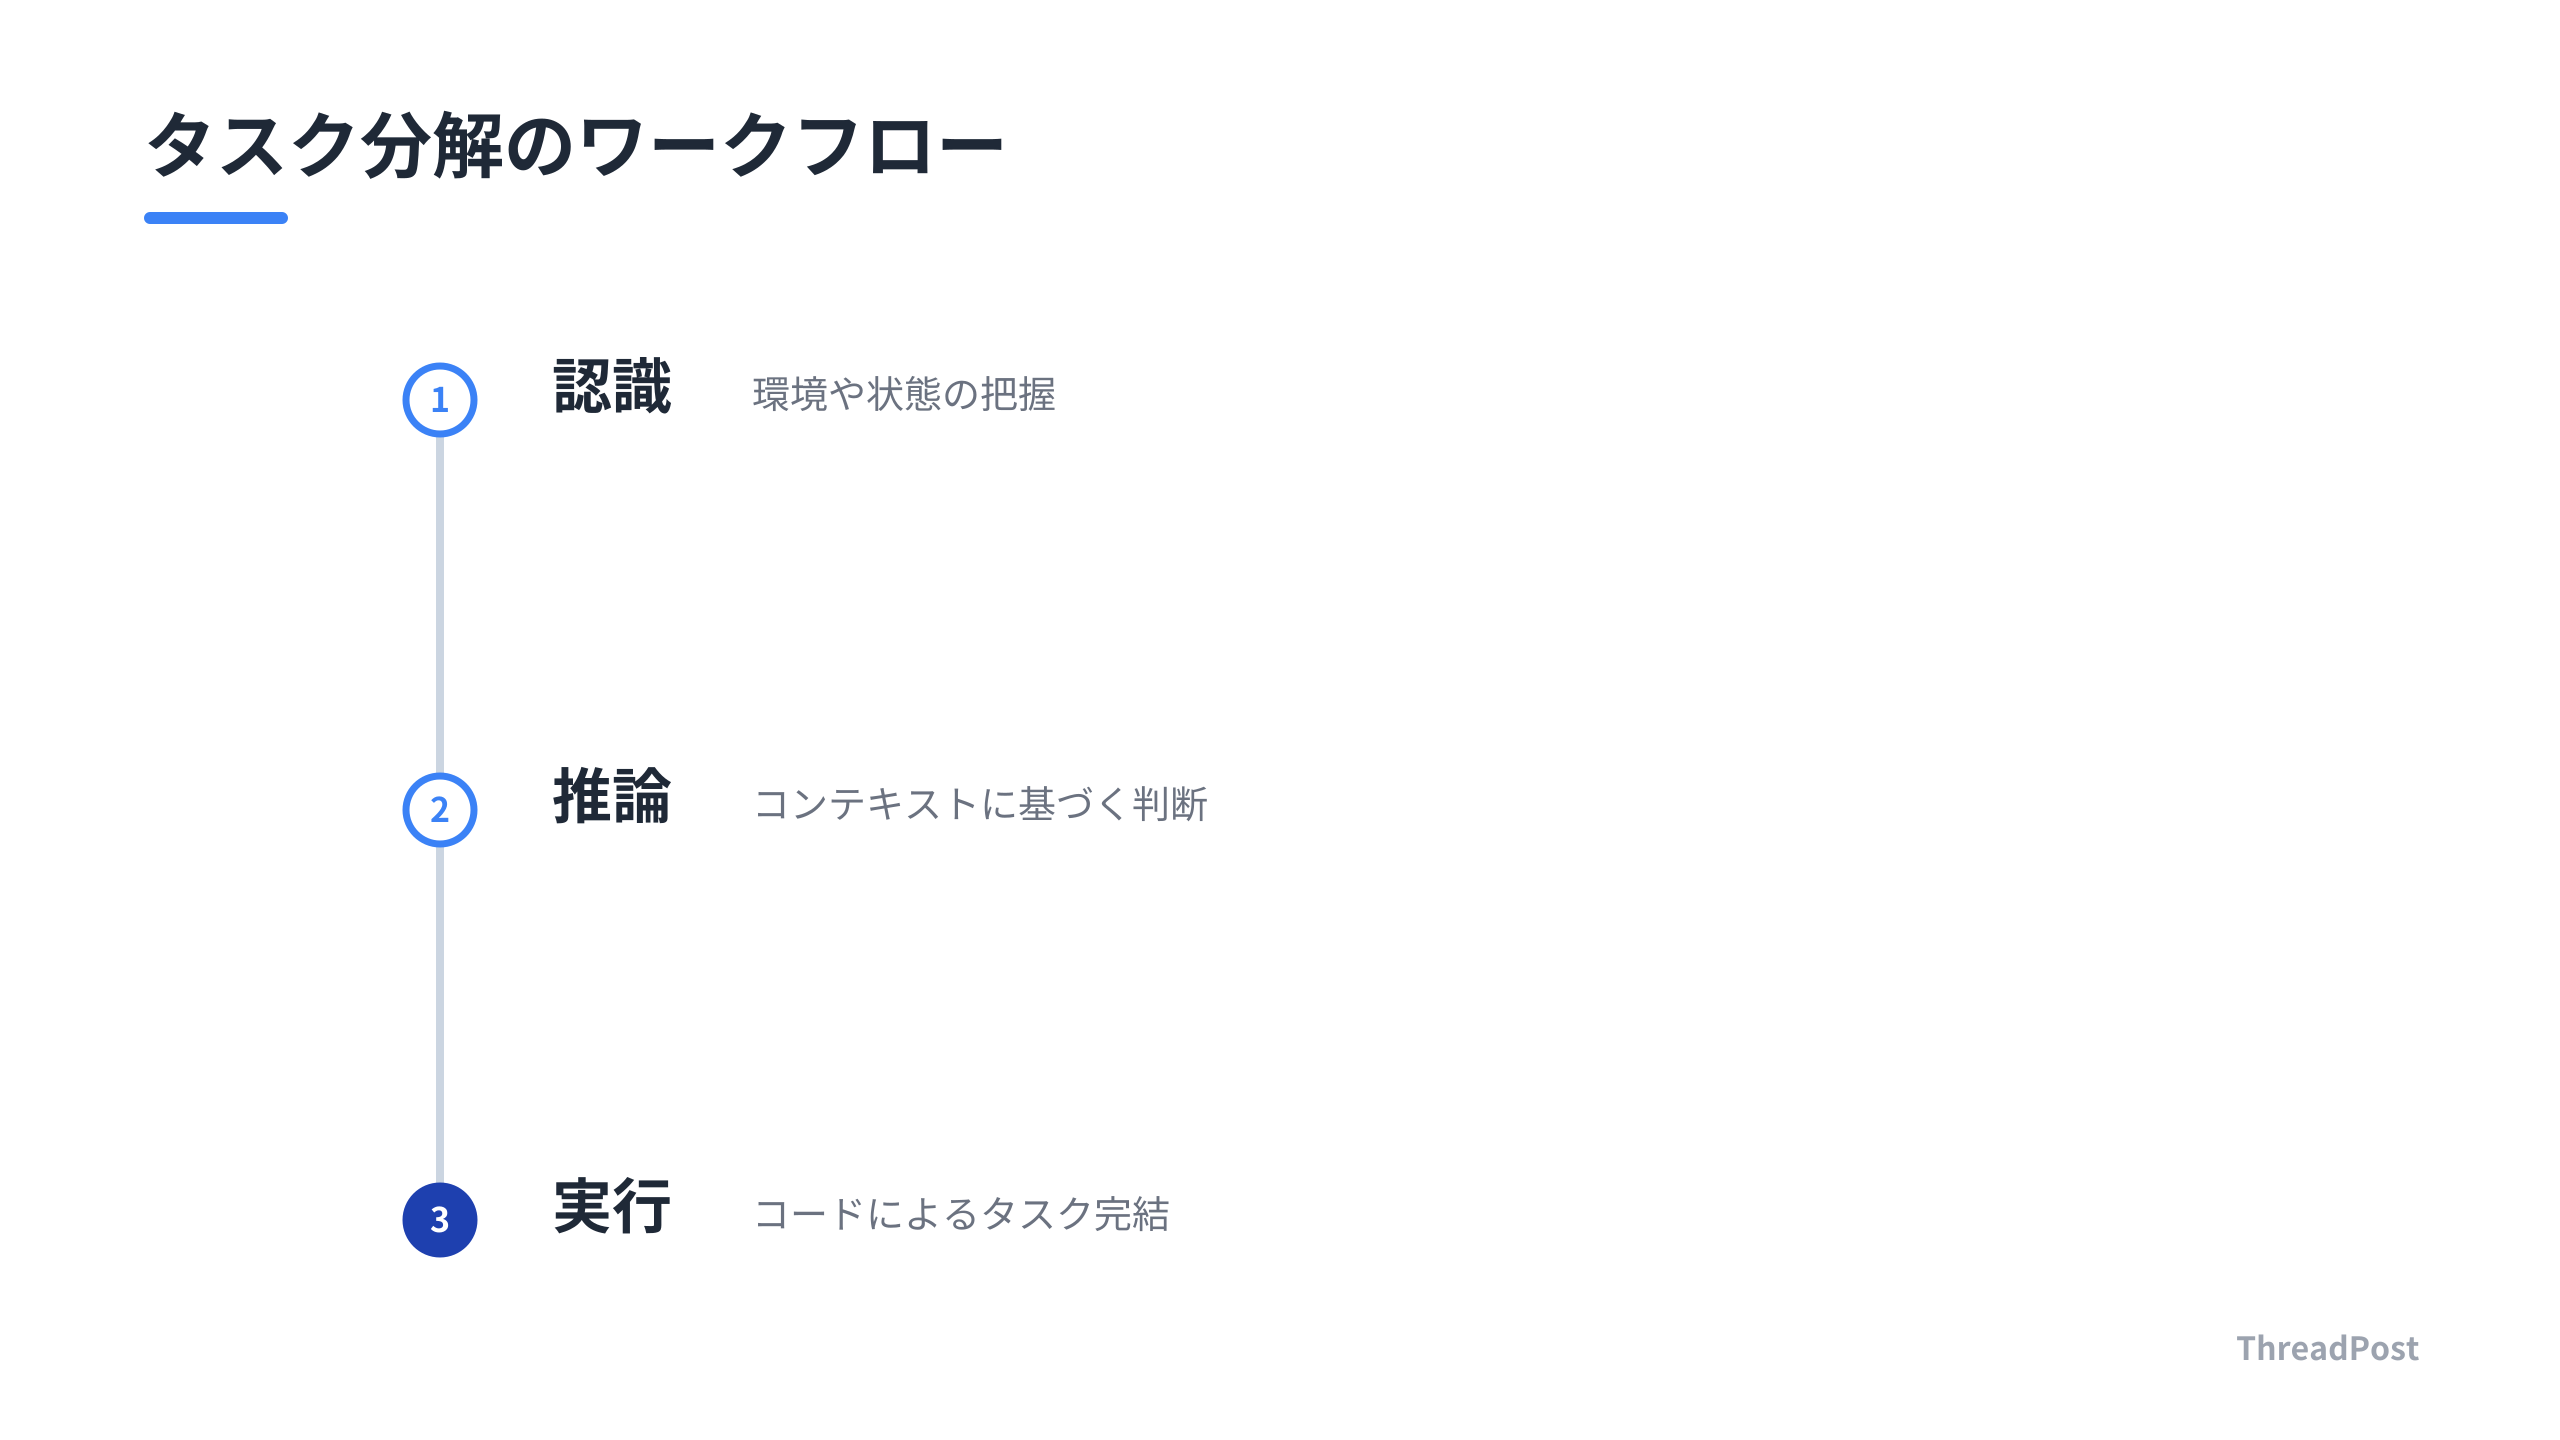
これまでの実装は、AIが「何を見たか」を人間が解釈するループが基本だった。今回のモデルは「視覚情報 → 推論 → コードによる計算 → 結論」というワークフローをAPI内で完結させる。
Claude Codeでコードベース全体を読み込ませて修正させる感覚に近い。AIが過去の履歴や環境の数値を把握して次のアクションを決める。この状態管理の自動化が、今のAI開発における勝ち筋だと考える。
開発者は、モデルの性能競争から、APIを通じてAIに「記憶」と「環境」を渡すアーキテクチャの競争へ移行している。
Gemini Nano Banana 2によるパーソナル生成機能も、Google Photosというデータベースをコンテキストとして引き出す設計思想に基づく。エンジニアには、高度なAIモデルを使いこなすためのデータパイプライン構築力が求められる。
Googleの戦略は、動画、ロボティクス、パーソナルデータという領域において、AIに一貫した文脈を持たせることに集中している。
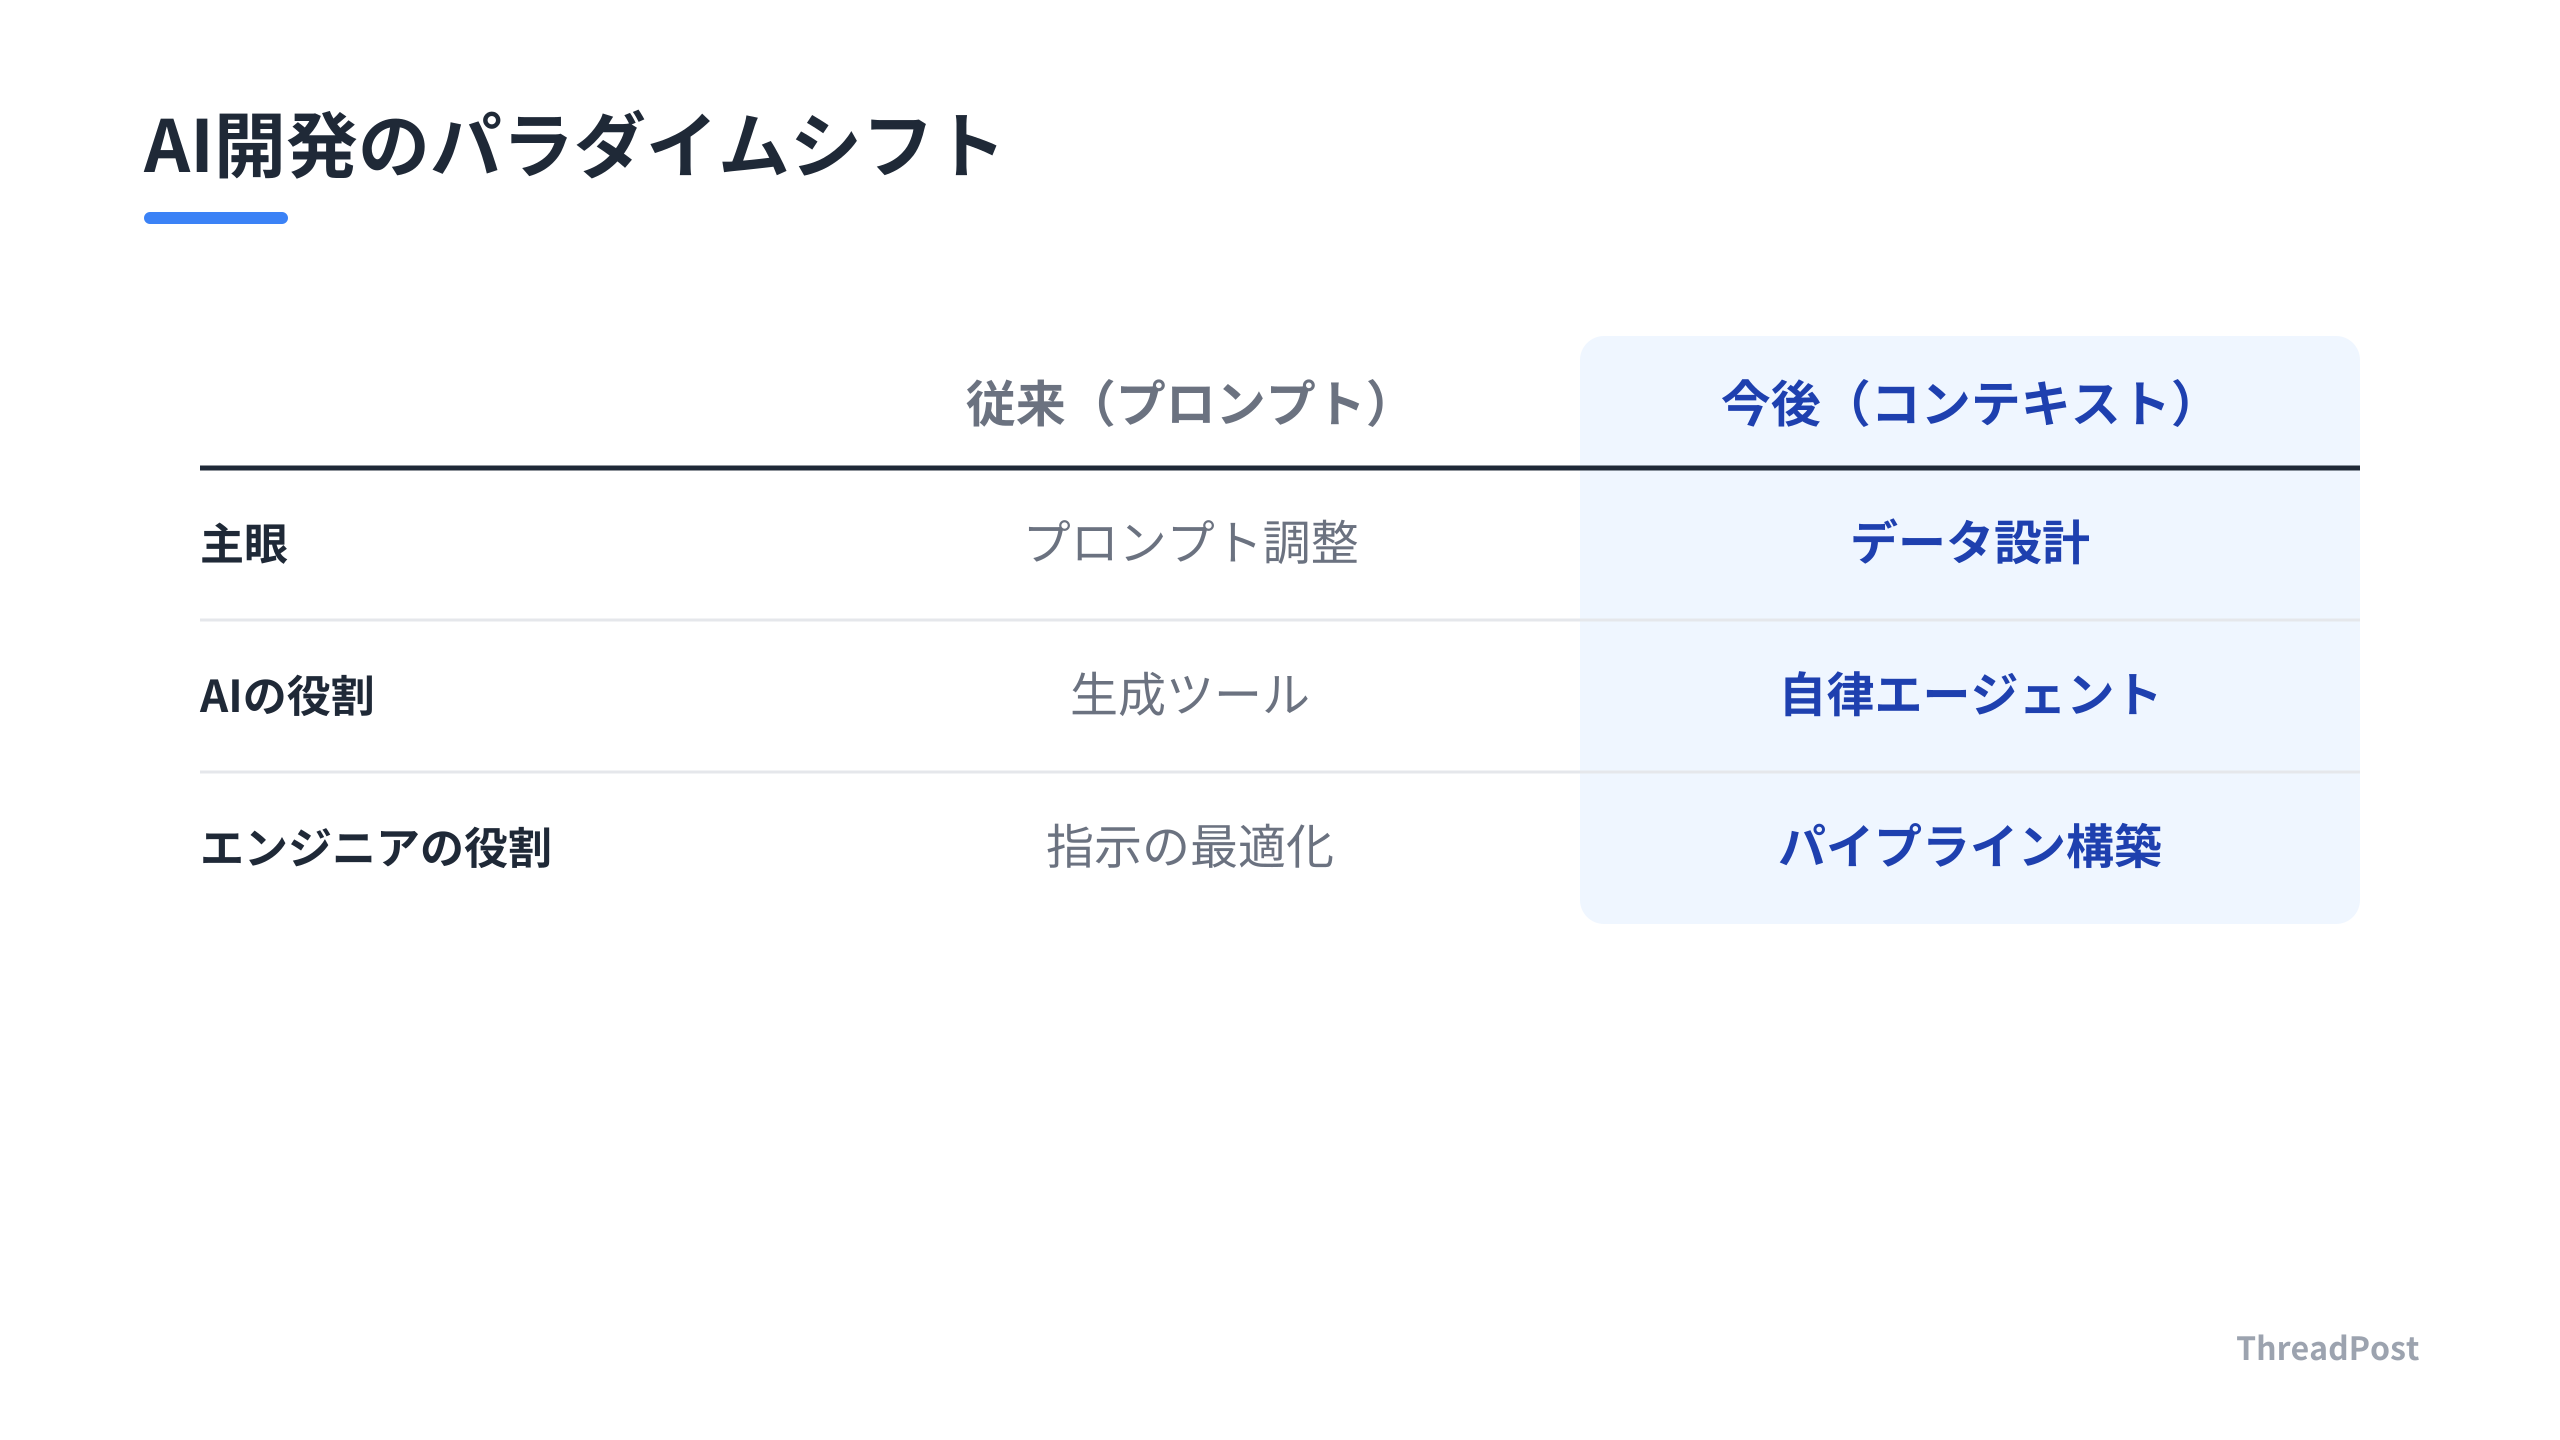
今やるべきことは、AIに複雑なプロンプトを投げることではない。APIに対して「どのコンテキストを、どのタイミングで、どの形式で渡すか」という、システム設計の解像度を上げることだ。
ThreadPostのようなSNS自動化ツールを開発する身として、AIが過去の投稿履歴やユーザーの好みを「記憶」として保持し、動画や画像生成に反映させる実装が差別化ポイントとなる。
AIはAPIを通じて、過去のデータと物理的な環境を統合し、自律的にタスクを完結させるエージェントとして扱うフェーズにある。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
開発者が明日から意識すべき「コンテキスト設計」のリアル
今回のアップデートを受け、開発現場では「プロンプトエンジニアリング」から「コンテキスト設計」へ重心を移す。
Gemini Omni 1.1 FlashやRobotics-ER 1.6は、AIの性能が「どれだけ適切な文脈をAPI経由で渡せるか」に依存することを示した。
動画生成やロボティクスのタスクを実装する際、単発の指示ではAIは一過性の出力しか返さない。
「過去10秒の映像データ」や「特定の物体を認識するための周辺環境データ」を、軽量かつ正確にAPIへ送り込めるかという、データパイプラインの構築が腕の見せ所となる。
明日からの実務で取り組むべきは以下の3点だ。
- API連携の粒度を細かくする
タスクを「認識」「推論」「実行」に分解し、各ステップで必要なコンテキストをAPIに再投入する設計に変える。
- 「記憶」の形式を定義する
ユーザーのライフスタイルや過去のコードベースなど、AIに持たせる情報をJSON形式やベクトル化などで構造化し、設計の解像度を上げる。
- ローカルとクラウドの使い分け
軽量な処理はローカルで完結させ、APIの制限内に収める工夫を行う。
AI開発はバックエンドの泥臭いデータハンドリングに戻っている。Claude Codeを使っていて思うが、AIに何を読ませるかが全てだ。APIの制限と戦いながら、必要な情報だけを抽出する自動化ツールを自分で書くことが関心事だ。
パーソナルインテリジェンスの実装に関しても注意が必要だ。ユーザーのプライベートなデータを扱う以上、APIに渡すデータが学習に利用されるか否か、規約を細かく追う必要がある。
技術的なトレンドは「推論能力の向上」から「環境適応能力の向上」へシフトしている。AIを賢いチャットボットとして見るのをやめ、「文脈を渡せばタスクを完了してくれるAPI基盤」として再定義する。
今すぐ開発しているシステムの「AIへの入力データ」を見直す。そのデータが、AIが長期的な文脈を維持するために十分な内容になっているかを確認する。ここを突き詰めるだけで、生成物の質は安定する。
 あわせて読みたい【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録 →
よくある質問
Gemini Omni 1.1 Flashで動画を延長する際、何秒まで可能ですか?
既存の動画に対して10秒単位で生成を追加でき、合計で最大40秒までの連続した動画生成が可能です。以前のモデルが直前の1秒程度の参照に留まっていたのに対し、10秒の先行コンテキストを保持できるようになったことで、物語の一貫性やカメラワークの継続性が向上しています。
Geminiのパーソナルインテリジェンス機能で、写真データはAIの学習に使われますか?
Googleの公式発表によると、ユーザーのGoogle PhotosライブラリそのものがAIモデルの直接的な学習データとして利用されることはありません。ただし、Geminiに対する特定のプロンプトや、それに対するモデルの応答といった「限定的な情報」については、サービスの改善のために学習に利用される可能性があります。
ロボティクス向けのGemini Robotics-ER 1.6は、どのような用途に適していますか?
このモデルは、ロボットが周囲の環境を認識し、自律的にタスクを計画する「高レベルの思考層」として設計されています。特に、圧力計や視覚的な計器の数値を読み取るといった精密な認識や、Google検索やコード実行を組み合わせて複雑な物理的タスクを遂行する用途に最適化されています。
まとめ
今回のGeminiアップデートで、AIは単なる生成マシンから文脈を理解するエージェントへと脱皮した。動画の連続性からロボットの物理推論まで、すべては「過去の文脈をいかに正確に保持し、タスクに反映するか」に集約される。
開発するアプリも、単発のプロンプトで終わらせず、ユーザーの生活やデータといった「記憶」をどう組み込むかが勝負となる。APIの進化を眺めるだけでなく、自分の手元でどう「文脈」を管理するか、設計を見直すタイミングだ。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
