


Claude Codeのようなコーディングエージェントは強力だが、API料金という高い壁が立ちはだかる。毎日開発に没頭すると、気づいた時には数万円単位の請求が届くことも珍しくない。しかし、運用方法を工夫すればコストは抑えられる。API料金の最小化には「通信の最適化」「モデルの使い分け」「無料枠の連結」の3つが不可欠だ。本記事では、コスト削減の決定版を紹介する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
1. Free Claude Code (FCC) でAPI通信を制御する
コーディングエージェントはメインのコード生成以外に、履歴要約やサジェストといった裏側の通信を大量に行う。これらすべてに有料APIを叩くとコストが跳ね上がる。FCCはプロキシサーバーとして働き、不要な通信をローカルで遮断・代行するツールだ。ローカルLLMを繋ぐことで、メインの推論以外にかかるコストをゼロにできる。まずはこの環境を構築する。
2. Cavemanによる入力トークンの圧縮
AIエージェントに渡すログやJSONデータは、コンテキストを圧迫する要因だ。Caveman 2.0.0は、LLMへ送るデータを事前にローカルで圧縮する。ノイズとなる進捗表示を削り、重要なエラー情報や構造化データだけを抽出するため、トークン消費量を削減できる可能性がある。コンテキストウィンドウの節約にもなり、長文のコードベースを扱う際に有利だ。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
3. 用途に応じたDecisionモデルの併用
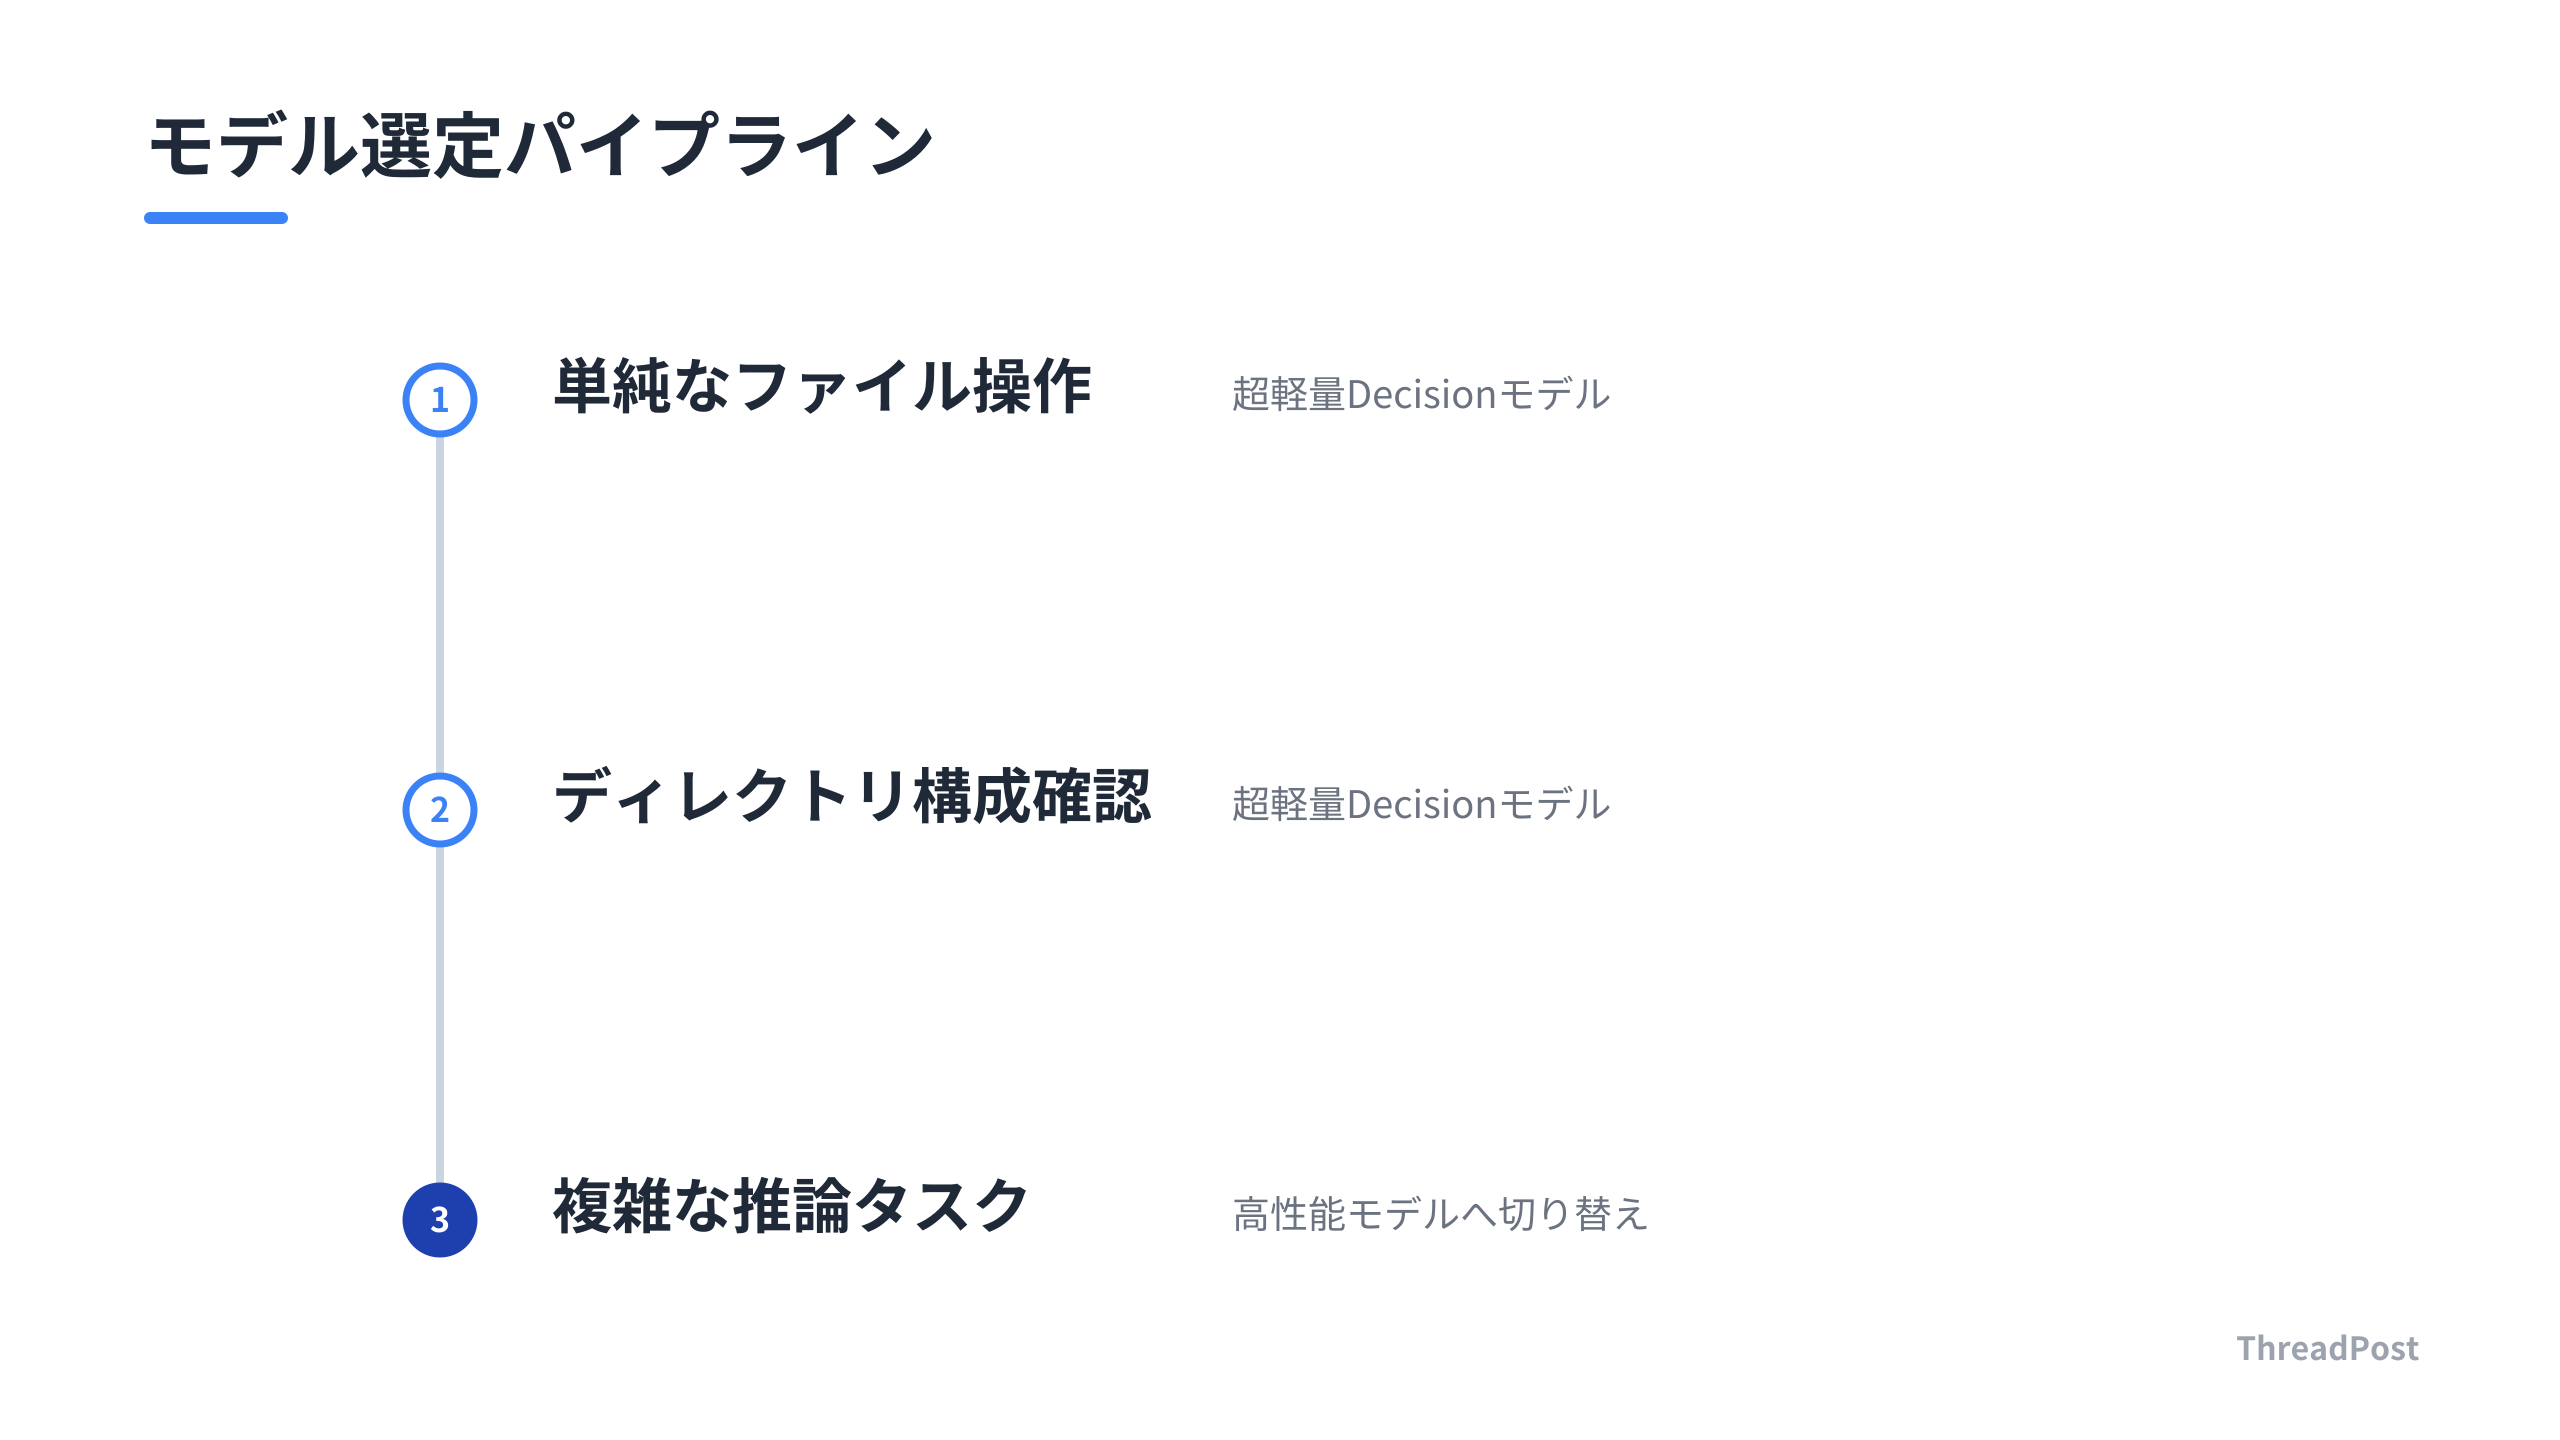
全てのタスクに最高性能のモデルを使うのは非効率だ。特定の判断や分類を行う際は、超軽量なDecisionモデルを導入する。汎用モデルよりも高速で、推論コストも極めて低い。単純なファイル操作やディレクトリ構成の確認などは、この軽量モデルに任せる。複雑な推論が必要な時だけ高性能モデルに切り替えるパイプラインを構築すれば、コストパフォーマンスは向上する。
4. プロバイダーの多段フォールバック構築
各社が提供する無料枠を単体で使うとすぐ上限に達するが、複数を束ねれば話は別だ。OpenRouterなどを経由し、主力が枯渇したら自動的に別のプロバイダーへ切り替わる構成を組む。これにより、無料枠を使い切るまで長時間の開発を継続できる。一度構築すればAPI代を気にせず開発に集中できる環境が手に入る。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
5. 出力トークン上限の最適化
Claude Codeはデフォルトで大きな出力枠を要求するが、これが無料枠の制限に引っかかりエラーを招く。環境変数で出力上限を絞る設定は必須だ。たとえば出力上限を8,000トークン程度に制限しておけば、無料枠の範囲内で安定した挙動を確保できる。長文生成が必要な場合は分割して実行する。
6. Serverless推論基盤の活用
自前で高性能なGPUサーバーを維持するのはコストと手間の面でリスクがある。Fireworks AIのようなサーバーレス推論基盤を利用すれば、オープンウェイトモデルをトークン従量課金で運用できる。インフラ管理が不要な上に、モデル選択の自由度も高い。特定のモデルに依存せず、その時々の最安かつ高性能なモデルを柔軟に選べる。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
7. HTMLベースでの生成品質検証
Markdownの差異だけでAIの生成精度を判断するのは危険だ。プログラムでHTMLに変換して比較する手法を採用する。実際の表示崩れを早期に発見すれば、再生成によるトークンの浪費を防げる。複雑なコードベースでは、見た目の不整合を自動検知する仕組みがあるだけで、無駄な修正指示を大幅に減らせる。
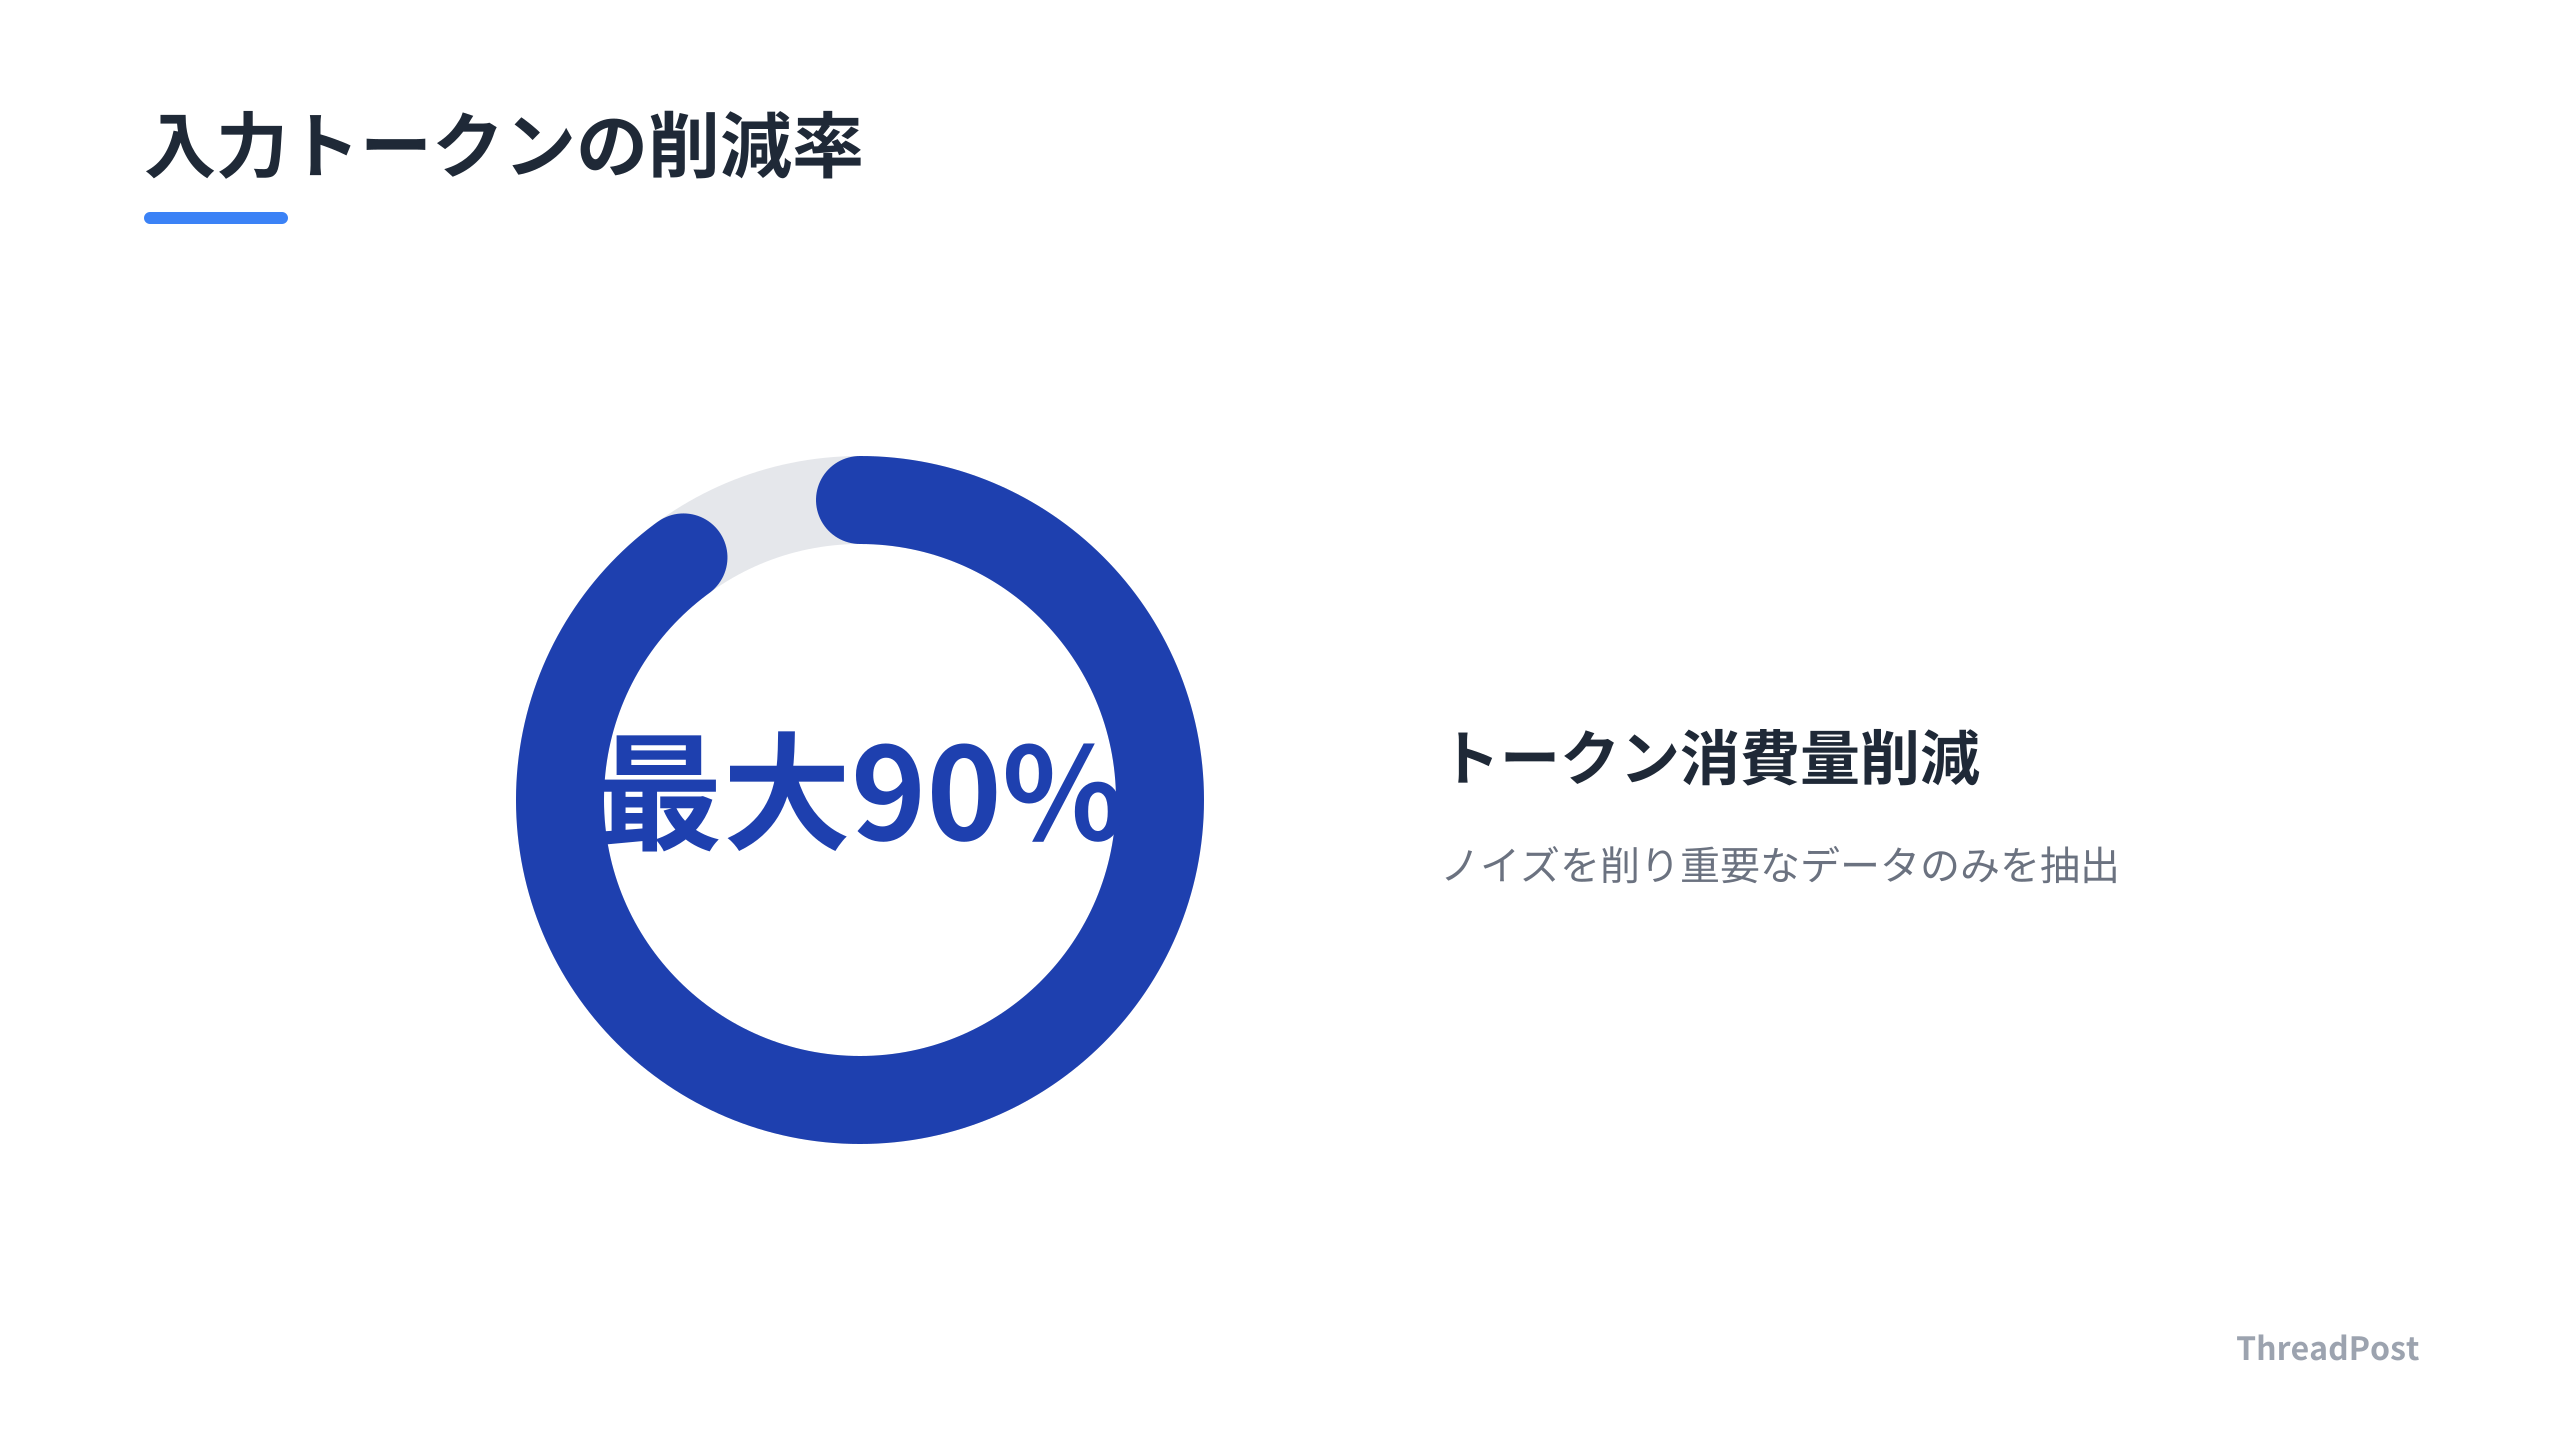
コスト削減手法の比較表
| 手法 | 削減対象 | 難易度 | おすすめ度 |
|---|---|---|---|
| Free Claude Code | 裏側の不要通信 | 中 | 高 |
| Caveman | 入力トークン | 中 | 高 |
| Decisionモデル | 推論負荷 | 高 | 中 |
| 多段フォールバック | API料金 | 中 | 高 |
| 出力上限設定 | 無料枠エラー | 低 | 高 |
| Serverless基盤 | インフラ維持費 | 低 | 中 |
| HTML検証 | 再生成コスト | 中 | 中 |
しんたろー:
Claude Codeでコードを書く際、FCCによる通信制御が効果的だ。エージェントが裏で吐き出す細かいリクエストを遮断するだけで、API代が目に見えて減る。
Cavemanも有用なツールだ。ログの圧縮でトークンを削るという発想は、大規模なプロジェクトを個人で管理するエンジニアにとって救世主になる。
FAQ
Q1: ローカルLLMでClaude Codeを動かすと重くなりませんか?
A1: そのままでは非常に重くなる。原因はClaude Codeが裏側で行う大量のサジェストや履歴要約リクエストだ。解決策はFree Claude Codeのようなプロキシツールを挟むことだ。これにより、不要なリクエストをローカルで遮断し、メインの推論リクエストのみをローカルLLMに送ることで、実用的な速度を確保できる。
Q2: 無料APIを束ねる際、何に注意すべきですか?
A2: 入力サイズと出力サイズの制限に注意が必要だ。無料枠は一度に送れるトークン数や返せるトークン数に厳しい制限がある。主力を入力許容量の大きいプロバイダーにし、制限が厳しいものをフォールバックに回す構成が推奨される。また、出力上限を環境変数で絞ることも必須だ。
Q3: Cavemanを使うと精度は落ちませんか?
A3: 圧縮の度合いにもよるが、ログやJSONなどの構造化データにおいて、ノイズを省き重要な情報を優先して送るため、精度が向上したり、コンテキストウィンドウの節約により長文対応力が上がったりするケースがある。ただし、HTMLなどの複雑なデータでは用途に応じた使い分けが重要だ。
Q4: 商用利用でオープンウェイトモデルを使う際の懸念は?
A4: データのプライバシーとライセンスが最重要だ。信頼できる推論基盤を選び、入力データがモデル学習に使われない設定を確認する必要がある。また、利用するツールやライブラリのライセンスが商用利用を許可しているか、将来的なライセンス変更がないかを事前に確認する。
Q5: コスト削減と品質維持を両立するには?
A5: Decisionモデルのような超軽量モデルと、高性能なモデルを組み合わせるのがベストだ。単純な判断や分類は安いモデルに任せ、複雑な推論が必要な時だけ高性能モデルを使うパイプラインを構築する。また、出力結果を自動テストする仕組みを導入することで、安価なモデルでも品質を担保できる。
まとめると、Claude Codeの運用コストは工夫次第で下げられる。まずは環境変数の設定やプロキシの導入から始め、無料枠を賢く使い倒す。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
