


Claude Codeでコードを書く。ふと「AIの回答がAIっぽい」と感じる。過剰な丁寧語や定型的な構成。違和感の正体はモデル単体の性能ではない。言語特有の文法や環境ごとのシステムプロンプトの制御にある。
AI生成物の質を引き上げる。言語・環境・セキュリティを統合した制御術を解説する。ThreadPostの開発で実践する、AI特有の癖を排除し成果物のクオリティを一定に保つアプローチだ。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
AI生成物の品質を左右する3つの技術動向
AI開発の焦点はモデルの性能から出力の質へ移った。言語ごとの文体制御、システムプロンプト構造、エッジでのプライバシー保護が重要だ。
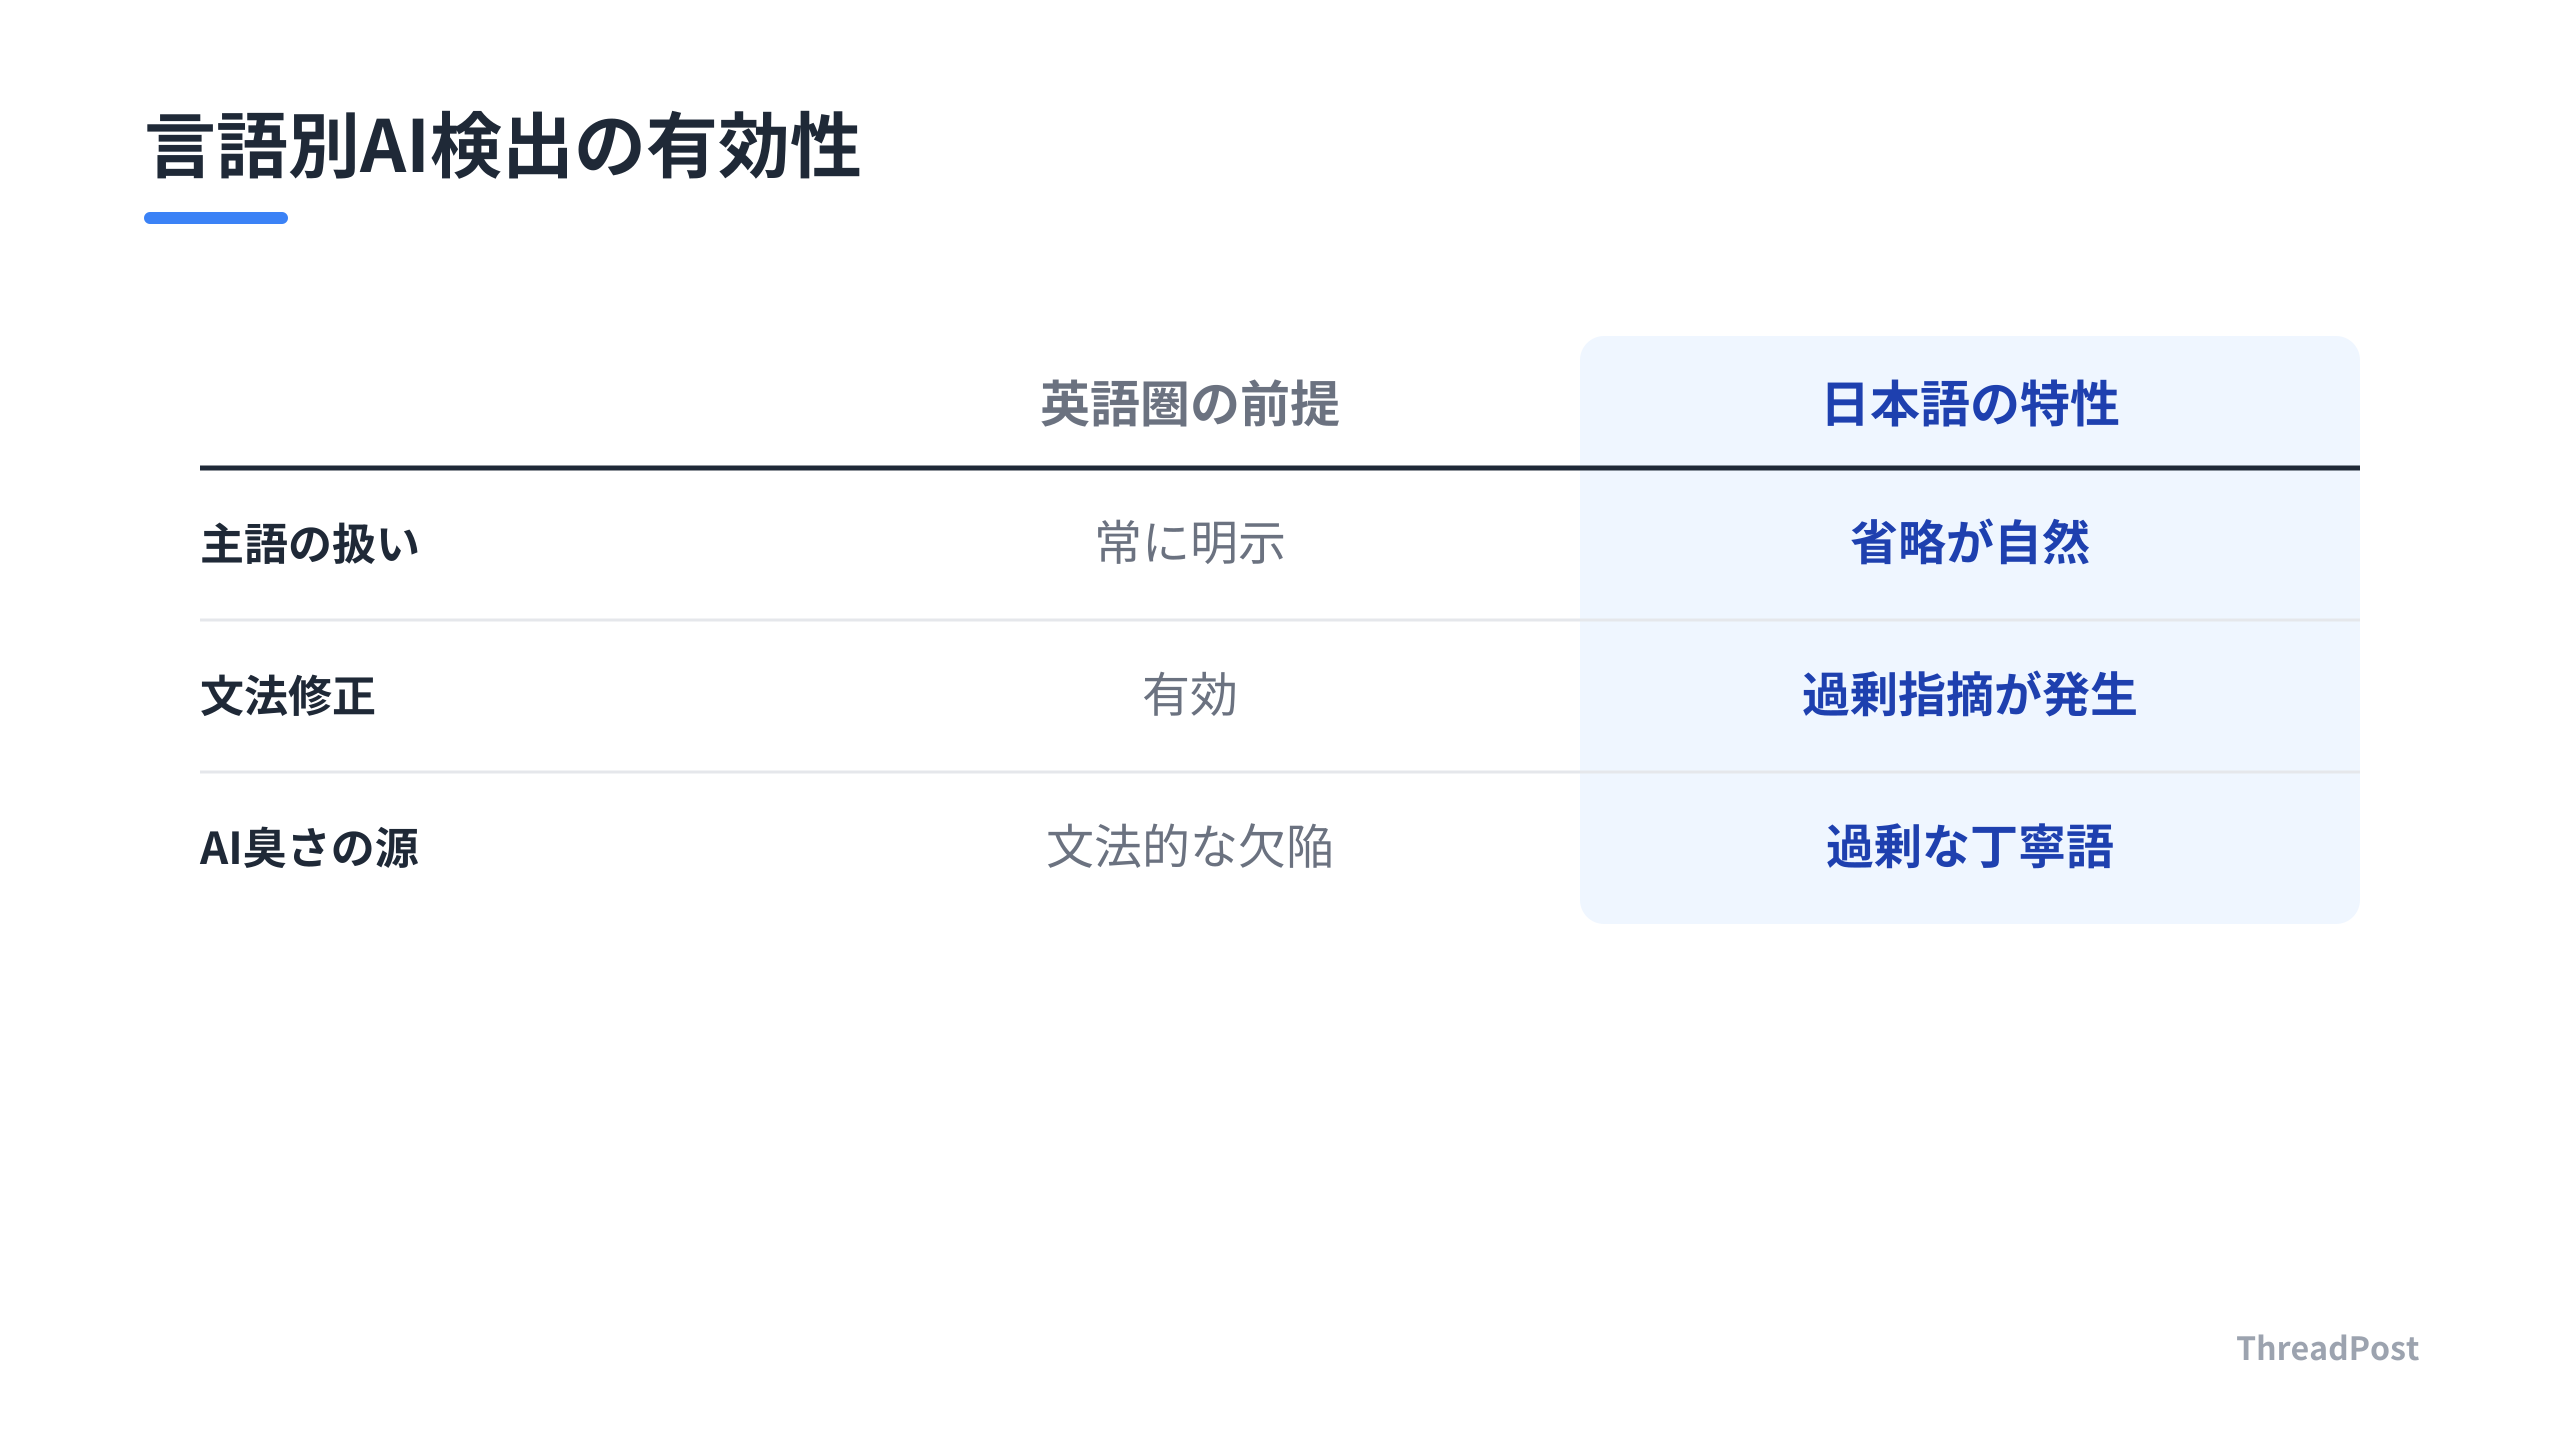
英語圏のAI検出スキル35パターンを日本語環境で精査した。半分以上が日本語でも有効だ。一方で英語の文法に基づく「主語の欠落への修正」や「カーリークォートの変換」は日本語では空振りする。日本語特有の「過剰な丁寧語」や「定型的な課題と展望」がAI臭さを強める。
モデルの内部構造も明らかになった。流出したシステムプロンプトを6つの環境で比較した。同じモデルでもWeb版、デスクトップ版、モバイル版で挙動が異なる。モバイル版は位置情報やカレンダー連携を優先する。検索の強制力や拒否の閾値は環境ごとに設計されている。
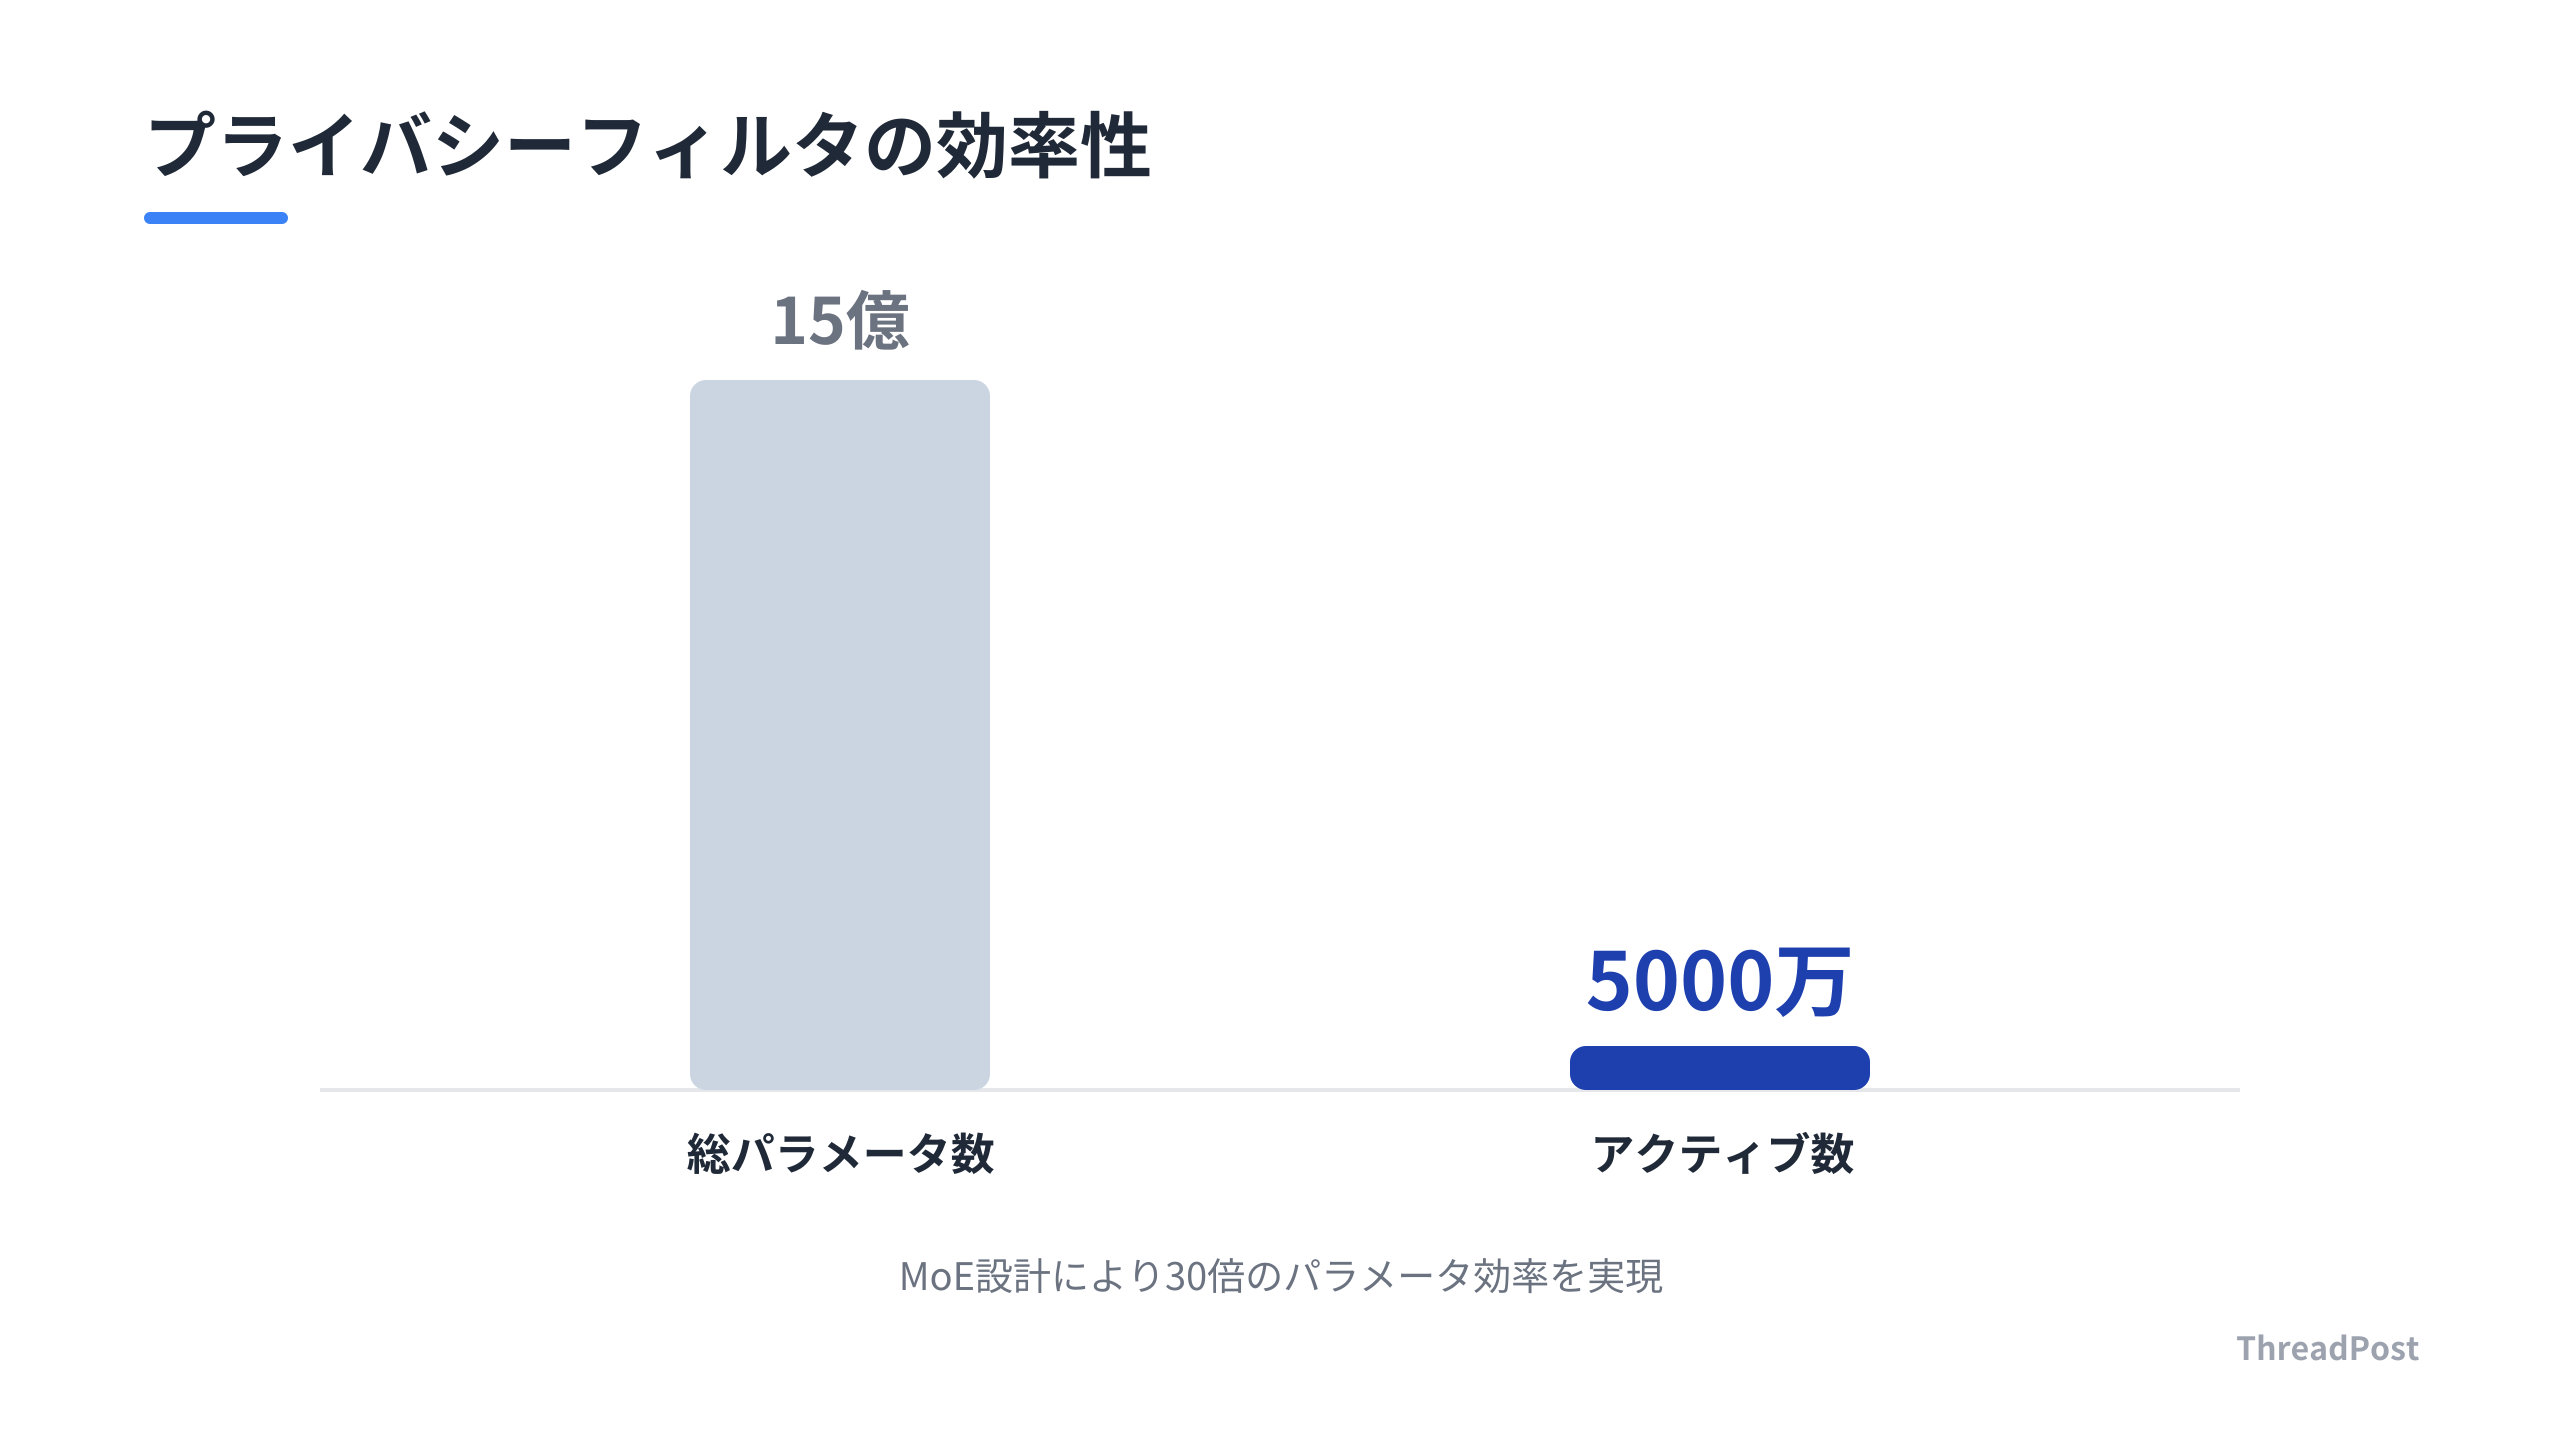
新しいプライバシーフィルタモデルは15億パラメータの軽量設計だ。アクティブなパラメータは5000万に絞り込まれる。30倍のパラメータ効率差を生む「疎な混合エキスパート(MoE)」設計だ。12万8000トークンのコンテキストウィンドウを持ち、ローカルで動作する。機密情報のサニタイズを外部APIへ送らずに行える。
しんたろー:
モデルの賢さより環境制御がすべてだ。プライバシーフィルタがローカルで動くのは大きい。API制限に怯える時代は終わった。
開発者はモデルの出力をそのまま受け取らない。言語特性や環境、セキュリティ層を個別に管理するパイプラインを構築する。Claude Codeを使うなら、AI特有の癖をフィルタリングする仕組みをCI/CDに組み込む。
 あわせて読みたいClaude Codeの使い方完全ガイド|インストールから実践まで2年運用の開発者が解説 →
AIの「質」を制御する3つの階層とモデルの構造的理解
AIの出力品質を向上させる技術は3つのレイヤーに分かれる。言語的な癖を制御する「フィルタリング」、環境ごとに規定する「システムプロンプトの設計」、機密情報を処理する「データクレンジング」だ。これらを一つのパイプラインとして統合管理する。
英語圏のスキルを日本語に適用すると精度が落ちる。英語の文法的な欠陥を指摘するツールは、日本語ではまともな段落ほど過剰に指摘を返す。主語の省略を許容する日本語の特性を無視しているからだ。
日本語はAIの品質管理が難しいわけではない。検出の前提が言語間で反転しているだけだ。同じ主語が連続する冗長な表現をAIの痕跡として拾うなど、日本語独自の指標を組み込む。汎用的なスキルセットは十分に機能する。
システムプロンプトはAIの人格ではない。その場その場で演じさせられているロール指示だ。環境によって検索の積極性や拒否の閾値が異なるのは、Anthropicが環境別のバリアントを使い分けているためだ。
Claudeのシステムプロンプトを覗くと、環境ごとに検索の優先順位や拒否ラインが違う。APIで叩くときはログから追うより、システムプロンプトの構造を理解してコンテキストを補う方が近道だ。
この構造を理解すれば挙動は予測可能になる。開発者はエッジで動作する軽量モデルを組み合わせ、機密情報のサニタイズを自前で実装する。能動的な制御へシフトする。
1.5Bパラメータ規模の軽量プライバシーフィルタが普及した。機密情報の取り扱いは変化した。API経由の送信リスクをローカル環境で完結できる。推論コストを抑えつつ機密情報を外部に出さないパイプラインを構築する。
Claude Codeでコードを生成する際も同じだ。CI/CDパイプラインの中に、AI特有の冗長な表現や曖昧なヘッジを排除するフィルタリング層を組み込む。レビュー負担は減る。
AI開発の質を高めるとは、AIモデルを任せる範囲と人間側でフィルタをかける範囲を線引きすることだ。モデルの内部構造をすべて理解する必要はない。どこで何がフィルタリングされ、どういう構造で回答が生成されているのかというレイヤー構造を把握する。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
明日から開発環境に組み込むべき「AI品質管理」の具体策
AIの挙動をモデルの機嫌で片付けない。モデルごとのシステムプロンプトの差異や、言語特有のAIくささを理解する。AIの出力をそのまま受け入れない防御的開発へシフトする。
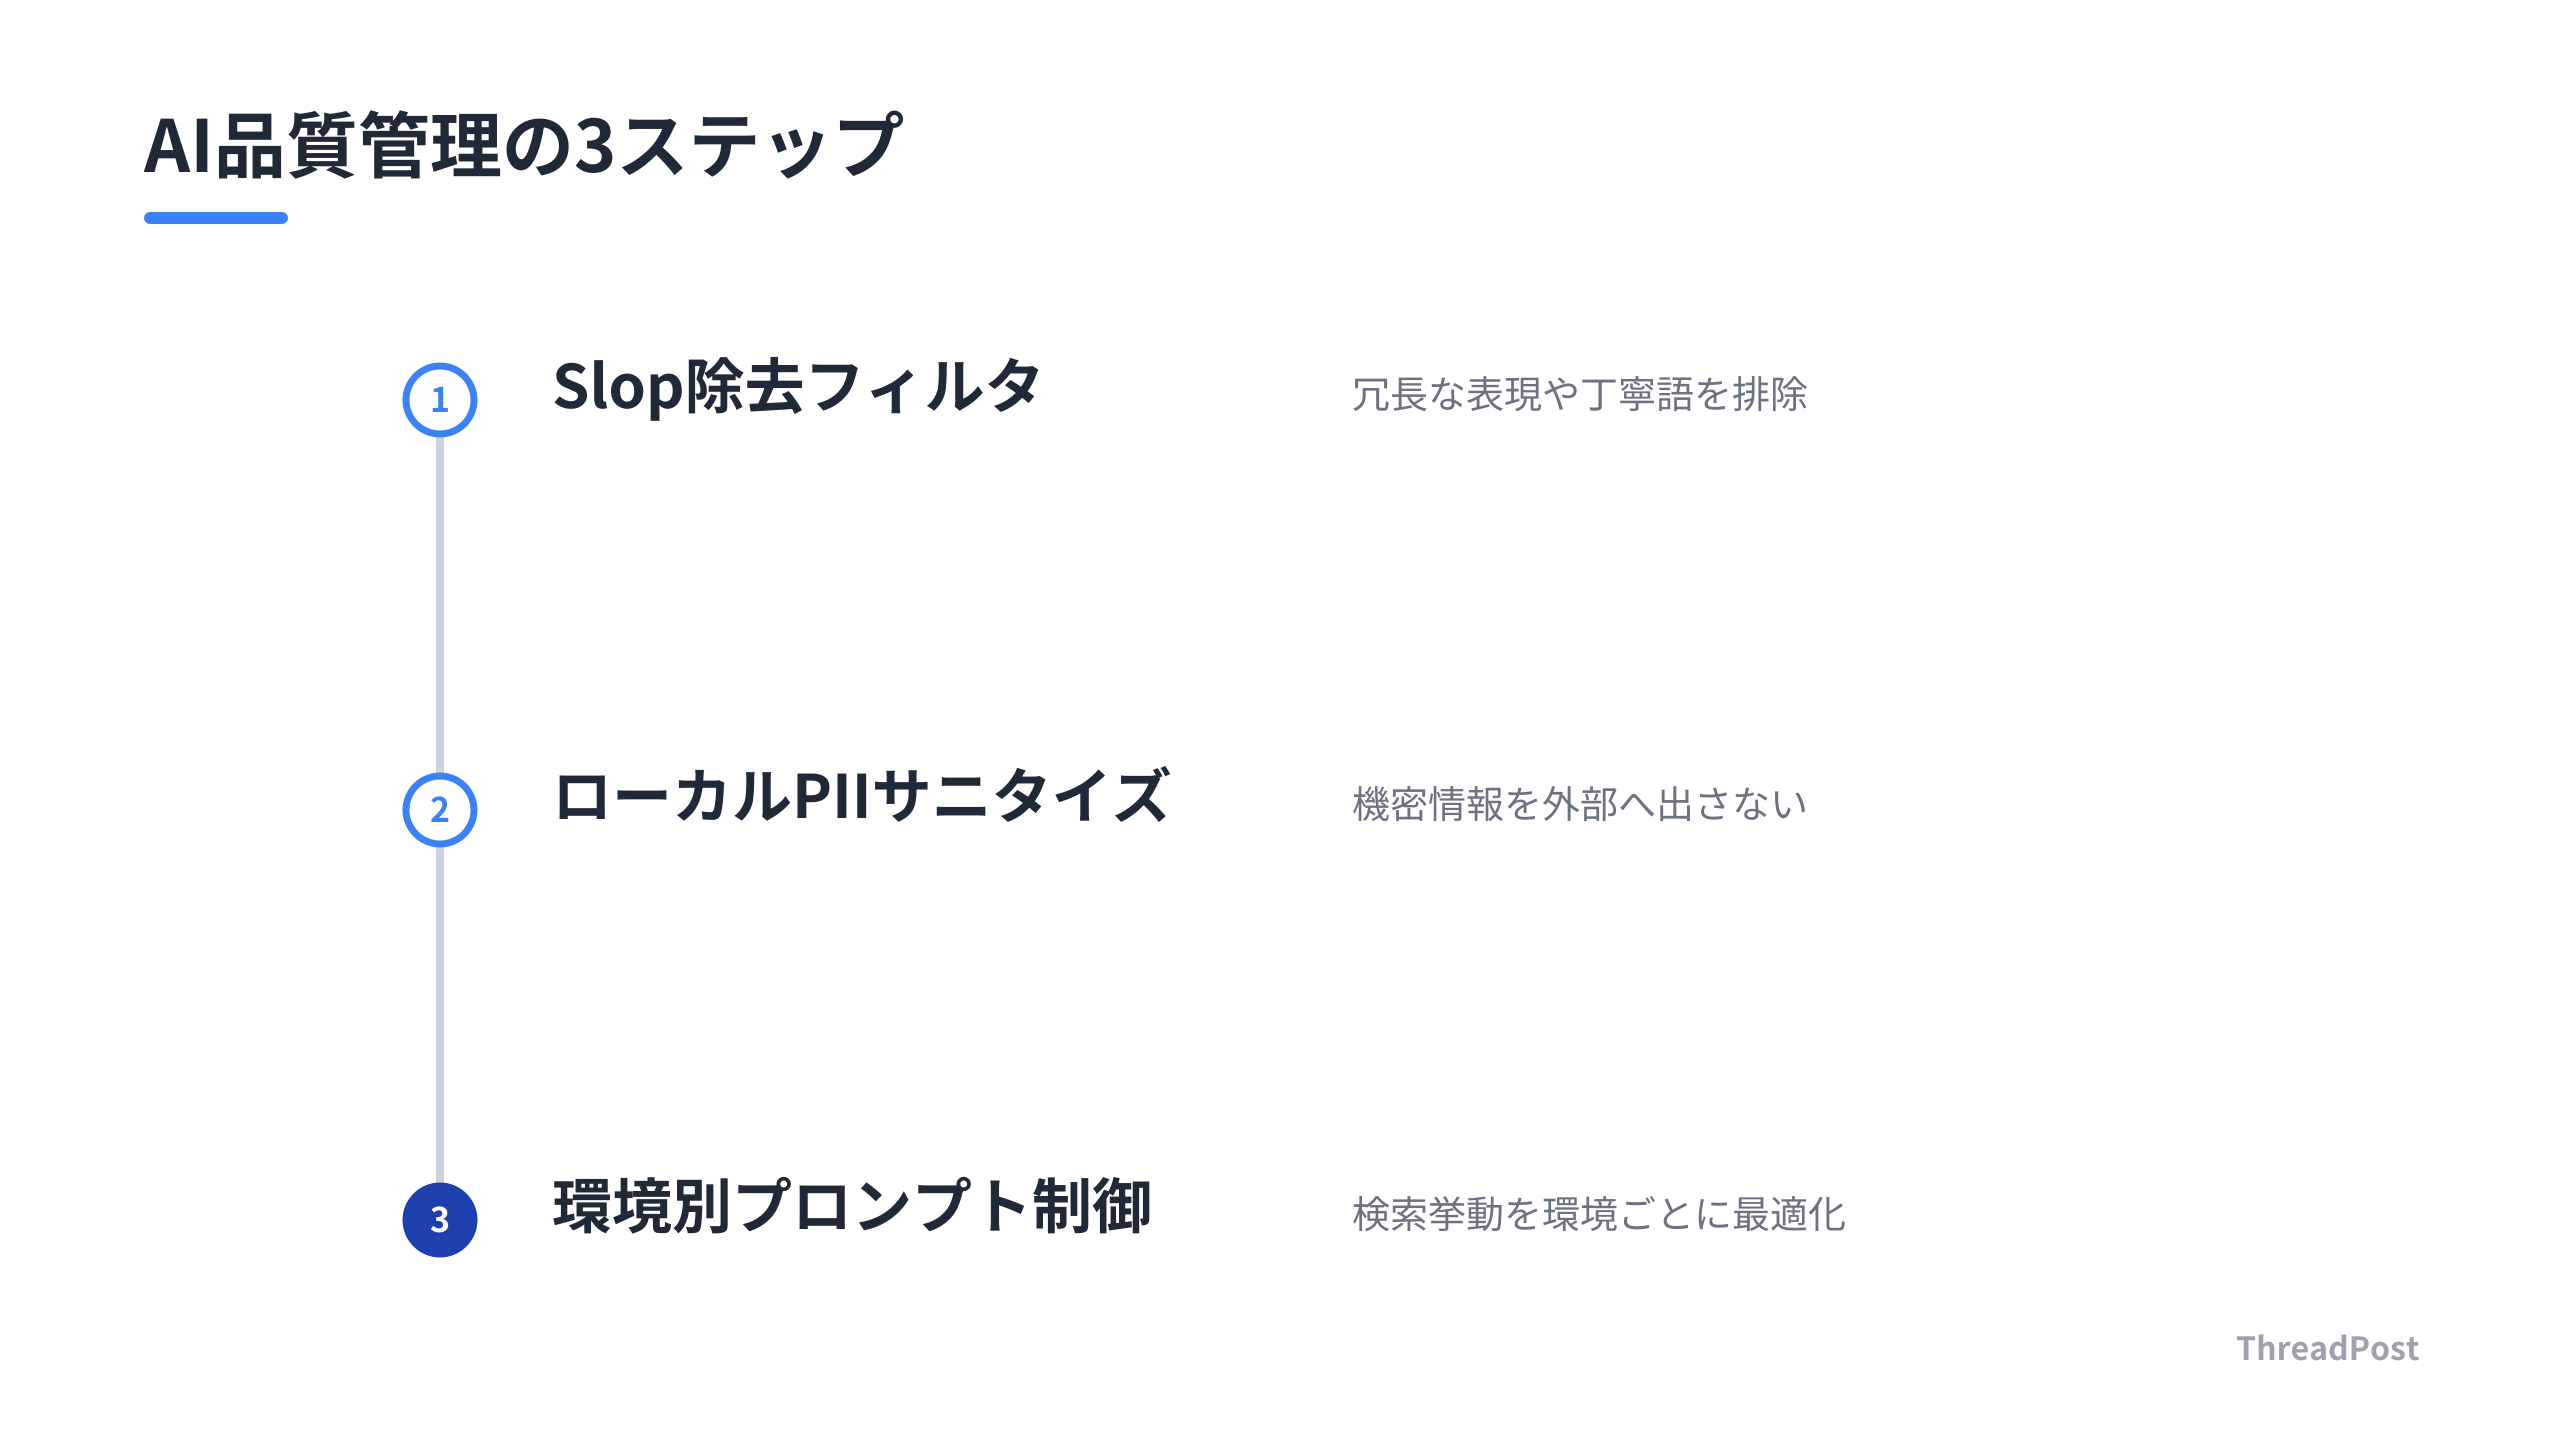
コード生成のパイプラインに「Slop除去フィルタ」を組み込む。日本語環境では英語の文法構造を翻訳したような冗長な言い回しや、過剰な丁寧語が質を下げる。GitHubの既存スキルをベースに、日本語特有の「同じ主語の連続」や「不自然な接続詞」を弾くカスタムルールを追加する。Claude Codeが生成するドキュメントの精度は上がる。
PII(個人情報)のサニタイズをAPI呼び出しの前工程に配置する。軽量なプライバシーフィルタをローカルで走らせれば、機密情報をクラウドに送るリスクを遮断できる。30倍のパラメータ効率で最適化されたモデルなら、ラップトップ上でもパフォーマンスへの影響はない。ログを定期的にクレンジングするバッチ処理を組む。
環境に応じたプロンプトの出し分けを実装する。モバイル版Claudeとデスクトップ版では、検索の積極性やツール呼び出しの閾値が異なる。Web版で動かすプロンプトと、バックエンドのバッチ処理で叩くプロンプトを分ける。検索を強制したいタスクでは、システムプロンプトの構造を意識し、検索をスキップさせない指示を加える。
AIの出力は入力した構造の鏡だ。Claude Codeのプロンプトを環境ごとに切り分けるようにしたら、エラーの発生率は減った。ツールを信じるのではなく、ツールが動く環境と条件をハックする。
AIを魔法の杖ではなく制御可能なモジュールとして扱う。意識の切り替えが開発者の生存戦略になる。
FAQ:AI開発の現場でよくある疑問
Q1: AIの生成物が「AIっぽい」と言われるのはなぜですか?
A1: 過剰な丁寧語、曖昧なヘッジ、構造の定型化が原因だ。英語の学習データに由来する癖が日本語に翻訳された際に違和感として現れる。日本語の自然な文脈に合わせた禁止語リストの適用や、主語の省略を許容する文体調整のプロンプトエンジニアリングで解決する。
Q2: Claudeのシステムプロンプトを意識して開発するメリットは?
A2: Claudeは環境によって検索の積極性や拒否の閾値が異なる。システムプロンプトの構造を理解することで、なぜ特定の環境で回答が拒否されるのかを予測できる。プロンプトの設計を環境に合わせて最適化し、検索を強制する指示や拒否を避けるためのコンテキスト付与が可能になる。
Q3: PII(個人情報)の除去はなぜローカルモデルで行うべきなのですか?
A3: API経由でデータを送信する前にローカルでPIIをサニタイズすることで、データプライバシーの懸念を払拭できるからだ。軽量モデルを使えば、推論コストを抑えつつ機密情報を外部に出さずに安全なデータ処理パイプラインを構築できる。社内ドキュメントを読み込ませる前の前処理として有効だ。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
まとめ
AI生成物の質は、モデルの賢さに依存する時代から環境を制御する時代へ移った。英語圏の知見をそのまま持ち込まず、日本語特有の文体や環境ごとに異なるシステムプロンプトの挙動を理解する。ローカルで動く軽量モデルでフィルタリングする。この泥臭い制御の積み重ねが、AIを実用的な開発パートナーへ引き上げる。
モデルの性能向上を待つ必要はない。今日からできる小さなパイプラインの構築が、開発効率の差を生む。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
