


AIエージェントを活用した開発と運用の自動化は、単に生成機能を組み込むだけでは終わらない。ログが正常でも結果が誤っている事態は頻発する。無人化を実現するためには、失敗を想定した防御的設計と、データ管理の構造的な最適化が必要だ。この記事では、1人SaaSを完全無人化するための具体的な活用術と、現場で陥りやすい欠陥を回避する鉄則を解説する。
1. OpenWikiによるドキュメント自動メンテナンス
リポジトリのコードとGit履歴を解析し、AIエージェント用のWikiを自動生成・更新するCLIツールだ。コードの「何であるか」だけでなく、履歴から「なぜ存在するのか」までを補完する。手動更新の負荷をゼロにし、AIエージェントのコンテキスト肥大化を防げる。ただし、別途LLMのAPIキーが必要だ。
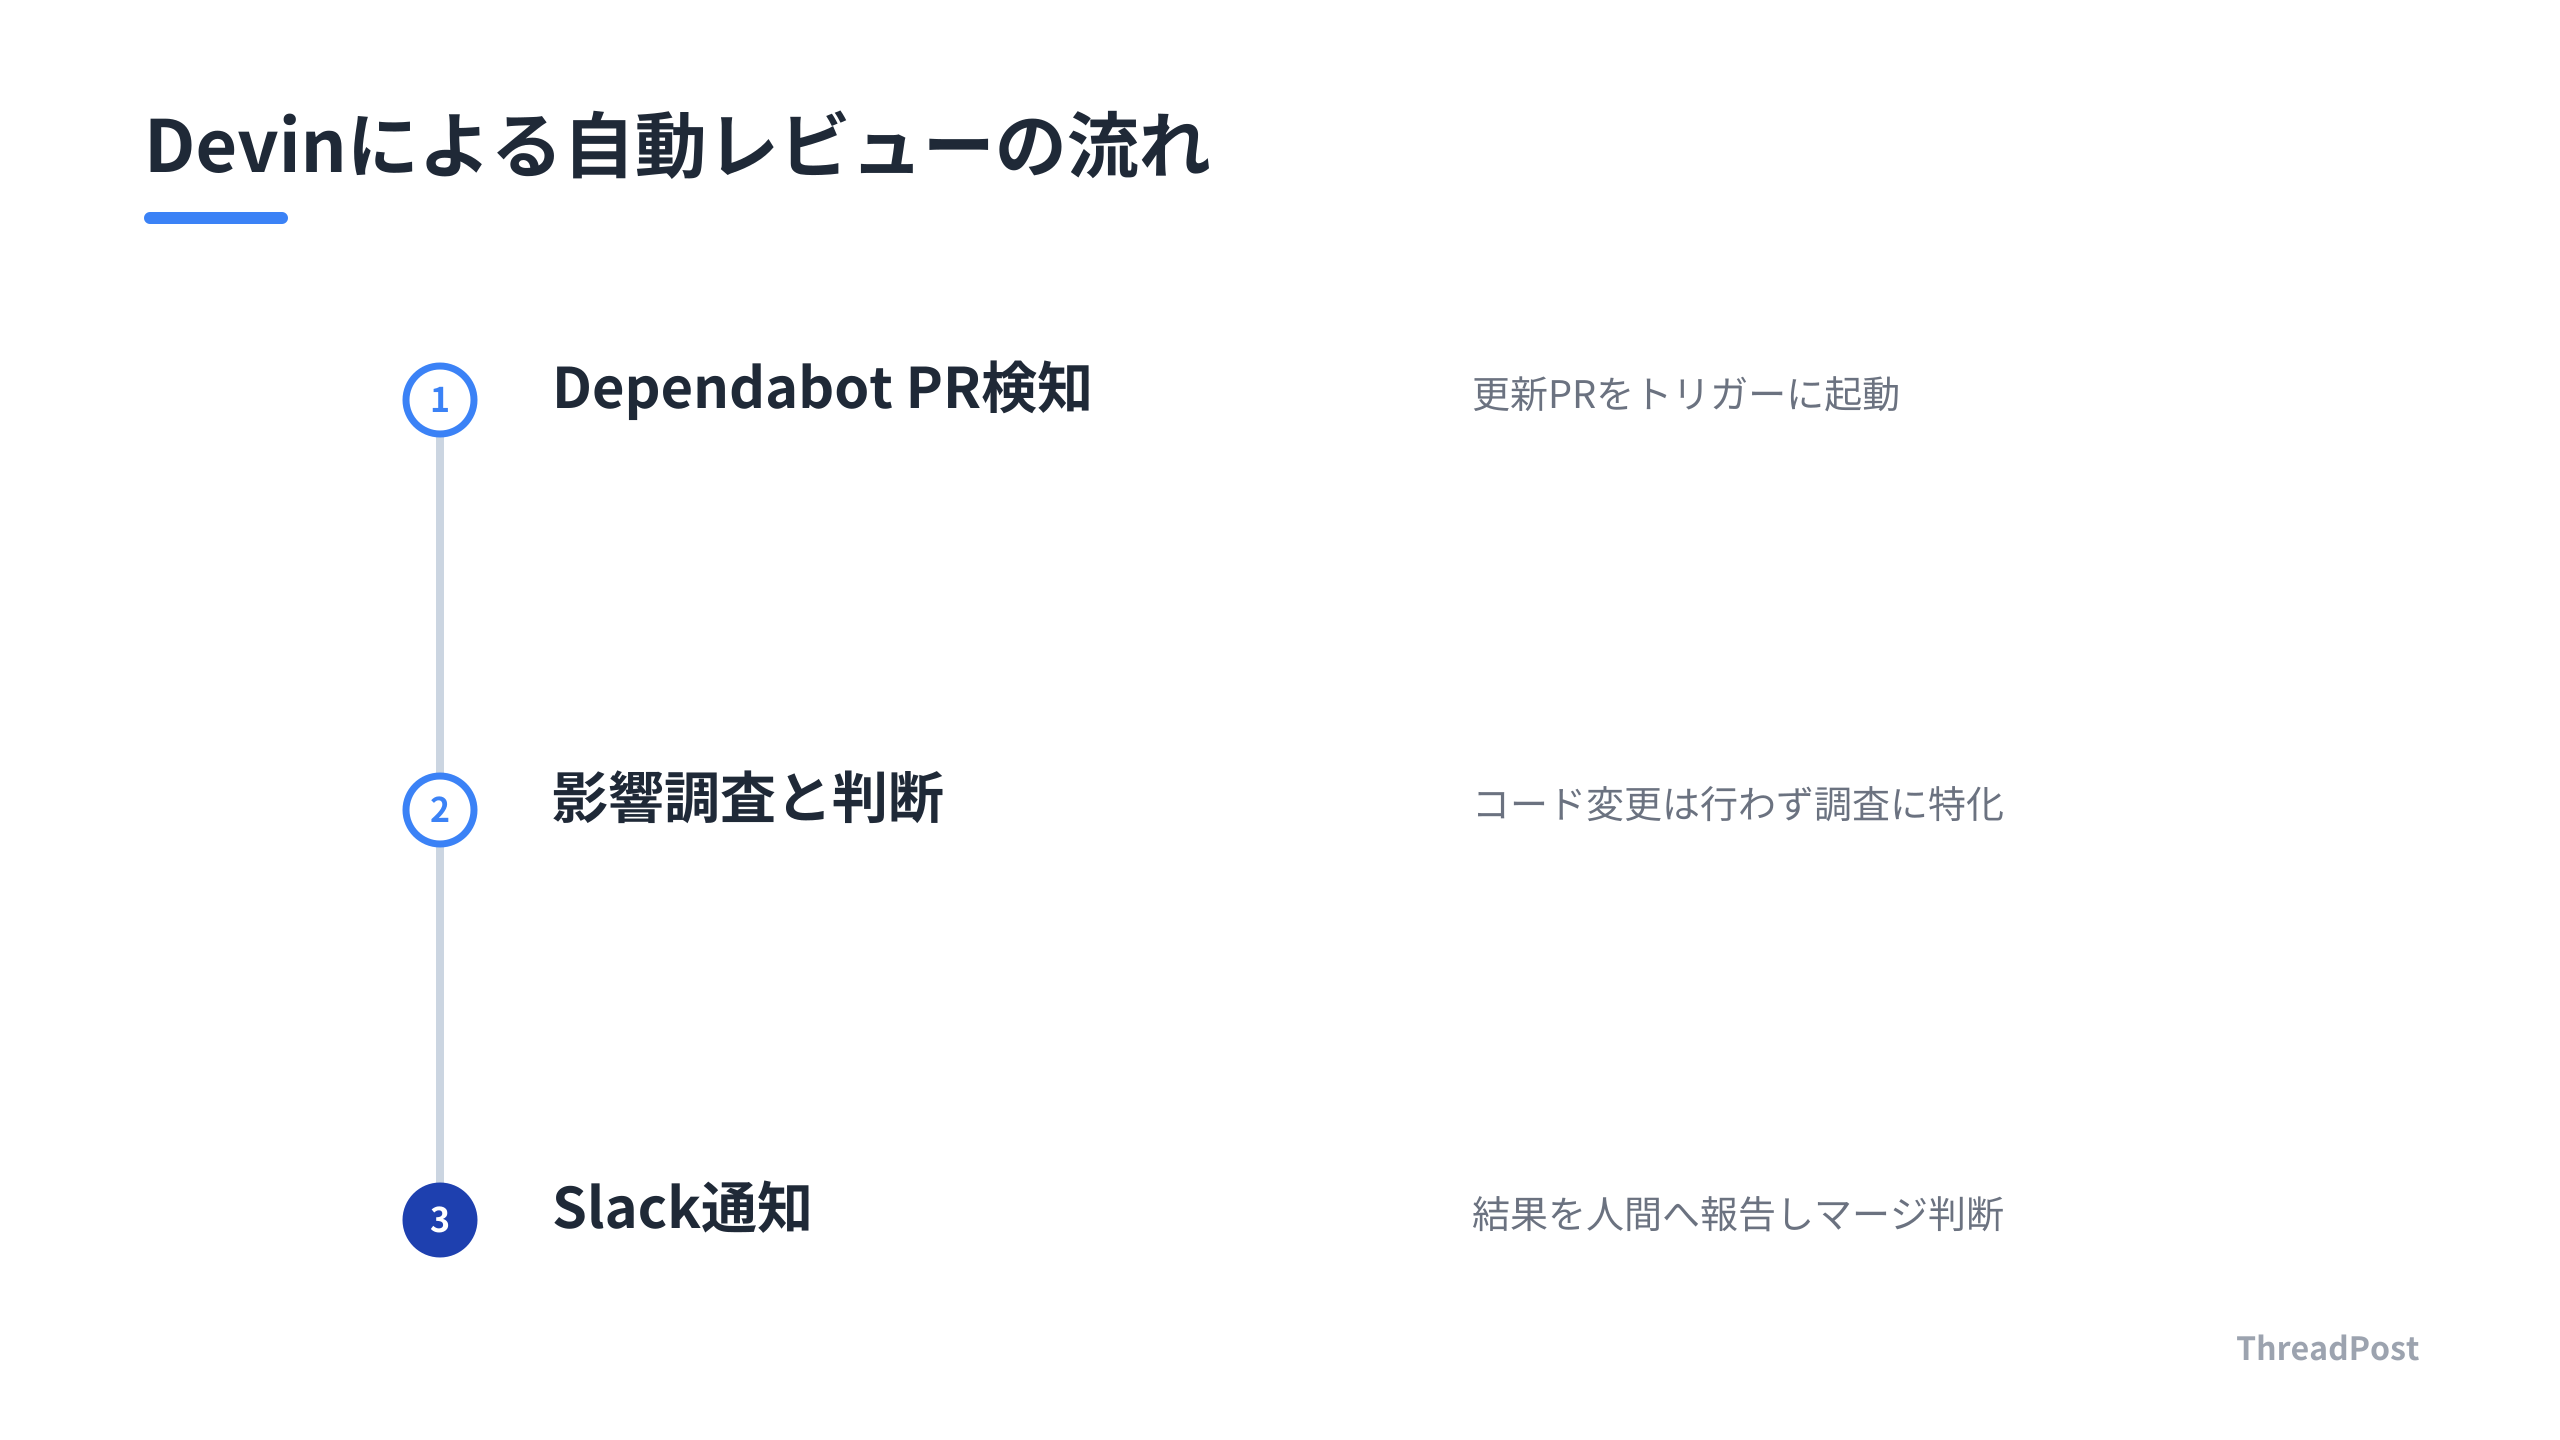
2. Devinを用いたDependabot PRの自動レビューとマージ
Dependabotの更新PRをトリガーにAIエージェントを呼び出し、影響調査からマージ判断、Slack通知までを自動化する。コード変更は行わず、調査と判断に特化させることでリスクを抑制する。パッチ更新のレビュー時間を削減し、破壊的変更の警告も受け取れる。プロンプト設計次第で余計な作業をされるリスクがあるため、権限管理は厳密に行う必要がある。
3. LLMによるブログ記事の無人生成と配信
データベースからデータを取得し、記事生成からデプロイまでを無人で行う仕組みだ。出力の検証ゲートを厳格に設け、怪しい場合は公開しない設計で安定運用を実現する。検証ロジックの設計が難しく、LLMの出力揺れに対するリカバリー処理が必須だ。
4. SNS運用の自己改善ループと構造欠陥の排除
SNS投稿の生成からメトリクス回収までを自動化した運用基盤だ。テストやログが正常でも結果が間違っている事態を防ぐため、データの正規化や賞味期限の設定といった構造的な対策が不可欠だ。学習データや在庫の管理が不適切だと、マンネリ化や古い情報の投稿といった構造的な欠陥に陥る。
5. Fail-soft(失敗してもシステムを壊さない)設計
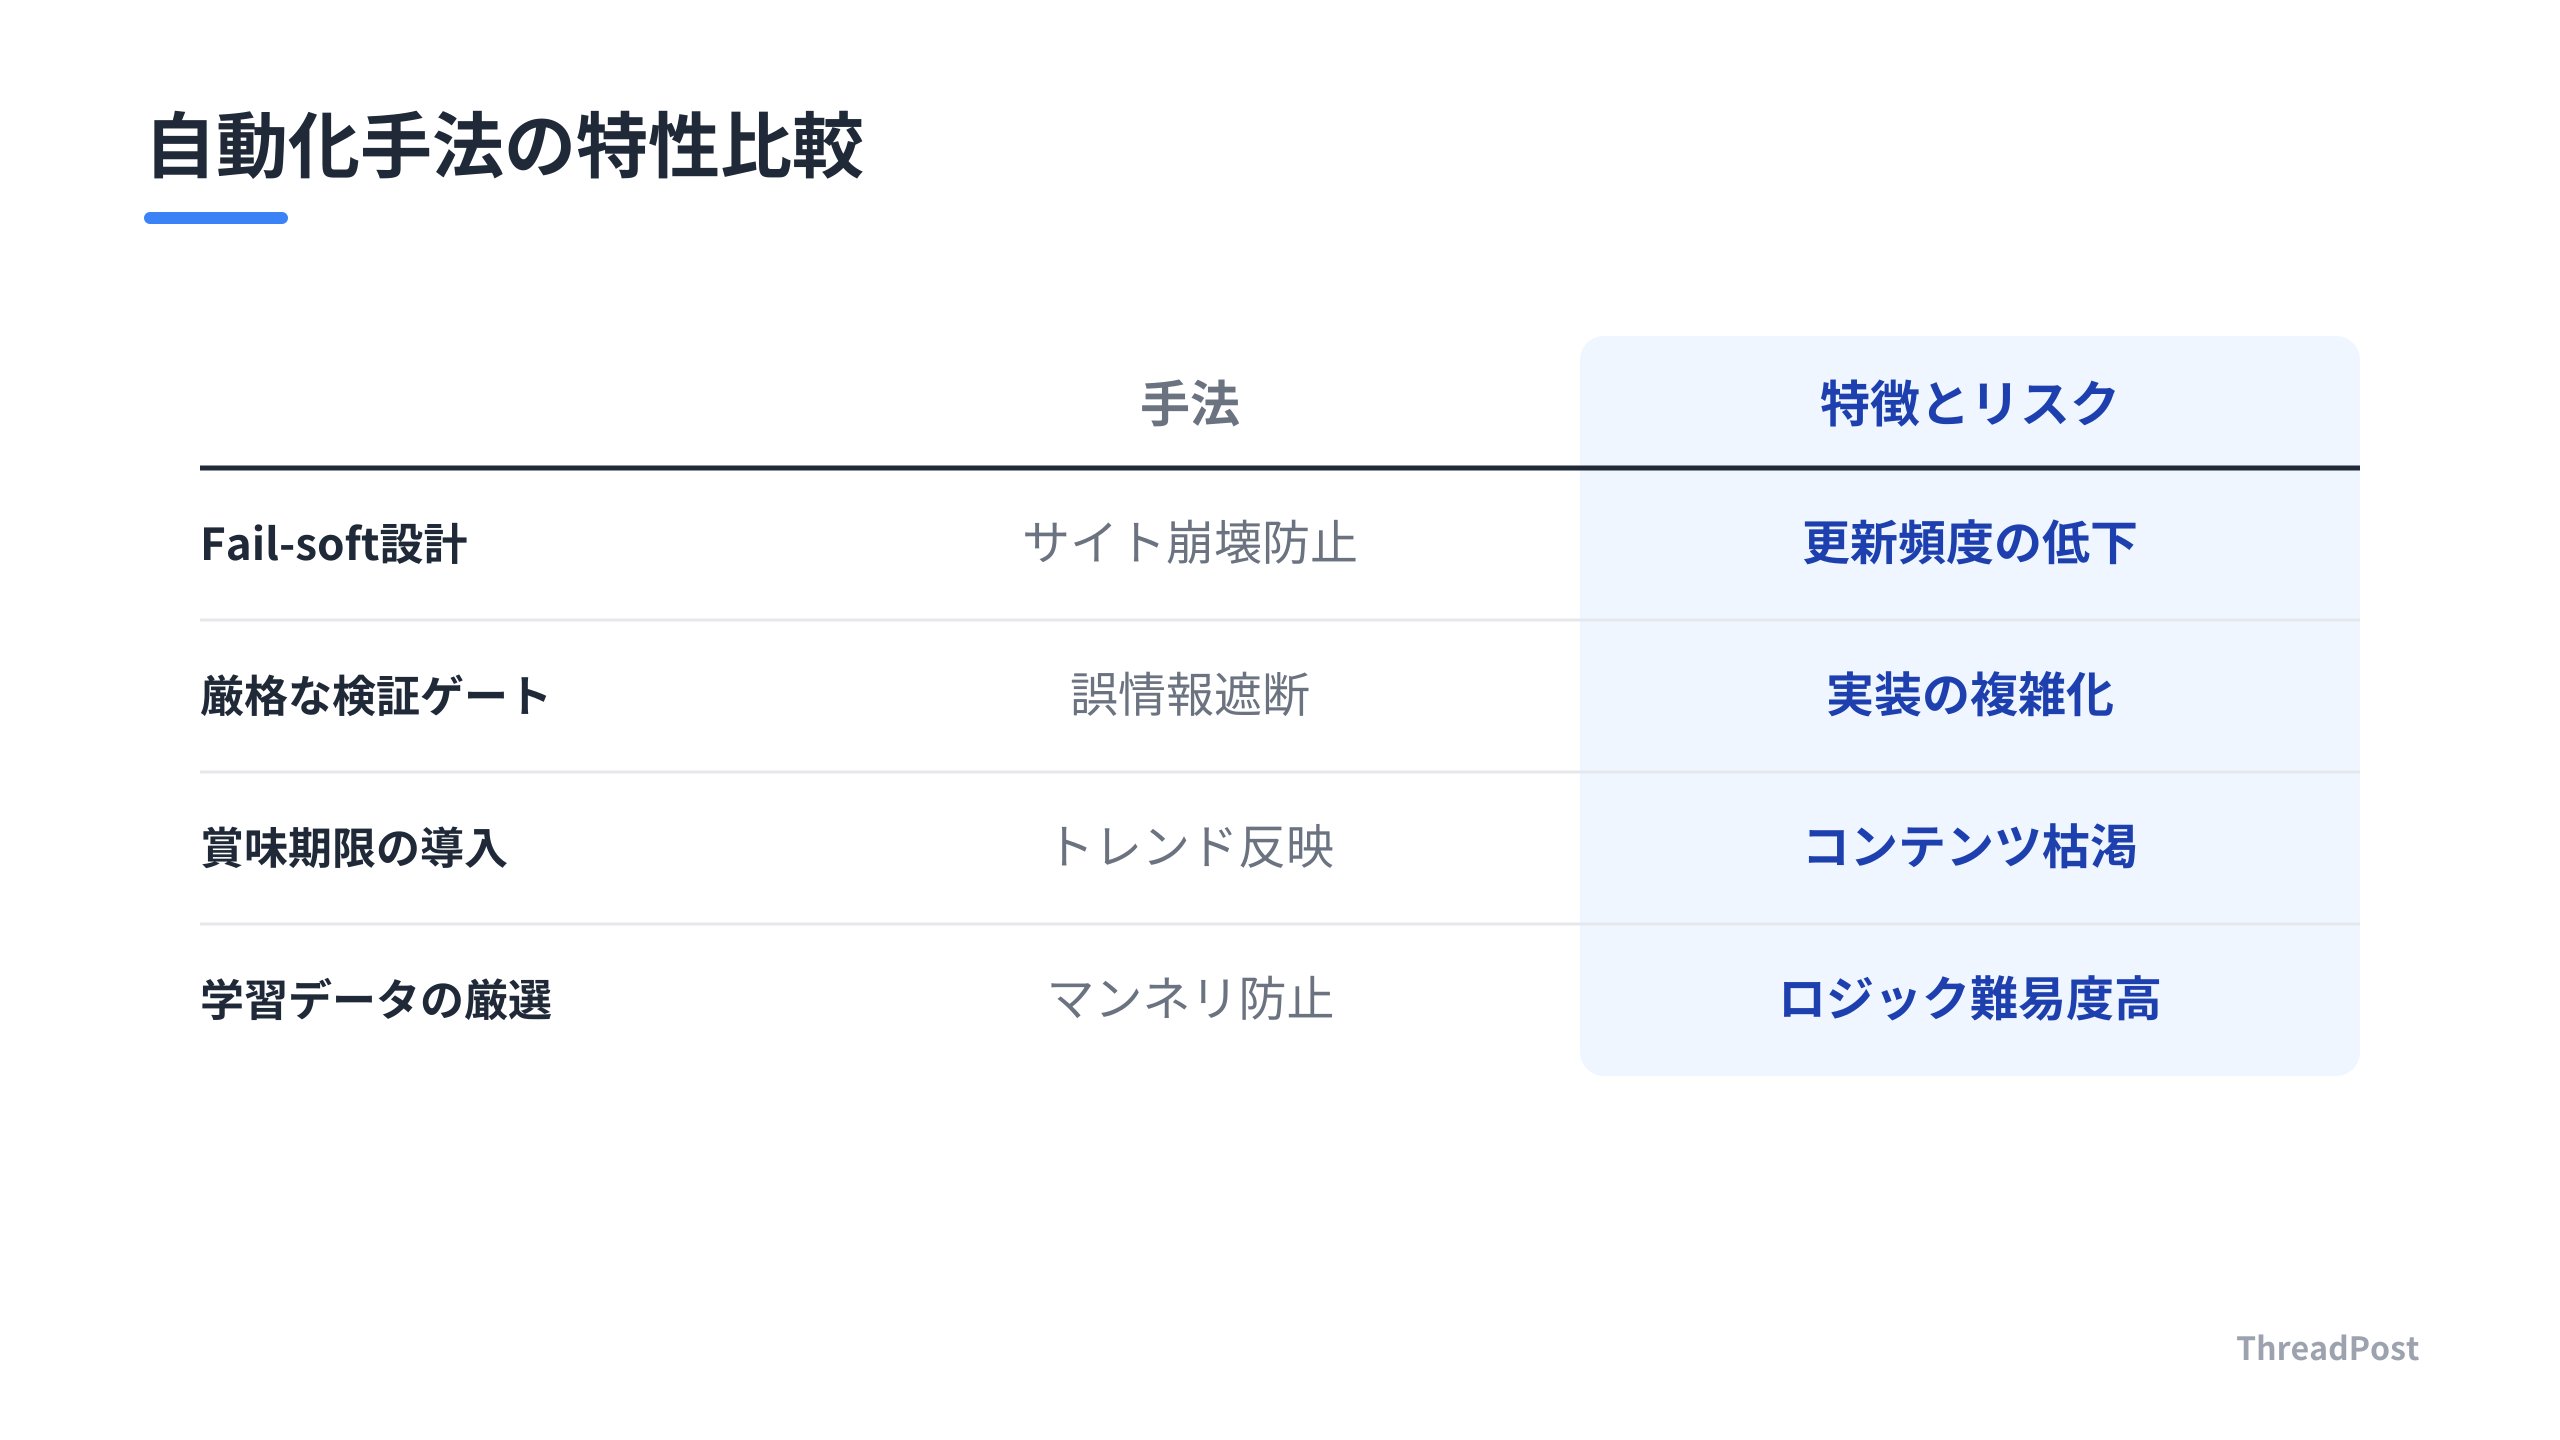
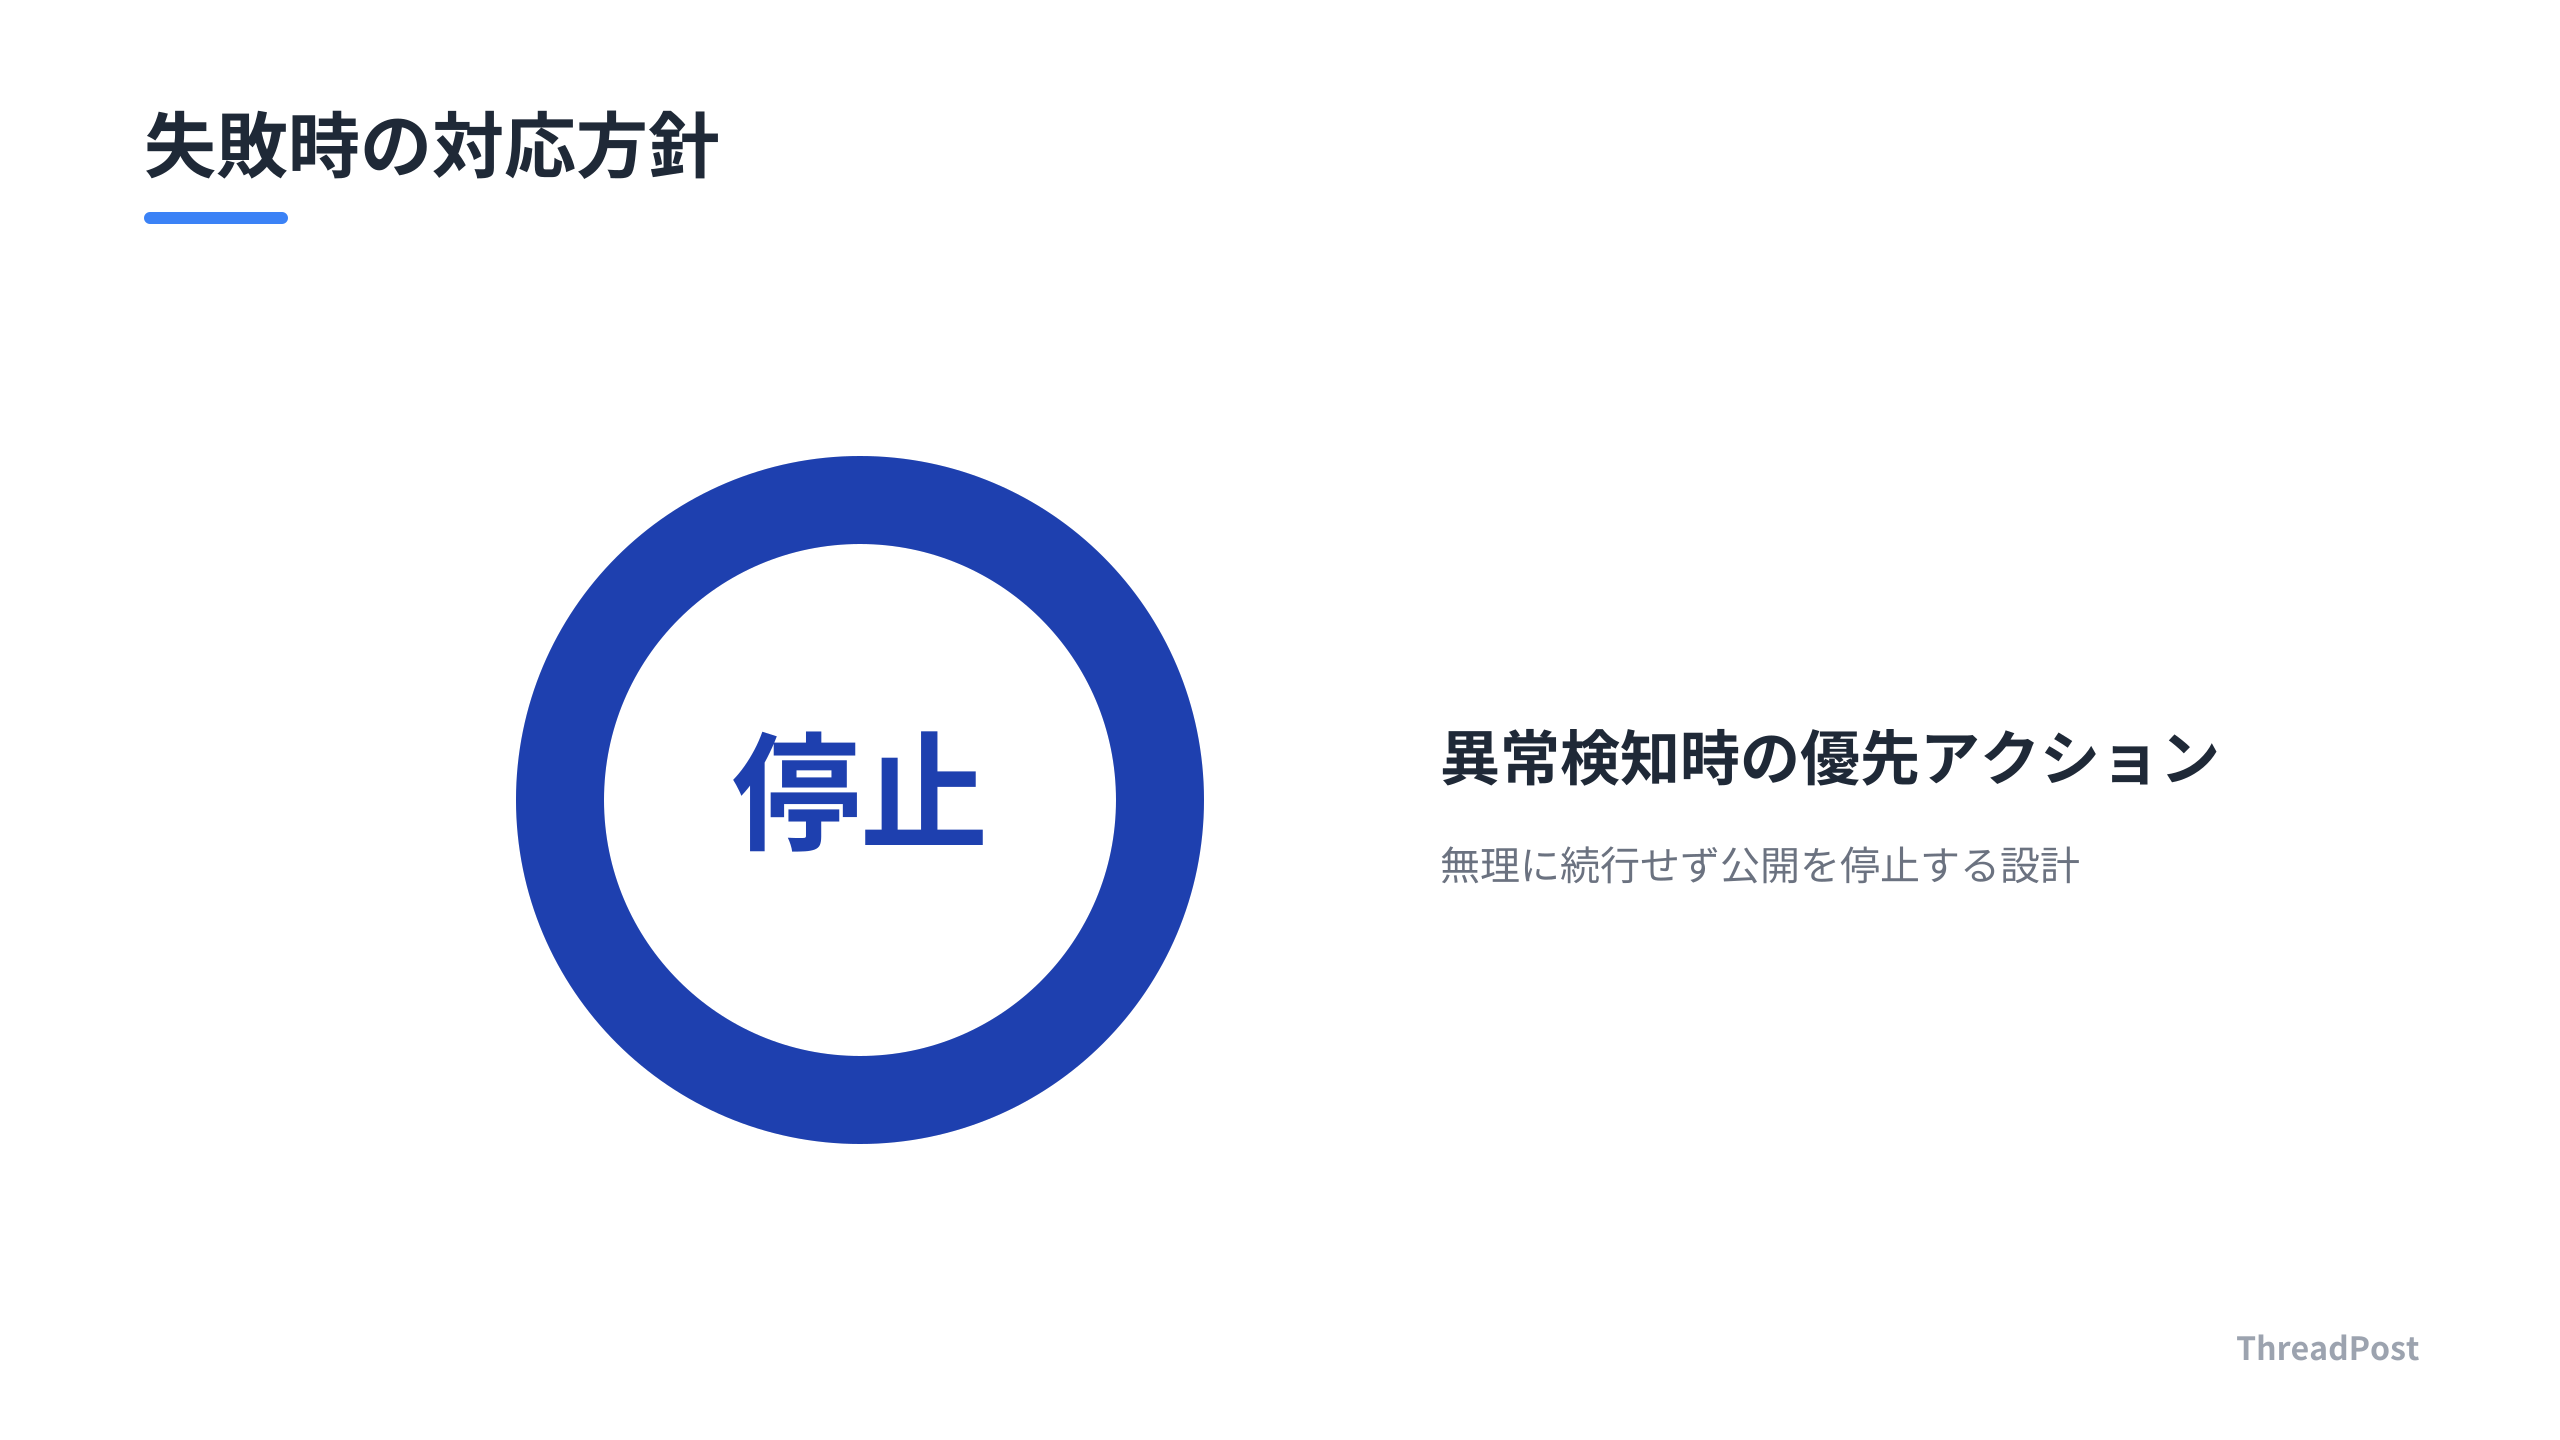
自動化プロセスが失敗した際、無理に続行せず、今日は公開しないという正常終了を選択する設計だ。前日までの成果物を維持することで、システム全体の可用性を担保する。システム障害やLLMの誤出力によるサイト崩壊を防げるが、更新頻度の維持には工夫が必要だ。
6. APIレスポンスの厳格な検証とエラーハンドリング
LLMや外部APIの呼び出しにおいて、ステータスコードやレスポンスの中身を厳格に検証する。曖昧な成功判定を避け、異常時は即座にプロセスを停止させる。予期せぬ挙動による誤ったマージや投稿を防げるが、実装が冗長になり、API側の仕様変更に敏感になる必要がある。
7. 生成と消費の在庫管理と賞味期限の導入
生成したコンテンツをデータベースに蓄積して消費する場合、古い下書きが溜まり続けないよう賞味期限を設定する。生成と公開のタイムラグを最小化し、最新のトレンドを反映させるための必須設定だ。プロンプト改善の成果が即座に反映されやすくなる。
| 手法 | メリット | デメリット |
|---|---|---|
| Fail-soft設計 | サイト崩壊を防げる | 更新頻度が不安定になる |
| 厳格な検証ゲート | 誤った情報を公開しない | 実装が複雑化する |
| 賞味期限の導入 | トレンドを反映できる | コンテンツ枯渇の恐れ |
| 学習データの厳選 | マンネリ化を防止する | ロジック設計が難しい |
しんたろー:
Claude Codeでコードを書く身からすると、自動化の肝は「いかに人間が介入するポイントを減らしつつ、失敗した瞬間に止めるか」にある。特に開発フローの自動化は、完璧を目指すより「おかしいときは何もしない」という勇気が重要だ。
OpenWikiのような最新ツールは非常に興味深い。開発者がドキュメント管理から解放される未来はすぐそこまで来ているはずだ。
FAQ
Q1: AI自動化で最も注意すべきリスクは何か。
A1: 最も大きなリスクは、テストやログは正常なのに出力結果だけが間違っている事態だ。SNS運用で古い投稿を学習し続けたり、ドキュメント生成で誤った情報を生成し続けたりするケースがある。これを防ぐには、出力内容を実測値と照合する検証ゲートを設けることや、データに賞味期限を設けて常に最新の状態を保つ仕組みが不可欠だ。
Q2: AIエージェントにコードの修正を任せても大丈夫か。
A2: 初期段階では推奨しない。まずは調査・コメント・通知のみを任せ、人間が最終的なマージ判断を行うワークフローから始めるのが安全だ。コード修正を任せる場合は、実行範囲を限定し、特定の権限に絞った上で、CI環境での厳格なテストを通過させる前提条件を整える必要がある。
Q3: LLMのAPIコストを抑えるにはどうすればいいか。
A3: ChatGPTのサブスクリプションをAPIキーとして利用できるツールを活用するか、検証ゲートを設けて明らかに失敗している出力を早期に弾くことで無駄なトークン消費を抑えられる。また、プロンプトに注入する学習データ量を最適化し、トークン数を節約することも長期的なコスト削減に繋がる。
Q4: 自動化がマンネリ化してしまう原因は何か。
A4: 過去の失敗パターンをプロンプトに詰め込みすぎると、AIの探索空間が狭まり、出力が画一化してマンネリ化する。対策として、学習データはサンプル数が十分なものだけに絞り込み、上限件数を設けて注入する情報を厳選する。また、定期的に学習データをリセットまたは正規化するプロセスを組み込むことが有効だ。
Q5: Fail-softな設計とは具体的にどういうことか。
A5: システムがエラーに直面した際、無理に処理を完遂させようとせず、今日は公開しない、あるいは今回はスキップするという安全な停止を選択することだ。これにより、システム全体が壊れるのを防ぎ、前日までの正常な状態を維持できる。自動化においては止まることを恐れず、誤った情報を公開しないことを優先する設計が重要だ。
自動化の成功は、高度なアルゴリズムの実装よりも、いかに堅牢な失敗回避策を組み込めるかで決まる。まずは小規模なタスクから自動化を始め、徐々に範囲を広げていくのが賢明だ。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
