


AI開発の現場で「生成」と「理解」の統合が進んでいる。Pollo AIが実践するモデルルーティングは、単なるツールの進化ではない。開発者がモデルを「APIの叩き先」から「推論・評価・データ生成を自己完結させるエンジン」へと再定義するタイミングだ。Claude Codeで1人SaaSを回す僕の視点から、この「AIの統合的知能」が開発ワークフローをどう書き換えるのか、その核心を解説する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
生成モデルが視覚を理解する時代へ
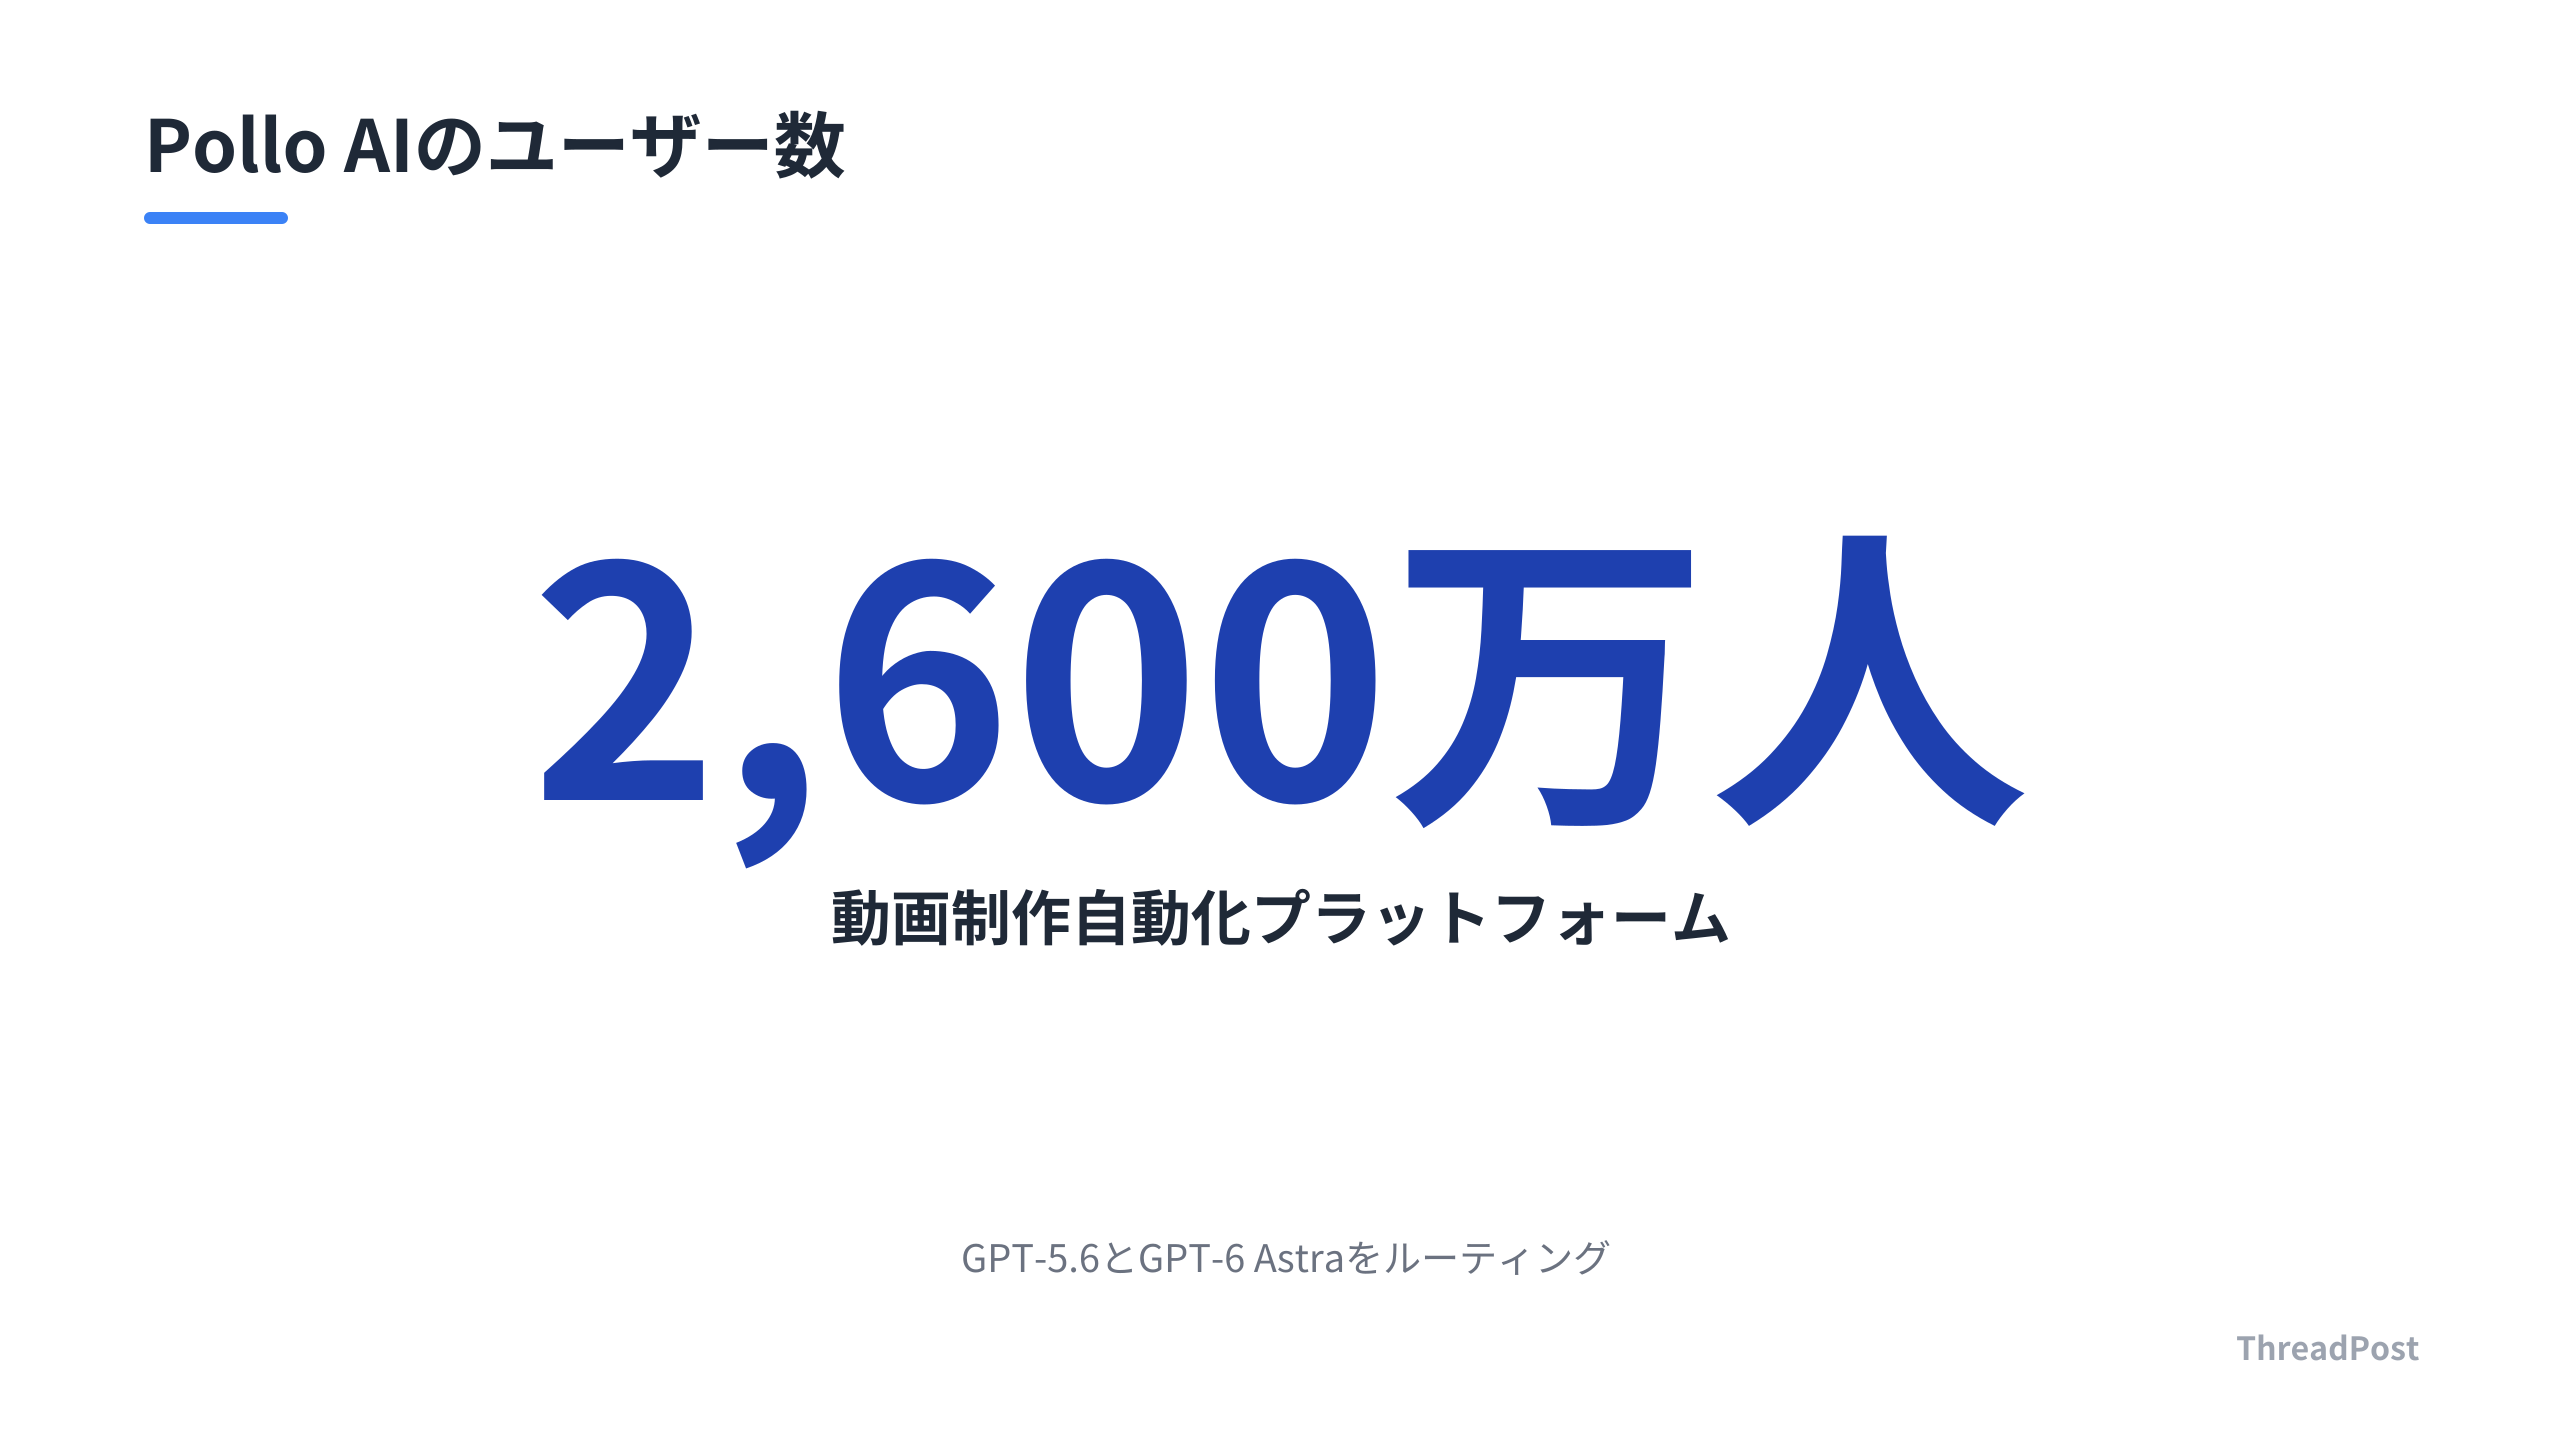
AI業界では動画制作の自動化プラットフォームであるPollo AIが躍進している。同社は2,600万人を超えるユーザーを抱え、GPT-5.6とGPT-6 Astraという複数のモデルをタスクに応じて使い分ける「モデルルーティング」を実装している。
このシステムは、単純な意図の解釈には軽量なモデルを、複雑な物語構成や修正には高性能なモデルを割り当てる。これにより、コストと精度のバランスを最適化している。
Pollo AIのルーティング戦略は、モデルの推論能力をタスクの難易度に合わせて動的に割り当てるアーキテクチャの先駆けだ。開発者が「外部の学習データ」や「専用モデル」に依存しなくても、高性能なAIシステムを自律的に構築できる環境が整いつつある。
しんたろー:
モデルが「何を知っているか」を引き出す勝負になっている。APIを叩いて結果を待つだけのコードは、数ヶ月後には見直す必要がありそうだ。Claude Codeで自動リファクタリングを回していても、モデルが自分の書いたコードを「理解」してテストまで完結させる未来が気になる。
今、開発者に求められているのは、これらの生成モデルを単なるツールとしてではなく、推論・評価・データ生成を自己完結させるエンジンとしてどう組み込むかという視点だ。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
生成モデルを「推論エンジン」として使い倒す設計思想
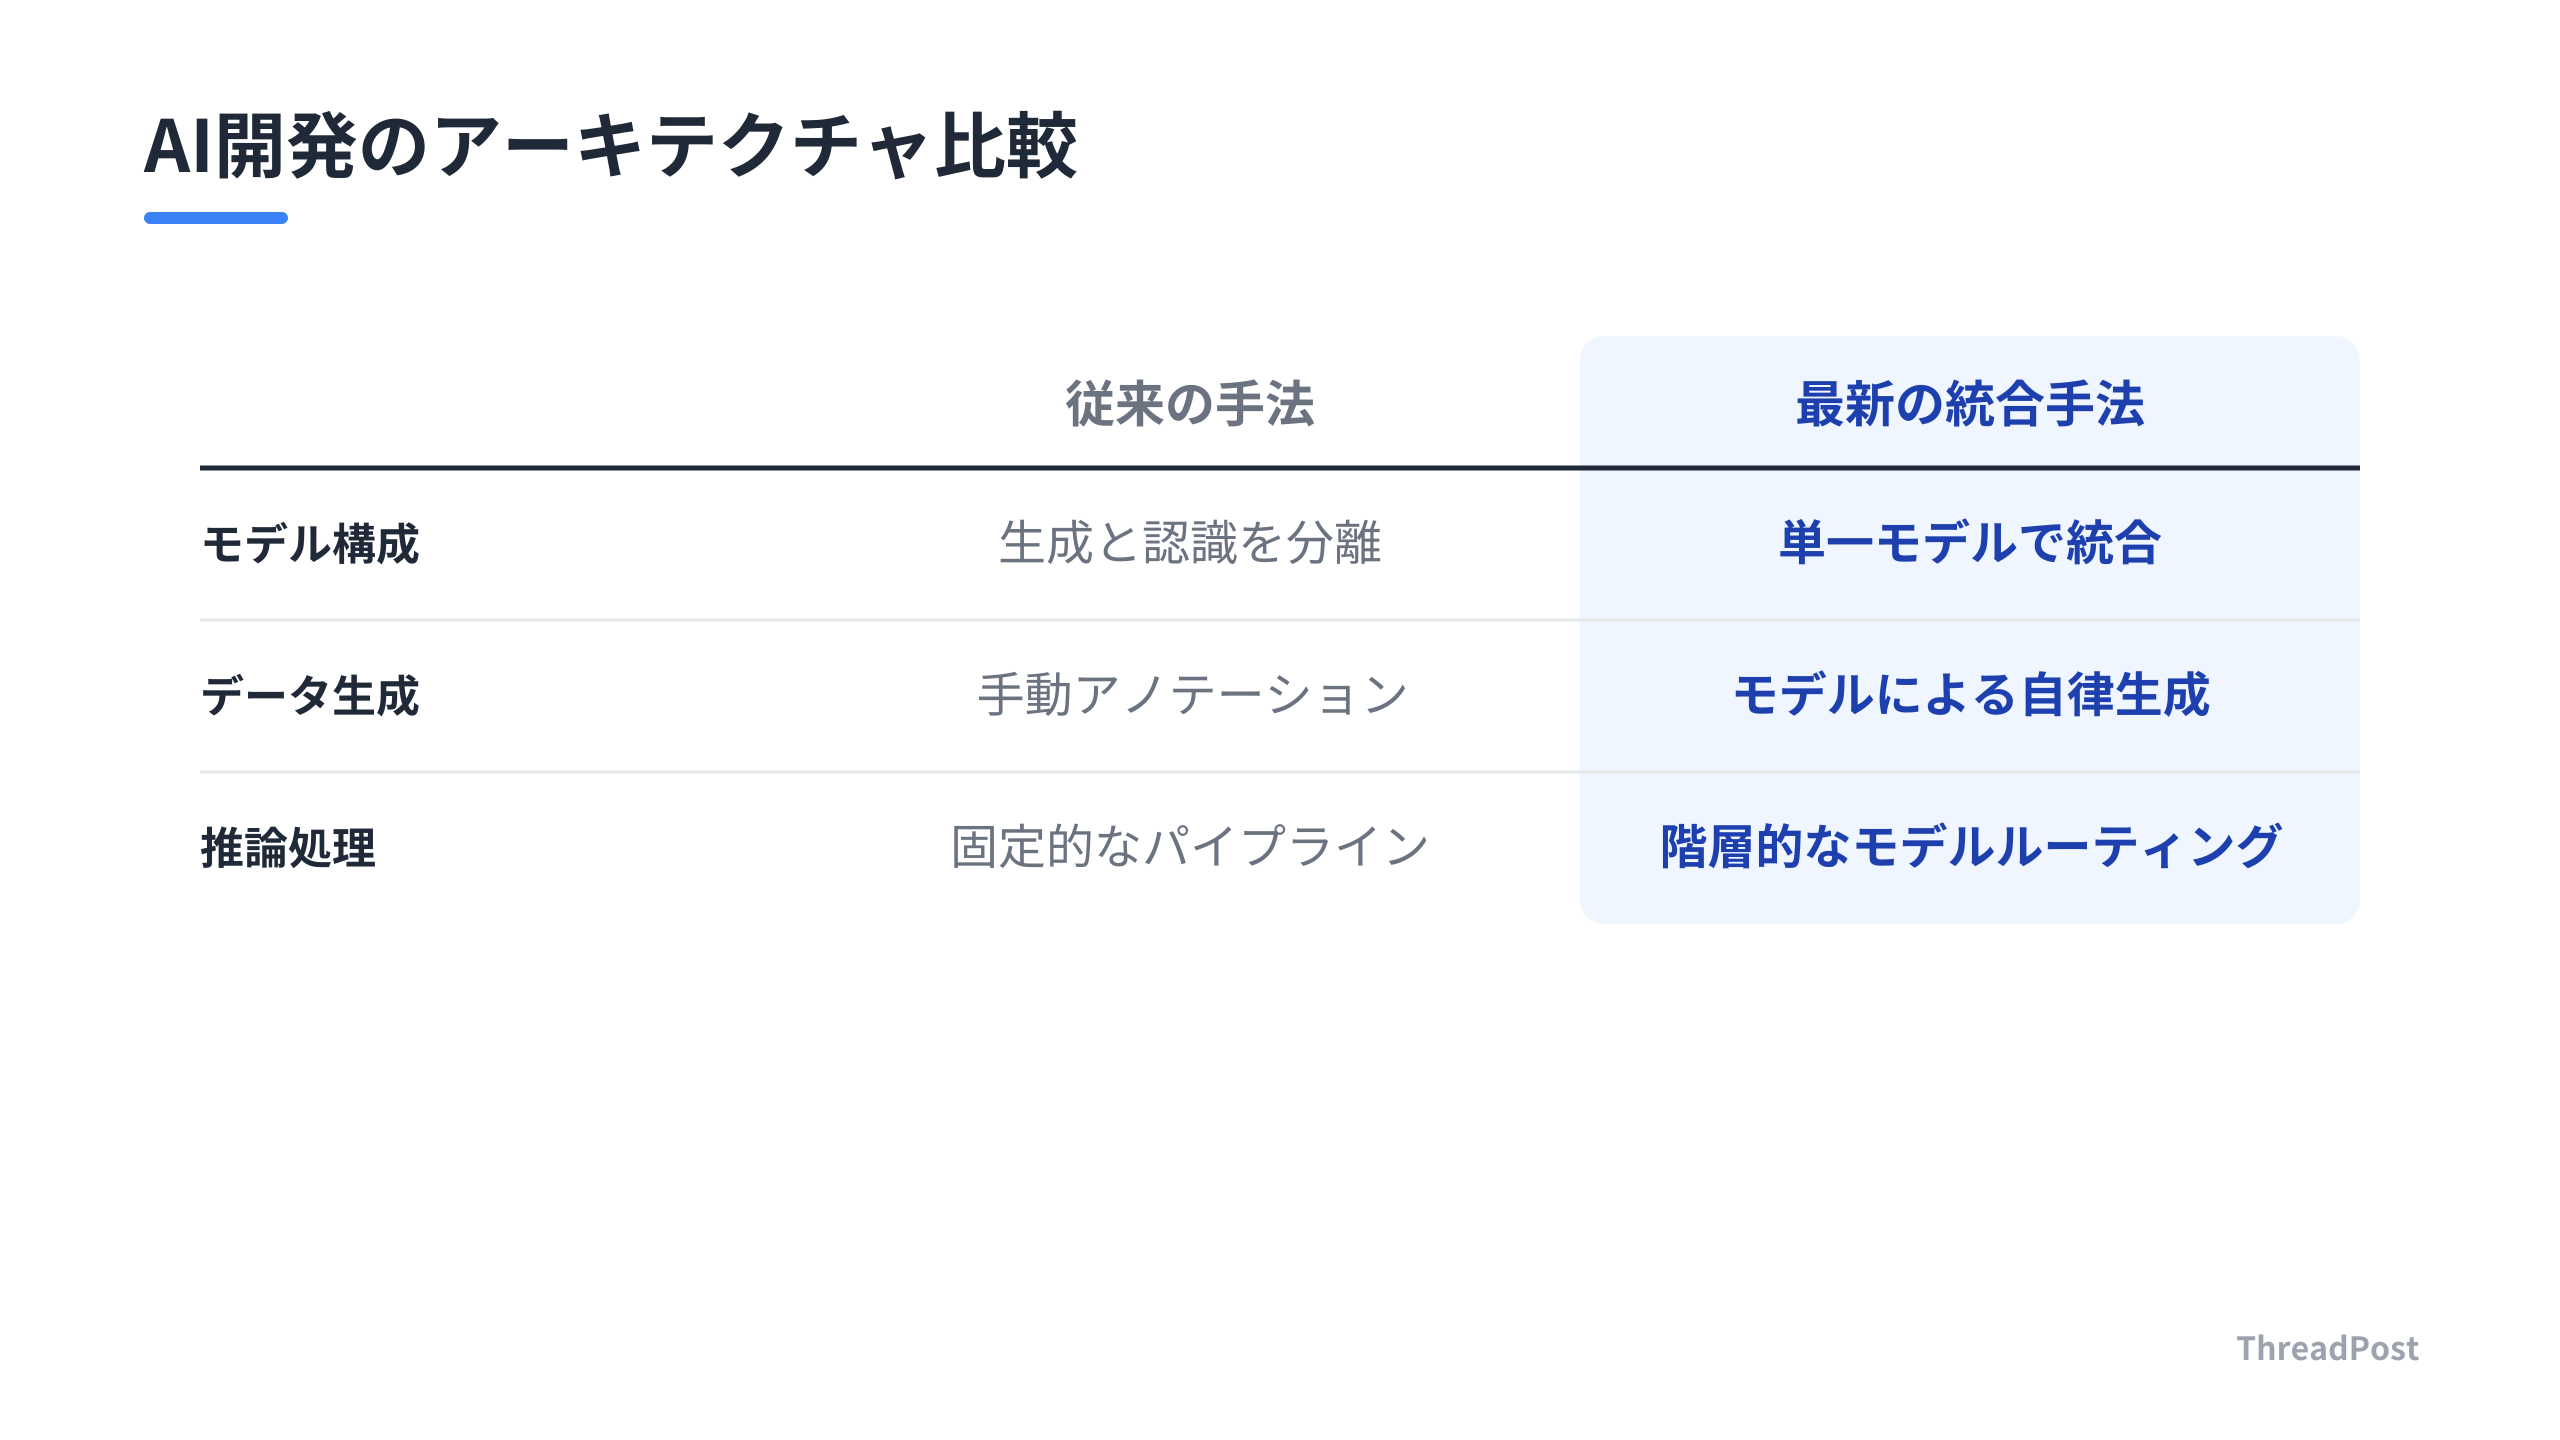
今回の技術動向で注目すべきは、AIが「生成」と「理解」という二つの異なるタスクを、一つのモデル内で統合し始めている点だ。これまで認識精度のために複数のモデルを微調整してデプロイする手間が発生していた。
Pollo AIが実践しているモデルルーティングの戦略は、実務におけるコストと精度の最適解を提示している。すべてのタスクに最強のモデルをぶつけるのは、非効率だ。
タスクの複雑さに応じて、軽量なモデルで意図を分類し、難易度の高い推論が必要な時だけ上位モデルを呼び出す。この「階層的推論パイプライン」の実装は、SaaS開発においてAPIコストを抑えつつ、ユーザー体験を維持するための生命線になる。
Claude Codeでコードを書いていると、「どこまでモデルに判断させるか」の境界線が悩ましい。全部丸投げするとコストが爆発するし、細かく切り分けすぎるとロジックが複雑化する。このルーティング設計は、自分のプロダクトにも組み込んでおきたい。
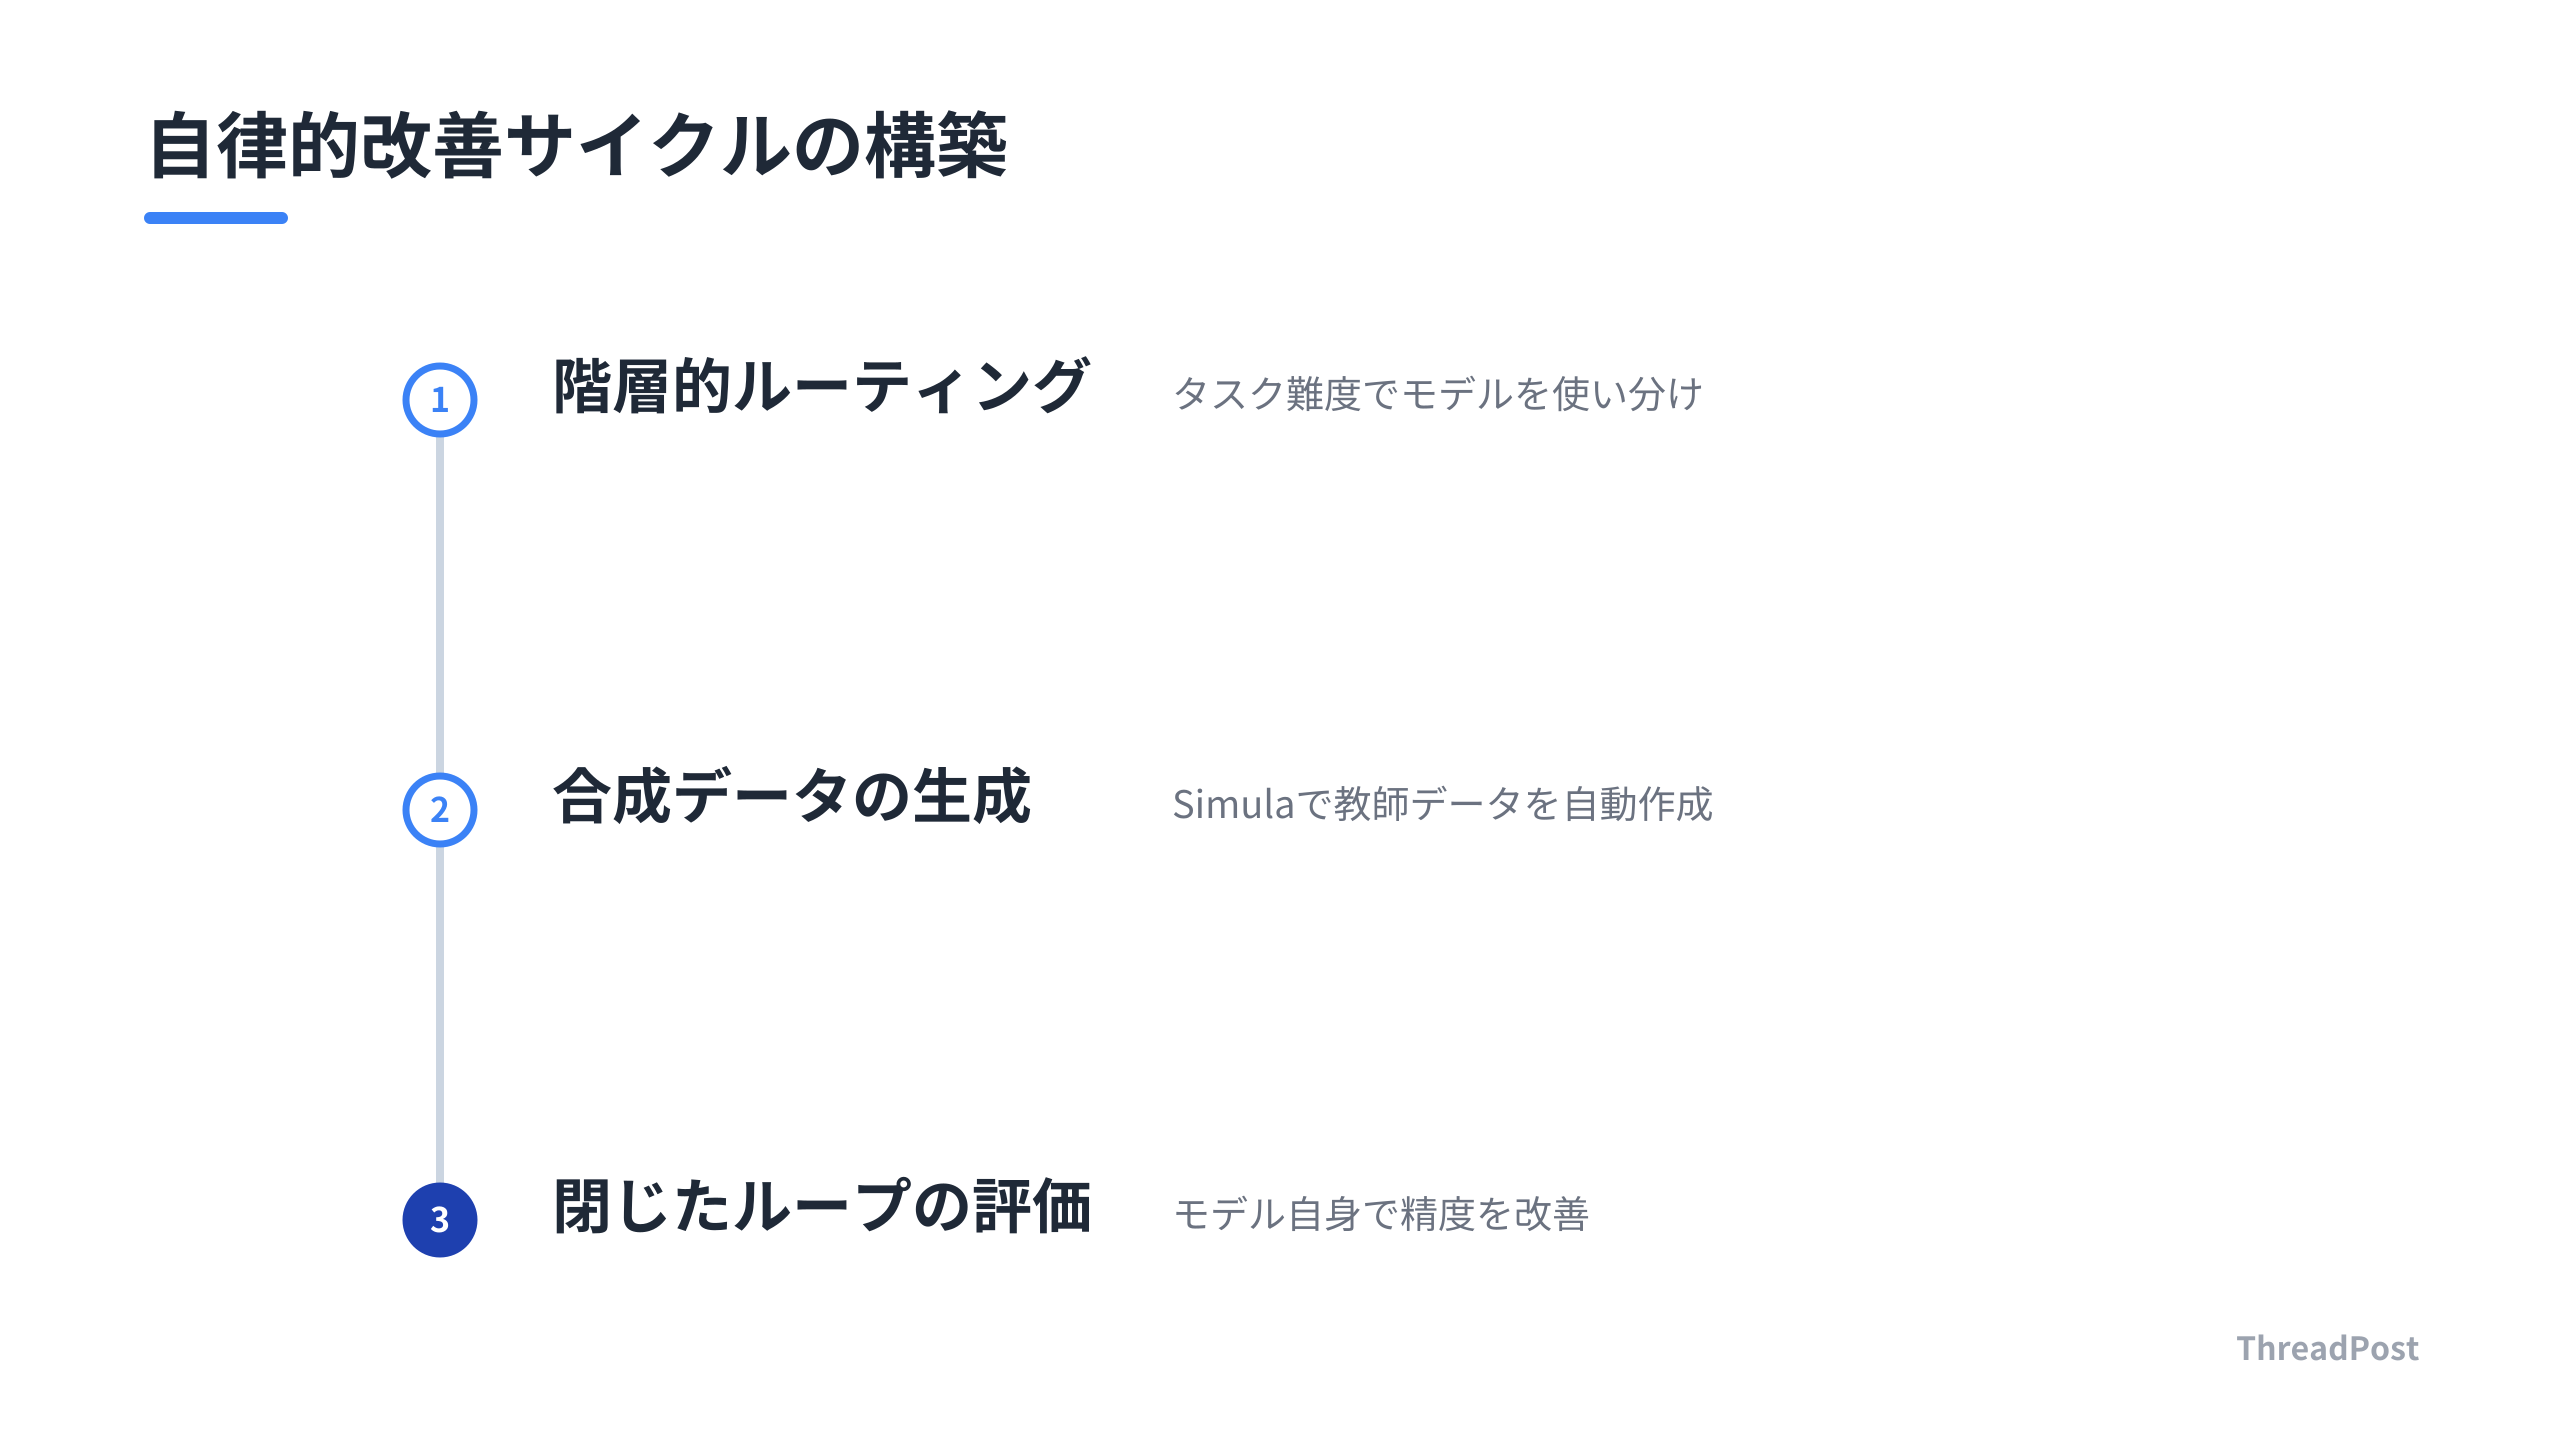
開発者が自らデータを集めるのではなく、モデル自身に「どんなデータが必要か」を考えさせ、そのデータを生成させ、さらにモデル自身に評価させるという閉じたループを構築できる。
僕たちが今やるべきことは、生成モデルをAPIとして呼び出すだけの「利用者」から、モデルの推論・評価能力をプロダクトのアーキテクチャに埋め込む「システム設計者」へと視点を切り替えることだ。Pollo AIが示したようなモデルの使い分けを組み合わせれば、一人で開発しているSaaSであっても、高度な推論をバックエンドで回すことが可能になる。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
実務レベルで明日から変えるべきワークフロー
生成モデルが「推論と評価を自律的に行うエンジン」に変わったことで、開発現場における優先順位も変わる。今すぐやるべきは、AIを「呼び出す」という発想を捨て、AIに「評価とデータ生成を任せる」アーキテクチャへのシフトだ。
モデルの使い分け(ルーティング)を実装レベルに落とし込む。全てのタスクに最高性能のモデルを叩き込むのは、コスト的にも速度的にも悪手だ。Pollo AIが実践するように、軽量なモデルで入力の意図を分類し、推論の深さが必要な場合だけ高性能なモデルへ流す。
この「階層的推論パイプライン」をAPIのラッパーとして構築しておくだけで、プロダクトの運用コストは最適化される。
API代の請求書を見て真っ青になるのは自分だ。全部「最新モデル」で処理する贅沢は卒業して、賢くルーティングするロジックをコードに書き込む。これをClaude Codeに「いい感じに分類して」と投げたら、一瞬でスクリプトを書いてくれる。
最後に、これら全てを「閉じたループ」にする。生成したデータでモデルを微調整し、そのモデルでさらに高度な評価を行い、精度を上げる。このサイクルをプロダクトのバックエンドに組み込めば、ユーザーが増えるほど、あるいは稼働時間が長いほど、システムが勝手に賢くなっていく仕組みが作れる。
明日から意識してほしいのは、AIを「ツール」として使うのではなく、自分のプロダクトの中に「推論エンジン」として埋め込むという視点だ。コードを書くとき、APIを叩くとき、「これは本当に人間が判断すべきことか?モデル自身に評価・生成させることはできないか?」と自問自答する。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
Pollo AIのように複数のモデルを使い分けるルーティングは、どう実装すべきか?
タスクの複雑さに応じてモデルを切り替える「階層的推論パイプライン」を構築する。まず軽量なモデルでタスクの意図を分類し、推論コストが必要な場合のみ高性能なモデルへルーティングするように実装する。これにより、処理速度と精度のバランスを最適化できる。
合成データ生成は、小規模な開発チームでも導入可能か?
小規模なチームほど恩恵を受ける。手動でのデータ収集やアノテーションという、コストのかかる工程をLLMの推論能力で代替する仕組みだからだ。ニッチなドメインで学習データが不足している場合、この手法を導入することで、高品質なデータをスケーラブルに生成し、モデル精度を底上げすることが可能だ。
開発者がモデルルーティングを導入するメリットは何か?
APIコストの削減と推論精度の両立だ。すべてのタスクに高性能なモデルを割り当てる必要はない。タスクの難易度に応じてモデルを使い分けることで、運用コストを抑えつつ、複雑な推論が必要な場面では高いパフォーマンスを維持できる。
まとめ
AIは「何かを作る」だけのツールから、自ら状況を「理解し、評価し、改善する」自律的なシステムへと進化している。開発者がやるべきは、モデルを単なるAPIの呼び出し先として終わらせず、推論エンジンとしてワークフローの深部まで組み込むことだ。
AIの可能性を最大限に引き出し、開発の現場をどう進化させるか。最新の技術動向をさらに深掘りしていく。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策
