


AIエージェントの品質管理は「数値による計測」と「構造的な役割分担」を組み合わせるのが正解だ。まずはツールでコストと速度を測り、次に検証役のエージェントを導入して論理的な欠陥を潰す。この2段構えが最も失敗しにくい。
AI開発において「テストは全部通っているのに本番で壊れる」という事態は珍しくない。テストコードを書いた本人が想像できる範囲しかカバーできないからだ。AIエージェントの品質を担保するためには、従来のソフトウェアテストに加え、AI自身を検証者として活用する仕組みが不可欠になる。
この記事では、AIエージェントの実務的な品質管理手法を徹底的に比較する。今日から取り入れられる手法を網羅したため、自分の開発体制に合わせた改善ポイントを見つけるといい。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
promptfoo|コストとレイテンシを可視化する
promptfooはNode.js製で、設定ファイルベースの評価ツールだ。プロンプトやコンテキストのバリアントを横並びで比較するのに適している。キャッシュ機能を備えており、再実行時のコストを抑えつつ、高速なパフォーマンスチューニングが可能だ。
このツールの最大の強みは、コストとレイテンシが評価項目として一級市民である点だ。結果テーブルにはテストごとのコストとレイテンシが明示されるため、修正の前後でどれだけ効率が改善したかを数字で追える。
低摩擦で導入できるため、まずはこのツールでパフォーマンスの土台を固めるのが賢いやり方だ。ただし、評価実行そのものにもトークン課金が発生する点は注意が必要だ。キャッシュを賢く使い、テスト数とモデルを意識して運用する。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
DeepEval|CI/CDに統合する品質テスト
DeepEvalはPythonベースのテストフレームワークで、既存のテスト環境とシームレスに連携できる。LLMTestCaseを用いた詳細な品質評価が得意であり、CI/CD環境への組み込みに適している。
Pythonのテスト資産が既に存在する場合、DeepEvalの導入は非常にスムーズだ。品質の作り込みが必要なフェーズでは、このツールの採用を推奨する。既存のテストコードとLLMの評価を組み合わせることで、より堅牢な開発パイプラインを構築できる。
マルチエージェント検証|番犬による論理チェック
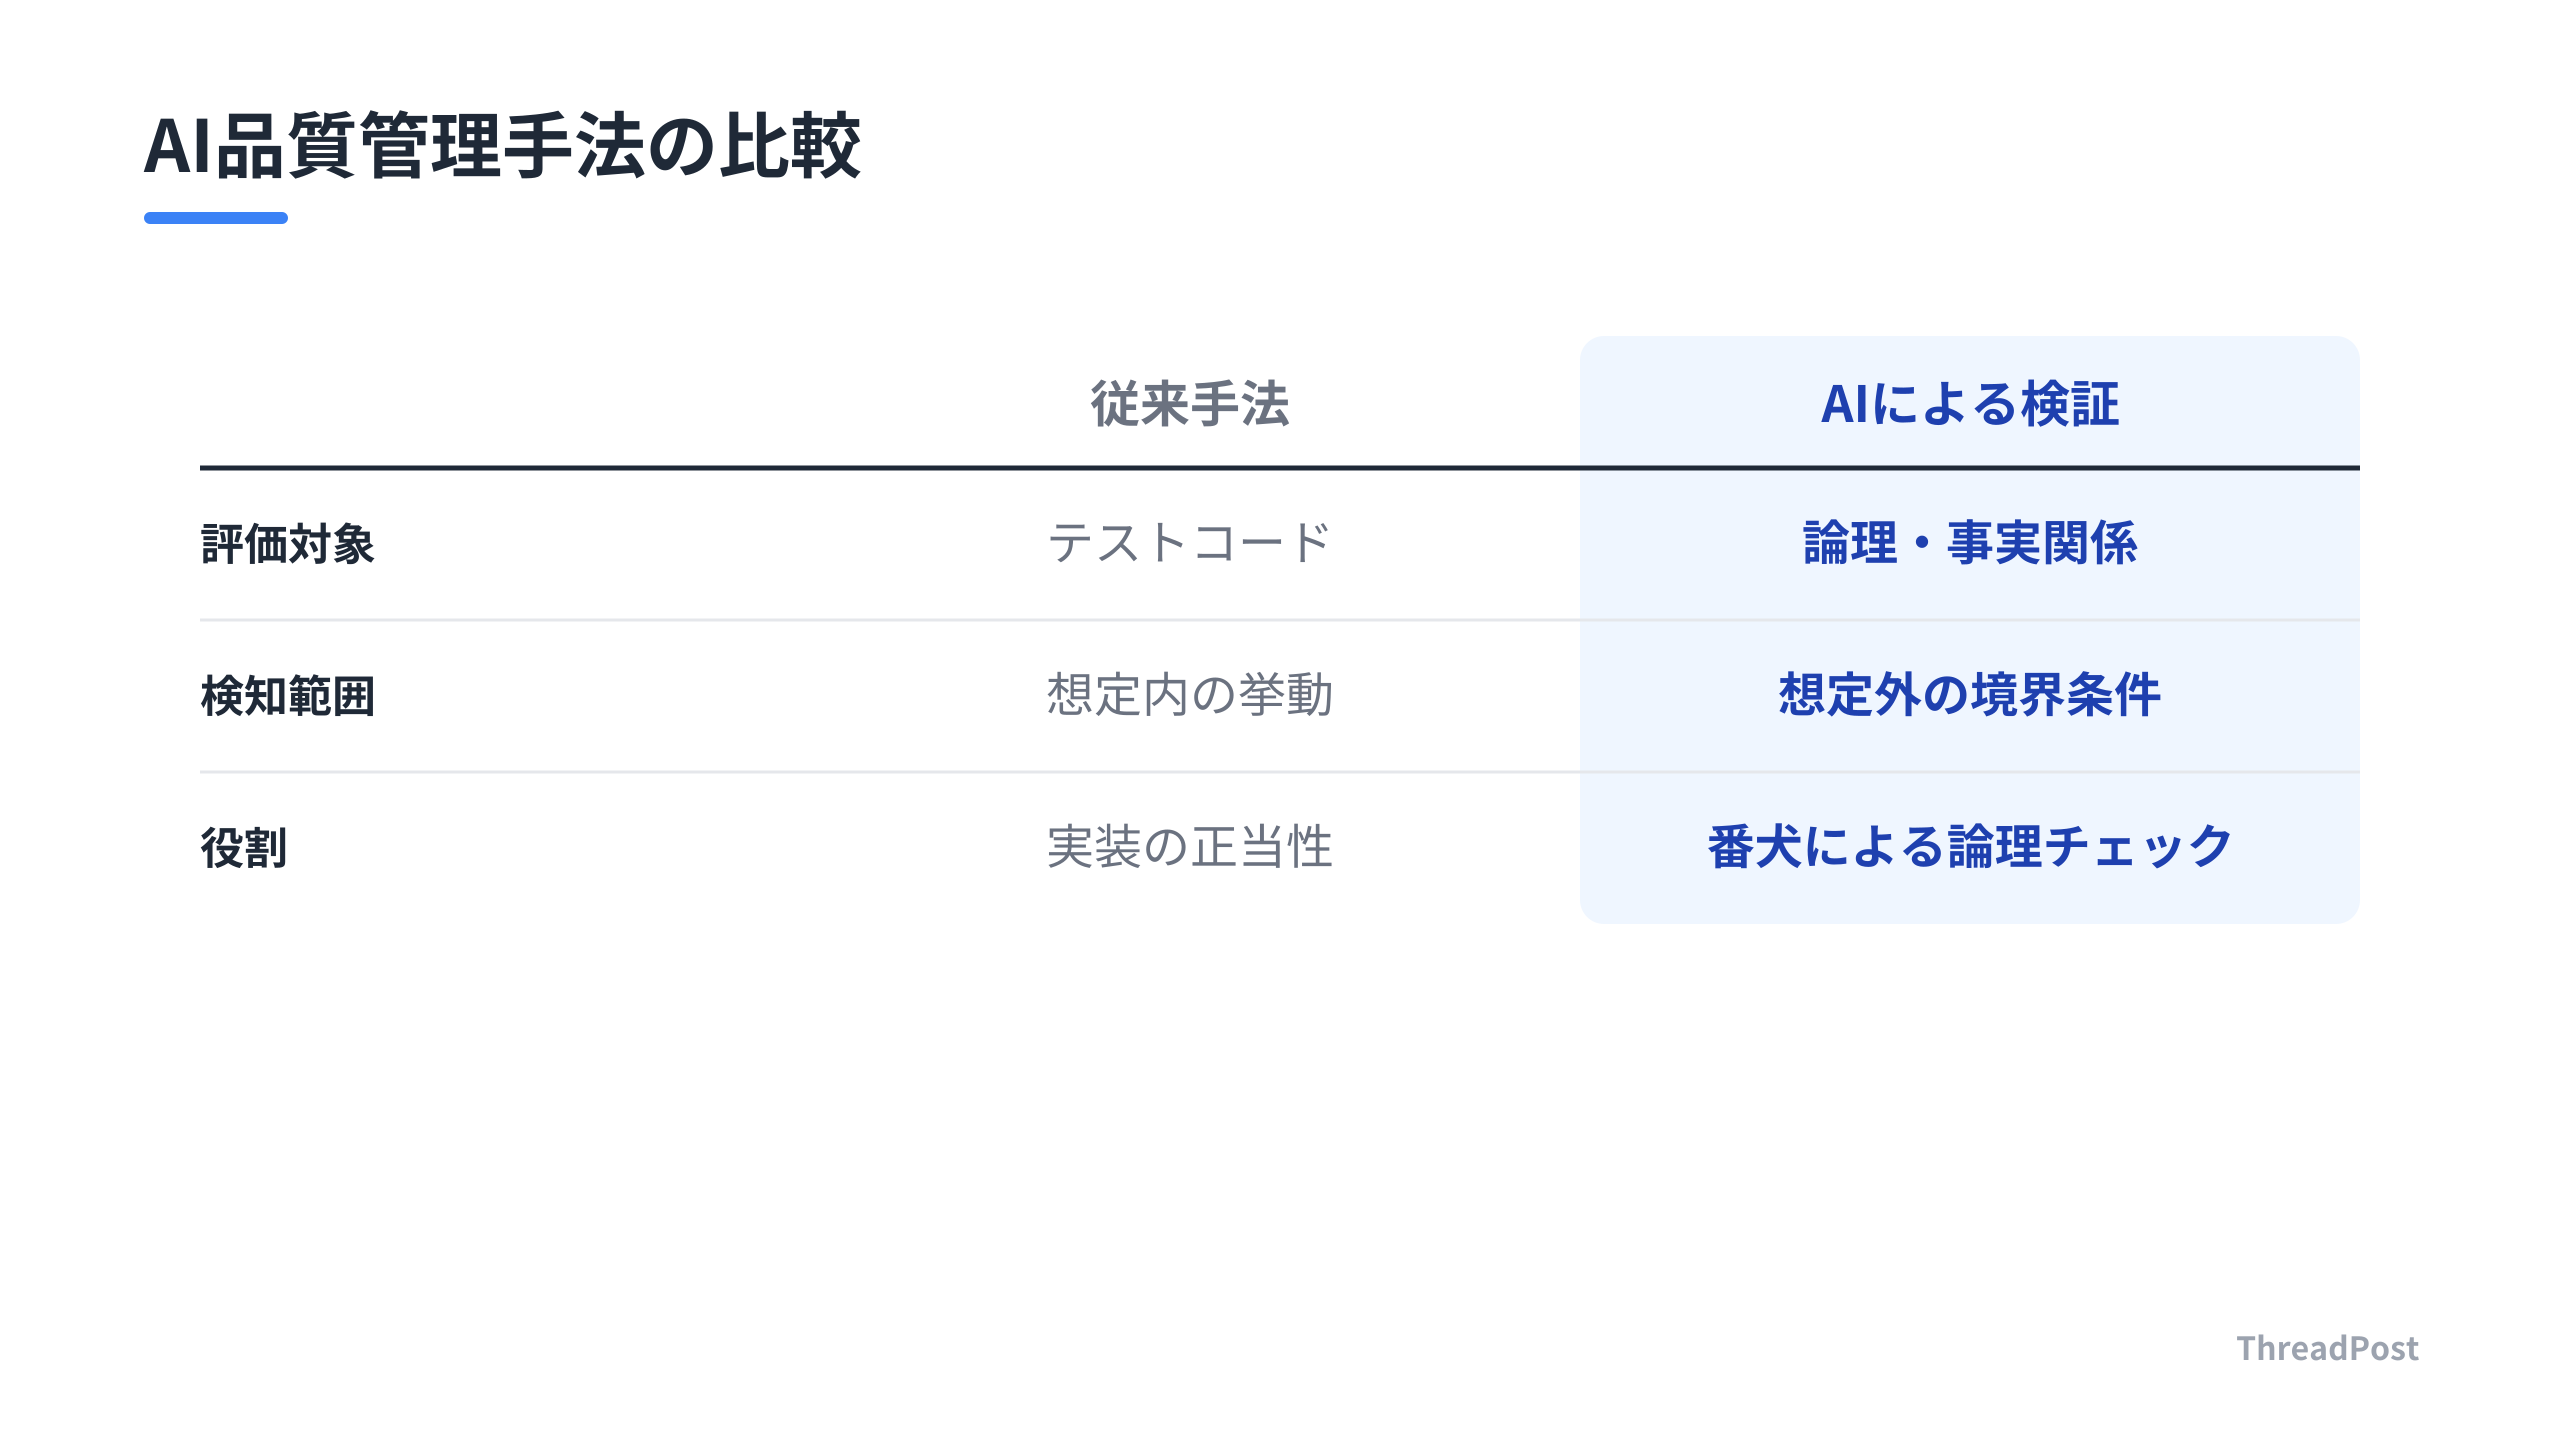
実装役と検証役を別のAIセッションに分ける手法を「番犬モデル」と呼ぶ。軽量モデルで体裁チェックを行い、重いモデルで事実確認を行う「2段構え」が効率的だ。
自己採点バイアスを避けるため、検証役には被採点モデルとは別の系列モデルを選ぶのが鉄則だ。同じ系列のモデルに採点させると、自分の出力を甘く評価する傾向がある。別系列のモデルを「番犬」として常駐させることで、人間では気づきにくい論理的な誤りを自動で発見できる。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
プロダクトリリースハーネス|最終安全装置の構築
リリース前の網羅的なチェックリストをAIに読み込ませ、人間が気づきにくい抜け漏れを機械的にスキャンする仕組みだ。技術的な脆弱性だけでなく、利用規約や法務観点まで横断的に確認し、リリース前の最終安全装置として機能させる。
この仕組みの肝は、チェックリストを「削る」ことだ。すべてを網羅しようとすると運用が形骸化する。リリースを止めるべき重要項目のみに絞り込むことで、実効性のある安全装置として機能する。
| ツール・手法 | 得意分野 | 導入難易度 | おすすめの用途 |
|---|---|---|---|
| promptfoo | コスト・速度計測 | 低 | プロンプトのABテスト |
| DeepEval | CI/CD連携 | 中 | 品質を追求する開発 |
| 番犬モデル | 論理的欠陥の発見 | 高 | 複雑なエージェント検証 |
| リリースハーネス | リリース前チェック | 中 | 運用上の安全装置 |
しんたろー:
Claude Codeでコードを書く身からすると、手元のコンテキスト管理が品質の鍵だ。promptfooのようなツールでコストを可視化しつつ、最終的には「検証役を別セッションで走らせる」という構造を作るのが、1人開発の安全性を高める。
用途別おすすめ
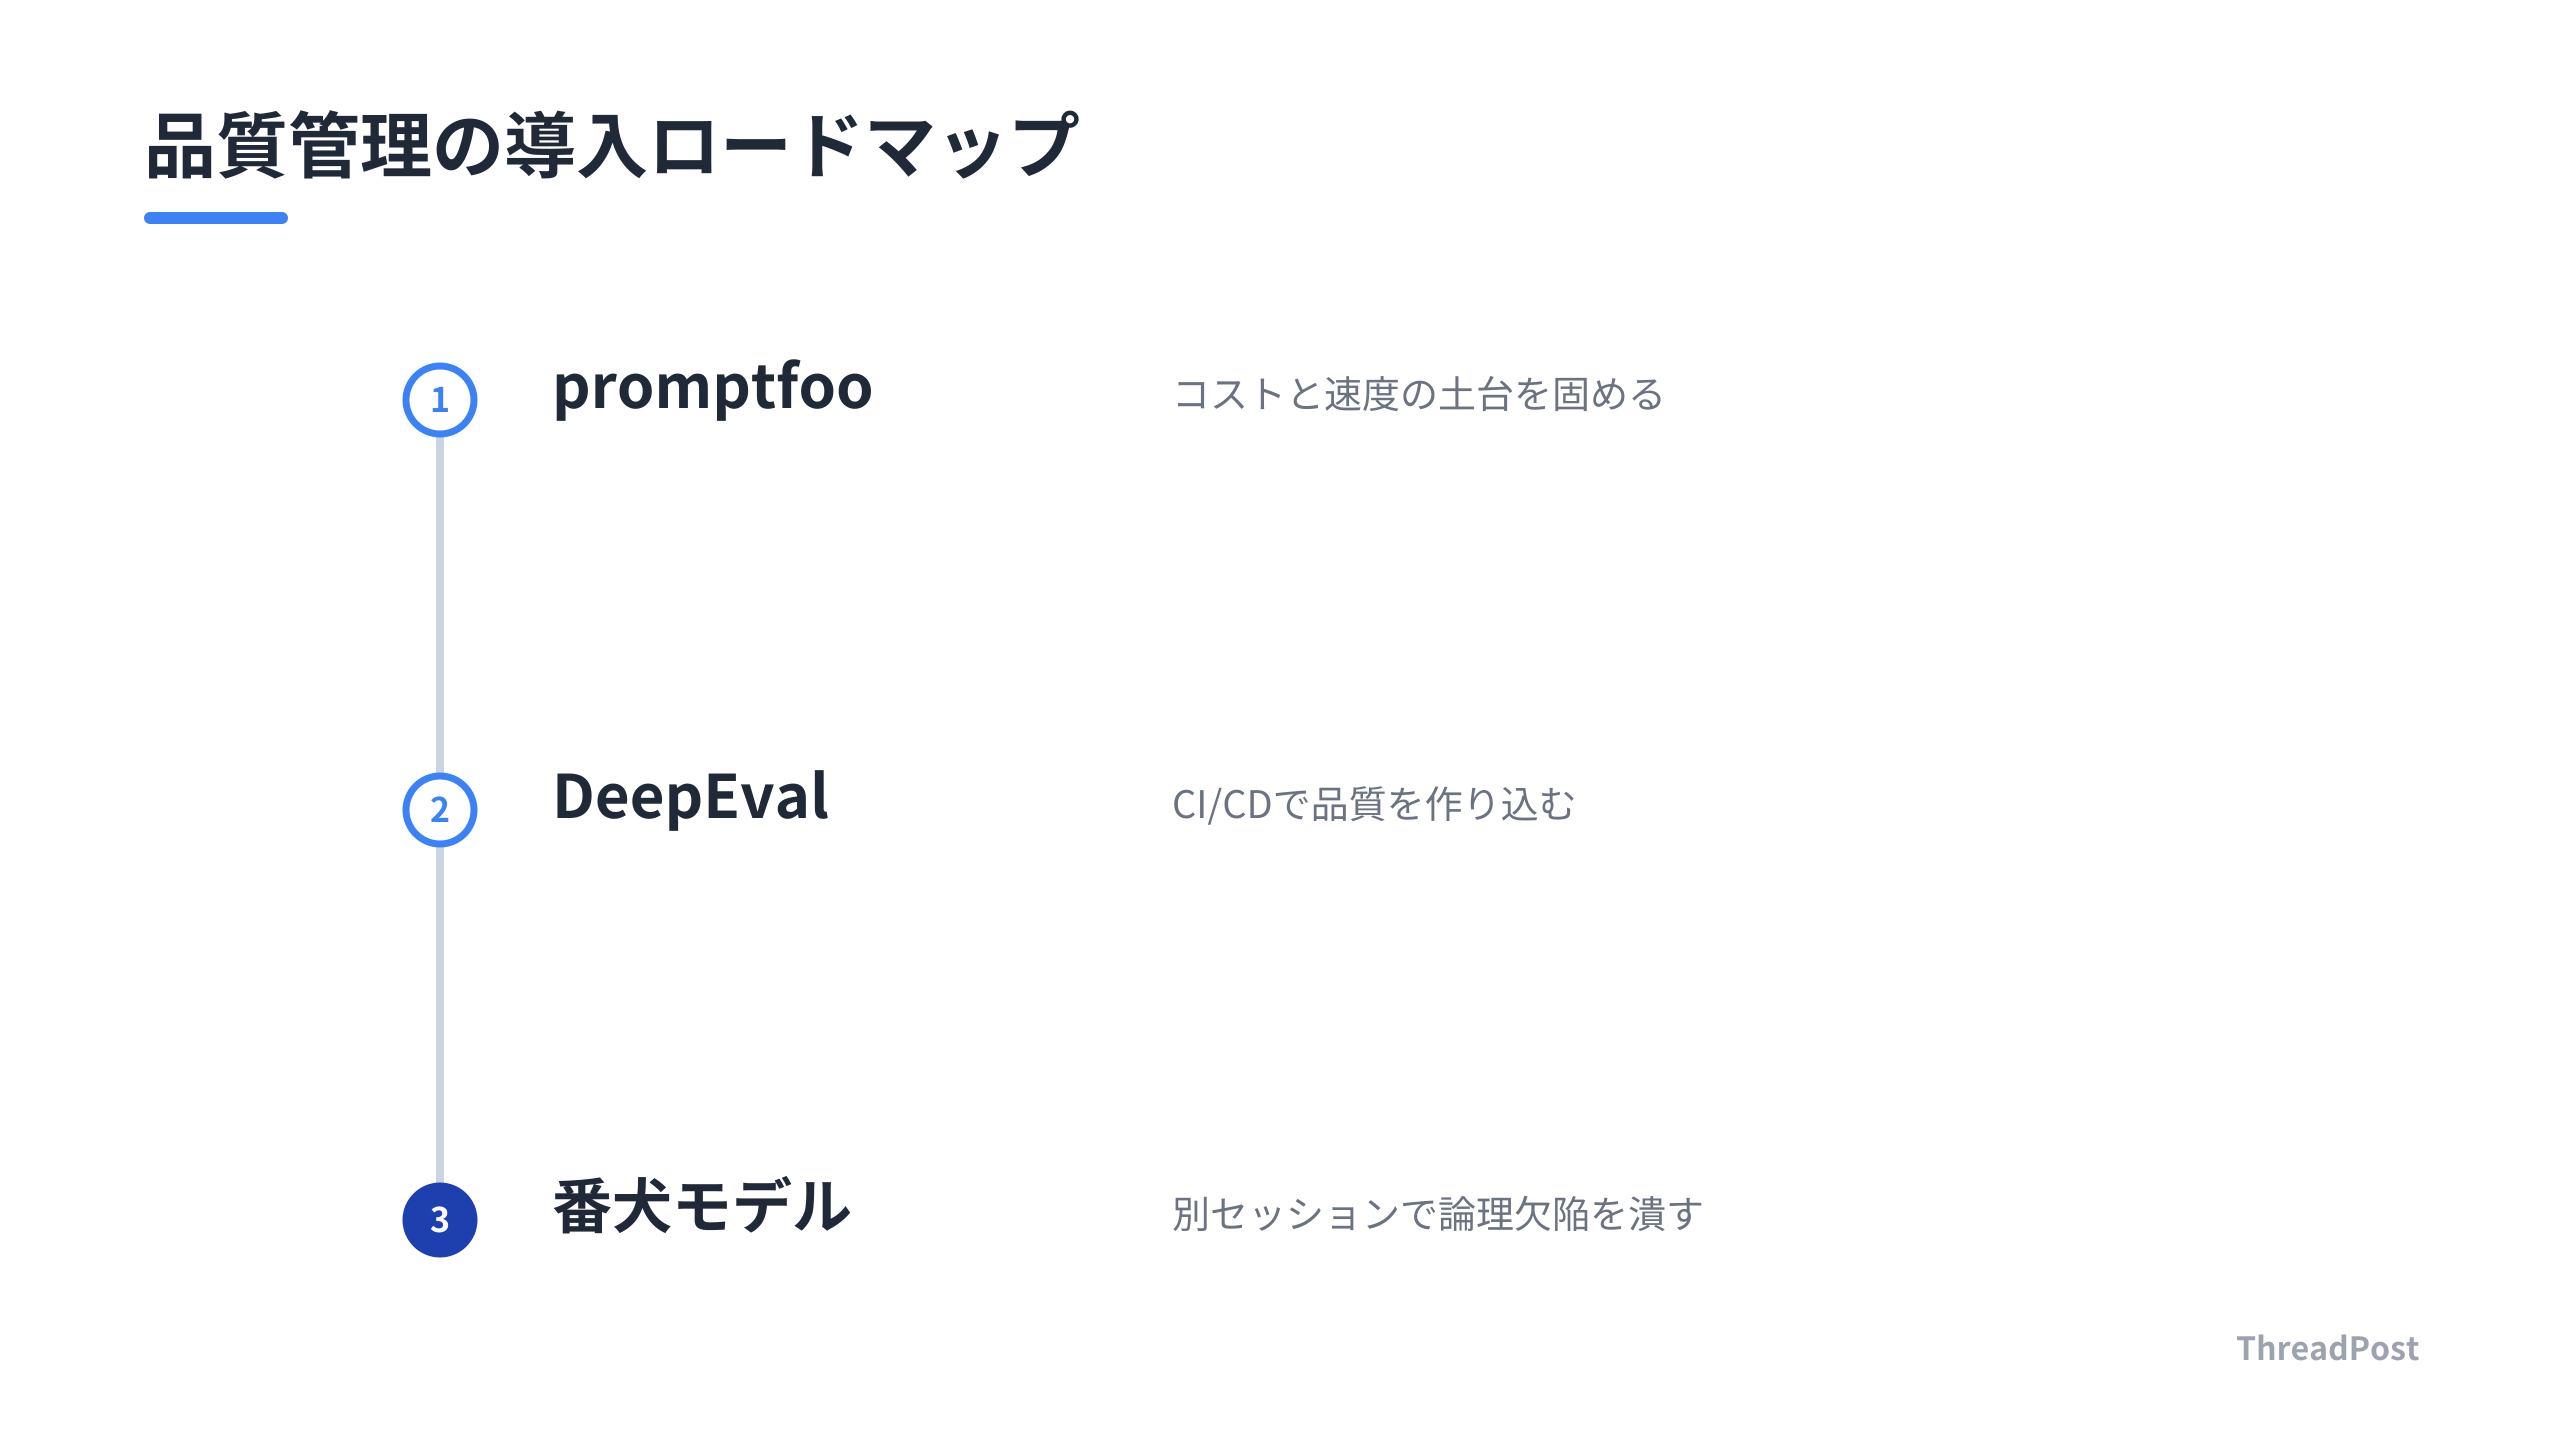
結論として、品質管理の順序は以下の通りだ。まずはpromptfooで低摩擦に土台を固め、品質の作り込みが必要になった段階でDeepEvalを足す。そして、論理的な欠陥を潰すために番犬モデルを導入する。
最初からすべてを導入する必要はない。まずは手元のプロンプト比較から始め、徐々に検証の層を厚くしていくのが失敗の少ない順序だ。
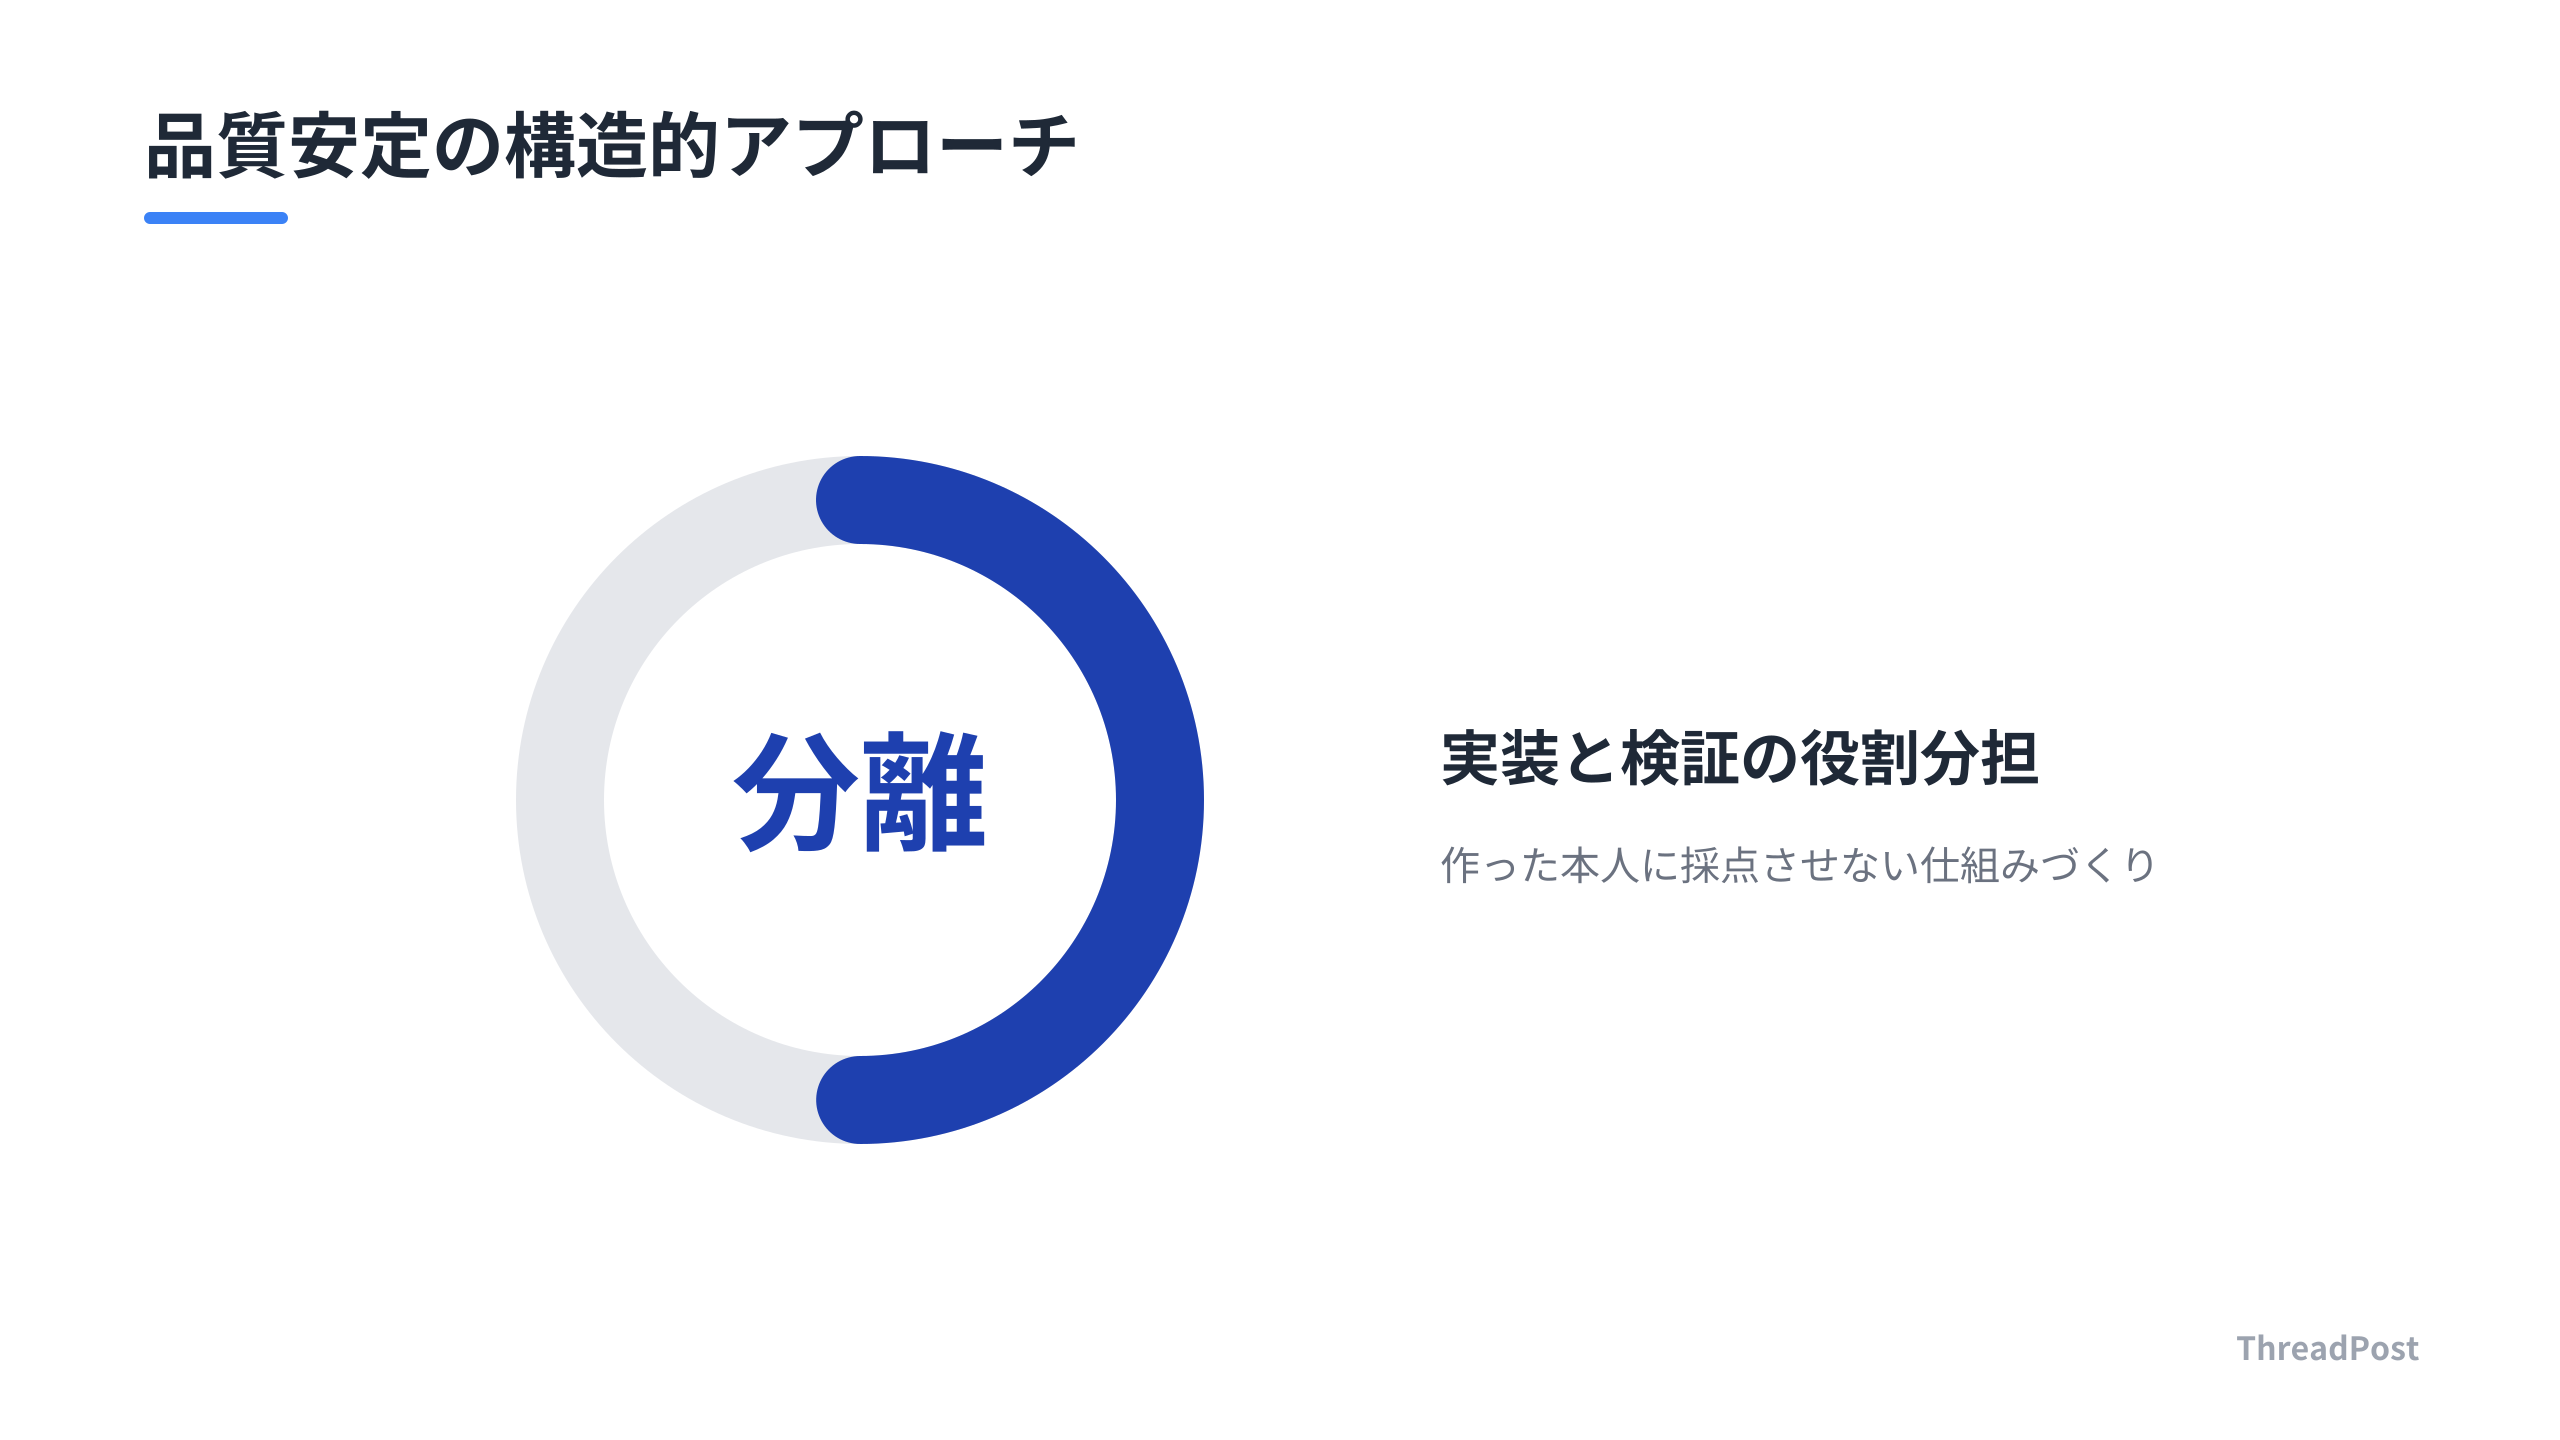
開発の初期段階でClaude Codeのコストを確認し、違和感があればすぐに検証役のエージェントにテストを投げている。ツールはあくまで補助輪だ。一番大事なのは「作った本人に採点させない」という仕組み作りだ。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
FAQ
Q1: AIの評価は、結局どのツールを使えばいいか?
A1: まずは「速さ・安さ」を測るためにpromptfooを導入し、CI/CDへの統合や詳細な品質検証が必要になった段階でDeepEvalへ拡張するのが最も効率的だ。最初から複雑な基盤を作らず、まずは手元のプロンプト比較から始める。
Q2: 安いモデルでAIの出力を採点しても大丈夫か?
A2: 露骨な崩れや形式チェックには有効だが、事実確認や複雑な論理判断には不向きだ。一次検知を軽量モデル、二次検知を高性能モデルと分ける2段構えを推奨する。また、自己採点バイアスを防ぐため、検証役には必ず別の系列のモデルを使用する。
Q3: テストコードがあるのにAIが間違えるのはなぜか?
A3: テストコードは書いた本人が想像できる範囲しかカバーできないからだ。AI開発では、テストコードで想定外の入力をあえて与える「検証役エージェント」を別セッションで走らせることで、境界条件や総量制限などの見落としを補完できる。
Q4: リリース前のチェックリストをAIに自動化させるコツは?
A4: 網羅的に洗い出したリストの中から、削る基準を「これができないとリリースを止めるべきか?」という一点に絞ることだ。すべてをAIに任せるのではなく、最終的な責任判断は人間が行う責任の3層構造を設計することが重要になる。
Q5: AIエージェントのテストにコストをかけすぎないためには?
A5: 評価結果をキャッシュする仕組みを活用し、再実行時のコストを最小化する。すべてのテストを高性能モデルで行うのではなく、一次フィルタリングに安価なモデルを使い、失敗の疑いがあるものだけを高性能モデルで再検証するコスト最適化が有効だ。
まとめ
AIエージェントの品質管理には、数値で測るツールと、役割を分離する構造的な検証の組み合わせが不可欠だ。まずは軽量なツールでコストと速度の土台を固め、次に検証役エージェントを導入して論理的な欠陥を潰す多層的なアプローチを実践する。
AI開発における不安は、AIそのものではなく、作った本人に採点までさせる構造にある。人間と同じように「実装」と「レビュー」を分ける体制を構築することが、品質を安定させる道だ。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策
