


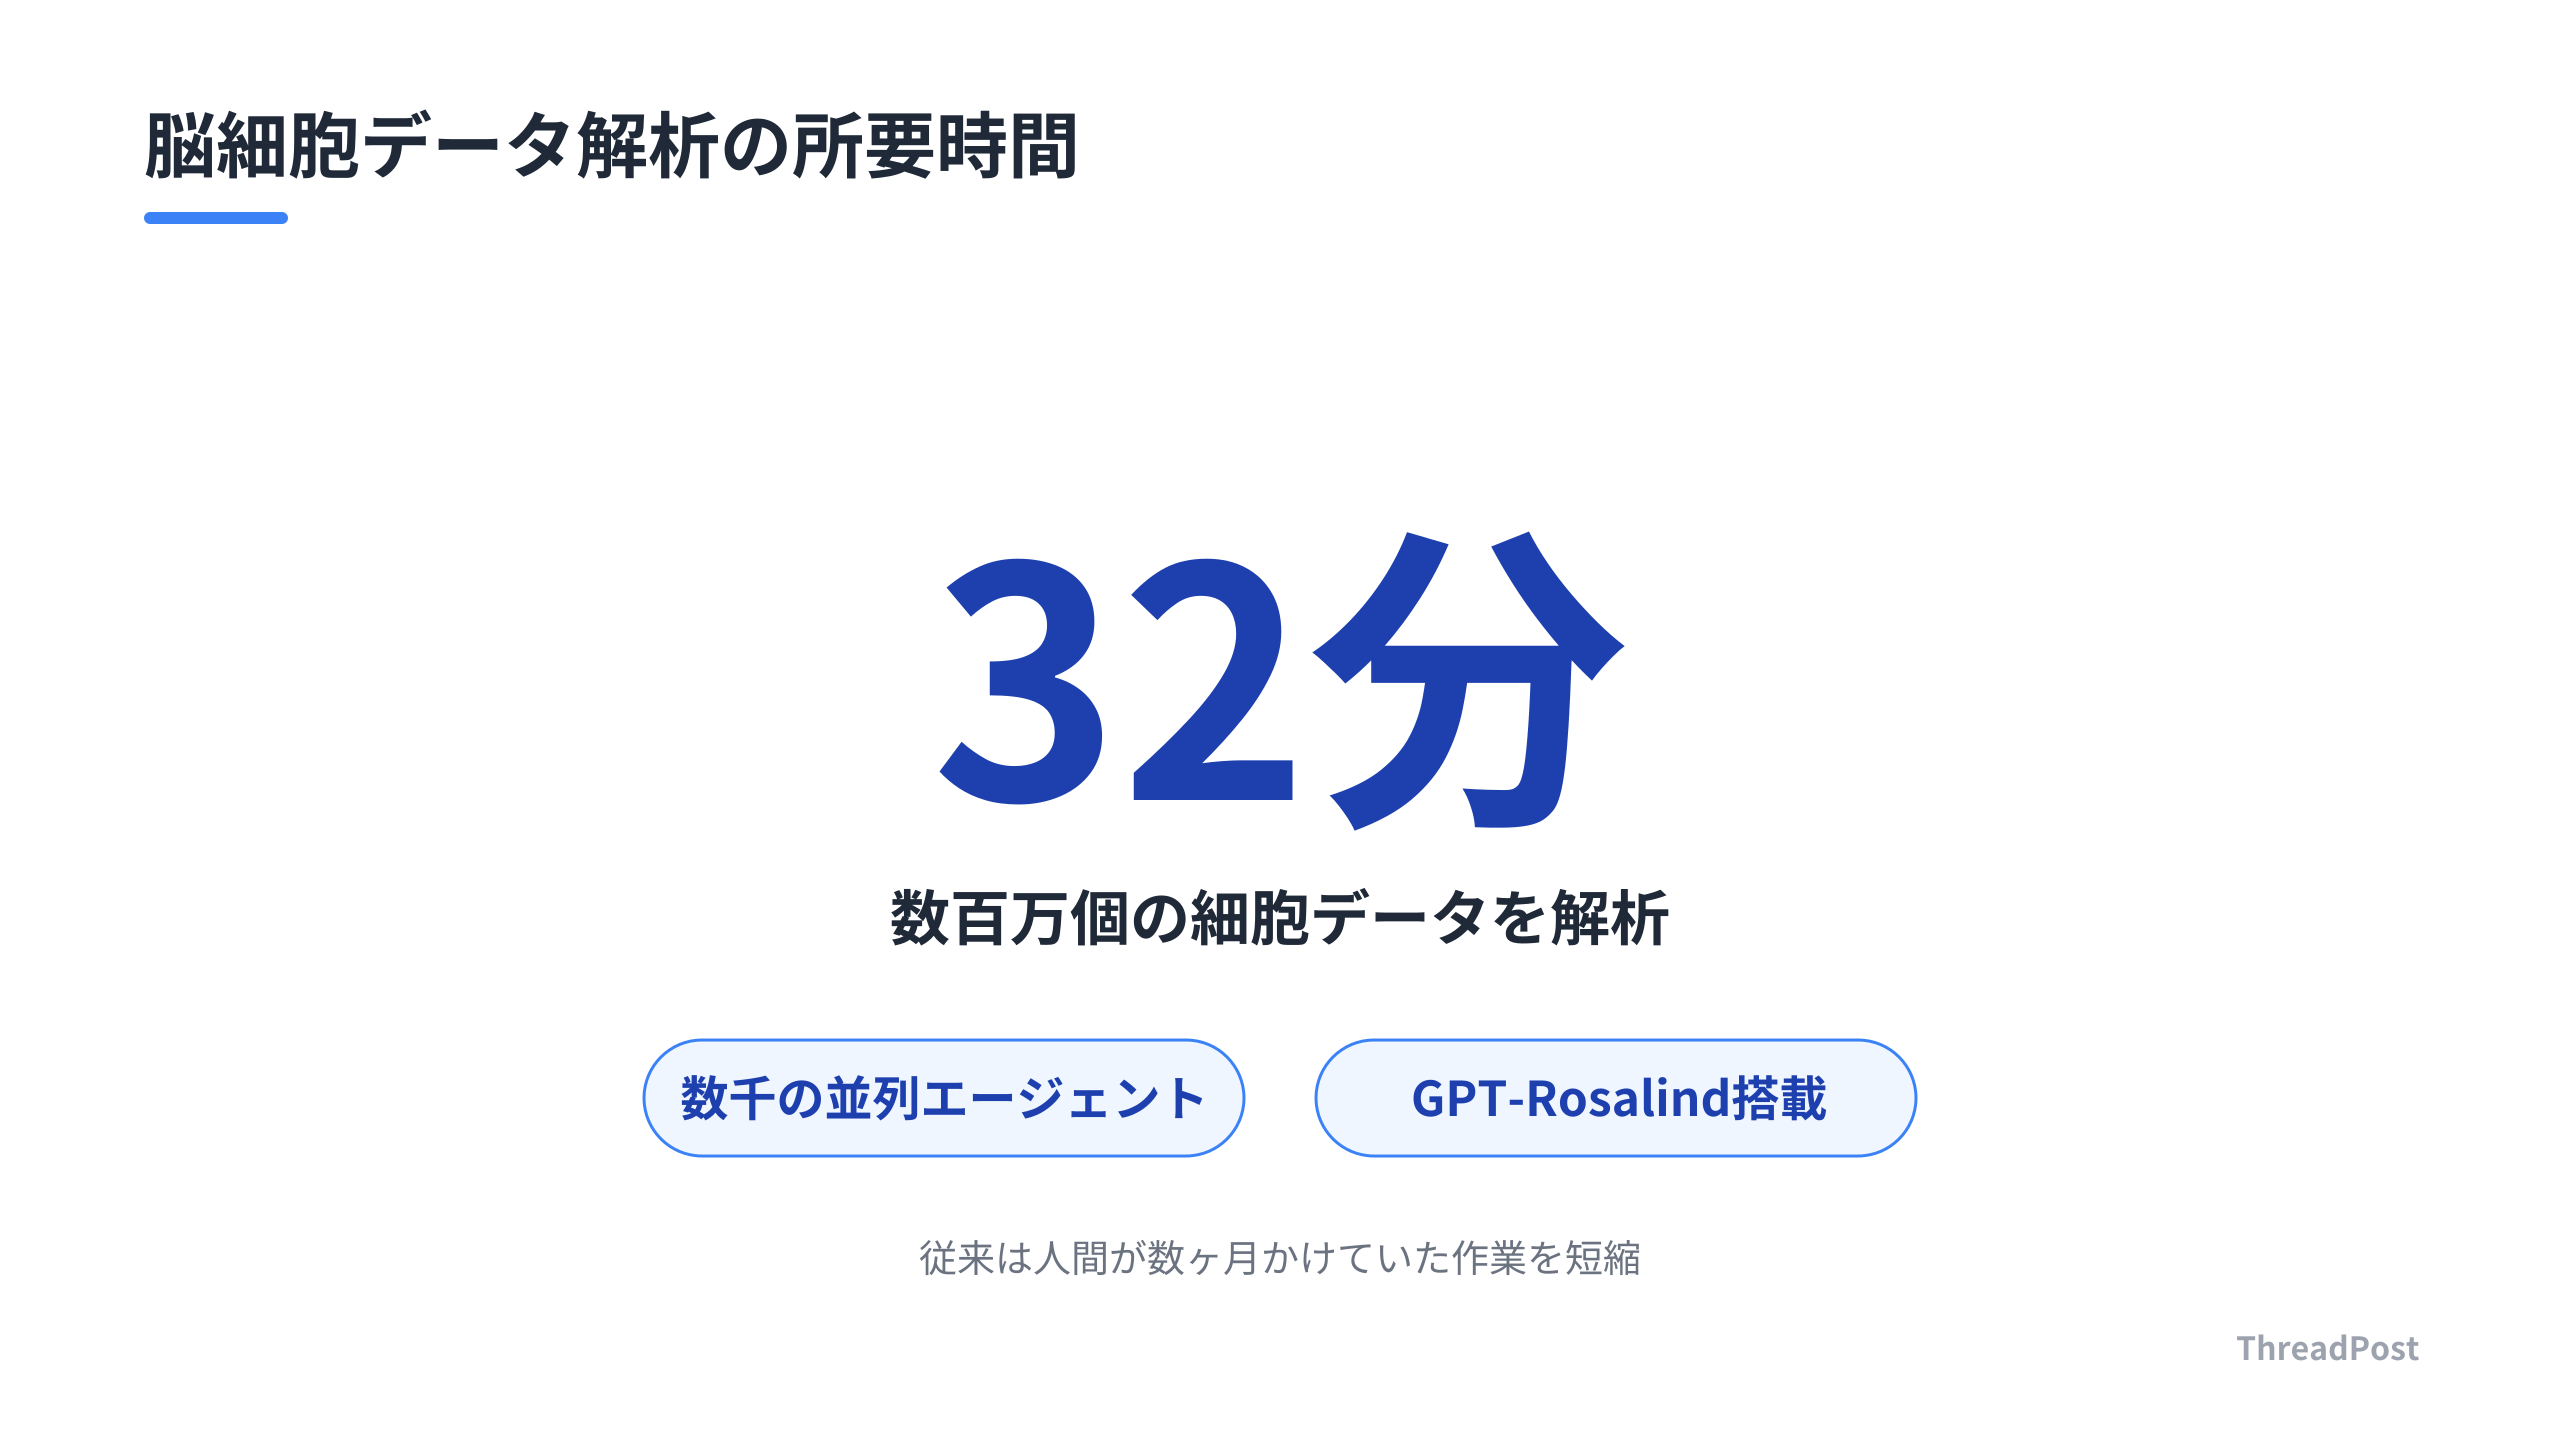
数千のAIエージェントが、32分で数百万個の細胞データを解析した。個別のタスクを自律的に分解し、外部知識と接続する「分散型推論」の成果だ。
開発者としてこのアーキテクチャの応用が気になる。Claude Codeで1人SaaSを構築する僕も、エージェントのタスク分解と外部検索のタイミングをシステムプロンプトでどう制御するかに注力している。
この記事では、最新の分散解析事例から、開発現場に応用できる「エージェントの自律性を引き出す構造化プロンプト」を解剖する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
分散型推論がもたらした解析速度
脳細胞のデータ解析において、数千のエージェントが並列稼働した。32分で数百万個の細胞データを解析したという結果が報告されている。
このプロジェクトでは、GPT-Rosalindを搭載した数千台のエージェントが、マウスの脳細胞における遺伝子変異の影響を調査した。AIが自律的にタスクを細分化して処理した事例だ。
各エージェントは割り当てられた遺伝子変異を特定し、細胞の反応を分析する。その上で、科学文献を検索し、仮説を提示する。これらの報告が統合され、遺伝子、細胞反応、科学的根拠が紐付いた「推論アトラス」が完成する。
しんたろー:
32分で数ヶ月分の解析という速度が気になる。単一モデルに全部投げ込むのではなく、タスクを数千にバラして並列で検索まで走らせる設計思想は、SaaS開発のバッチ処理でも参考になると思った。
この事例では、AIが自身の知識の境界を理解し、外部データベースや文献から能動的に補完する「検索ファースト」のアーキテクチャが採用されている。
AIのシステムプロンプトに関する構造分析も進んでいる。LLMの振る舞いは「キャラ設定」「メモリ」「ツール利用」「検索ルール」といったレイヤーが積み重なって規定されている。
特にツール利用の判断フローが重要だ。エージェントはユーザーのプロンプト構造に応じて、どのツールを即時に呼び出し、どの検索を遅延させるかを制御されている。
「現在の状態」や「最新の価格」といった動的な情報を求める際、システムプロンプト内に具体的な検索トリガーが設定されていれば、AIは知識ベースに頼らず検索を走らせる。設計された構造がAIの出力を強制的に「検索」へと向かわせている。
分散解析におけるエージェントの自律性と、システムプロンプトによる挙動制御。AIが「対話相手」から「タスクを完遂する実務者」へと進化している。モデルのスペックを追いかける段階から、エージェントが自律的に動ける「環境と指示」を設計する段階へシフトしている。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
AIエージェントを「実務者」へ変えるプロンプト設計の核心
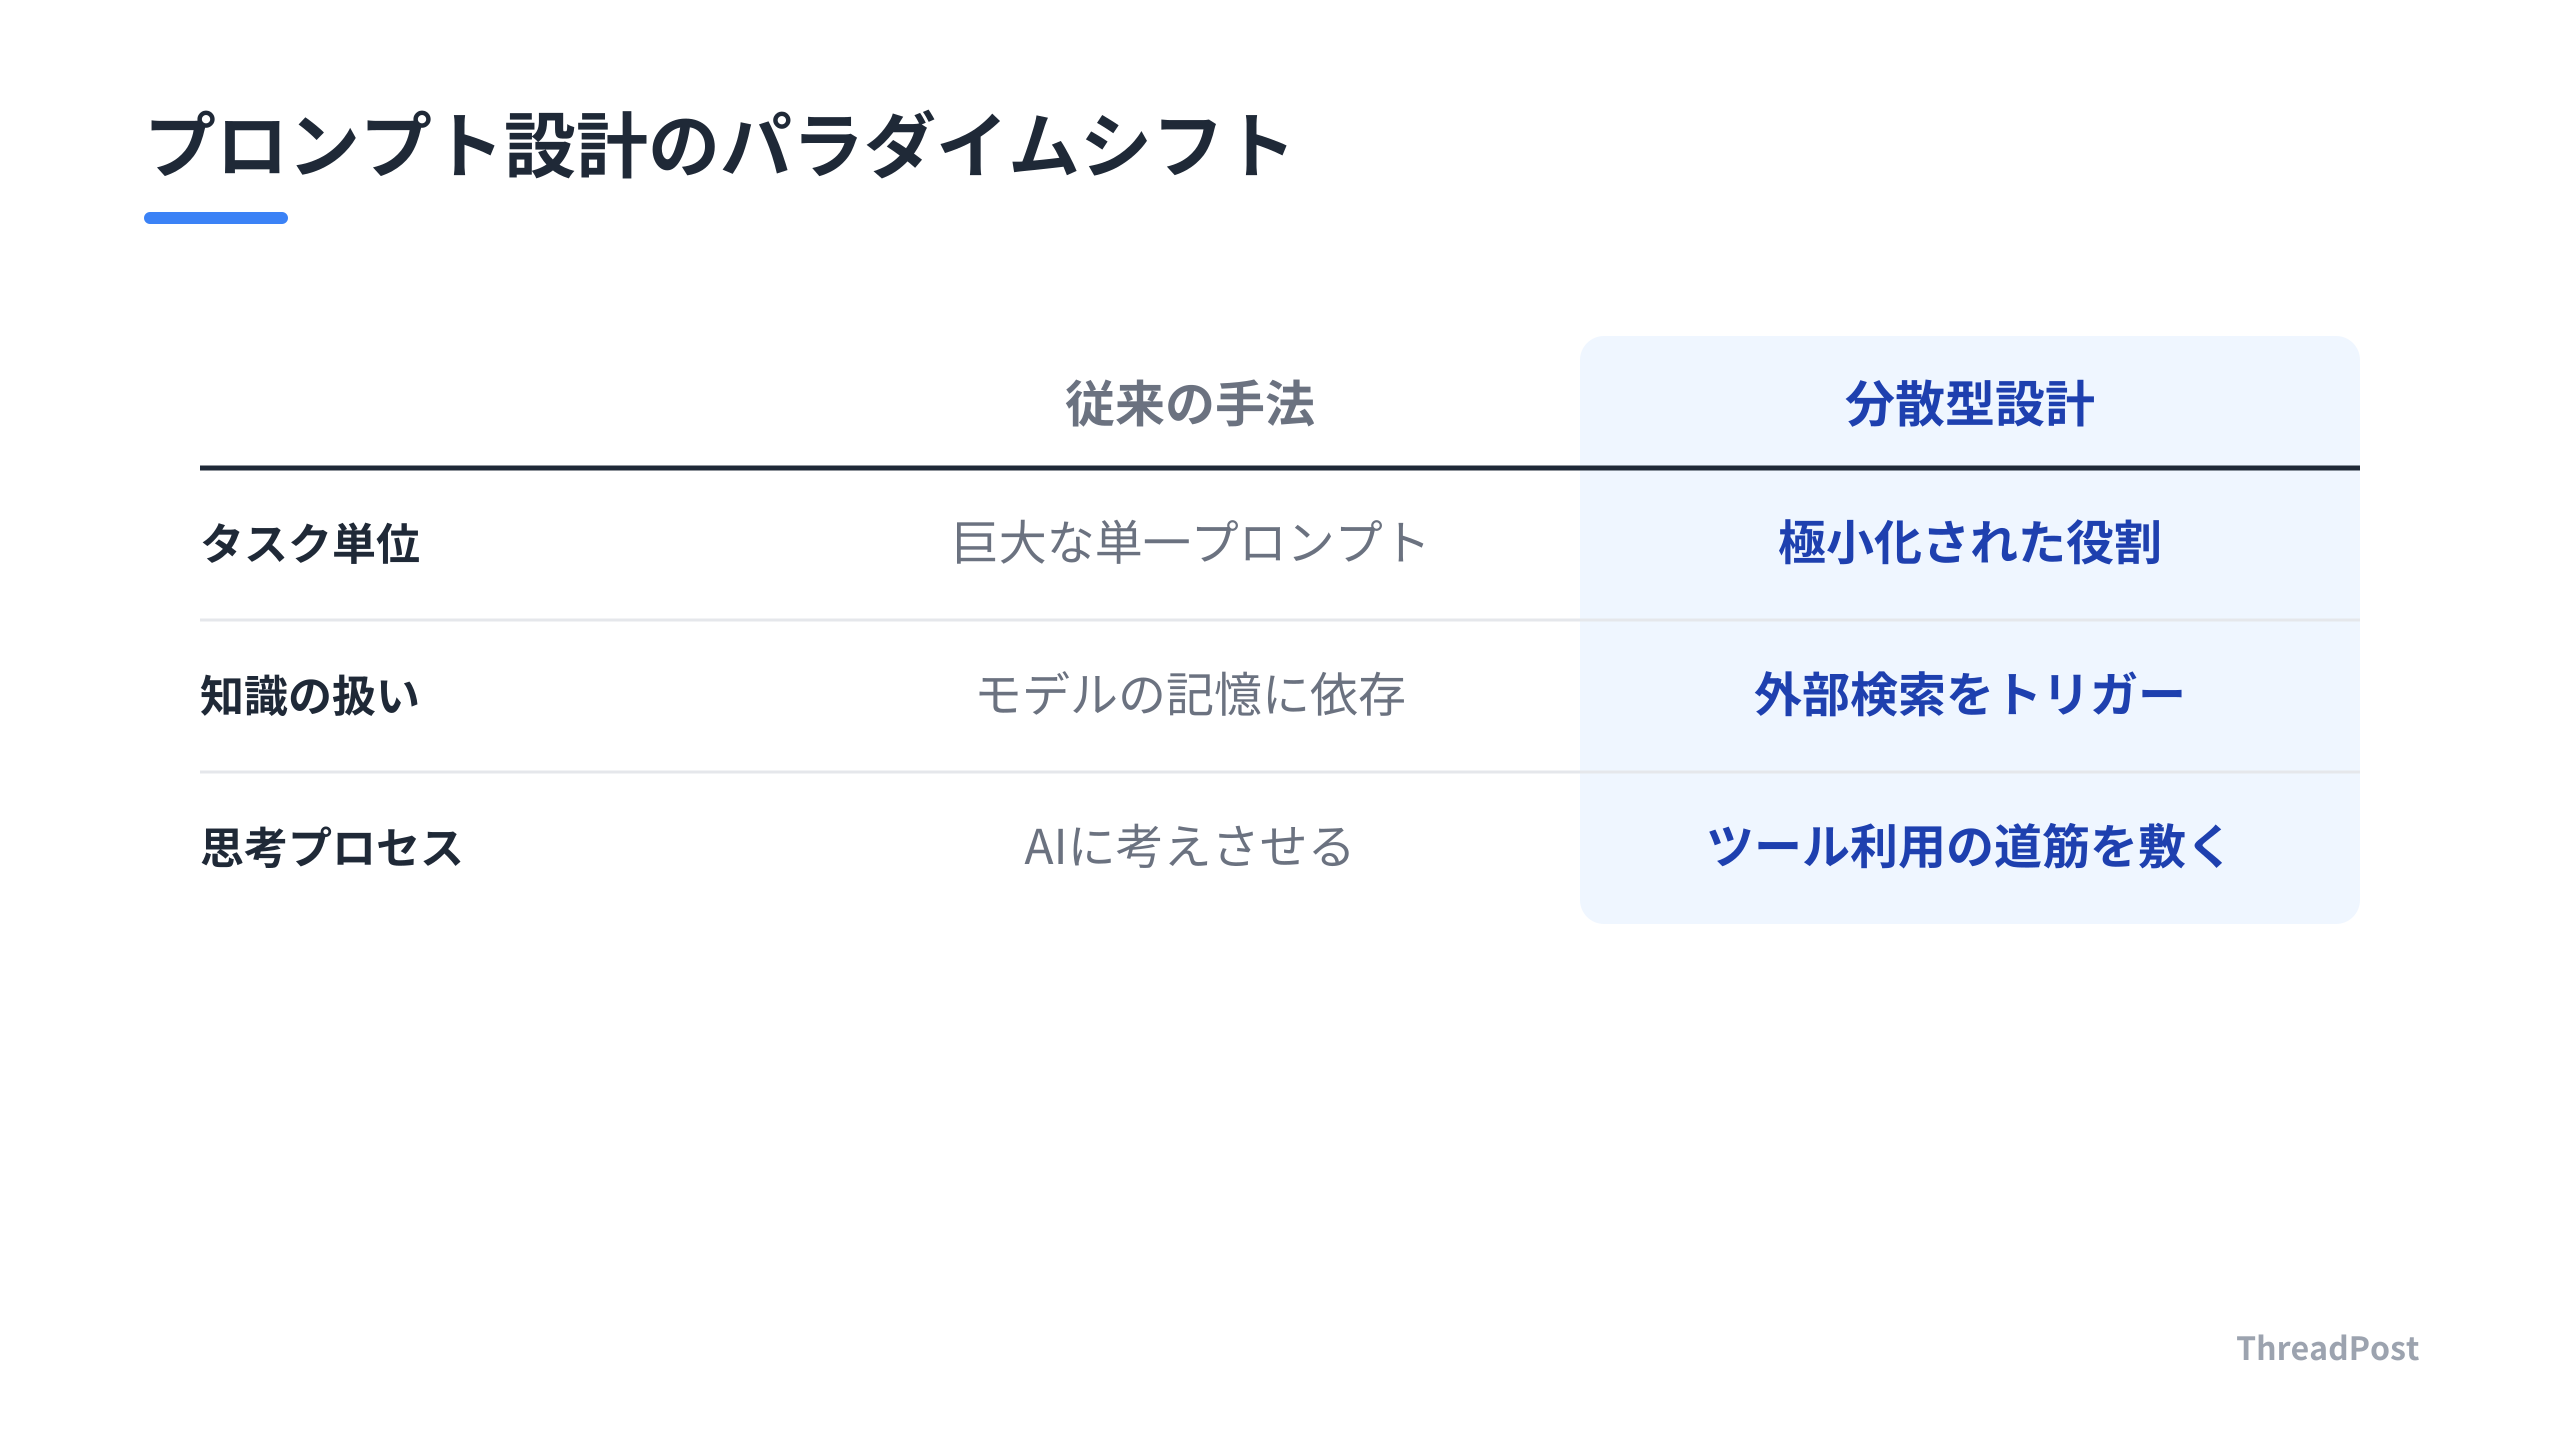
今回の分散型解析の事例と、Claudeのシステムプロンプト構造には共通点がある。AIに考えさせるのではなく、AIがツールを使いこなすための道筋を敷く設計思想だ。
従来の開発では、一つの巨大なプロンプトで要件を網羅しようとしがちだ。しかし、GPT-Rosalindは数千のエージェントを並列化し、それぞれに「特定の遺伝子解析」と「文献検索」という限定的な役割を与えた。AIの推論能力を拡張する際、モデルのパラメータを増やすことよりも、タスクの分解とツールへのアクセス権限の設計が重要だ。
開発者が注目すべきは、AIが自らの知識不足を検知し、自律的に外部検索を走らせるための「トリガー設計」だ。Claudeのシステムプロンプトが「最新の動向」を検索させるよう制御されているのと同様に、自分たちのアプリでも、AIエージェントに対して「どのタイミングで検索APIを叩くべきか」という境界線をプロンプト内で定義する。
Claude Codeで複雑なバッチ処理を組む際、プロンプトに「検索すべき状況」を具体的に書き足すとハルシネーションが減る。AIが「何を知らないか」を自覚できるルールを渡すことで、開発の進捗が変わると思った。
この「検索ファースト」な挙動は、モデルの知識ベースという「静的な記憶」と、インターネットやデータベースという「動的な情報」を、エージェントを通じてリアルタイムに同期させるアーキテクチャだ。
分散エージェントによる解析が32分で完了した事実は大きい。単一のAIエージェントに投げれば、コンテキストウィンドウの制限や推論の迷走で、数日かかっても終わらないか、精度が低下していただろう。タスクを細分化し、各エージェントに「専門家」としての役割と、必要な「検索ツール」を渡す。この設計パターンが、複雑なデータ解析を自動化するためのルートになる。
開発者目線で言えば、これは「コードを書く」作業と「AIの挙動を制御する」作業の境界が消えつつあることを意味する。Claude Codeを使いながら実感するのは、コードそのものよりも、そのコードを実行するAIエージェントの「思考プロセス」をいかに構造化して指示するかが、プロダクトの質を左右するという現実だ。
システムプロンプトの階層構造を解剖すると、AIがいかに「より具体的で、より安全な指示」を優先するかがわかる。自作のAIツールやThreadPostのようなSaaSを開発する際にも応用できる。プロンプト内で「役割」「検索ルール」「ツール利用の優先順位」を明確にレイヤー分けしておくことで、AIの回答の一貫性は向上する。
AIの進化は「どれだけ賢いモデルを使うか」から「どれだけ賢いエージェントの連携システムを組めるか」というフェーズに移行した。GPT-Rosalindのような大規模な解析も、日常的なコード生成も、本質的なアプローチは同じだ。タスクを最小単位まで分解し、各エージェントが自律的に外部情報にアクセスできる「レール」を敷く。
AIを「魔法の箱」として扱うのではなく、システムの一部品として「いかに制御し、いかに情報を補完させるか」を考える。この視点を持つことで、AIエージェントの実装難易度は下がり、実用的なレベルへと引き上げられる。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
明日から取り入れるべきエージェント設計の最適解
単一の大きなプロンプトでAIに全てを丸投げするスタイルは限界がある。AIを実務で使い倒すために、明日から取り入れるべきアクションは以下の通りだ。
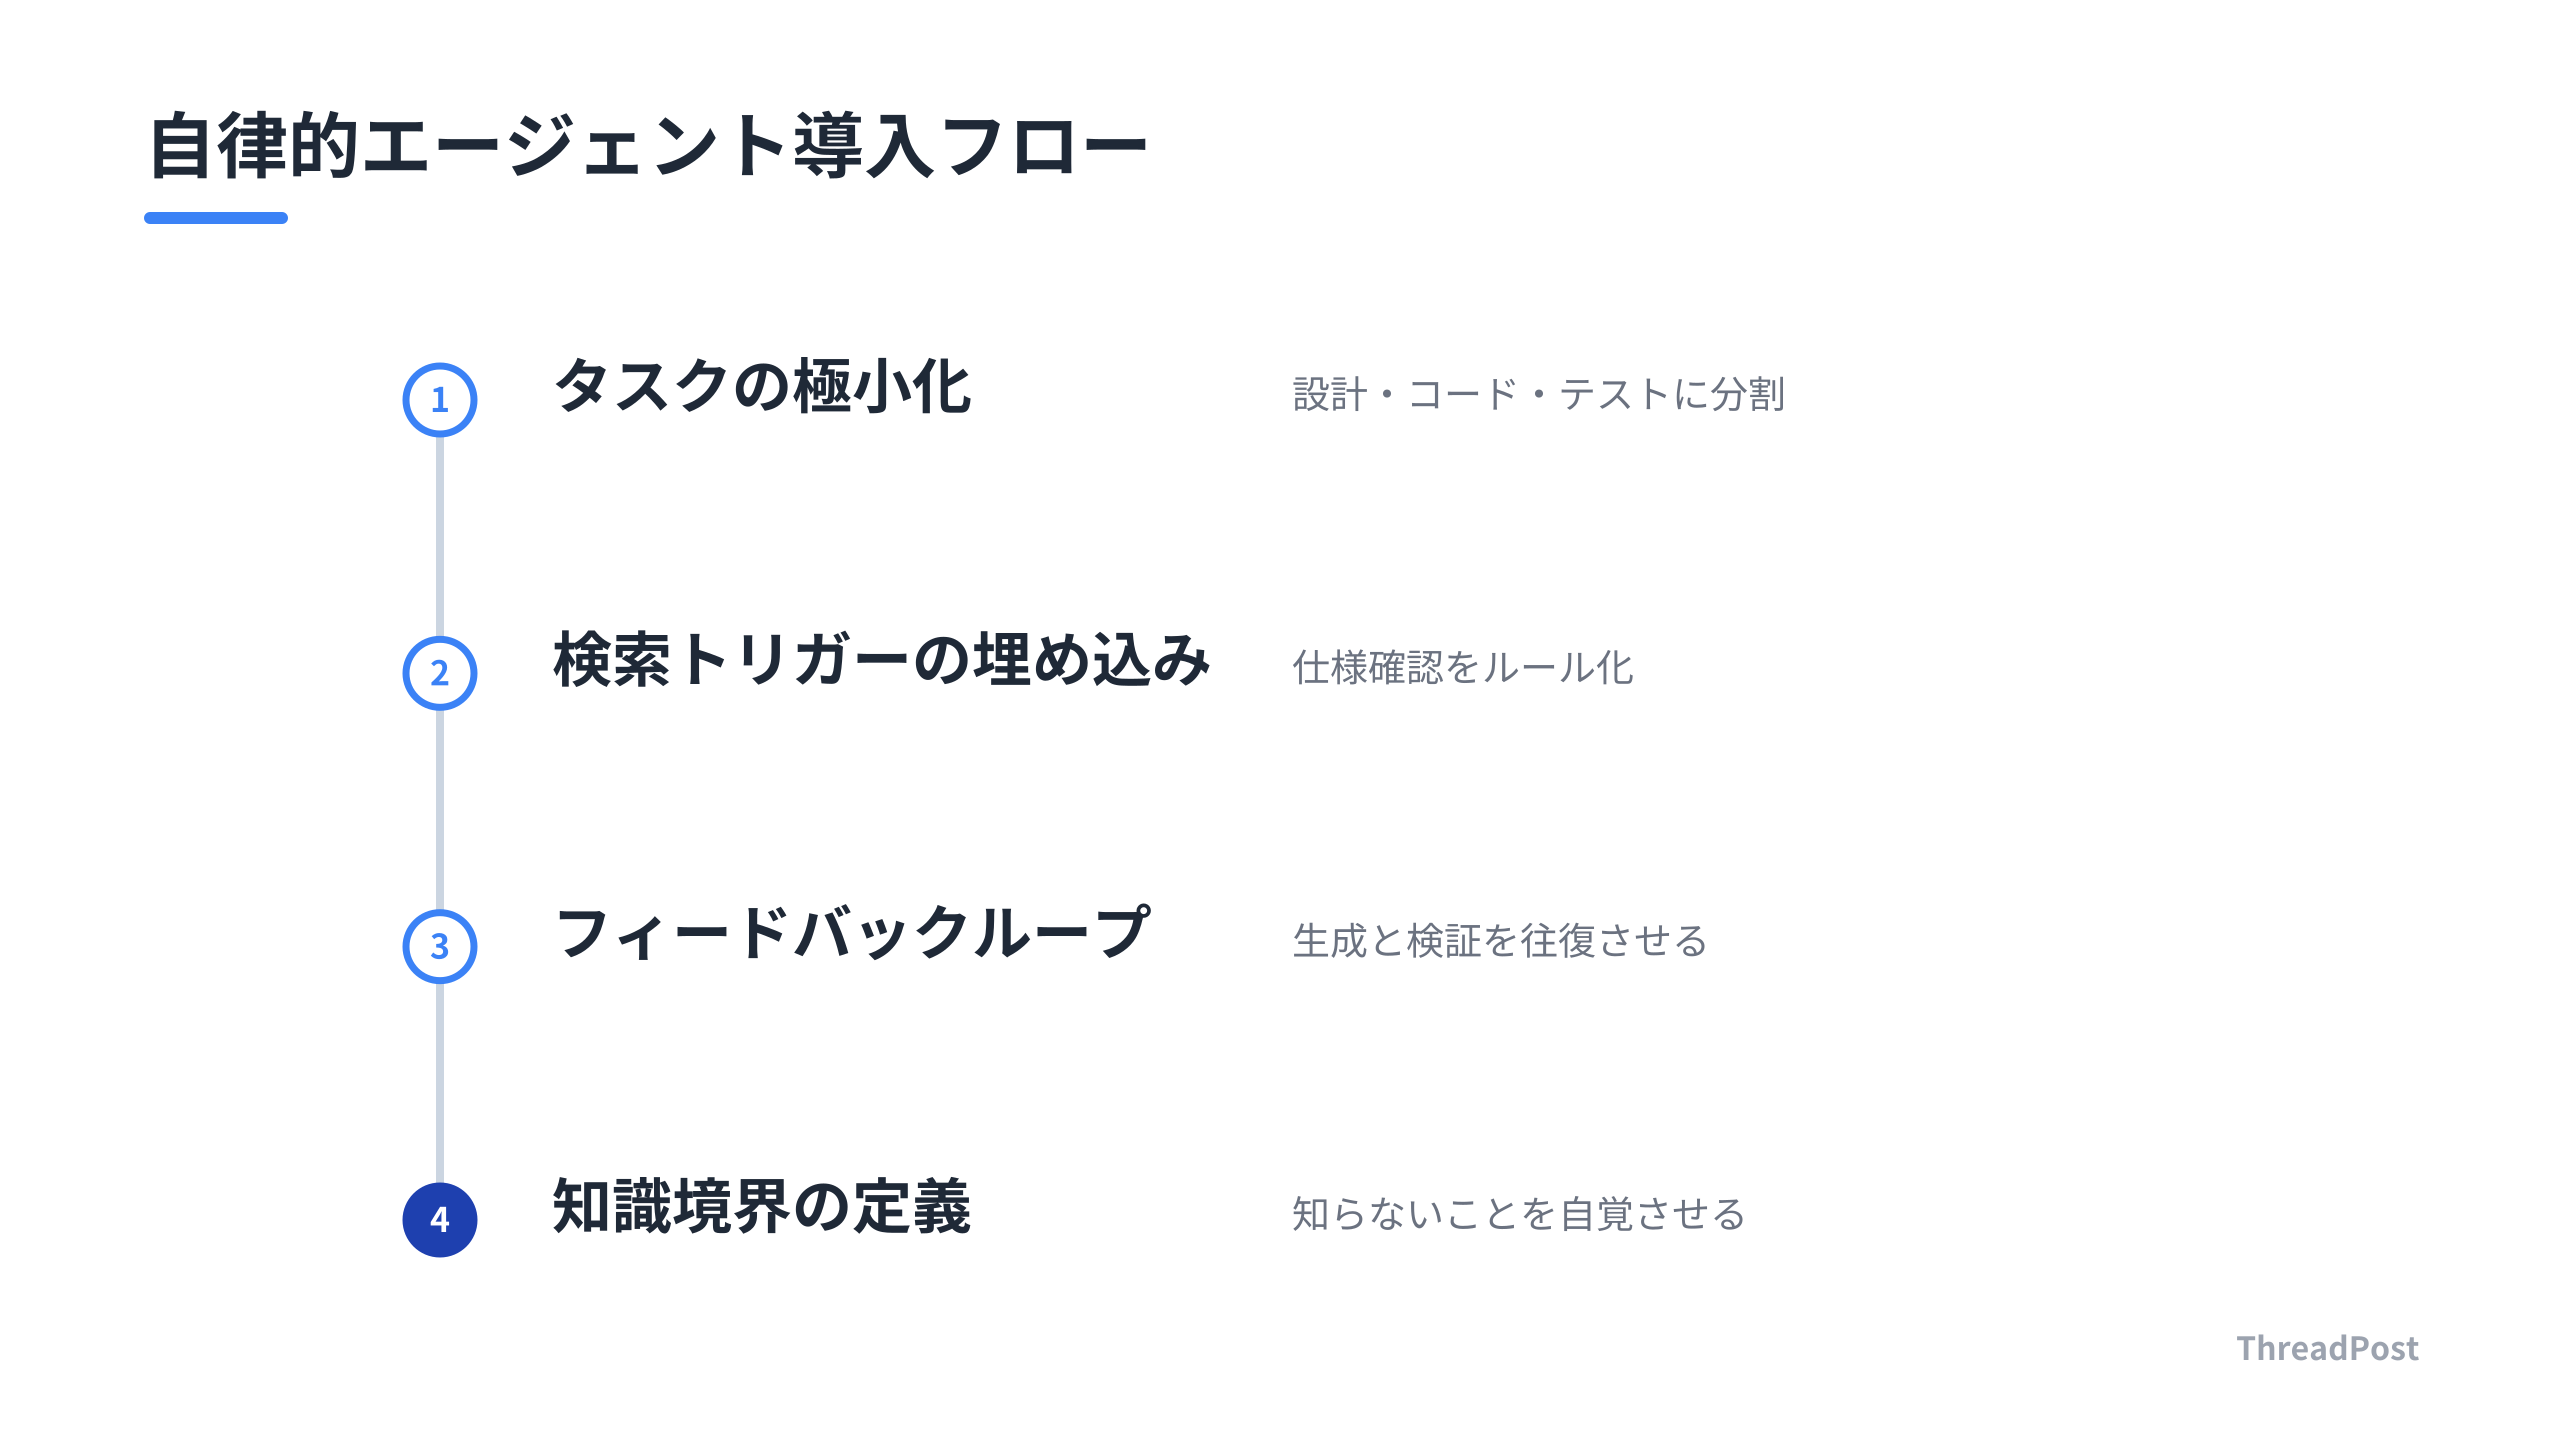
- タスクの「極小化」と「エージェント分割」
複雑な機能を実装する際、一つのプロンプトで完結させない。まずは「設計」「コード生成」「テスト」「ドキュメント更新」という具合にタスクを分割する。それぞれのプロセスを別々のエージェントに担当させるのがコツだ。
- 外部検索を「トリガー」として組み込む
AIの知識に頼りすぎない。システムプロンプトの中に「最新のライブラリ仕様を確認せよ」「公式ドキュメントを検索して齟齬がないか照合せよ」という指示を明示的に組み込む。これにより、AIの回答精度は安定する。
- 「検索可能なキーワード」を意識した入力
AIに指示を出すとき、文脈に固有名詞を混ぜる。「例のあれ」ではなく「プロジェクト名の〇〇における、直近のAPI仕様」と書く。これだけで、AIが内部で検索を実行する可能性が上がる。
ThreadPostのデバッグでClaude Codeを酷使しているが、抽象的な指示だと「いい感じにやっといて」という空気を読みすぎるAIの悪い癖が出る。逆に「このファイルと公式の最新仕様を突き合わせて、型定義の不整合がないか検索して」と役割を具体化すると、正確な回答が返ってくる。AIに「考えるな、検索しろ」と指示する勇気を持つのが近道だと感じた。
- フィードバックループの自動化
AIの出力を一度保存し、別のエージェントがそれを検証するフローを組む。GPT-Rosalindが数千のエージェントで解析したように、小規模な開発でも「生成」と「検証」を往復させるだけで、バグの混入率は下がる。
- 「何を知らないか」をAIに自覚させる
自分のツール開発において、AIが回答に窮したときに「適当に回答せず、検索を実行する」というガードレールをプロンプトに仕込む。Claudeのようなモデルは、システムプロンプトで「検索ファースト」を徹底させるだけで、ハルシネーションの発生率を自発的に下げる。
これらのアプローチは、今日からプロンプトの書き方を変えるだけで実行できる。AIを「全知全能の執筆家」として扱うのではなく、「適切なツールと検索権限を持たせた専門家チーム」として扱う。この意識の切り替えが、開発者の生産性を引き上げる鍵だ。
明日からは、プロンプトを書くたびに「これはエージェントが自律的に検索できる指示になっているか?」と自問自答してみる。それだけで、AIから返ってくるコードや回答の質は変わる。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
AIエージェントに複雑な解析をさせる際、プロンプトで工夫すべき点は?
役割・検索ルール・ツール利用基準を階層的に定義する。特に、エージェントが自身の知識不足を検知して外部検索を走らせるよう、具体的な検索トリガーを明示的に指示に組み込むことで、推論の精度と網羅性が向上する。AIが「何を検索すべきか」を判断できるまでタスクを具体化するのがコツだ。
分散エージェントによる解析は、小規模な開発環境でも再現可能か?
可能だ。数千のエージェントを並列化する大規模な事例も、本質は「タスクの分解」と「外部知識との接続」にある。開発者は、タスクを「調査」「検証」「統合」のステップに分け、各段階で適切なツールを呼び出すエージェントを構築することで、同様のアーキテクチャを実装できる。小さなタスクで、エージェント同士が情報をやり取りするフローを組むことから始める。
Claude Codeで検索機能を最大限に活かすコツはあるか?
Claudeが「一般知識で答えられる」と判断して検索を省略するのを防ぐため、検索トリガーを意識的に混ぜる。「最新の」「現在の」といった言葉を添えるだけでなく、「〇〇プロジェクトの仕様書を参照して」のように、検索可能な固有名詞を入れるのが有効だ。AIに「何を知らないか」を自覚させ、不足情報を能動的に補完させる構造を作れば、開発効率は高まる。
まとめ
AIは「賢い回答者」から「自律的な実務者」へと役割を変えた。数千のエージェントを束ねる解析手法も、個人の開発環境におけるシステムプロンプトの設計も、本質は同じだ。タスクを細分化し、AIが「何を知らないか」を自覚して能動的に検索へ向かう構造を作れるかどうかが、成果を分ける。
Claude Codeでの開発も、単にコードを書かせるだけでなく、検索トリガーを意識したプロンプトで「AIの能力境界」を拡張していくのが近道だ。僕もバッチ処理の設計を見直して、より自律的なエージェント連携を試してみる。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
