


AIエージェントの精度向上に悩む開発者は多い。ベンチマークスコアだけを追っても、実務で役に立たないケースが後を絶たないからだ。AIの評価には「多数決」や「平均スコア」の盲点を突くフレームワークが必要だ。今日から実践できる評価手法をまとめる。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
1. 血統(ベンダー)の多様性による判定
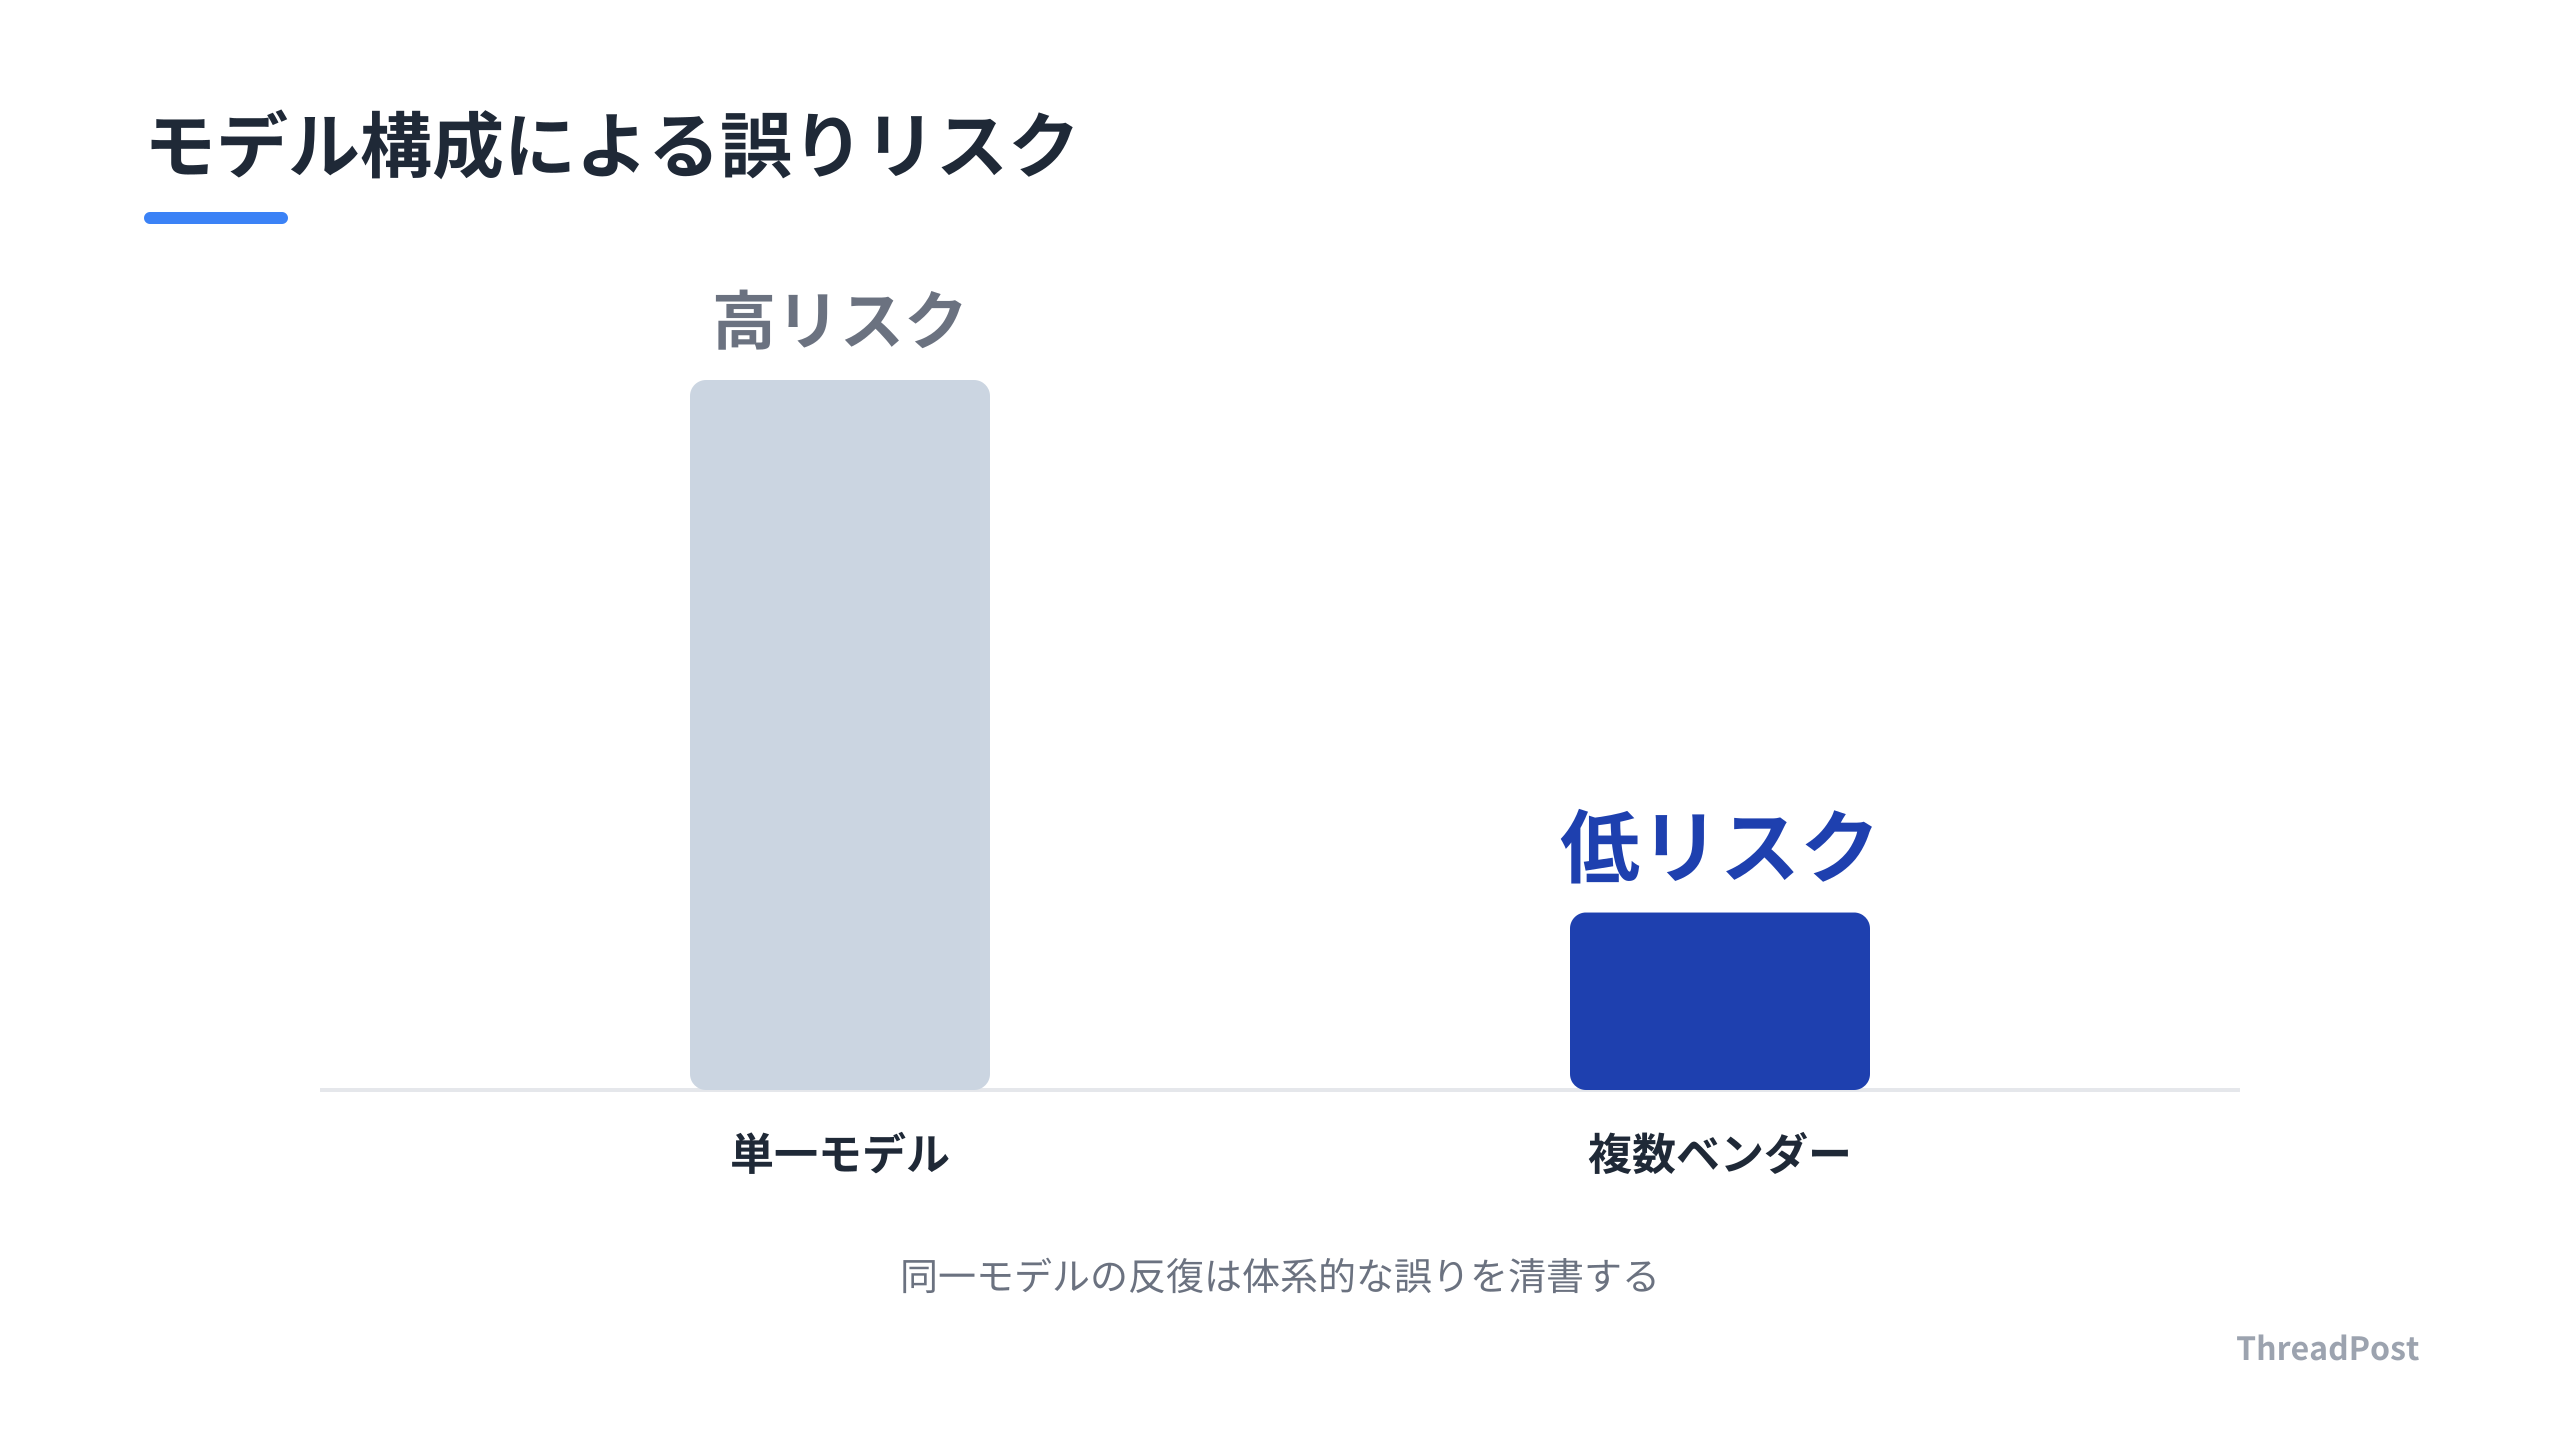
AIにディベートをさせ、多数決で回答を決める手法がある。これは確率的なブレを抑える有効な手段だ。ただし、同じモデルだけで繰り返すと、モデル固有の体系的な誤りまで清書してしまう。温度(Temperature)を上げても分布の中心は動かないからだ。
Anthropic、OpenAI、Googleなど、訓練の系譜が異なるモデルを組み合わせるのが鉄則だ。特定のモデルが抱える盲点を、他方の視界で補完する。
* メリット: モデル固有の体系的な誤りを未然に防げる
* デメリット: APIコストが増大し、実装の複雑度が増す
2. 判定者の「採用面接」テスト
審判AIを導入する前に、弁別力を測定する「採用面接」を行う。正しい主張の中に、論理を反転させた「偽主張」を混ぜたテストセットを用意する。偽主張を「正しい」と判定する確率が高いモデルは、審判として不適格だ。
この試験を通過したモデルだけを評価団に加える。あやふやな審判に判断を委ねるのは、間違った答えを選ぶのと同じだ。
* メリット: 審判AIの信頼性を定量的に担保できる
* デメリット: 高品質なテストセット作成に工数がかかる
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
3. 質問タイプ別の100問並列評価
合計スコアだけで判断するのは危険だ。質問を「局所・時系列・推論」などのカテゴリに分解する。手法の強みと弱みはカテゴリによって真っ二つに割れる。
ユーザーが頻繁に投げる質問タイプで勝てる手法を選択する。たとえ全体スコアが低くても、重要な質問で勝っている手法の方が実運用では価値が高い。
* メリット: 実運用での失敗リスクを大幅に下げられる
* デメリット: 質問カテゴリの設計と分類作業が必要
4. プロダクト意思決定からの逆算
技術的な調整の前に「どの間違いが許容されるか」を定義する。セキュリティツールなら、偽陽性の削減よりもリコールの維持を優先する。
技術的な改善よりも、ビジネス上の優先順位を評価基準に落とし込む作業が先だ。開発の方向性がブレないための羅針盤になる。
* メリット: 開発の方向性がビジネス価値に直結する
* デメリット: 技術的な改善よりも要件定義に多くの時間がかかる
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
5. 決定論的チェック(出典照合・再現実行)
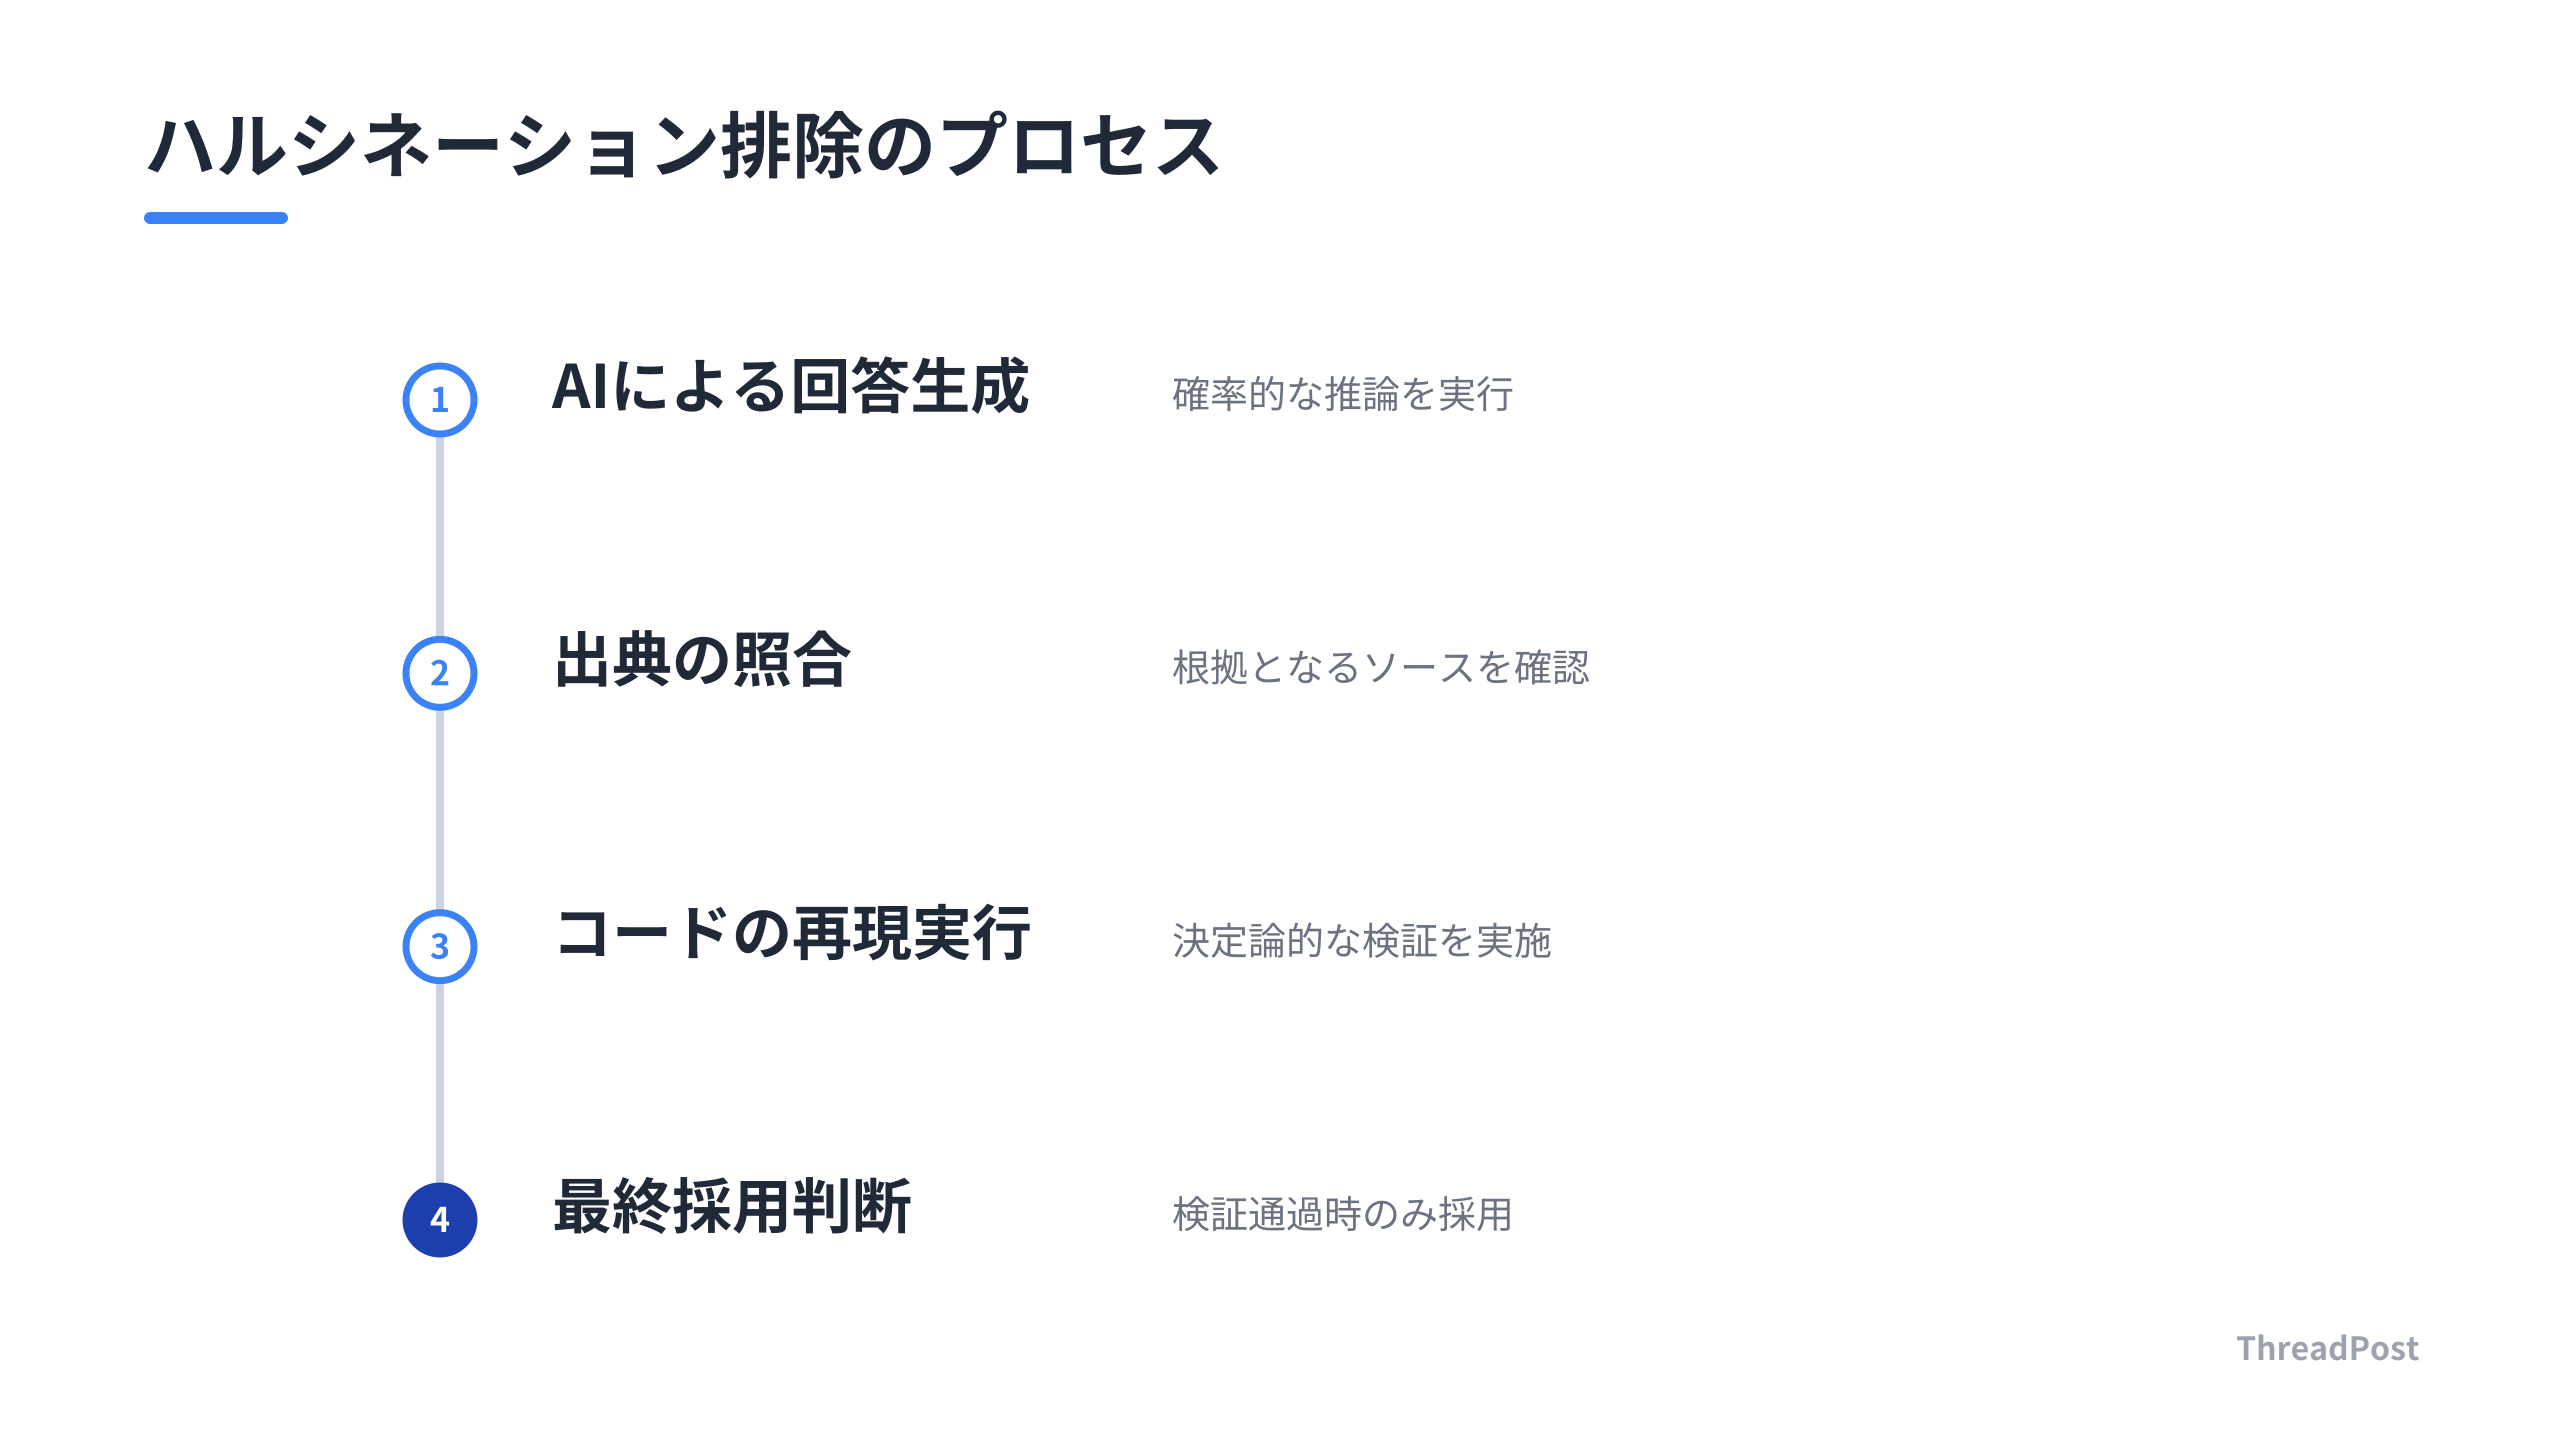
AIによる確率的な判定を過信しない。最終的には出典の照合やコードの再現実行など、決定論的な検証を組み込む。
AIが何体賛成しても、出典が確認できない場合は採用しない。これがハルシネーションを確実に排除するための「最後の砦」だ。
* メリット: AIの嘘を確実に排除できる
* デメリット: 自動化が難しく、人間による確認が必要
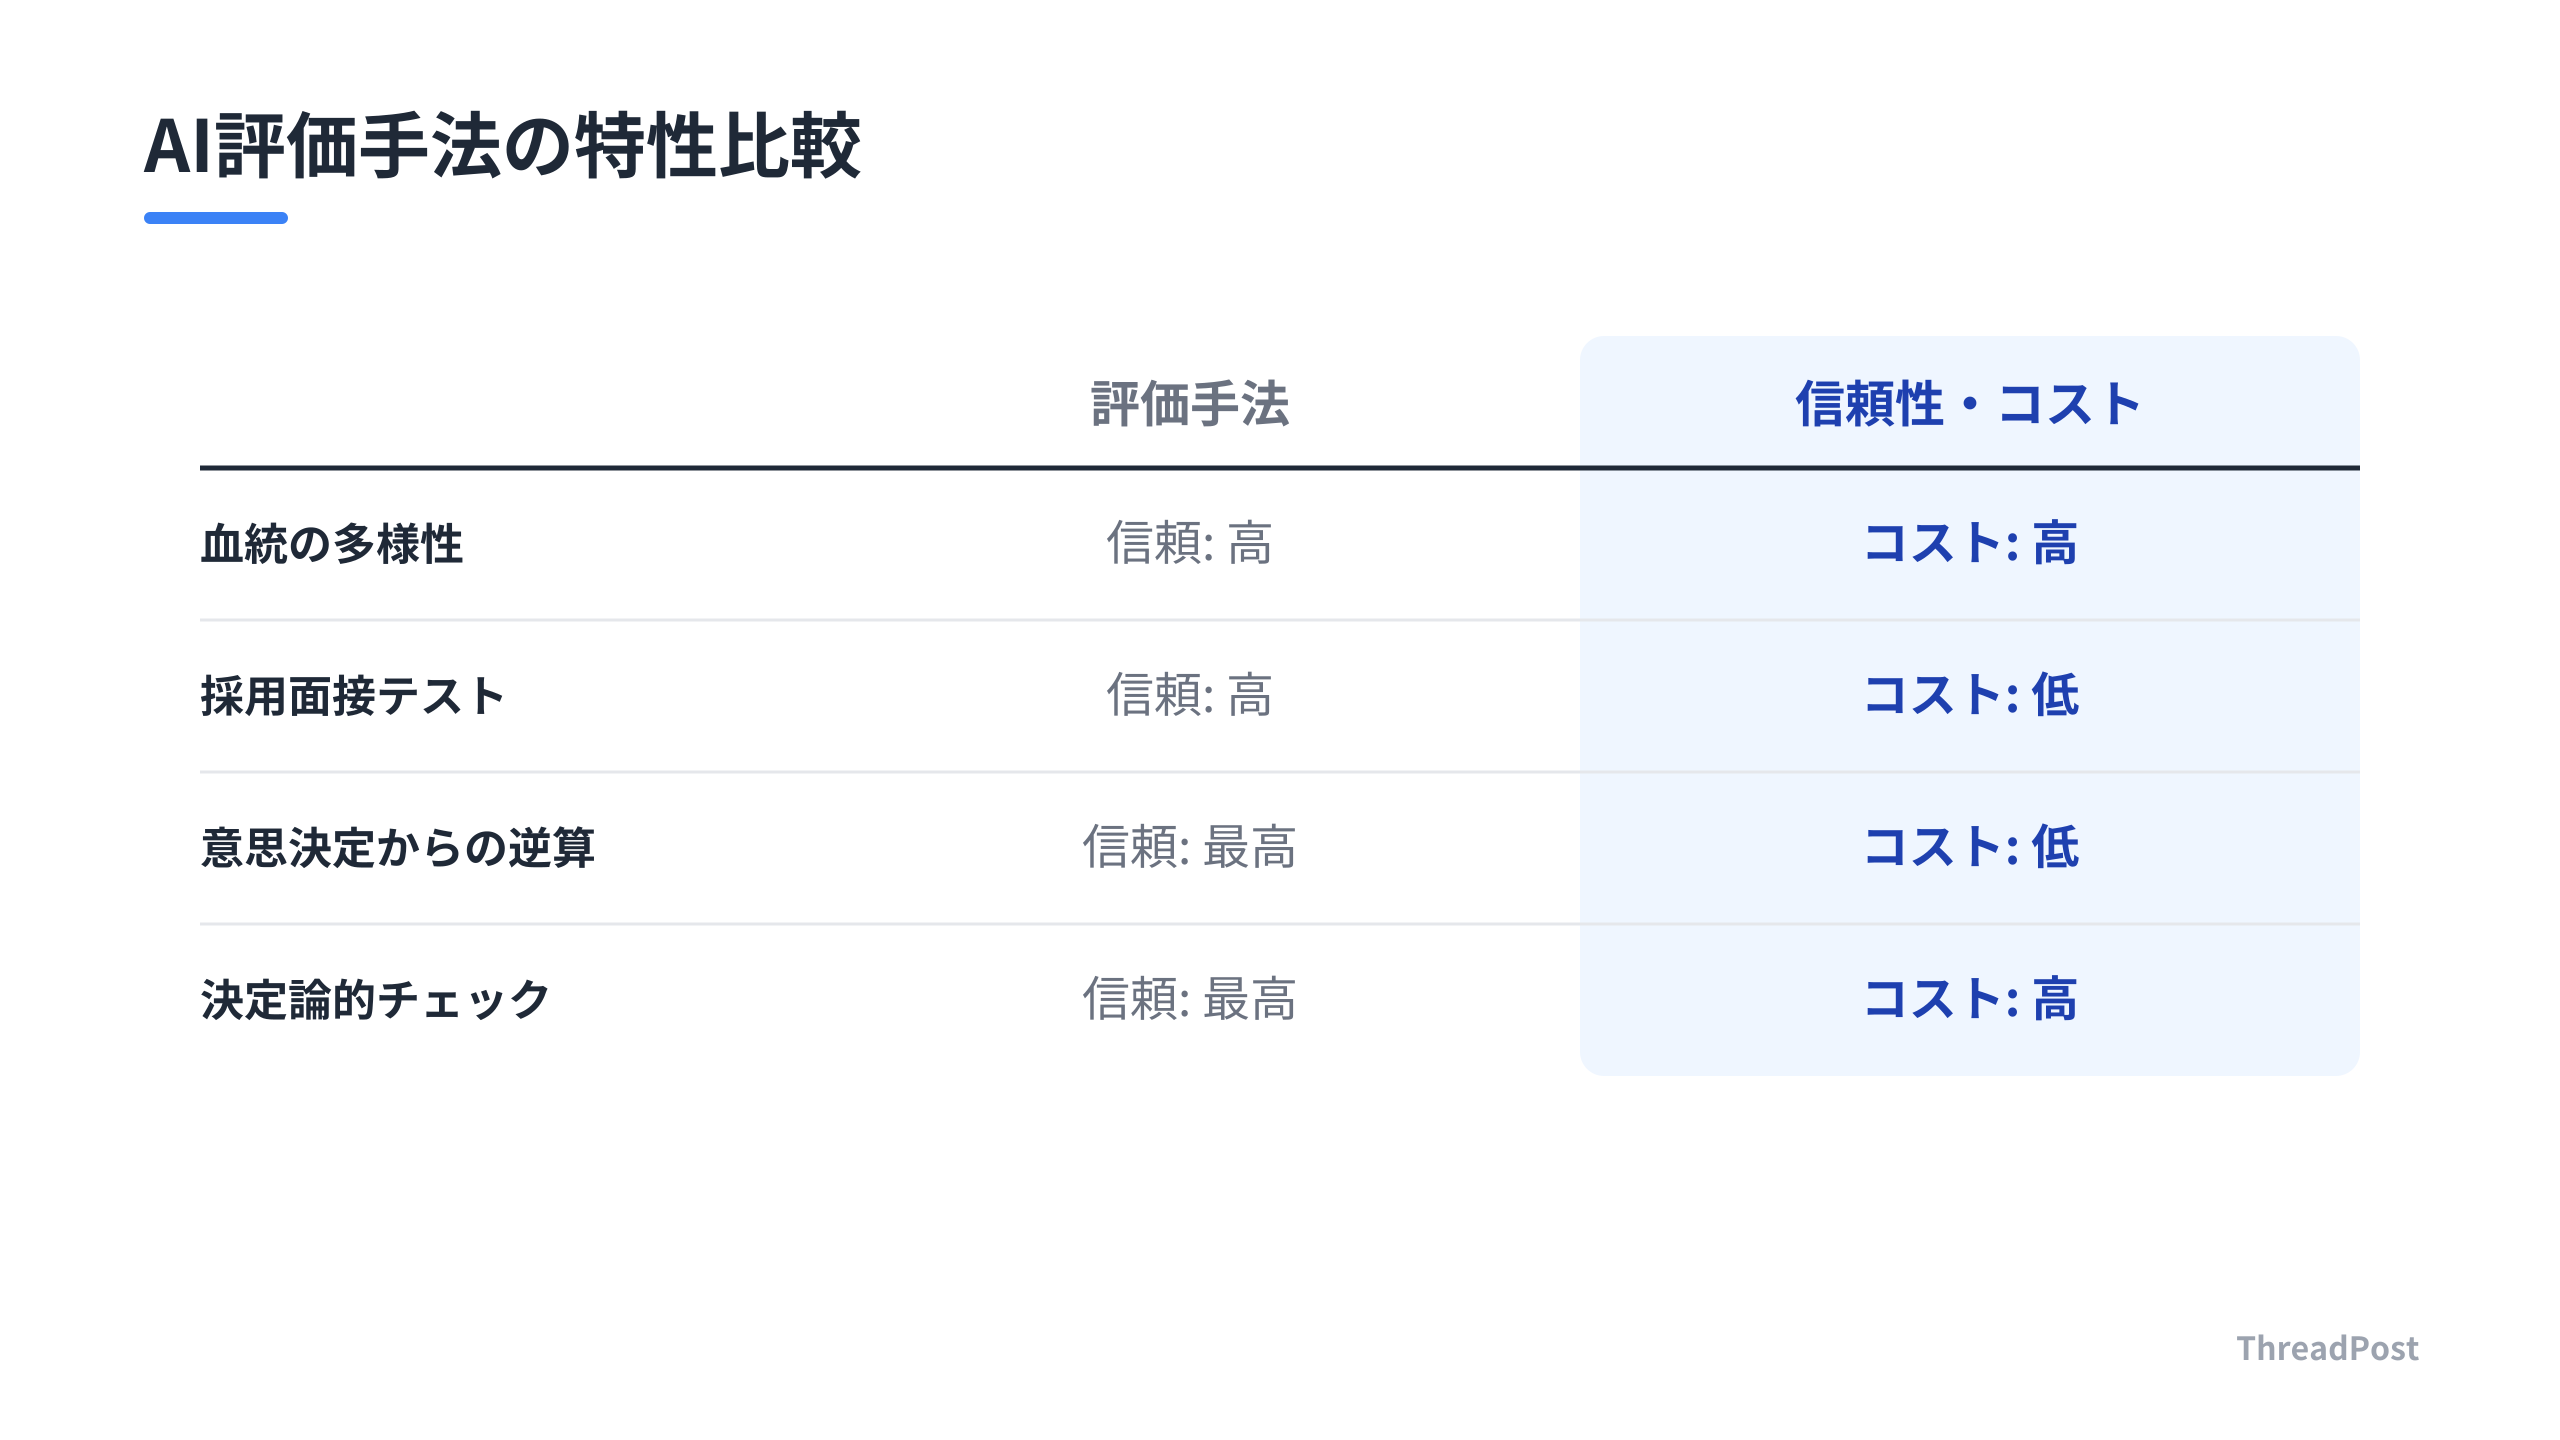
| 評価手法 | 難易度 | 信頼性 | コスト |
|---|---|---|---|
| 血統の多様性 | 中 | 高 | 高 |
| 採用面接テスト | 低 | 高 | 低 |
| 質問タイプ別評価 | 中 | 高 | 中 |
| 意思決定からの逆算 | 高 | 最高 | 低 |
| 決定論的チェック | 高 | 最高 | 高 |
しんたろー:
血統の多様性は重要だ。1つのモデルに依存せず、複数の視点を組み合わせてコードの整合性を担保する癖がつくと、開発の精度が変わる。
しんたろーのイチ推し手法
イチ推しは「判定者の採用面接」だ。審判AIを信頼しきってしまう前に、偽の主張を混ぜて「こいつは本当に正しい判断ができるのか」を試す。この一手間だけで、本番環境での誤判定を大幅に減らせる。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
FAQ
Q1: AIを200回議論させれば精度は上がりますか?
A1: それだけでは不十分だ。200回議論させることで確率的なブレは確認できるが、モデルそのものが持っている体系的な誤りや歪みは修正されない。同じモデルで繰り返すと、同じ嘘を200回清書するリスクがある。多様なベンダーのモデルを組み合わせるか、決定論的な検証を併用することが不可欠だ。
Q2: 評価用のテストセットはどう作ればいいですか?
A2: 実際のユーザーログから抽出したよくある質問と、回答が難しい境界線上の質問を混ぜるのがベストだ。特に、わざと論理を反転させた偽の主張や、回答が複数に分かれるような曖昧な質問をセットに含める。これにより、AIの弁別力を正確に測定できる。
Q3: GraphRAGと従来RAG、どちらを使うべきですか?
A3: どちらか一方が常に優れているわけではない。局所的な事実確認には従来RAGが強く、プロジェクトを横断した関係性や多段推論が必要な質問にはGraphRAGが適している。自社のユースケースが事実検索寄りか分析寄りかを見極め、必要であれば両方を使い分けるのが正解だ。
Q4: 評価コストが高すぎて困っています。
A4: すべての質問を評価するのではなく、プロダクトの成功に直結するクリティカルな質問に絞って評価セットを作成する。また、審判AIの採用面接を行う際は、APIコストを抑えるために、まずは少数のテストセットで弁別力を確認し、合格したモデルのみを本番の評価に回すといった段階的な運用が有効だ。
Q5: AIの評価で一番やってはいけないことは?
A5: 合計スコアだけで良し悪しを判断することだ。特定のカテゴリで致命的なミスをしていても、全体平均で隠れてしまうことがよくある。ユーザー体験に直撃する「絶対に外してはいけない質問」で負けていないかを、必ずカテゴリ別に分解して確認する。
まとめ
AIエージェントの精度向上は、地道な評価プロセスの構築にかかっている。ベンチマークの数字に踊らされず、自社のプロダクトで何が重要かを定義する。血統の多様性を意識し、厳格なテストを繰り返すことで、実務に耐えうるAIシステムを構築できる。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
