


AIエージェントは驚異的な速度でコードを書く。しかし、もっともらしい間違いも同じ速度で生成する。開発のボトルネックは「コードを書くこと」から「AIの成果物を受け入れてよいか判断すること」へシフトした。本記事では、AIを信じすぎず、仕組みで品質を担保するための実践的なTipsを5つ紹介する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
1. Claude CodeのHookを活用した実装プランの自動レビュー
Claude Codeで開発を進める際、プラン作成時に自動でレビューを走らせる仕組みを構築する。まず設定でプランの保存先を固定する。次に「特定のパスへの書き込み」を検知するフックを定義し、書き込み後にAIによるレビューを自動実行させる。
この手法の最大の利点は、実装に着手する前の「プラン段階」で論理矛盾を潰せることだ。人間が承認ボタンを押す前に、AI同士でプランの抜け漏れを反復修正させる。これにより実装後の手戻りが減る。設定には一定の学習コストがかかるが、一度構築すれば開発の安定感は高まる。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
2. AIの成果物を疑う「5層の品質ゲート」設計
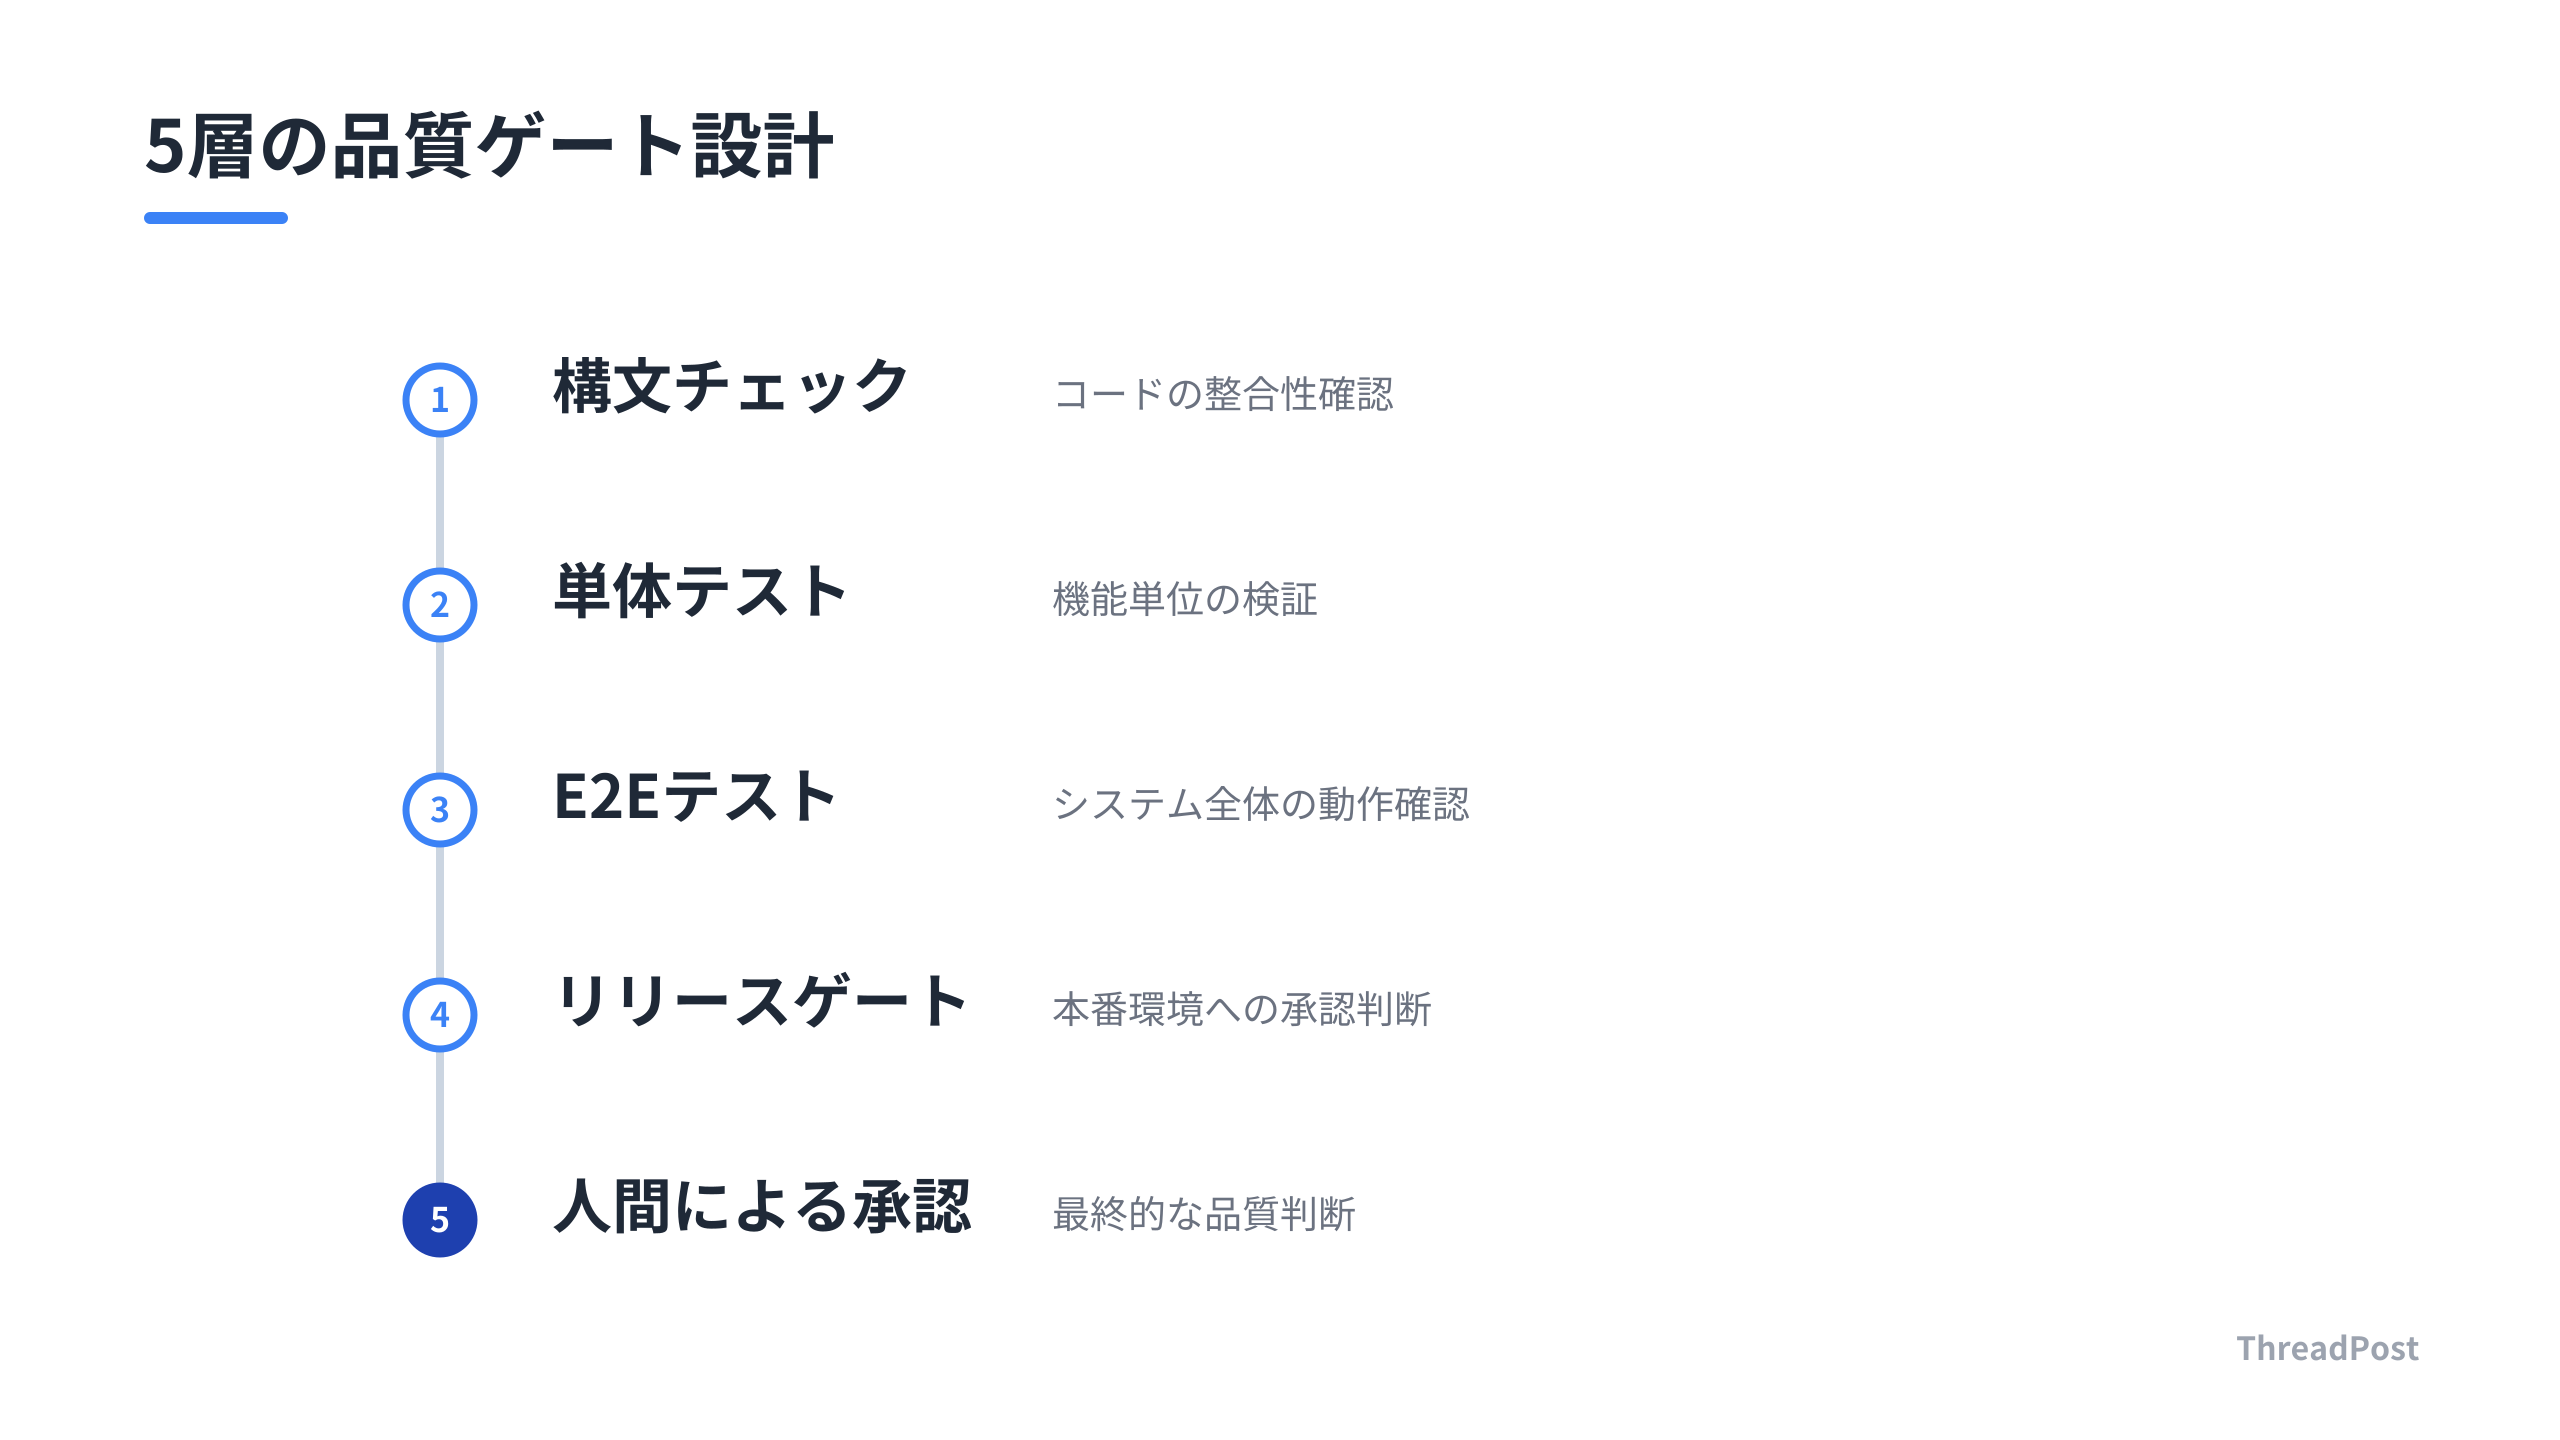
AIの生成物を無条件に信用してはならない。検証レベルを5層に分け、各段階で機械的なゲートを設ける。構文チェックから始まり、E2Eテスト、リリースゲートまでをコマンド化する。AIが実行した結果を人間が「合格か否か」判断する責任境界を明確にすることが重要だ。
失敗時にどの工程へ戻るべきかが明確になるため、デバッグの迷走を防げる。テスト定義やスクリプトの保守運用負荷は増大するが、AIによる高速な変更を安全に受け入れるためには必要な投資だ。
3. 生成役と採点役のモデル分離(クロスモデル検証)
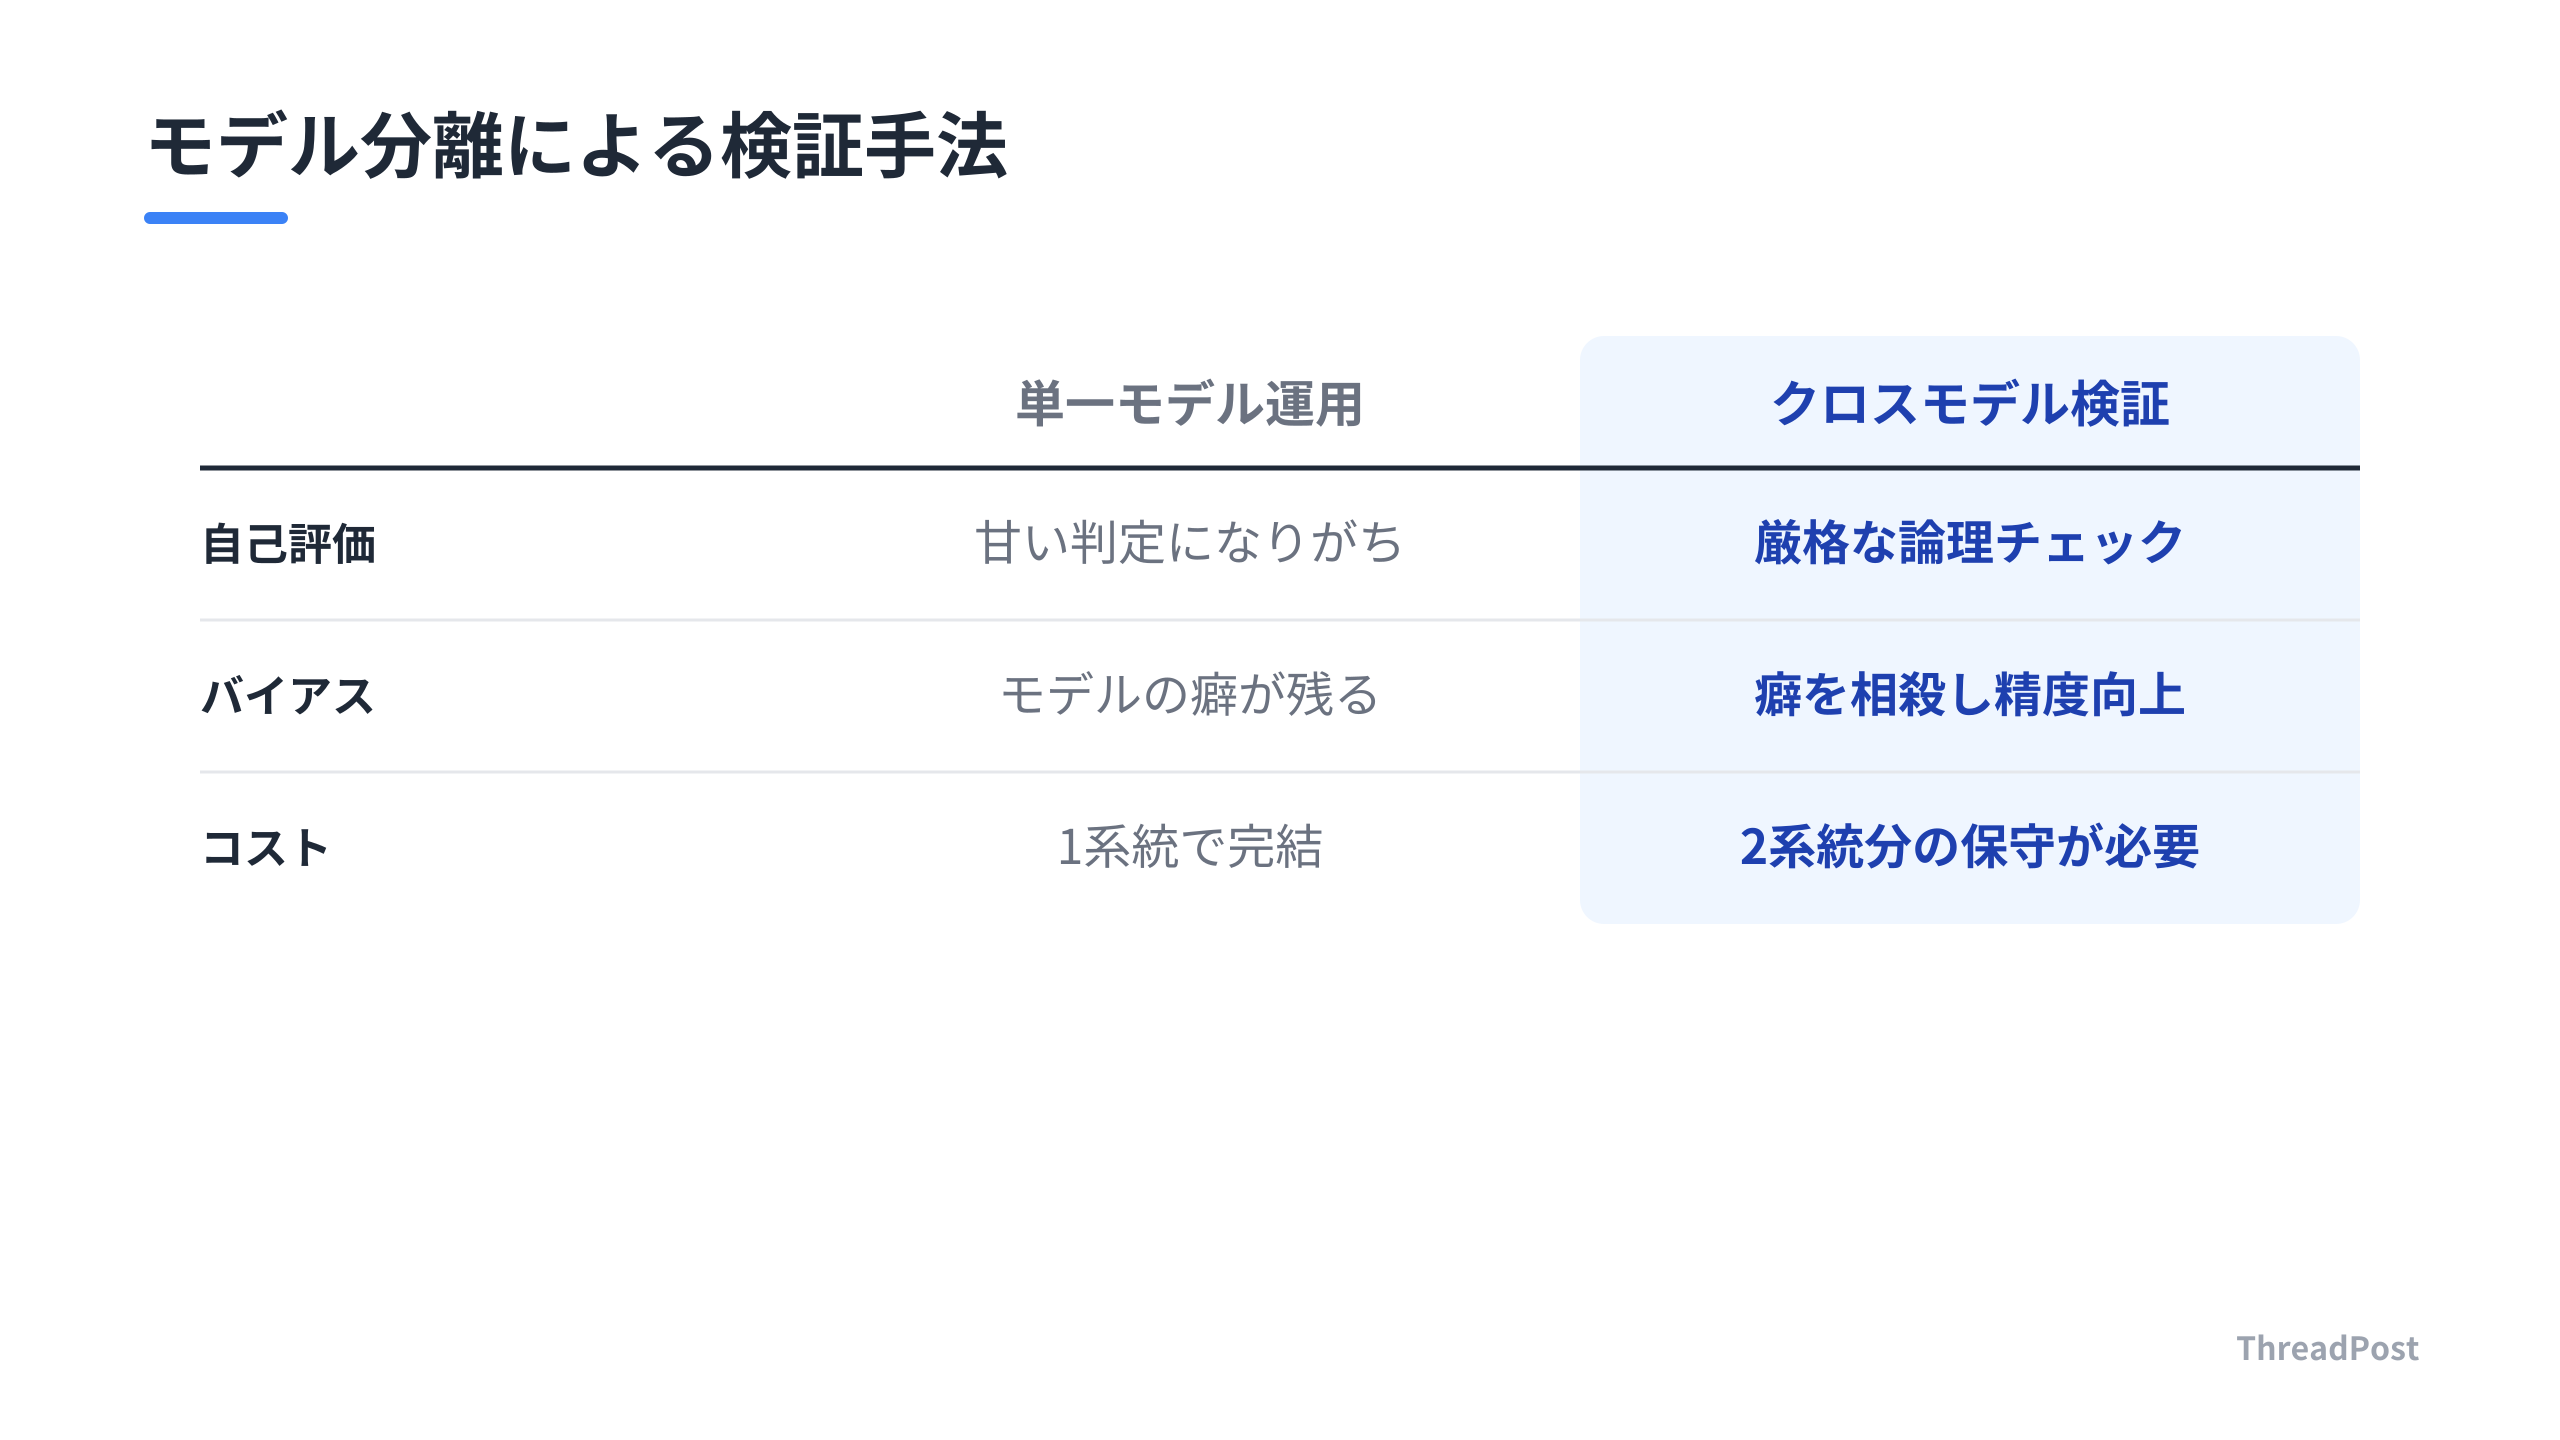
LLMには自分が生成したものを甘く採点する自己評価バイアスが存在する。これを防ぐため、生成モデルと採点モデルを異なるプロバイダに分ける。論理的な欠陥をより厳しく検知し、自動完成判定の精度を底上げできる。
モデルを分けるとAPIコストや保守コストが2系統分必要になる。しかし、特定のモデルの癖を相殺できるため、品質の信頼性は上がる。採点役が正しく機能しているかは、少数の正解データと突き合わせて一致率を計測する運用が基本だ。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
4. 禁止語の正規表現による決定論的検出
LLMに禁止語の遵守を指示するだけでは不十分だ。LLMは指示を無視して禁止語を出力することがある。あるべきでない表現を確実に排除するため、正規表現を用いた機械的なチェックを導入する。
これはLLMのハルシネーションに依存しない確実な品質管理だ。文脈依存で判断が難しい場合は、エラーで止めるのではなく警告として人間に通知する設計にする。決定的手段だからこそ、重大度の設計を丁寧に積み重ねる価値がある。
5. 出典の構造化データ化による根拠の追跡
LLMに根拠のファイル名やURLを記述させると、実在しない情報をでっち上げることがある。これを防ぐため、APIから提供される構造化データを直接利用して出典を管理する。
AIに文章で書かせるのではなく、システム側で管理されたIDやパスを利用する。これにより、回答の根拠がどこにあるかをプログラム的に追跡できる。利用するAPI仕様への依存度は高まるが、情報の正確性は向上する。
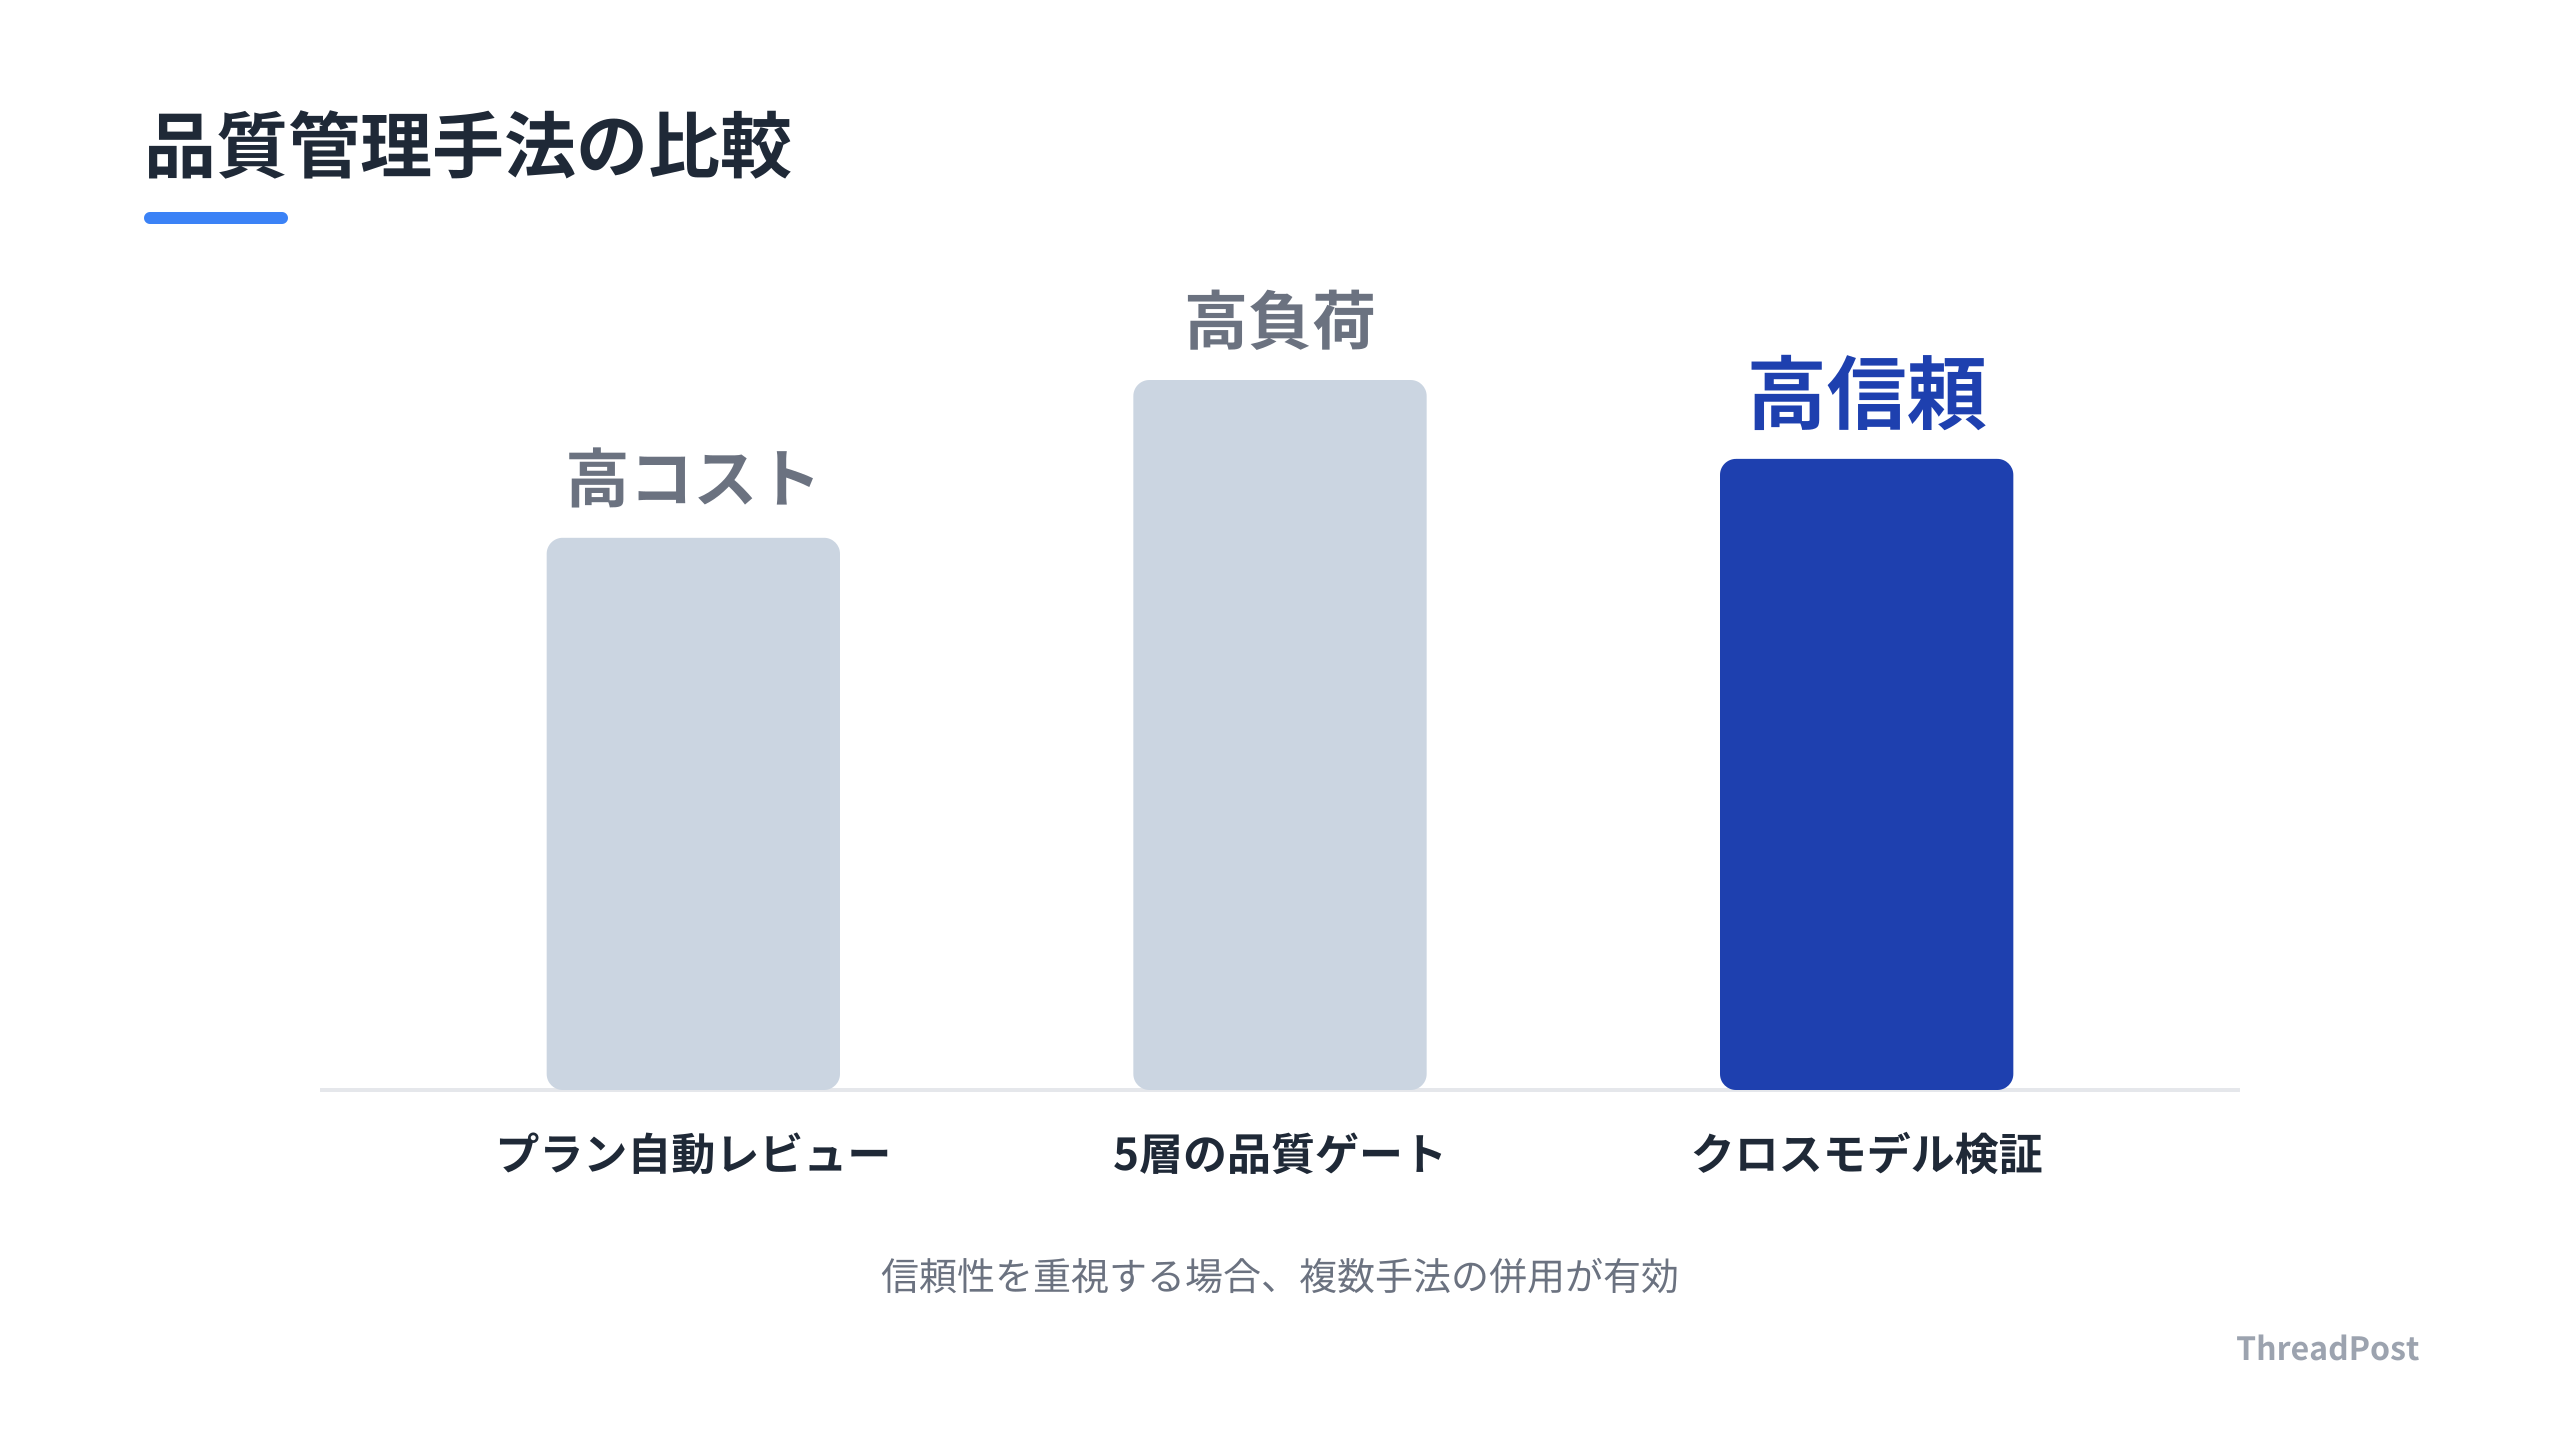
| 手法 | メリット | デメリット |
|---|---|---|
| プラン自動レビュー | 実装前の論理チェックが可能 | 設計と設定に工数がかかる |
| 5層の品質ゲート | 失敗時の戻り位置が明確 | 保守運用負荷が増大する |
| クロスモデル検証 | 自己評価バイアスを排除 | 2系統分の保守コスト発生 |
| 正規表現による検出 | 誤検出を物理的に防げる | 文脈判断には別途設計が必要 |
| 構造化データ管理 | 根拠の正確性が高い | API仕様への依存が生じる |
しんたろー:
Claude Codeでコードを書く際、プランの自動レビューは導入して良かった。自分で書いたプランを自分で眺めるより、AIに厳しく突っ込んでもらった方が論理の穴が減る。
構造化データでの出典管理も、最初は面倒に感じるかもしれない。でも、後から情報源を探す時間を考えれば、最初に仕組み化しておくのが近道だ。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
FAQ
Q1: AIにテストコードまで書かせるのは危険ではないか
危険だ。しかし、AIが書いたテストをそのまま信用するのではなく「テストが何を検証すべきか」という要件を人間が定義し、テスト自体が正しく機能しているかを人間がレビューするプロセスが必要になる。テストが通っても不具合がすり抜けることを前提に、E2Eや契約テストなど複数の層で検証を重ねる多重防御の考え方が重要だ。
Q2: AIのレビューにAIを使うと、結局どちらも間違えるのではないか
その通りだ。そのため、生成役とレビュー役のモデルを分けるクロスモデル検証を行うことで、特定のモデルの癖やバイアスを相殺させる。また、AIのレビュー結果を鵜呑みにせず、あくまで人間がチェックすべきポイントを指摘してもらうための補助ツールとして位置づけるのが現実的な運用だ。
Q3: 品質ゲートを細かくしすぎると開発速度が落ちるのではないか
初期構築のコストはかかるが、結果として手戻りが減るため、中長期的には開発速度が向上する。特にAIはもっともらしい間違いを高速で生成するため、後工程でのバグ修正コストを考えると、早い段階で自動ゲートを通過させる方がトータルの工数は削減できる。
Q4: 正規表現でのチェックはLLMの柔軟性を損なわないか
柔軟性が必要な文章のトーンなどはLLMに任せ、絶対に守るべきルールのみを正規表現で固定する。すべてをLLMに任せず、決定論的なルールと確率論的な生成を使い分けるのが、堅牢なAIシステム構築の鉄則だ。
Q5: 個人開発でここまでやる必要はあるか
個人開発こそ、AIを優秀なペアプログラマーとして活用するために品質管理が重要だ。AIに実装を任せて自分は品質ゲートの設計と承認に回ることで、一人でもチーム開発に近い品質を維持しながら、開発規模を拡大することが可能になる。
まとめ
AIエージェント開発において、品質管理の本質はAIを信じるか疑うかではない。検証の境界をどこに引くかだ。AI同士の相互レビューや決定論的なチェックを自動化し、人間が価値判断に集中できるゲートを設計する。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
