


AIエージェントの性能を引き出せないと悩む時間は終わりだ。Claude Opus 5のような高性能モデルが登場した今、重要なのはプロンプトの「言葉の工夫」ではない。情報の構造と質を最適化する「コンテキスト工学」こそが、AIを真のパートナーにする唯一の鍵だ。今日からこの手法を取り入れると、AIの推論精度は劇的に向上する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
コンテキスト工学に必要な前提知識
AIエージェントを動かすために必要なものは、PCと安定したインターネット環境、そして「情報を構造化して渡す」という意識だ。特別なプログラミング知識は不要だ。AIは与えられた情報をそのまま処理する鏡のような存在だ。入力される情報の質が低ければ、出力される結果も低い。まずは「AIに渡す情報は整理されているか」という視点を持つ。
ステップ1:データ基盤の正規化
AI分析の失敗原因の多くは、曖昧なデータ定義にある。複数の計算元を放置せず、正当な源を1つに定めて派生させることで、AIが迷わない「信頼できる唯一の情報源」を構築する。データモデルの整理こそが、AIエージェントの精度を支える土台だ。税込・税抜の混在や、部門ごとに異なる定義を放置してはならない。1つの指標に対して1つの定義を徹底するだけで、AIの回答精度は劇的に向上する。
 あわせて読みたいAIエージェントを自作して本番運用する方法|最小構成の実装とサブエージェント設計 →
ステップ2:セマンティック・レイヤーの導入
指標の定義をコンパイル済みの関数としてAIに提供する手法だ。AIは「売上を出して」という曖昧な指示に対し、定義済みのロジックを呼び出すことで、誰が聞いても同じ結果を得られるようになる。指示の解釈をAIに委ねず、構造的に縛るのがコツだ。組織内で指標の解釈が統一され、AIの信頼性が担保される。
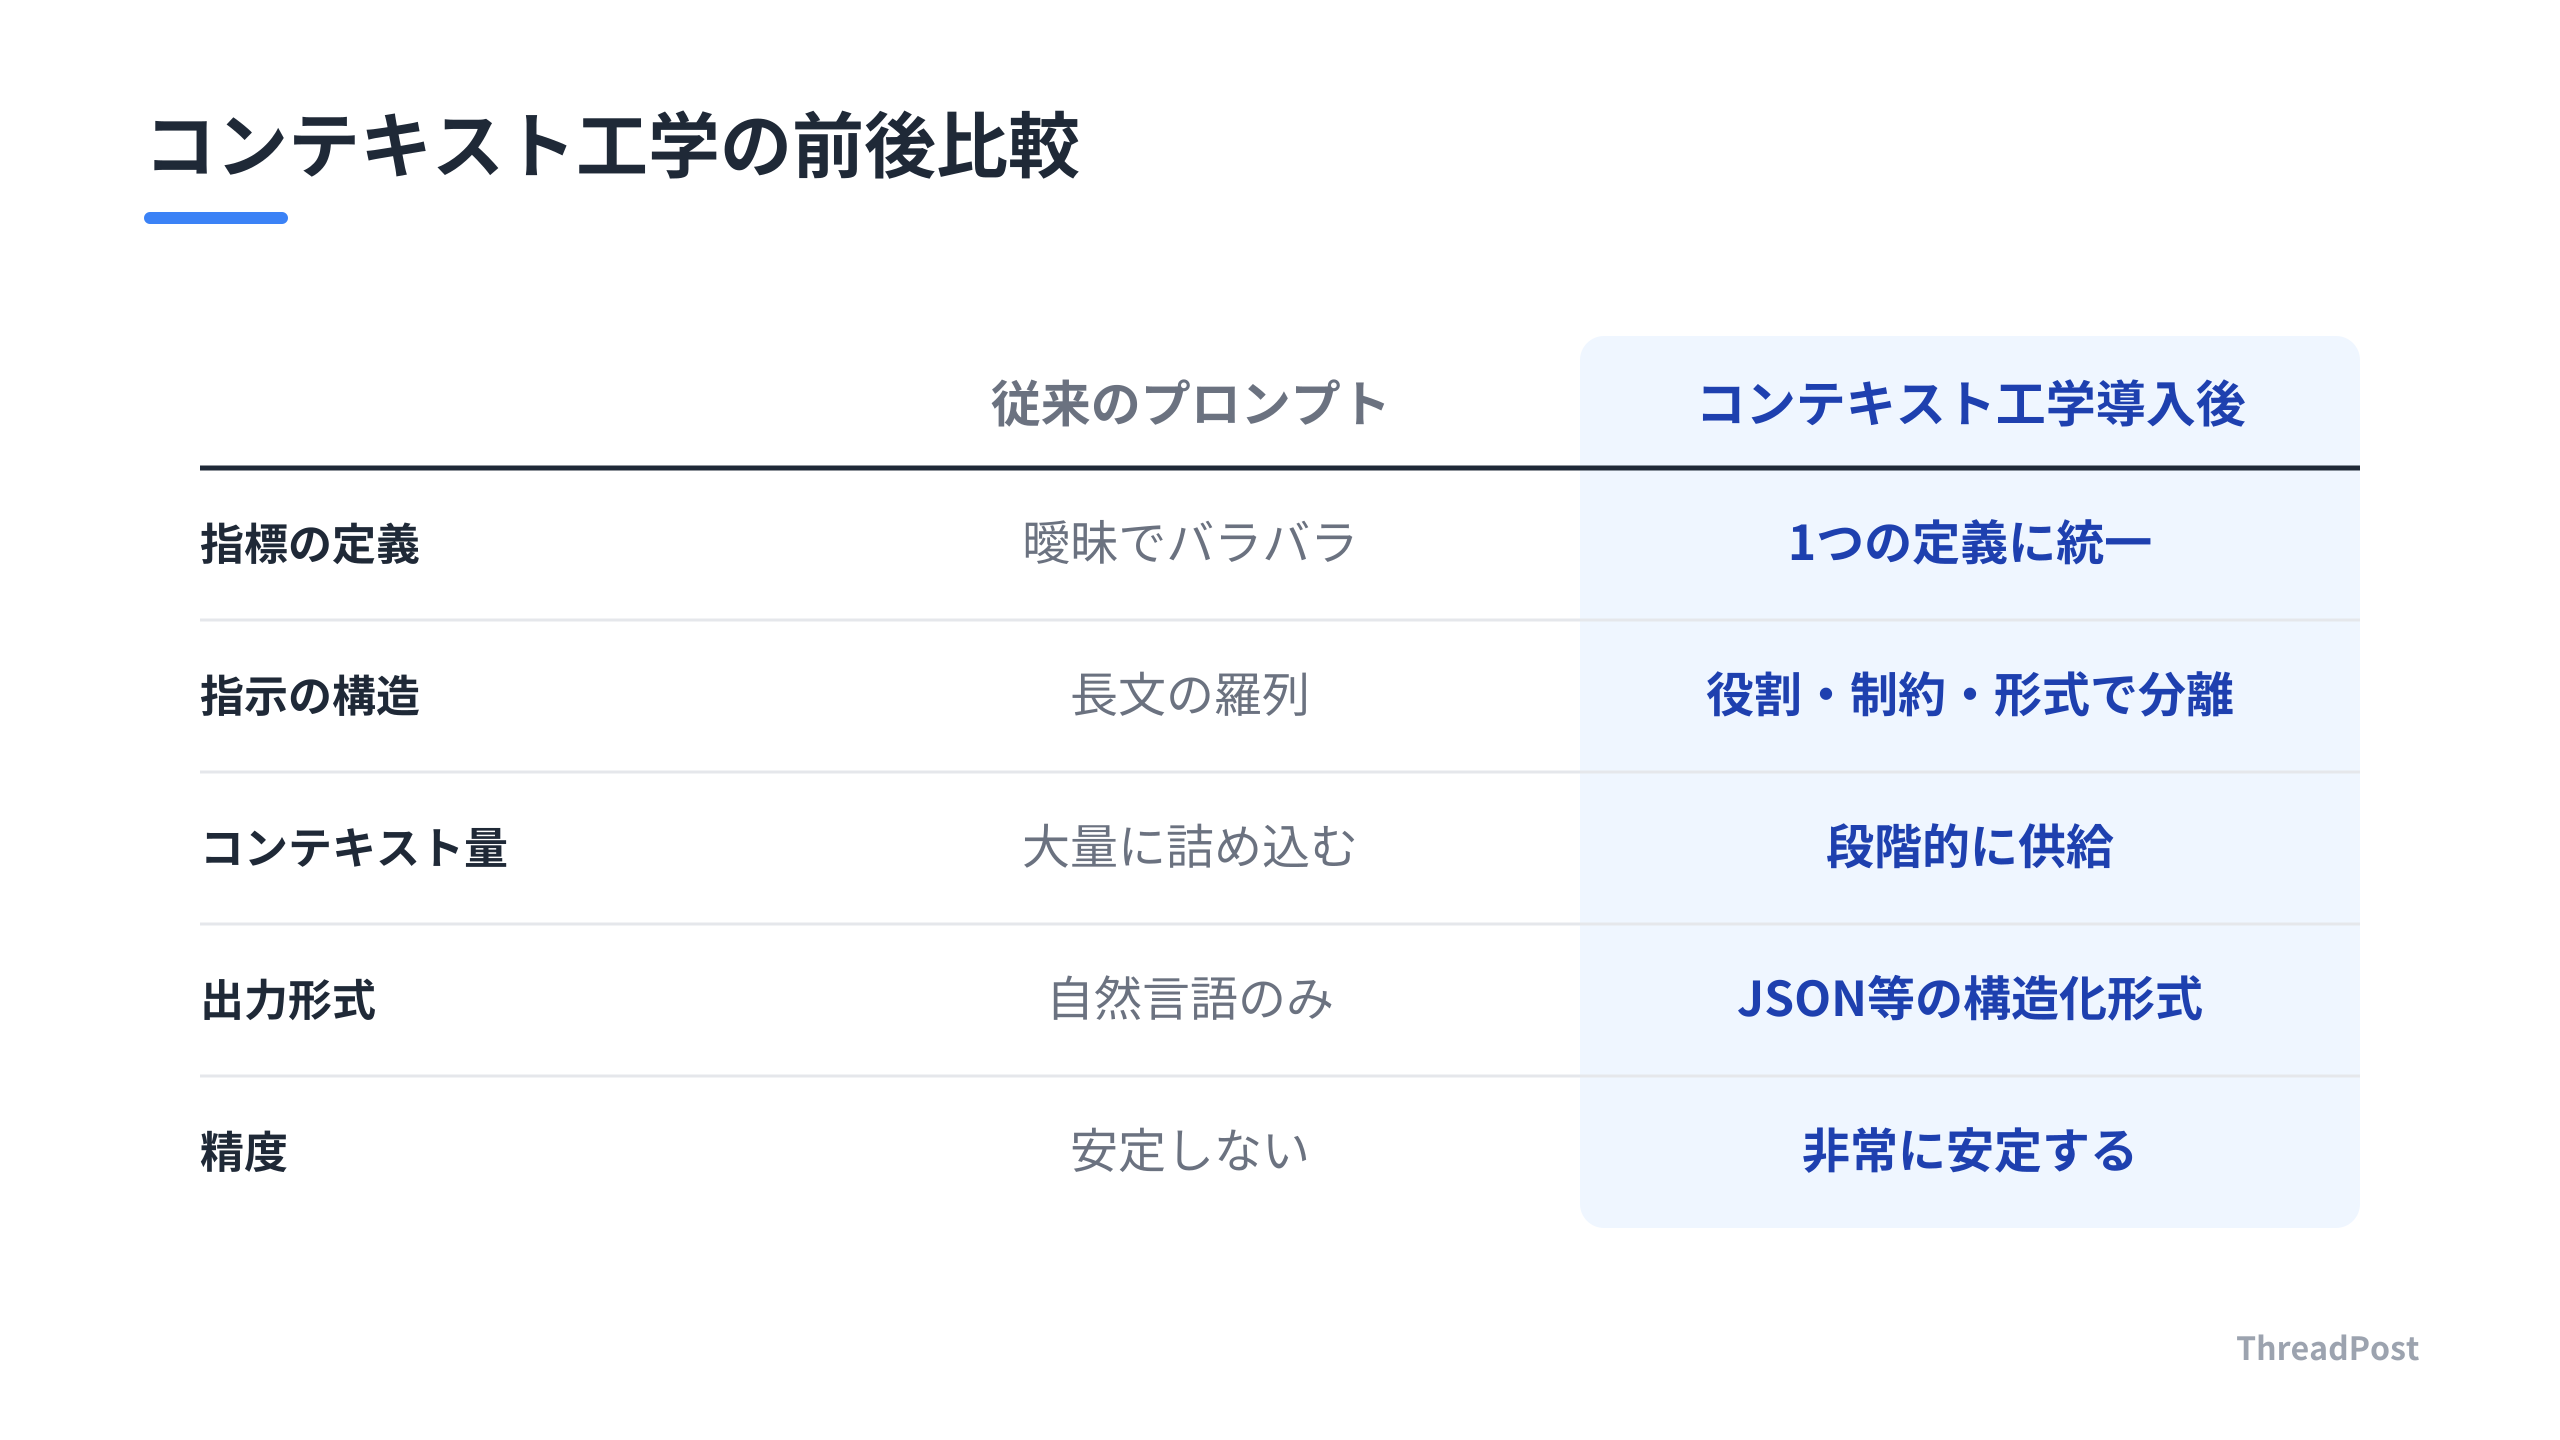
ステップ3:システムプロンプトの構造化
役割、制約、出力形式を明確に分離したセクション分けを行う。見出しや箇条書きを活用し、AIが情報を優先順位付けして読み込めるように設計する。単なる指示の羅列ではなく、AIが処理しやすい「ドキュメントのアーキテクチャ」を意識することが重要だ。役割(Role)、制約(Constraint)、出力形式(Format)を明確にセクション分けすることで、AIの誤解を減らせる。
ステップ4:コンテキストの段階的供給
一度に大量の情報を詰め込むのは逆効果だ。タスクの流れに沿って必要な情報を順次提供する。長文コンテキストの「中だるみ」を回避し、モデルの注意力を最大限に活用するための、情報の出し入れを制御する設計手法だ。重要情報は冒頭に配置し、次に重要な情報を末尾に置くことで、モデルの推論精度を安定させられる。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
ステップ5:出力フォーマットの厳格化
JSONキー名やネスト構造、文字数制限までを具体的に指定する。AIの出力を後工程のシステムでそのまま利用可能な形式に固定することで、人間による修正コストをゼロに近づける。構造化された入力には、構造化された出力で応えさせるのが鉄則だ。
しんたろー:
Claude Codeのようなツールを触っていると、コンテキスト工学の重要性は痛感する。曖昧な指示を投げると、AIも曖昧な回答を返す。逆に、制約と形式をガチガチに固めて渡すと、正確なコードを生成する。コンテキスト設計は、AIという有能な部下をマネジメントする行為そのものだ。
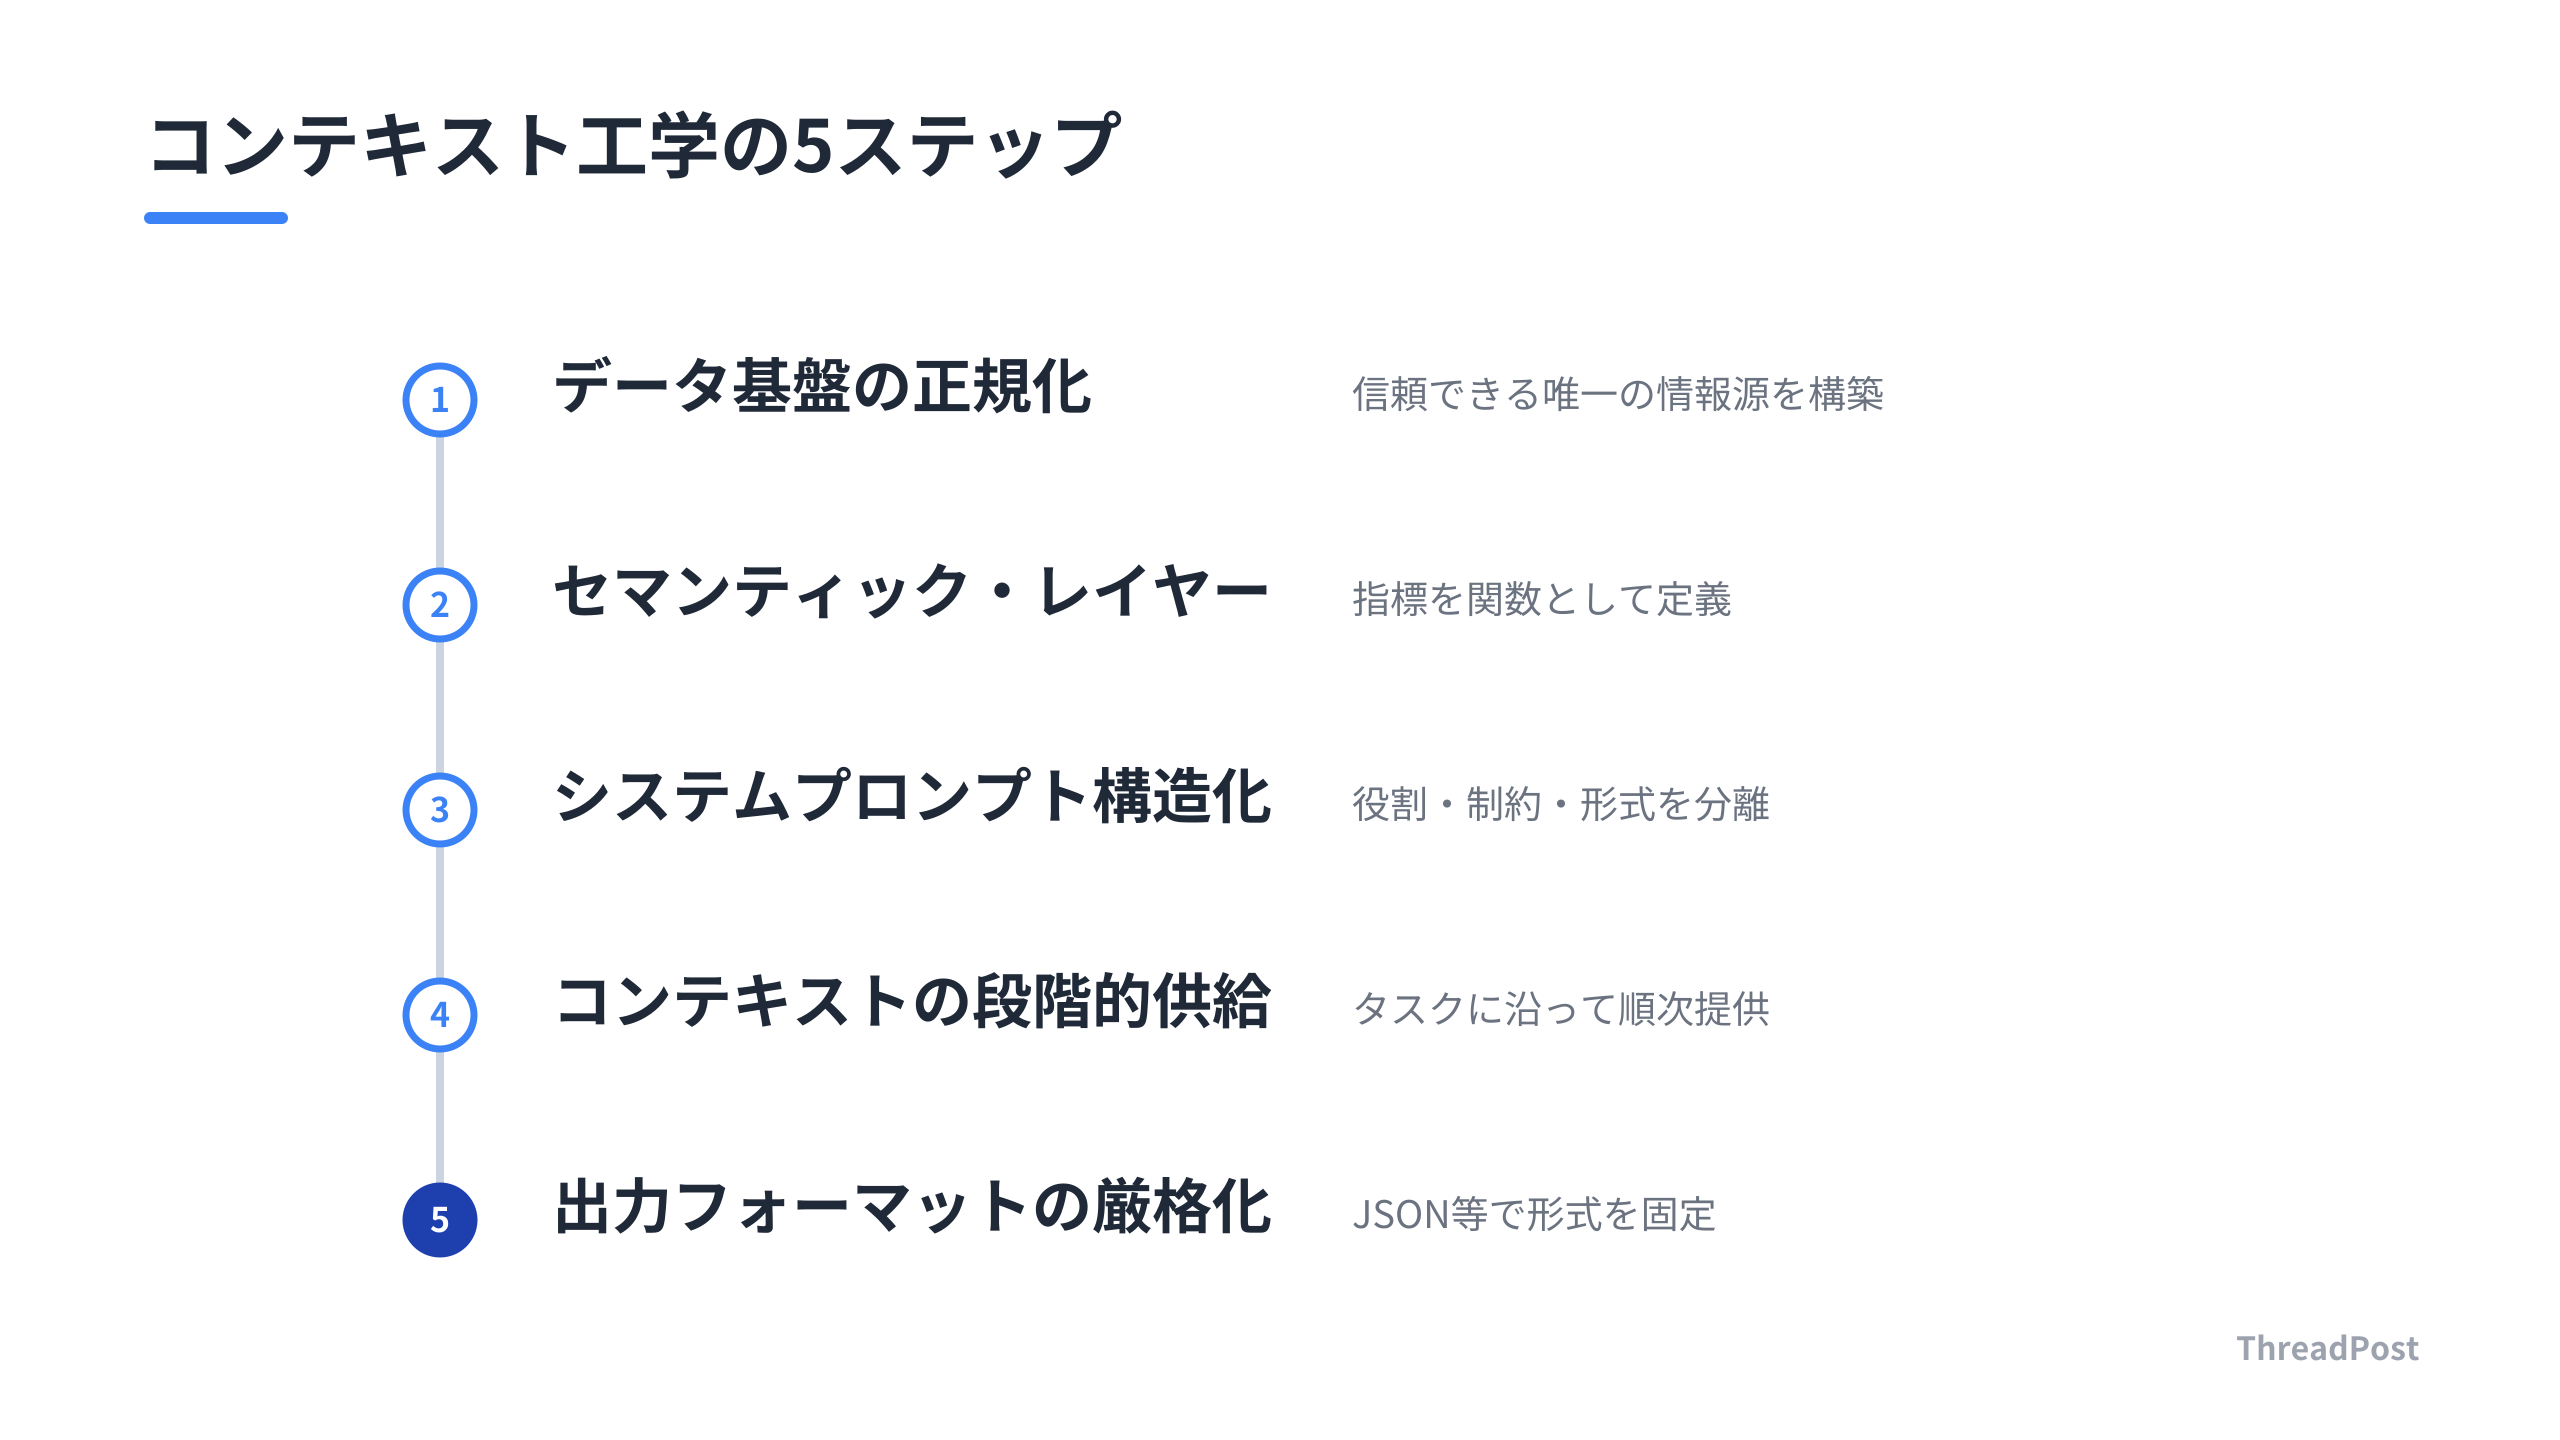
比較表:コンテキスト設計の前後比較
| 項目 | 従来のプロンプト | コンテキスト工学の導入後 |
|---|---|---|
| 指標の定義 | 曖昧でバラバラ | 1つの定義に統一 |
| 指示の構造 | 長文の羅列 | 役割・制約・形式で分離 |
| コンテキスト量 | 大量に詰め込む | 段階的に供給 |
| 出力形式 | 自然言語のみ | JSON等の構造化形式 |
| 精度 | 安定しない | 非常に安定する |
しんたろーの推し:コンテキスト工学の極意
Claude Codeを検証する中で、特に「ネガティブ・プロンプト」の活用は有効だ。「してほしいこと」を並べるよりも、「これだけはやるな」という制約を冒頭に置く方が、AIの暴走を確実に防げる。賢いモデルほど勝手に意図を補完しようとするため、その「余計な親切心」をルールで制限するのが近道だ。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
つまずきポイント
- 情報を詰め込みすぎる: 長ければ良いという考えは間違いだ。ノイズを削ぎ落とす。
- 定義の曖昧さを放置する: 営業とマーケティングで同じ指標の定義が異なると、AIは混乱する。
- 制約を忘れる: 「してはいけないこと」を明示しないと、AIは勝手に意図を補完して行動する。
FAQ
Q1: プロンプトを長く書くのは逆効果か?
A1: はい、過剰な説明はノイズとなり、モデルの精度を下げる可能性がある。最新モデルでは情報の質と構造が重要だ。不要な情報を削ぎ落とし、役割、制約、出力形式を簡潔にまとめる方が、モデルの注意力を適切に引き出せる。
Q2: 「Lost in the Middle」とは何か?
A2: AIが長いコンテキストを読み込む際、冒頭と末尾の情報は記憶しやすい一方で、中盤の情報が軽視される現象のことだ。この対策として、最も重要な指示やデータは先頭に配置し、次に重要な情報を末尾に置くことで、モデルの推論精度を安定させられる。
Q3: コンテキスト工学を学ぶための最初の一歩は?
A3: Anthropicが公開している公式のガイドを参考にすることだ。実務で使えるコードサンプルや、構造化されたプロンプトの設計例が豊富に掲載されている。まずは自分のユースケースに近いサンプルを模倣し、情報の渡し方を少し変えてみることから始めるのが最速だ。
Q4: なぜ分析でAIが間違った数字を出すのか?
A4: 多くの場合、AIの計算能力ではなく「文脈の欠如」が原因だ。社内で定義が曖昧な指標や、最新ではないデータソースを参照していると、AIはもっともらしい数字を捏造する。指標を1つの明確な定義に絞り、AIに参照先を構造的に縛ることで、この問題は大幅に改善できる。
Q5: 構造化プロンプトの具体的なコツは?
A5: 役割、制約、出力形式を明確にセクション分けすることだ。例えば「# 役割」「# 制約事項」「# 出力フォーマット」といった見出しを使い、AIが情報の優先順位を理解できるように設計する。曖昧な指示を避け、期待する結果を具体的に定義することが成功の鍵だ。
まとめ
AIエージェントの性能を引き出す鍵は、モデルの性能向上を待つことではなく、自分自身のコンテキスト設計能力にある。まずはシステムプロンプトの構造化と、出力形式の指定から始める。AIに渡す情報を整理する習慣がつくだけで、生産性は劇的に向上する。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
