


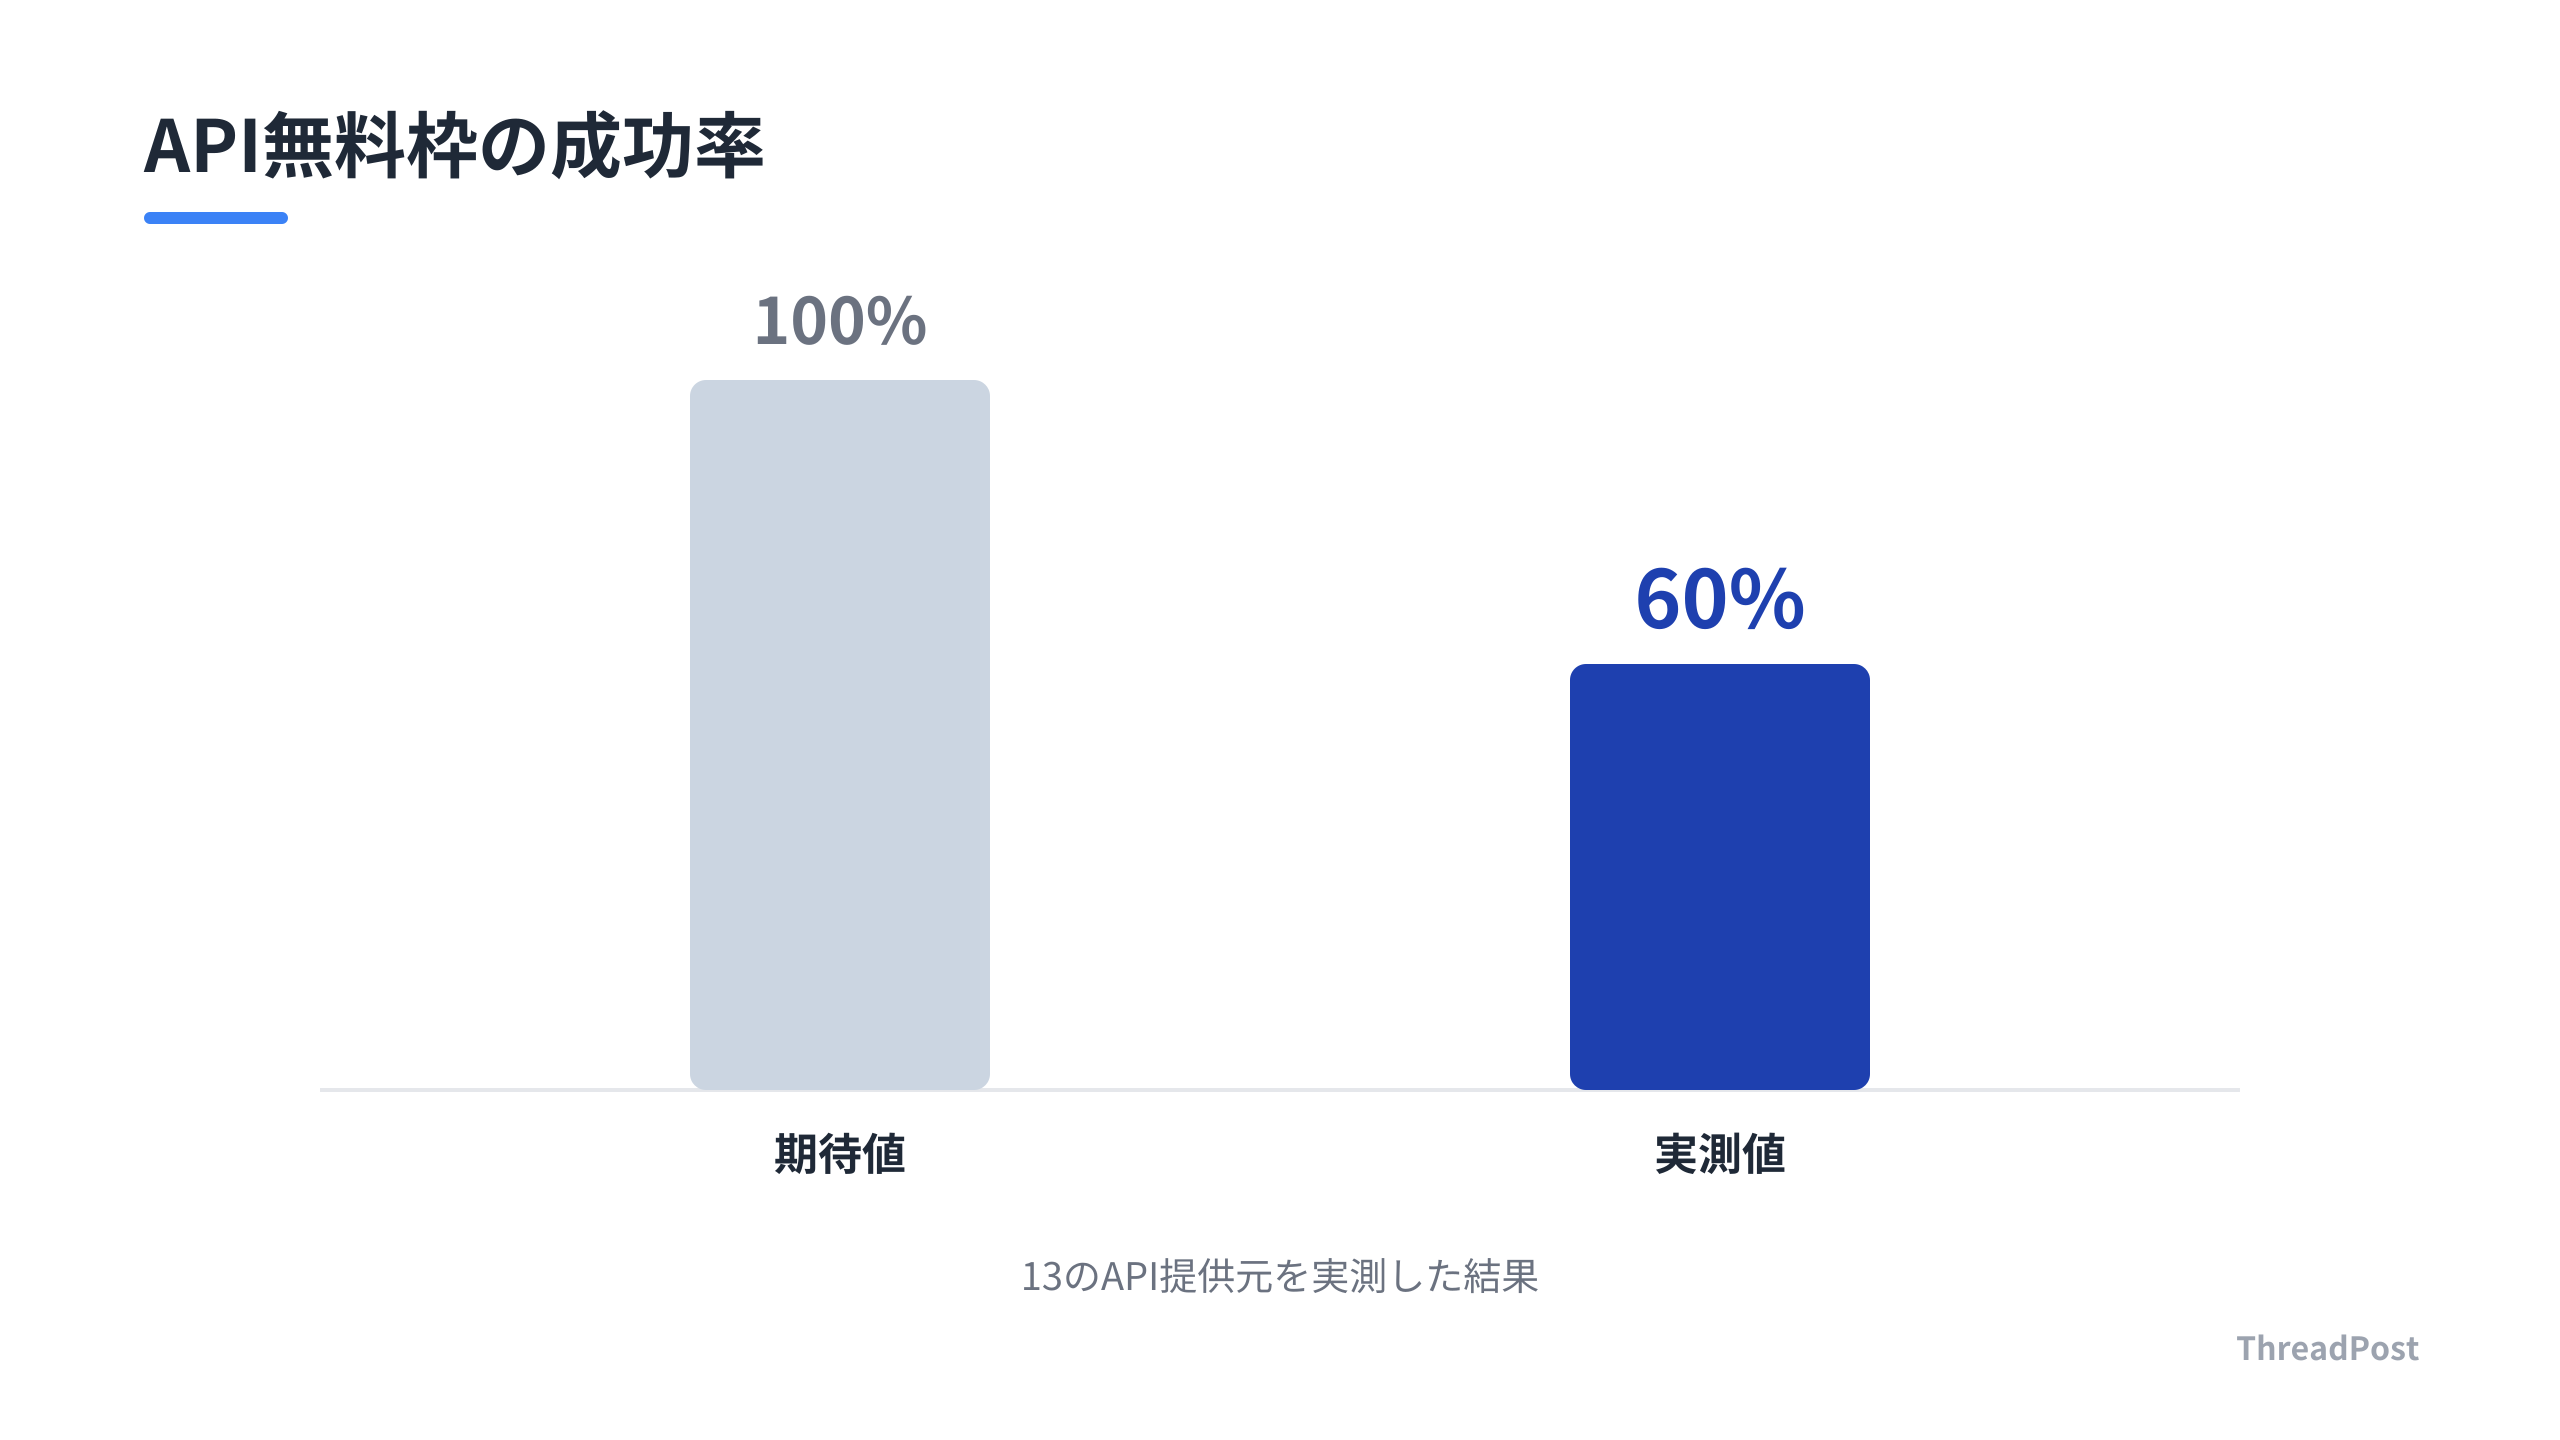
「無料枠のAPIを束ねれば、コストゼロで堅牢なAI開発ができる」。そう信じていた時期が僕にもあった。しかし、実際に本番環境で運用して2ヶ月。検証の結果、成功率は60%まで低下した。
原因はプロバイダの突然の仕様変更や、モデルの廃止、そして「無料」という謳い文句の裏に隠された複雑な制約だ。APIの冗長化は幻想に過ぎない。
この記事では、API依存の不安定なパイプラインを捨て、ローカルLLMを自律運用することで開発環境を安定させるための「移行戦略」を解説する。なぜ今、1GBのモデルがAPIの代替として最適解なのか。Claude Codeで日々エージェントを動かす僕が、現場の数字と事実を元に紐解く。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
API無料枠の「崩壊」とローカルLLMへの回帰
2026年9月、複数のAIプロバイダが提供していた「無料API枠」の運用実態を調査したデータが公開された。これまで「複数のAPIをルーターで束ねてフォールバックさせれば、コストゼロで可用性を確保できる」と信じられてきた運用モデルは、実際には機能不全に陥っている。
調査対象となった13のAPI提供元を実測した結果、成功率は60%という低水準を記録した。単なる通信エラーではなく、プロバイダ側の都合による「恒久的な仕様変更」が多発している。
具体的には、以下の事象が確認された。
- モデル名の突然の廃止: 特定のモデル名がカタログから削除され、古いAPIリクエストが「404 Not Found」を返す。
- 無料枠の制限変更: 7月時点では無料だったものが、9月には「課金必須」へ切り替わった。
- カタログの形骸化: API一覧には存在するが、実際には「410 Gone」でアクセス不可、あるいは「402 Payment Required」を要求されるケースが全体の約4割を占める。
一方で、注目を集めているのが「1bitモデル」によるローカル推論の軽量化だ。PrismMLが公開した「Bonsai 8B」は、パラメータをあえて-1と+1の2択に絞ることで、モデルサイズをわずか1.15GBまで圧縮した。
従来の8Bモデルが16GB前後のメモリを要求していたことを考えれば、これは約1/14の軽量化である。このモデルはGPUを必要とせず、CPU環境下で11〜12トークン/秒という速度で動作する。ベンチマーク性能においても、16GB級のモデルと遜色ない数値を記録しており、APIの不安定さに依存しない「自律型推論環境」の構築が現実的な選択肢となっている。
しんたろー:
60%の成功率はシステムダウンと同義だ。APIルーターでフォールバックを組んでも、鍵の期限切れやモデル廃止で全滅すれば意味がない。無料枠を繋ぎ合わせる工数を考えれば、ローカルで1GBのモデルを回す方が精神衛生上いい。APIの無料枠を追いかけるのは、もはや趣味の領域だな。
APIプロバイダ側は「モデル名の世代交代」や「無料枠の整理」を頻繁に行う。それに追従するコードを書き続けるのは、本来の開発リソースを浪費する行為だ。現在、開発者の視点は「いかに多くの無料APIを束ねるか」から、「いかにローカルLLMをエージェントのバックアップとして組み込むか」という堅牢性重視の戦略へとシフトしている。
 あわせて読みたいローカルLLMのおすすめ構成2026|モデルと実行ツールを実測で選ぶ完全ガイド →
API依存を脱却する「自律型推論」という選択肢
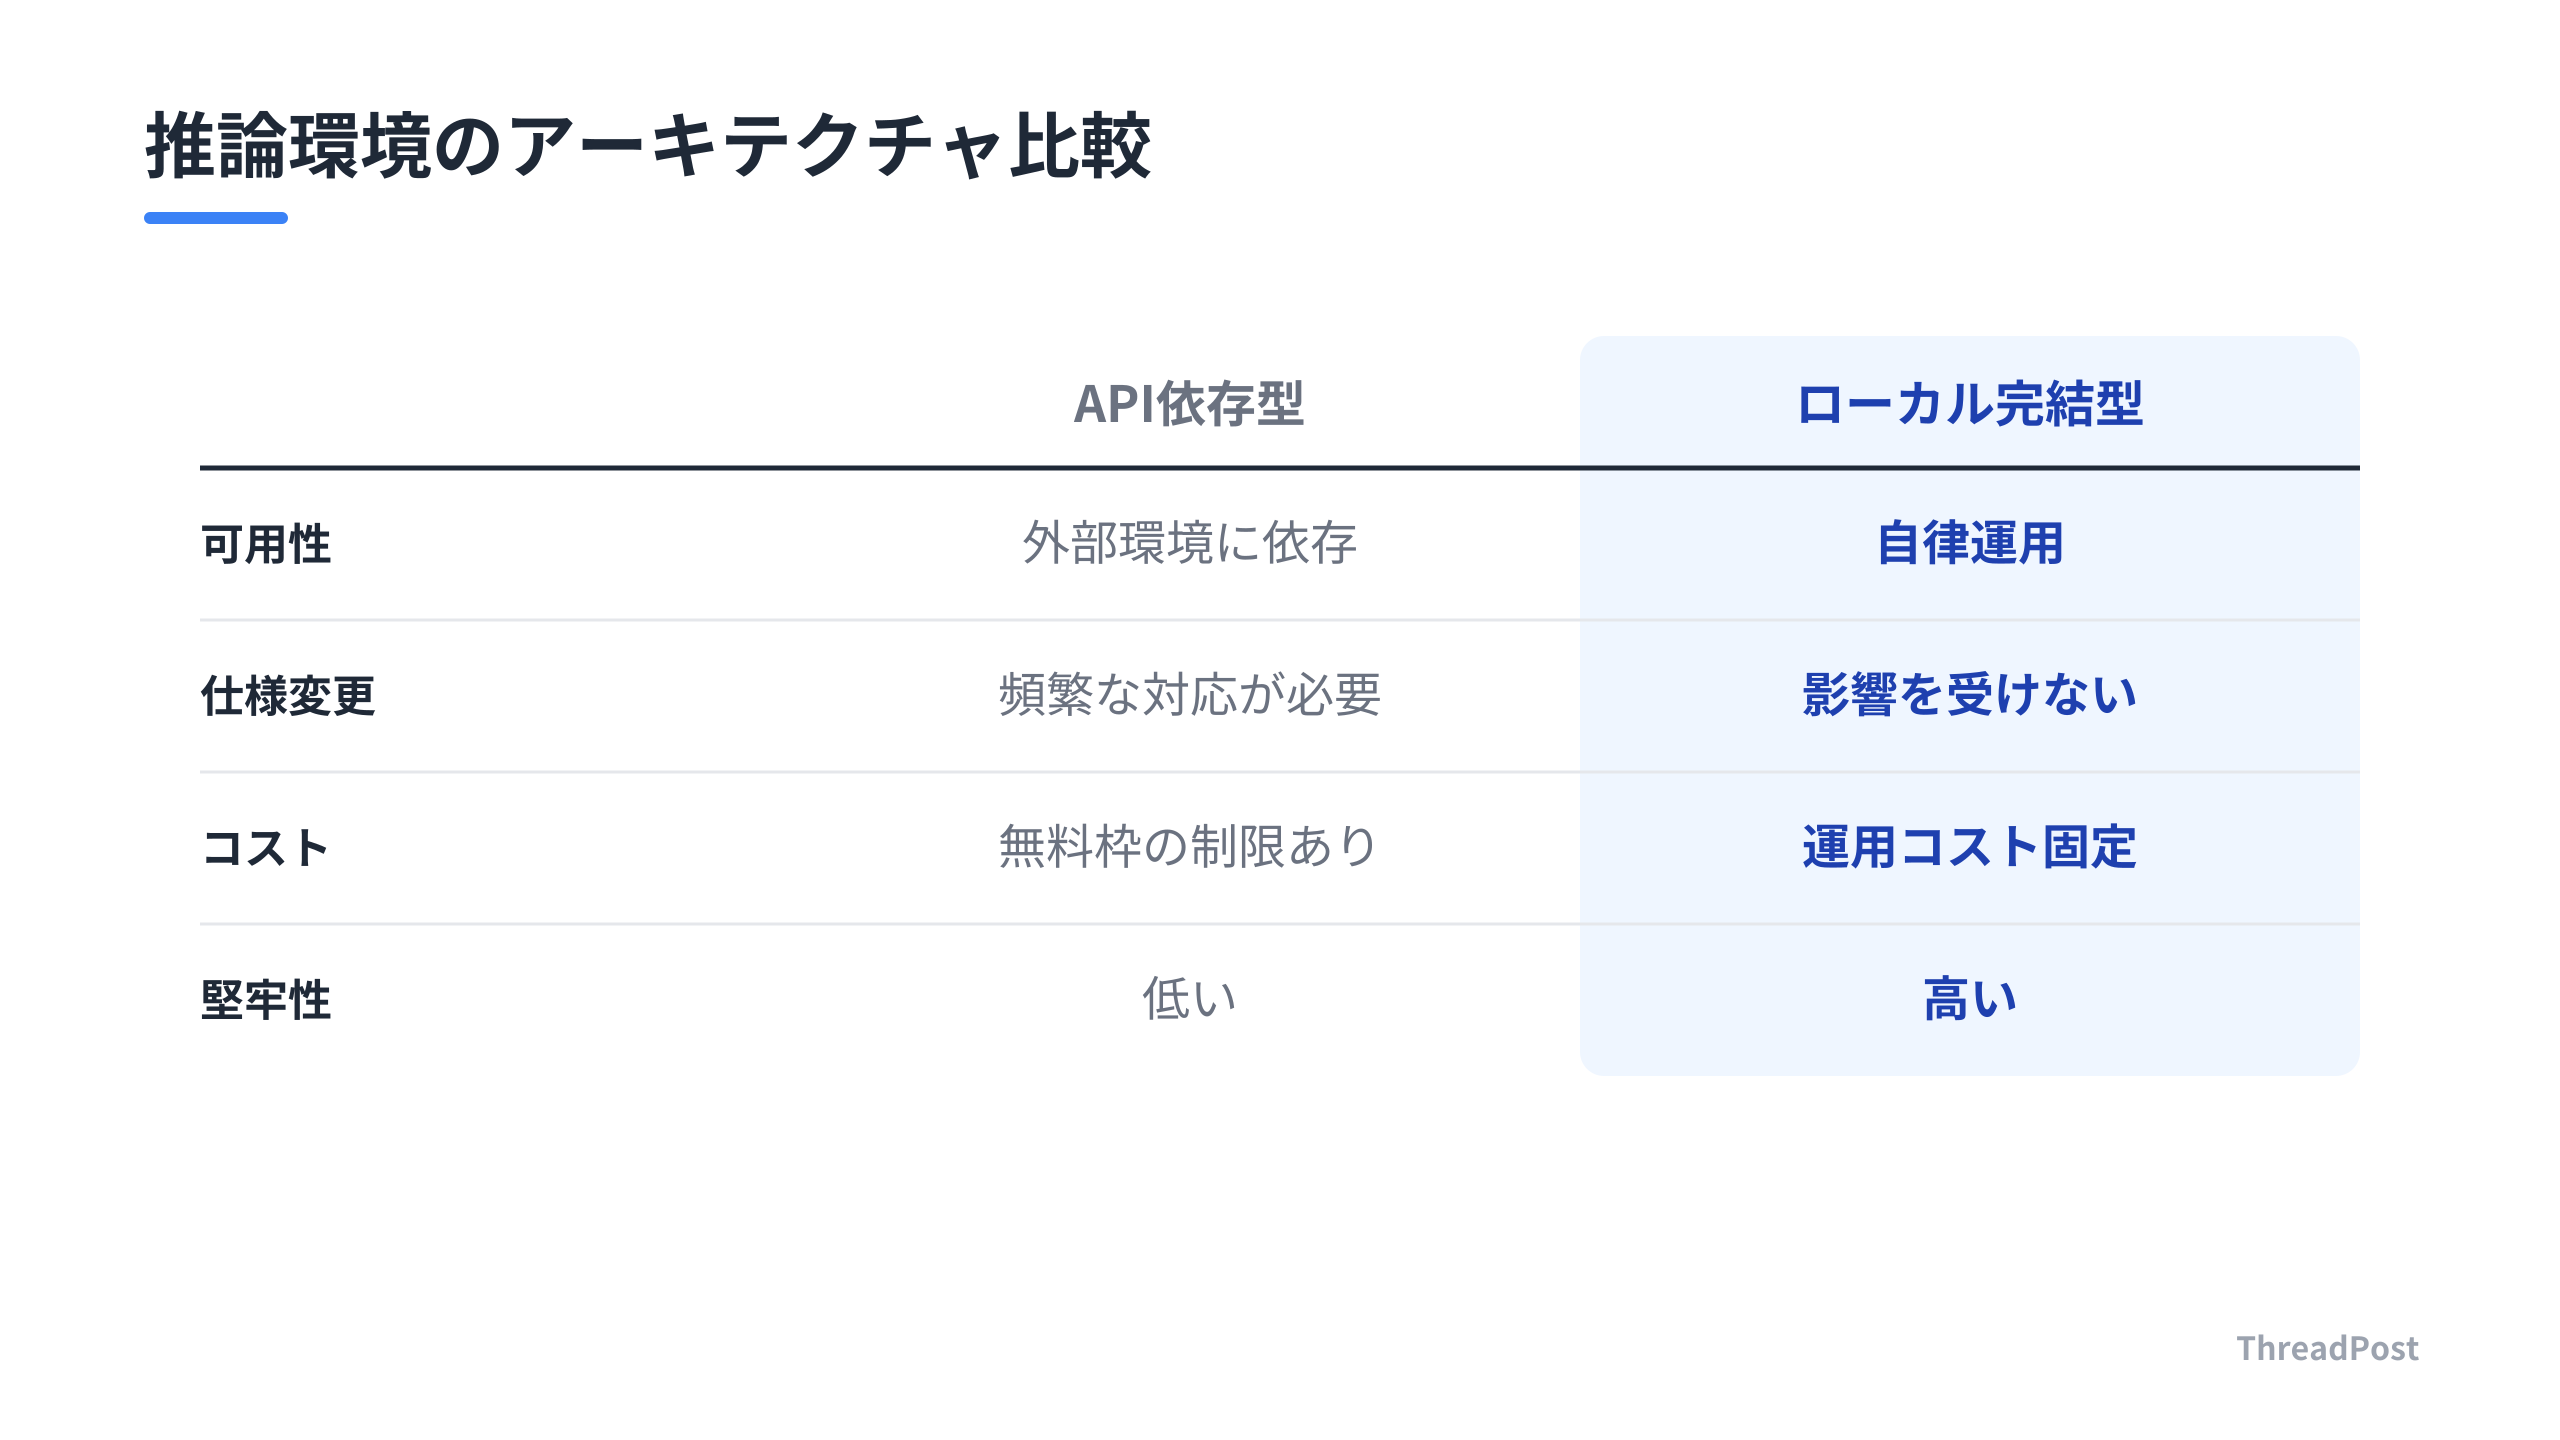
今のAI開発現場で起きているのは、単なる「無料APIの枯渇」ではない。「外部環境の変化に翻弄されるAPI依存型アーキテクチャ」から、「推論環境を制御下に置くローカル完結型アーキテクチャ」への強制的なシフトだ。
かつて僕は、複数のAPIプロバイダをルーターで束ねて死活監視とフォールバックを実装すれば、実質無料で安定したAIパイプラインが作れると考えていた。しかし、現実は甘くない。プロバイダ側は「モデル名の突然の変更」「カタログからの削除」「課金ポリシーのサイレント修正」を繰り返しており、これらに対応するためのメンテナンス工数は無視できないレベルに達している。
特にClaude Codeのような自律型エージェントを運用していると、この問題は致命的だ。エージェントがコードを書き、テストを走らせ、デバッグを繰り返すループの中で、APIが「404 Not Found」や「402 Payment Required」を返せば、その瞬間にプロセスは停止する。エラーハンドリングをどれだけ細かく書いても、モデルそのものが消滅してしまえば、コードを修正する術すら失われる。
ここで注目すべきは、1bitモデルのような極小モデルが実用レベルに達しているという事実だ。1GB程度のサイズで、コード生成や論理的な推論をこなせるモデルをローカルで動かす。この構成なら、プロバイダの仕様変更に怯える必要はない。一度環境を構築してしまえば、APIの制限レートや課金体系、あるいは「明日モデルが消えるかもしれない」という不安から解放される。
APIのフォールバック実装に時間を溶かすくらいなら、最初から定型タスクをローカルLLMにオフロードする方が合理的だ。エージェントがAPIエラーで止まるたびにログを追いかけるあの虚無感、もう味わいたくない。
開発者として考えるべきは、すべての推論を一つの大規模モデルに頼る設計の見直しだ。複雑な推論や深い文脈理解が必要な部分はAPIに任せつつ、コード整形やエラーログの要約、定型的な変換処理といった「APIが落ちても致命傷にならないタスク」を、ローカルの軽量モデルへ切り出す。これが、今後生き残るエージェント設計の基本戦略だ。
また、APIを利用し続ける場合でも、モデル名のエイリアス管理は必須だ。「Gemini-2.0-flash」のように特定のモデル名を直書きするのではなく、常に最新版を指すエイリアスを利用し、プロバイダ側の更新に自動追従させる。これだけで、モデル名の世代交代によるシステム停止を回避できる。
結局のところ、AI開発における「堅牢性」とは、外部のクラウド環境をどれだけ信じないか、という点に集約される。「動くはず」という前提でコードを書くのではなく、「いつAPIが死んでも、ローカルのBonsaiが代役を務める」という冗長性をどう確保するか。この思想を持てるかどうかが、個人のSaaS開発者としてプロダクトを安定稼働させ続けられるかの分かれ道だ。
1GBのモデルが、16GBモデルと並ぶベンチマーク性能を叩き出す時代だ。僕らの開発環境も、クラウドへの過剰な依存を捨て、ローカル環境を再評価するフェーズに来ている。APIの不安定さに疲弊してリトライ回数を増やすよりも、手元のCPUで淡々と推論を回し続ける環境を作る。その方が、結果として開発のスピードも、精神的な安定も手に入る。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
実務への影響:API依存から「ハイブリッド推論」への切り替え
明日からの開発において、まずは「APIの無料枠を繋ぎ合わせる」という戦略を即座にやめる。複数のAPIをルーターで束ねて冗長性を確保したつもりでも、実際にはプロバイダ側の仕様変更やモデルの廃止により、パイプライン全体が共倒れになるリスクが高い。実務で採用すべきは、クラウドAPIとローカルLLMを組み合わせた「ハイブリッド推論」の設計だ。
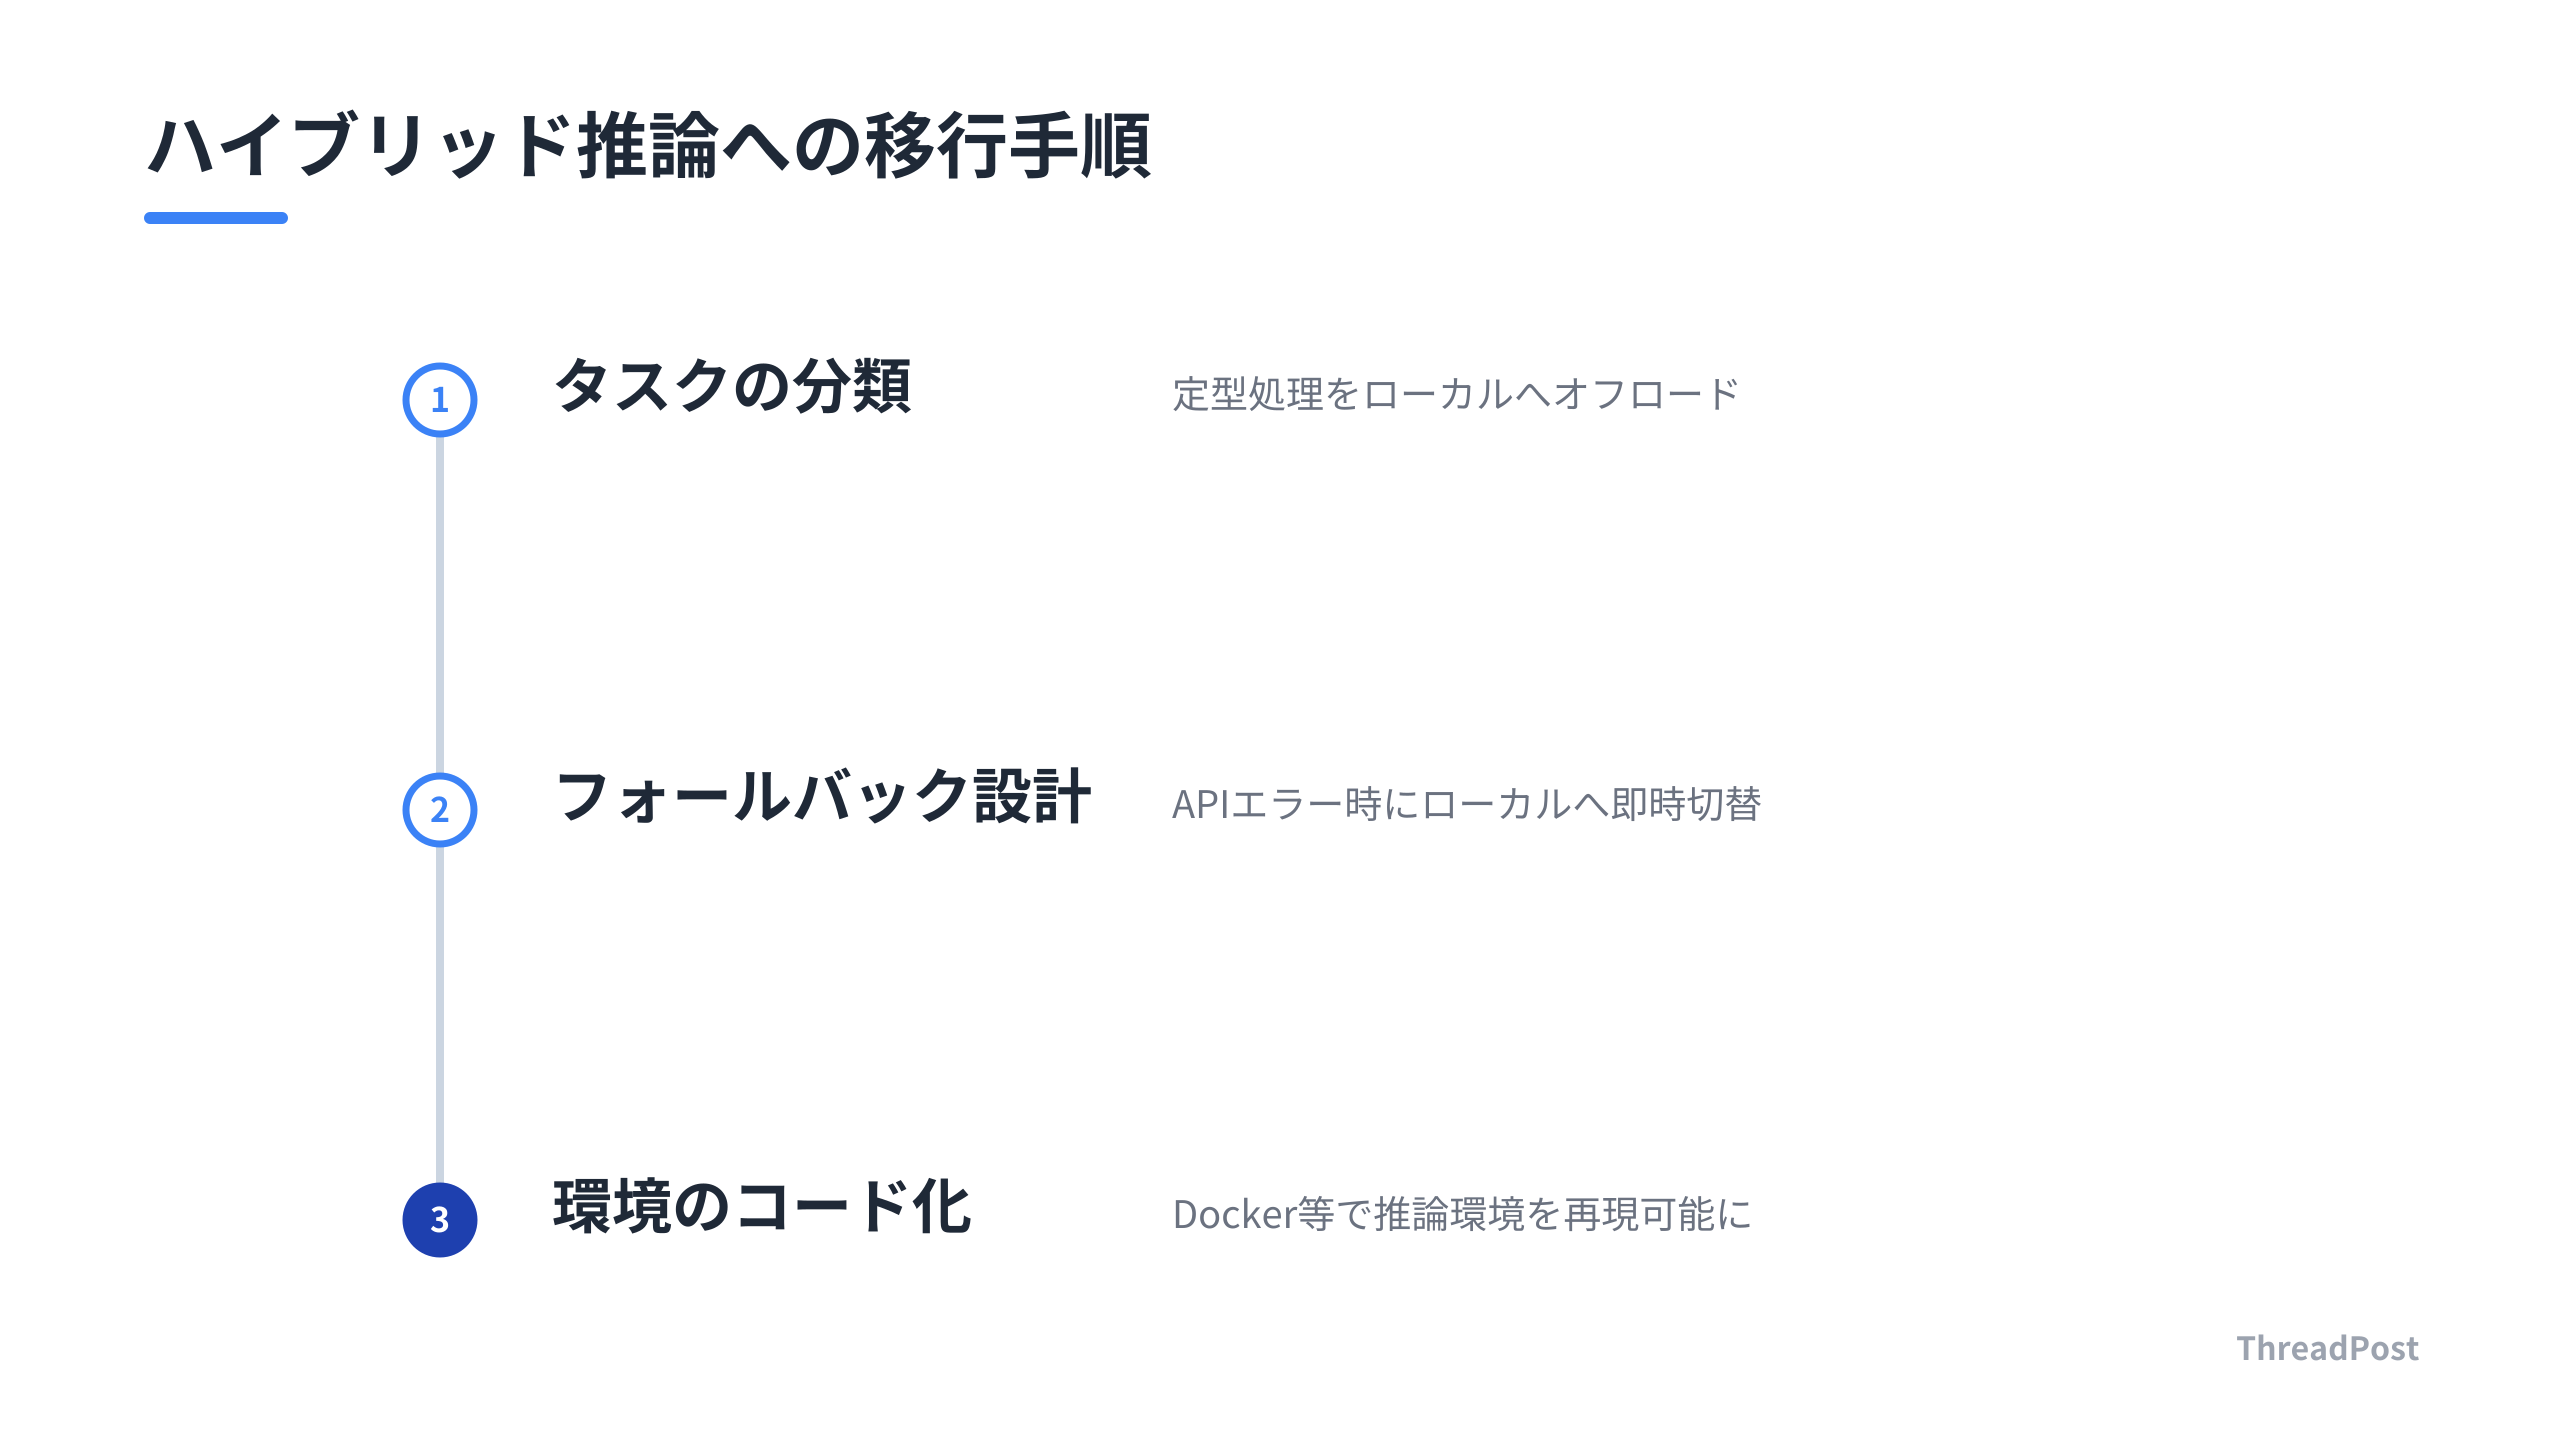
具体的には、以下の3つのアクションを推奨する。
- タスクの分類とオフロード
全ての推論をクラウドAPIに投げるのはやめる。要約、定型的なコード生成、フォーマットの整形といった「計算コストが低く、即時性が求められるタスク」は、ローカルのBonsaiのような軽量モデルにオフロードする。これにより、APIの呼び出し回数を劇的に減らし、コストと安定性の両面を改善できる。
- フォールバック設計の再定義
APIエラーの検知時に「別モデルへのリトライ」を繰り返すのは、エラーの温床を増やすだけだ。「APIが402や404を返した瞬間、即座にローカル環境へ切り替える」という、物理的に異なる推論エンジンへのフォールバックを実装する。ネットワークやプロバイダの障害に左右されない「最後の砦」を確保することで、エージェントの処理ループが停止する事態を回避できる。
- 環境構築のコード化
ローカルLLMの推論環境は、Dockerやセットアップスクリプトで完全に再現可能にしておく。「自分のPCでは動く」という状態は、チーム開発やデプロイ環境において負債でしかない。Claude Codeで開発を行う際も、ローカル推論サーバーを立ち上げておくことで、APIの制限を気にせず、オフラインでもロジックの検証を継続できる。
APIのレスポンスを待つあの数秒間、実は結構なストレスだった。ローカルで推論が完結するタスクを増やしただけで、ThreadPostのデバッグ速度が体感で2倍になった気がする。クラウドに依存しないって、エンジニアとしての精神安定剤だね。まあ、たまにローカル環境の依存関係で地獄を見るけど。
重要なのは、APIの性能を追いかけてカタログを眺める時間よりも、自分のプロダクトが「どの程度の推論精度で動くか」を定義することだ。1GB程度の軽量モデルでも、多くの実務タスクは十分にこなせる。「大規模なモデルでなければならない」という思い込みを捨て、推論の安定性を制御下に置く。この視点を持てば、APIプロバイダの気まぐれなアップデートに一喜一憂する日々から脱却できる。
明日からは、Claude Codeのプロンプトを投げる先を、クラウドとローカルでどう分けるかを考えることから始めてみてほしい。APIの不安定さに疲弊する時間を、プロダクトの機能磨きに回す。それが、今のAI開発の現場で最もROIの高い動き方だ。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
Q1: APIの無料枠を使い続けるのはもう限界ですか?
「無料枠」を前提とした運用は、プロバイダの仕様変更やモデルの廃止に常に振り回されるため、ビジネス用途では推奨されません。どうしても使う場合は、死活監視を徹底し、エラー発生時に即座に通知が飛ぶ仕組みが必要です。また、402や404といった「待っても直らないエラー」を検知した際、自動的に別のモデルやローカルLLMへ切り替えるフォールバック設計が不可欠です。
Q2: 1bitモデル(Bonsai)は実務で使えますか?
コード生成や要約などのタスクでは、1GB程度のサイズでも高い性能を発揮します。ただし、複雑な論理的推論や文脈の深い理解が必要なタスクでは、依然として大規模モデルに分があります。まずは定型的な処理や、APIのコスト削減を目的とした「前処理」としての利用から検討するのが現実的です。CPUのみで動作するため、サーバーコストをかけずに推論環境を構築できるのが最大の強みです。
Q3: ローカルLLMを導入する際に一番の障壁は何ですか?
モデルの選定よりも、推論環境の「一貫性」を保つことです。APIであればプロバイダが環境を管理してくれますが、ローカルではモデルのバージョン、量子化の手法、推論エンジンの設定をすべて自分で管理しなければなりません。特にコンテキストサイズの設定次第でメモリ使用量が大きく変動するため、まずはターゲットとするタスクに合わせて最小限のメモリ消費で動作する構成を構築し、検証を繰り返すプロセスが重要になります。
まとめ
APIの無料枠を繋ぎ合わせた不安定な構成に頼る時代は終わりを告げた。プロバイダの仕様変更やモデルの廃止に振り回されるくらいなら、1bitモデルをローカルで自律運用する方が、結果として開発の堅牢性は高まる。
APIエラーの通知に追われる日々から脱出し、自分の手で推論環境をコントロールする。この戦略転換こそが、今のAI開発において最もコスパの良い投資だ。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
