


開発の現場において、クラウドのAPIに頼り切る時代は終わりつつある。ローカル環境でLLMを動かせば、セキュリティやコストの懸念から解放され、開発速度を劇的に向上できる。MacBookのような高性能なPCさえあれば、今日から自分専用のAIエージェントを構築可能だ。本記事では、ローカルLLMを活用したコーディング高速化のステップを解説する。
必要なものはApple Silicon搭載のPCだ。複雑な環境構築は不要であり、ツールを導入すれば数分でAIがコードを生成し始める。失敗を恐れず、何度でも構築し直せるローカル環境の強みを活かし、開発体験を次のレベルへ押し上げる。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
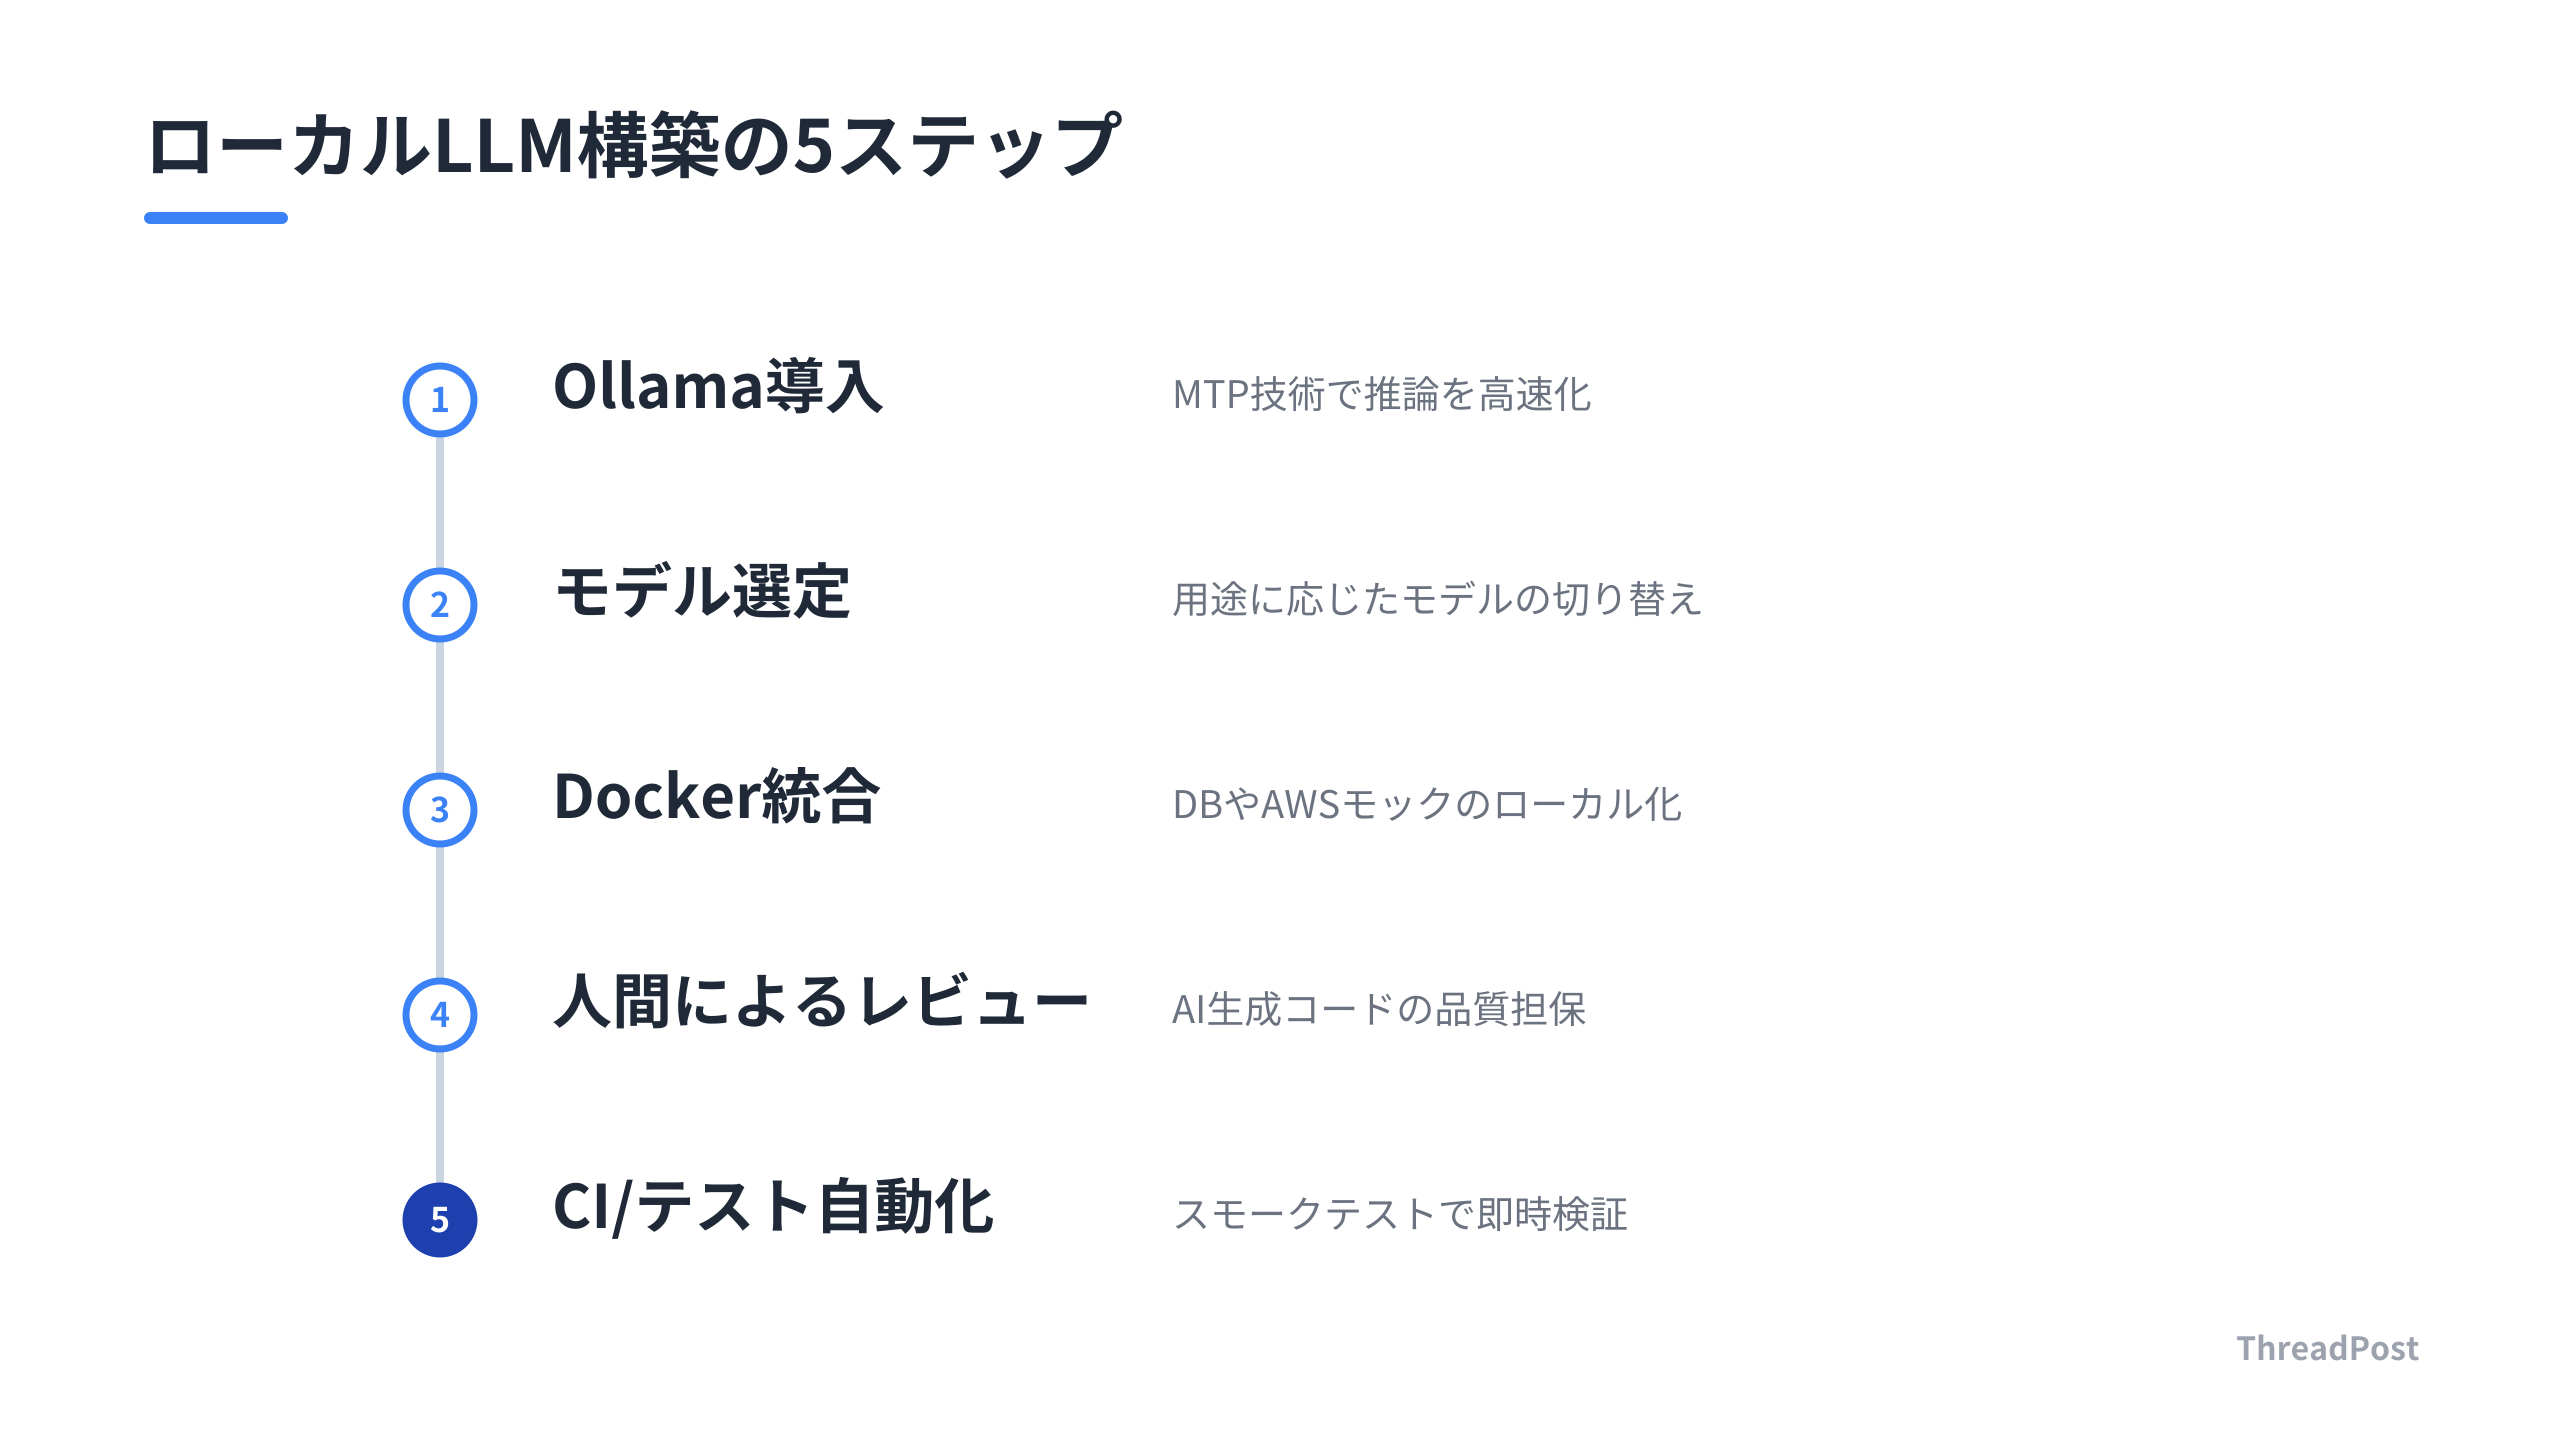
ステップ1:Ollamaによるローカル実行環境の構築
ローカルLLMの導入において、Ollamaはデファクトスタンダードだ。面倒な設定なしで、コマンド一つでモデルを起動できる。特にApple Silicon環境では、最新バージョンで導入されたMulti-Token Prediction(MTP)技術が強力だ。これは一度の推論で複数のトークンを予測する仕組みで、生成速度を大幅に引き上げる。まずはOllamaをインストールし、自分のPCでモデルが動く感覚を掴む。
 あわせて読みたいローカルLLMのおすすめ構成2026|モデルと実行ツールを実測で選ぶ完全ガイド →
ステップ2:用途に応じたモデル選定とベンチマーク
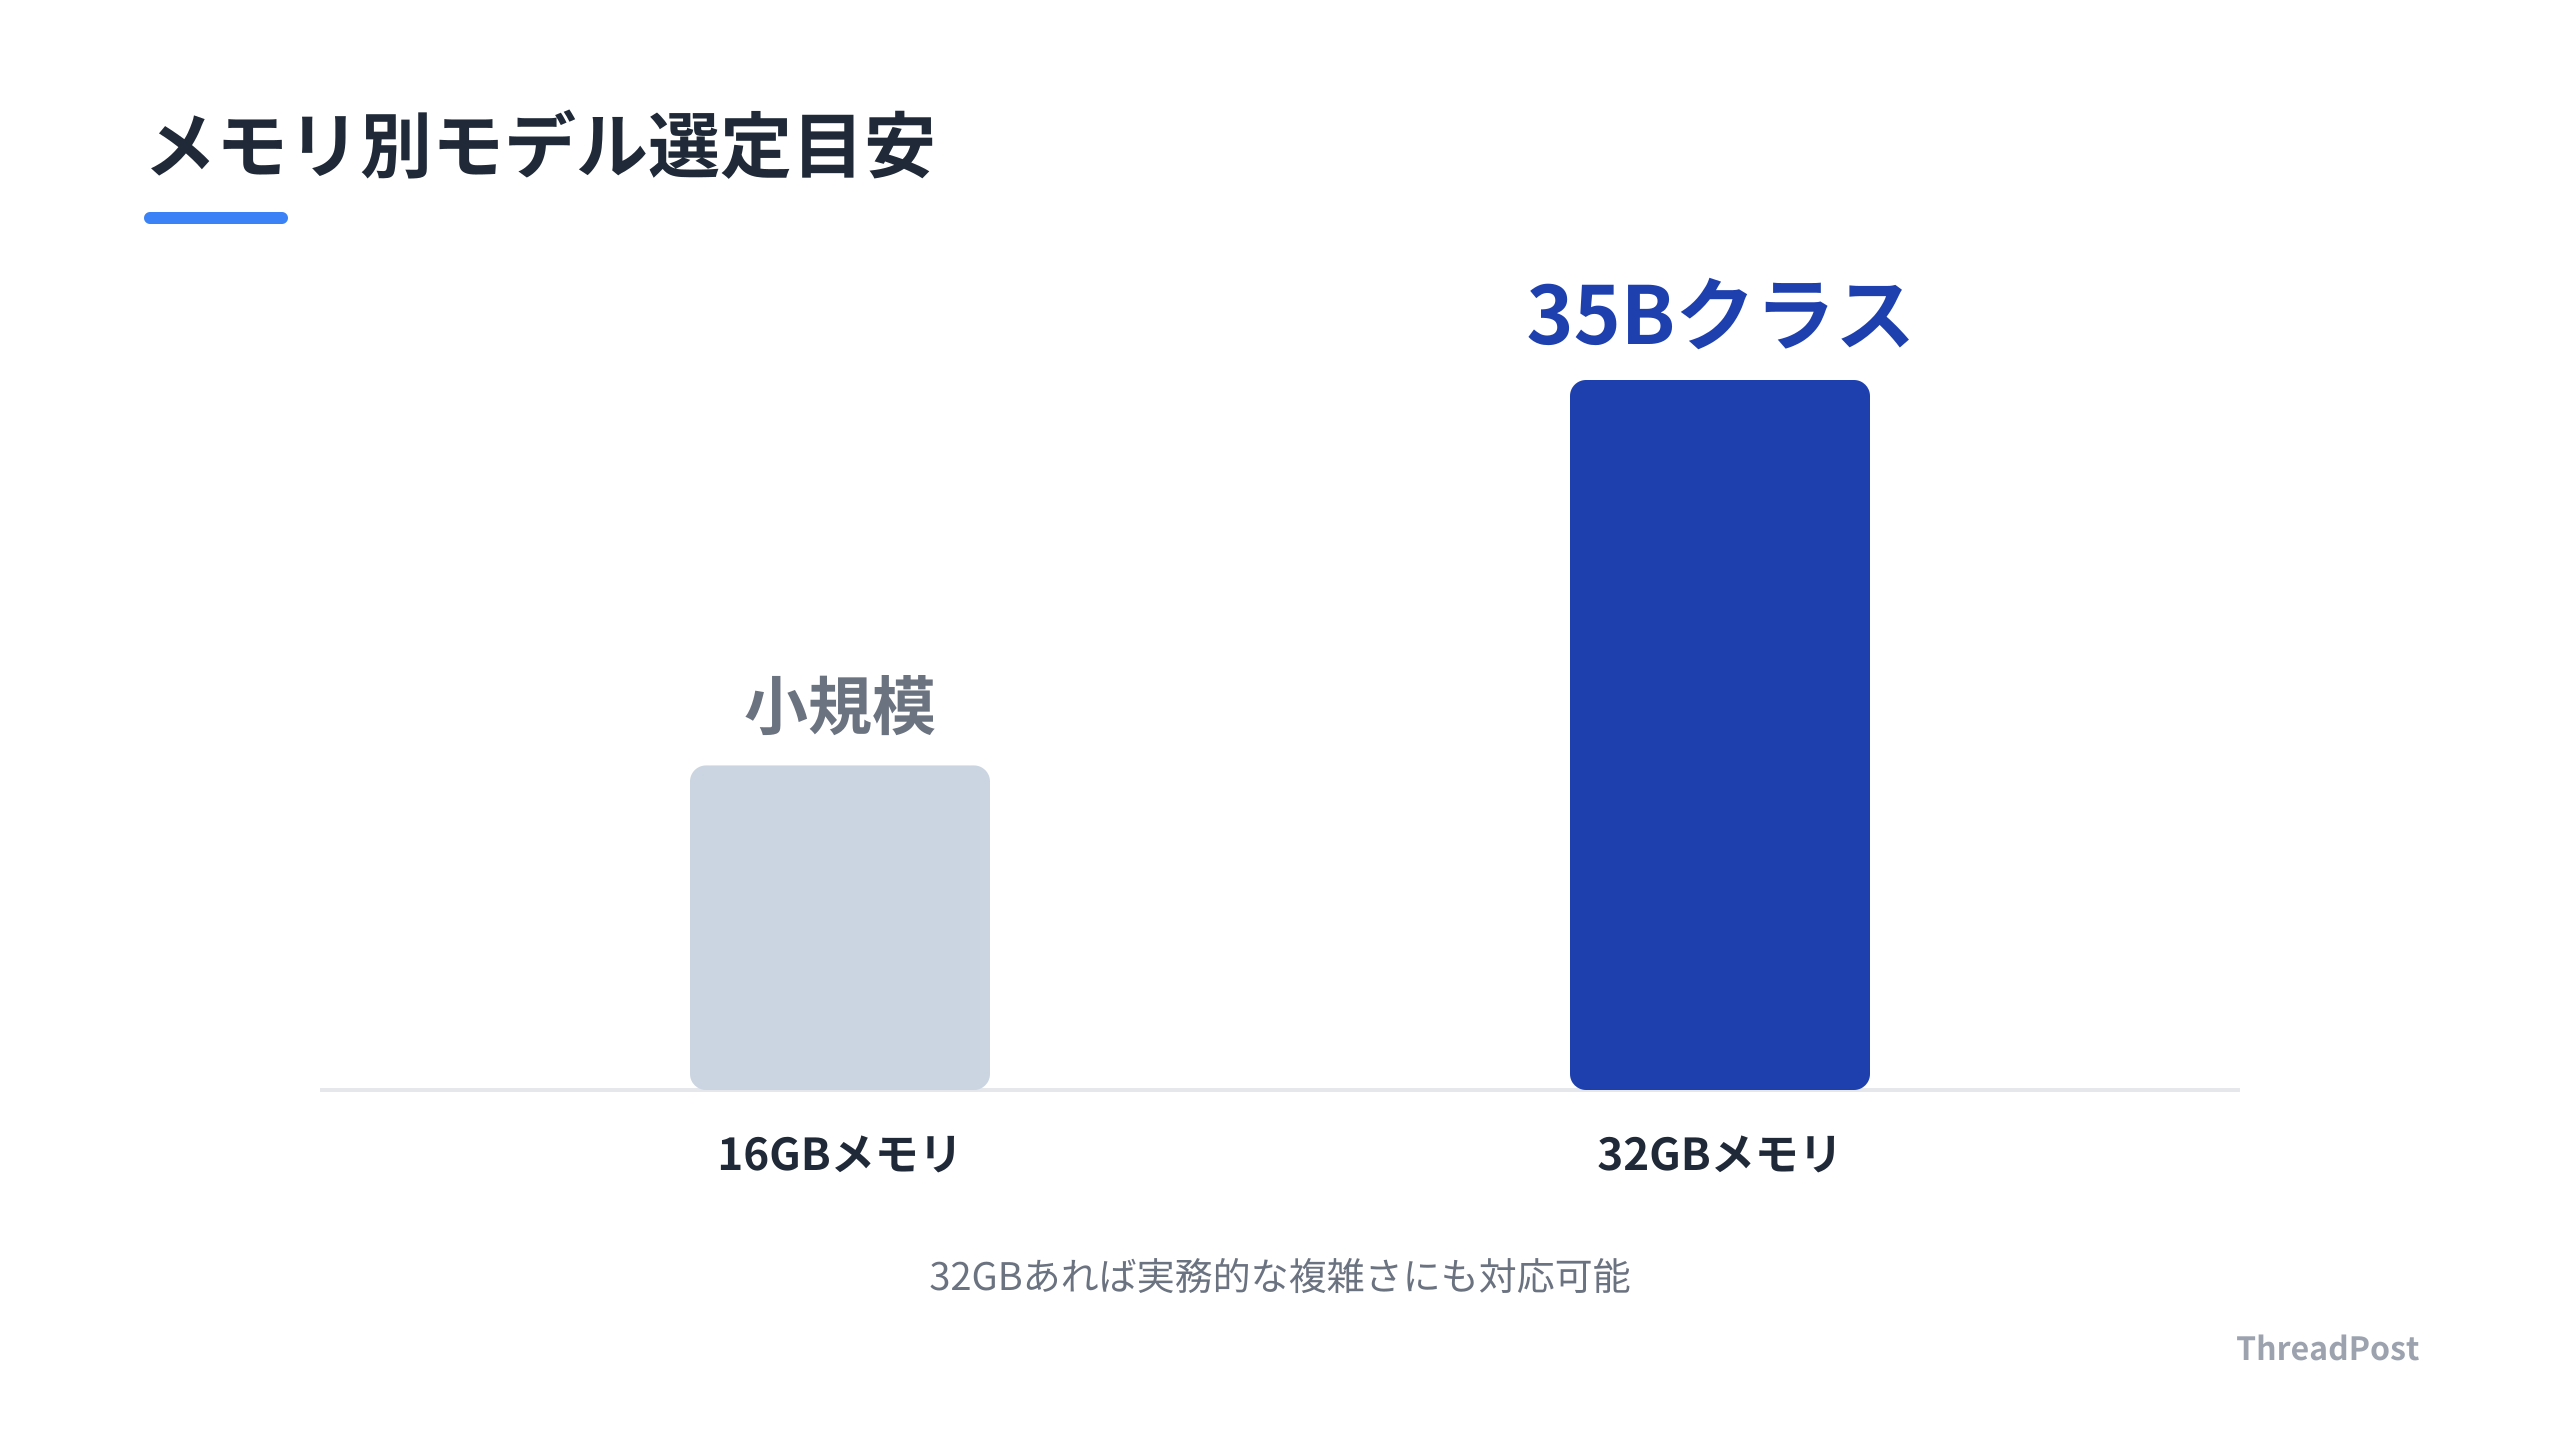
コーディング用途では、ベンチマークスコアよりも「タスクを完遂できるか」が重要だ。32GBメモリを搭載した環境であれば、35Bクラスのモデルが実務的な複雑さを持つAPI実装にも対応できる。モデルにはそれぞれ得意不得意があるため、一つのモデルに固執せず、用途に応じて切り替える運用が最適だ。まずは軽量なモデルから試し、自分のPCで快適に動作するラインを見極める。
ステップ3:Docker Composeによる開発環境の完全ローカル化
LLMだけでは開発は完結しない。データベースやAWSモックなどの周辺環境をDocker Composeで統合する。クラウドのAPIキーを管理する必要はなく、ローカルで完結する環境を構築する。この構成であれば、開発環境を何度壊しても金銭的リスクはゼロだ。失敗を重ねることでしか得られない知見を、心ゆくまで追求する。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
ステップ4:AIエージェントの「人間によるレビュー」フローの確立
ローカルLLMに実装を丸投げするのは危険だ。AIはあくまで強力な「下書き作成者」と定義する。生成されたコードは人間が必ずレビューし、CIで検証するサイクルを回す。この役割分担を徹底することで、既存機能を壊すリスクを抑えつつ、実装スピードを最大化できる。AIを信頼しすぎず、人間の判断力を組み合わせることが成功の鍵だ。
しんたろー:
ローカルLLMを組み合わせた開発フローは強力だ。自分でコードを書きつつ、面倒な定型処理をAIに任せる感覚は一度味わうと戻れない。
ステップ5:CIとスモークテストの自動化
AIに実装を任せるなら、その結果を検証する仕組みもセットで構築する。スモークテストを自動化し、AIが生成したコードが仕様を満たしているか即座に判定する。ローカル環境でこのテストを高速に回せれば、開発サイクルは劇的に短縮される。AIとテストの連携こそが、現代のエンジニアが持つべき武器だ。
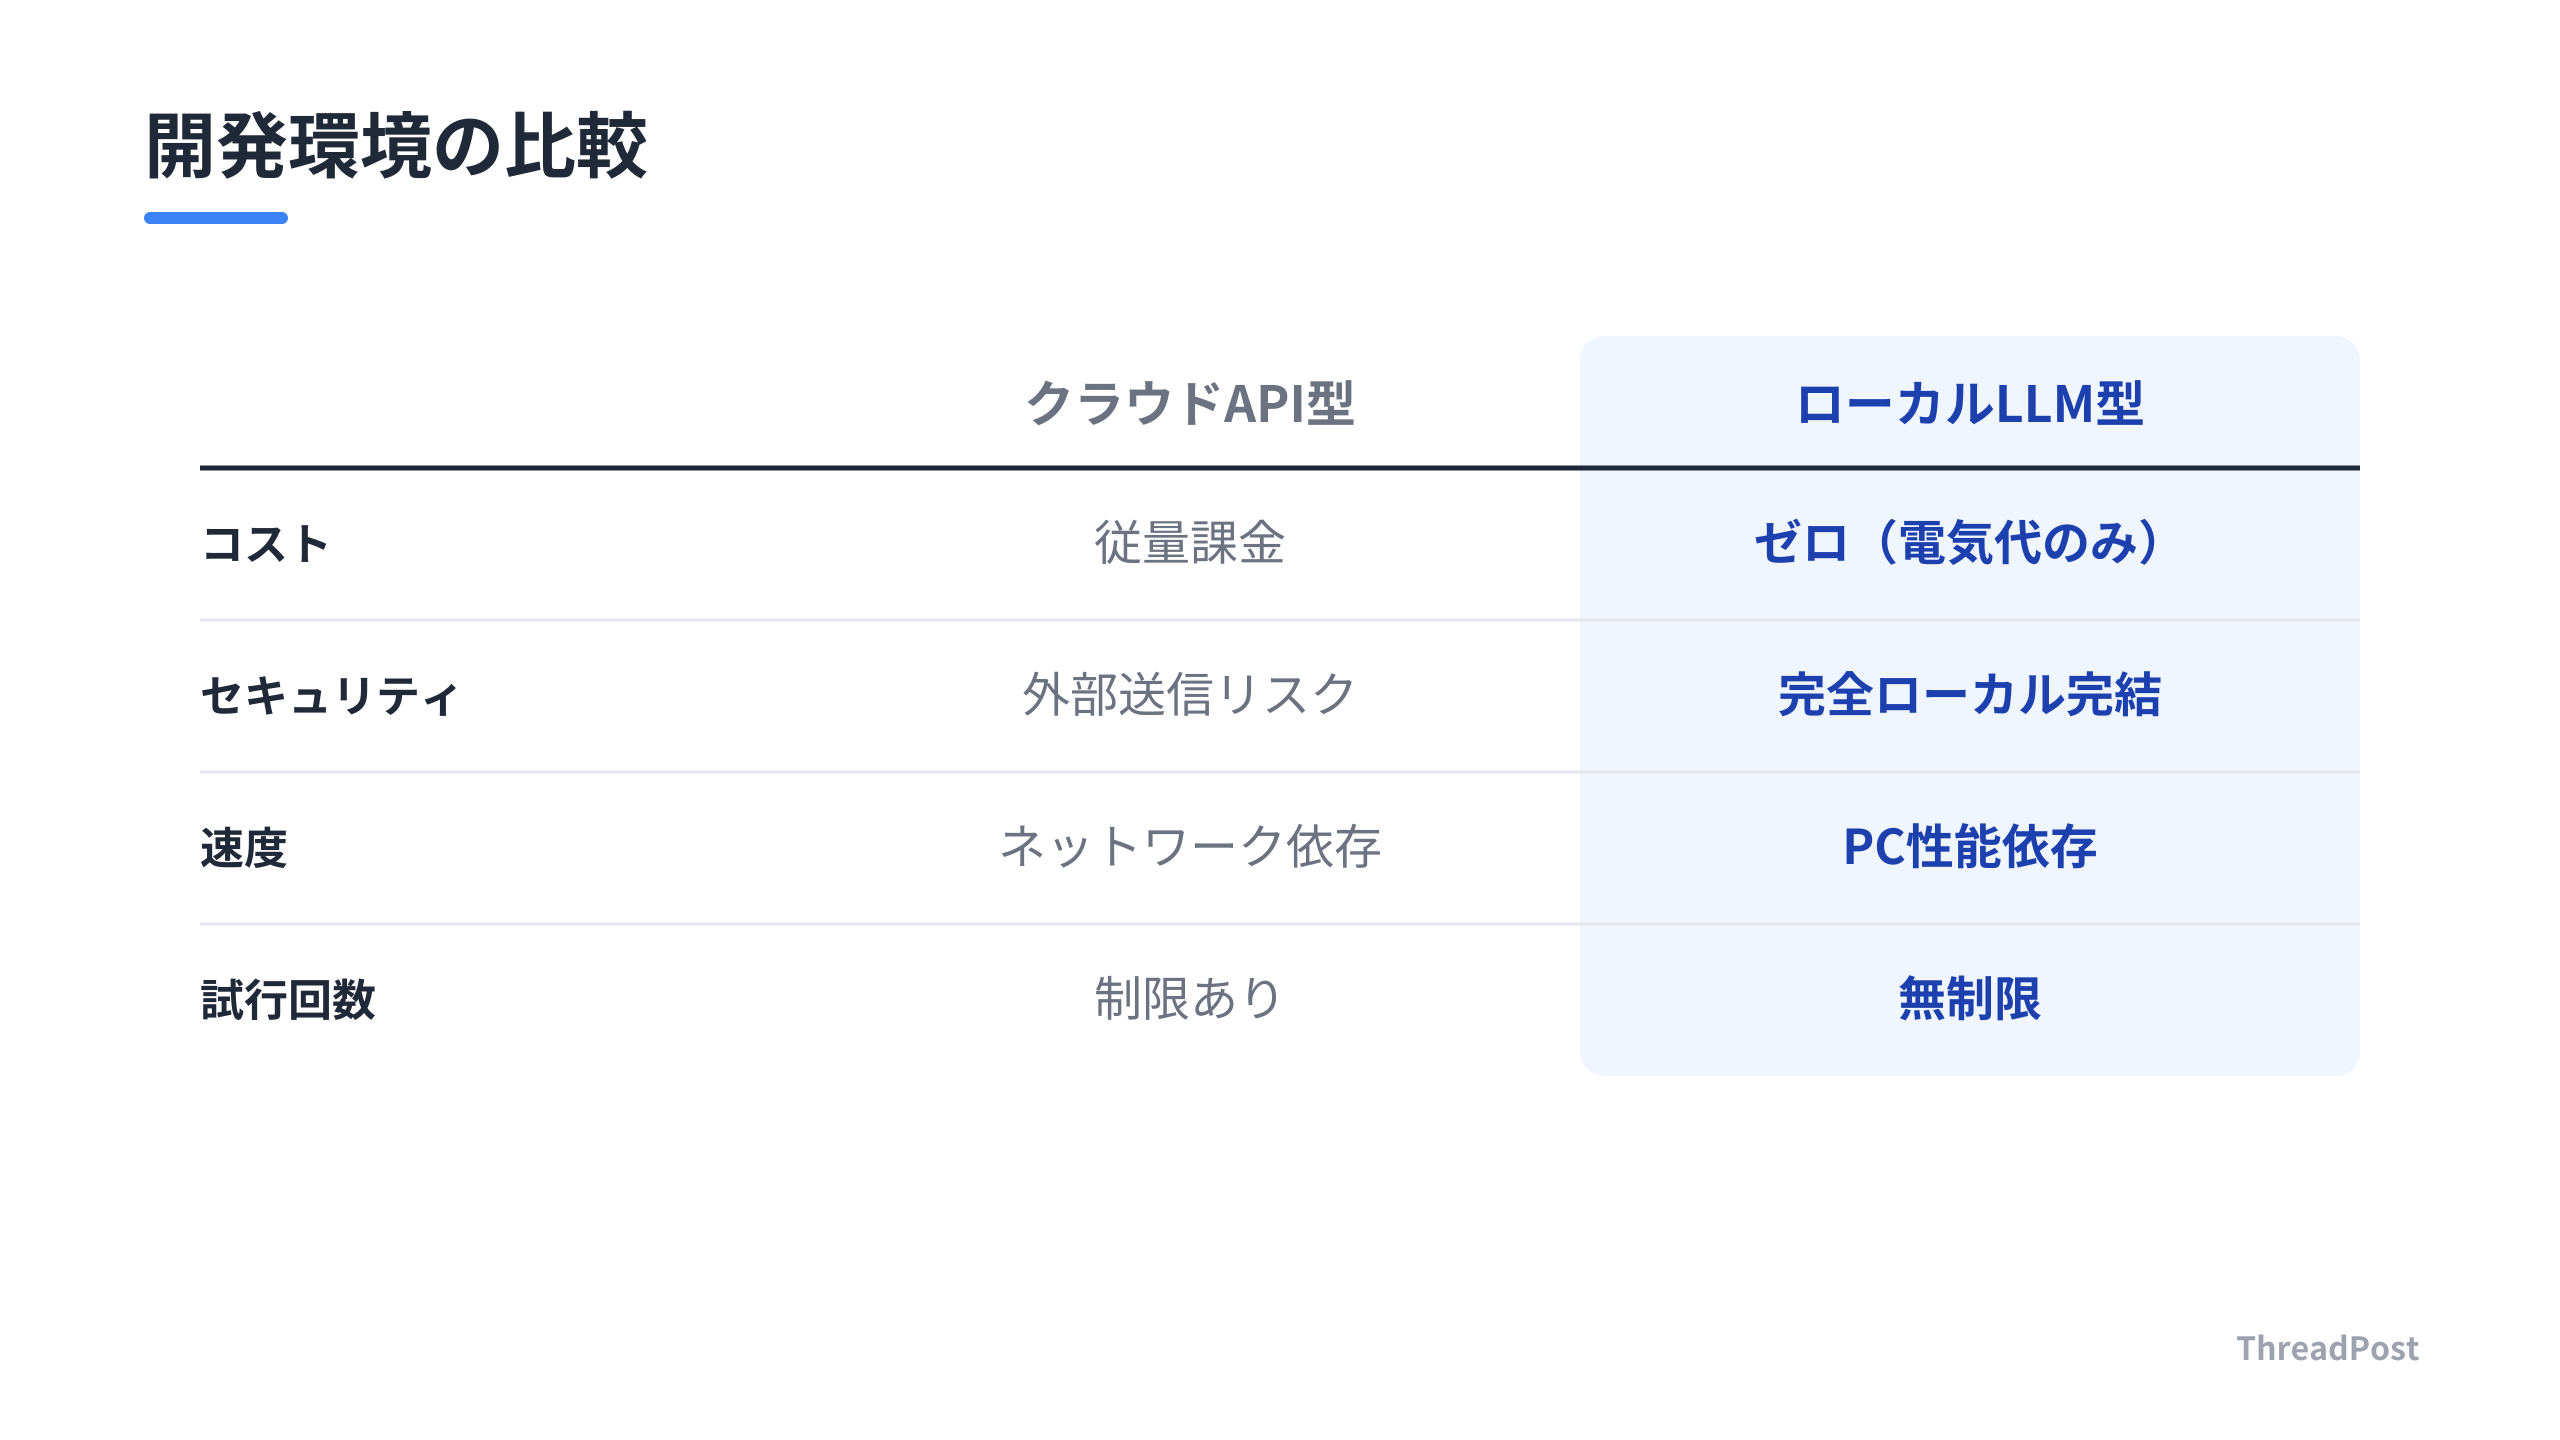
| 比較項目 | クラウドAPI型 | ローカルLLM型 |
|---|---|---|
| コスト | 従量課金 | ゼロ(電気代のみ) |
| セキュリティ | 外部送信リスクあり | 完全ローカルで完結 |
| 速度 | ネットワーク依存 | PC性能依存 |
| 試行回数 | 制限あり | 無制限 |
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
ローカルLLM環境の性能比較
ローカルLLMは、モデルのサイズやコンテキスト長がPCのメモリに大きく依存する。16GBメモリでは小規模なモデルが限界だが、32GBあれば35Bクラスのモデルも実用範囲内で動く。推論速度はOllamaのMTP機能によって劇的に向上しており、一昔前のような「トークンを待つ時間」は大幅に短縮された。自分のPCスペックに合わせて最適なモデルを選定する。
ローカル環境での構築は最初こそ苦労するが、一度整えば一生モノの資産になる。特にDockerとの組み合わせは、開発者としての自由度を大きく広げる。
よくある質問
Q1: ローカルLLMでコーディングする際、PCのスペックはどれくらい必要か。
A1: 最低でも16GB、できれば32GB以上のメモリを搭載したApple Silicon搭載Macを推奨する。コーディング用途ではコンテキスト長を長く確保する必要があり、メモリを大量に消費するためだ。32GBあれば、35Bクラスのモデルを実用的な速度で動かせる。
Q2: ローカルLLMに実装を任せて、本当にバグは出ないのか。
A2: バグは必ず出る。現時点では、AIに実装を丸投げして放置するのは推奨しない。AIが書いたコードを人間がレビューし、CIやスモークテストで自動検証する安全装置が必須だ。AIは下書きを作成し、最終的な品質保証は人間が行うという役割分担を徹底する。
Q3: クラウドのAPIと比べて、ローカルLLMのメリットは何か。
A3: 最大のメリットはコストとプライバシーだ。API利用料を気にせず何度でも試行錯誤できるため、開発サイクルを高速化できる。機密性の高いソースコードを外部サーバーに送信せずに済むため、セキュリティポリシーが厳しい環境でもAIを活用できる点が大きな強みだ。
Q4: Ollamaの「MTP」とは何か。設定は必要か。
A4: MTPは、一度の計算で複数のトークンを予測する技術だ。これにより、メモリ帯域のボトルネックを解消し、生成速度を大幅に向上させる。Ollamaの最新版ではデフォルトで有効になっており、特別な設定なしで対応モデルの恩恵を受けることができる。
Q5: ローカル環境でRAGを構築する意味はあるか。
A5: 大いにある。社内ドキュメントや過去のコードベースを検索対象にする場合、クラウドにデータを上げることなく高いセキュリティを維持できる。LocalStackなどを活用すれば、クラウド環境の構築コストをかけずに、本番に近いRAGパイプラインの動作確認を何度も繰り返すことが可能だ。
ローカルLLMを使いこなせば、開発体験は劇的に変化する。まずはOllamaの導入から始め、自分だけのコーディング環境を構築する。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
