


APIコストを気にして、開発の手を止める瞬間がある。毎日Claude Codeでコードを書き続けていると、APIの請求額が開発のブレーキになる。
LLMのコスト削減は「APIを叩かない工夫」だけでは限界がある。1-bitモデルによる推論エンジンの軽量化と、RAGを組み合わせたハイブリッドな設計が、推論単価を極限まで下げる解になる。
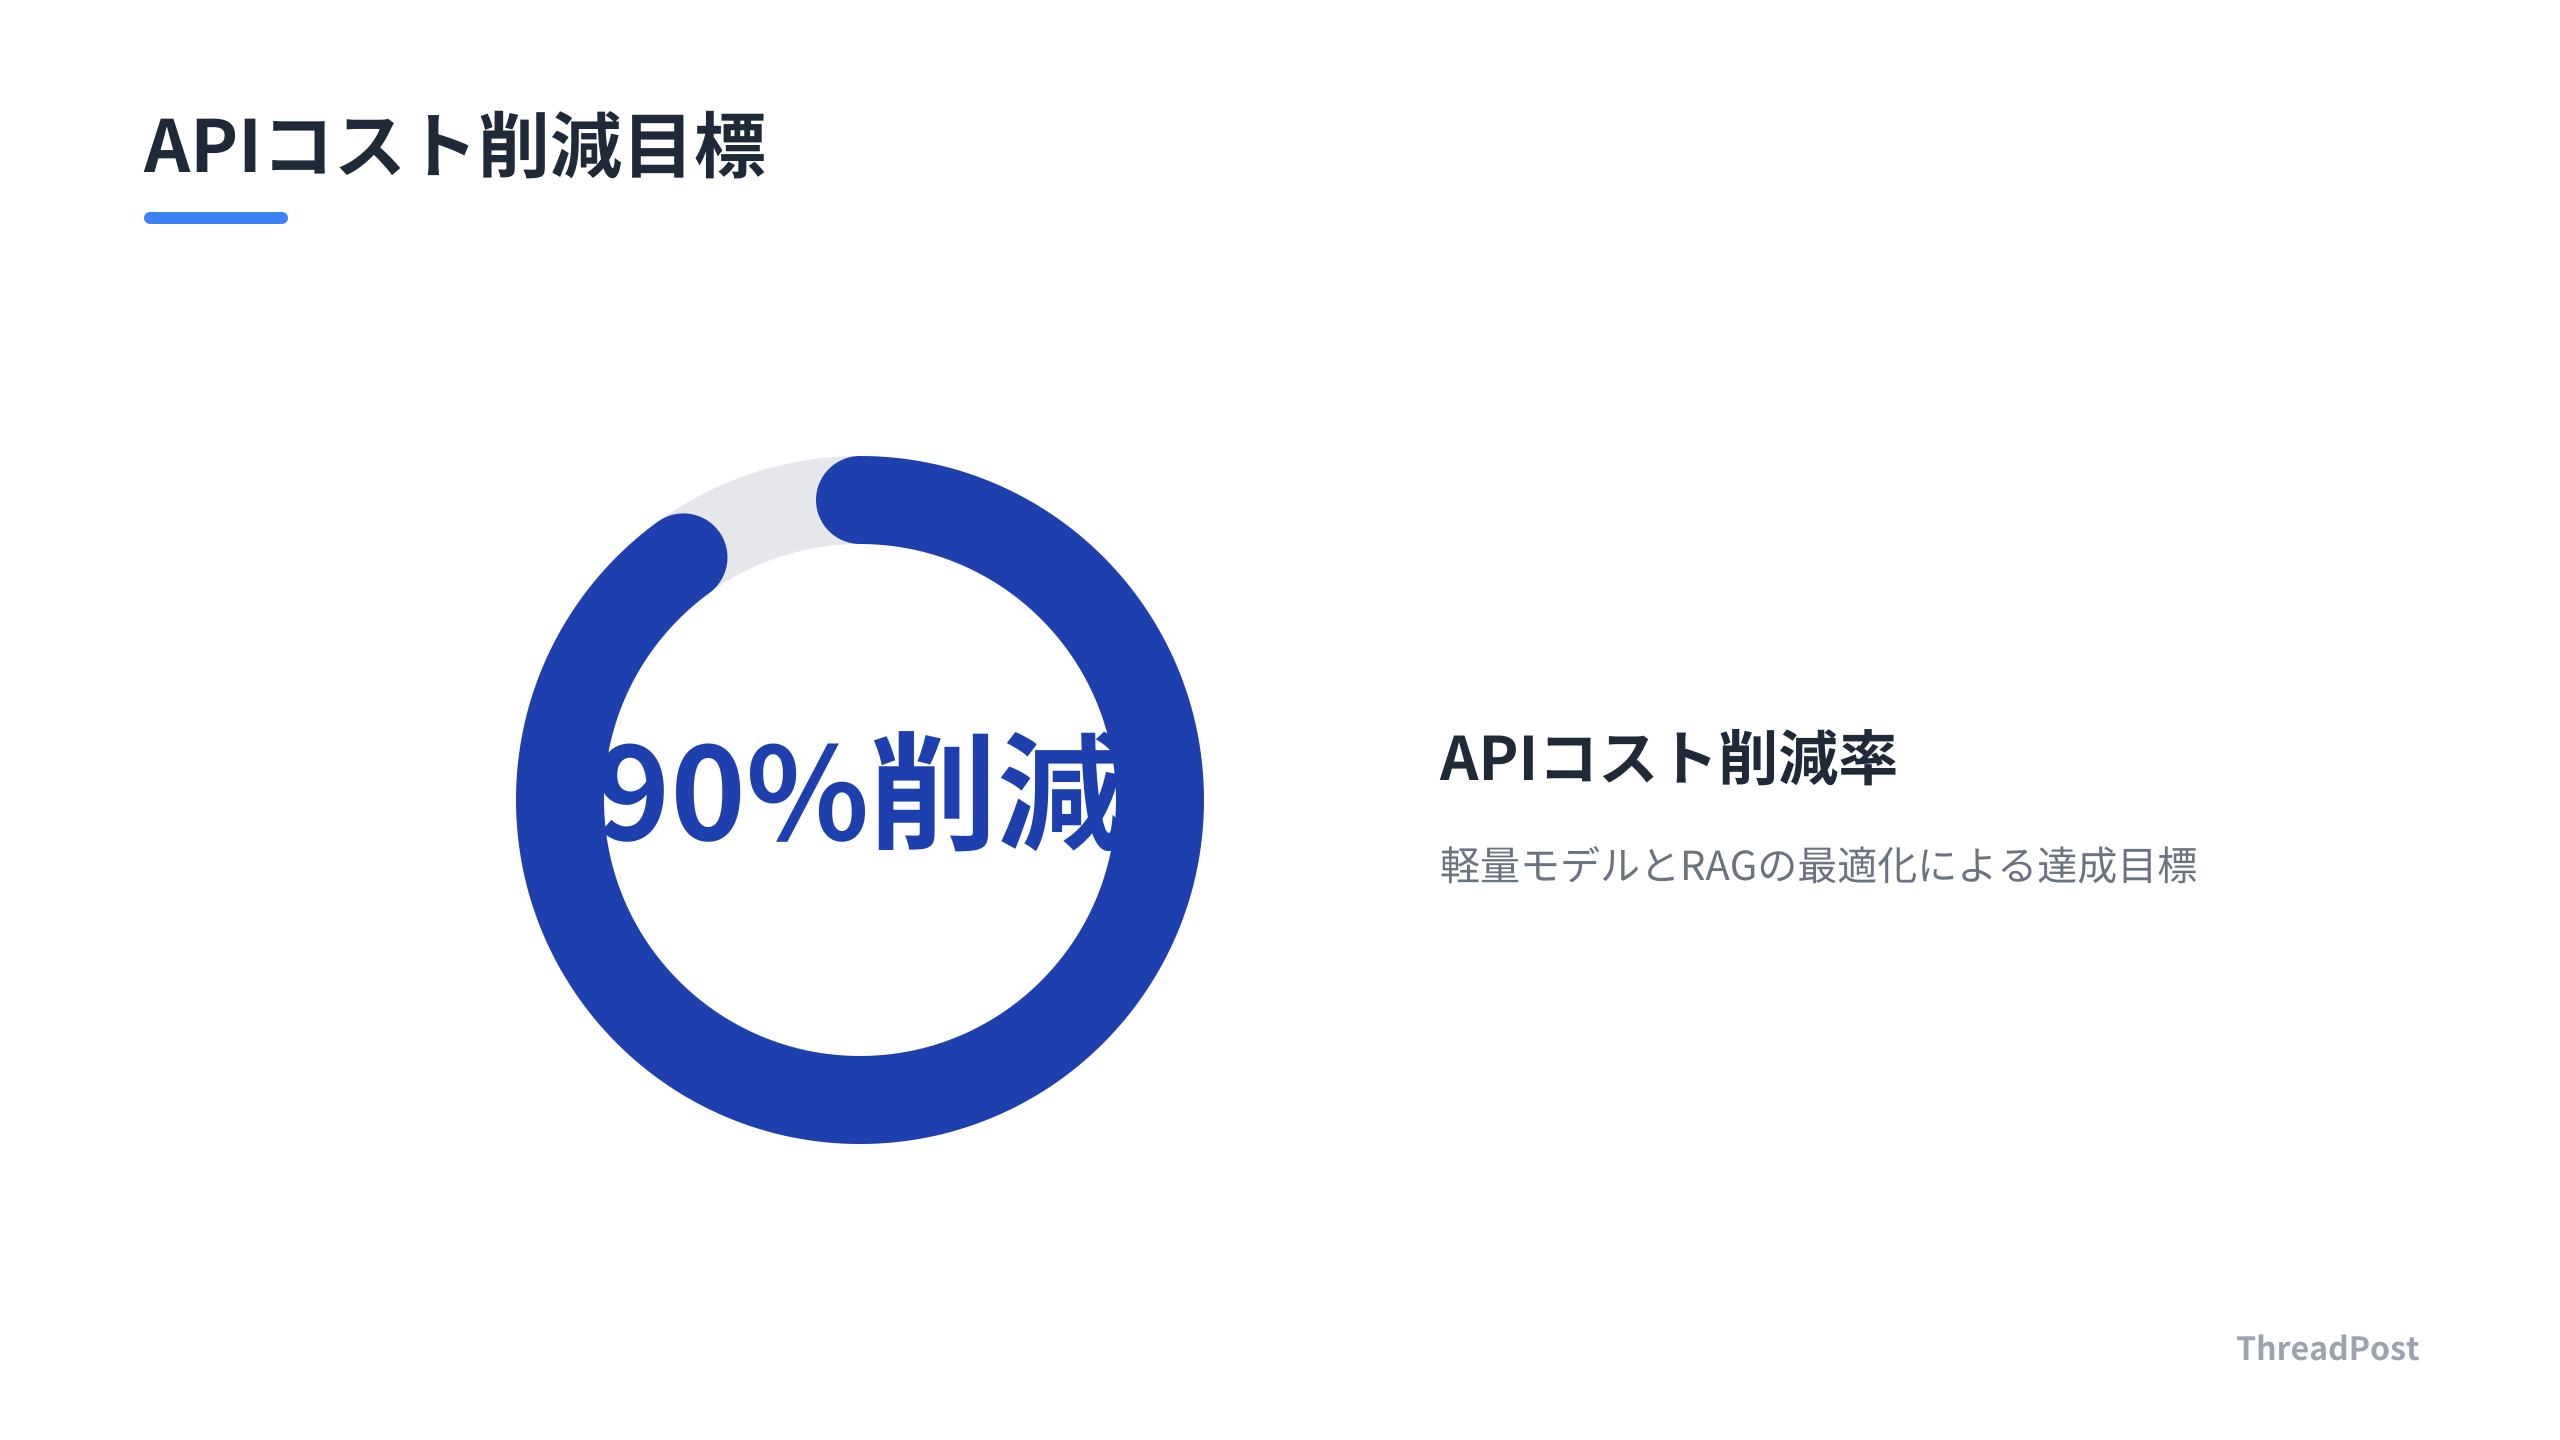
この記事では、APIコストを9割削減するための設計思想と、軽量モデルをタスク特化させるビット反転技術を解説する。開発者が知るべき、次世代のコスト最適化の全貌を共有する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
LLMの推論コストを下げる3つの技術的アプローチ
AI開発において、APIコストの増大は課題だ。コスト最適化の手法は「API呼び出しの削減」「推論モデルの軽量化」「インフラのサーバーレス化」の3つのレイヤーに集約される。
API呼び出しの削減には、キャッシュ活用と非同期処理がある。同じ入力を繰り返さないキャッシュ戦略や、バッチ処理によるAPIリクエストの集約は、運用コストを下げる。Claude Codeのようなエージェントを活用する際、エージェントの思考プロセスやツール呼び出しの抑制が鍵となる。
推論モデルの軽量化として注目されているのが1-bitモデルだ。従来のモデルが16ビットの浮動小数点数で重みを管理するのに対し、重みを1ビット(0か1)まで圧縮する。勾配降下法による微調整ができない代わりに、特定の行のビットを反転させる「ビット反転パッチ」を用いることで、モデルの挙動を特定のタスクに特化させる。
RAG(検索拡張生成)の最適化も有効だ。外部知識をLLMに参照させる際、検索対象のチャンク化を工夫し、検索頻度をcronジョブなどで制御することで、API呼び出し回数を削減できる。Cloudflareなどが提供するサーバーレス環境では、ベクトルストアを活用して必要な情報だけを効率よく抽出する設計が標準的だ。
しんたろー:
1-bitモデルのビット反転パッチが気になる。LoRAのように浮動小数点の重みを追加するより軽く、XORで元に戻せるため検証が速い。API予算を溶かす前に、推論単価を削る実装を一つでも仕込んでおきたい。
これらの技術は、組み合わせて運用することで真価を発揮する。汎用的な知識はRAGで補完し、特定の推論パターンや定型タスクは1-bitモデルにパッチを当てる。このハイブリッドな設計が、APIコストを9割削減する現実的な解だ。
多くの事例において、これらの手法を導入した開発者は、推論単価を抑制しつつ、アプリケーションの応答速度を維持している。APIの利用量を計測するフェーズから、モデルの重みや推論インフラを制御し、コストと精度のバランスを自ら設計するフェーズへ移行している。
 あわせて読みたいClaude Codeの使い方完全ガイド|インストールから実践まで2年運用の開発者が解説 →
推論インフラの制御権を取り戻す戦略
APIコスト削減に対し、多くの開発者は「APIの呼び出し回数を減らす」運用レベルの最適化に終始する。しかし、より深いレイヤーでコストを制御する「推論エンジンの軽量化」という選択肢がある。
Claude CodeでThreadPostを開発する際も、APIの利用量には神経を尖らせる。重要なのは「APIをいかに節約するか」という守りの姿勢だけでなく、「どのタスクをどの計算資源に割り振るか」というアーキテクチャの設計思想だ。
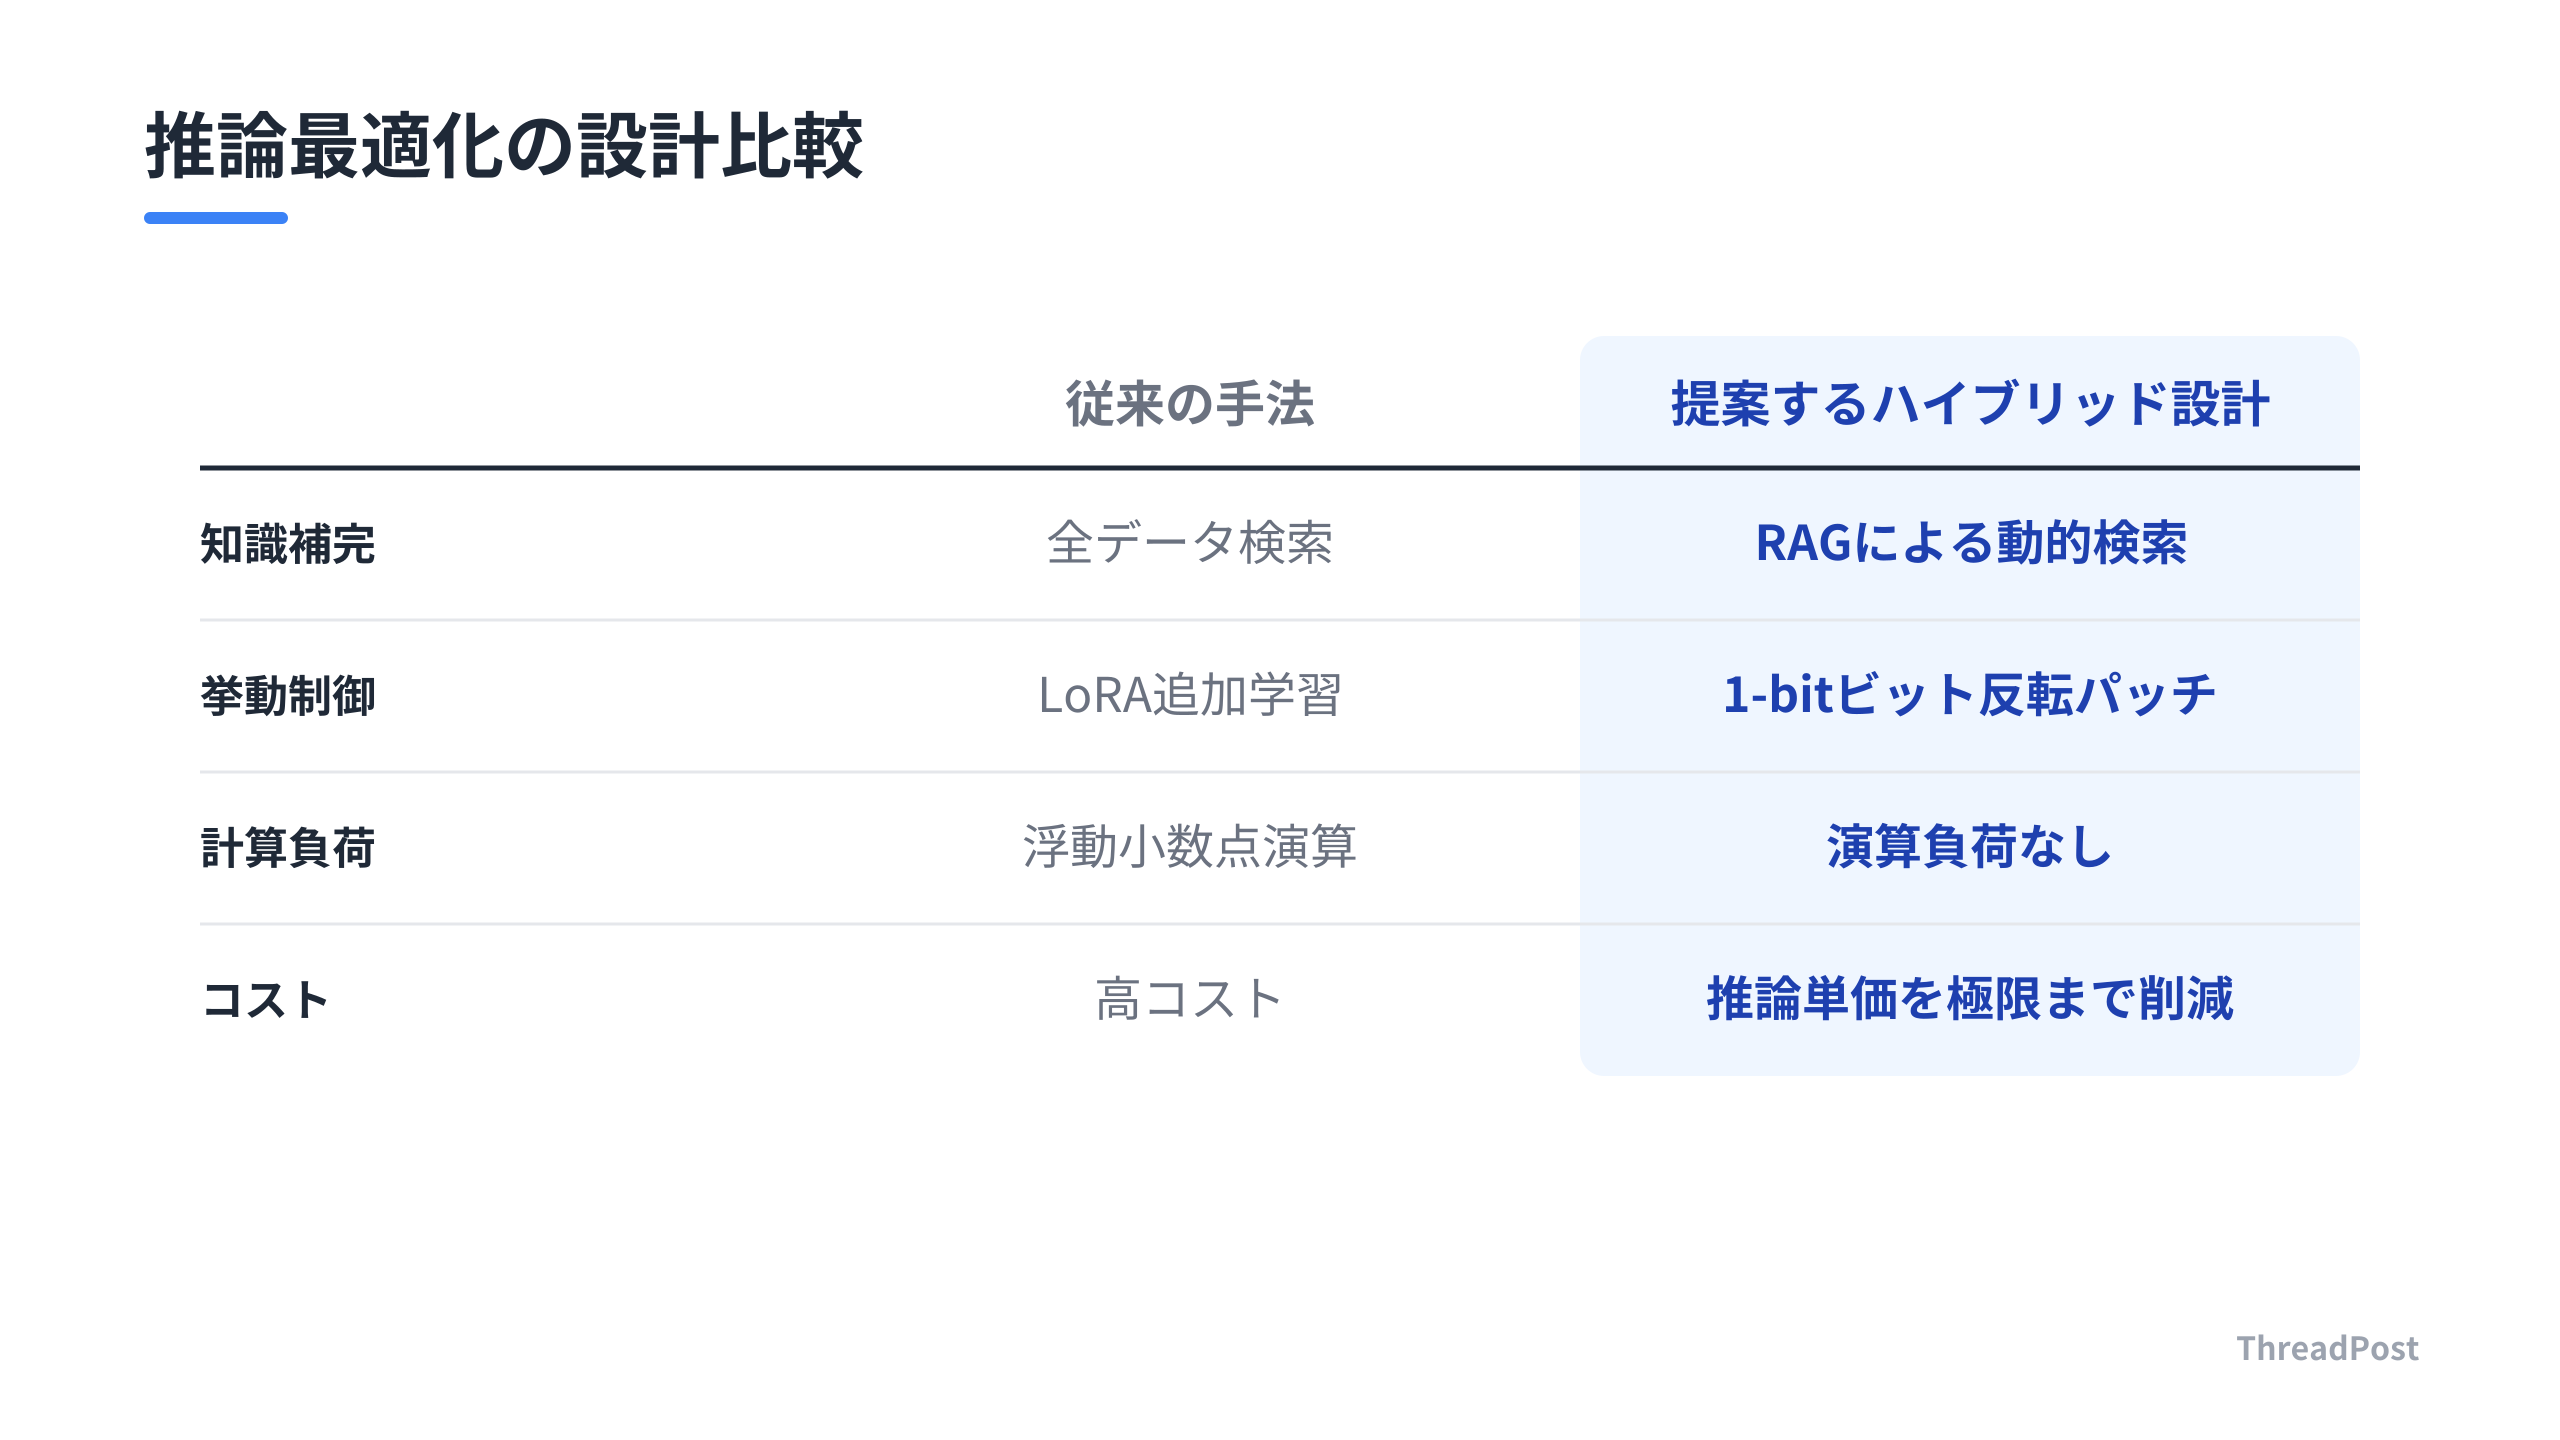
1-bitモデルのビット反転パッチは、LoRAのような浮動小数点演算を伴う追加学習が前提だった世界観を覆す。従来のファインチューニングが「モデルの重みを微調整して挙動を変える」ものだとすれば、ビット反転は「モデルの論理回路の一部を強制的にスイッチする」低コストな介入だ。
この手法は、推論速度を犠牲にしない。浮動小数点演算を伴うアダプタ層を追加すれば、推論エンジンへの負荷は増大し、レイテンシも悪化する。一方で、ビット反転パッチはモデルの重みそのものを操作するため、推論時の計算負荷は元の軽量モデルと変わらない。
LoRAで学習するとGPU代がかさみ、ローカルで動かすには重い。ビット反転パッチなら、MacBookで試して、ダメなら即XORで元通り。この「失敗の軽さ」が1人SaaS開発には必要だ。
RAGの設計においてもパラダイムシフトが起きている。これまでは「全データをベクトル化して検索する」アプローチが主流だったが、今は「検索対象を絞り込み、LLMのコンテキストウィンドウを節約する」ことが腕の見せ所だ。
RAGによる「汎用的な知識の補完」と、ビット反転による「タスク特化型の挙動強制」は補完関係にある。RAGは動的に変化する最新情報や広範なナレッジを扱い、ビット反転パッチは「算術」や「分類」といった、モデルの推論ロジックを固定化したいタスクに適している。
これを組み合わせて、「最新の攻略情報はRAGから取得し、その情報を整形して分類するロジックは軽量モデルにパッチを当てる」パイプラインを組めば、推論単価を下げつつ、精度を担保できる。
開発者が陥りやすい罠は、すべてのタスクを汎用的な高性能APIに投げることだ。思考モデルは賢いが、トークン消費量は膨大になる。定型的な処理や分類のような単純なタスクであれば、軽量モデルをエッジ環境で動かし、パッチで挙動を制御するほうが、長期的には安上がりで安定する。
今、意識すべきは、APIを単なる「魔法の箱」として使うのではなく、モデルの重みやインフラ構成を制御可能な「部品」として扱うことだ。Claude Codeのようなエージェントを駆使して開発効率を上げる際も、生成されるコードの背後にある推論コストまで意識して設計する。それが、コスト競争に勝ち残る防衛線だ。
こうした技術は、大規模なチームだけのものではない。限られた予算と時間で動く1人SaaS開発者こそが、この「推論単価を削る実装」を武器にして、高効率なプロダクトを構築できる。API料金の請求書を見て溜息をつくのは、終わりにしよう。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
実務への影響:APIコストを「設計」する
APIの料金明細を確認するだけのフェーズは終わりだ。実装の初期段階から「推論単価をどう削るか」をアーキテクチャに組み込む。
まず取り組むべきは、タスクごとのモデルルーティングだ。思考モデルのような高コストなモデルは、複雑な推論が必要な箇所に限定する。定型的な分類や、単純なテキスト生成であれば、軽量モデルへ即座に切り替える判断をコードベースで自動化する。
次に、RAGの設計を見直す。すべてのナレッジを毎回ベクトル検索してLLMに投げ込むのは、トークン消費の浪費だ。検索頻度をcronジョブで制御し、キャッシュヒット率を高める仕組みを作るだけで、API呼び出し回数は減る。
さらに、特定の挙動を強制したい場合は、無理にファインチューニングやプロンプトエンジニアリングで解決しようとせず、ビット反転パッチのような軽量な手法を検討する。モデルそのものを「丸ごと入れ替える」のではなく、必要最小限のパッチを当てる発想が、運用コストを下げる。
Claude Codeで実装していると、つい強力なモデルに頼りたくなるが、その分だけ財布が軽くなる。最近は「これ、本当にthinkingモデルが必要か?」と自問してからプロンプトを投げている。賢いエンジニアリングはモデルの性能以上に、使い方の設計で決まる。
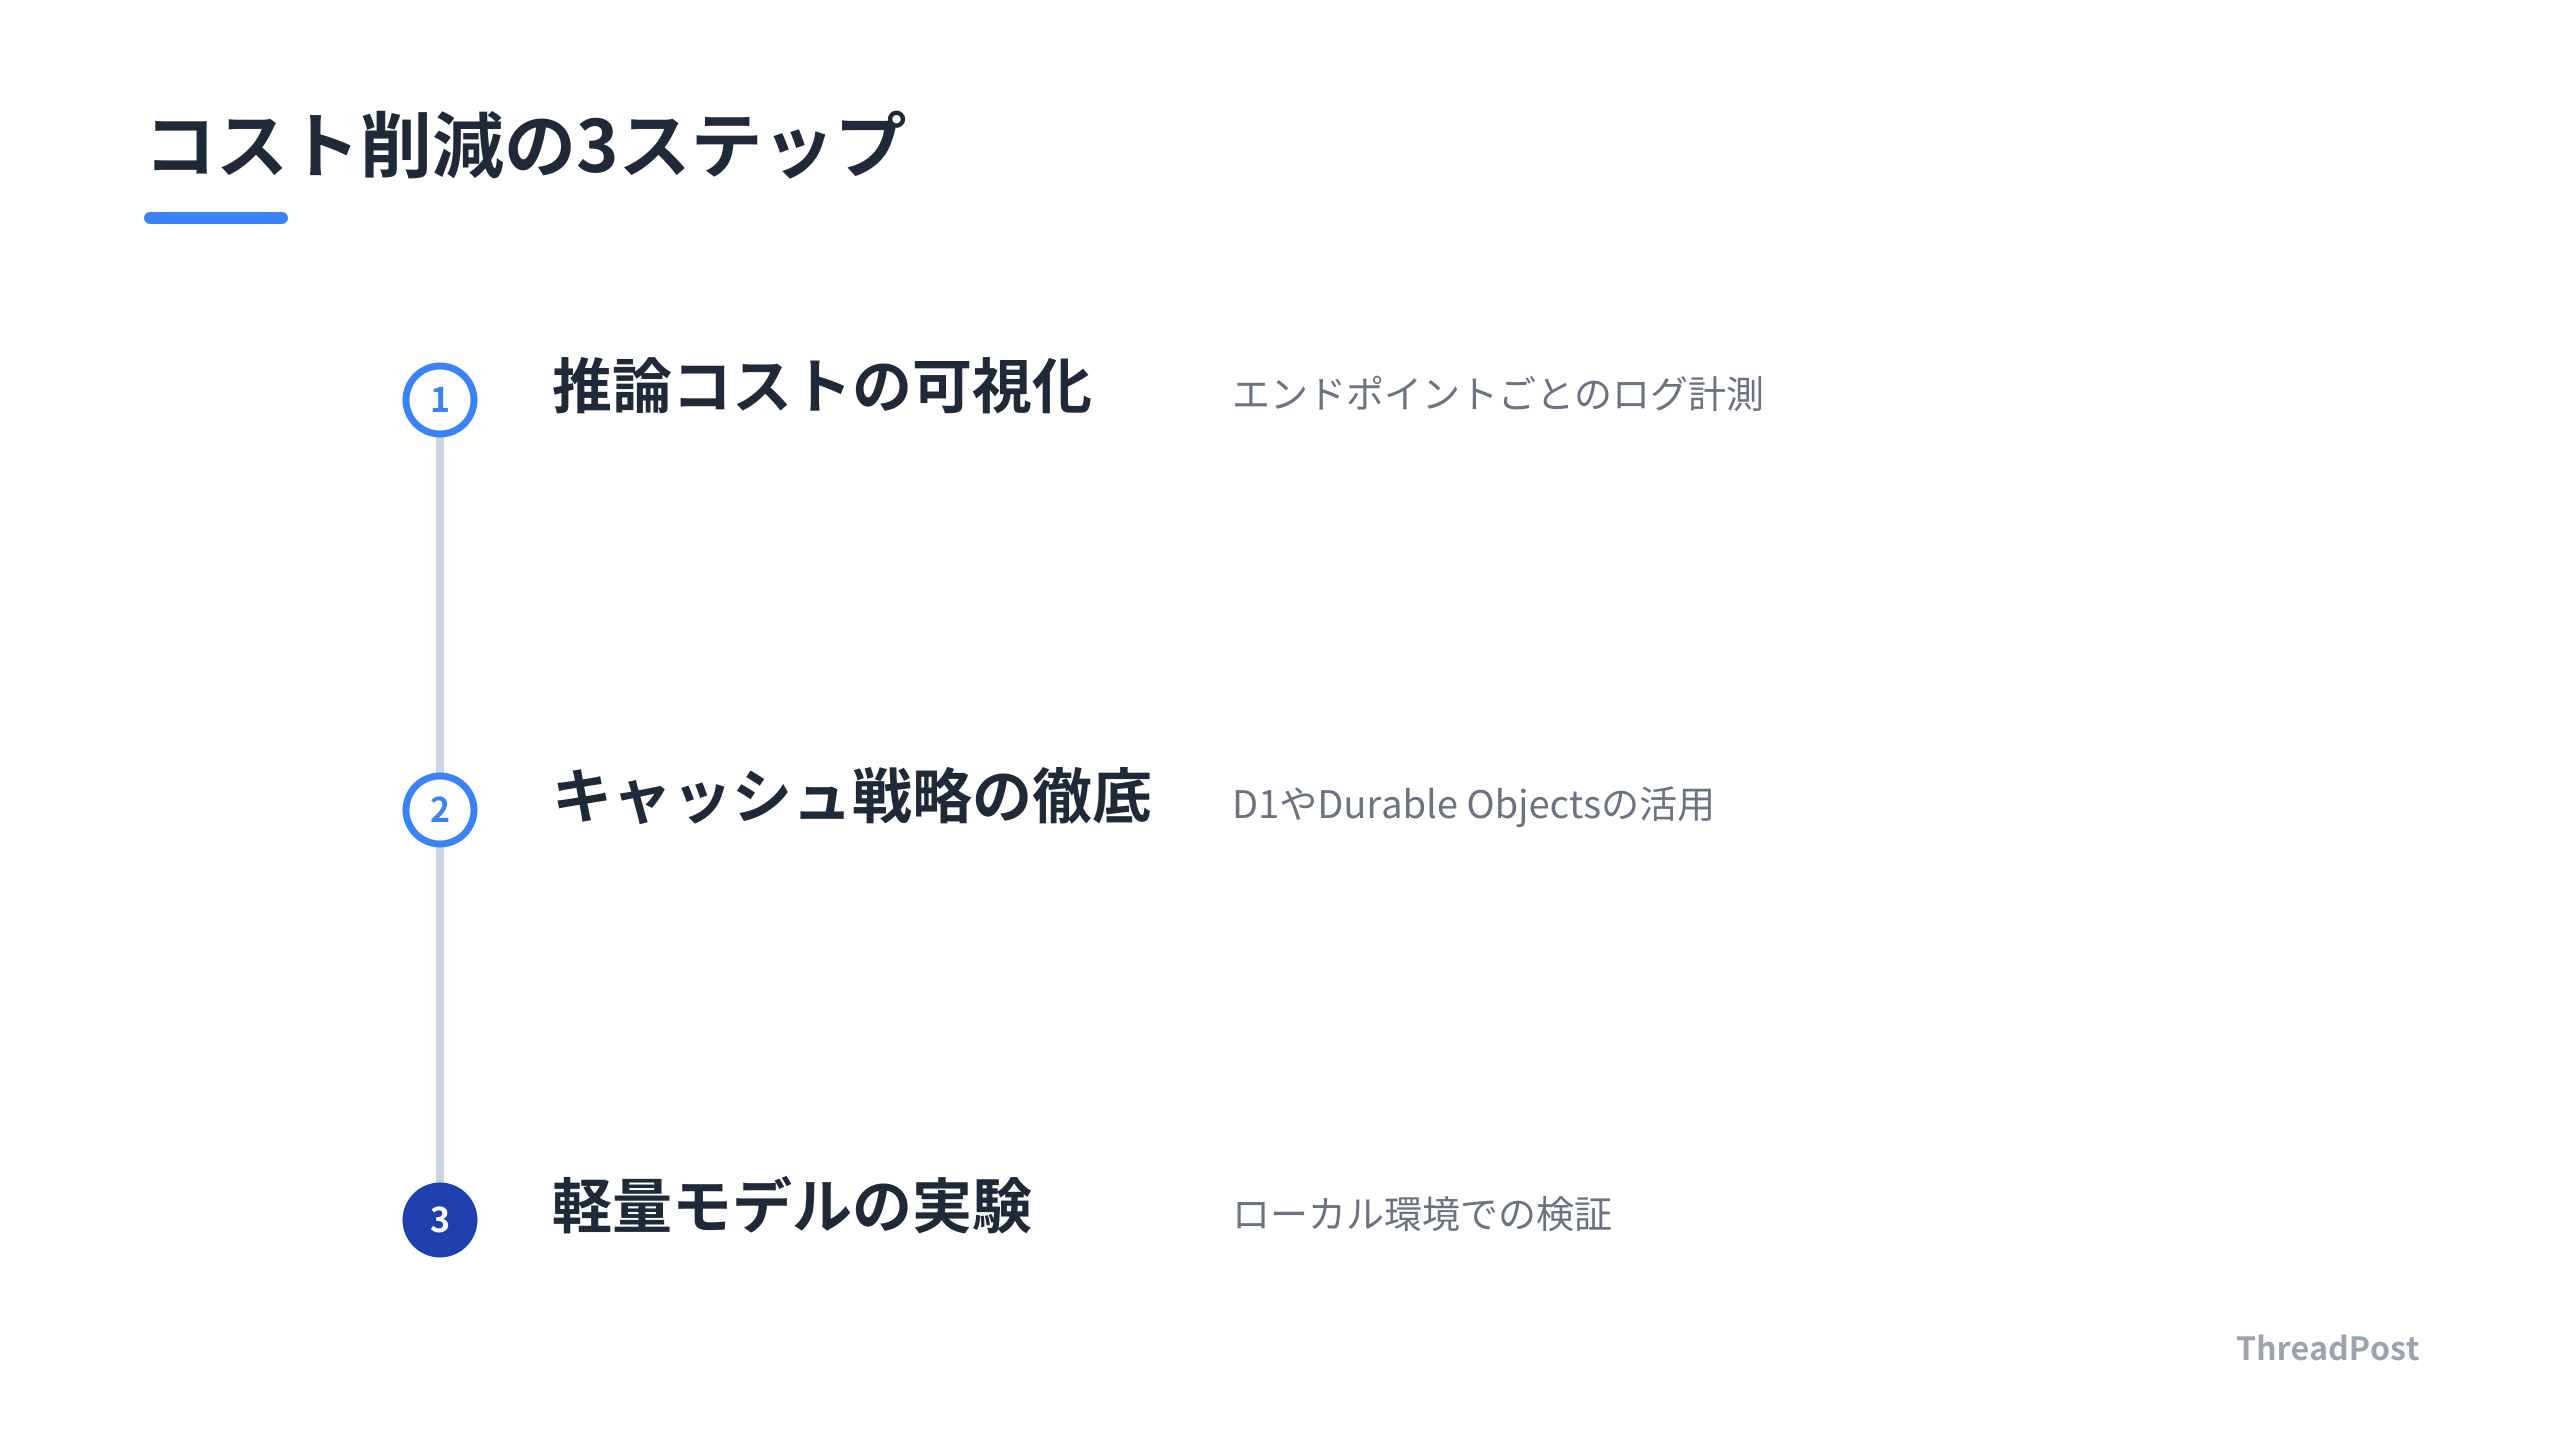
具体的なアクションとして、以下の3点を試す。
* 推論コストの可視化: どの機能がどの程度のトークンを消費しているか、エンドポイントごとに計測するログを実装する。
* キャッシュ戦略の徹底: 頻出するクエリや、過去の推論結果を再利用できる仕組みをD1やDurable Objectsで構築する。
* 軽量モデルの実験: 汎用APIを叩く前に、ローカル環境や軽量モデルで完結できないか検証する時間を確保する。
これらは単なるコスト削減のための作業ではない。推論単価を極限まで下げることは、プロダクトの利益率を向上させ、競合がコスト増で苦しむ中でも、低価格で高品質なサービスを提供し続けられる武器になる。
APIを使いこなす側から、推論インフラを設計する側へ。この視点の切り替えができれば、AI開発の現場は変わる。手元の実装で、最もトークンを食っている箇所を1つ特定することから始める。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
1-bitモデルのビット反転パッチは、本番環境で実用レベルですか?
現時点では、特定の定型タスクや分類問題に特化した「補助的な最適化」として強力だ。LoRAのような浮動小数点演算を伴う追加学習とは異なり、モデルの重みを直接ビット反転させるため、推論速度を落とさずに特定の挙動を強制できる。エッジ環境や、推論コストを削りたいサーバーレス構成において、従来のファインチューニングに代わる軽量な選択肢となる。
検索拡張生成(RAG)のAPIコストを抑えるコツはありますか?
検索対象のチャンク化と、検索頻度の最適化が鍵だ。例えば、cronジョブを用いてナレッジ更新をバッチ処理化し、ベクトルストアへの書き込みを「5分に1回」のように制御するだけで、APIの呼び出し回数を減らせる。また、Thinkingモデルをオフにするか、タスクに応じて軽量モデルへルーティングする運用を徹底するだけで、推論単価は変わる。
Claude CodeのようなAIエージェントを使う際、コスト管理の注意点は?
エージェントは自律的にAPIを叩くため、意図しないコスト増幅が起きやすい。特に「ツール呼び出し」の回数を制限するレートリミット設定は必須だ。また、エージェントが生成するコードや推論結果をキャッシュ層に保存し、同じ計算を繰り返さない設計を組み込むことで、API利用料を抑えられる。まずは利用ログを細かく計測し、どのツールが最もトークンを消費しているか特定する。
まとめ
APIコストの削減は、単なる節約術ではなく、推論インフラをどう設計するかの勝負だ。1-bitモデルのビット反転パッチで挙動を制御し、RAGで知識を動的に補完する。この二段構えが、今の開発者が取るべき最適解だ。
汎用モデルに頼り切る時代は終わり、自分たちのタスクに特化した「軽量で賢い」推論環境を構築するフェーズに入った。コストを削るだけでなく、推論の質と速度を同時に高める技術を磨く。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
