


月額480ドルのAPI費用を削減できたとしたら、あなたならその予算を何に使いますか?
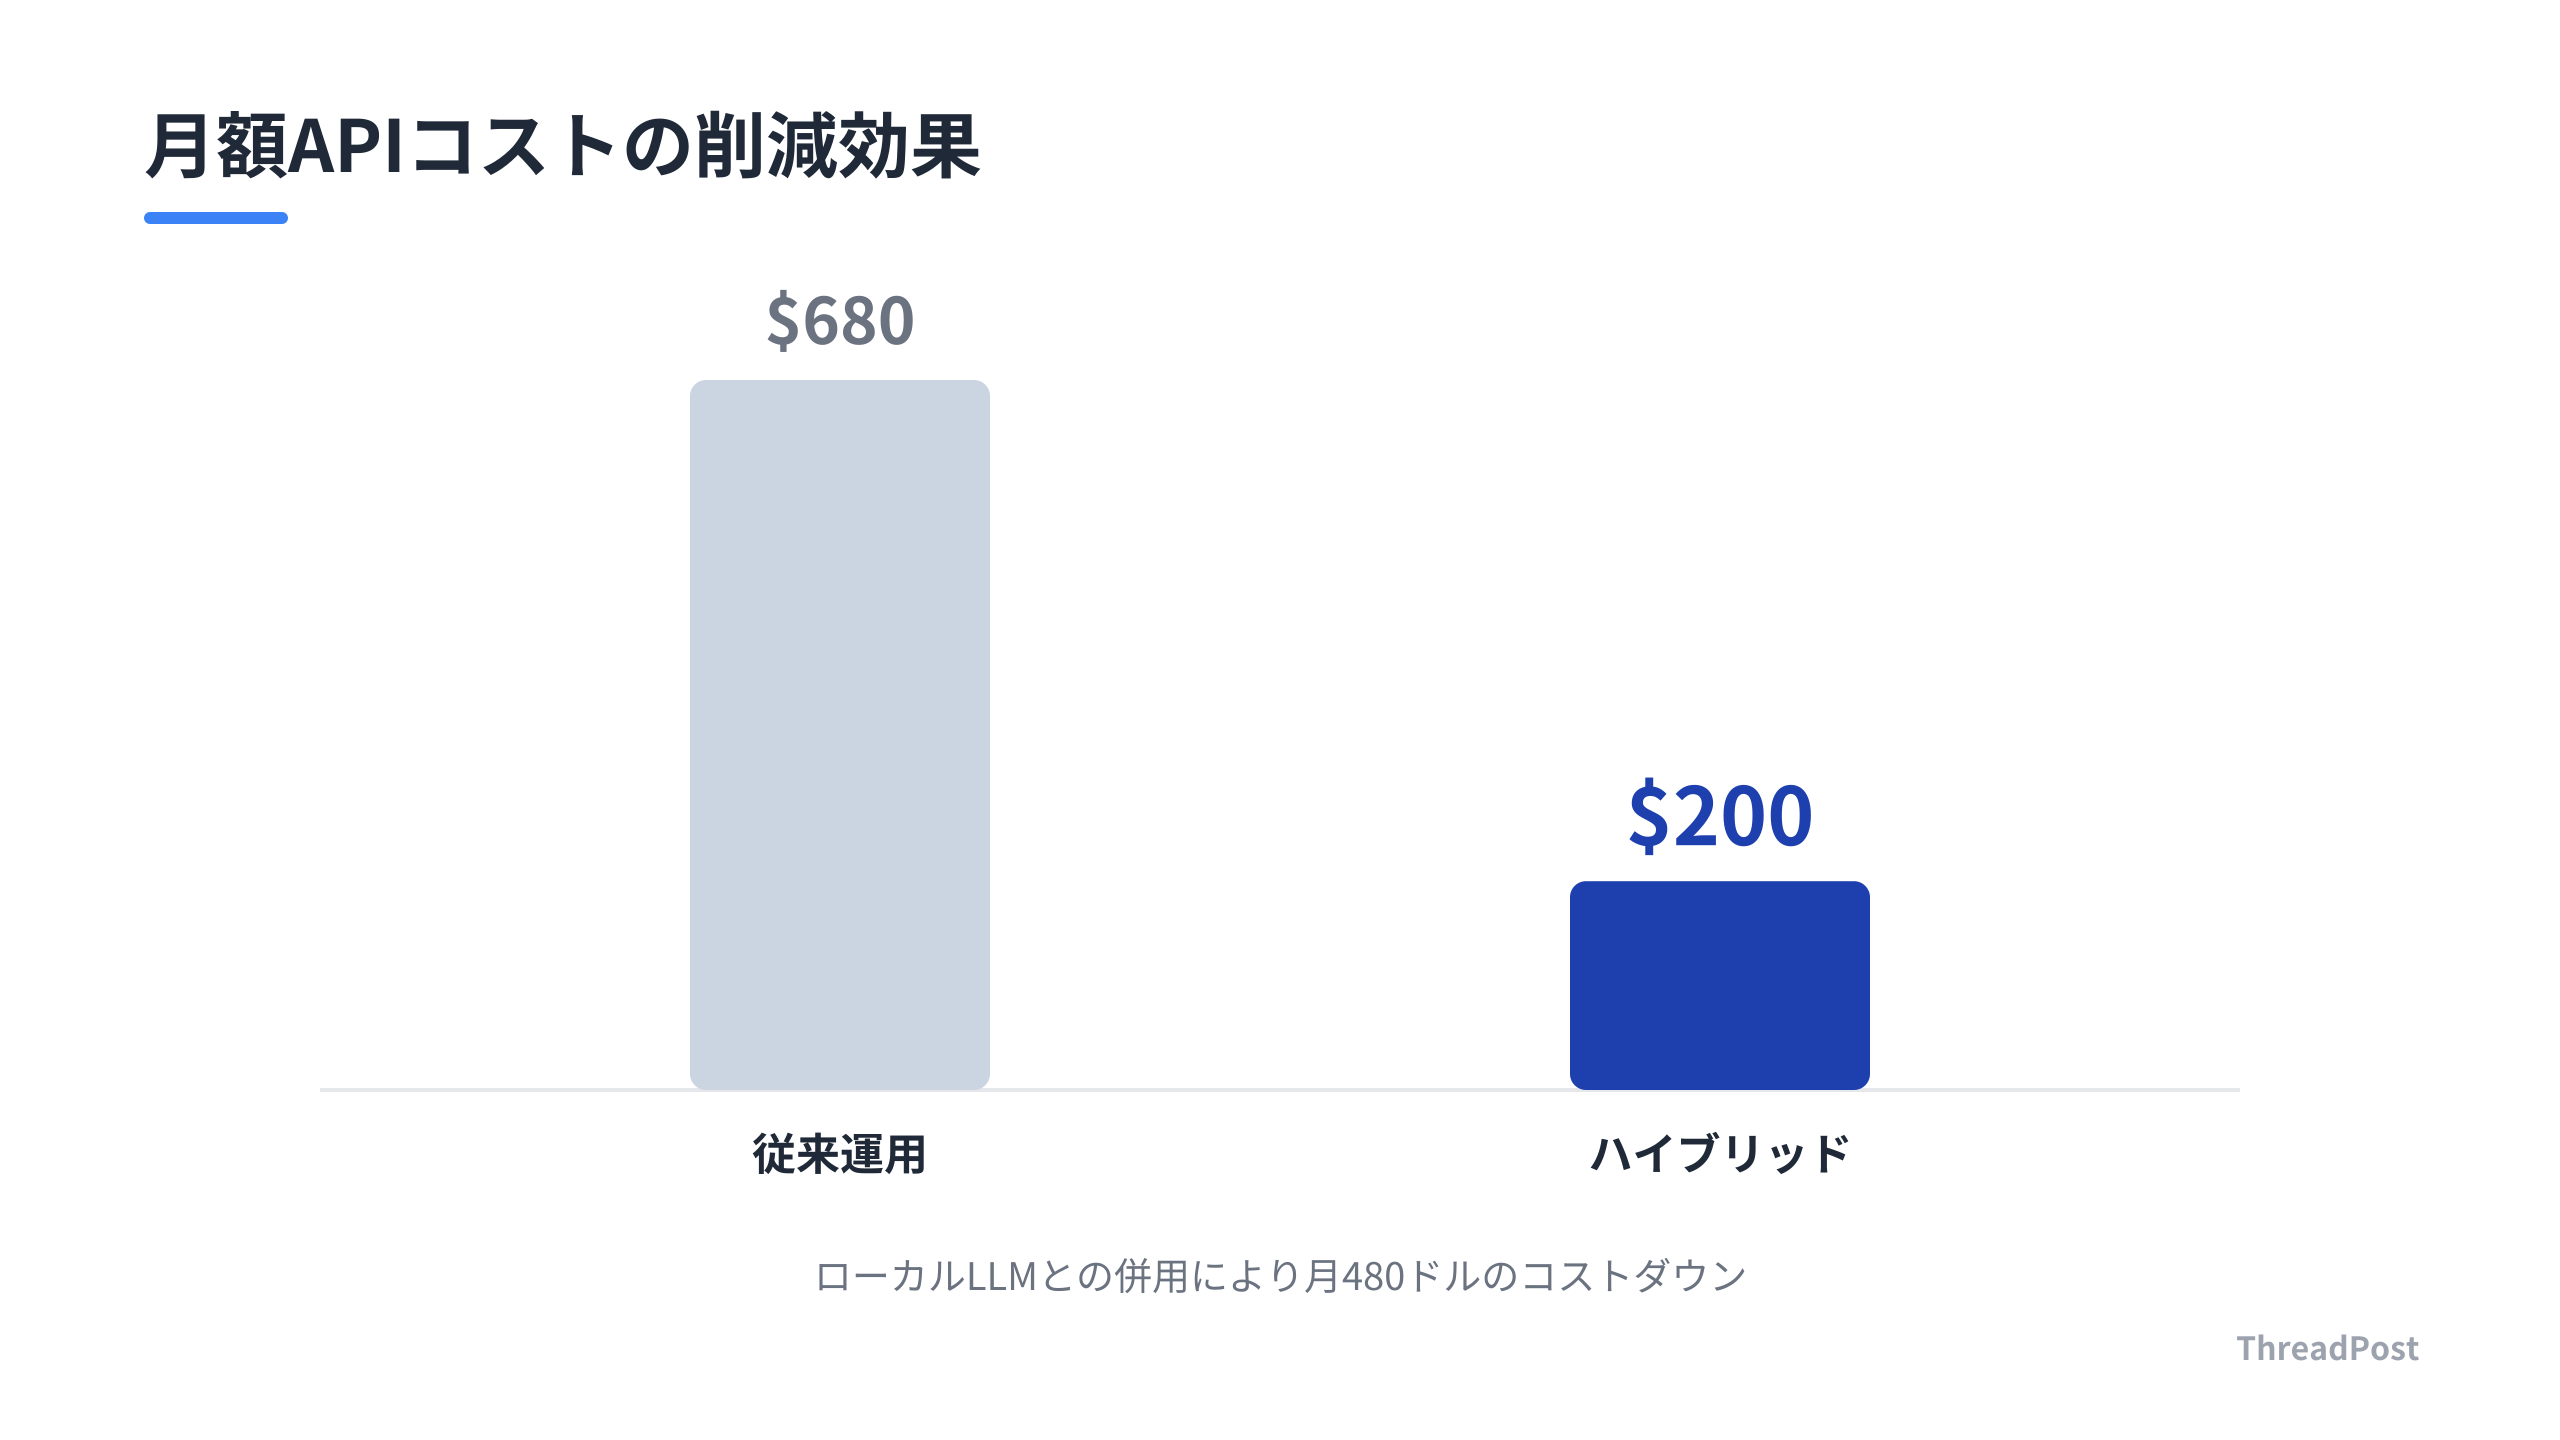
僕はClaude Codeで1人SaaSを開発している。APIコストが月680ドルを超えた時、全量をローカルLLMに切り替えた。
この記事では、Qwen3-NextとClaudeを組み合わせ、月480ドルのコストダウンを実現したハイブリッド運用の全貌を公開する。推論エンジンの最適化とタスクルーティングを組み込んだインフラ構築手法だ。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
ローカルLLM運用におけるコスト削減とインフラ設計の現実
APIコスト削減のためにローカルLLMへ移行する開発者が増えている。Qwen3-Next 80BをMLXフレームワークでApple Silicon上で動かす構成だ。月額680ドルかかっていたAPI利用料を、ローカルとのハイブリッド運用へ切り替えることで、月480ドルの削減を実現した。
移行にはモデルをローカルで走らせる以上の準備が必要だ。16GBのメモリでは45GBの量子化モデルを展開できず、スワップ発生により推論速度が1〜3 tokens/secまで低下する。64GB以上のメモリを搭載したマシンへの投資や、モデルをMLX形式へ変換する30分程度の事前準備、再起動時に推論サーバーを自動復旧させるlaunchd設定が必須だ。
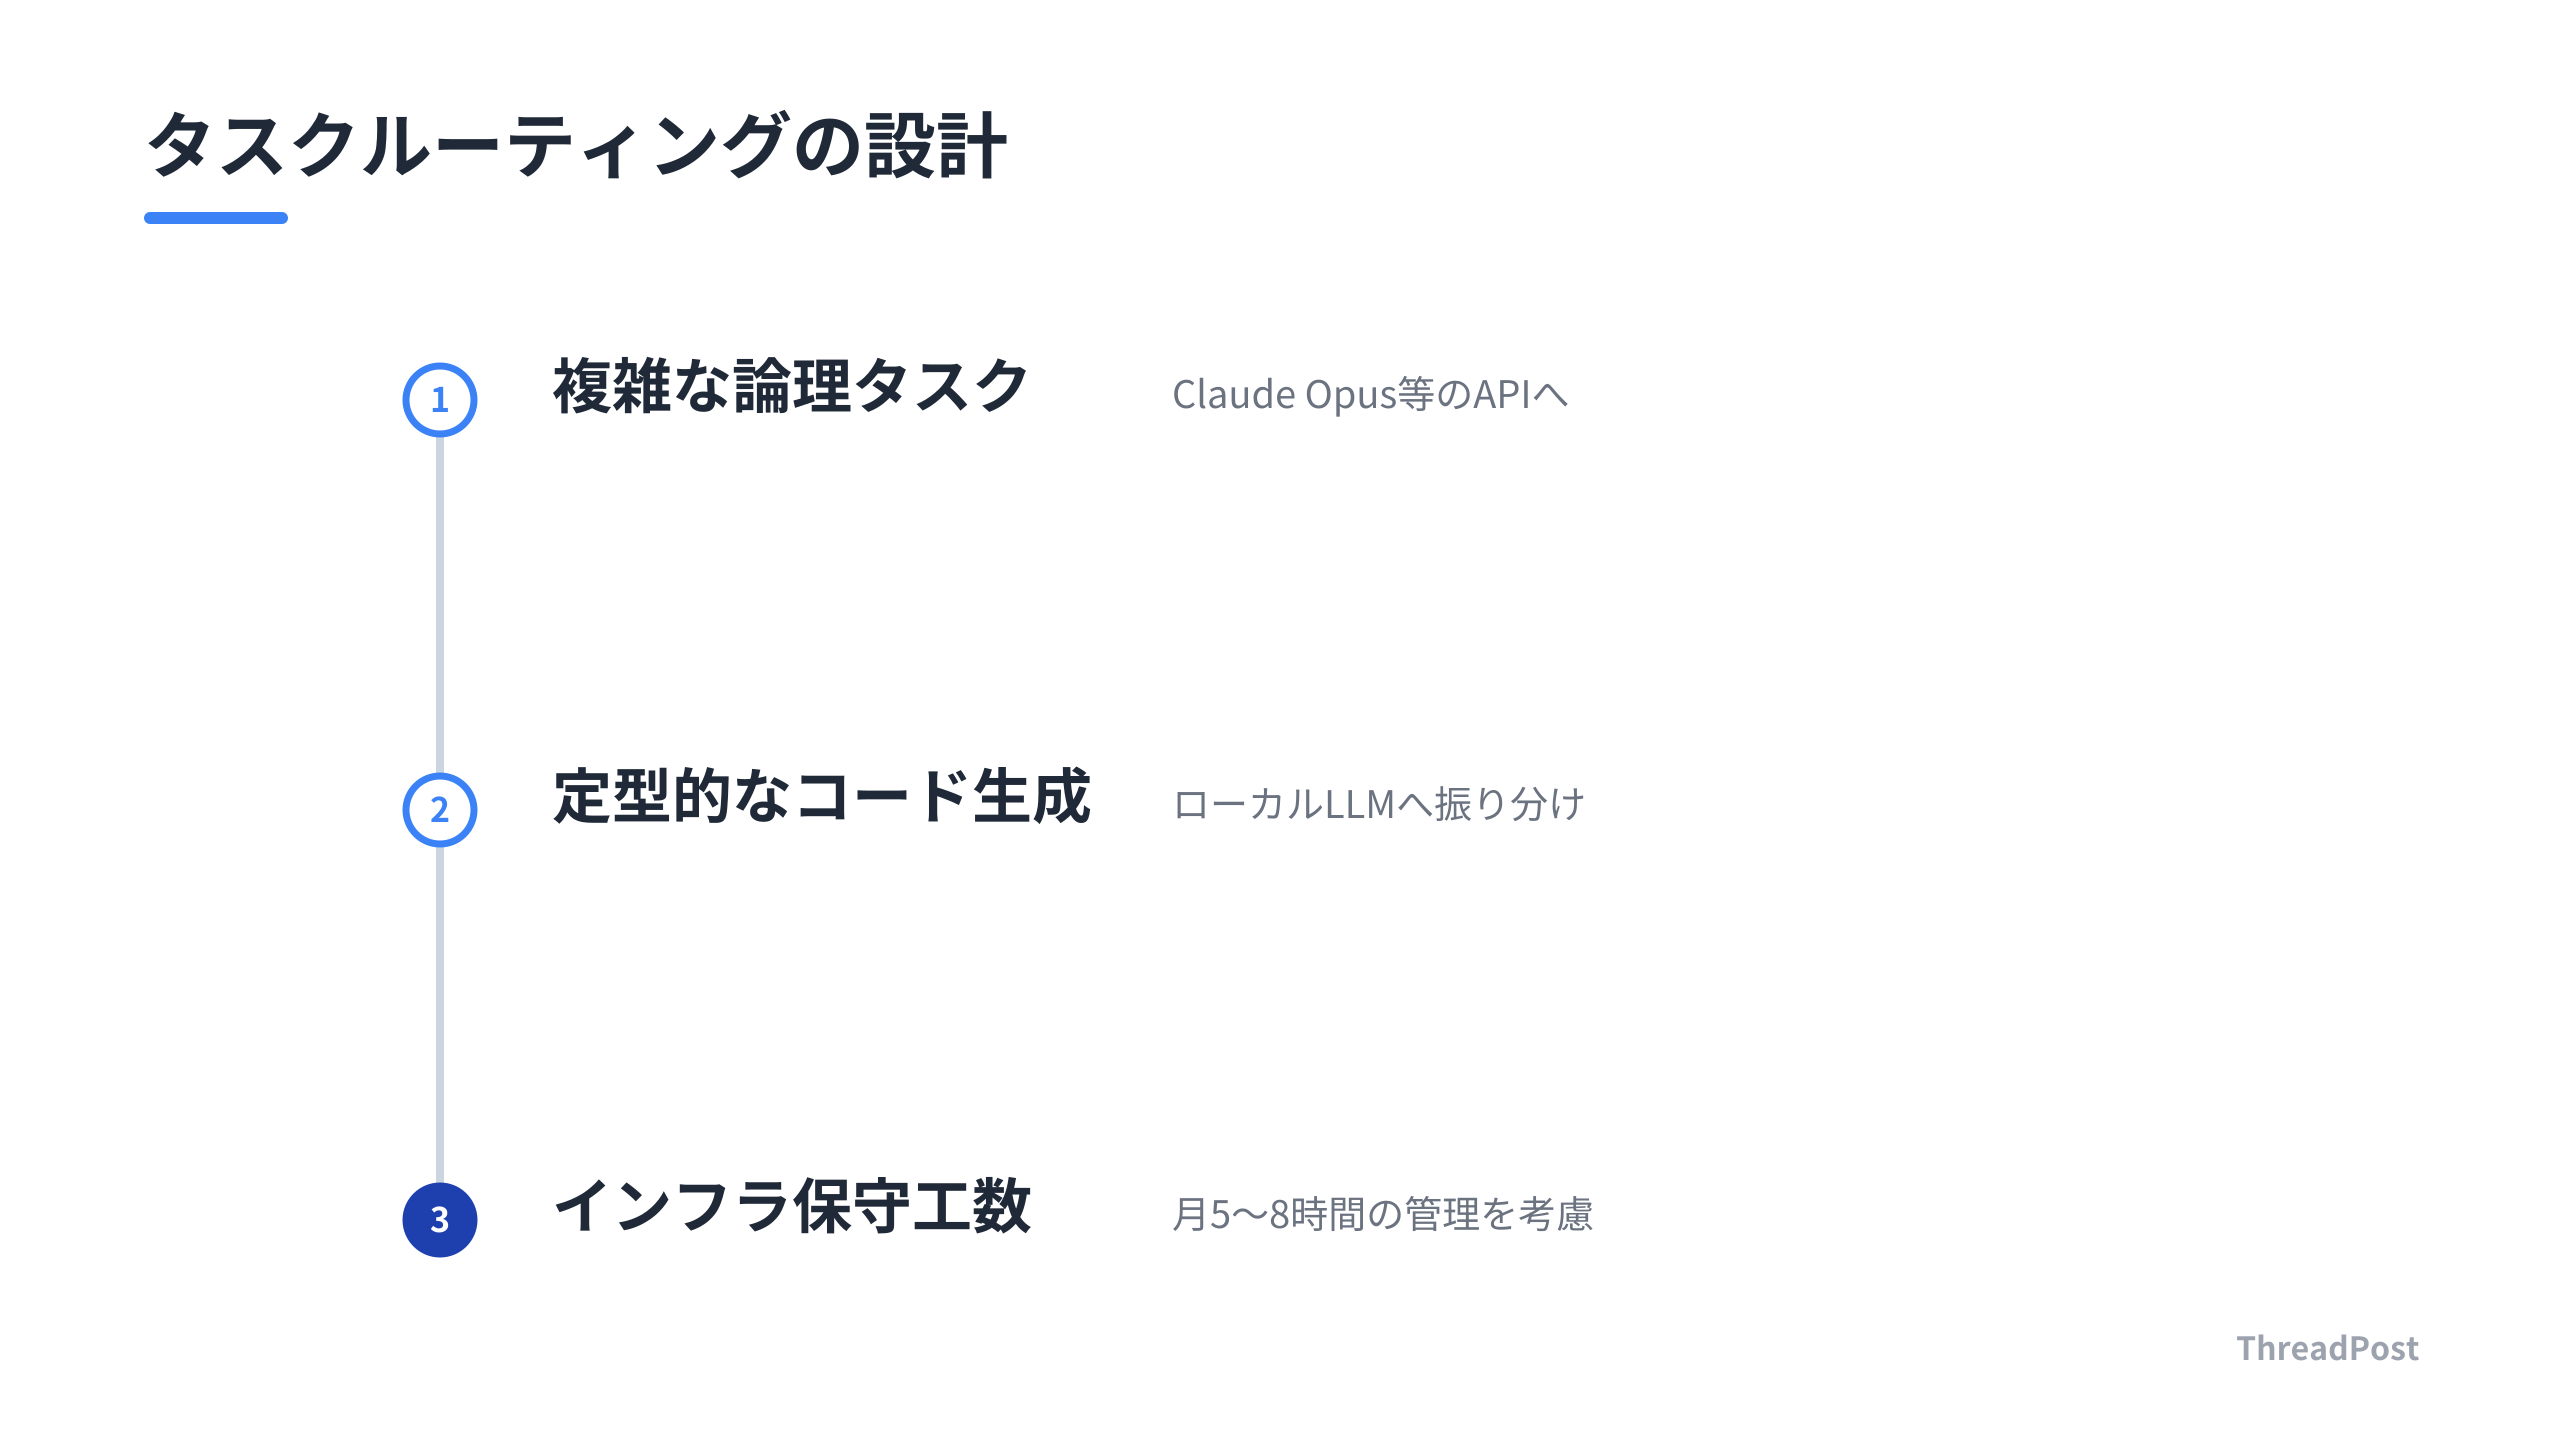
ローカルLLM運用にはサーバーの保守管理に月5〜8時間の工数がかかる。論理的思考が必要な複雑なタスクはClaude Opusへ、定型的なコード生成や要約をローカルへ流すタスクルーティングが品質とコストを両立させる。
しんたろー:
ローカルLLMを導入すると、OSのアップデートや依存関係のトラブルで深夜に叩き起こされるリスクが増える。API代を払うか、自分の時間を切り売りしてサーバー管理するか。このトレードオフが気になる。
並列推論の設計においても注意が必要だ。OLLAMA_NUM_PARALLELを設定すると、リクエストの有無に関わらずその分だけKVキャッシュがVRAM上に予約される。32GBのVRAM環境であっても、不適切な設定では2GiBを超える中間テンソルが生成されてアサート落ちが発生する。
最新のGemma 4などが備える思考モードは、複雑な推論タスクにおいて247通りものパターンを論理的に導き出す処理を可能にする。これらを引き出すためには、Flash Attentionの有効化やKVキャッシュ量子化(q8_0)といった最適化をセットで適用する。推論エンジンとハードウェアの制約を理解したAIインフラエンジニアリングが開発者に求められている。
 あわせて読みたいローカルLLMのおすすめ構成2026|モデルと実行ツールを実測で選ぶ完全ガイド →
ローカルLLM運用は「モデル選び」ではなく「インフラ設計」である
ローカルLLMへの移行を検討する際、推論性能という単一の指標でモデルやエンジンを選んでしまう開発者が多い。実際に運用すると、直面するのはモデルの賢さよりも、サーバーの常駐管理やメモリの物理制約という泥臭いインフラ運用だ。
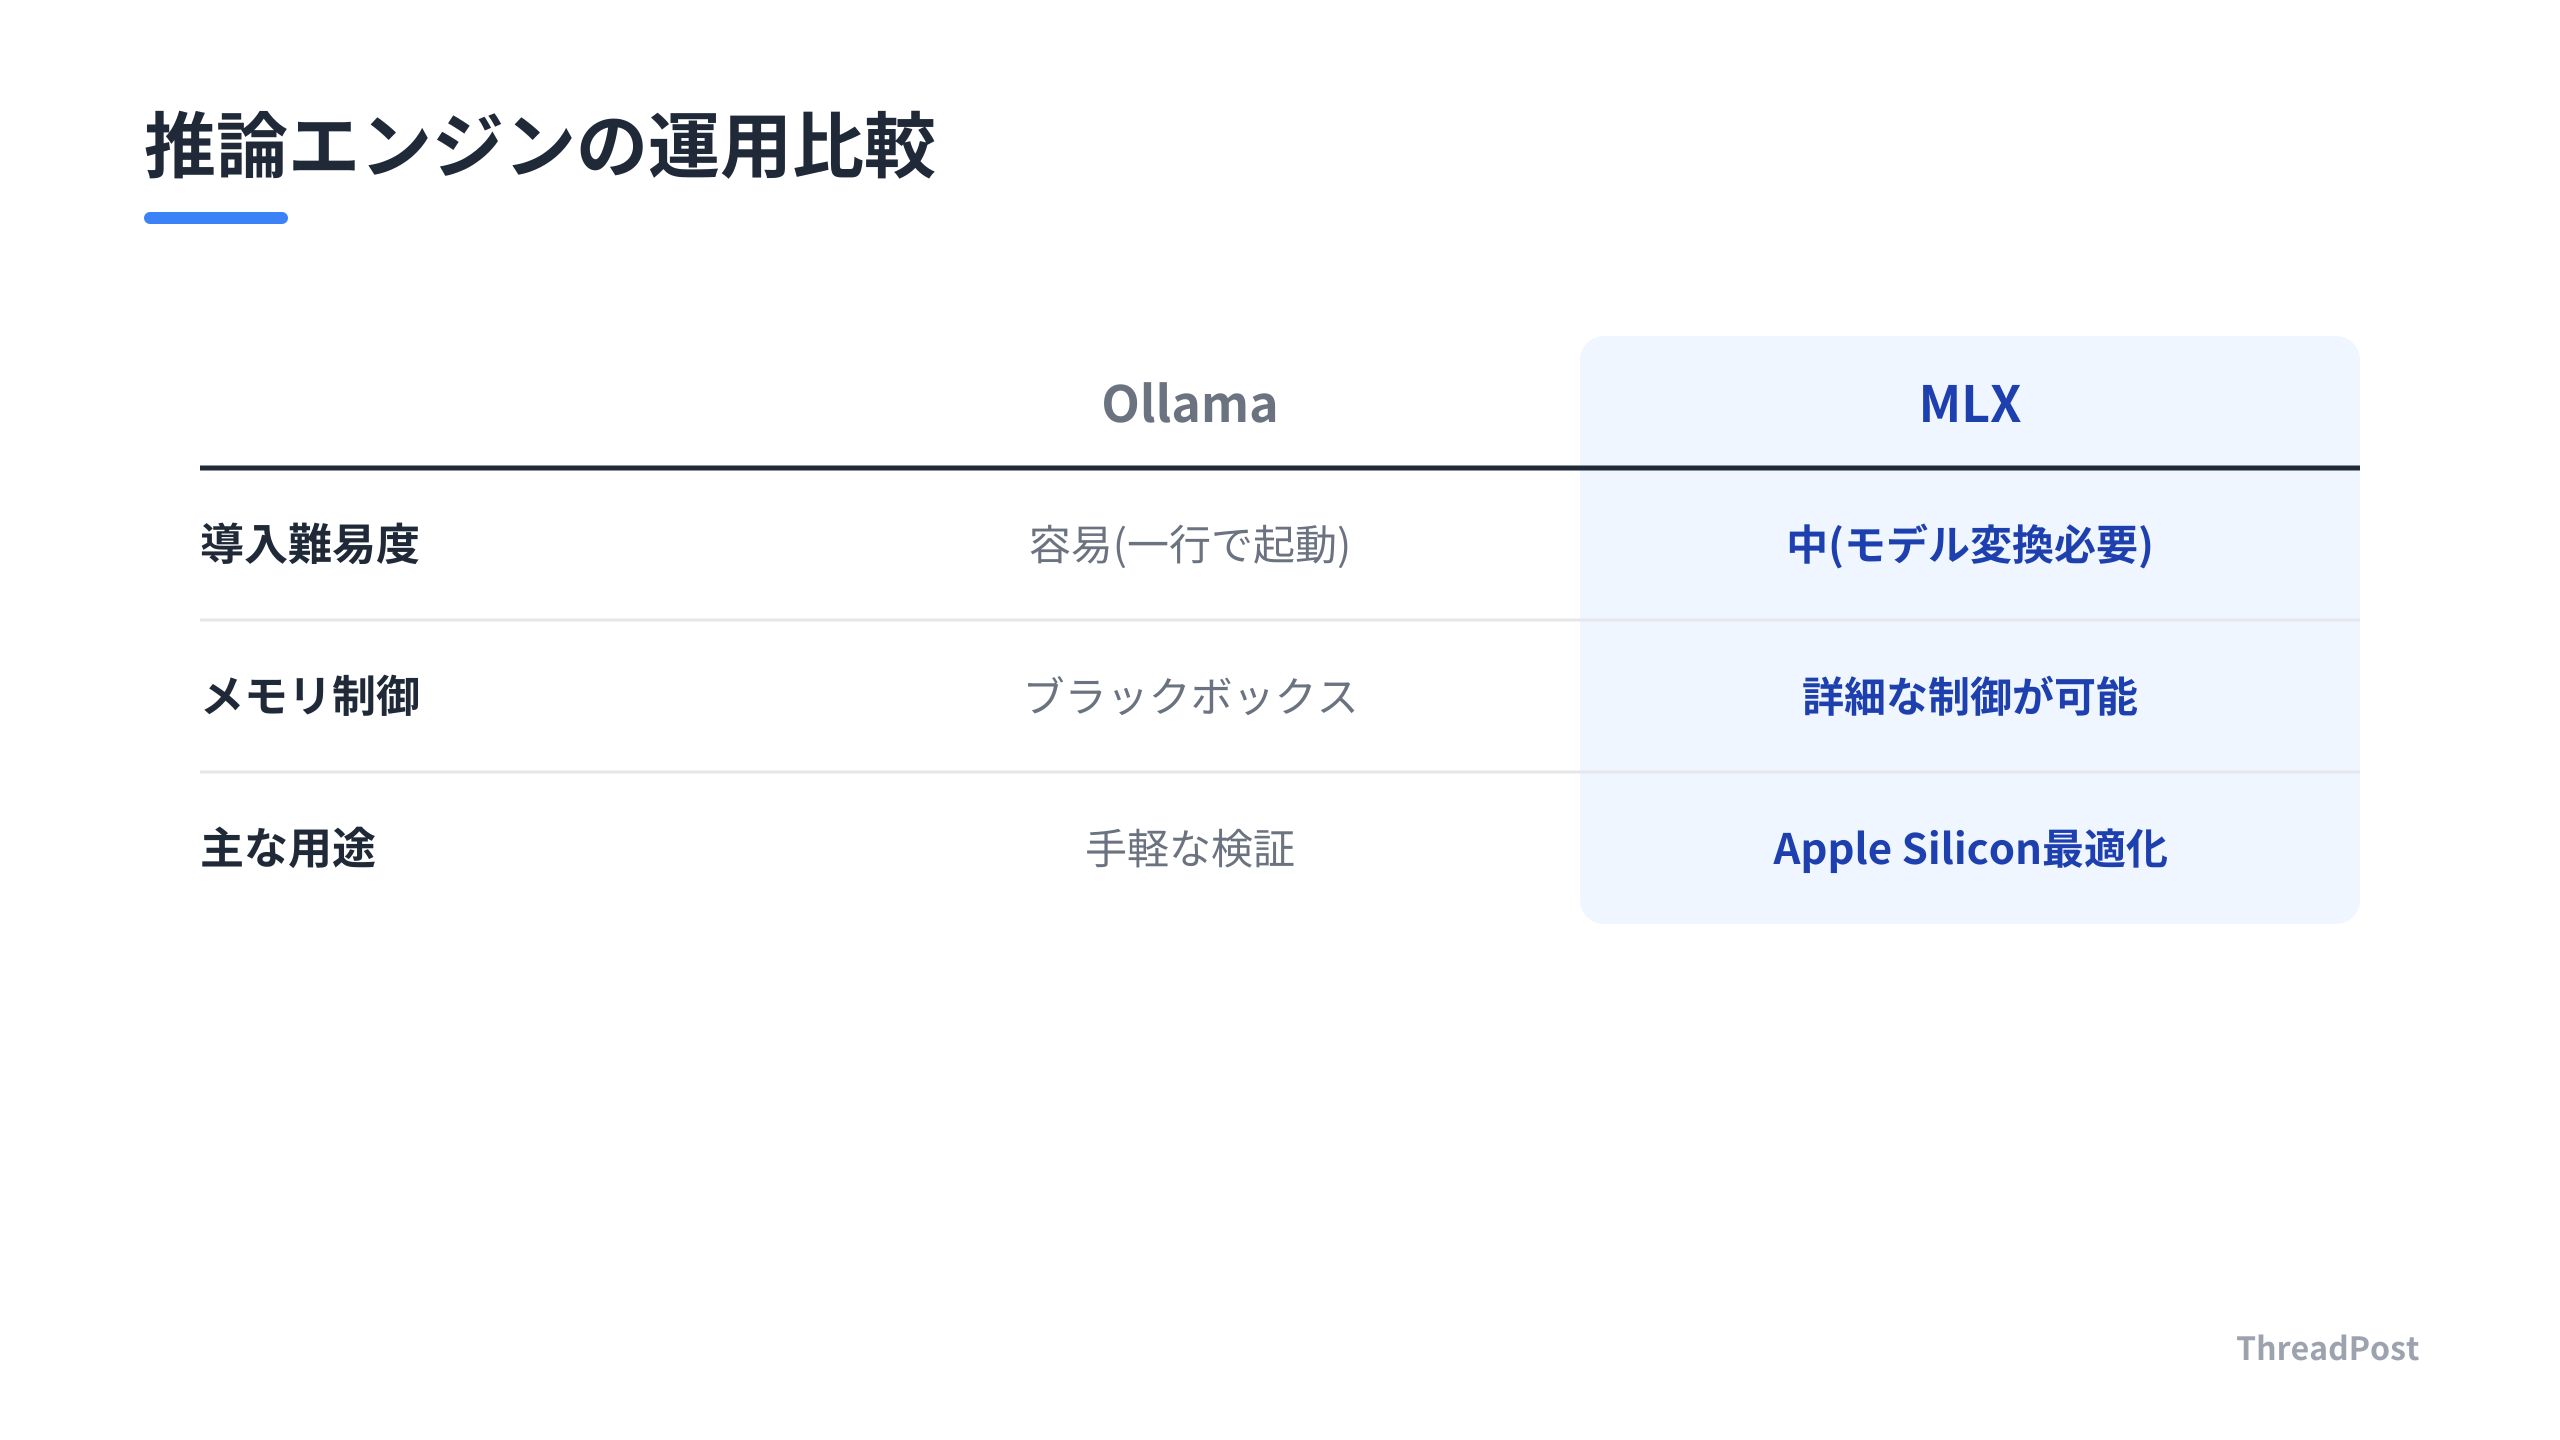
Ollamaの利便性とMLXの高度な最適化は、開発フェーズの差を物語っている。Ollamaは一行で立ち上がるが、並列推論の制御や中間テンソルのメモリ管理といった低レイヤーの挙動をブラックボックス化する。対してMLXは、モデル変換という手間を強いる代わりに、Apple Siliconのユニファイドメモリを使い切るための制御を開発者に委ねる。
僕はClaude Codeで1人SaaSを開発する際、この制御の主導権を重視する。エージェントが自律的にコードを生成・テストするループを回す際、推論エンジンの応答速度が数秒遅れるだけで、エージェントの思考プロセスは断絶する。ローカルLLMの導入は、自分の開発環境に最適化された推論パイプラインを構築するインフラエンジニアリングだ。
ローカルLLMを動かし始めると、なぜか推論が止まる、メモリが解放されないといったトラブルと戦うことになる。便利になったのか退化したのか分からなくなる瞬間があるが、自分のコードで推論を制御している感覚は面白い。
全てのタスクをローカルの高性能モデルに投げるのは、コストと品質の両面で最適解ではない。論理的思考や日本語のニュアンスが求められるタスクはClaudeのようなクラウドAPIに流し、コードの補完や単純なバッチ処理、要約といった定型業務をローカルLLMに肩代わりさせる。このハイブリッド構成こそが、月480ドルのコスト削減と開発クオリティの維持を両立させる現実的な解だ。
ローカルLLMの保守に月5〜8時間を費やしているなら、削減したAPIコストと時給を天秤にかける必要がある。管理コストが削減額を上回るなら、エンジニアとしての自己満足に終わっている。
並列推論を行う際、リクエストが来ていないにもかかわらず並列数分だけメモリを予約するOllamaの仕様は、小規模なVRAM環境では致命的なOOMを招く。Flash AttentionとKV量子化を組み合わせ、Context Lengthをアプリケーション側とサーバー側で厳密に同期させる。これら一連のパラメータ調整は、OSやミドルウェアのカーネルチューニングに近い。
ローカルLLM運用とは、AIを動かすインフラを飼い慣らすことに他ならない。Claude Codeを動かすバックエンドとして、どのモデルを、どのくらいの並列数で、どのハードウェアに乗せるか。その設計図が描けるかどうかが、今後の開発効率を左右する。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
開発者が今すぐ向き合うべき「AIインフラ」の現実
ローカルLLMの導入は、開発フローの中に推論インフラという新たなレイヤーを組み込む作業だ。APIを叩くだけで完結していた処理に、モデルの変換、ハードウェアの監視、自動起動スクリプトの保守という管理工数が付随する。
開発者はどのモデルを使うか以上に、どのタスクをローカルで捌き、どのタスクをAPIに投げるかというルーティング設計を避けて通れない。すべての処理をローカルに寄せるのは、品質リスクと保守コストの観点から現実的ではない。論理的思考が必要な複雑なタスクは高性能なAPIに任せ、コード生成や要約といった定型的な処理をローカルへ振り分ける。このハイブリッドな構成こそが、実務レベルで持続可能なAI活用の最適解だ。
何でもかんでもローカルで動かそうとするのは趣味の領域だ。仕事で使うなら、落ちたら困るAPIと、コストを削りたいローカルをどう混ぜるか。この混ぜる技術がないと、システムが詰まって夜中に対応する羽目になる。
並列推論の設定にも注意が必要だ。Ollama等のツールで並列数を設定する際、リクエストの有無に関わらずKVキャッシュが物理メモリを占有する仕様は、VRAMの限られた環境でボトルネックになりやすい。実務では、アプリケーション側から送信するプロンプトのコンテキスト長をサーバー側の設定と厳密に揃えることが不可欠だ。検証環境で動いたコードが、本番環境で突然のOOMでクラッシュする。起動ログの環境変数を徹底的に精査し、意図したメモリ消費量に収まっているかを計測する習慣が求められる。
今後は、AIを安定稼働させるためのリソース管理能力がエンジニアの価値を左右する。Claude Codeのような自律型エージェントをローカルで運用するなら、推論エンジンのボトルネックを特定し、ネットワークI/Oにあるのか、あるいはGPU演算にあるのかを切り分ける観察眼が必要だ。
API代が浮いた裏で、時給換算で何時間の保守コストが発生しているか。このROIを冷徹に計算できるエンジニアこそが、これからのAI時代に生き残る。明日からの開発では、APIの利用料だけでなく、自身の運用工数もコストとして計上する。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
Q1: ローカルLLMに移行すれば本当にAPI費用はゼロになりますか?
直接的なAPI課金は消えるが、ハードウェアの減価償却、電気代、保守・運用コストが発生する。実運用では、環境のセットアップや再起動時の自動化、モデルの更新といった管理工数が避けられない。月間5〜8時間の保守工数を時給換算すると、APIコスト削減分を相殺するケースもある。導入前には、APIの利用料だけでなく、自身の運用工数をコストとして含めたROIを冷徹に計算する。
Q2: Ollamaで並列推論を行うとVRAMが足りなくなるのはなぜですか?
Ollamaは並列数(OLLAMA_NUM_PARALLEL)を設定した瞬間に、リクエストの有無に関わらずその分だけKVキャッシュをVRAM上に予約する仕様だからだ。VRAMが足りない場合は、Flash Attentionの有効化や、KVキャッシュの量子化(OLLAMA_KV_CACHE_TYPE=q8_0)を検討する。これらはモデル側が対応している必要があり、設定を誤るとOOMで即座にクラッシュする。起動ログを確認し、意図した環境変数が反映されているかチェックする。
Q3: ローカルLLMで日本語の品質を維持するにはどうすればいいですか?
全てのタスクをローカルで完結させず、タスクルーティングを導入する。論理的思考や高度な日本語表現が必要なタスクはClaude Opus等の高性能APIへ、コード生成や定型的な要約タスクはローカルLLMへと自動的に振り分けるハイブリッド構成をとることで、品質とコストのバランスを最適化できる。全部をローカルに置き換えるのではなく、適材適所で使い分ける運用設計こそが、実務でAIを使い倒すための鍵だ。
まとめ
ローカルLLMの導入は、単なるAPI費用の削減策ではなく、推論エンジンの最適化やハードウェア制約との戦いを含むインフラ構築そのものだ。推論速度やメモリ消費、モデルごとの日本語品質の癖を理解し、タスクルーティングによって賢く使い分ける。
この適材適所の運用設計こそが、開発者の手元を最強の環境に変えるための道だ。APIのコストとローカル運用の品質のジレンマを解消し、より高速かつ柔軟な開発フローを構築する手法については、ThreadPostでさらに深掘りしていく。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
