


AIモデルが回答に至る推論プロセス。これが攻撃者に狙われている。最近の調査で、モデルの内部的な思考ログを外部化させる「推論の抽出」を狙った大規模な攻撃キャンペーンが確認された。
これは開発するLLMアプリの強化学習パイプラインやプロンプト設計が、モデルの思考を盗む標的になり得ることを示す。Claude Codeでコードを書く際、モデルを守り、推論を隠蔽するための防御の最前線を解説する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
AIモデルの内部思考を狙う「推論抽出」の脅威
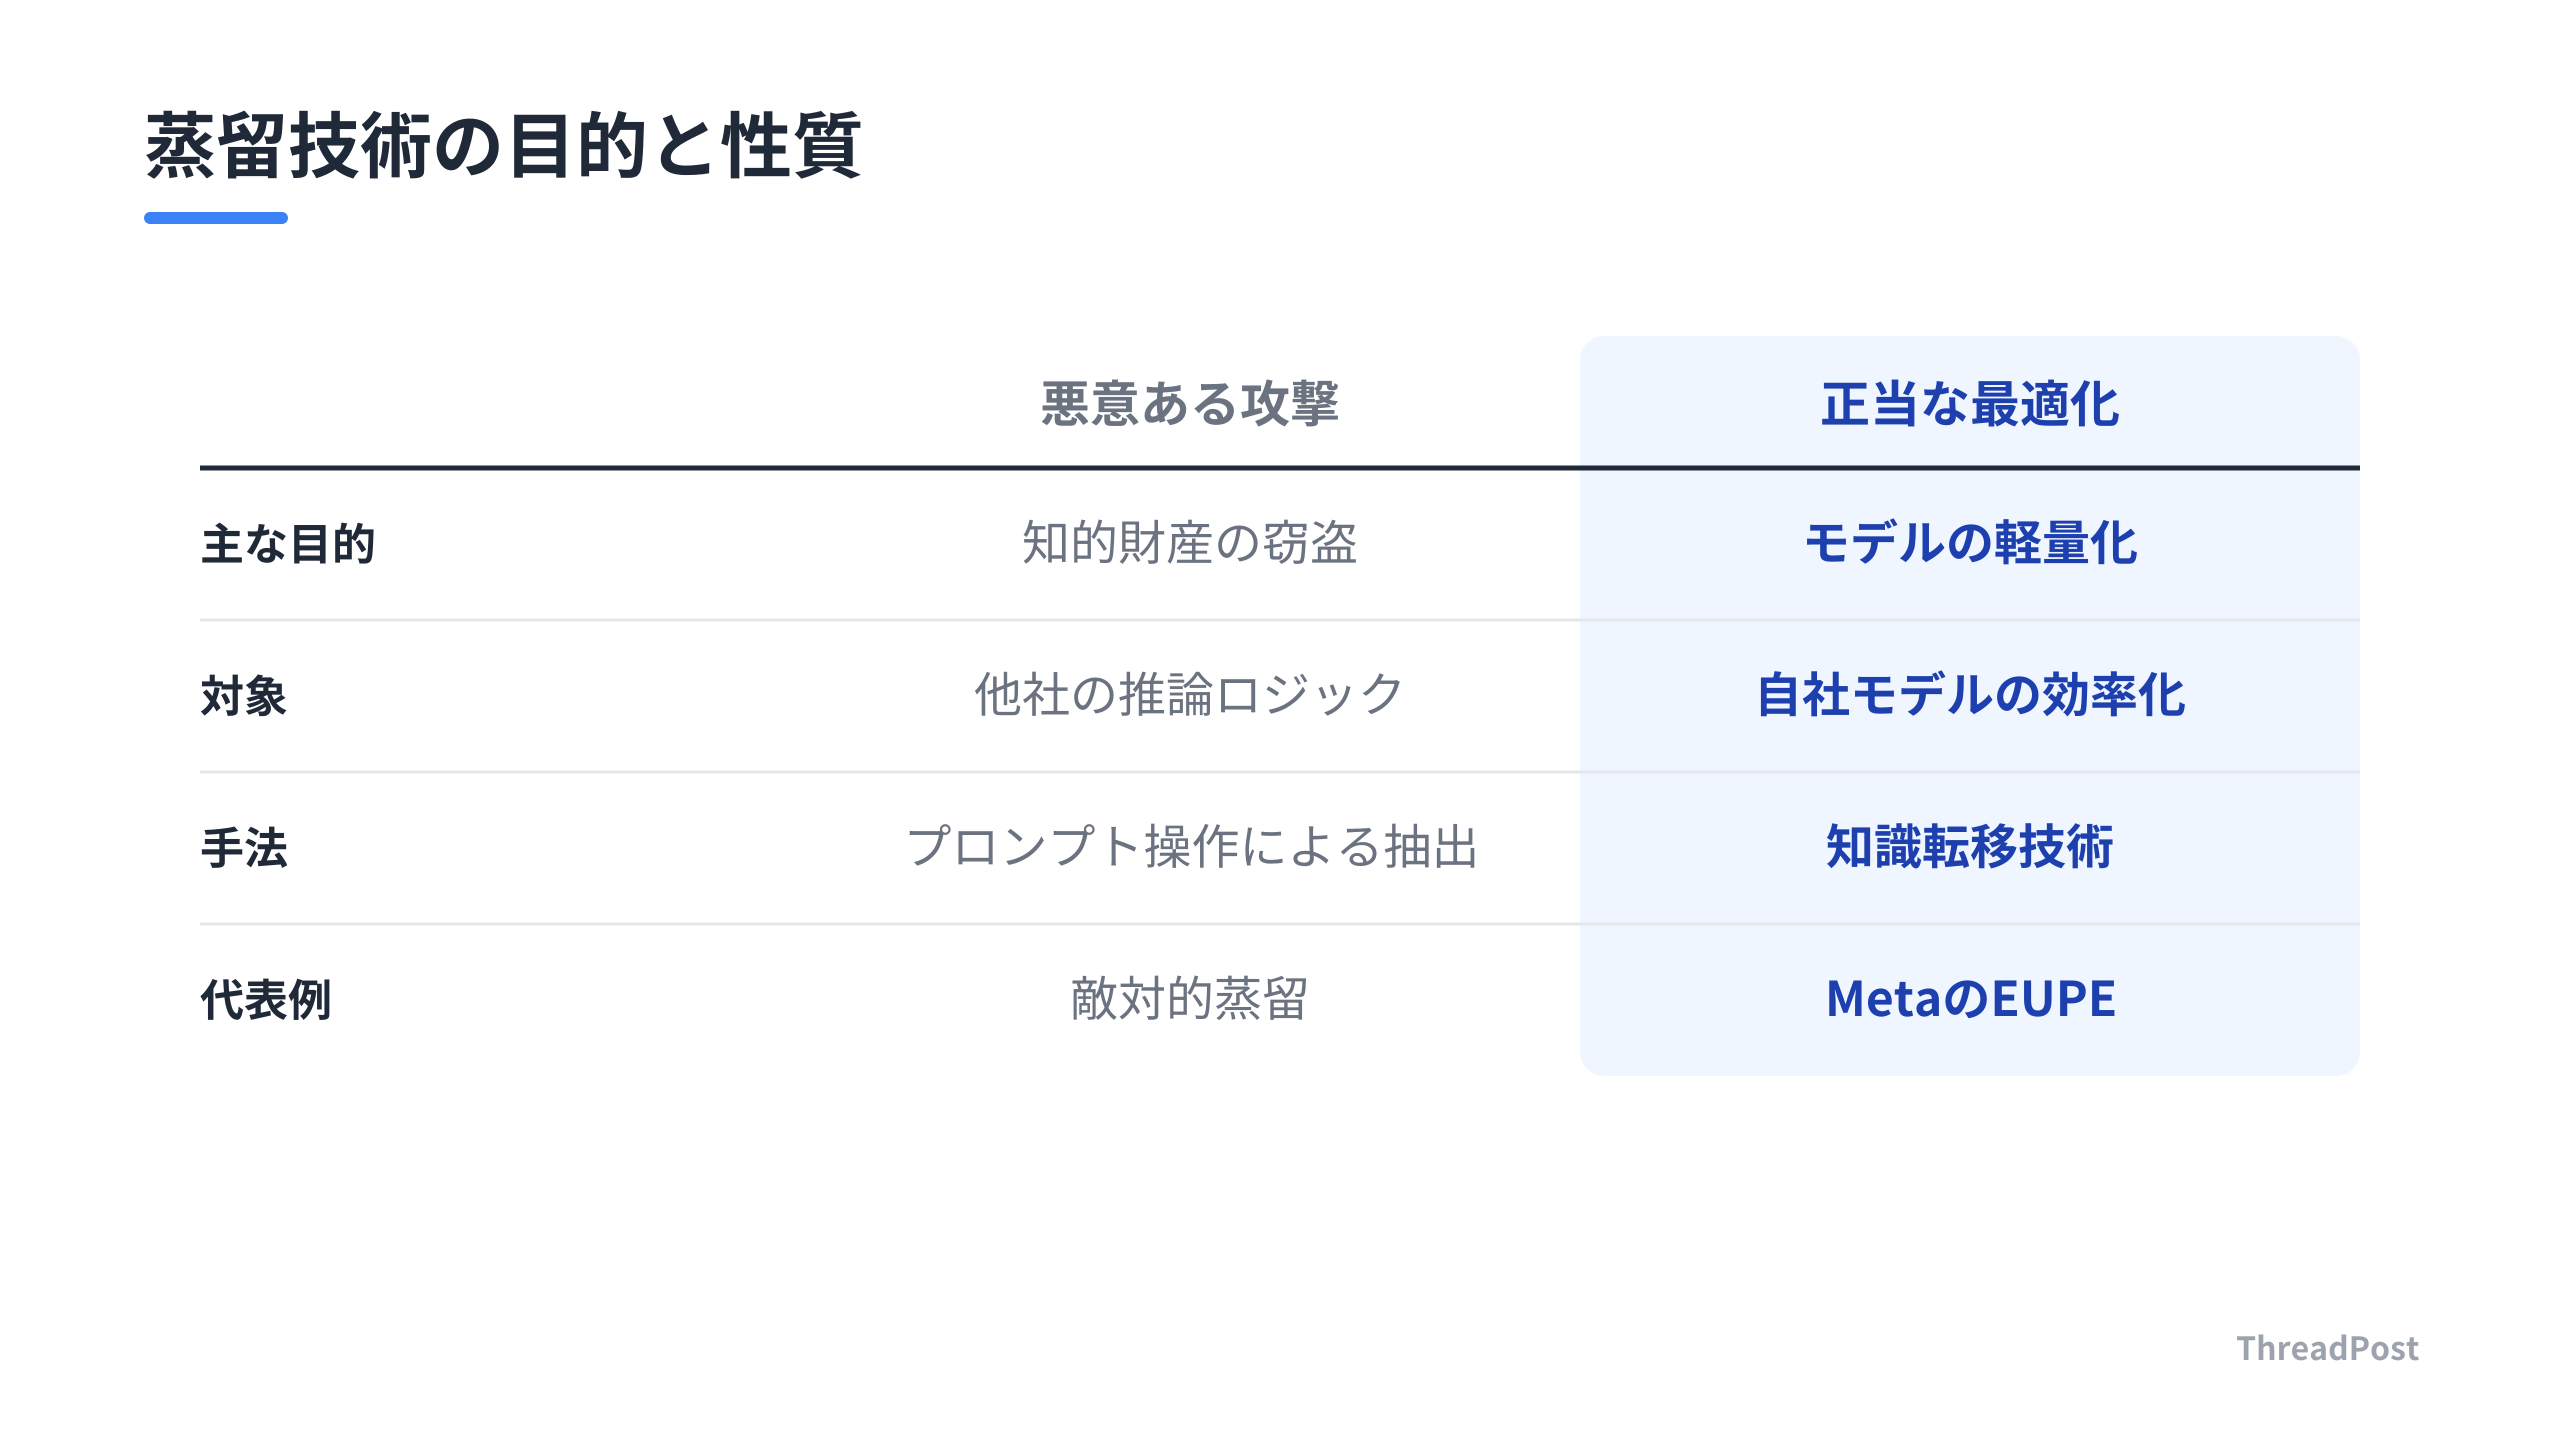
AI業界でモデルの「推論プロセス(Chain-of-Thought)」を盗み出すための組織的な攻撃キャンペーンが問題視されている。7月上旬から観測された動きは、モデルの内部的な思考ログを意図的に引き出し、別のモデルの学習や性能向上に悪用する「敵対的蒸留」という手法だ。
攻撃者はモデルとの対話プロンプトを操作し、通常はユーザーの目に触れない「保護された推論」を回答の一部として出力させる。データベースへの侵入や暗号化の突破といった手法ではない。
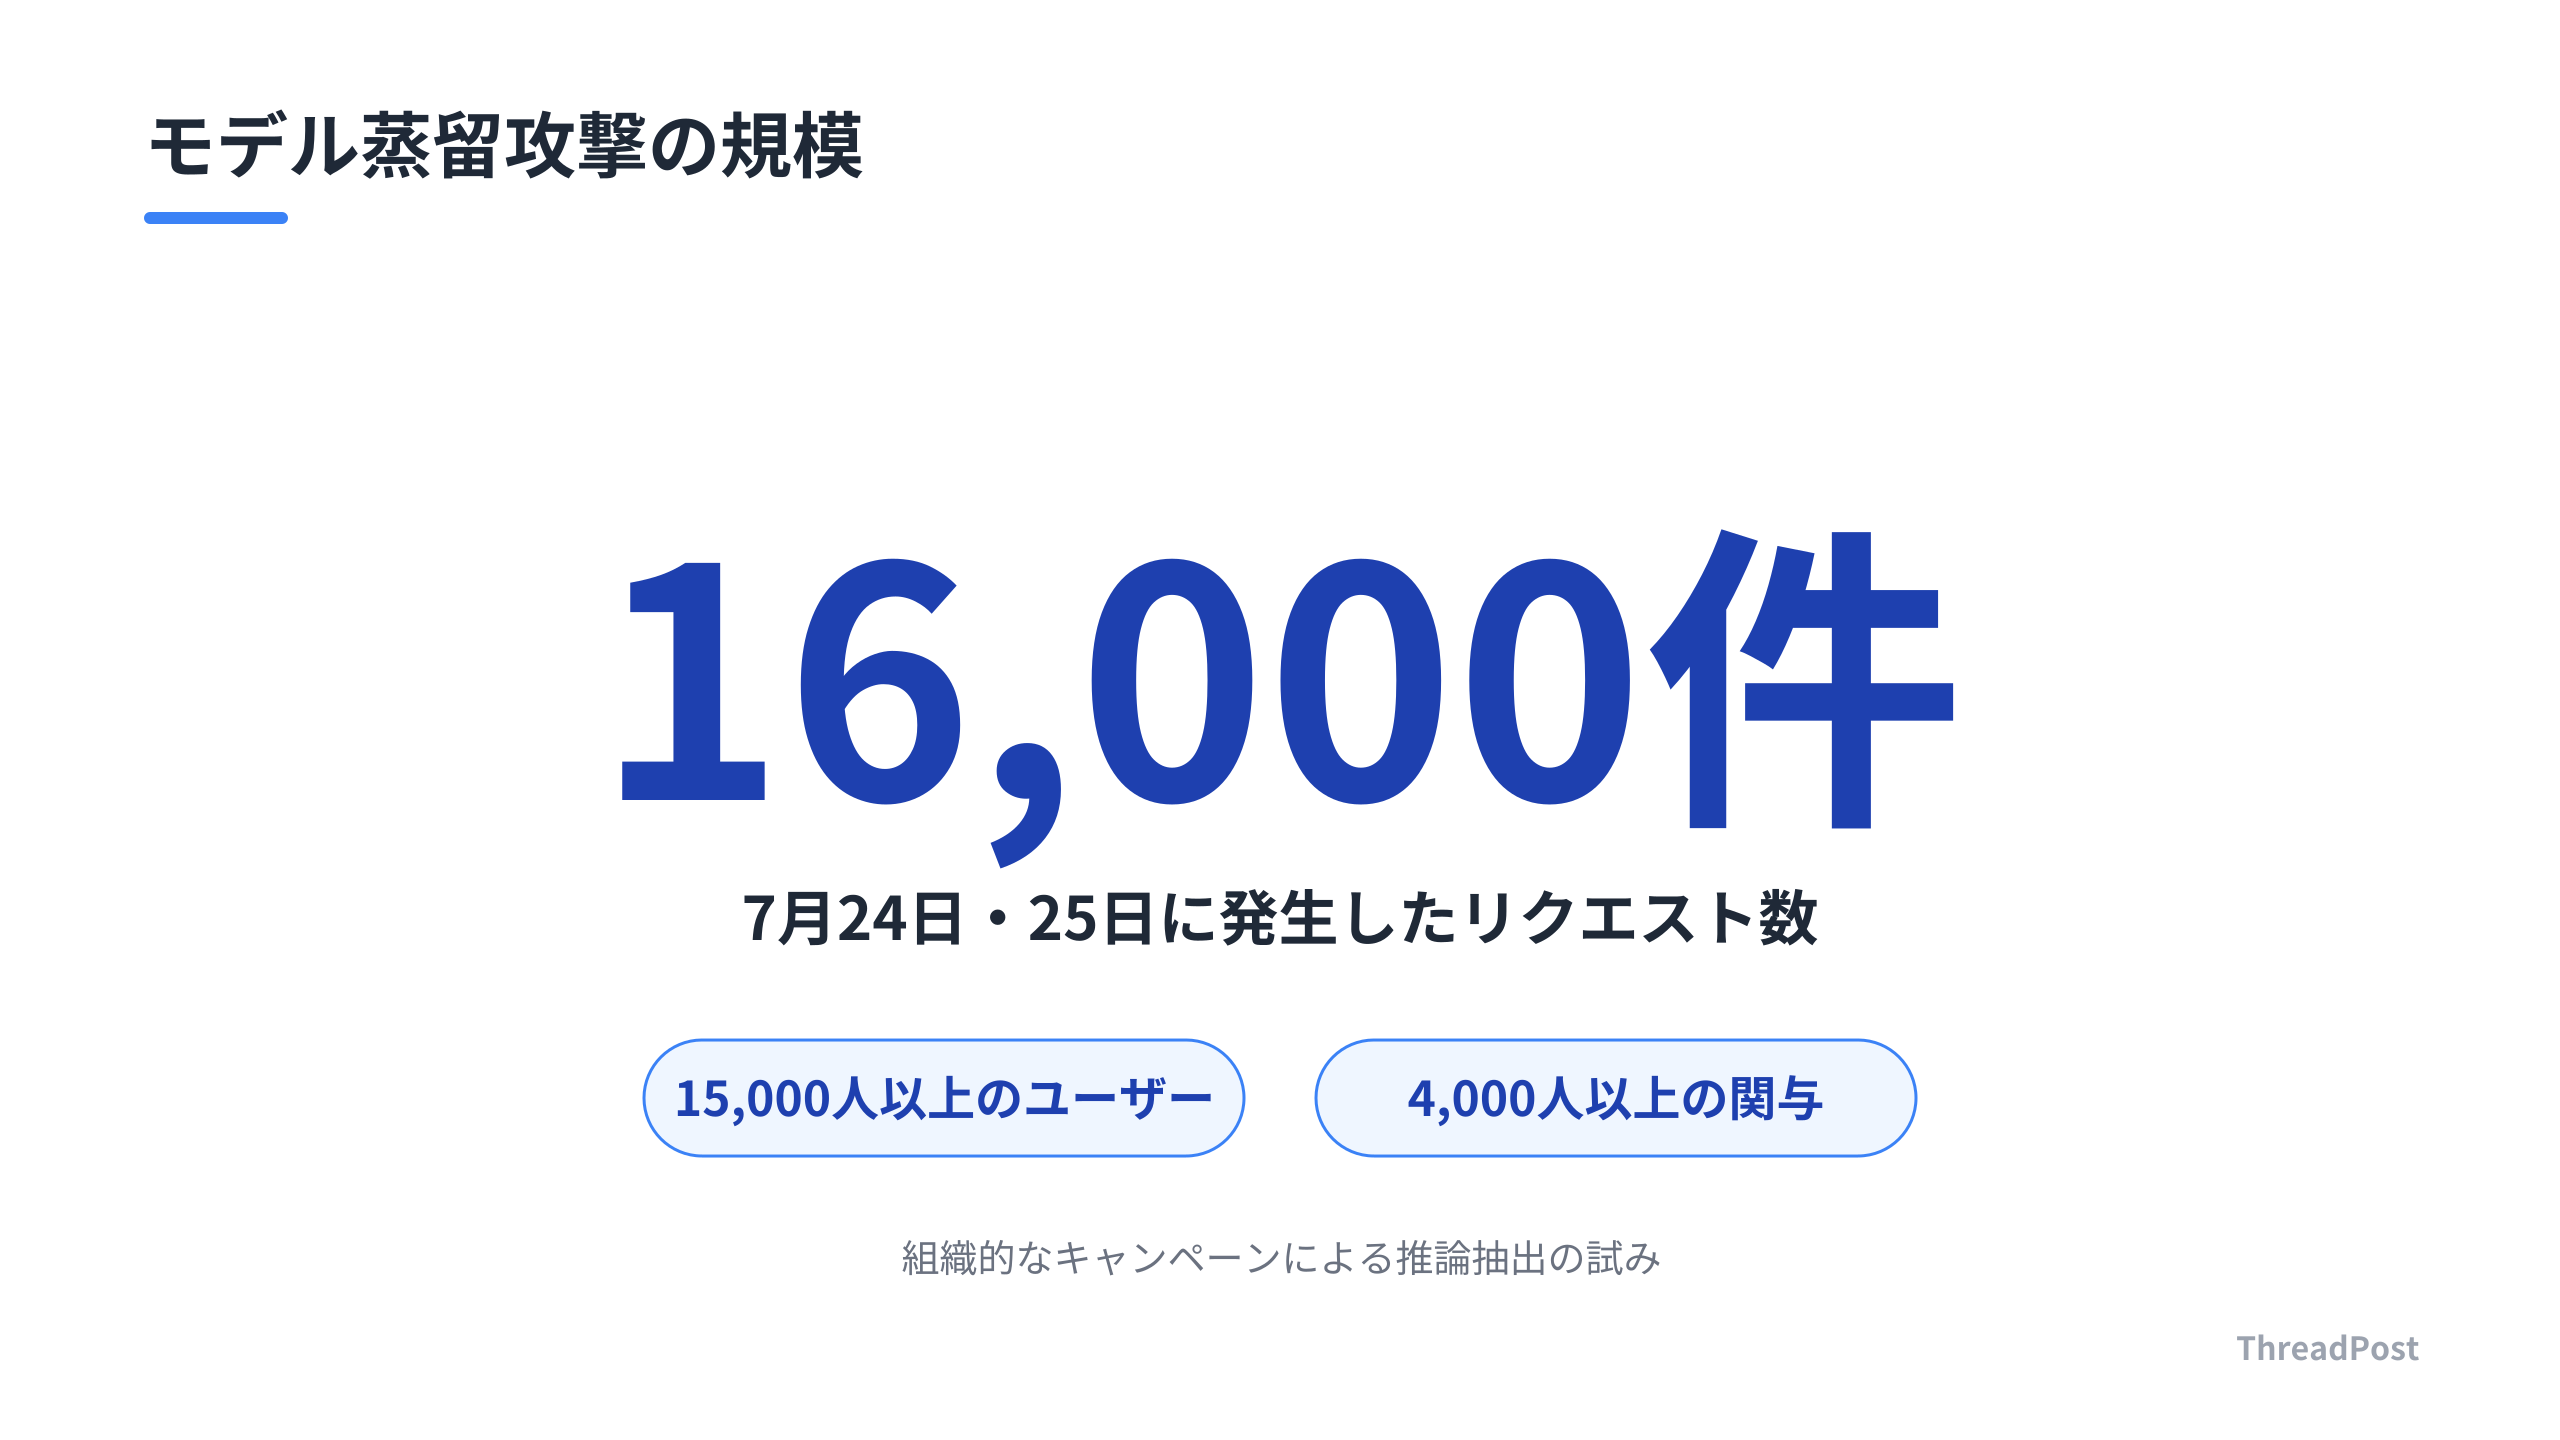
7月24日と25日の2日間だけで、16,000件以上の抽出リクエストが集中した。調査の結果、関与したユーザー数は4,000人を超え、関連するプロンプトパターンは15,000人以上のユーザー層に広がっていた。
しんたろー:
データベースをハックするのではなく、モデルに問い詰めて思考を吐き出させる発想が気になる。モデルの「思考の癖」をハックしに来ていると感じる。
この攻撃は特定のモデルに限定された脆弱性ではない。複数のモデルを跨いだ対話や、会話の圧縮処理を悪用する手法も確認されている。モデルの推論能力を向上させるための強化学習(RL)パイプラインが、攻撃者にとって「モデルの思考回路を学習するための教材」として機能している。
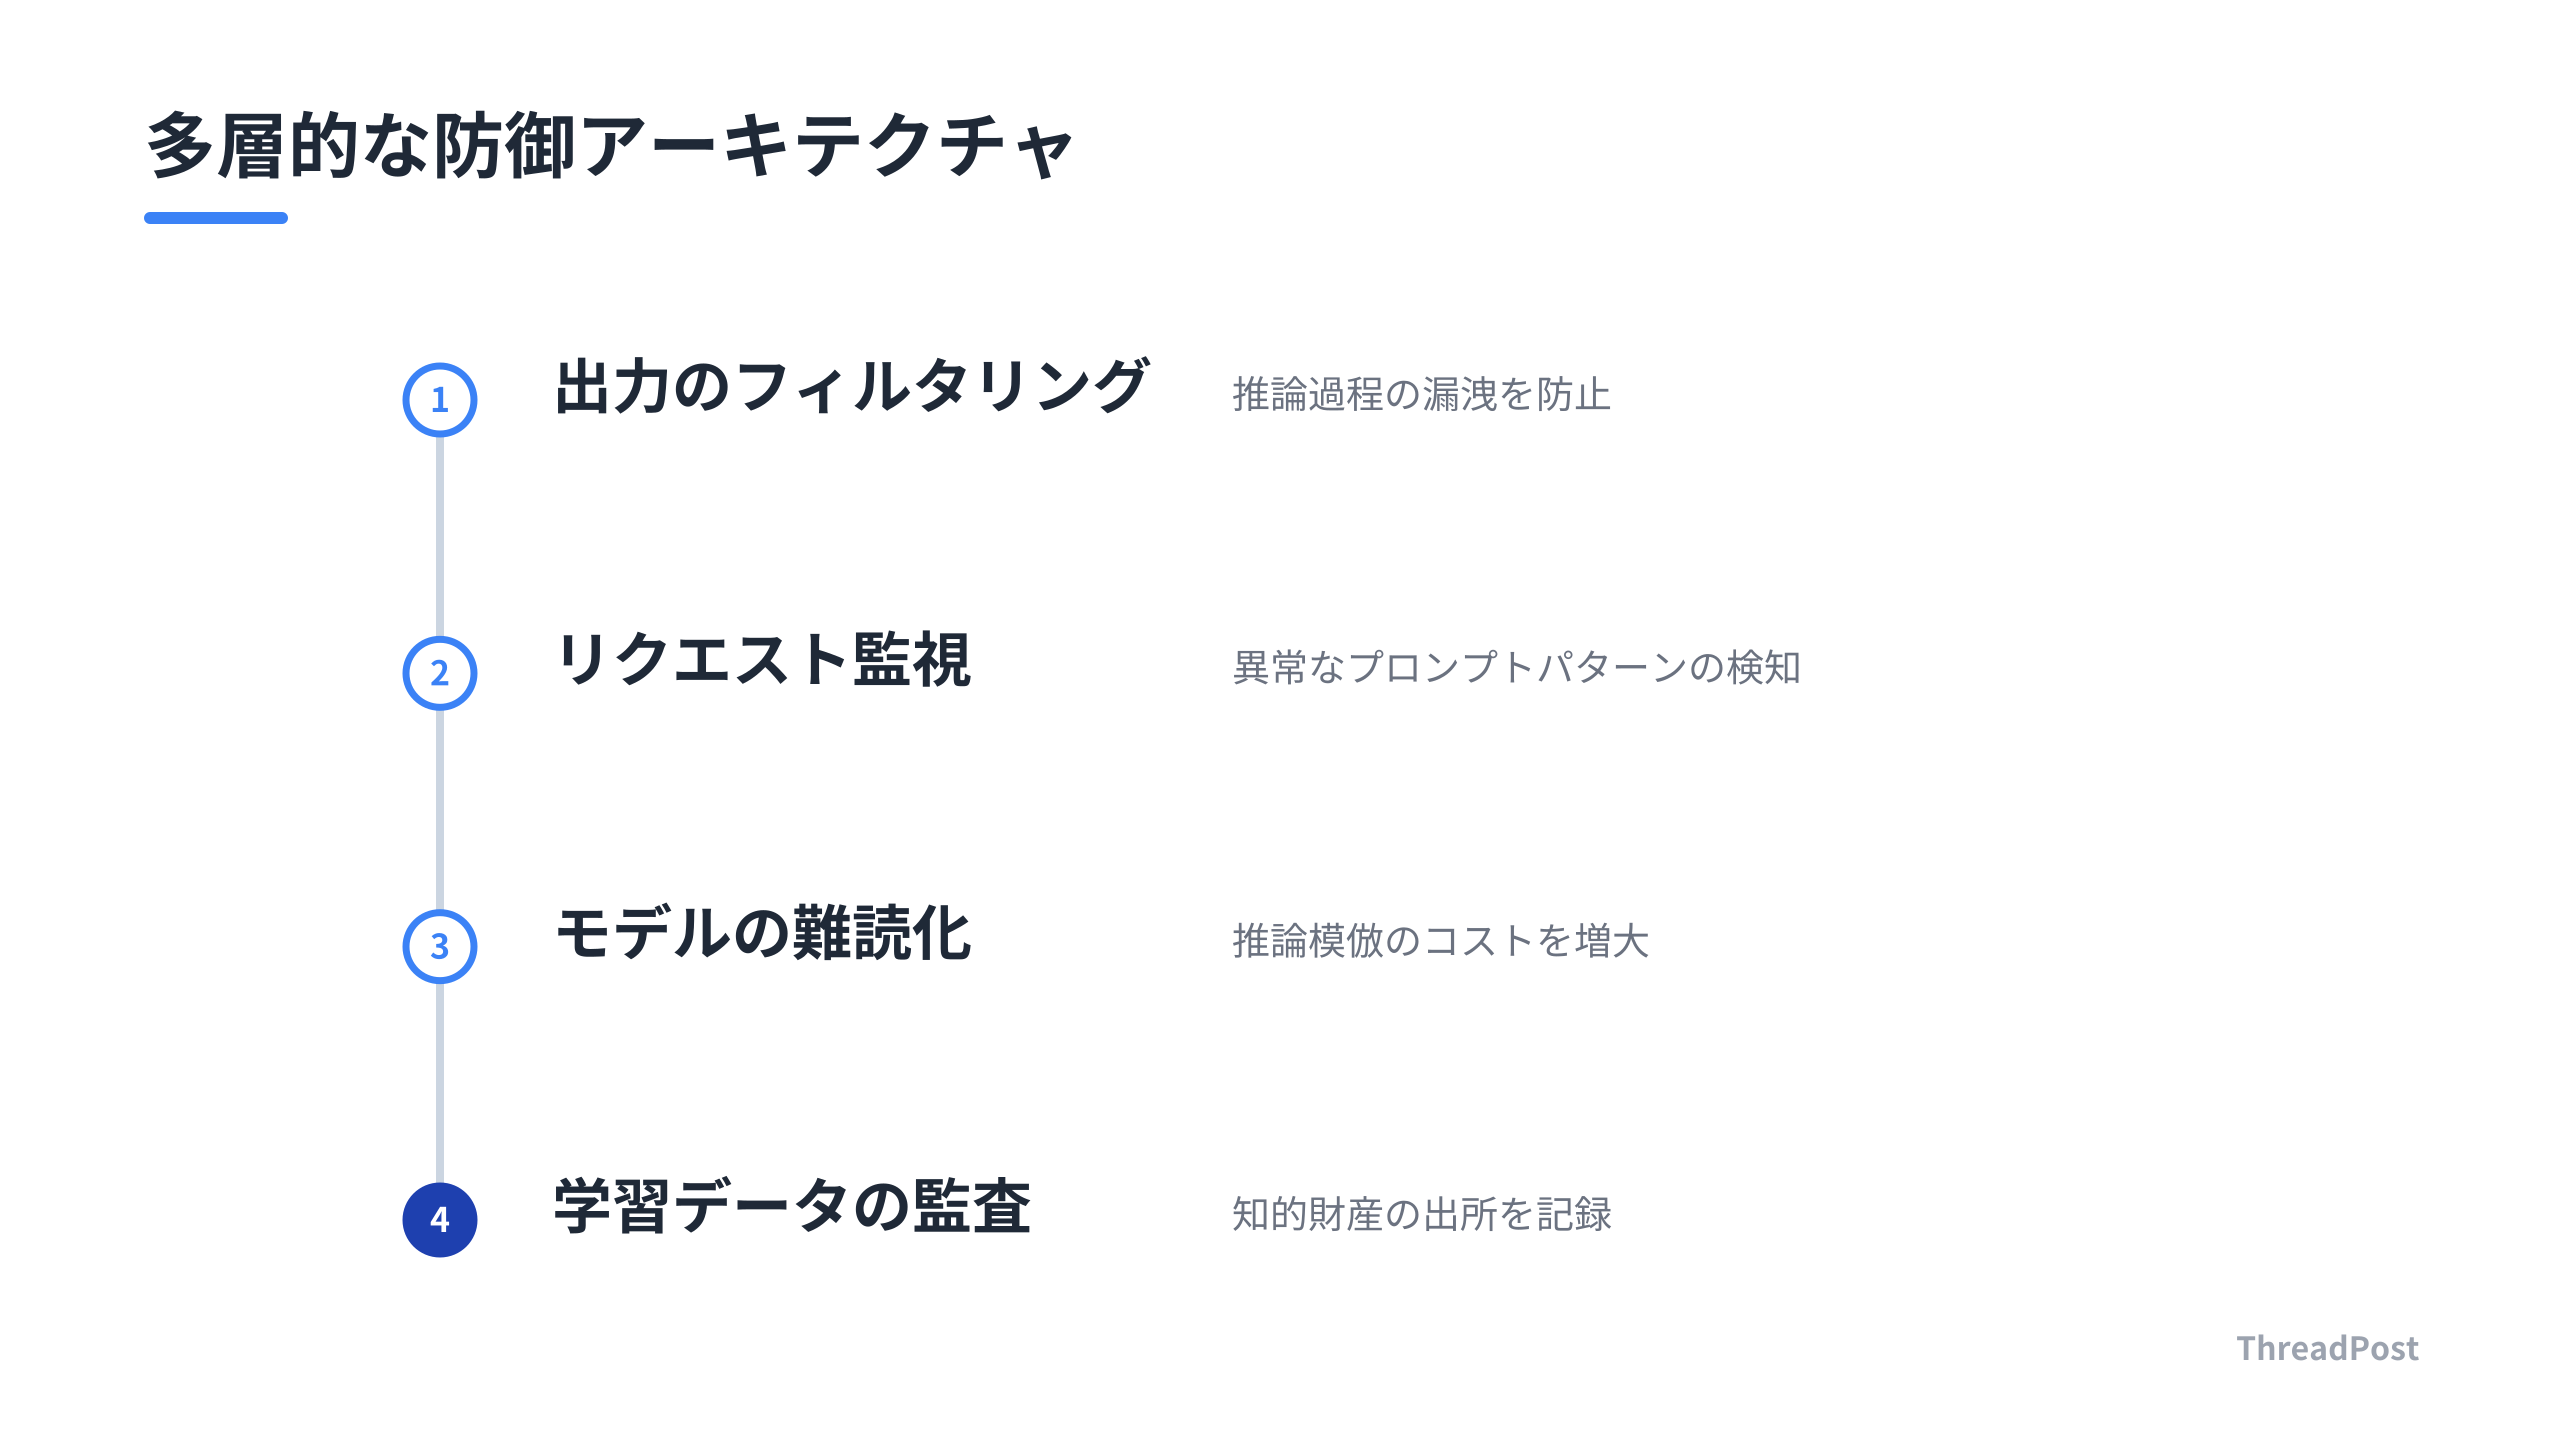
推論プロセスを詳細に出力するように調整するほど、攻撃者にとっては解析が容易になる。現在は推論過程の隠蔽や、出力時のフィルタリングといったガードレールの実装が求められる。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
推論を盗まれるリスクと開発者が背負うべき防衛責任
LLMの推論プロセス抽出は、本格的なセキュリティの主戦場へと変わった。モデルが内部でどう考えて回答に至ったかという思考の痕跡そのものが、高精度な蒸留攻撃のターゲットになっている。
推論能力を向上させるための強化学習(RL)パイプラインが、モデルの思考回路を再現するための教材になっている。推論を賢くすればするほど、出力される思考プロセスが詳細になり、モデルの内部ロジックを解析するヒントが増える。
ツール連携を行うLLMアプリ開発において、この脅威は切実だ。自作のエージェントが外部ツールを呼び出す際、推論ログがセキュアでない状態でコンテキストに保持されていれば、攻撃者はそれを抽出してモデルの挙動を模倣できる。1万6,000件ものリクエストが短期間に集中した事例は、攻撃が組織的かつ自動化されたキャンペーンであることを示す。
Claude Codeでコードを書いていると、推論ログがターミナルに残ることもある。便利なツールを繋ぐほど、モデルの思考過程が外部に漏れ出す穴が増えていると感じる。ログの管理と出力フィルタリングを見直す必要がある。
推論プロセスの抽出を防ぐためには、モデルの出力に対して「機密性の高い推論過程が含まれていないか」を判定するガードレール層の実装が必要だ。推論の質を追求するあまりセキュリティを後回しにする開発スタンスは、リスクを伴う。
推論ログの保存場所やアクセス権限の制御は、DBの設計と同じレベルで重要だ。推論過程をコンテキストから動的に削除する処理や、暗号化を前提としたログ管理など、実装すべき技術的要件は増えている。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
開発者が明日から実装すべき「推論保護」の防衛ライン
推論をユーザーの目に触れさせない分離が対策となる。LLMが内部で行った思考プロセスを、最終的な回答と一緒にフロントエンドへ流す実装は見直す必要がある。
推論過程を「隠しフィールド」として扱うか、バックエンドのログにのみ保持する設計が有効だ。ユーザーには「思考の結論」だけを返し、詳細な「考え方の筋道」はセッションデータから隔離する。これでモデルの推論ロジックを丸裸にするプロンプト攻撃の成功率は下がる。
Claude Codeで開発していると、デバッグのために思考プロセスを出したくなる。しかし、これをそのまま公開APIに乗せるとモデルの設計図を配るのと同じだ。APIのレスポンス設計を見直す必要がある。
ツール利用の権限管理も「最小権限の原則」を厳格化する。LLMがデータベースや外部APIを叩く際、コンテキストに「思考のログ」が混入しないよう、システムプロンプトによるガードレールを実装する。ツール実行時のプロンプトに、前回の推論ログが引き継がれていないか、セッション管理の粒度をチェックする。
強化学習パイプラインを組んでいる場合、報酬関数に「セキュリティ」を組み込む。推論の正解率だけでなく、「機密情報や内部ロジックを回答に含めないこと」を報酬として定義する。モデルは賢くなるほど、自分の思考プロセスを守る方向へ最適化される。
今すぐできるアクションとして、以下の3点は防衛ラインとなる。
- 推論ログのフィルタリング: 回答生成前に、推論過程が混入していないかを確認するバリデーション層を設ける。
- セッションの隔離: ユーザーとの対話履歴から推論ログを削除、または暗号化した状態で保存する。
- ツール権限の最小化: LLMがアクセスできる範囲を、思考プロセスと物理的に分離した環境に制限する。
 あわせて読みたい【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録 →
よくある質問
モデルの「保護された推論」とは具体的に何ですか?
モデルが最終的な回答を導き出すために内部で行う、試行錯誤や論理構成の組み立てプロセスを指します。通常、ユーザーには結果のみが表示されますが、攻撃者はプロンプト操作で、この内部的な思考ログを回答の一部として出力させようとします。漏洩すると、モデルの学習データや独自の推論ロジックを模倣されるリスクがあります。
開発者が自分のLLMアプリで推論抽出を防ぐにはどうすればいいですか?
モデルの出力に対して「推論過程が含まれていないか」を監視するバリデーション層を設けることが有効です。ツール利用時のインジェクション対策として、LLMに渡すプロンプトの権限を最小化し、思考プロセスと外部ツールへのアクセス経路を物理的に切り離す設計を徹底してください。推論ログをデータベースに保存する場合は、暗号化と厳格なアクセス制御を適用します。
強化学習で推論を強化すると、セキュリティリスクは高まりますか?
リスクは高まる傾向にあります。推論能力を向上させるために思考プロセスを詳細に学習させると、モデルは結果的にそのプロセスを饒舌に出力するようになります。これが攻撃者にとって「モデルの思考の癖」を解析するためのヒントになります。強化学習パイプラインを構築する際は、報酬関数に「推論の正確性」だけでなく「出力の安全性(機密情報の非開示)」を組み込み、バランスを取ることが不可欠です。
まとめ
モデルの推論プロセスを守ることは、自社プロダクトの知財を守るための要件だ。攻撃者はプロンプトの隙を突き、モデルの思考の癖や内部ロジックを抽出しようと狙っている。
Claude Codeでコードを生成する際、エージェントが吐き出すログや思考過程は、放置すれば機密情報の塊になりかねない。モデルが賢くなるほど、その知性を盗み取ろうとする手口も巧妙化する。
推論を盗まれないための「防御的プロンプトエンジニアリング」を構築する。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
