


AzureのModel Routerは、プロンプトに応じて最適なモデルを自動で選ぶ。この仕組みは実用期に入った。
AI任せの運用には落とし穴がある。文書の配置で精度が変わる「Lost in the Middle」や、画像PDFの解像度によるVRAMパンクといった物理的な制約だ。
モデルの選択が自動化される今、開発者に求められるのはカタログスペックの比較ではない。システム内部の挙動を把握し、制御するエンジニアリングだ。
実環境の検証データをもとに、モデル自動選択のリアルと実務上の注意点を解説する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
自動ルーティングの実像とモデルが抱える物理的制約
Model Router機能は、主要クラウドプラットフォームで実用段階にある。アプリ側は1つのデプロイ名を呼び出し、プロンプトの難易度に応じたモデルへ自動で振り分けられる。
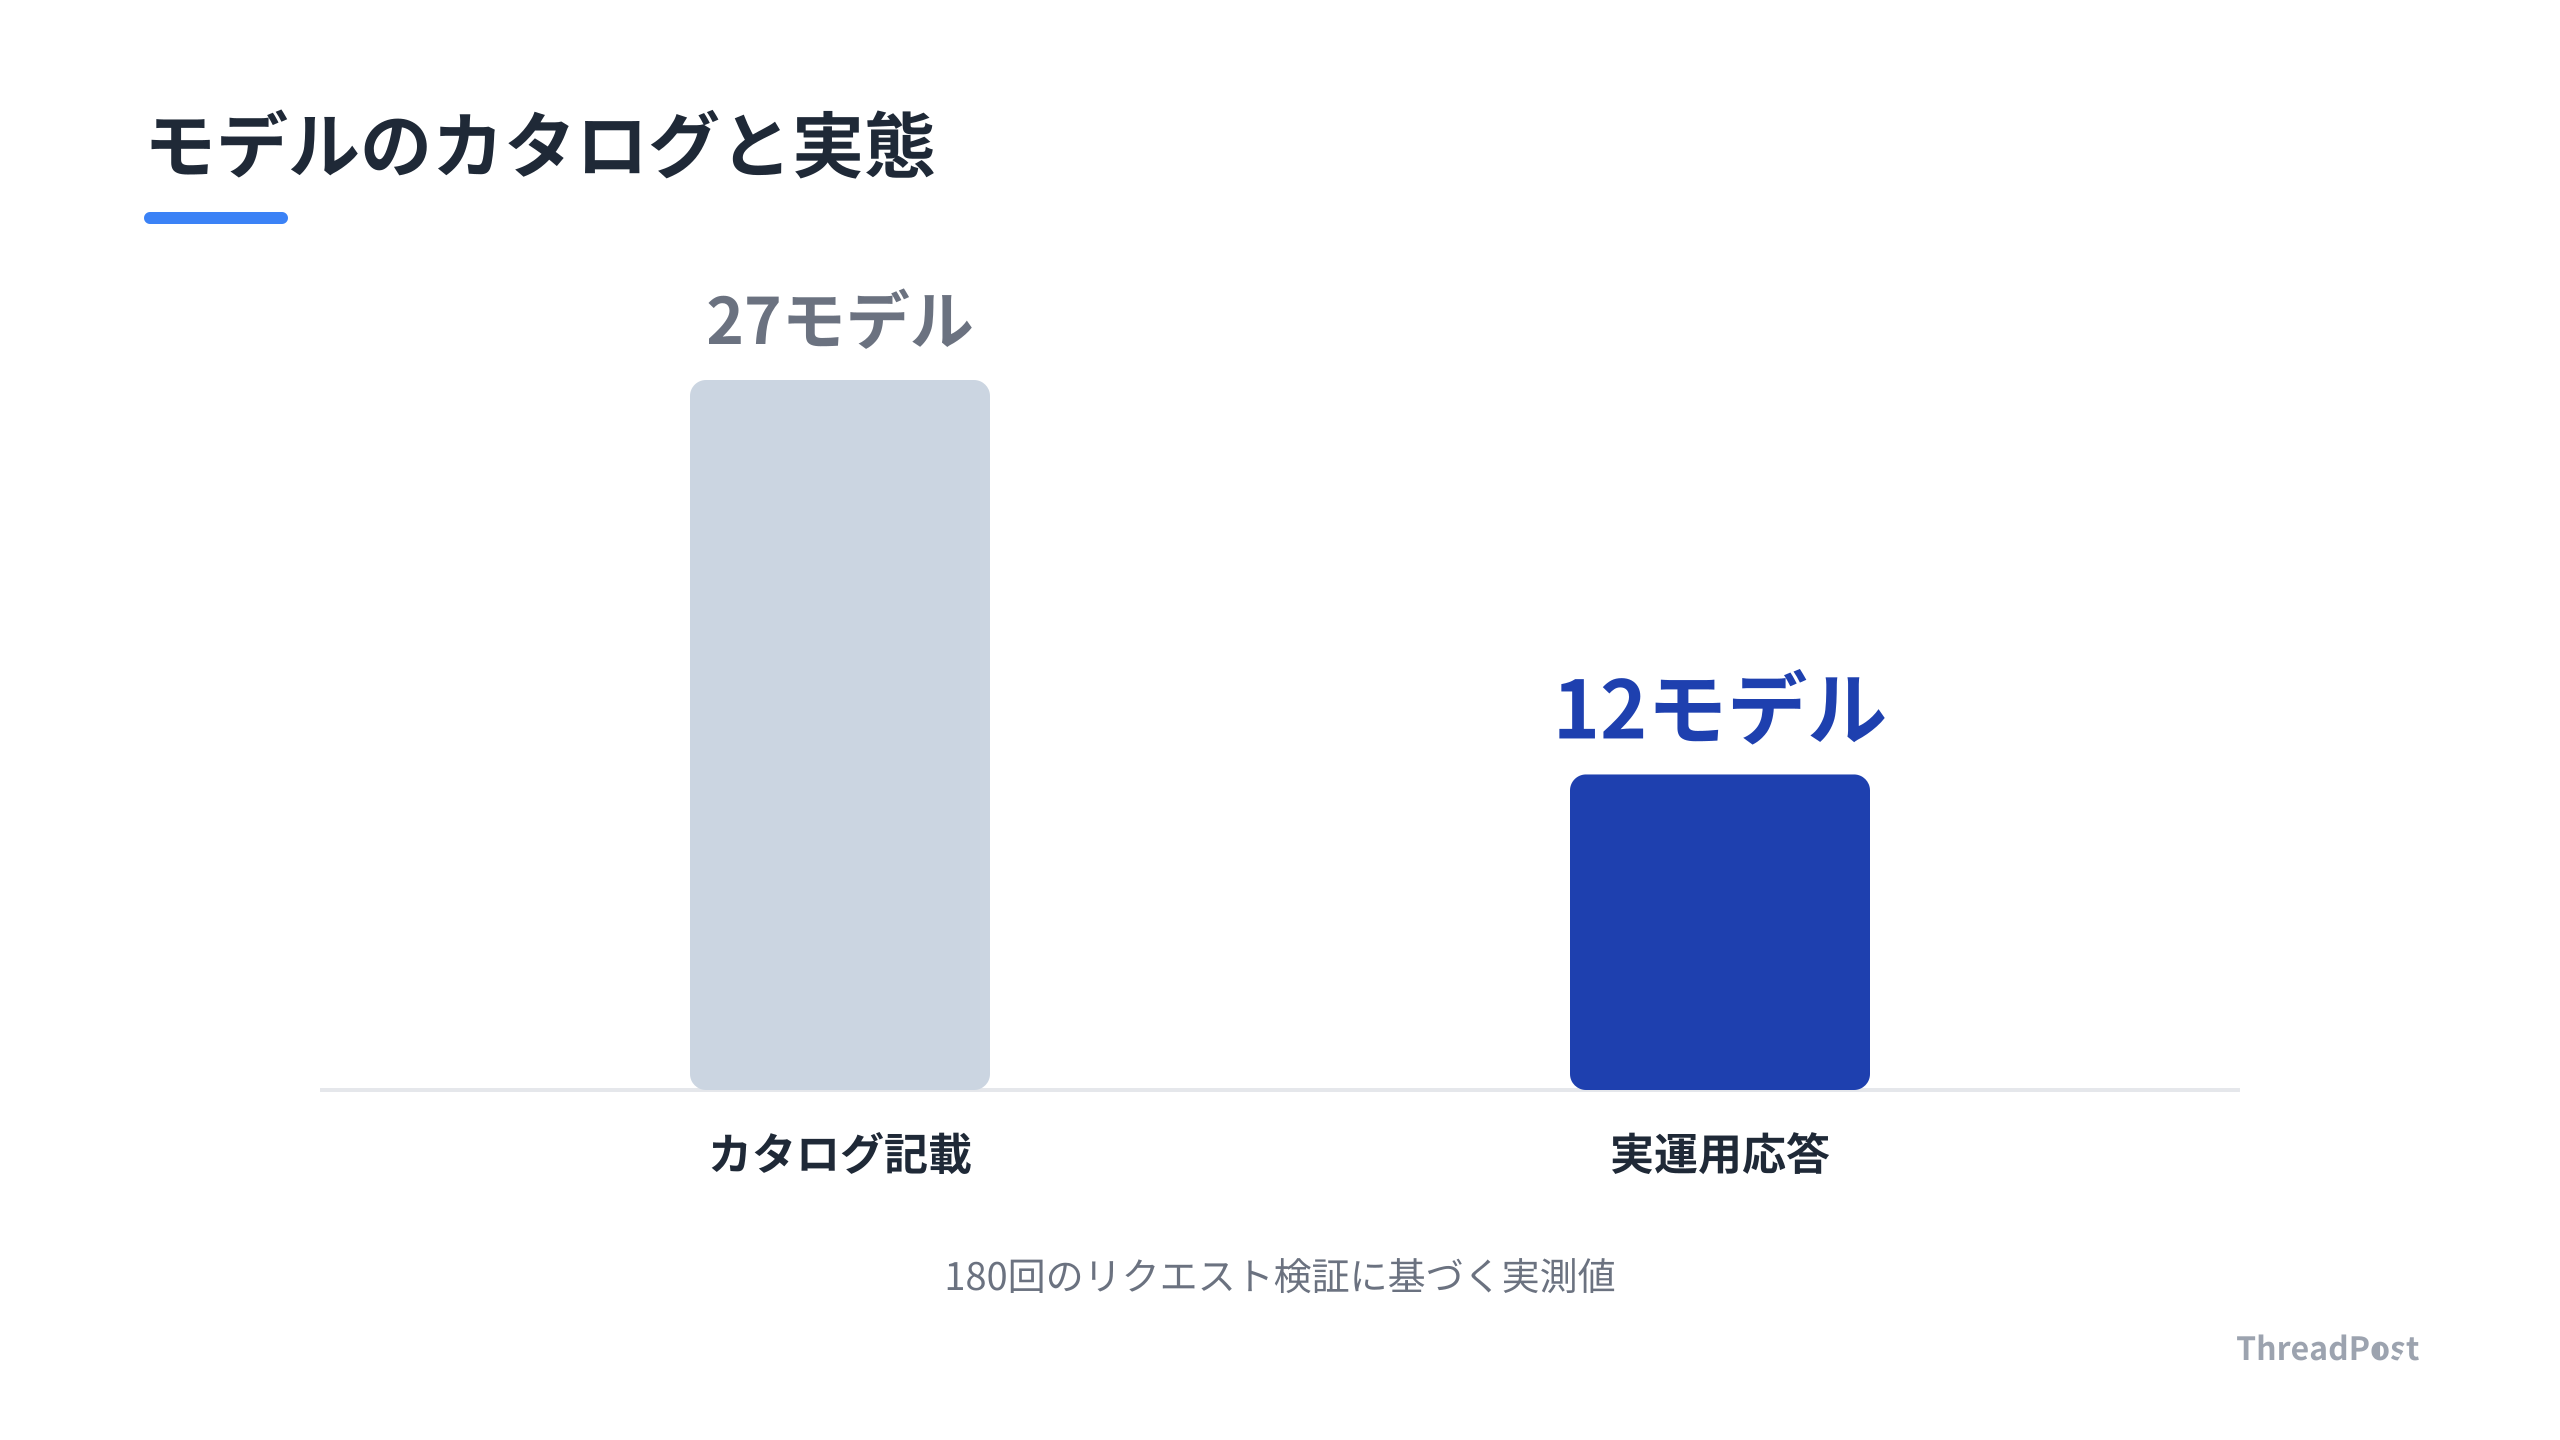
カタログ上には27モデルが提示されているが、180回のリクエスト検証では、実際に応答したモデルは12種類だった。ルーティングはBalanced、Quality、Costの3つのモードで制御される。
設定変更から実際のルーティング反映まで、最大5分のタイムラグが発生する。この仕様は開発時の動作確認で影響する。
しんたろー:
1つのAPIを叩くだけで裏のモデルが切り替わるのは魅力的だ。設定変更から5分間は古い挙動のまま動く仕様が気になる。開発中の動作確認で沼にハマりそうだ。
プロンプトの構造やメモリ消費といった物理的な制約はツール側では解決されない。10件のドキュメントを用いたRAG処理では、正解の配置場所によって精度が変化する。
正解がコンテキストの中央にあると精度が落ちるモデルがある一方、末尾に近づくほど精度が上がるモデルも存在する。選択されたモデルごとに最適な配置は異なる。
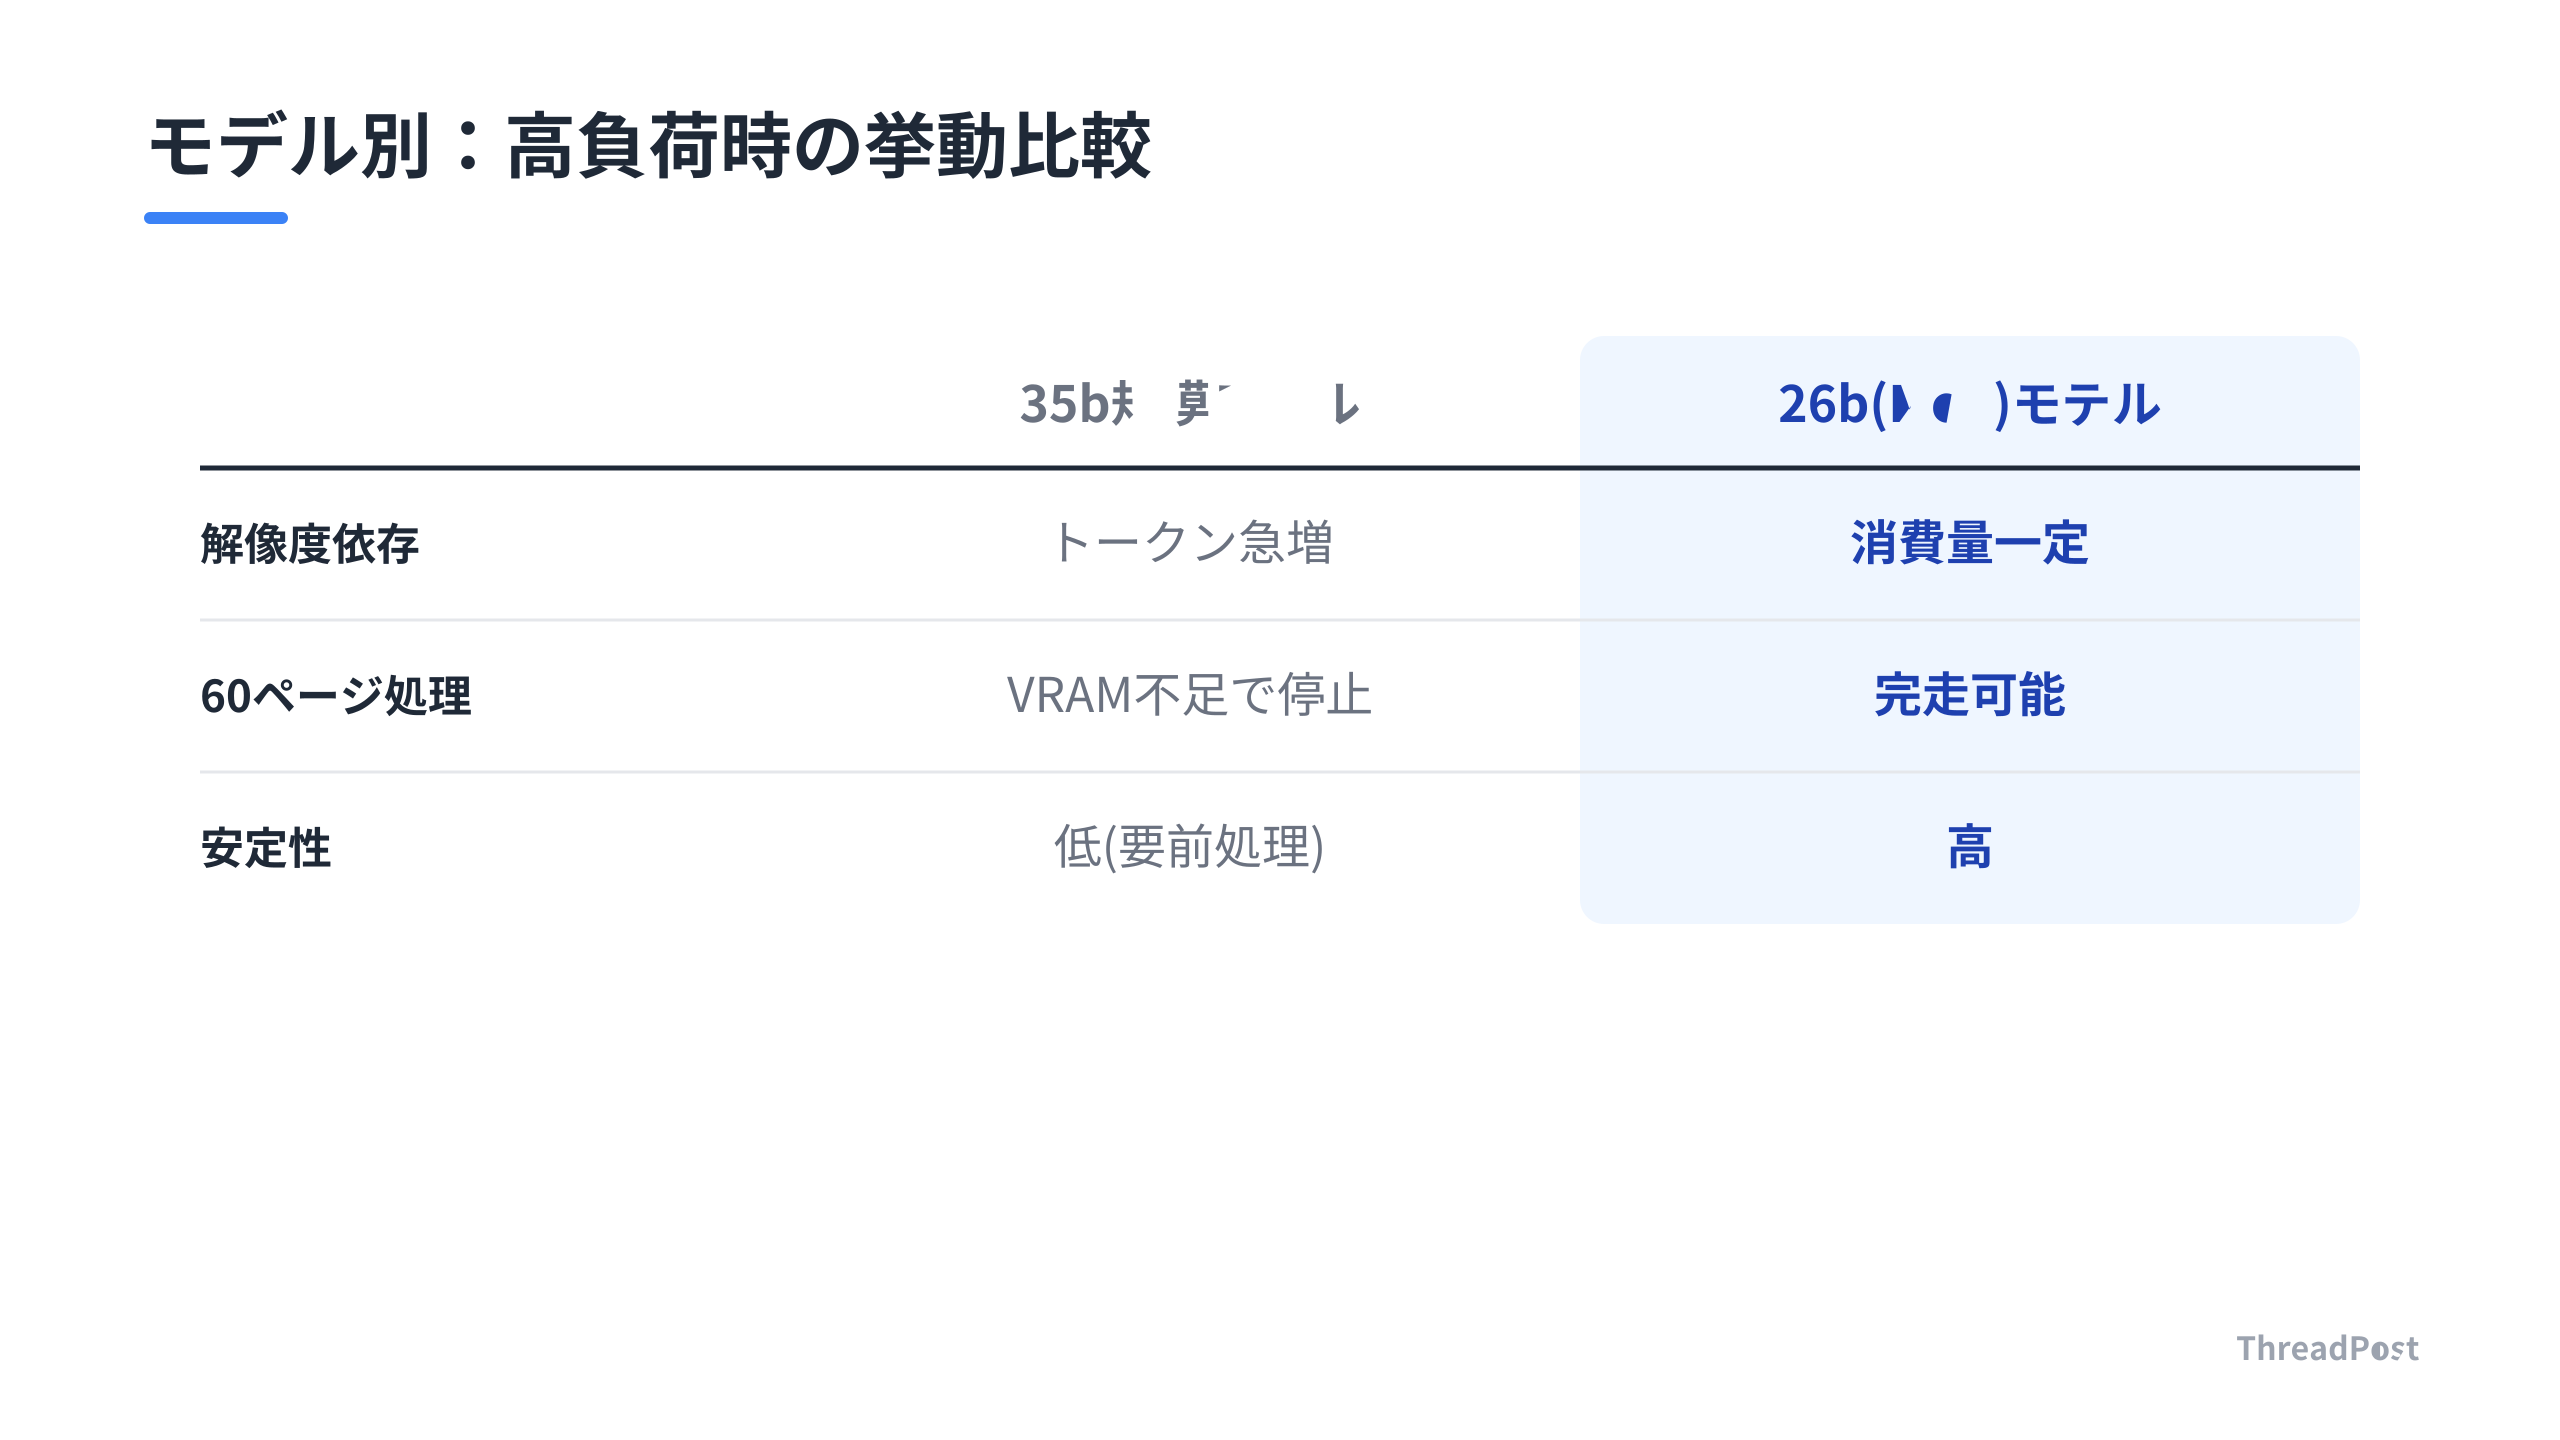
画像ベースのPDF処理では、入力データの解像度がインフラリソースを直撃する。35b規模のモデルでは、画像のdpi設定に比例してトークン数が跳ね上がり、60ページ(約4.5MB)のデータで24GBのVRAM上限に達しエラーが発生した。
一方で26bのMoE構成モデルは、入力解像度に関わらずトークン消費が一定に制御され、77ページのドキュメントでもVRAMを枯渇させずに処理を完走した。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
抽象化の裏で発生する「入力最適化」の泥臭さ
モデルを自動で選別するルーティング機能は、開発者の負担を軽減する。しかし、システムを隠蔽する抽象化の裏には罠がある。
カタログ上に27種類の対応モデルが記載されていても、標準運用でレスポンスを返すのは12種類程度だ。ルーティング設定を変更しても、反映まで最大5分間のタイムラグがある。この遅延を知らずにテストを行うと、古いルーティング設定のまま評価されるリスクがある。
ルーターでモデルが自動で切り替わるのは便利だが、裏でどのモデルが選ばれたかでプロンプトの効き目が変わるとデバッグが難しい。レスポンスのヘッダーを毎回チェックする羽目になる。
コンテキスト内に複数の文書を流し込んだ際、正解データが中央付近に位置すると認識率が下がる「Lost in the Middle」という現象がある。この現象への耐性はモデルによって異なる。
ルーティング機能によって呼び出されるモデルが頻繁に変わると、プロンプト内のドキュメント配置を最適化する難易度が上がる。どのモデルが選択されても精度を保つため、重要情報をコンテキストの先頭と末尾の両方に重複配置する工夫が必要だ。
マルチモーダル解析では、入力画像のdpi設定が処理負荷に直結する。あるモデルではdpiを上げても処理負荷が0.06秒で一定だが、別のモデルではdpi=72からdpi=150に変えただけで処理時間が1秒超へと膨れ上がる。
60ページ(約4.5MB)を超えると、24GBのVRAM上限に達してエラーを返すモデルがある。一方で26b規模の軽量モデルであれば、77ページのドキュメントでもVRAMを枯渇させずに完走できる。
Claude Codeのような自律型エージェント開発においても、入力設計の重要性は変わらない。エージェントが参照するモデルのルーティング候補を絞り込む制御や、入力前の解像度削減が不可欠だ。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
明日からのAIプロダクト開発で適用するアクション
モデルのカタログスペック比較から一歩進み、実装に落とし込むためのアクションを整理する。
1. ルーター導入時のタイムラグ対策とモデル絞り込み
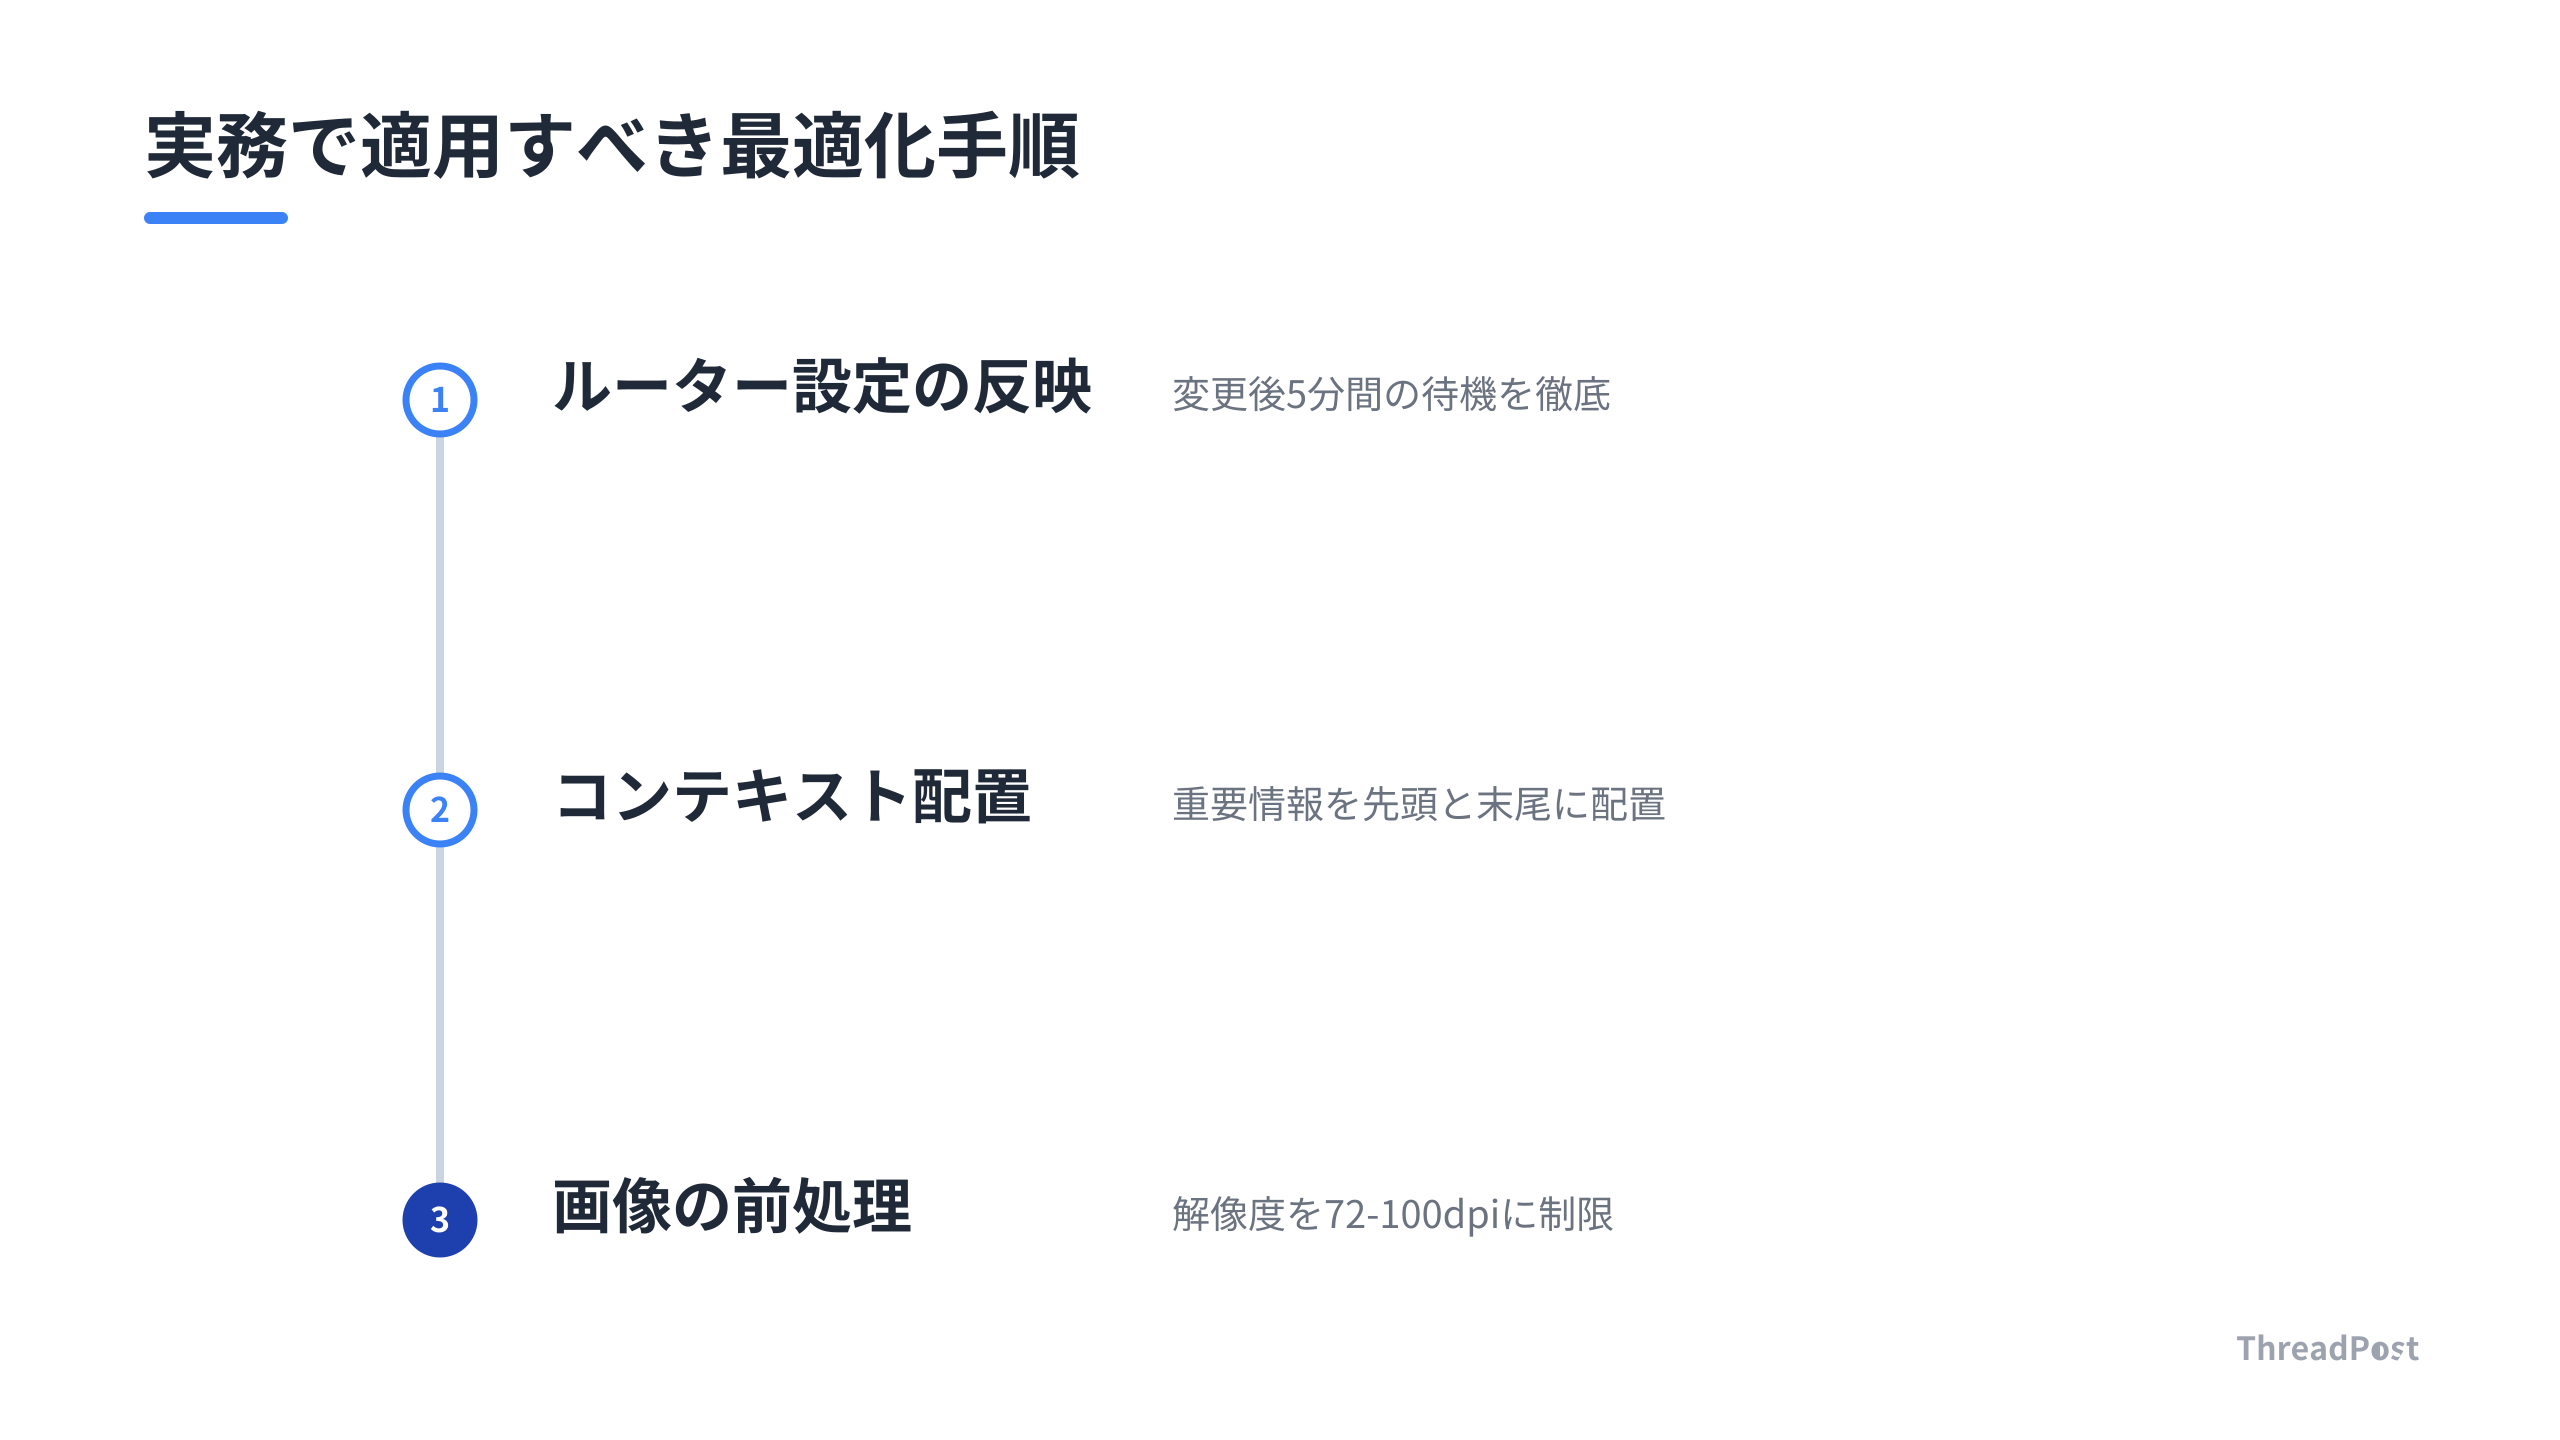
モデルルーターの設定変更から反映までには最大5分かかる。CI/CDや評価パイプラインを組むときは、設定変更後に5分間のディレイを入れるか、構成が固定されたFrozen版のデプロイを選択する。
予期せぬ低スペックモデルへの脱線を防ぐため、ルーティング対象をあらかじめ3〜4個のモデルに限定する「サブセット指定」を有効にする。
プロンプト調整直後に挙動が変わらないと思ったら反映ラグだったことがある。5分待つのは焦るが、テストの無駄打ちでAPI代を溶かすよりはマシだ。
2. RAG構築におけるコンテキスト配置の定型化
長文ドキュメントやRAGの検索結果を渡すときは、重要情報を「先頭か末尾」に配置する。正解データが中央に埋もれると、Lost in the Middle現象によって回答精度が落ちる。
検索で取得した複数のテキストを結合する際、類似度スコアが最も高い情報を配列の最初と最後に分配するロジックを挟む。これで精度向上が狙える。
3. マルチモーダル入力における前処理のルール化
画像PDFや図表入りのドキュメントを処理させる場合、高解像度ファイルをそのまま投げてはいけない。入力画像の解像度は72〜100 dpiに抑え、画質設定も60程度まで落とす。
モデルによっては解像度の高低がトークン数に反映され、60ページを超えたあたりでVRAM(24GB)の上限に達してシステムが停止する。前処理で解像度を統一することが、大量バッチ処理を安定稼働させる条件だ。
4. Claude Codeなどの自律型エージェントへの適用
AIエージェントに自律的なタスクを行わせる場合、エージェントが参照するコンテキストが数万トークンに膨らむと、応答速度と消費コストは数倍に跳ね上がる。エージェントに渡すファイル群の配置を工夫し、画像リソースの解像度を事前に削ることで、推論精度を保ったまま処理を完結させる。
 あわせて読みたい【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録 →
よくある質問
AzureのModel Routerで特定のモデルのみに処理を限定したい場合はどう設定すればいい?
「Route to a subset of models」機能を活用して候補を絞り込む。全モデルに分散させず、特定のモデル群にルーティングを絞り込める。
設定変更の反映には最大5分のタイムラグが発生する。変更直後に動作検証を行うと、古い設定のまま予期せぬモデルにリクエストが飛ぶ可能性があるため注意が必要だ。
RAGのコンテキスト内で正解ドキュメントの配置によって精度が下がるのを防ぐには?
「Lost in the Middle」現象を回避するため、最も重要な情報はプロンプトの先頭か末尾に配置する。コンテキストの中央付近に置かれた情報は、モデルのアテンションが弱まり回答精度が落ちやすい。
感度はモデルごとに異なる。10件程度の検証データで配置による精度落ちが起きないかテストしておくのが確実だ。
画像化された大量のPDFをVisionモデルで処理する場合、最適なモデルの選択肢は?
処理対象が60ページを超えるような多ページのPDFなら、Gemma 4系のモデル(gemma4:26bなど)を選択する。入力ページ数が増加してもVRAMの消費量が跳ね上がらず、安定して完走できる。
高解像度な画像処理でトークン数が膨れ上がり、24GBのVRAM上限を超えてエラーで停止する場合がある。事前に画像の解像度を72〜100 dpiまで落とす前処理を挟むのが処理を破綻させないコツだ。
まとめ
モデルの自動選択やコンテキスト配置が進むほど、単なるスペック比較ではなく「入力をどう設計するか」という制御が重要になる。抽象化されたブラックボックスを自分の手で最適化していく作業が、今のAI開発で重要だ。
ThreadPostでも、こうしたAIの挙動を制御する技術を日々検証している。AIの「裏側」を制御してプロダクトをブラッシュアップする開発手法を深掘りする。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】ローカルLLM環境構築5ステップ|APIコストゼロでAI開発
