


AIが生成したテキストに「透かし」を入れる。OpenAIがこの動きを加速させている。EUの規制対応が名目だが、開発者にとっての現実は、これが単なるコンプライアンスの問題にとどまらない点だ。
今後、API経由で生成されるテキストには統計的な追跡信号が埋め込まれる。一方で、ローカル環境で完結するツール群は、プライバシー保護を武器に「外部から不可視であること」を価値に変えている。
「AIの利用を証明するのか、それとも隠すのか」。この二極化するトレンドの中で、自分のSaaSやアプリにどんな実装を選択するか。その判断基準を整理する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
AI生成物の透明性を巡る動きとEU規制の要件
OpenAIは、EUのAI規制法(EU AI Act)に対応し、生成テキストに統計的な「透かし(Watermarking)」を埋め込む機能を導入すると発表した。APIユーザーは、特定のモデル利用時に透かしの有無をオプトインで選択できる。
今回の発表の要点は以下の通りだ。
* APIでのオプトイン導入: 世界中のAPI利用者は、特定のモデルにおいて透かしの有効化を選択可能だ。デフォルト設定は「オフ」のままである。
* ChatGPTへの適用: 今後数週間以内に、EU圏内のChatGPTおよびCodexのテキスト出力に対し、自動的に不可視の透かしが埋め込まれる。
* 検出ツールの限定公開: モデルが生成した文章かを判定する検出ツールが、特定の研究機関や専門家向けに限定公開される。
* 技術的アプローチ: 「textGrain」と呼ばれる統計的信号を単語選択のプロセスに付与する手法を採用した。これは既存のSynthID等の技術と同等以上の性能を目指している。
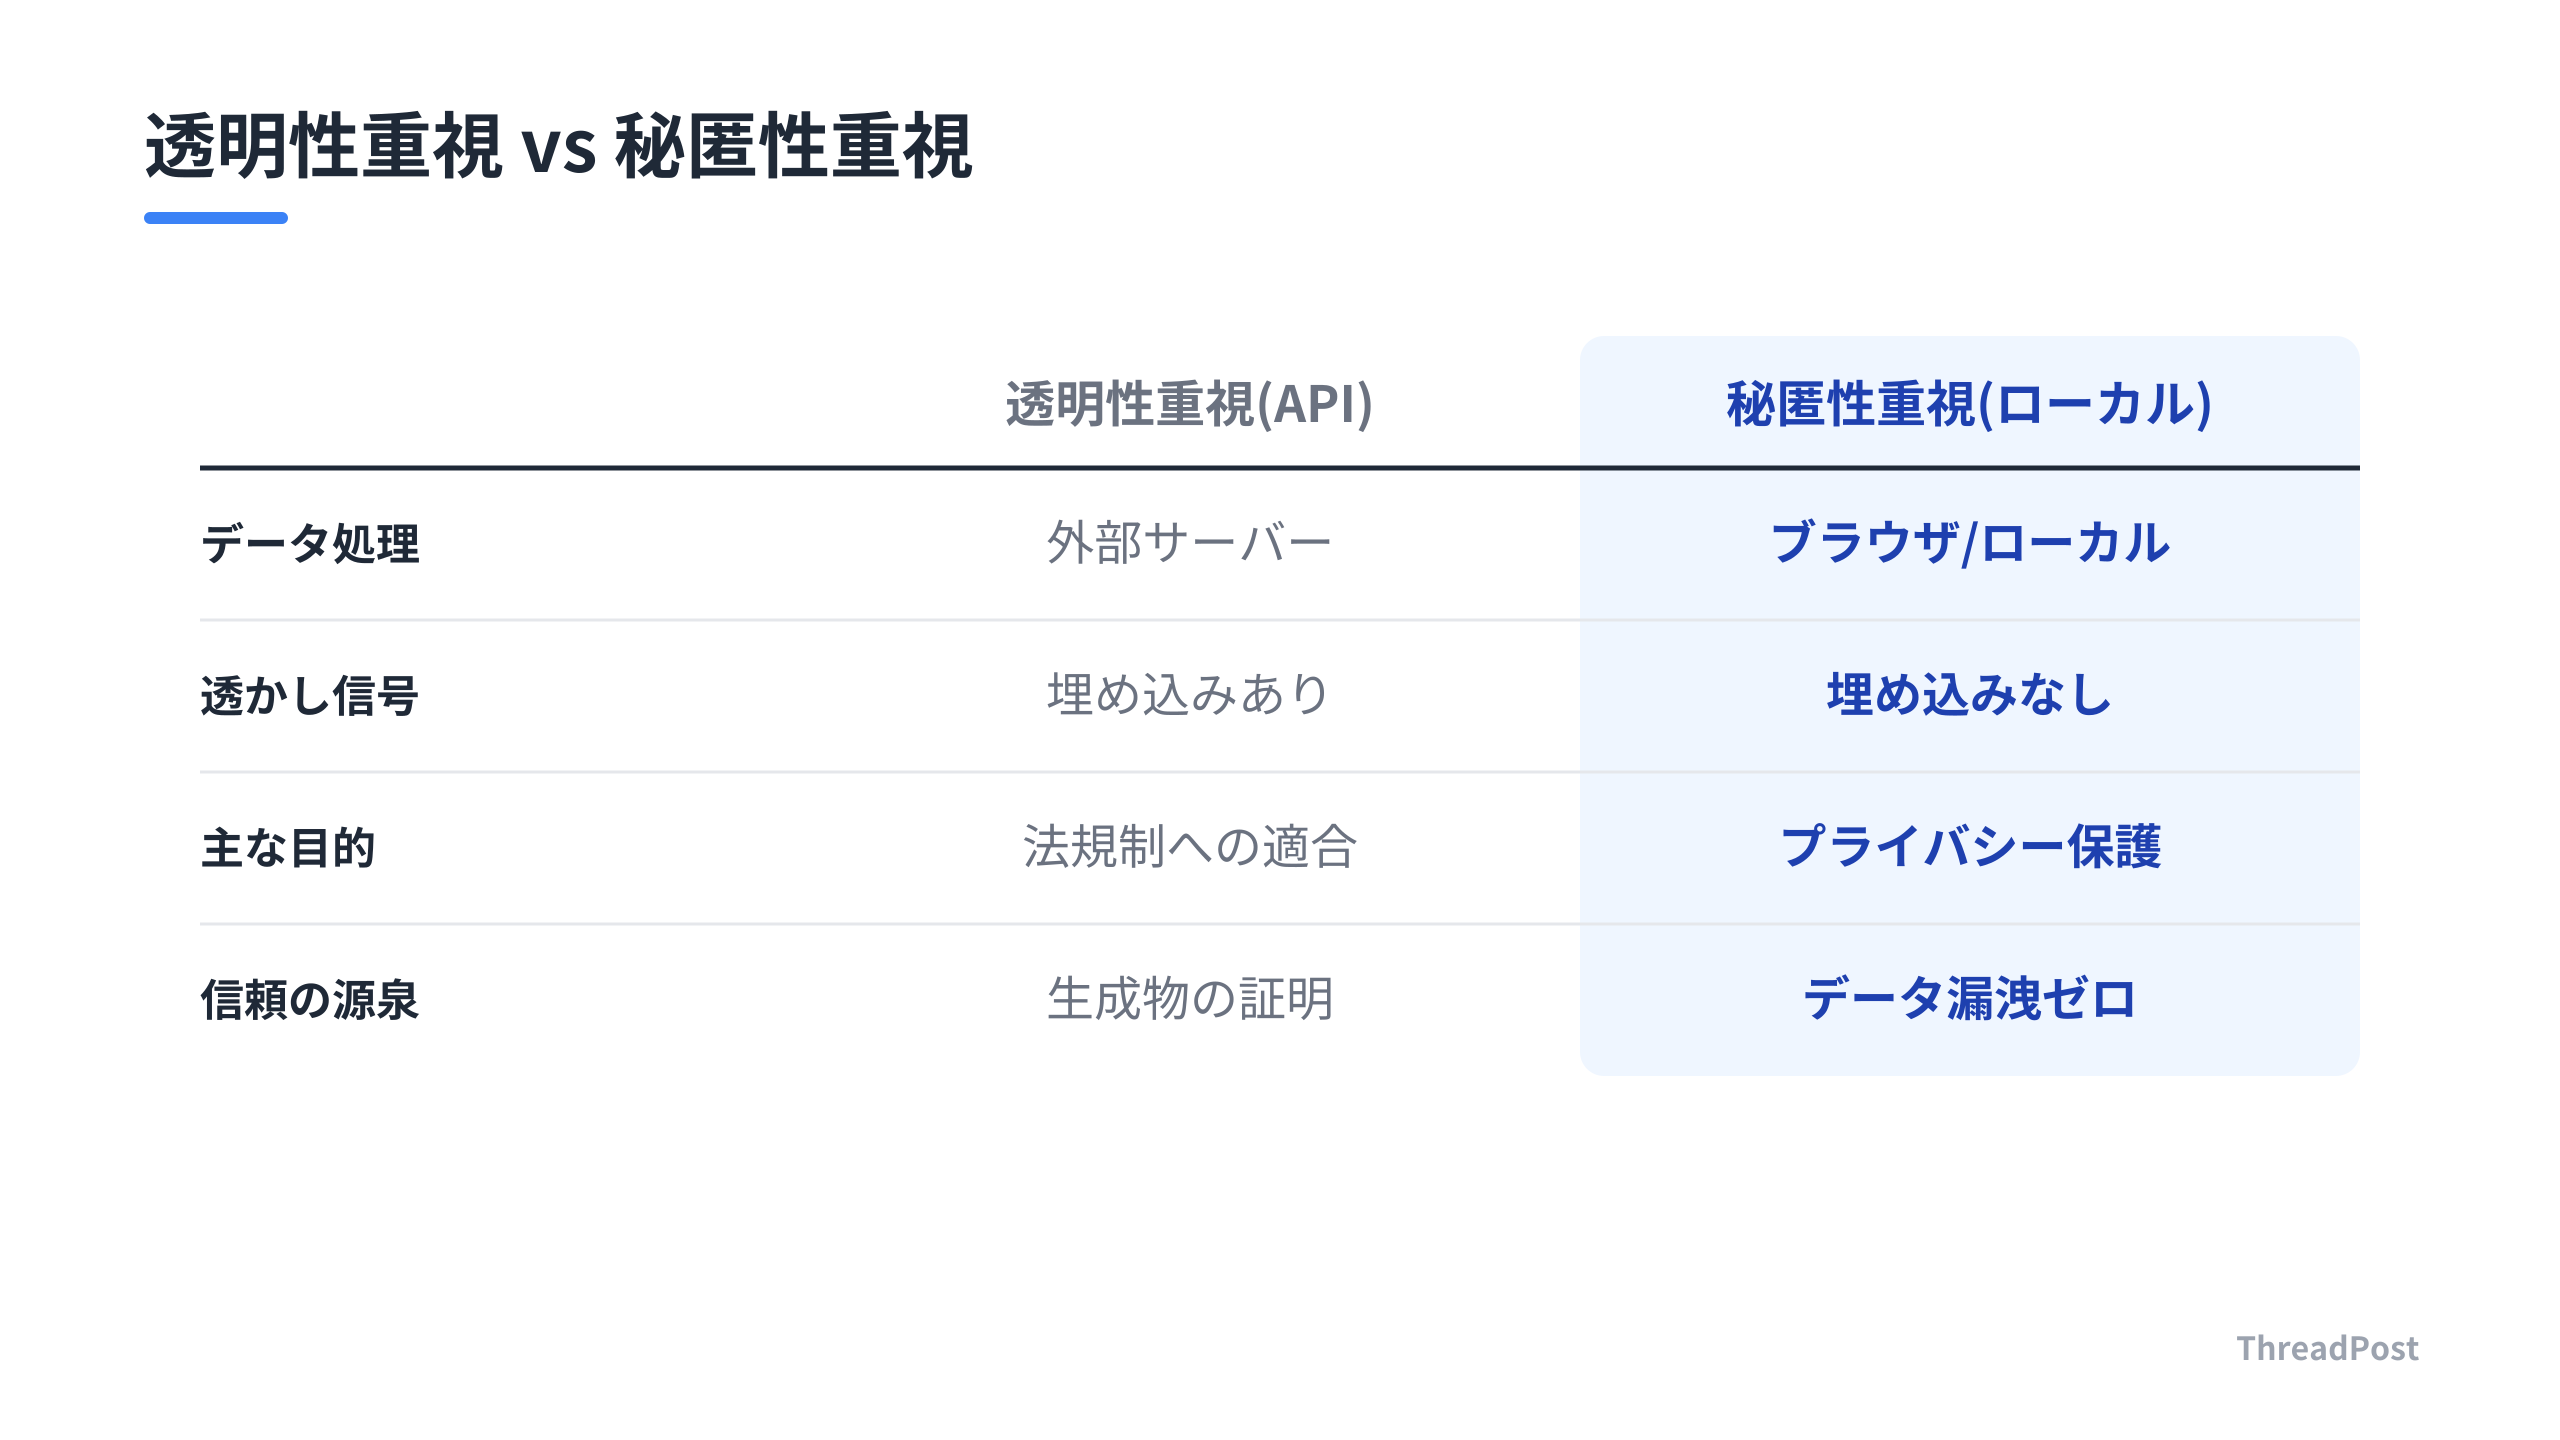
一方で、世の中の潮流は「透明性」だけではない。ローカル環境で動作するOCRツールや、機密情報を扱う法務レビューツールなど、「外部サーバーにデータを送信しない」ことでプライバシーを担保する動きも加速している。
しんたろー:
OpenAIが透かしで「AI生成の証明」を突き進む一方で、ローカル完結型ツールは「外部へのデータ漏洩ゼロ」を掲げている。目的が真逆だ。APIを叩くのかローカルで回すのか、開発者としてどっちのスタンスをユーザーに見せるか、明確にする必要があると感じる。
今回のOpenAIの発表は、あくまで「透明性を求める法規制」への対応が主眼だ。しかし、開発者目線で見れば、「モデルが生成した」というタグ付けが、将来的に検索エンジンやプラットフォーム側でどう扱われるかという懸念も残る。
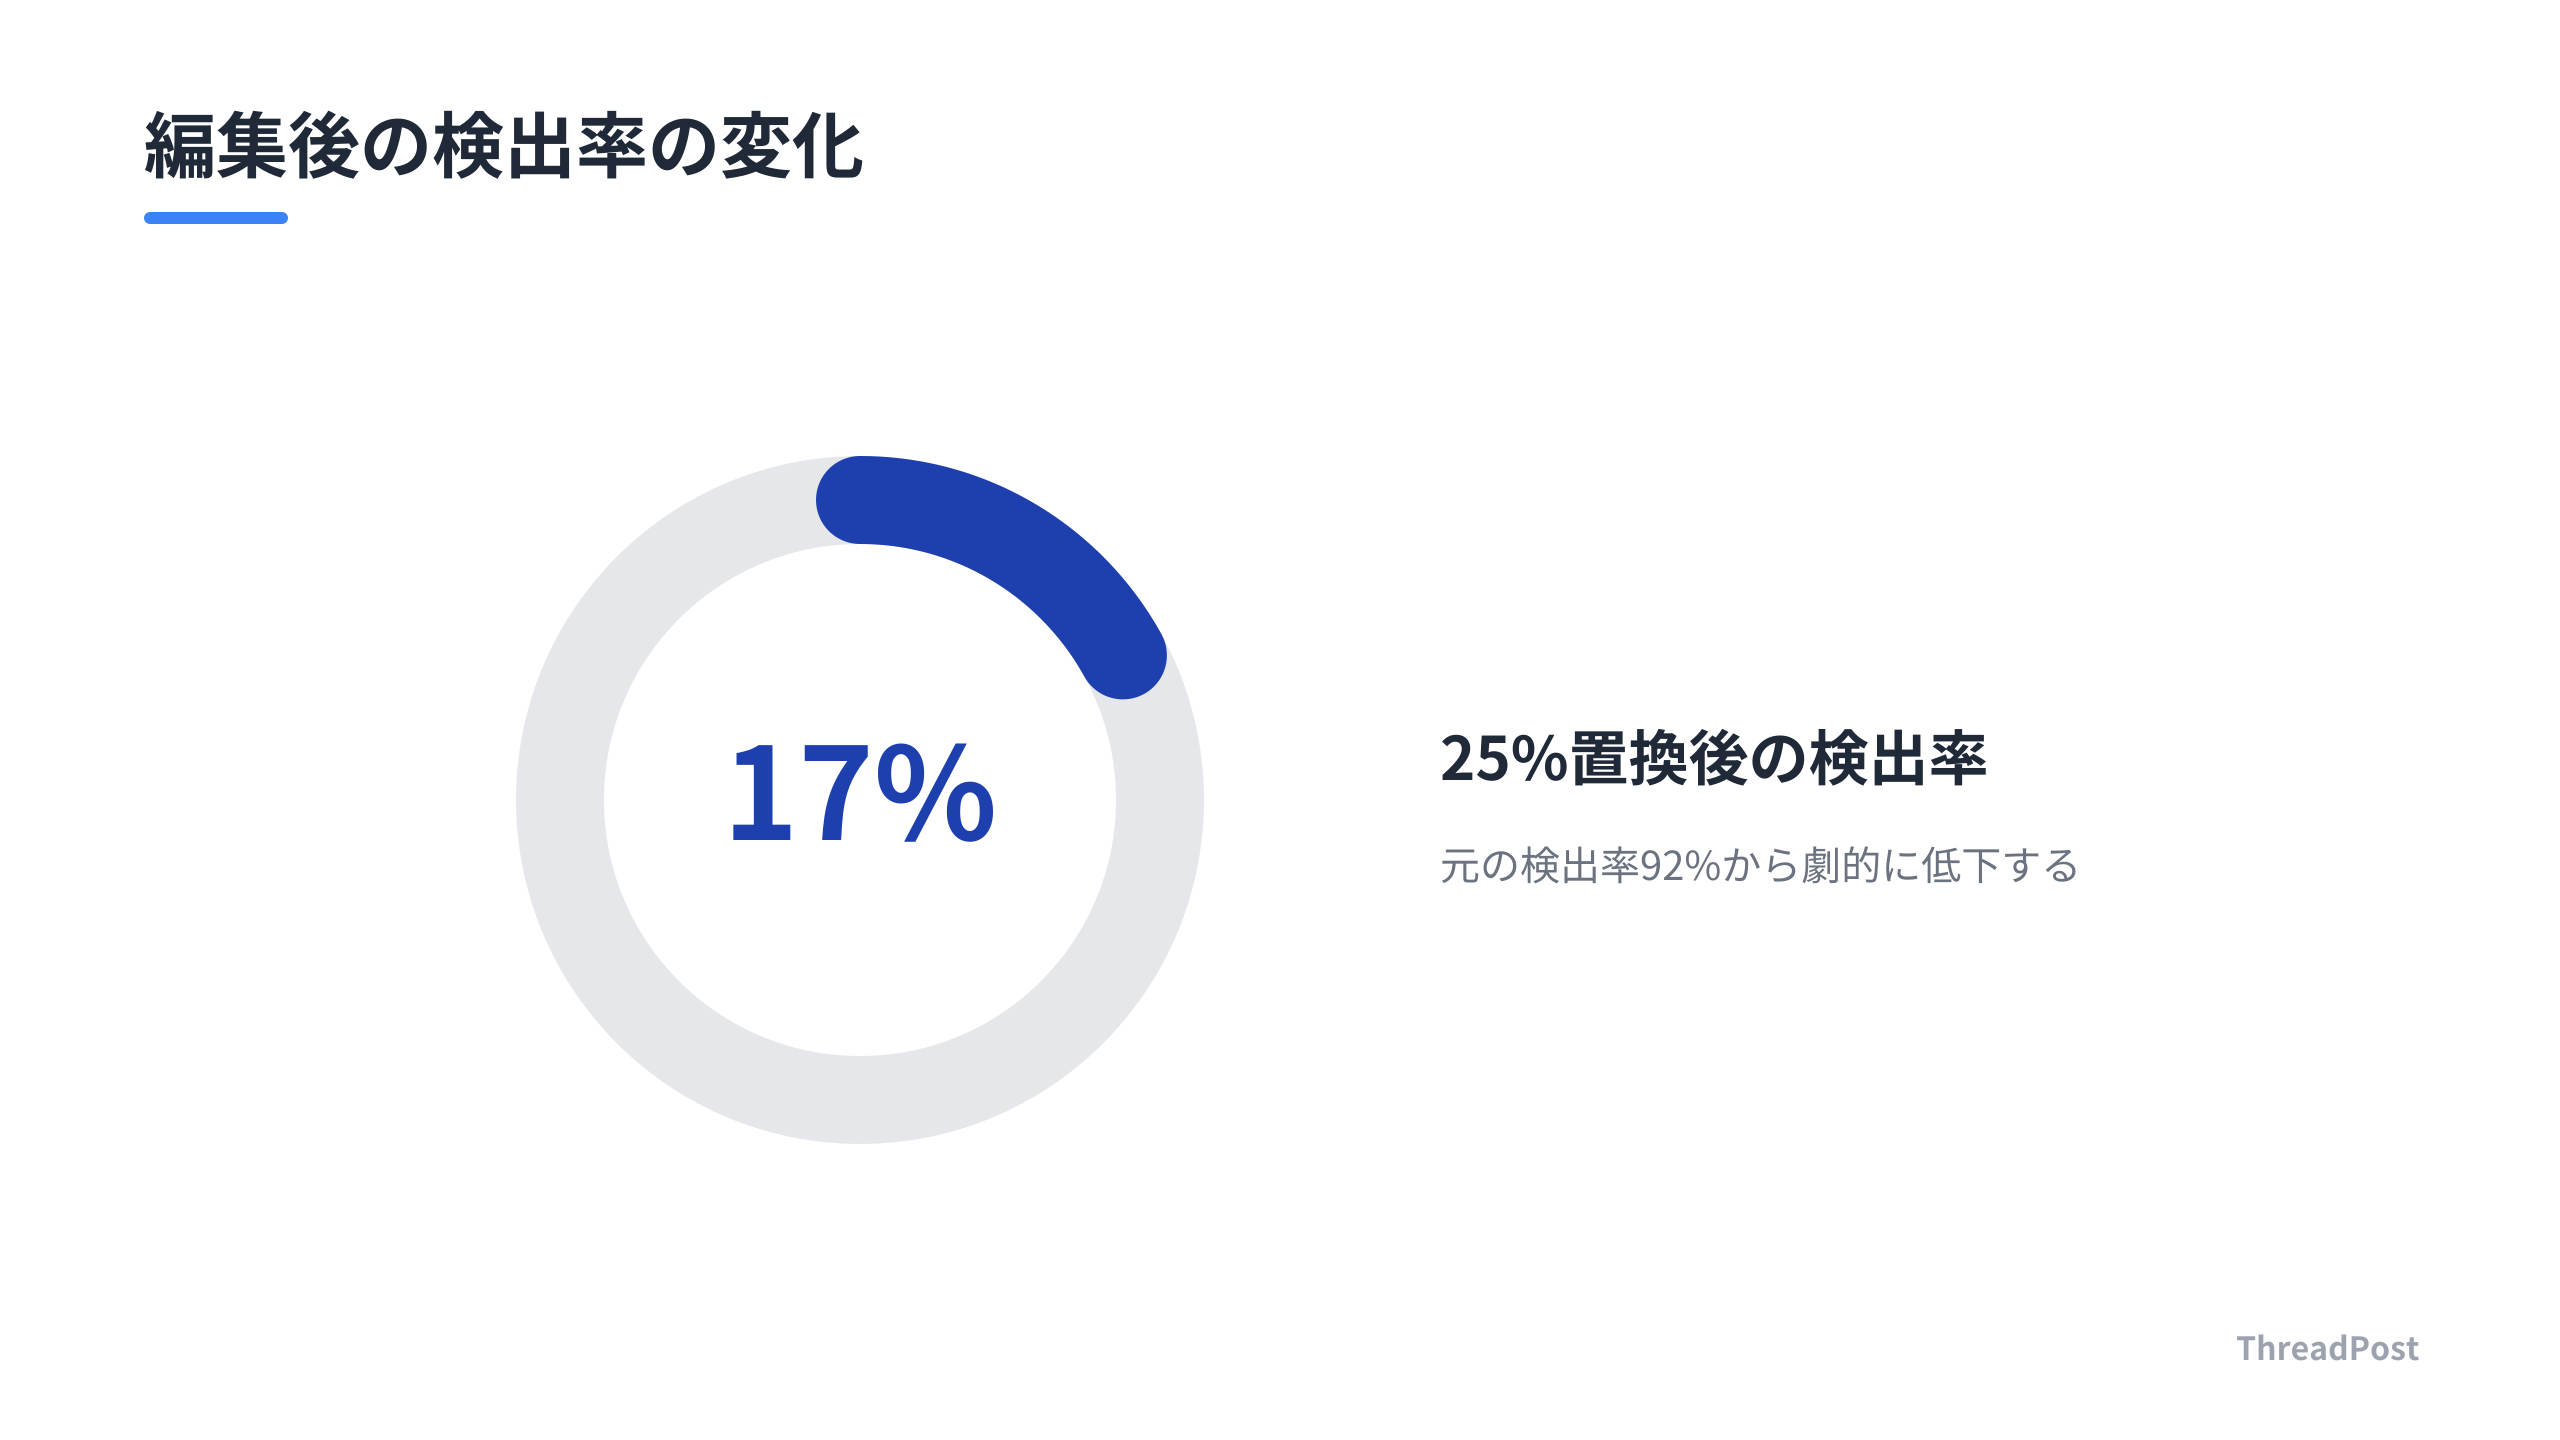
特に、透かし技術は編集耐性が低い。400トークンの文章において、単語の25%を同義語に置き換えるだけで、検出率は92%から17%まで低下する特性がある。これを「完全な証明」として扱うのは時期尚早だ。
OpenAIは、この透かし技術をオープンソース化する方針も示している。これにより、将来的には他社モデルやローカルLLMとの相互運用性がどう担保されるか、あるいは互換性のない「透かしの乱立」が起きるのかが、次の焦点となる。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
開発者が直面する「透明性」と「秘匿性」のジレンマ
今回の動きで興味深いのは、AIの「透明性」を担保しようとする動きと、現場で求められる「秘匿性」のニーズが、逆方向を向いている点だ。
OpenAIが進めるのは、生成物に対して統計的なシグナルを埋め込み、外部から「AI製であること」を証明可能にするアプローチだ。これはEU AI Actといった法規制への適合としては正しいが、開発者の日常的な実装方針とは必ずしも一致しない。
対照的に、多くの個人開発者が取り組んでいるのは、ブラウザやローカル環境で完結する「外部依存ゼロ」のツールだ。これらは、ユーザーの入力データや生成結果を外部サーバーに一切送信しないことで、秘匿性を最大化することを価値の源泉としている。
この二つの潮流は、開発者が「どのレイヤーで価値を提供するか」を分かつ分岐点になる。
「AI生成物であることを積極的に証明して信頼を得るサービス」を構築するのか。それとも「AIを徹底的に隠蔽し、ローカル処理によるプライバシー保護で信頼を得るサービス」を作るのか。この二者択一に近い判断が、プロダクトの設計思想を決定づける。
Claude Codeでコードを書いていると、API制限や機密保持の壁にぶつかる。生成物に透かしが入るなら、将来的にそのコードをGitHubに上げる際、AI製であることを宣言するメタデータとして活用できるかもしれない。ただ、プライバシー重視のツールでこれを実装したら、ユーザーから「勝手に追跡用タグを埋め込むな」と指摘される未来が見える。
さらに技術的な視点で言えば、この「透かし」の信頼性をどう扱うかは繊細な問題だ。
現在、多くのOCRツールや法務チェックツールでは、生成AIによる自動校正機能が標準化されつつある。しかし、この校正プロセス自体が、モデルが埋め込んだ「統計的な透かし」を破壊する可能性がある。
ユーザーがAIを使って文書をブラッシュアップすればするほど、その文書が「AI生成物である」という証明は失われていくという、皮肉なトレードオフが存在する。
開発者としては、以下の三点を評価しておく必要がある。
* 編集耐性の限界: 短い文章や頻繁に編集が行われるコンテンツでは、透かしによる検出率は低下する。
* 実装コストと目的の不一致: APIの透かし機能はオプトイン方式だ。将来的な規制対応を考え、今から「透かしあり」のパイプラインをテストするか、「透かしなし」のローカル処理に特化し続けるかを選択する必要がある。
* 相互運用性の欠如: 今後、各モデルが独自の透かし技術を実装した場合、複数のAIを組み合わせて生成したコンテンツの出所をどう管理するかという、新しい技術的負債が生まれる可能性がある。
結局のところ、AIによる「透明性」はモデル提供者側の論理だ。我々開発者は「ユーザーが何を求めているか」という現場の論理で技術を選定しなければならない。
機密情報を扱う業務ツールであれば、外部APIに依存せず、ローカル完結型のルールベース処理と軽量LLMを組み合わせる方が、現時点ではユーザーの信頼を獲得しやすい。
一方で、パブリックなコンテンツ制作ツールであれば、透明性を担保し、AI生成物であることを明示する機能をあえて実装することで、将来的なプラットフォーム側の規制リスクを回避できる。
どちらの道を歩むにせよ、AIを「魔法の箱」として扱う時期は終わった。この透かし技術の挙動を理解し、自分のプロダクトの特性に合わせて「透かしを許容するか、徹底的に排除するか」を設計の初期段階で決めておくことが、これからの開発者には求められている。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
透かし技術とプライバシー保護を実装レベルで使い分ける
明日から開発現場に何を落とし込むか。結論は「AIの利用目的が、外部への証明か、内部での安全な処理か」によって、技術構成を切り分けることだ。
まず、EU圏を含むグローバル展開を視野に入れたコンテンツ生成アプリなら、OpenAIのAPIにおける透かし機能のオプトインを、初期段階から設計に組み込む必要がある。法規制への対応コストを後から支払うのは、スタートアップにとって死活問題になるからだ。
一方で、社内の機密文書や個人情報を扱う業務ツールを開発する場合、話は全く別になる。ここでは「透かし」は単なるノイズだ。サーバーにデータを送らない「ローカル完結型」のアーキテクチャこそが最大の差別化要因になる。
Claude Codeでローカルのコードベースをいじっていると、外部APIへのデータ送信は極力減らしたくなる。結局、ユーザーが一番気にしてるのは「自分のデータがどこに行くか」だ。ローカル完結の安心感は機能の多さより優先順位が高い。
実装面での具体的なアクションは以下の通りだ。
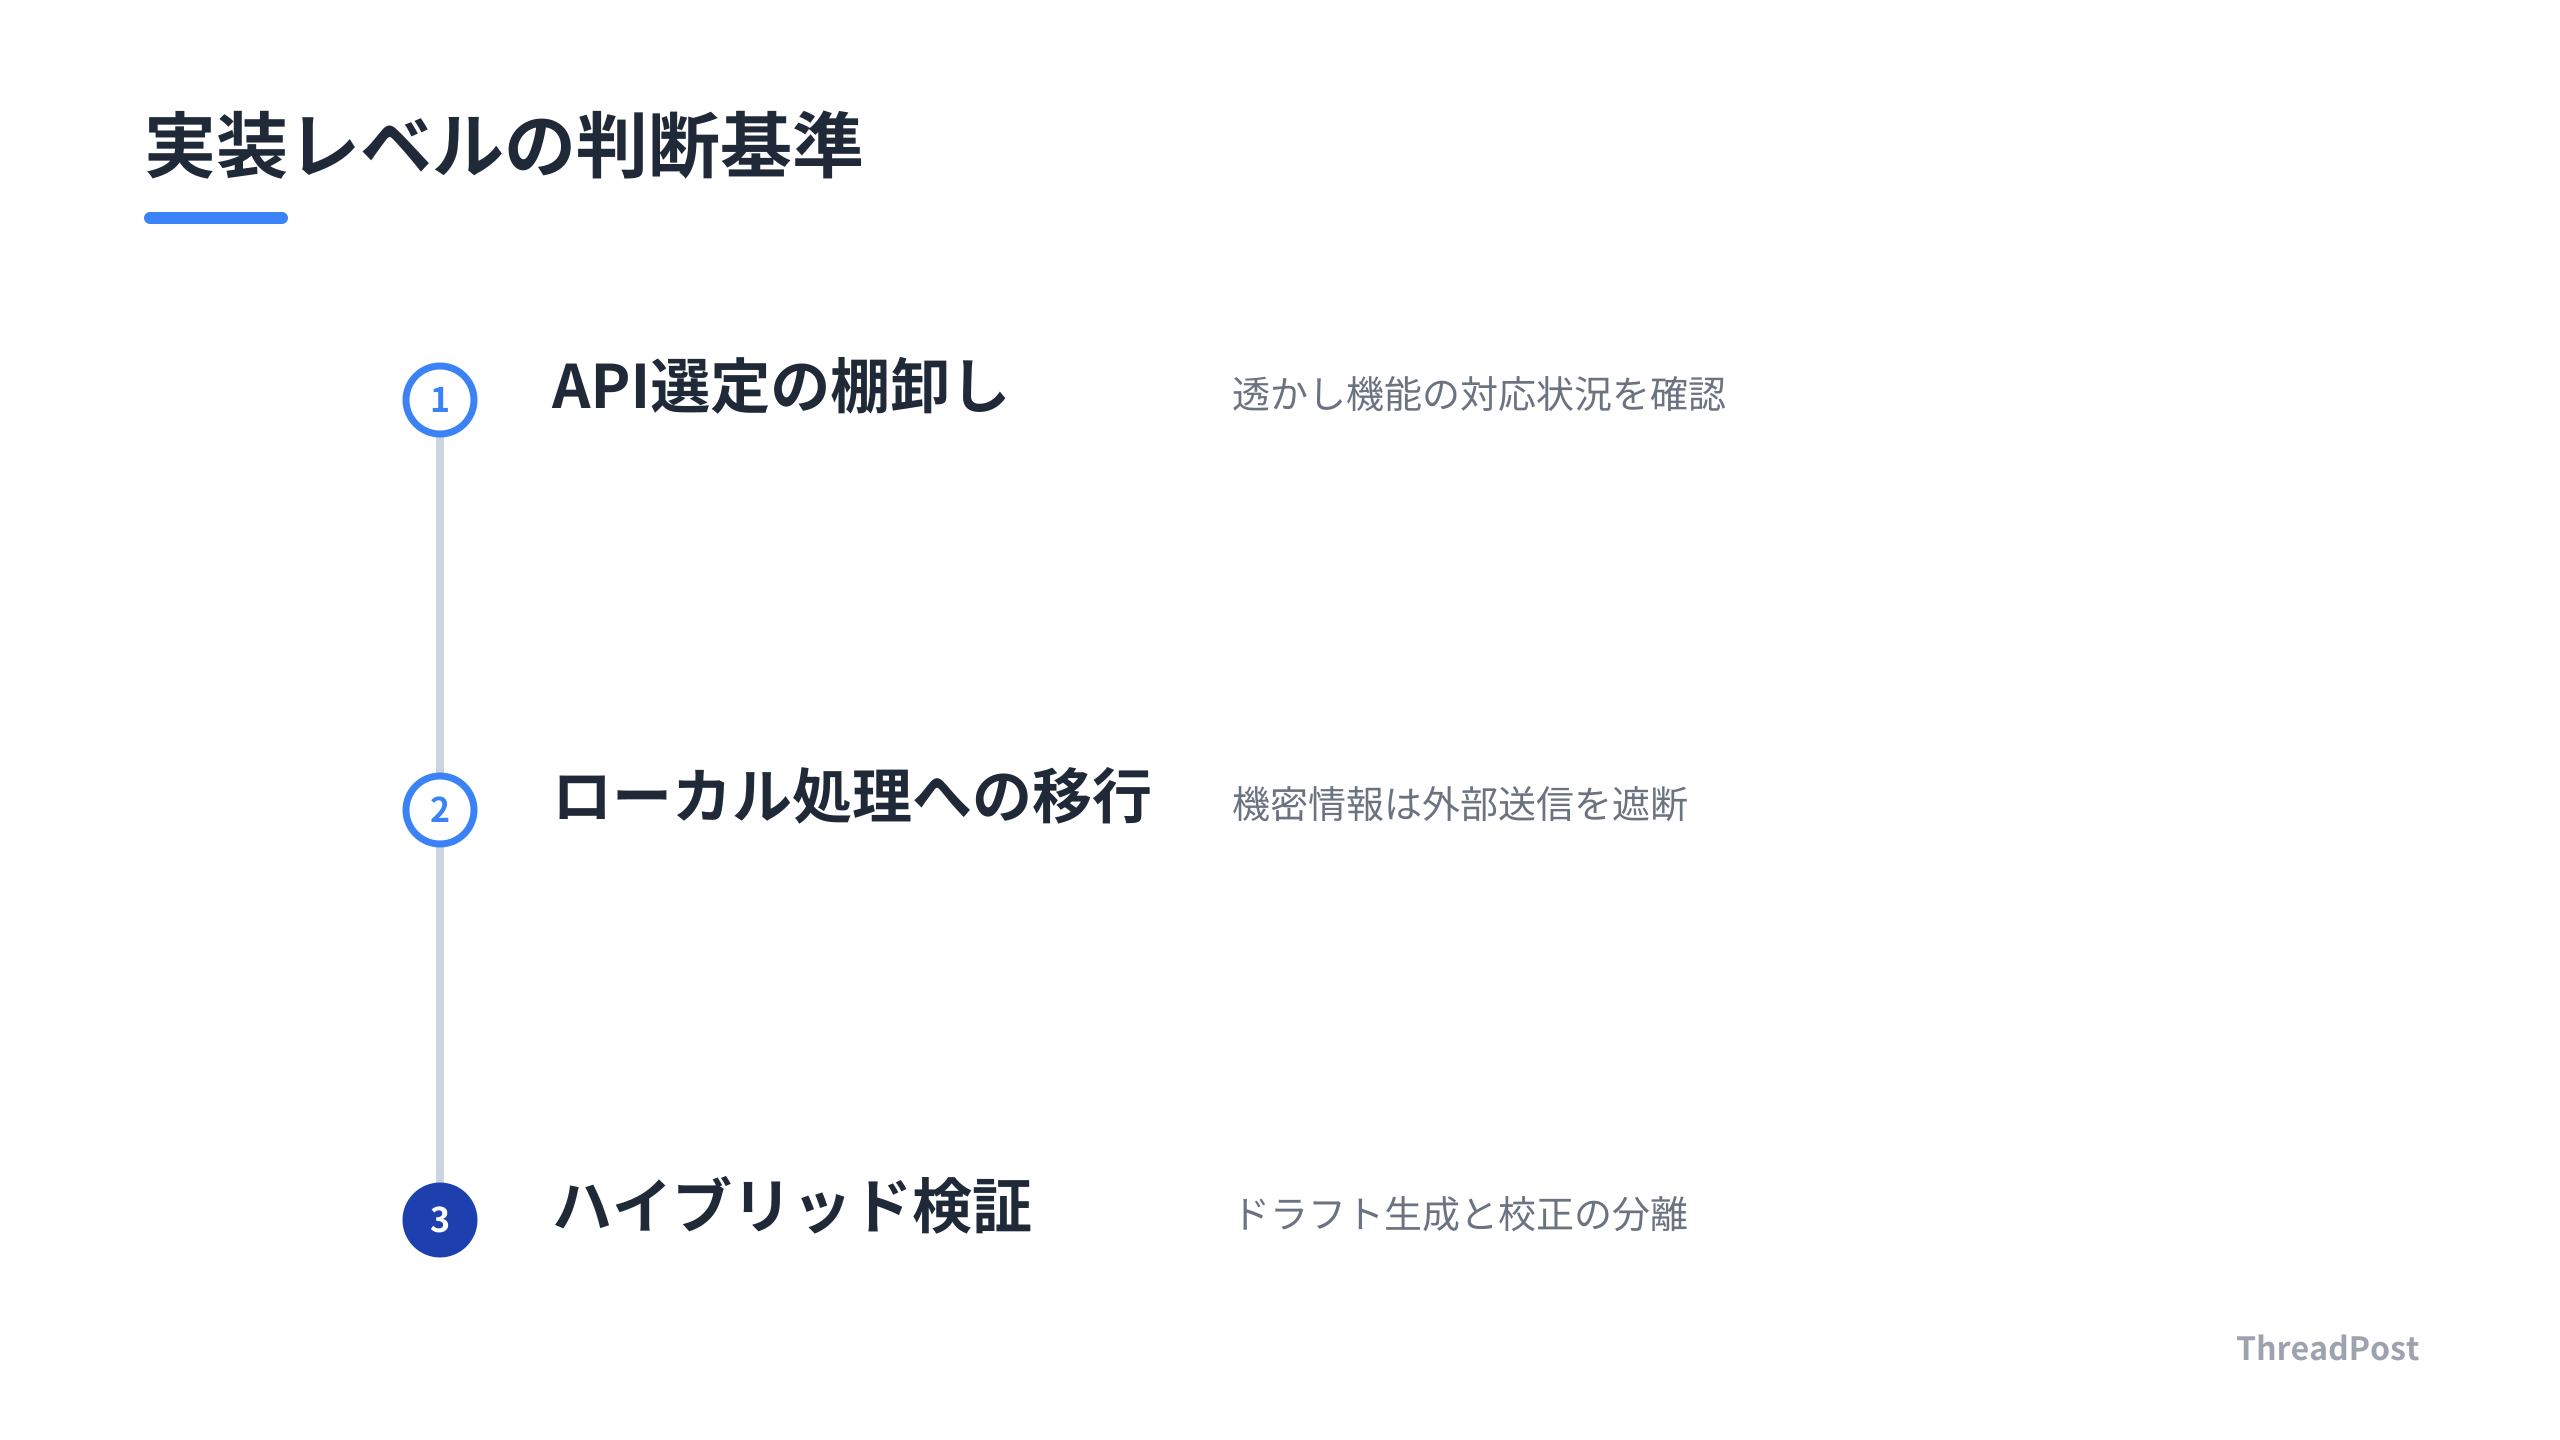
- API選定の棚卸し: 利用しているLLMのAPIが、透かし機能の提供を開始しているかを確認する。対応していれば、設定項目にフラグを立てられるよう、今のうちにUIを設計しておく。
- ローカル処理への切り替え: OCRや法務チェックなど、機密性の高い処理は、ブラウザ側で完結するライブラリや、ローカルで動作する軽量モデルへの移行を検討する。これにより、透かしによる追跡リスクを物理的に遮断できる。
- ハイブリッド構成の検証: コンテンツ制作ツールなら、生成プロセスを「AIによるドラフト生成(透かしあり)」と「人間による編集・校正(透かしの減衰)」の二段階に分ける実装を試す。透かしが編集耐性に弱いという特性を逆手に取り、どの程度までなら「AI生成物」として認識されるかをテストする。
特に、透かし技術は「生成された瞬間の信号」に依存している。そのため、生成後に自前でスクリプトを走らせて微細なリライトやフォーマット変換を挟むだけで、検出精度は低下する。
この「検出の回避」を悪用するのではなく、ユーザーのプライバシーを守るための「ノイズ付加技術」として捉え直すことが、開発者には求められている。
AI生成物を「透明にする」か「秘匿する」か。この二択をプロダクトのロードマップの最上段に置く。開発者がこの方針を明確に示せば、それは単なる機能追加ではなく、ユーザーに対する「信頼の設計図」になる。
明日からの開発では、APIを叩く前に一度立ち止まって考えてみてほしい。そのAIの出力は、誰のために、何のために透明であるべきなのかを。
 あわせて読みたい【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録 →
よくある質問
OpenAIのテキスト透かしは、自分のアプリで強制的に有効化されますか?
いいえ、API経由の透かしはデフォルトでオフになっています。開発者が明示的にオプトインしない限り、自動的に適用されることはありません。ただし、EU AI Actの規制対象となるサービスを提供する場合、法規制への準拠として将来的に対応が求められる可能性があります。現時点では、主に研究目的や高い透明性が求められるユースケースでの利用が想定されています。
ローカル完結型のツールは、なぜサーバー型より優れているのですか?
最大の違いは「データプライバシー」の確保です。機密情報や個人情報を含む文書を外部サーバーに送信しないため、物理的に情報漏洩リスクをゼロにできます。また、インターネット環境に依存せず、API利用料も発生しません。中小企業や個人事業主が、低コストかつ高精度なAI機能を業務に組み込む際の現実的な選択肢となります。
透かし技術は、文章を書き換えても検出できますか?
検出率は低下します。OpenAIの評価では、同義語への置換などで文章を編集すると、検出精度が大きく損なわれることが示されています。例えば、400トークンの文章で単語の25%を入れ替えるだけで、検出率は92%から17%まで下がります。透かしは「AI生成物の完全な証明」ではなく、あくまで補助的な識別手段として捉えるのが賢明です。
まとめ
OpenAIが導入した透かし技術と、僕らが開発するローカル完結型ツール。これらは「透明性の確保」と「プライバシーの保護」という、相反する方向に進化している。どちらが正解というわけではなく、開発者として「そのAIを何のために使うのか」という目的意識が、これまで以上に重要になる。
「AI生成物を外部に証明したいのか」、それとも「機密データを守り抜きたいのか」。この設計思想の分岐点こそが、これからのSaaS開発における最大の差別化要因になる。
AIの透明性とプライバシー保護のバランスをどう設計すべきか、ThreadPostで議論を深めませんか?
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
