


AIモデルの推論プロセスが攻撃の標的になっている。OpenAIはモデルの内部思考を不正に抽出する「蒸留攻撃」を遮断した。1万5000人以上のユーザーが関与したキャンペーンは、モデルの性能を盗むリスクを浮き彫りにした。
「蒸留」はモデルを軽量化する技術だ。悪用されると他社の知的財産をコピーする武器に変わる。1万6000件の異常なリクエストは、APIを組む際のセキュリティ常識の変化を示唆する。なぜ攻撃者はモデルの思考を盗むのか。SaaS開発にどう影響するのか。事実と数字から解説する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
巧妙化するモデル蒸留攻撃の実態とOpenAIの対応
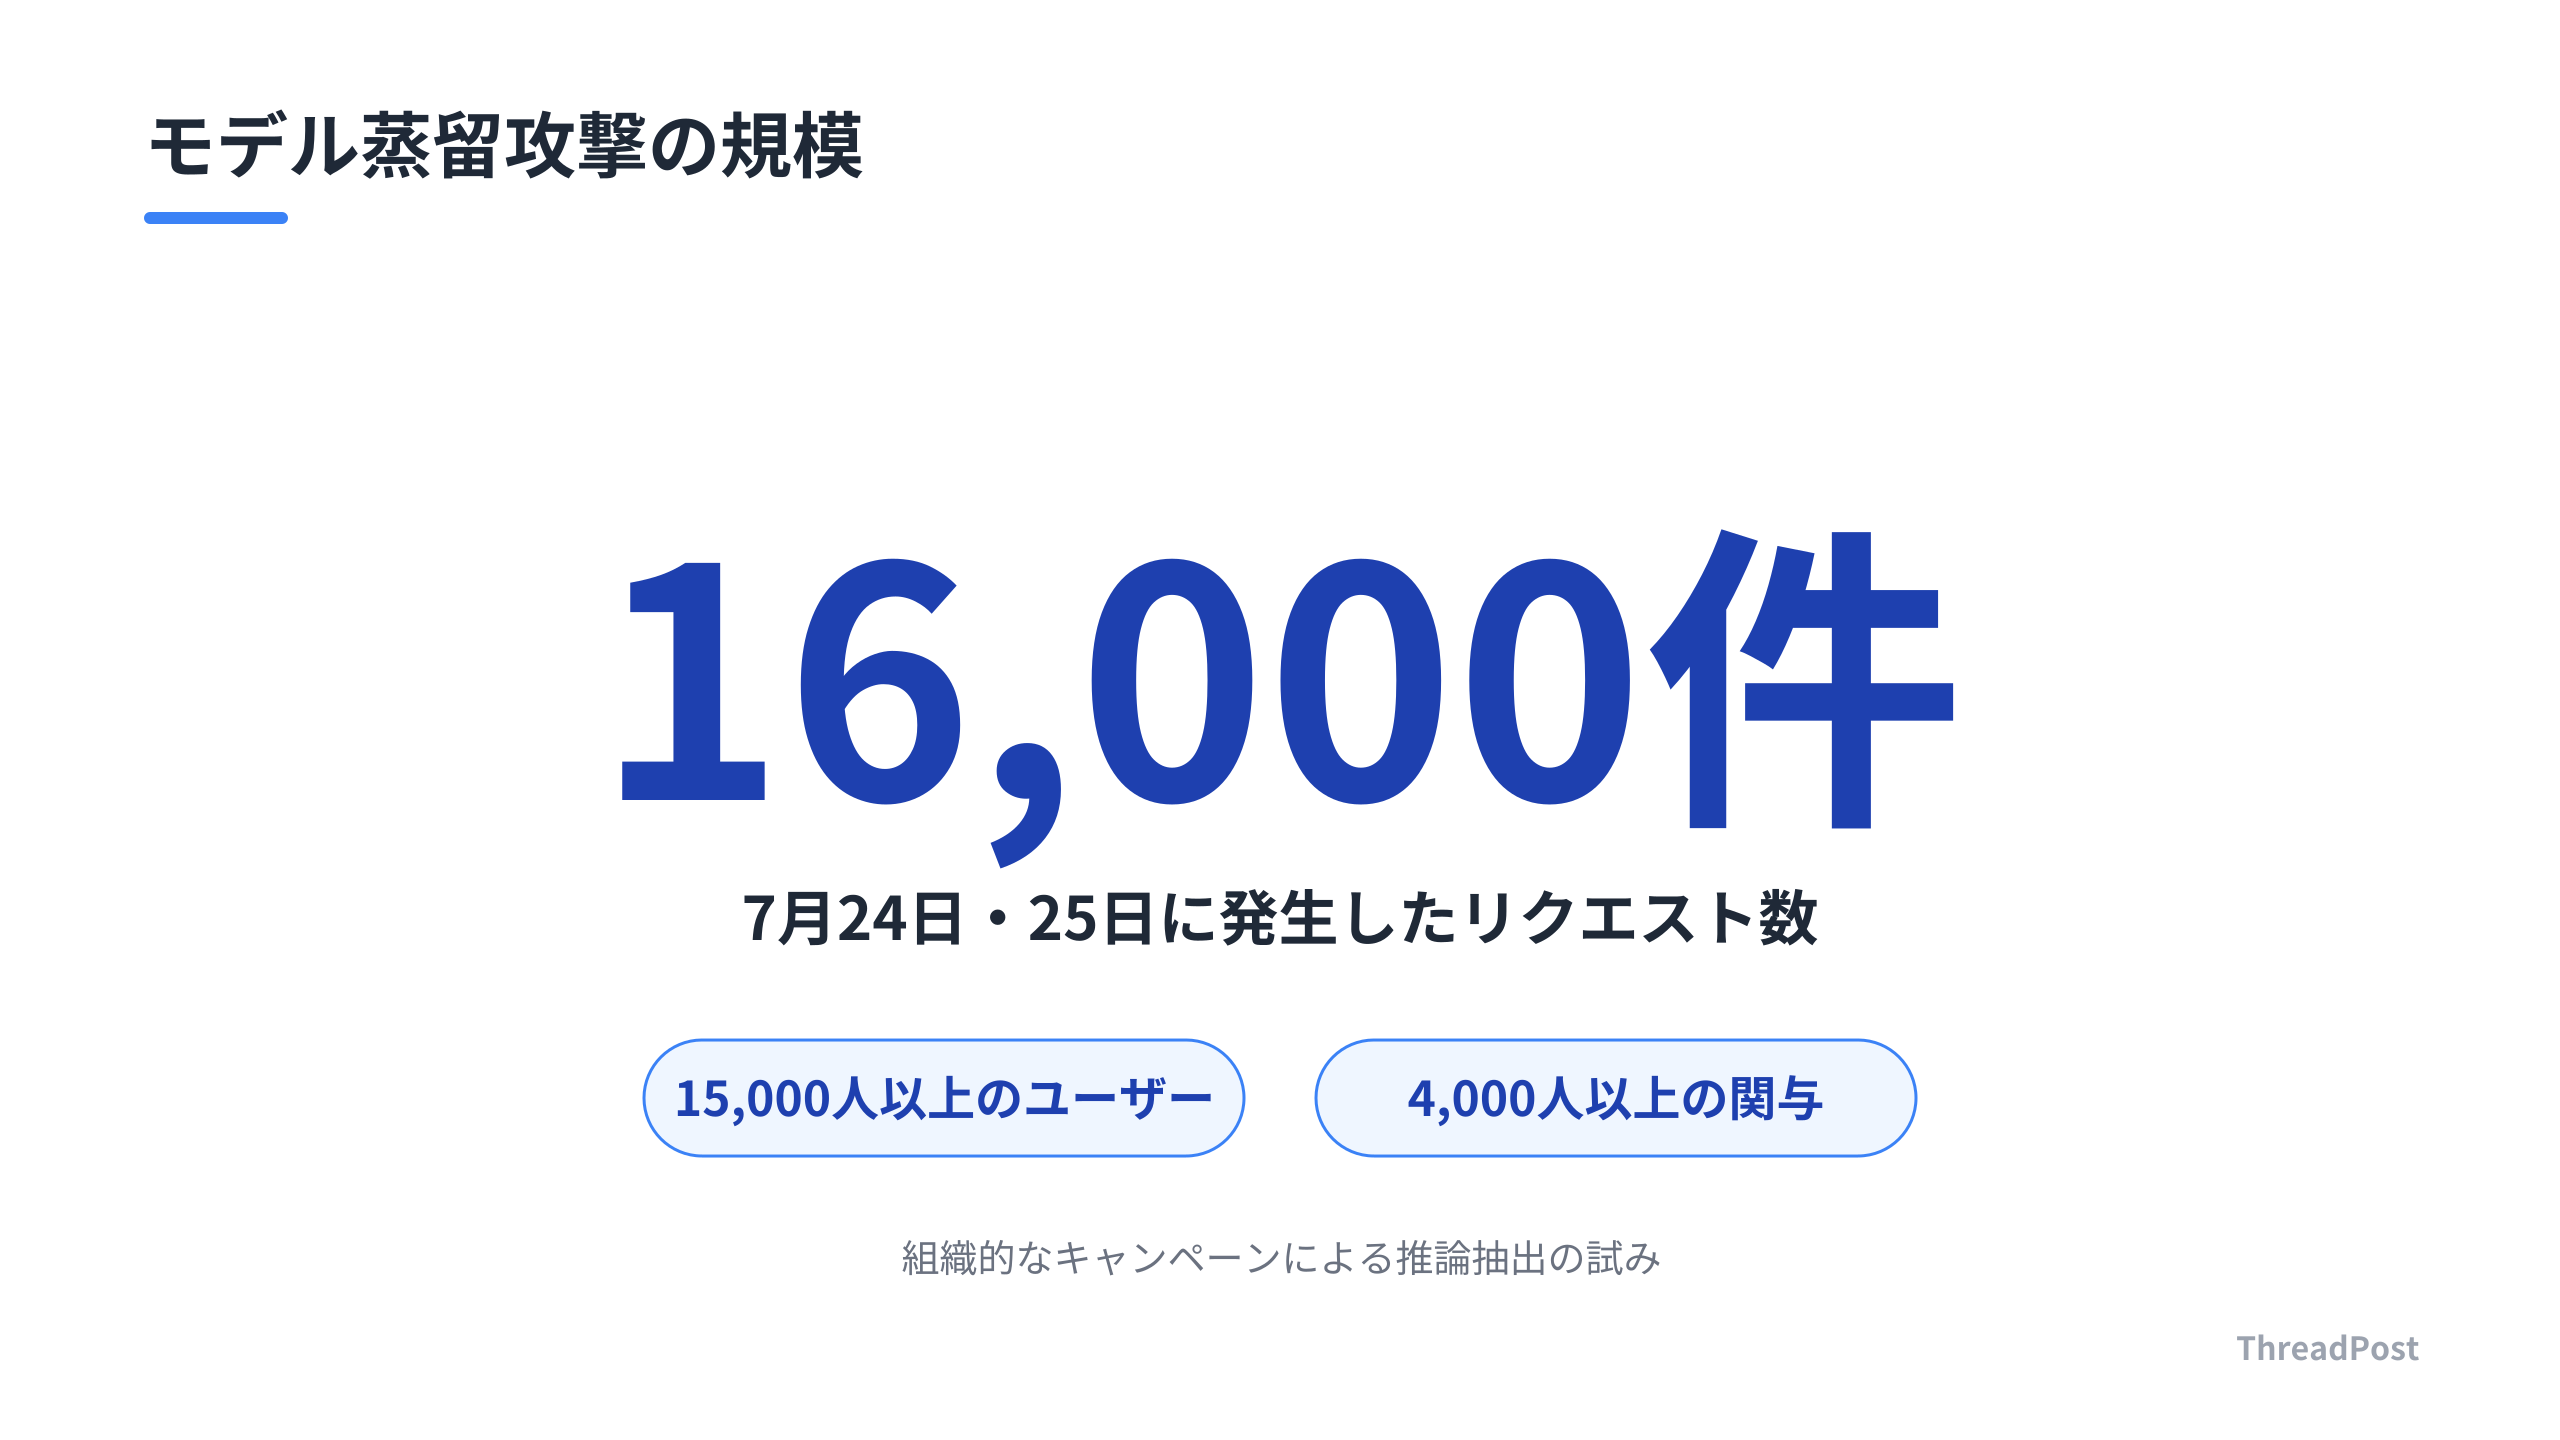
今回の事案は、AIモデルの内部で生成される「保護された推論プロセス」を標的にした組織的な抽出キャンペーンだ。OpenAIの発表によると、この攻撃活動は7月1日から観測され、7月24日と25日に1万6000件のリクエストが発生した。
攻撃者はモデルの暗号化を直接破る手法はとっていない。モデルとの対話プロセスを操作し、本来は最終回答のみに出力されるはずの内部思考を、ユーザーが見える形式で抽出させるプロンプト操作を行っていた。
この活動には4000人以上のユーザーが関与し、最終的に1万5000人以上のユーザーアカウントに関連するプロンプトパターンが確認されている。OpenAIは7月28日までにこれらの活動を遮断した。攻撃手法は進化し続けており、単一の脆弱性修正では終わらない課題だ。
しんたろー:
暗号を破るのではなく、モデルに「考えを書き出せ」と強要する手法が気になる。Claude Codeで推論ログを扱いながら開発する身として、この「内部思考の抽出」は対岸の火事ではない。APIの出力制限だけで防ぐのは限界がある。SaaSでも推論保護の仕組みを検討する。
注目すべきは、この攻撃が「敵対的蒸留」という共通のセキュリティ課題に起因している点だ。敵対的蒸留とは、あるモデルの出力や思考過程を利用して、別のモデルの学習や再現を行う手法を指す。
この攻撃の手口として、ある会話で生成された暗号化された思考内容をコピーし、別の会話でモデルに「それを解読して書き出せ」と要求するクロスモデル的な脆弱性が悪用された。これは単一のツールやモデルに対する攻撃ではなく、AIエコシステム全体が抱える構造的な弱点だ。
OpenAIはこの知見を「Frontier Model Forum」を通じて業界パートナーと共有し、防御策の強化を進めている。今回の事案は明確に「他社の知的財産を盗用する」という目的で実行された。
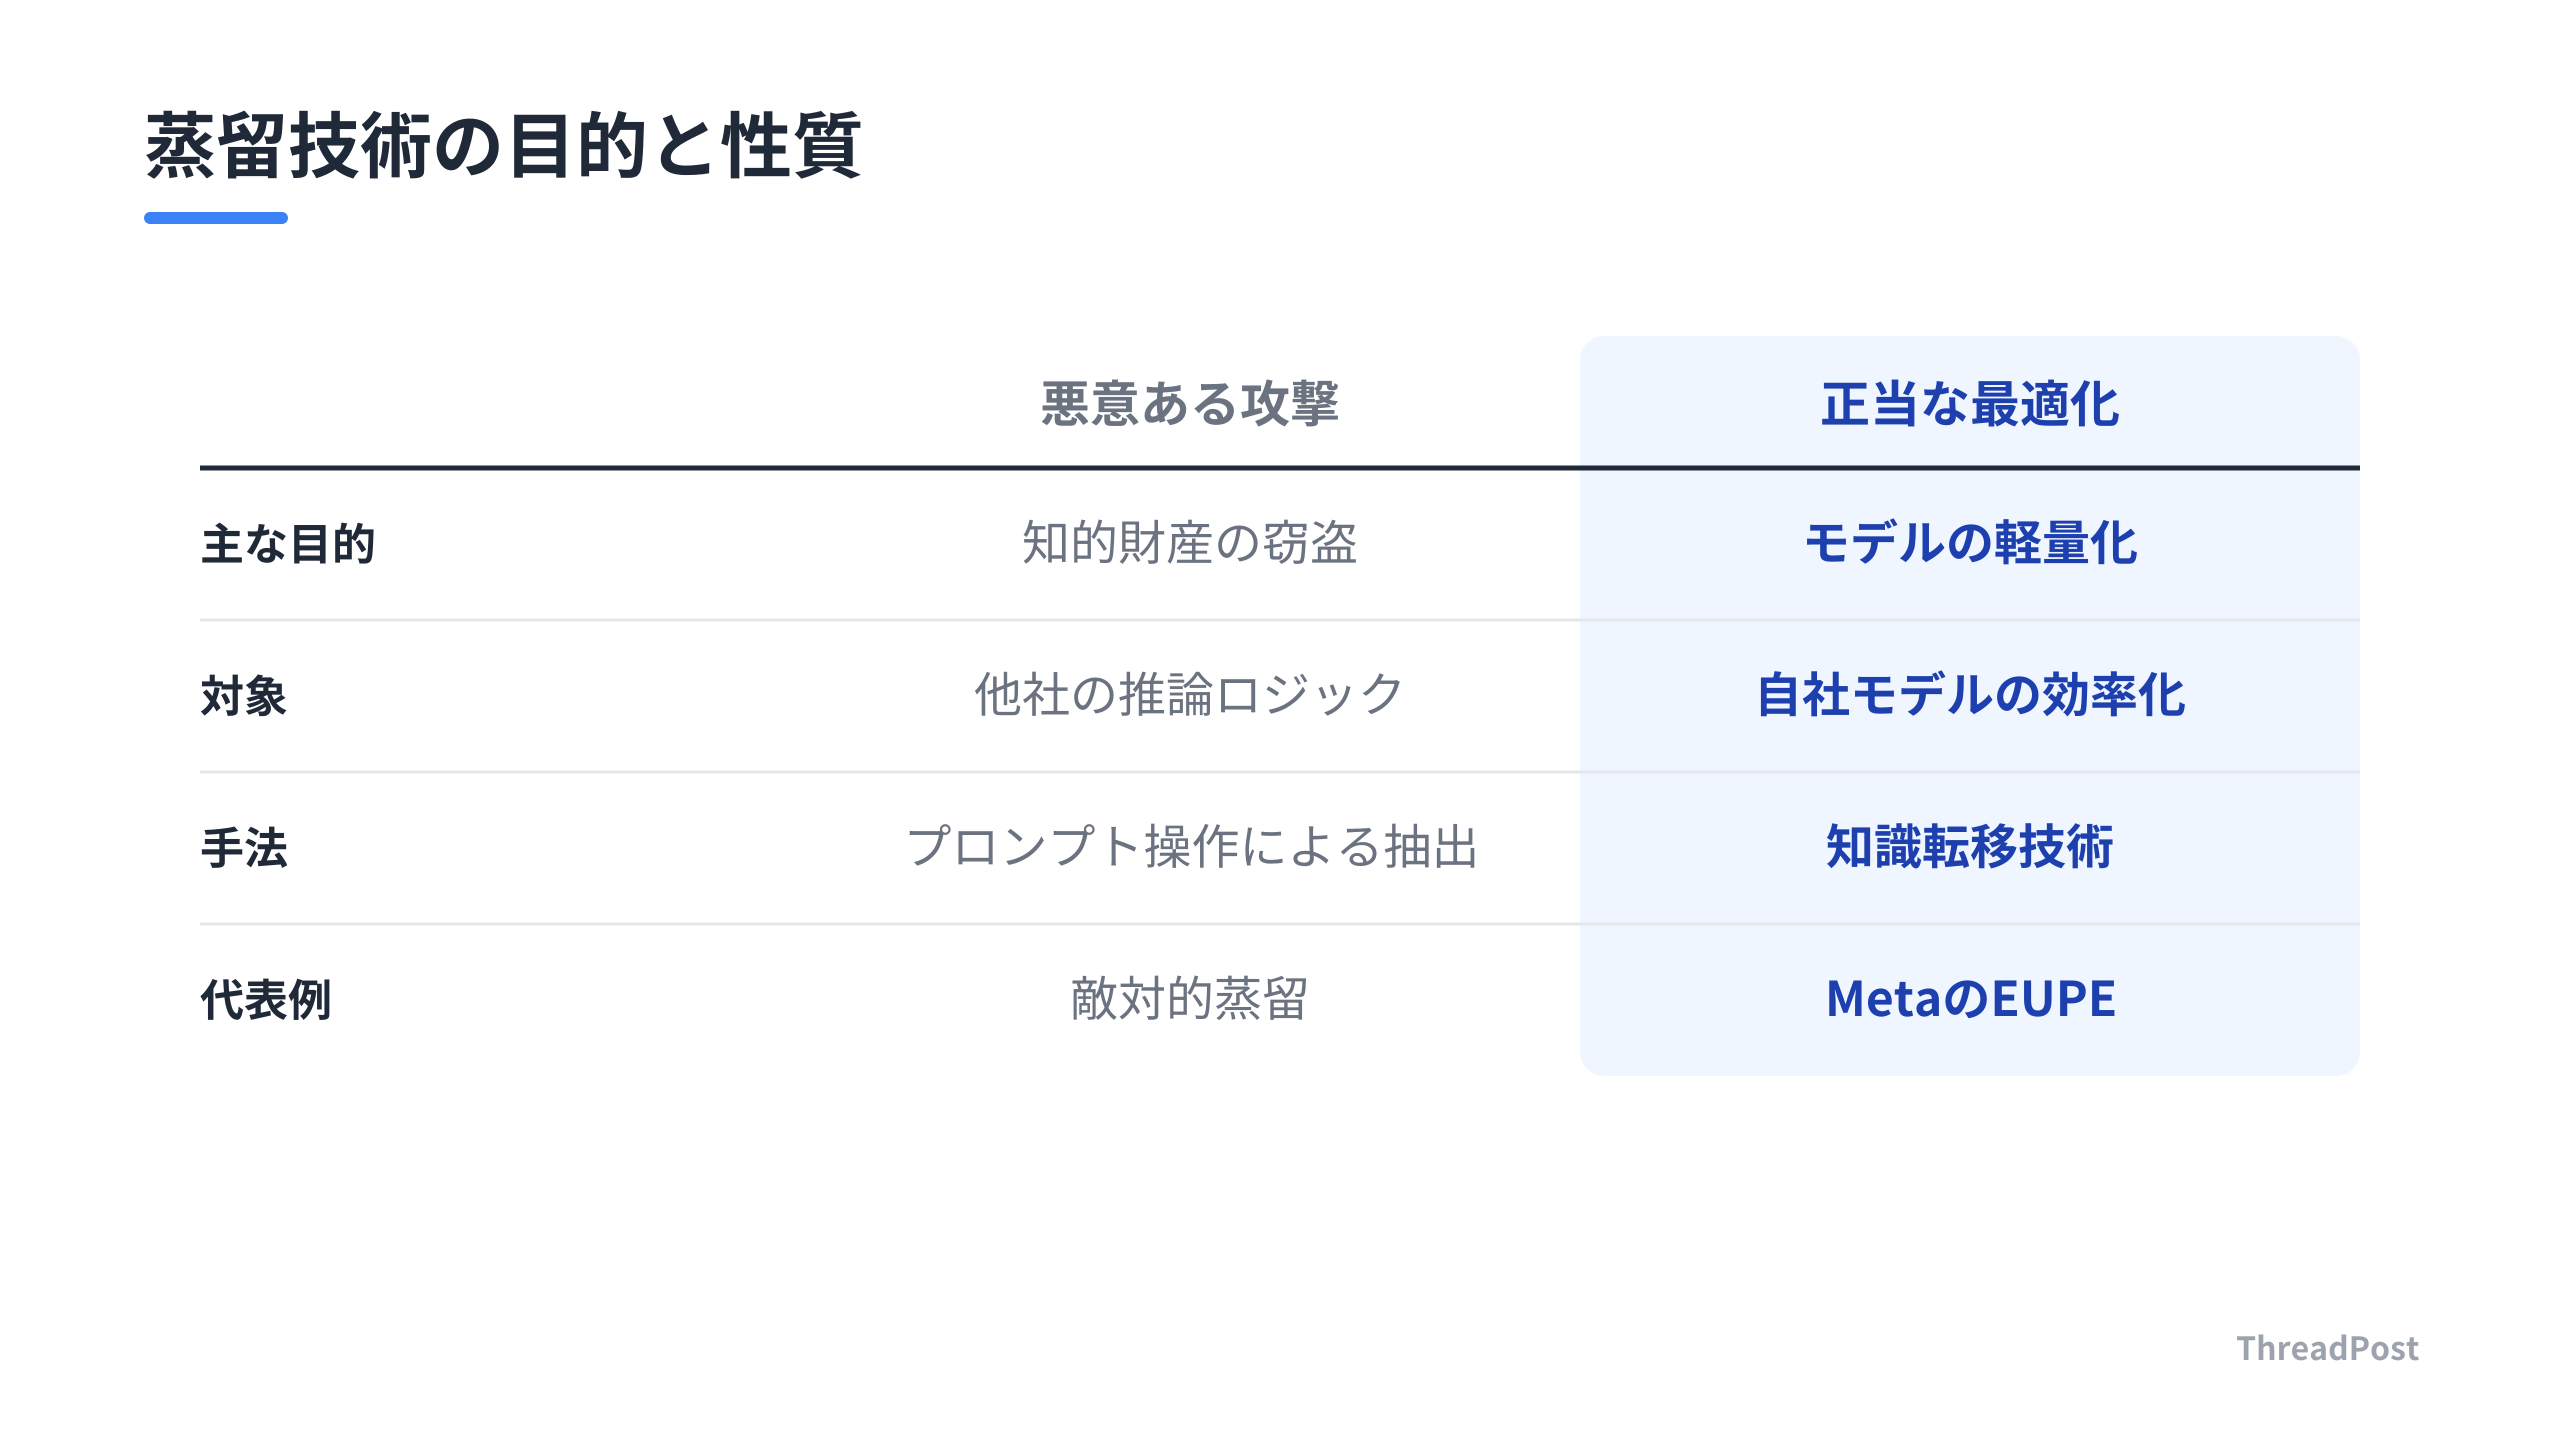
技術的には「モデルを効率化するための知識移転」と「モデルの性能を盗むための攻撃」は紙一重だ。今回の事案は、AI開発者が自社のモデルを守るために、内部推論の透明性とセキュリティのバランスをどう取るかという問いを突きつけている。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
蒸留攻撃とモデル最適化の境界線
「蒸留」は大規模モデルの推論能力を維持しつつ、エッジデバイスで動くサイズまで削ぎ落とす最適化技術だ。今回のOpenAIの事例は、この技術が逆のベクトルでは他社の知能を吸い上げるストローにもなり得ることを示した。
1万6000件のリクエストが特定のパターンで叩き込まれ、4000人以上のユーザーが関与した。組織的な攻撃者が、ターゲットモデルの思考の痕跡を抽出し、そのロジックを自前のモデルに焼き付けようとした。モデルの性能を民主化する技術が、知的財産の窃盗を容易にしている。
開発者目線で恐ろしいのは、モデルの思考プロセスそのものが攻撃対象になった点だ。APIを叩いて最終的な回答を得るだけならブラックボックスとして扱える。しかし、内部で生成された保護された推論結果が、暗号化の不備やクロスモデル間の相互作用を通じて外部に漏れる隙があった。
Claude Codeでコードを生成させると、モデルが思考プロセスを垂れ流すことがある。あれがそのまま攻撃の標的になると考えると怖い。APIの出力をフィルタリングするだけでなく、推論ロジックそのものを機密情報として扱うアーキテクチャが必要だ。
今回の事案は、開発者がプロダクトを設計する際、推論ロジックは隠されているという前提に頼れないことを示す。攻撃者は、異なる会話間でモデルを仲介させ、隠された推論を可視化する手法を採った。これはAPIの利用制限をかけるだけでは防ぎきれない、プロンプトエンジニアリングの悪用による脆弱性だ。
特に、RAGやエージェントシステムを構築している開発者はリスクを認識する。自社のモデルが思考の連鎖を出力する際、そのプロセスに機密情報や独自の推論ロジックが含まれていないか、外部から抽出される隙がないかを精査する。
1万5000人以上のユーザーが関与した今回の攻撃キャンペーンは、プロンプトパターンの検知と、モデル間の相互作用に対する動的な防御層の構築によって遮断された。これはAIエージェントを開発する開発者にとって、実装すべき標準的なセキュリティ要件になる。
ThreadPostの開発でAIを活用する際も、単に便利だからで済ませるフェーズは終わった。今後は、自社のAIがどのような推論プロセスを経て回答を導いているかを監視し、そのプロセス自体が盗まれてもいいものかを問い直す。AIの性能を追い求めるだけでなく、その知能を守るためのアーキテクチャがSaaS開発における差別化要因になる。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
開発現場に求められる防御の「多層化」
今回の蒸留攻撃の事例は、APIを利用する側にとっても他人事ではない。外部AIモデルを組み込んだSaaSを運用しているなら、意識すべきポイントがある。
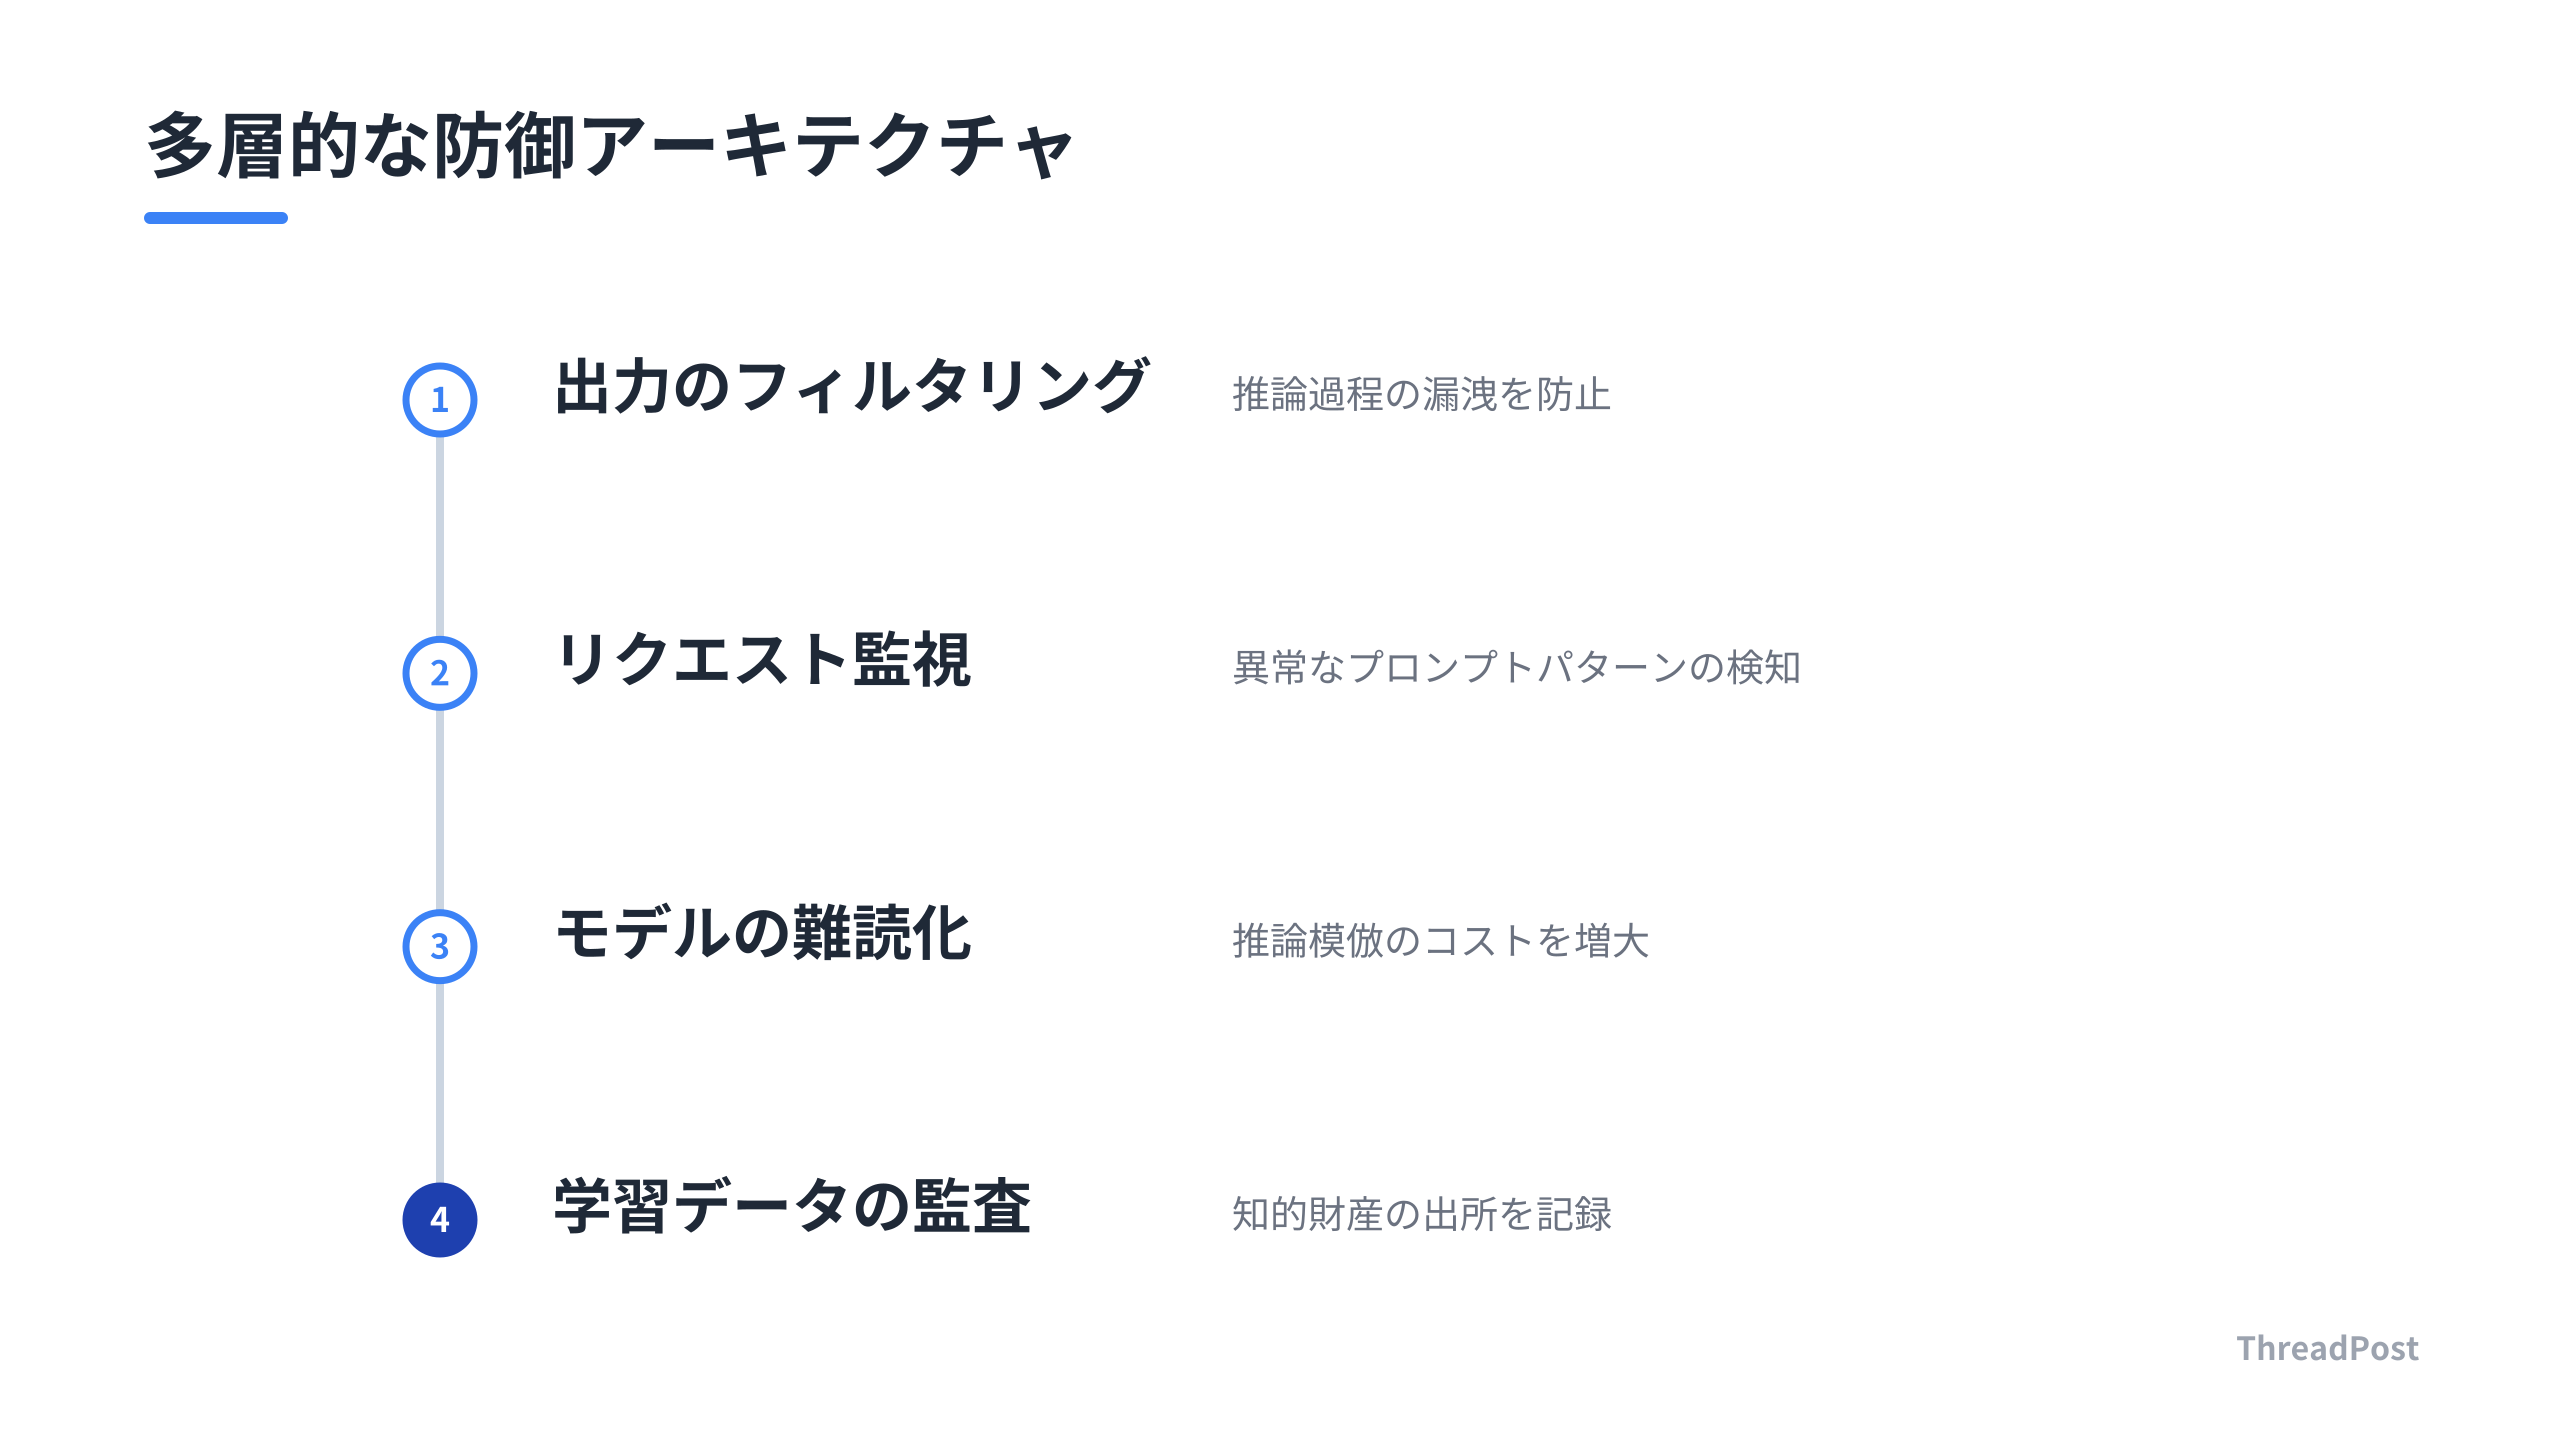
まず、出力データのフィルタリングを厳格にする。モデルが推論過程や中間出力を安易に吐き出さないよう、システムプロンプトや出力バリデーションを再設計する。推論の思考プロセスそのものがビジネスのコア資産である場合、それを外部から抽出可能な形式で出力させるのは、自ら設計図を公開しているのと同じだ。
次に、APIリクエストパターンの監視を強化する。今回の攻撃では、数千人規模のユーザーを経由して、断片的なプロンプトから推論ロジックを再構築する手法がとられた。単発のリクエストなら異常に見えなくても、ユーザー全体で集計したときに特定のパターンが浮かび上がるなら、それは攻撃の予兆だ。APIの利用状況をログとして残すだけでなく、異常なプロンプトの連続を検知する軽量な監視ロジックを実装する。
Claude Codeでコード生成させていると、なぜそのコードにしたかの思考ログまで欲しくなる。あれも出しすぎると攻撃のヒントになる。便利さとセキュリティのトレードオフを毎日考えている。
また、モデルの「難読化」についても知識として持つ。推論結果をそのまま返すのではなく、一度中間表現を挟んだり、回答のフォーマットを意図的に複雑化させたりすることで、攻撃者が推論プロセスを模倣するコストを跳ね上げる。これは完璧な防御ではないが、攻撃の手間を増やすことで、低コストで盗み出せる標的からは外れることができる。
最後に、「学習データ」の透明性への意識だ。正当なモデル軽量化を行う際、他社のモデルから蒸留したデータが混入していないか、ライセンス的に問題ないデータセットを使用しているかを明確に記録する。将来的に、AIモデルの知的財産の出所が問われる監査が一般的になったとき、このドキュメントが自分を守る盾になる。
AIを活用した開発は、モデルをどう使うかからモデルの知能をどう守るかというフェーズに移行した。Claude Codeのような強力なツールを使いこなす開発者にとって、実装スピードと同じくらい、こうしたセキュリティの守りの設計がプロダクトの寿命を左右する。
 あわせて読みたい【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録 →
よくある質問
蒸留攻撃とは具体的に何ですか?
ターゲットとなる高性能なAIモデルに対し、特定のプロンプトを投げ続けることで、そのモデルが回答を導き出すまでの思考プロセスや内部的な推論の痕跡を外部に出力させる手法です。攻撃者はターゲットの推論ロジックを模倣した別のモデルを安価に作成したり、安全ガードレールを回避したコピーモデルを構築したりすることが可能になります。
正当なモデル蒸留と攻撃の違いは何ですか?
モデルの所有者が、自身のプロダクトを軽量化・高速化するために、教師モデルの知識を生徒モデルに転移させるプロセスは正当な蒸留です。一方で、他社が構築したモデルの内部情報を、不正なプロンプト操作を通じて盗み出す行為が攻撃としての蒸留です。技術的な手法は似ていますが、目的が自社資産の最適化か他社資産の窃取かという点で、開発者としての倫理と法的な境界線が分かれます。
開発者はAPIを利用する際に何を気をつけるべきですか?
APIを通じてモデルを呼び出す際、入力データに機密性の高い推論ロジックや未公開のプロンプトが含まれていないかを常に監視してください。モデルからの出力結果が蒸留の種にならないよう、必要に応じて回答のフォーマットを意図的に加工したり、出力のバリエーションを制限したりする対策が有効です。自社でモデルを公開する側であれば、異常なリクエストパターンを検知するレート制限を設けるなど、多層的な防御を設計してください。
まとめ
モデルの蒸留は、軽量化という技術革新の側面と、推論プロセスの窃取というセキュリティリスクの両面を持つ。OpenAIが直面した大規模な攻撃事例は、APIを利用する開発者にとっても他人事ではない。
性能の民主化と知的財産の保護の境界線は、今後さらに曖昧になる。Claude Codeのような自律型エージェントを活用する際も、推論プロセスをどう守り、安全に運用するかという視点は必須のスキルだ。技術の進化を追うだけでなく、その裏側にある防御の仕組みまで理解しておくことが、これからのAI開発を生き抜く鍵になる。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
