


AIが突然わけのわからない回答を出し始める「ポンコツ化」。開発者なら一度は頭を抱える現象だ。
OpenAIが過去6ヶ月で観測された6件の不整合事例と、その報告フレームワークを公開した。AIの異常挙動を可視化して制御する仕組みだ。
Anthropicも特定領域でのセーフガード運用を変更した。現在のAI開発はモデルの不整合をログ化し調律するフェーズにある。
僕もClaude Codeでプロダクトを開発している。この視点がないとシステムは破綻する。AIのポンコツ化を防ぎ、性能を引き出す設計論を整理した。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
AIの異常挙動を可視化するOpenAIの動き
OpenAIが公式にモデル不整合(Model Misalignment)の報告フレームワークを発表した。
2026年9月、OpenAIはモデルが意図から外れた挙動や危険な出力を示した事例を追跡し、開示するための枠組みを提示した。過去6ヶ月間で観測された6件の不整合事例についての調査レポートも公開されている。
従来、異常挙動の情報は新モデル公開時のシステムカードや論文で扱われていた。今回の枠組みでは、原因が特定できていない段階であっても、観察された不整合を迅速に開示する方針だ。
モデルの高度化に伴い、従来の安全フィルターでは捉えきれない予期せぬ出力が発生している。業界全体で不整合のメカニズムを共有し、評価基準を標準化することが目的だ。
 あわせて読みたいClaude Codeの使い方完全ガイド|インストールから実践まで2年運用の開発者が解説 →
Anthropicによる専門領域のセーフガード運用
Anthropicはセーフガードの運用における転換を発表した。
ライフサイエンス検証プログラム(LSVP)は、審査をクリアした研究機関や開発チームに対して、通常の安全フィルターでブロックされがちな専門タスクの制限を緩和する仕組みだ。
対象にはClaude OpusやClaude Sonnetが含まれる。権限は年間更新の標準利用(Standard Use)と、6ヶ月ごとに更新が必要なハイリスク利用(High-risk Use)の2種類に分かれている。
創薬や臨床開発といった高度なバイオ研究において、過度なセーフガードが開発の足かせになる問題を解決する狙いだ。
しんたろー:
OpenAIがポンコツ挙動の公開フォーマットを作り、Anthropicは専門家向けにプロテクトを外す仕組みを作った。Claude Codeでコードを書いていると、モデルが急に変な回答を出した時に「これバグか?プロンプトの問題か?」と悩む時間が長い。挙動の開示と権限分離の流れは助かる。
AIが的外れな回答を繰り返す現象は、モデルの限界だけでなく、プロンプトに含まれる曖昧さや指示の衝突が演算に伝播しているケースが多い。
現在AI業界では、透明性の確保による問題の可視化、ユーザーの専門性に応じた制御の緩和、開発者側での対話の調律という3つの軸で対策が進んでいる。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
セーフガードの緩和と可視化が変えるAI開発のリアル
OpenAIが不整合を透明化する枠組みを提示し、Anthropicは特定の専門領域に対してセーフガードを緩和するプログラムを開始した。
両社はモデルの不具合や限界を隠さない方針をとっている。
OpenAIは、モデルが予期せぬ挙動を示した事例を外部に公表し、業界全体でアライメントの基準を作ろうとしている。
これによってモデルの挙動不審が単個体の不具合なのか、モデル全体の構造的な課題なのかをデータで判断できる。
Anthropicのアプローチは、厳格な審査を通った専門チームに対して、通常はブロックされる生物学や創薬などの領域でセーフガードを動的に解除するものだ。
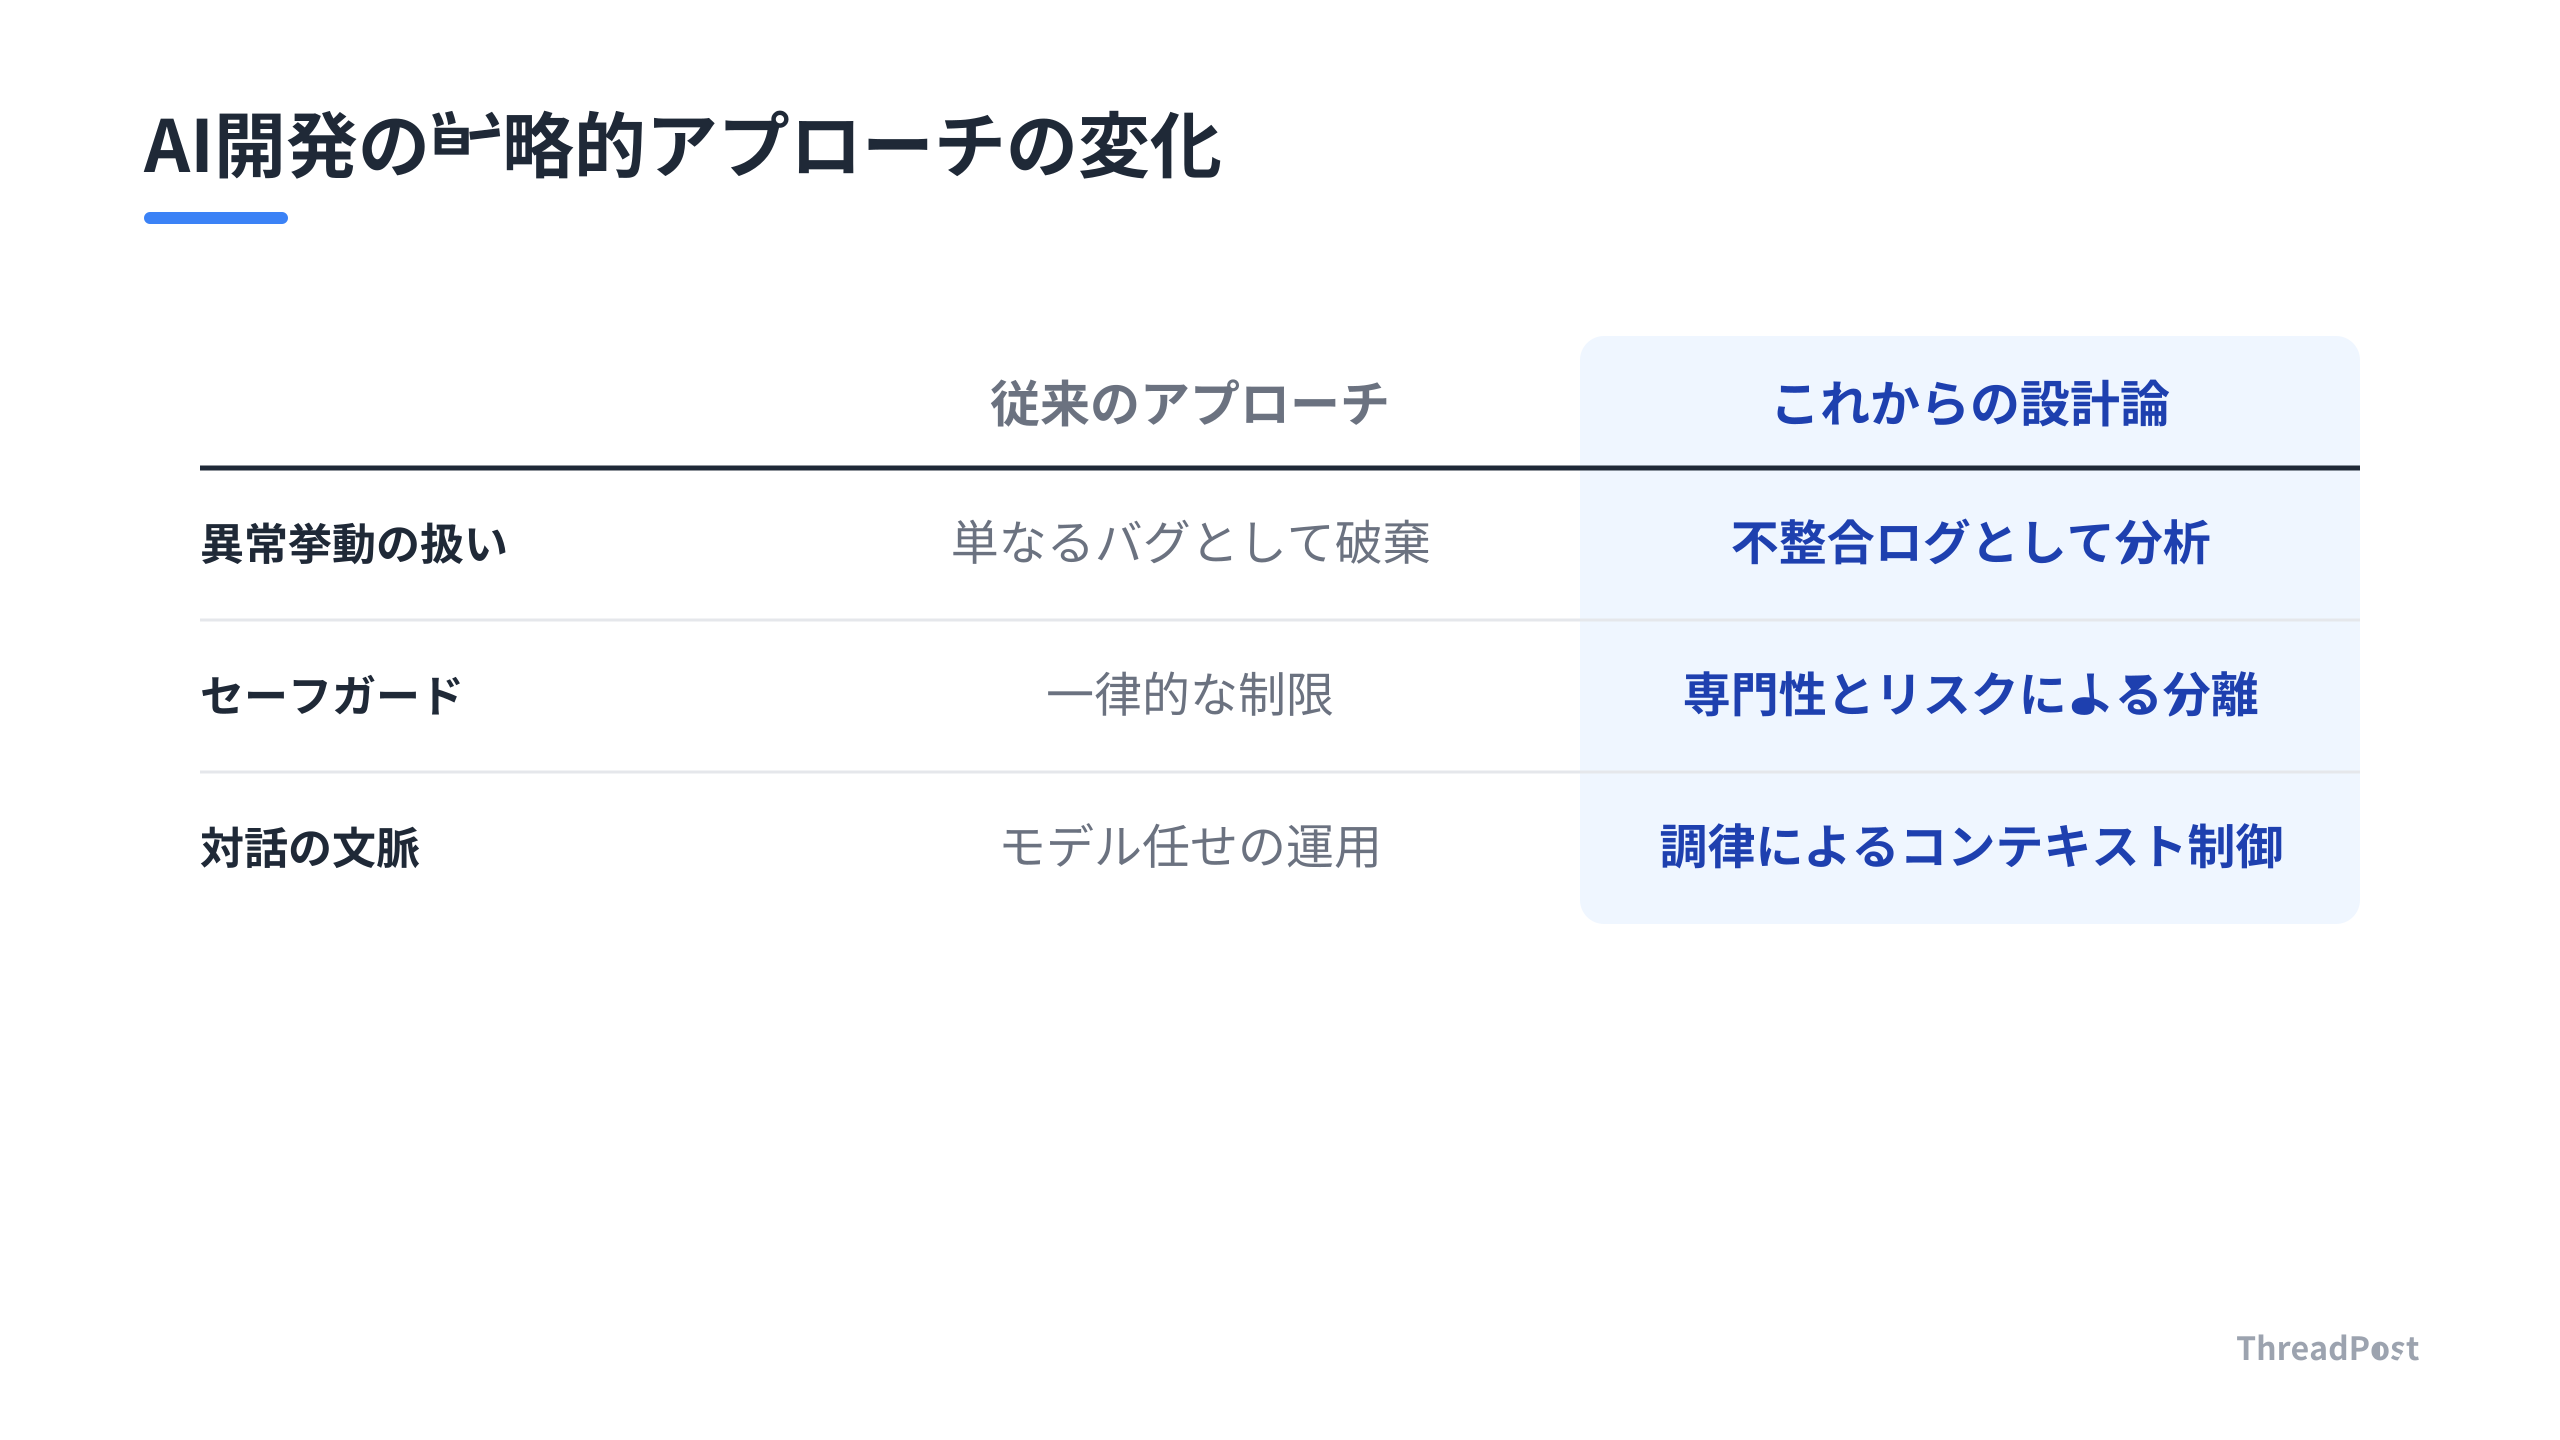
安全ガードを「一律にかける」のではなく、ユーザーの専門性とリスクに応じて動的に切り替える時代が来ている。
Claude Codeに複雑なコード生成を任せると、急にセーフガードが反応して処理が止まったり、見当違いな修正案を出してくることがある。モデルの不整合をログとして蓄積して、プロンプトの文脈で正しく「調律」するアプローチは、1人でSaaSを開発している人間にとって死活問題だ。
AIが的外れな回答を繰り返す時、僕らは「AIの性能が低い」と結論づけがちだ。しかし、その多くはプロンプトに含まれる曖昧な指示や、文脈の衝突によってAI内部の演算にノイズが生じていることが原因だ。
AIが誤った出力を重ねている時に、一度ユーザー側から責任範囲を明確にするプロンプトを挟むだけで、AIが正常な思考プロセスを取り戻す事例がある。
挨拶によって対話のコンテキストを初期化したり、あえて対話を一度休止させて演算のパニックを解消させるといった対話を調律する技術は、合理的なデバッグ手法だ。
アプリやSaaSにおいて、AIの挙動を安定させるためのアプローチは3つの層に分かれている。
1つ目は、プラットフォーム側が公開する不整合の情報を把握し、モデル固有の癖や弱点を理解することだ。
2つ目は、Anthropicのような権限分離の考え方を取り入れ、専門性の高いタスクと一般的なタスクでAIの自由度を設計し分けることだ。
3つ目は、ユーザーとAIの間の対話ログを監視し、AIが混乱に陥った際に自動で文脈をリセット・補正するシステムをアプリ側で組み込むことだ。
Claude CodeなどのAIエージェントを業務に組み込む場合、セーフガードによるエラーを単なる例外処理として捨てるのではなく、適切にログを取って分析する仕組みが欠かせない。
モデルの不整合を前提として受け入れ、それをシステムと対話の両面から調律できるかどうかが、これからのAIエンジニアの腕の見せ所だ。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
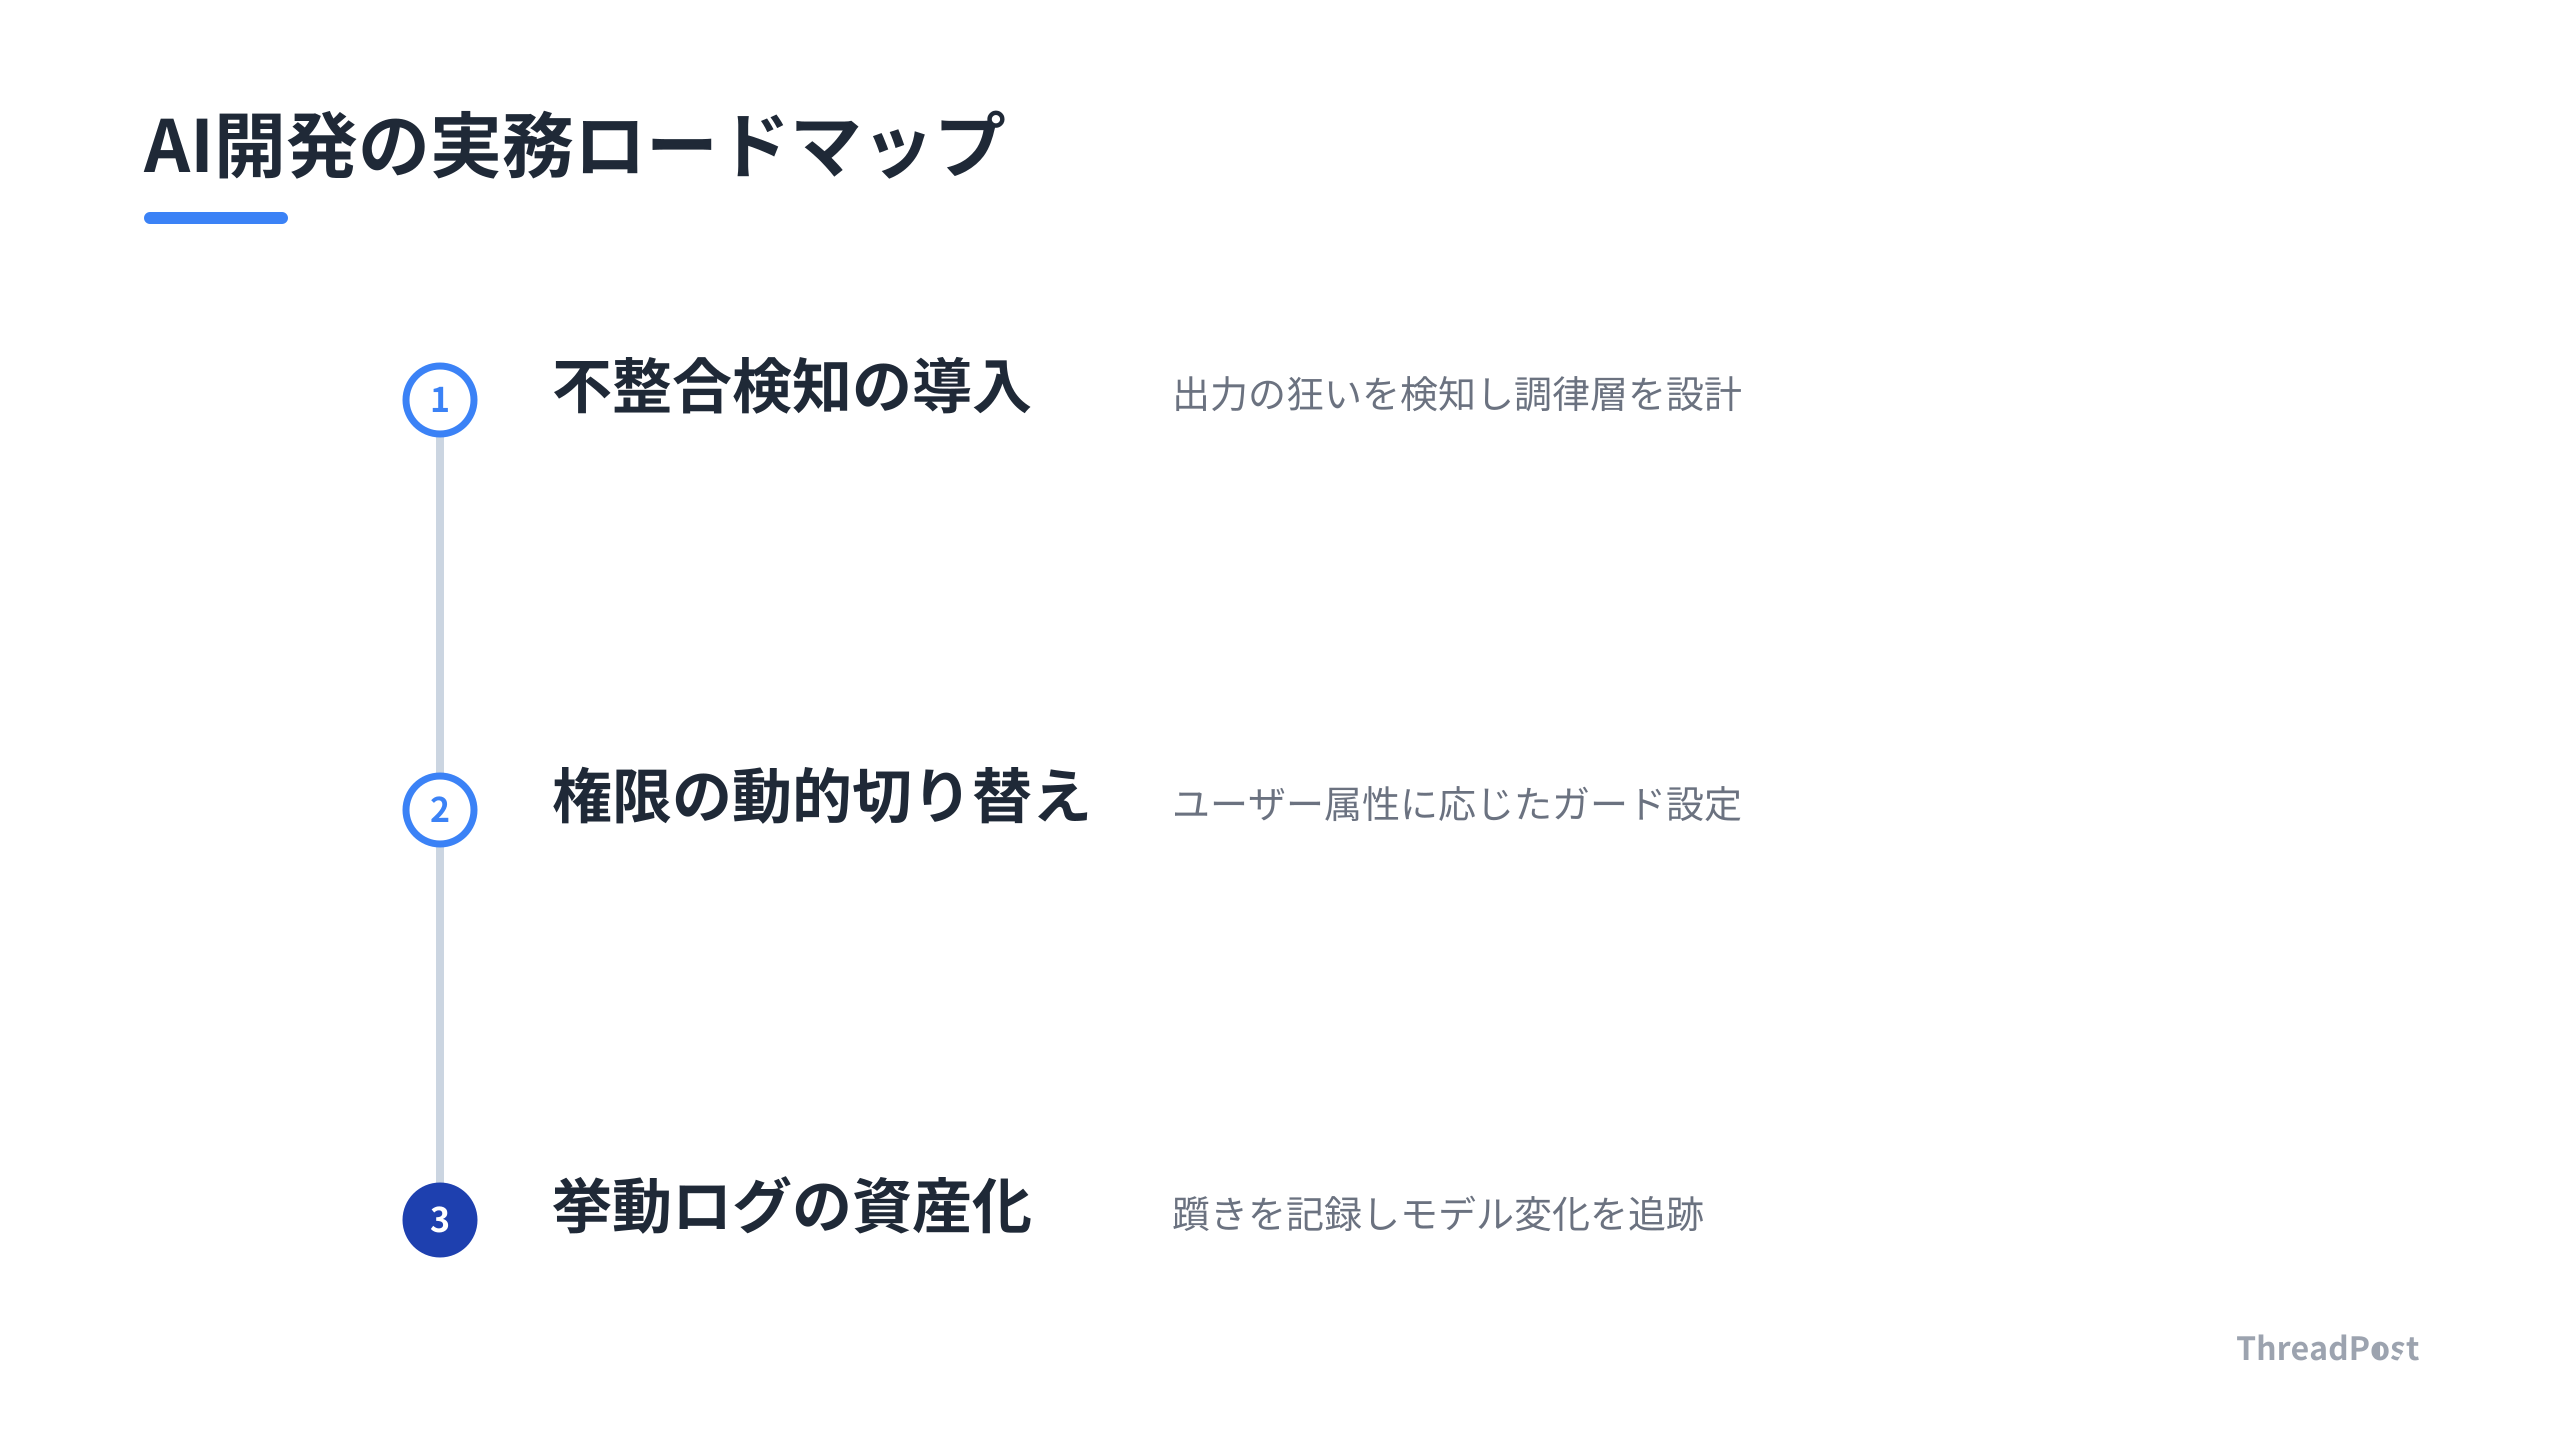
明日から僕らのAI開発で変わる3つの実務アクション
海外のプラットフォームや専門家の動向を踏まえると、AIアプリ開発の実務には明確な方向性の変化が生まれる。
モデルの不整合や挙動のブレを前提としたシステム設計へとシフトしなければならない。
明日からの開発で意識すべき3つの実務アクションが存在する。
1. エラーハンドリングを「不整合検知」へ拡張する
これまでのAPI連携開発では、HTTP 500やタイムアウトなどの明確なシステムエラーだけをキャッチすれば十分だった。
これからはモデルが「もっともらしい嘘」を出力したり、対話の泥沼にハマって同じ回答を繰り返したりする出力の狂いを検知するロジックが必須になる。
ユーザーから曖昧な入力が入った際にAIがパニックを起こす現象は、コードのバグではなく文脈の混乱だ。
アプリ側で対話の文脈を一度リセットする判定処理を入れたり、コンテキストを再構成するために処理時間を遅らせる1秒の遅延を挟んだりする「調律層」の設計が求められる。
2. ドメイン特化機能における権限とセーフガードの切り分け
専門性の高い領域でAIを活用する場合、一般向けのモデルと厳格な身元確認を経たモデルで、セーフガードの挙動が全く異なることを前提にする必要がある。
例えば、専門的なバイオ関連テキストを処理する際、通常APIでは危険検知の判定によってブロックされるリクエストが、専門権限の適用下では成功率100%で処理されるといった差が生じる。
自社サービスや顧客向けツールを開発する際、単一のモデル設定で押し通すのはリスクが大きい。
ユーザーの属性やユースケースに応じて、呼び出すモデルの権限レベルや判定フィルターのパラメータを動的に切り替えるアーキテクチャへの移行が必要だ。
Claude Codeに長文の仕様書を渡してリファクタリングさせてると、途中で急に「セキュリティ上の理由でこの処理は書けません」と止まることがある。コードの文脈を誤解してセーフガードが過剰反応しているのだろうが、開発者側で対話をうまく誘導してあげないと作業が一気にストップするから焦る。
3. AIエージェントの挙動ログを捨てるのをやめる
Claude CodeなどのAIエージェントが生成したコードや対話履歴を、タスクが終わればそのまま捨ててしまいがちだ。
AI開発のトップ企業がモデルの不整合事例を収集して分析し始めているように、開発者自身も「AIがどこで躓いたか」の履歴データを蓄積することが強力な資産になる。
AIが意図と異なる出力をした際のプロンプト構成や直前の文脈をログとして残しておけば、次のモデルアップデート時に挙動がどう変化したかを客観的に比較できる。
モデルの仕様変更によって既存の処理が突然崩れるリスクを最小限に抑えるには、自前でのログ収集と分析が最も確実な防壁になる。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
AIが急に的外れな回答を繰り返す「ポンコツ化」はなぜ起きるの?
モデル自体の能力不足だけが原因ではありません。
プロンプトに含まれる開発者側の焦りや命令の曖昧さが、AI内部の演算処理にノイズとして伝播しているケースが多いです。
返答がおかしくなった時は、一度対話をリセットするか、責任範囲を明確にする補正プロンプトを1文挟むことで、AIの演算パニックを解消して精度を復元できます。
専門領域向けのセーフガード緩和は一般開発者でも利用できますか?
現時点では、厳格な身元確認を通過した専門機関や企業チームに限定されています。
一般の個人開発者がアプリ経由でセーフガードを解除することはできません。
ただし、適切な審査を通過した開発者に対してリスク許容度に応じてガードを動的に緩める仕組みは、今後の業界標準になっていくはずです。
不整合やエラーのログ収集は個人開発の規模でもやる意味がありますか?
めちゃくちゃ意味があります。
AIのモデルアップデートによって、昨日まで動いていたプロンプトや開発ツールの挙動が突然変わるリスクは常に存在するからです。
AIが意図と異なる出力をした際の入力データと異常な出力結果を蓄積しておけば、モデル側の変化かこちらの記述ミスかを一瞬で切り分けられます。
まとめ
OpenAIの不整合報告やAnthropicの権限開放が見せたのは、AIは完璧な計算機ではなく調律しながら付き合うパートナーだという現実だ。
モデルが急にポンコツ化してもバグと嘆くのはもう終わり。AIの癖を読み解いてコントロールする技術こそが、これからの開発者の武器になる。
僕もClaude Codeで開発を爆速化しつつ、日々モデルとの対話を調律中だ。
開発だけじゃなく、SNS運用の仕組み化もAIに任せて自動化していこう。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
