


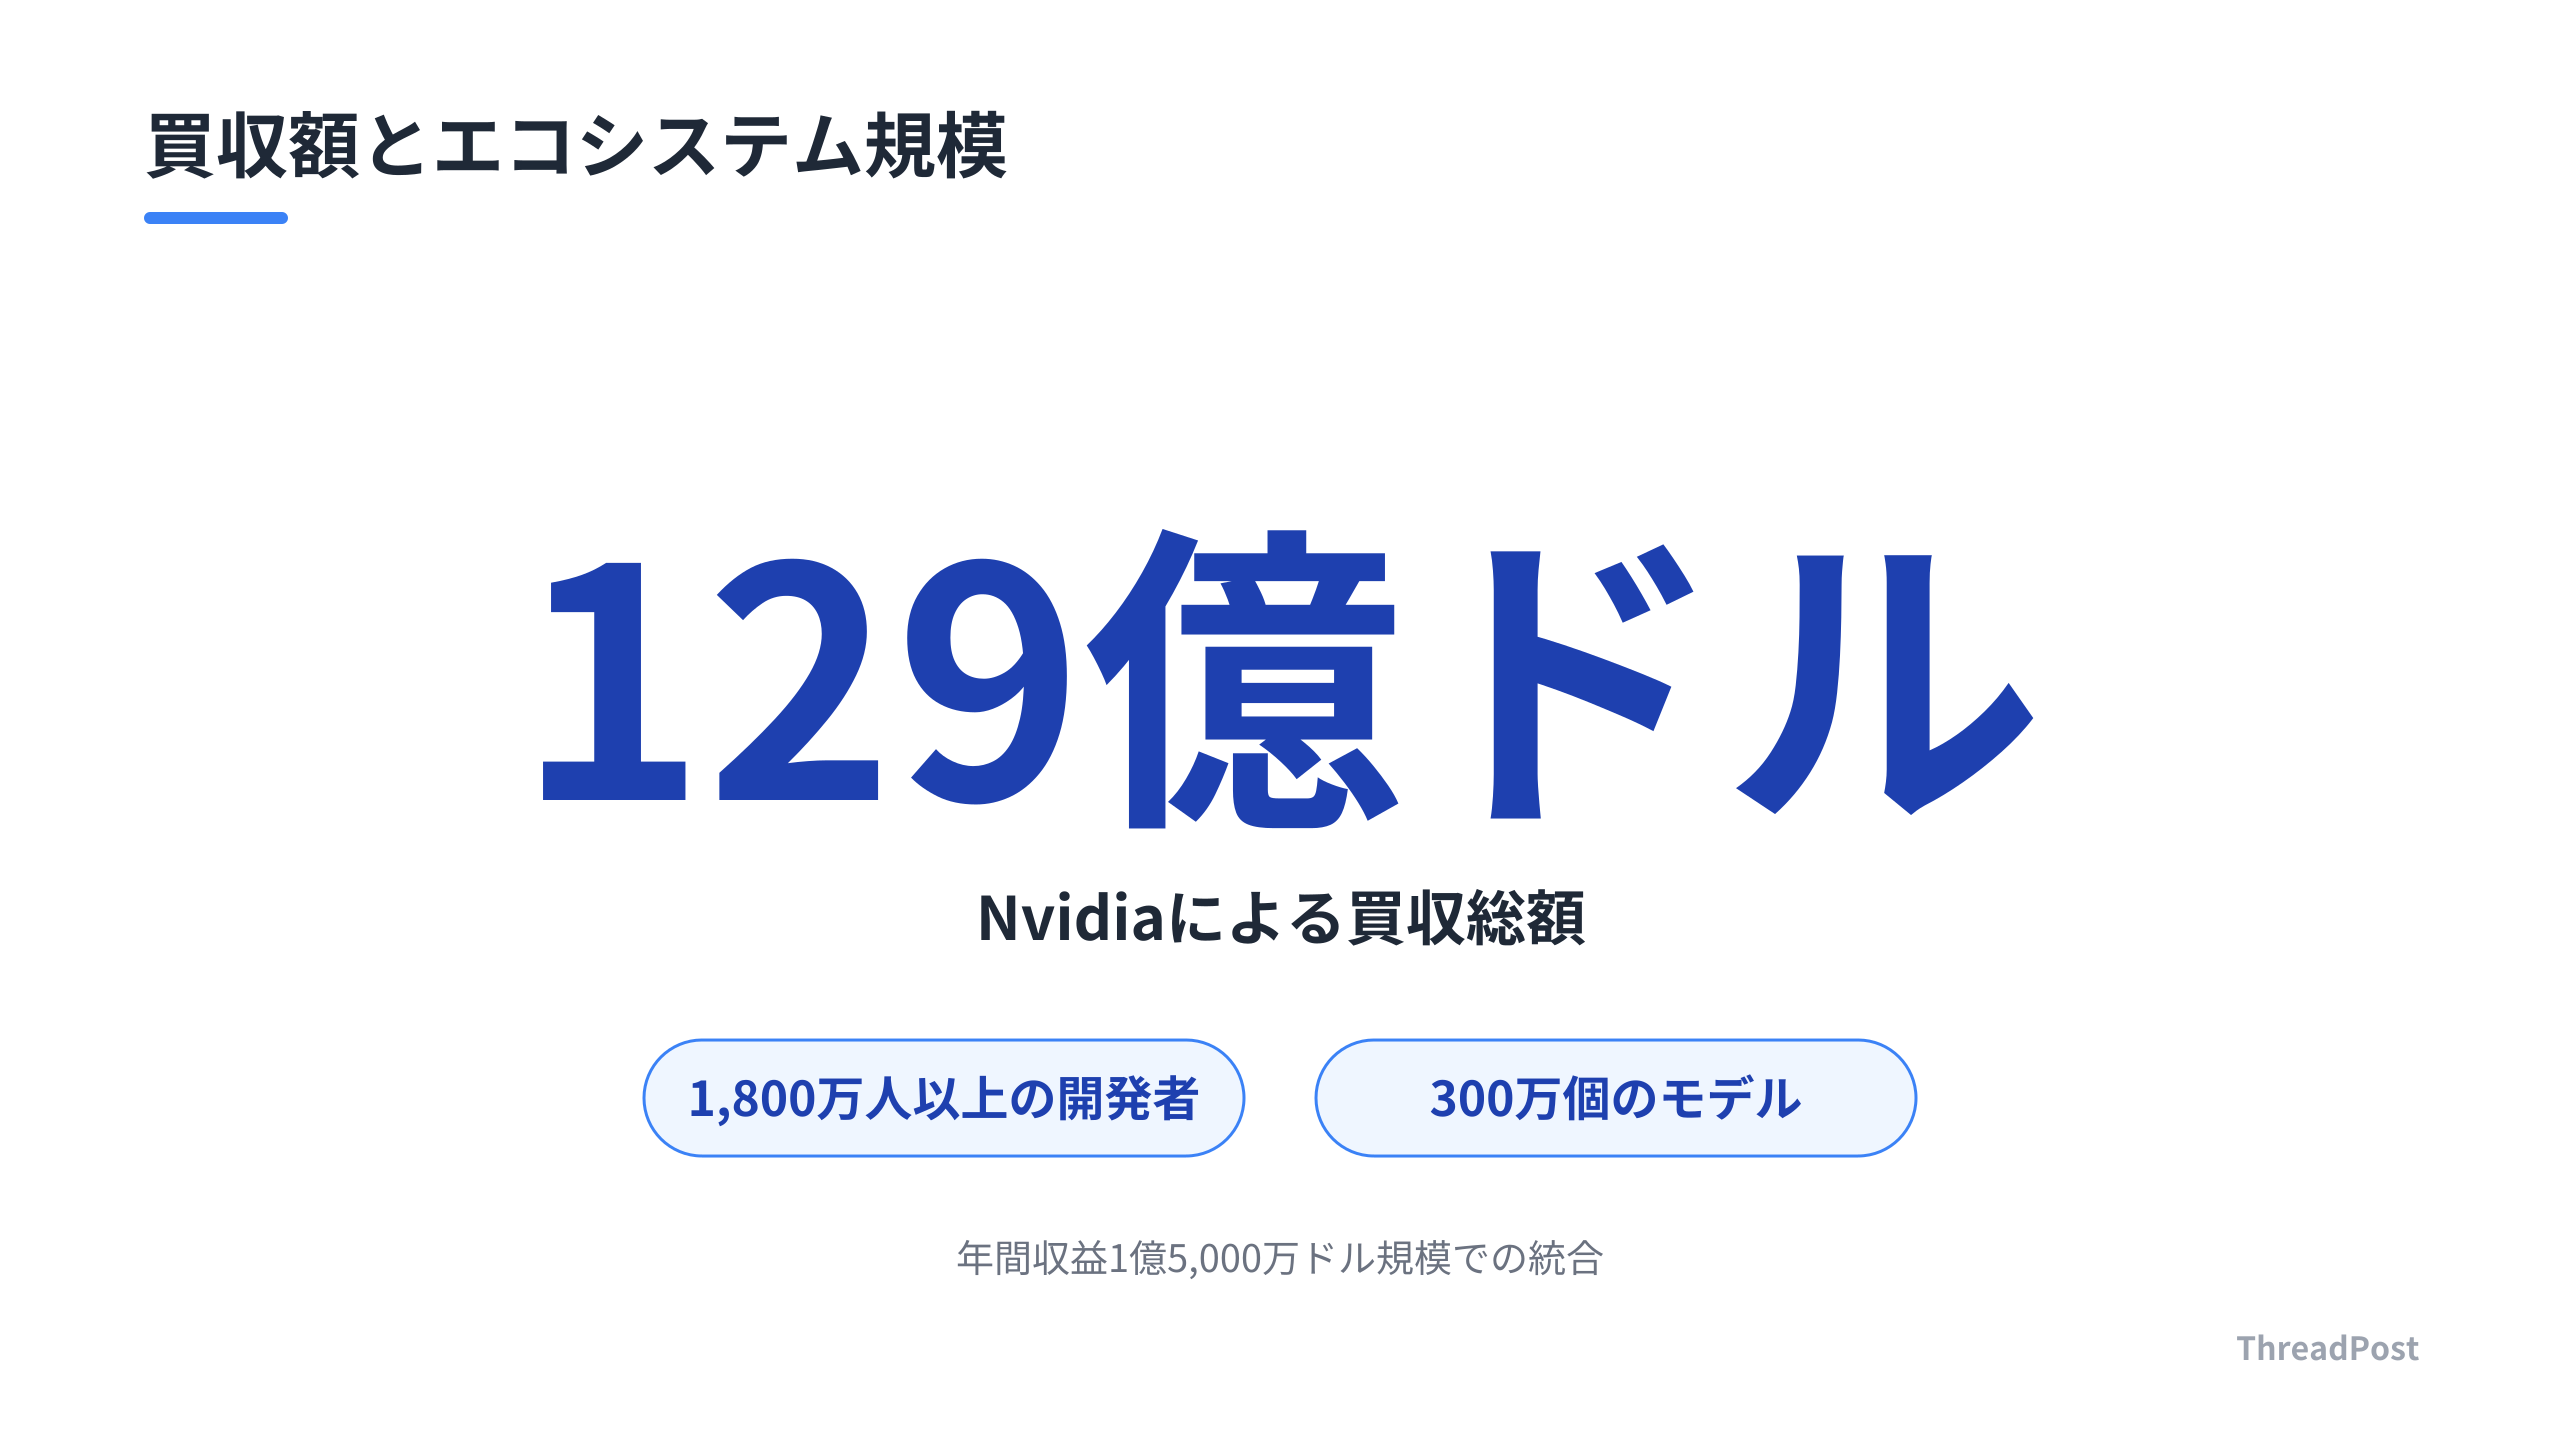
NvidiaによるHugging Faceの買収が確定した。取引額は129億ドルだ。これまで分断されていた「データ探索」と「ハードウェア最適化」の境界線が消滅する。
今後はHugging Face上の巨大なデータセットをストリーミングで読み込み、そのままNvidiaのTransformer EngineでFP8演算まで直結させるフローが標準になる。計算リソースの制約を意識せずに大規模モデルを回せる環境は、開発スピードを大きく変える。
この記事では、今回の買収が開発スタックに与える影響と、技術的な視点から何を変えるべきなのかを深掘りする。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
買収の全貌とエコシステムの統合
買収額は129億ドルだ。1,800万人を超える開発者が利用し、300万個のモデルと50万個のデータセットを抱えるプラットフォームがNvidiaの傘下に入る。
公式発表によると、プラットフォーム自体は今後もオープンな性質を維持する。モデルの選択やフレームワークの自由度は損なわれない方針だ。これまで別個のサービスとして存在していた「データ探索」と「ハードウェア最適化」が、Nvidiaのスタック内で統合される。
Hugging Face上で公開されているモデルやデータセットに対し、NvidiaのTransformer Engineがネイティブで組み込まれる。開発者はモデルのダウンロードからFP8精度での学習・推論までを、シームレスなパイプラインとして実行する。
年間収益は1億5,000万ドル規模に達する。収益化の目処が立ったタイミングでの合流だ。
しんたろー:
129億ドルか。数字が大きすぎて実感が湧かない。Hugging Faceでモデルを落として、CUDAの設定で頭を抱える時間が減るなら歓迎だ。API制限やインフラのボトルネックが解消されるなら、ThreadPostの裏側も楽に動かせるようになる。
今回の合意には、エンタープライズ顧客向けの計算リソース販売も含まれる。NvidiaのGPUインフラとHugging Faceのライブラリがセットで提供されるため、企業は自前で大規模な学習基盤を構築する手間が省ける。
Nvidiaはすでに500個以上のモデルと250個以上のデータセットを公開している。今回の買収は、これらのオープンソース資産を自社のハードウェアに最適化させるための布石だ。
開発者にとっての関心事は、特定のハードウェアへの囲い込みだ。しかし、現状の発表では特定の計算プラットフォームを強要する意図はない。NvidiaのGPU上で動かす際、最も効率的な開発フローが提供されるという位置付けだ。
これまで、データセットのストリーミング解析や混合精度学習のセットアップには多くのボイラープレートコードが必要だった。今後は、これらの処理がNvidiaの提供するライブラリによって自動化される。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
垂直統合がもたらす開発サイクルの最適化
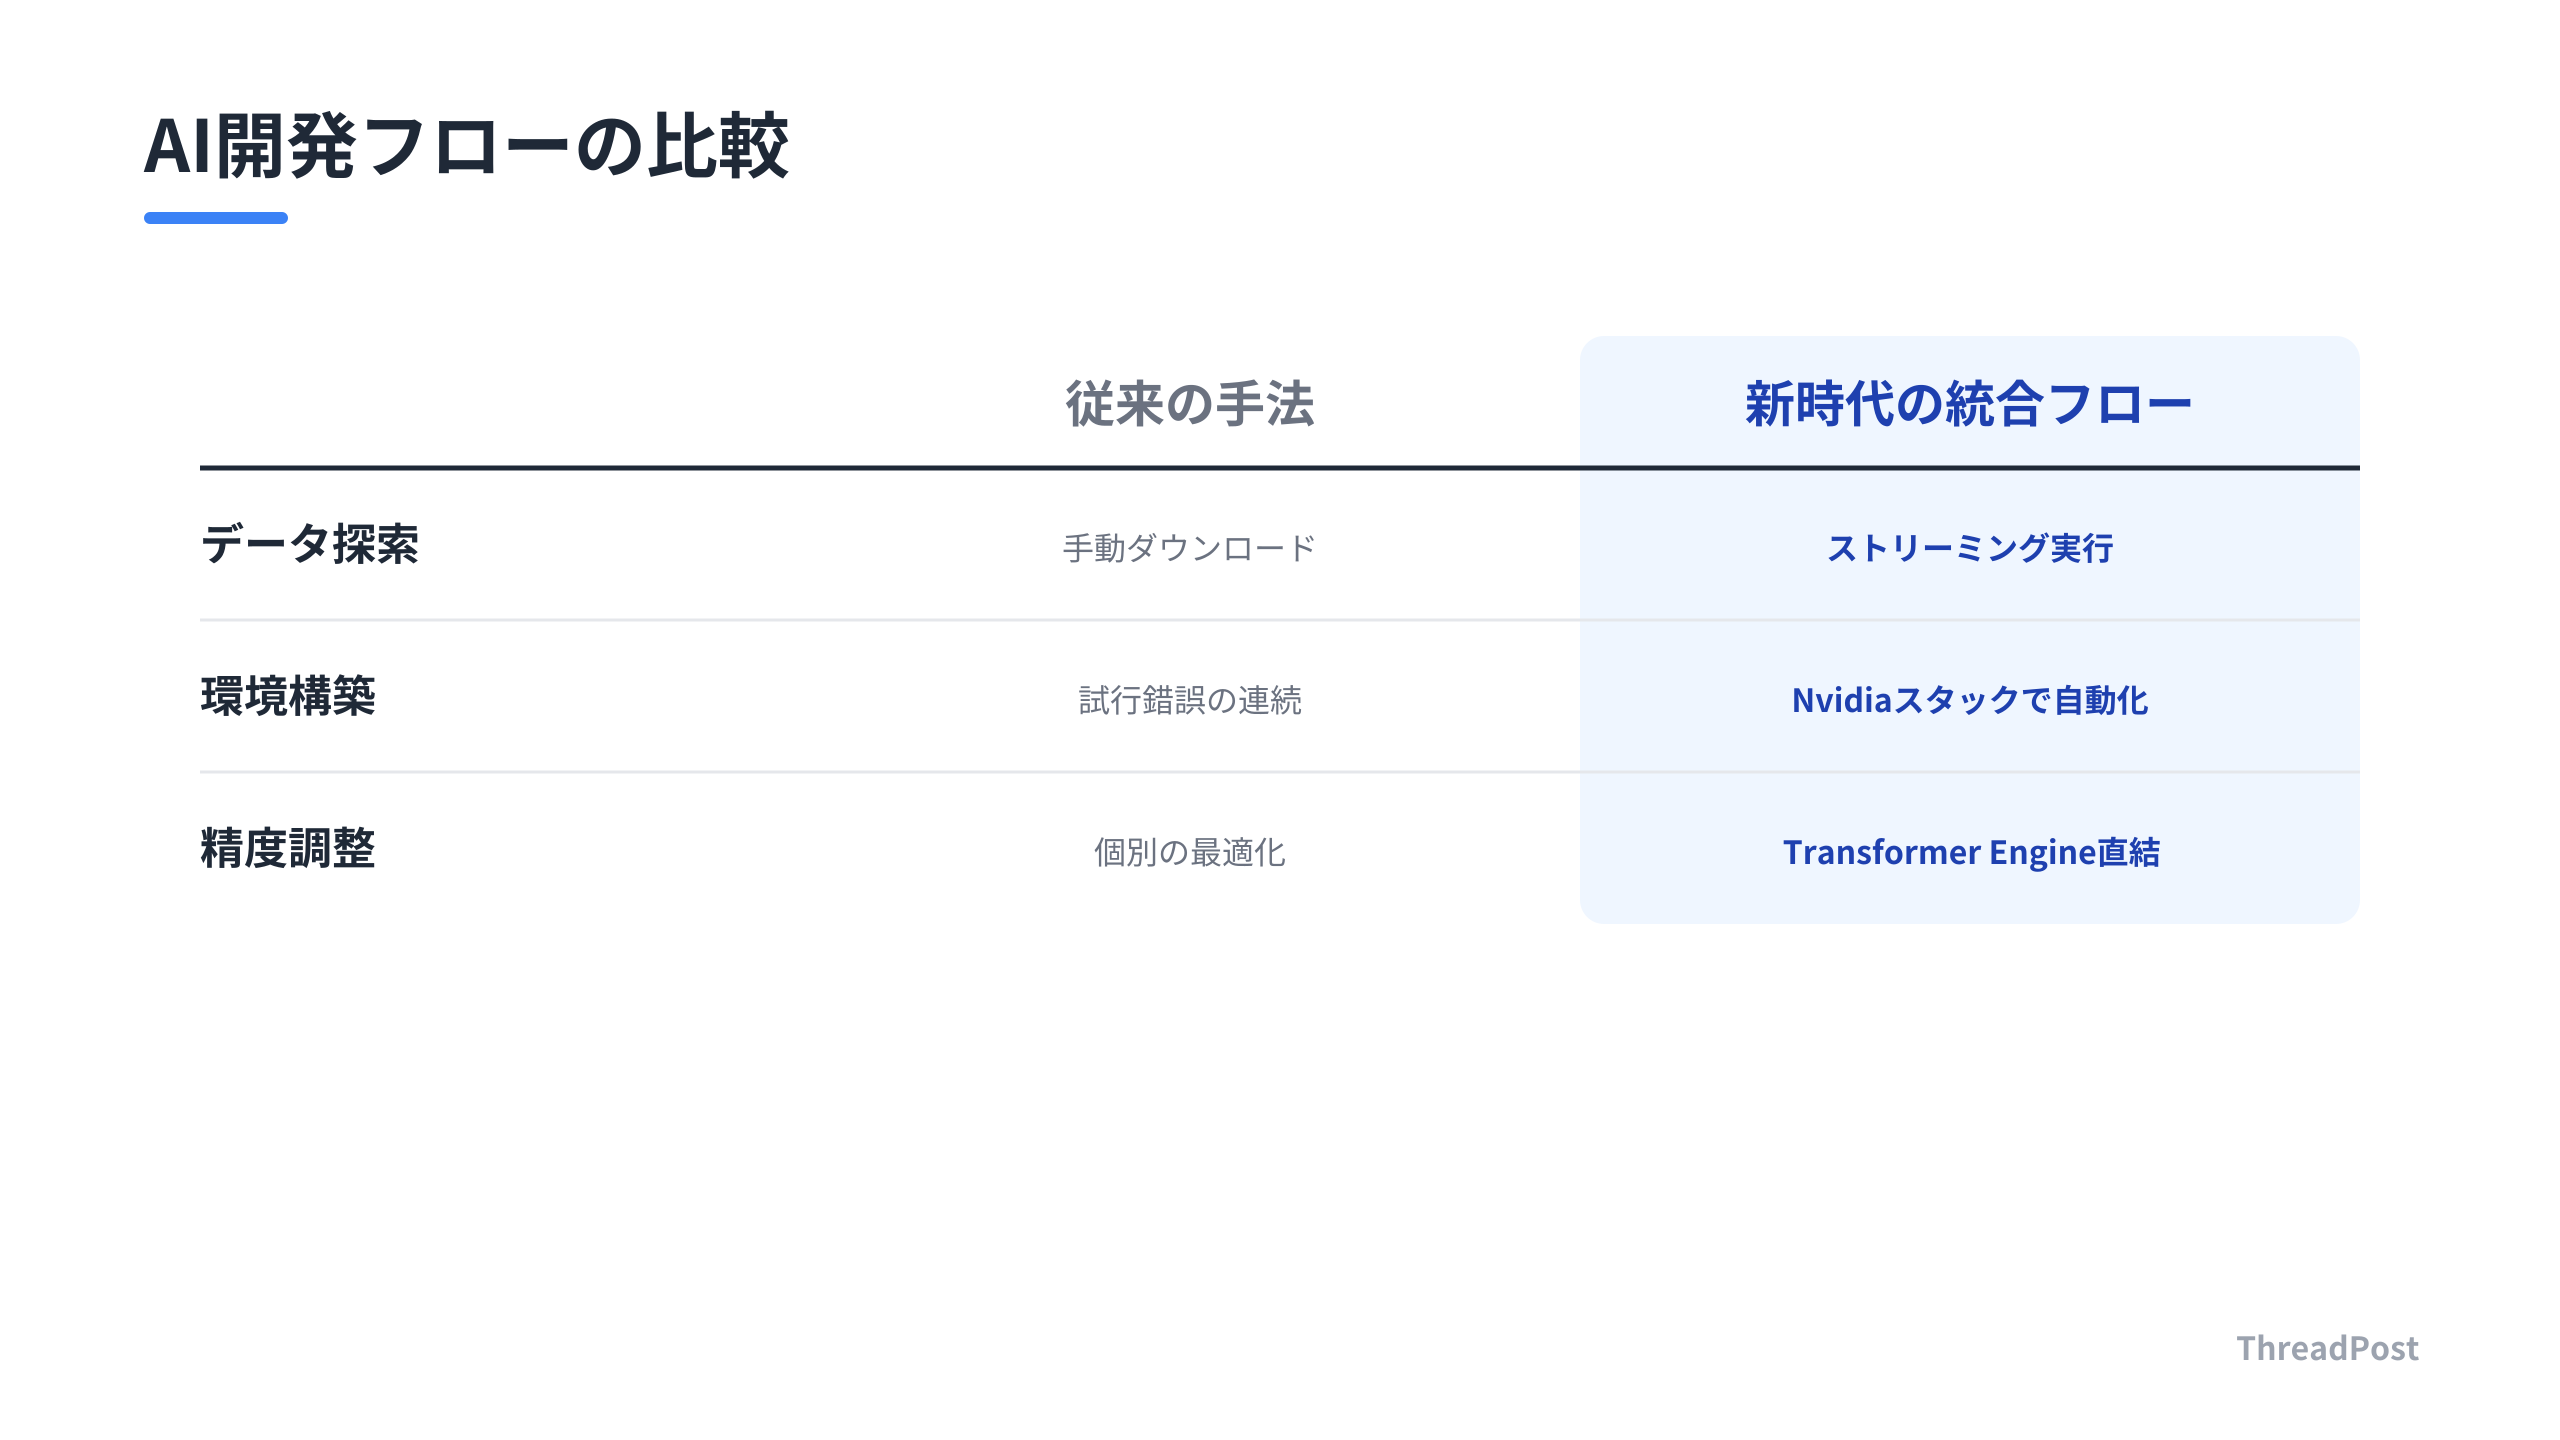
今回の買収のポイントは、Hugging Faceが持つ300万個のモデルライブラリと、NvidiaのTransformer Engineが物理的に直結する点だ。これまでは、データセットの探索とGPU上での最適化は、異なるレイヤーの作業として分断されていた。開発者はHugging Faceでモデルを選び、自前の環境でFP8などの混合精度に調整していた。
この統合により、「データセットのストリーミング実行」から「ハードウェアへの最適化」までが単一のエコシステム内で完結する。1,800万人を超える開発者が利用するプラットフォーム上で、Nvidiaの計算リソースに最適化されたパイプラインが標準化される。
Claude Codeでコードを書いていると、ライブラリの依存関係や型エラーで止まる時間がストレスだ。データセットの読み込みから最適化までがNvidiaのスタックで統一されたら、CLIツールに丸投げできる範囲が広がる。開発速度が一段階上がる気がする。
技術的な重要性は「ストリーミング処理」の進化にある。数ギガバイトあるデータセットをローカルに落とす必要はなくなる。Hugging Faceのデータストリーミング機能とNvidiaのGPUメモリ管理が統合され、巨大なデータをオンデマンドでGPUへ流し込む手法が一般的になる。
業界内では「囲い込み」への懸念も囁かれるが、事実は少し異なる。Nvidiaが目指しているのは、特定のプラットフォームへの制限ではなく、自社のハードウェアがAI開発の「最も効率的なインフラ」であることを証明し続けることだ。1億5,000万ドルという年商規模で成長を続けるHugging Faceを傘下に収めることで、Nvidiaは自社のハードウェア上で動くソフトウェア資産をコントロールできるようになった。
開発者視点では、今後は「どのフレームワークを使うか」よりも「Nvidiaの最適化エンジンにどれだけ適合したパイプラインを組めるか」が技術的価値を左右する。Transformer Engineを使いこなし、学習時間を数倍に短縮できるエンジニアが求められる。
この買収によって、AI開発の「標準」は書き換わる。これまで別々だった「データ探索」と「ハードウェア最適化」が、一つのプロセスとして統合された。開発者は、この新しいパイプラインを自分のプロジェクトに組み込み、素早くプロダクトをリリースする。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
実務への影響:データパイプラインの再設計と最適化の標準化
今回の買収により、実務レベルでの開発パイプラインには変化が訪れる。これまで、Hugging Faceでモデルやデータセットを探し、ローカルやクラウド環境で試行錯誤してから、推論最適化のためにハードウェアごとの調整を行うという「分断された工程」が一般的だった。今後は、このプロセスがNvidiaのエコシステム内で垂直統合される。
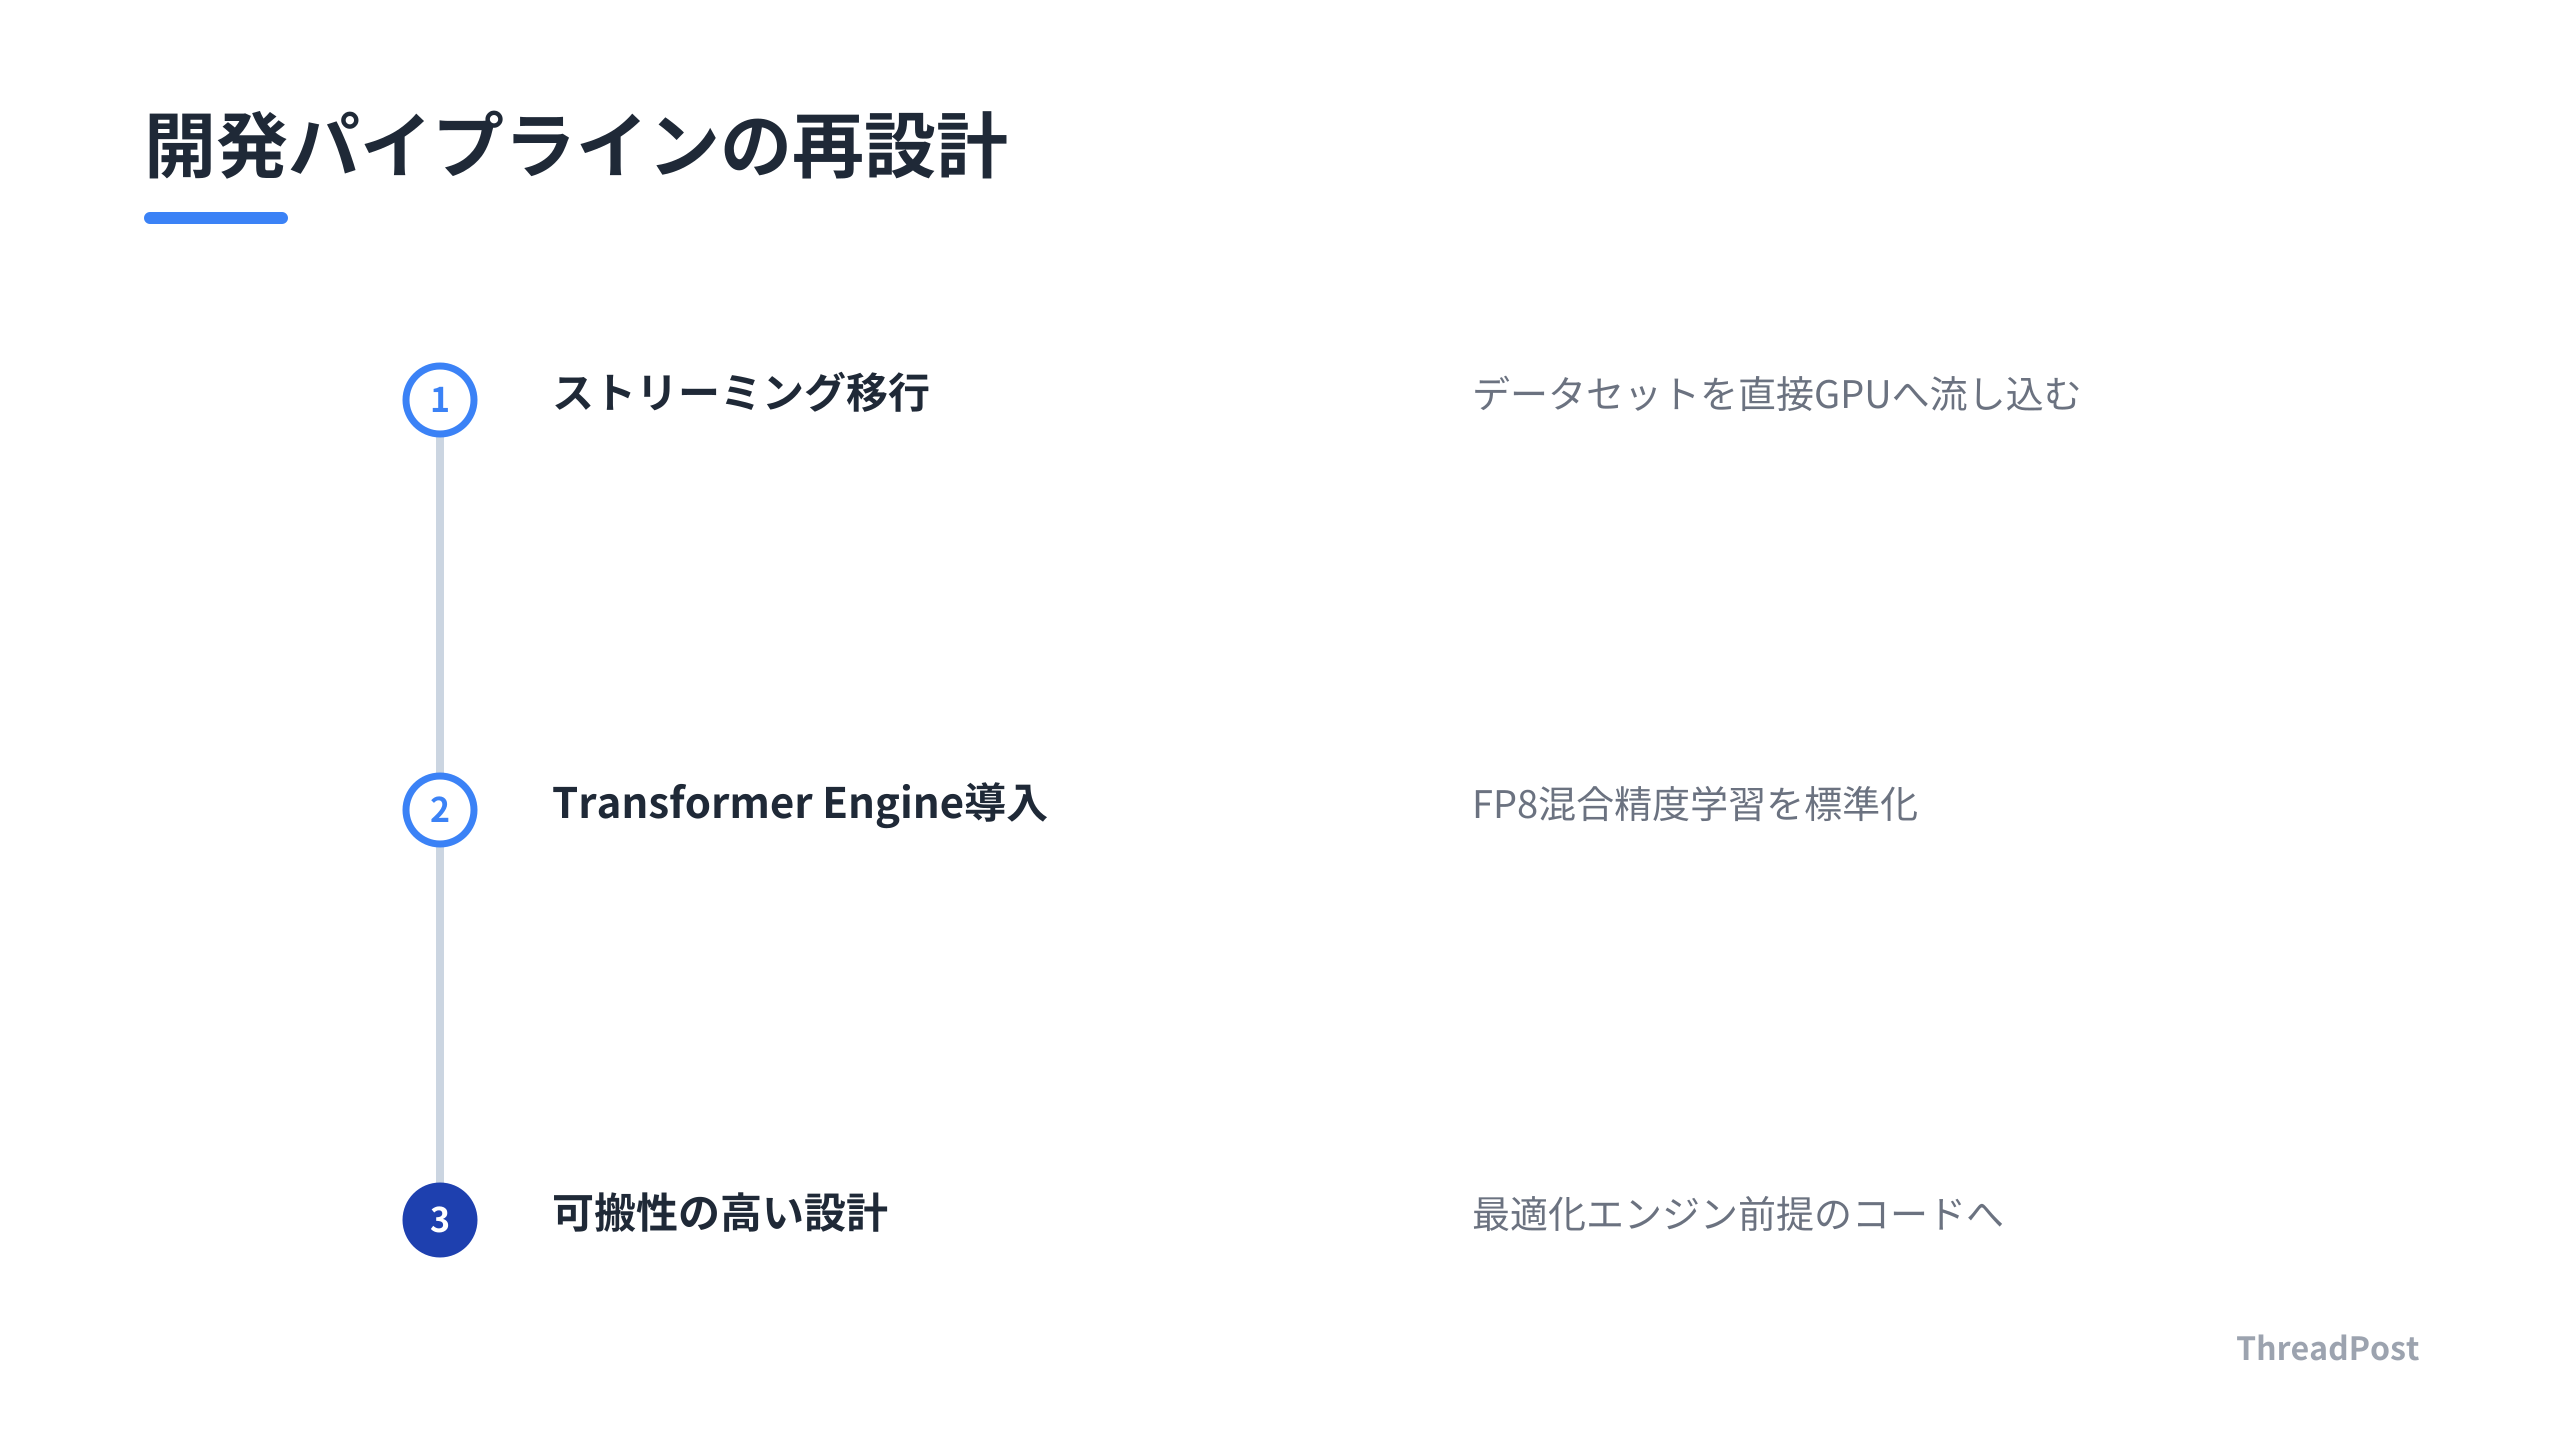
具体的には、データセットのストリーミング処理を導入する。数ギガバイトのデータをローカルにダウンロードして展開する手法は非効率になる。Hugging Faceのストリーミング機能を使い、必要な時に必要な分だけデータをGPUメモリへ直接流し込むパイプラインを構築する。
さらに、Transformer Engineの導入を前提とした開発を行う。FP8混合精度学習への対応をコードの初期段階から盛り込むことで、学習コストと推論速度の両面で優位性を確保する。これは「後から最適化する」のではなく「最初からNvidiaスタック上で動かすことを前提に設計する」という開発スタイルの転換だ。
NvidiaのGPUをフル活用できるかどうかが、個人の開発スピードの限界を決める時代だ。Claude Codeでコードを書くときも、Transformer Engineを叩くための定型処理をいかに効率よくテンプレート化しておくかが勝負の分かれ目になる。
今すぐ行うべきアクションは、既存のデータパイプラインの見直しだ。大規模なデータセットを扱うプロジェクトがあるなら、ダウンロード不要なストリーミング読み込みへの移行を試す。また、推論エンジンとしてTransformer EngineのAPIを触っておくことが、今後のAIアプリ開発における武器になる。
特定のハードウェアに依存しない汎用的なコードを書くことは重要だが、実務においては「最適化されたインフラをいかに早く使いこなすか」というリアリズムが勝る。Hugging Faceという「データの入り口」と、Nvidiaという「計算の出口」が繋がったことで、これまで以上に素早く、かつ低コストでAIモデルを実戦投入できる環境が整った。
この変化を「囲い込み」と捉えて警戒するよりも、新しい高速道路に乗って、自分のプロダクトを遠くまで運ぶことを考える。技術スタックの標準化が進む今、学ぶべき対象が明確になったことは、開発者にとって追い風だ。
 あわせて読みたい【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録 →
よくある質問
Hugging Faceのオープンソースモデルは今後も無料で使えますか?
NvidiaのCEOであるジェンスン・フアンは、買収後もプラットフォームのオープン性を維持することを明言している。これまで通り誰でも自由にモデルを選択し、好みのクラウド環境でデプロイできる自由度は変わらない。ただし、今後はNvidiaの計算リソースや最適化エンジンとの親和性が極めて高くなるため、特定のハードウェア環境下での運用が、コストと性能の両面で最も効率的になる。
データセットのストリーミング処理は、買収によってどう変わりますか?
これまではデータセットのダウンロードや管理が開発者の負担となっていたが、今後はHugging Face上のデータとNvidiaのGPUインフラが、より深いレイヤーで統合される。特に、大規模データをローカルに保存せず、ストリーミングで直接GPUメモリへ転送するパイプラインの構築が容易になる。ストレージ容量や通信速度を気にせず、巨大なデータセットを用いた学習や推論の検証を、より低レイテンシで実行できる環境が標準化される。
開発者は今すぐNvidiaのハードウェアに乗り換えるべきですか?
ハードウェアを今すぐ刷新する必要はない。重要なのは、コードの書き方を「データから推論まで」を一気通貫で最適化できる設計に変えていくことだ。現状の汎用的なライブラリに依存しすぎるのではなく、Transformer Engineのような最適化ツールをパイプラインに組み込む準備を始める。インフラの進化に合わせて、自分の開発環境を柔軟にアップデートできる「可搬性の高いデータフロー」を構築しておくことが、長期的な開発効率の向上に繋がる。
まとめ
今回の買収は、単なる資金移動ではなく、データと計算資源の境界が消える合図だ。開発者として注目すべきは、Hugging FaceのデータストリーミングとNvidiaのハードウェア最適化が、一つのパイプラインとして直結する点にある。
「データを探す」「環境を構築する」「推論を最適化する」といった断片的な作業は、今後ますますシームレスに統合される。一人SaaS開発者にとって、このエコシステムの進化は、より巨大なモデルを個人の開発フローに組み込むための追い風となる。
インフラの進化をただ眺めるのではなく、自分の開発パイプラインをどう最適化するか。ThreadPostで最新のAI活用術を共有しながら、この新しい開発の波を乗りこなしていく。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
