


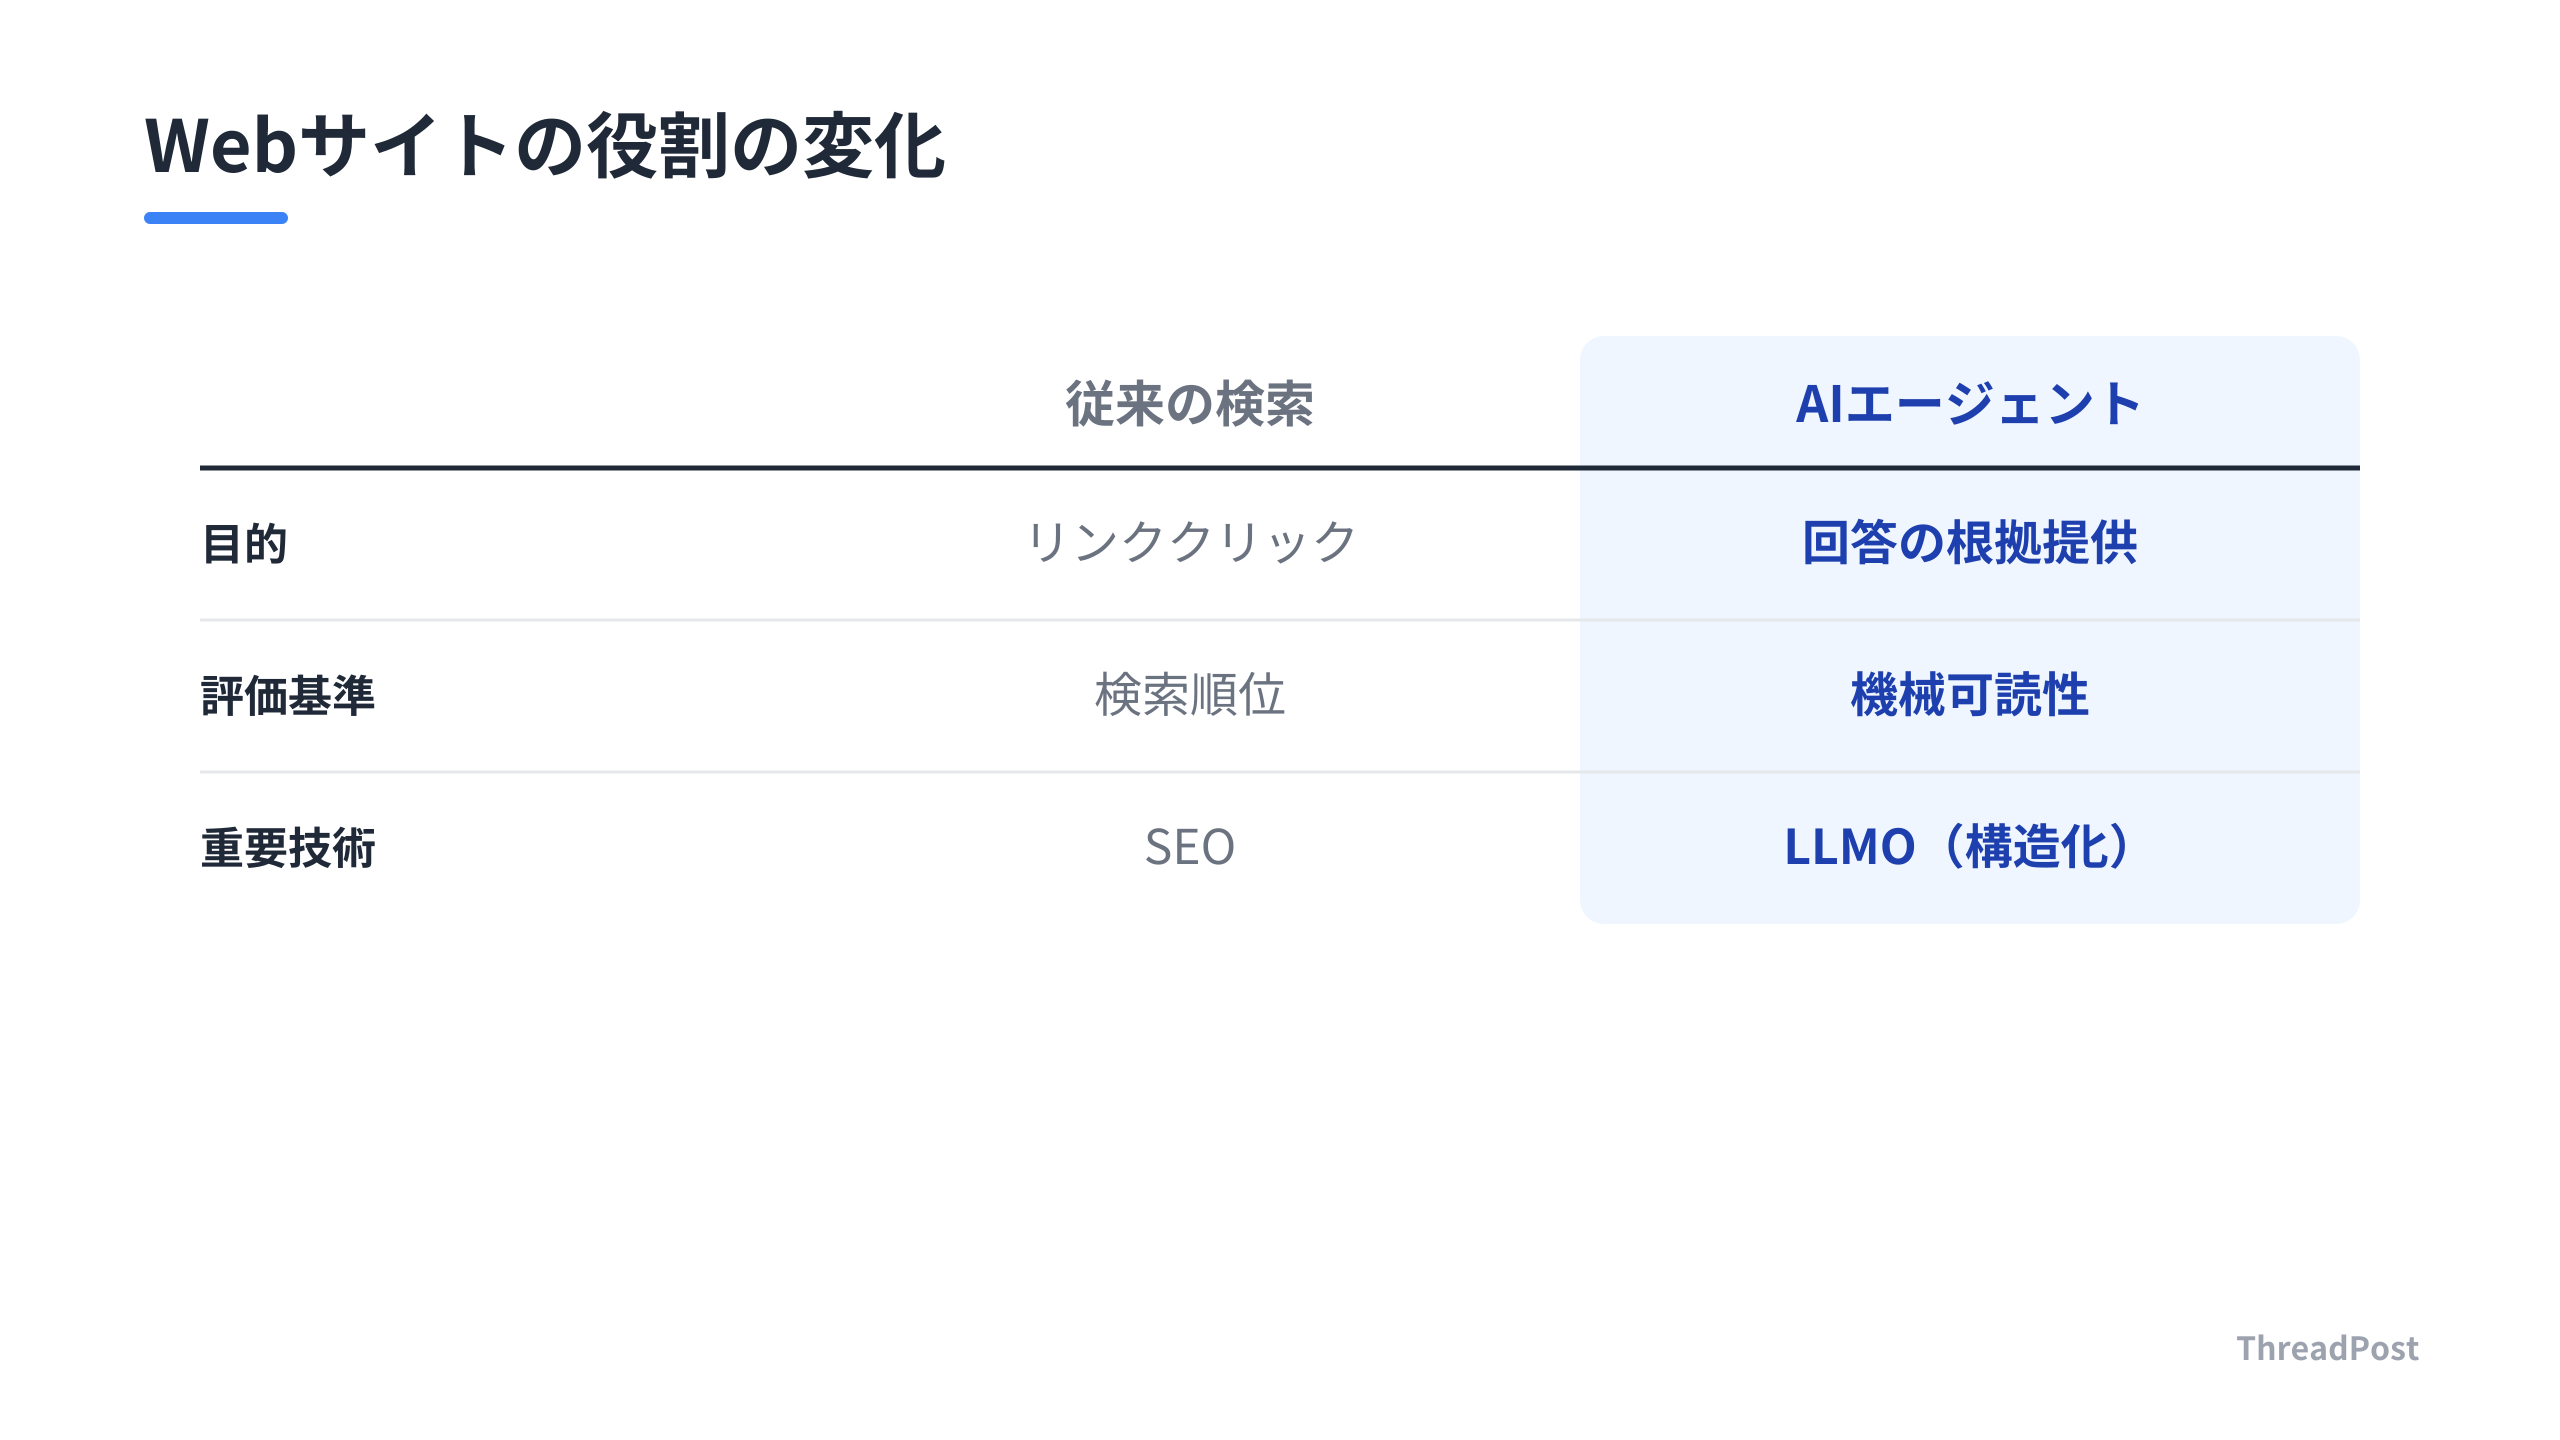
検索結果に「青いリンク」が並ぶ時代は終わりを告げた。これからのWeb戦略は、SEOによる順位争いから、AIの回答の一部として採用される「LLMO(大規模言語モデル最適化)」へシフトしている。
OpenAIは学習データの提供を制御する共通シグナルを発表した。Googleは検索を「情報提供エージェント」へと変貌させた。開発者が向き合うのは「AIを拒否するか」という二元論ではない。AIに情報を読み取らせ、信頼できる一次情報源として選ばれるための「構造化」がWebサイトの価値を決める。
この記事では、なぜサイトがAIから無視されるのか、どうすればAIの回答に引用されるのかを解説する。Claude CodeでSaaS開発を行う僕の視点から、実装戦略を解き明かす。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
AI時代の「学習拒否」と「引用最適化」という二つの潮流
Webサイトを取り巻く環境は変化している。転換点は、OpenAIが発表した「学習データ提供を制御する共通シグナル」への対応だ。サイト運営者は、主要なAIモデルごとに異なるクローラーを識別し、個別にrobots.txtを編集していた。今後は、標準化団体が推進する共通シグナルを採用することで、複数のAIプロバイダーに対して一括で「学習への利用可否」を伝えられる。
検索エンジン側の動きも加速している。Googleは、従来の「青いリンクが並ぶ検索結果」から、AIが直接回答を生成し、ユーザーが対話的に深掘りできる「情報エージェント型」の体験へのシフトを宣言した。検索結果のトップ表示だけが正義ではない。ユーザーがAIに複雑なクエリを投げた際、回答の根拠として「引用されること」が、現代のWebサイトにおける新しいトラフィック獲得の形だ。
この新しい検索体験において、AIが情報を収集する際の指標となるのがLLMO(大規模言語モデル最適化)だ。AIは、単なるテキストの羅列よりも、構造化データ(JSON-LD)が整備され、見出し階層が論理的に整理されたページを「高品質な一次情報」として優先的に認識する。サイト運営者には、AIの学習を拒否して情報を守る「防御」と、構造化を徹底してAIの回答に選ばれる「攻撃」の選択肢がある。
しんたろー:
学習拒否のシグナル対応は、自分のサイトをどう扱ってほしいかという意思表示だ。ThreadPostの開発でrobots.txtをいじるときも思う。AIにクロールさせないならさせないで、AIが回答を生成する際の「参照先」としての価値はどうなるのか。そこまでセットで考える。
開発者やサイト運営者は、robots.txtによる制御だけでなく、schema.orgを用いたデータ構造の最適化を急ぐ。AIがWebを巡回し、情報を抽出するプロセスは、従来のSEOよりも「機械可読性」を重視する。特に、FAQや製品データ、価格表といった情報は、HTML上の適切なマークアップを行っているか否かで、AIの回答精度に差が出る。
Googleが提示した「情報エージェント」という未来は、Webサイトを「リンクをクリックさせるための広告塔」から「AIが判断を下すための信頼できるデータベース」へと再定義した。AIが自律的に情報を集め、ユーザーの代わりに回答を組み立てる時代において、構造化データを持たないサイトは、AIの視界から外れる。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
開発者から見た「AIに選ばれる」ための実装戦略
開発者が直面しているのは「AIがWebをどうパース(解析)するか」という技術的なパラダイムシフトだ。これまでCSSで装飾し、人間が見て分かりやすいUIを作ることに全力を注いできた。しかし、AIエージェントがブラウザの裏側でDOMを走査し、コンテキストを抜き出す現状、その「見た目」はAIにとっての優先順位において二の次だ。
重要なのは、LLMが情報を効率的に食えるかという機械可読性だ。例えば、Claude Codeで自社サービスのドキュメントやAPI仕様を読み込ませる際、構造化されていないテキストの塊と、論理的な見出し階層(h1-h6)が整ったHTMLでは、後者の方が高い精度でコンテキストを抽出できる。AIは確率的なモデルであり、構造という「ヒント」が明確なサイトを好む。これはSEOにおけるメタタグ最適化よりも、物理的な「AIの読み取りやすさ」に直結する。
学習拒否と引用最適化のバランスは興味深い。多くの運営者が「AIに学習されたくない」としてrobots.txtで門前払いをしているが、これは「AIの回答の根拠として選ばれる権利」も放棄していることになる。情報エージェントが主流になる未来では、AIの回答に自社情報が引用されることが、かつての検索流入に代わる最大のトラフィック源になる。学習を拒否しつつ、引用の対象として最適化する。この両立が、これからのWeb開発における駆け引きだ。
Claude CodeでThreadPostのコードベースをいじってると痛感する。AIは本当に構造化データが好きだ。JSON-LDが綺麗に書かれてるページだと、一発で仕様を理解する。逆に、divタグで無理やりレイアウトしてるようなサイトを読ませると、トンチンカンな解釈をしてくる。AI時代になっても「綺麗なコード」の価値は上がっている。
LLMO(大規模言語モデル最適化)は魔法ではない。schema.orgのボキャブラリーを適切に使い、FAQやProductといったスキーマを実装する作業は、泥臭い。しかし、この泥臭い作業を自動化したり、テンプレート化してSaaSに組み込んだりできるのが、開発者の強みだ。
競合他社が「AIの進化にどう対応するか」と悩む間に、僕らはHTMLをパースして構造化データに変換するスクリプトを書き、サイトの可読性を一段階引き上げる。これはGoogleのアルゴリズム変更に一喜一憂するSEOとは異なり、LLMという「知能」そのものに自社サイトを正しく理解させるための、本質的なハックだ。
検索という行為は「リンクの海を泳ぐ」ものから「エージェントに答えを求める」ものへと変質した。Googleが検索ボックスをインタラクティブなエージェント体験へ作り変えている以上、僕らも「ユーザーが検索結果をクリックしてくれること」を前提としたWeb設計を卒業する。
AIが自律的に情報を集め、推論し、回答を生成する際、自社サイトが「信頼できる一次情報源」のリストに入っているか。これが、デジタルプレゼンスを左右する指標だ。robots.txtでガードを固めつつ、JSON-LDでAIに「ここには正しい答えがある」とシグナルを送り続ける。この矛盾した二面性を、いかに洗練された実装に落とし込めるかが、開発者としての腕の見せ所だ。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
明日から始めるAI最適化の具体的なアクション
「検索結果の1位」を目指す時代から、「AIの回答ソース」に選ばれる時代へ。この変化は、開発現場に即座に落とし込むべき具体的なタスクを突きつけている。明日から着手すべきは、サイトの「機械可読性」を極限まで高めることだ。
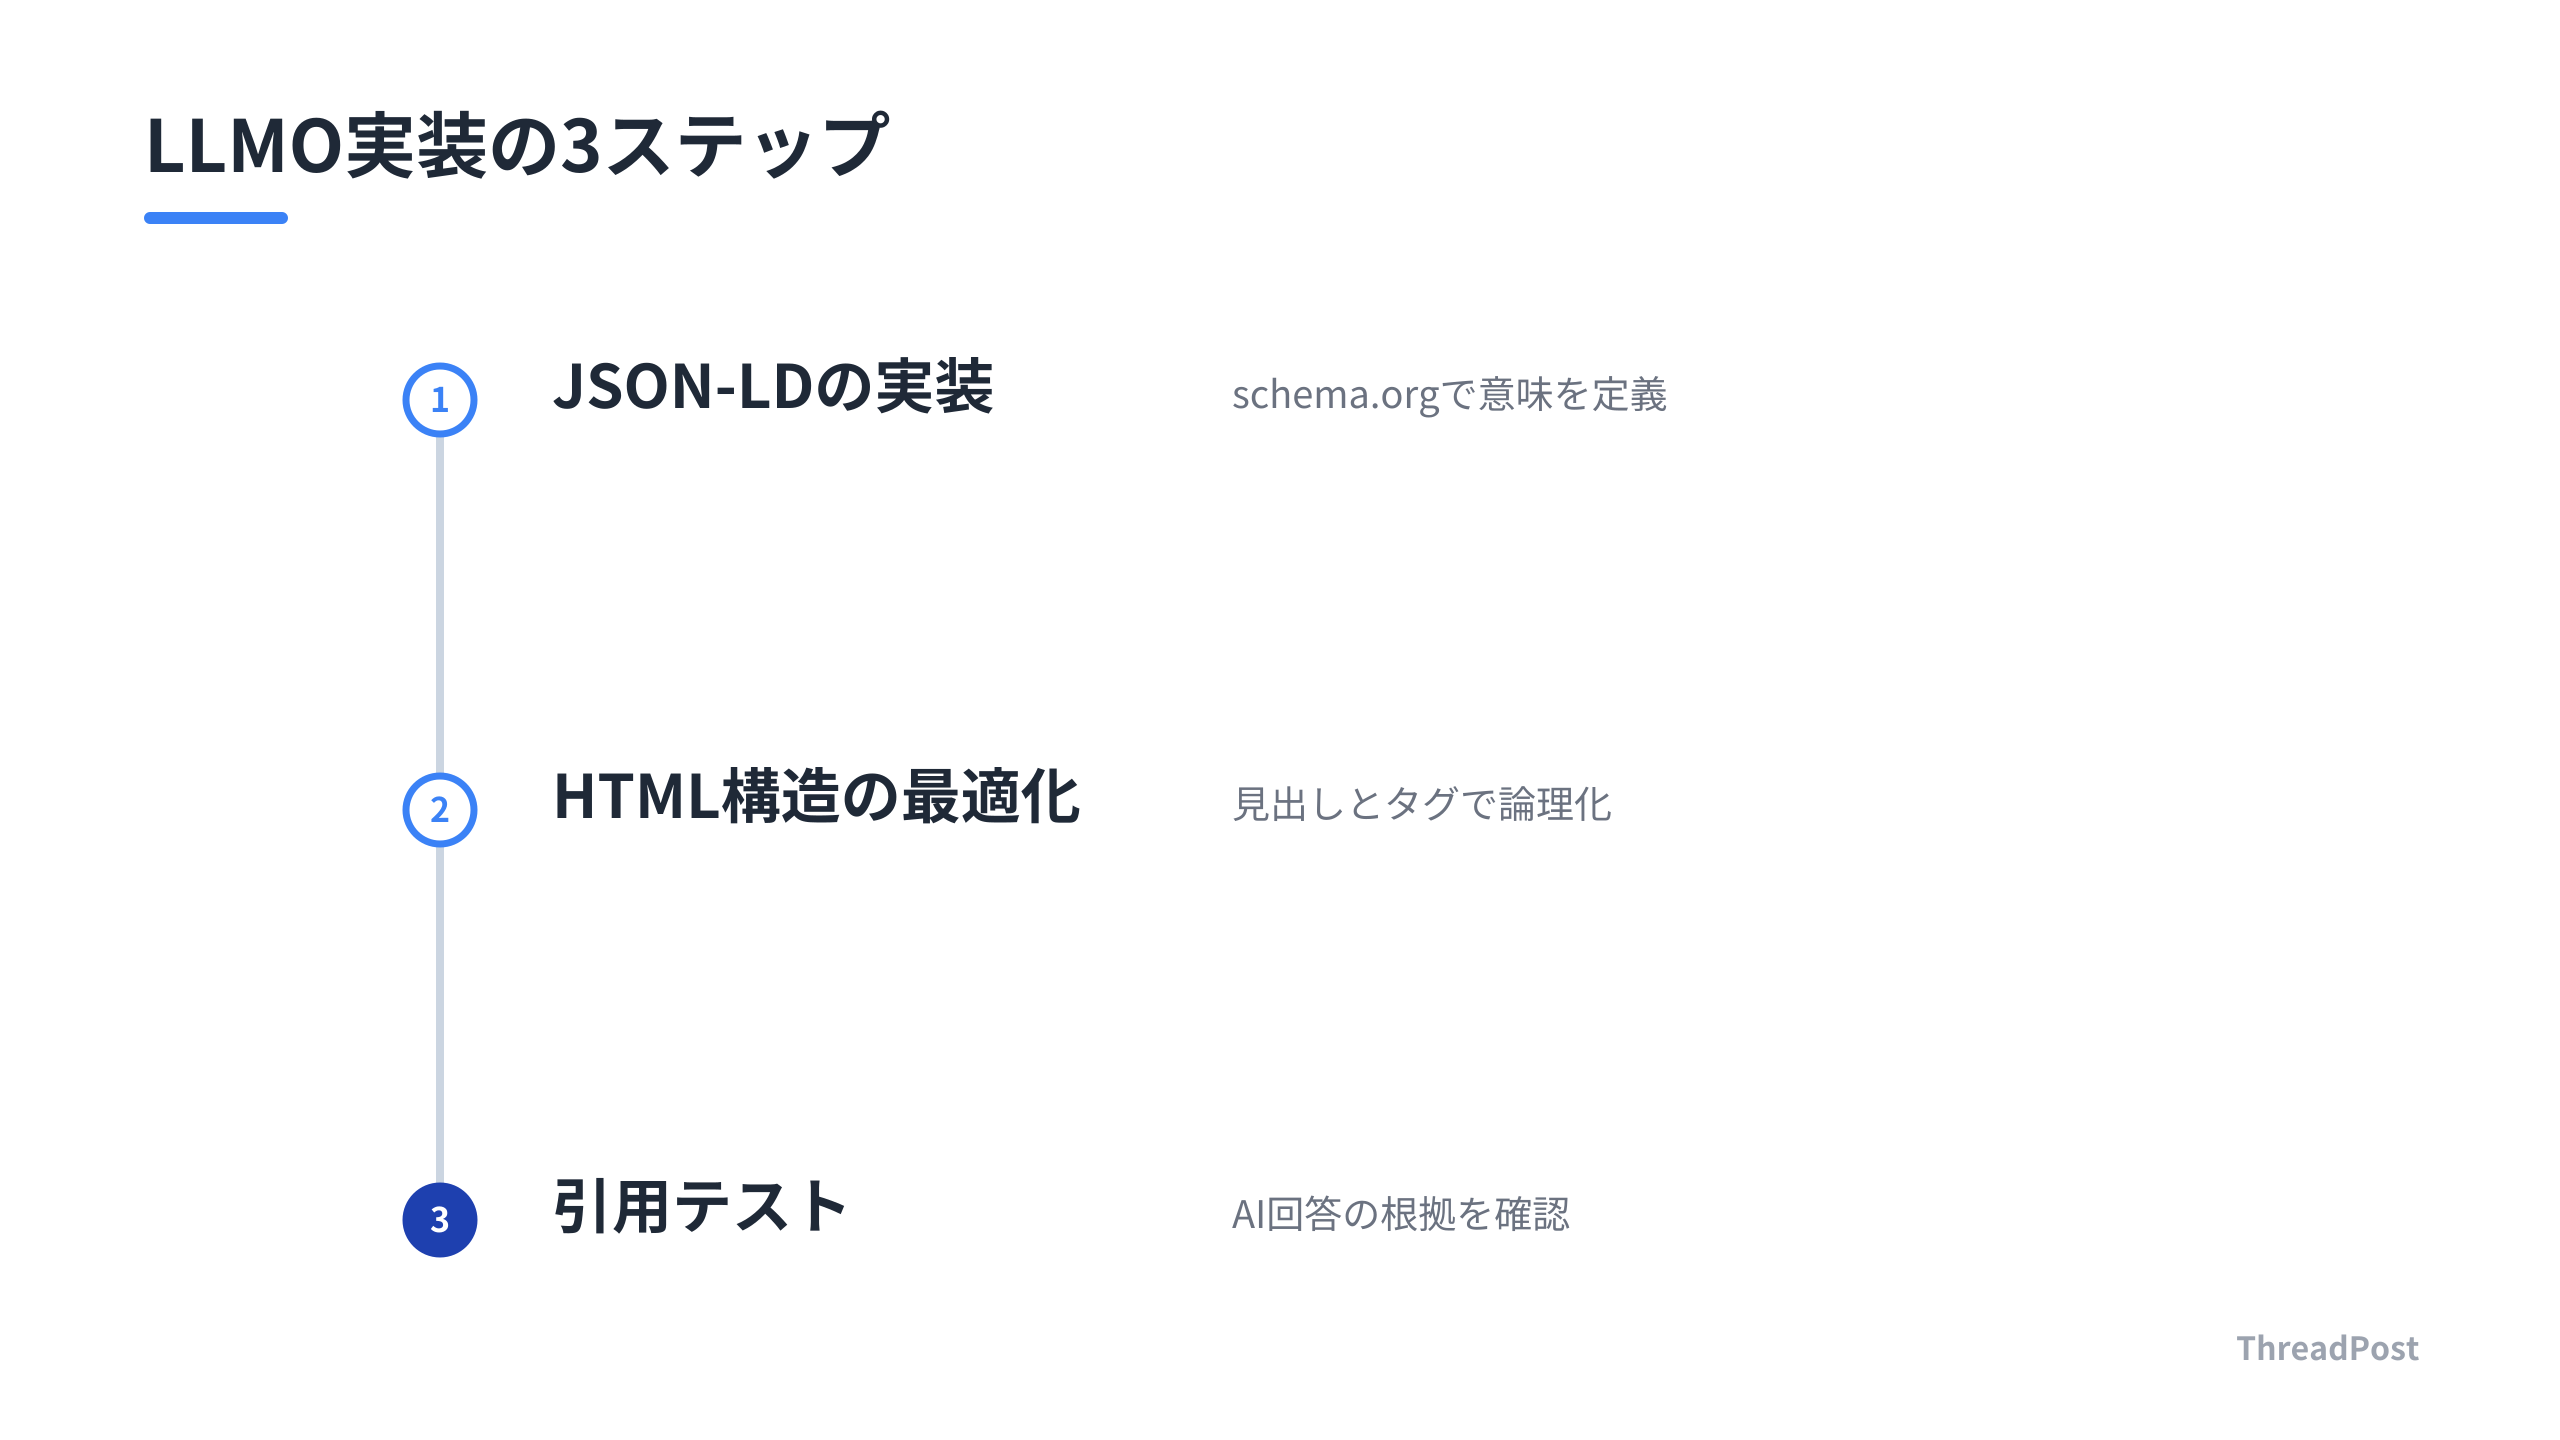
まずは、現状のサイトの構造をJSON-LDで記述し直す。特に、FAQや製品スペック、価格表といった情報は、手動でHTMLをマークアップするだけではLLMに意図が伝わらない。`schema.org`の定義に従い、`FAQPage`や`Product`といったスキーマを正しく埋め込む。これが、AIがあなたのサイトを「情報の根拠」として採用するためのパスポートになる。
次に、HTMLの階層構造を整理する。`h1`から始まる見出し階層が論理的に整っているか、`table`タグや`ul`/`ol`タグでデータが整理されているかを確認する。AIはWebサイトを「文章」として読むのではなく、タグが示す「構造」としてパースする。複雑なデータをダラダラとテキストで書くのは今日で終わりだ。
自分のSaaSでやってみたけど、意外と面倒だ。でも、Claude Codeに「このページの情報をschema.orgのFAQPage形式で抽出して」と投げてから実装すれば、工数は大幅に減る。AIを飼い慣らすにはAIを使うのが一番早い。
robots.txtの制御も「全拒否」という極端な選択肢から脱却する。AIの学習を拒否したい場合でも、特定のボットや、回答生成に必要なインデックス用ボットを適切に許可する設定が必要だ。無差別にシャットアウトすれば、「インターネット上の情報の海」から自ら孤立することになる。
Webサイトを持つ意味そのものを再定義する時期だ。リンクのクリック数を稼ぐための「釣り見出し」は、AI時代には無価値だ。LLMが自信を持って回答の根拠として提示できる「一次情報」や「独自のデータ」を、いかに構造化して公開できるか。これが、これからのWebサイトが持つ生存戦略だ。
具体的には、以下の3点を明日からの開発フローに組み込む。
- 新規公開するコンテンツには必ず`JSON-LD`の構造化データをセットで実装する
- 複雑なデータ構造は必ず`table`タグかリスト形式に変換し、AIがパースしやすい形にする
- ChatGPTやPerplexityに自社サイトの内容を質問し、正しく引用されるか定期的にテストする
SEOの順位変動に一喜一憂する日々は終わりだ。これからは、AIという巨大な知能に対して、どれだけクリアで構造化された情報を差し出せるか。その開発者としての誠実さが、トラフィックの質とブランドの信頼性に直結する。今すぐ手を動かす。1年後に笑っているのは、今のこの変化を「面倒な作業」ではなく「AI時代のアドバンテージ」と捉えた側だ。
 あわせて読みたい【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録 →
よくある質問
robots.txtで学習拒否をすると、Google検索の順位にも影響しますか?
現時点では、robots.txtによるAI学習の制御と、Googleの検索インデックスへの登録は別個の仕組みとして扱われている。AIモデルの学習を拒否したからといって、検索順位が直接下がることはない。ただし、AIが回答を生成する際の「情報源」として選ばれなくなるため、AI経由のトラフィックやブランド認知の機会は失われる。SEOとAIへの引用は、別々の戦略として管理する。
LLMO(LLM最適化)を始めるために、まず何をすべきですか?
まずは、主要なコンテンツに対して「schema.org」の構造化データを実装する。次に、HTMLの論理構造を見直し、h1からh6までの見出し階層が正しくネストされているか確認する。複雑な比較データや価格表は、divで囲っただけの装飾ではなく、tableタグやリストタグを使ってAIがパースしやすい形式に整えるのが鉄則だ。最後に、実際にLLMへ自サイトについて質問し、意図した情報が正しく引用されるかテストする。
Googleの「情報エージェント」時代に、Webサイトを持つ意味はありますか?
ある。AIが「信頼できる一次情報源」として参照し続けるためには、構造化された高品質なデータを持つサイトが以前にも増して重要になる。リンクをクリックさせることだけが目的ではなく、AIの回答の「根拠」として選ばれることが、これからのWebサイトが持つ最大の価値だ。AIが自律的に情報を収集・統合する世界において、あなたのサイトが「AIに選ばれる一次情報源」であることは、最強の生存戦略になる。
まとめ
AI時代のWeb戦略は、robots.txtで「拒否」する守りの姿勢と、構造化データで「選ばれる」攻めの姿勢を両立させる時代に入った。検索エンジンがリンク集から情報提供エージェントへ変貌する今、従来のSEOだけでは不十分だ。LLMが回答の根拠として自社サイトを採用したくなるような、機械可読性の高い設計こそが、これからのWeb開発における防衛策になる。
AIに選ばれるサイトを作るか、ただ埋もれていくか。Webの未来は、開発者の手元にあるHTMLの書き方一つで決まる。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
