


「Claudeを使っているのに、API経由とクラウド経由で挙動が違う」。そんな違和感がある。モデル名が同じでも、推論を実行する基盤や契約形態が異なれば、出力の質やツール呼び出しの安定性は別物だ。
開発者はLLMの提供経路が「モデル開発元」「推論運用者」「契約窓口」という3つの階層に分離している事実を把握する。Claude Codeで実装を回す際、このレイヤー構造の理解がFunction Callingの成功率やプロンプトの効き目を左右する。
この記事では、推論基盤の選択がアプリの成否を分ける構造的な理由を解き明かす。自分の開発環境を最適化する第一歩は、この「見えないインフラ」の正体を突き止めることだ。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
LLM利用経路の複雑なレイヤー構造
現在のLLM利用環境は「どのモデルを使うか」という選択肢だけでは語れない。Amazon BedrockやVertex AI、Microsoft Foundryといったクラウドサービス経由の利用と、モデル開発元が直接提供する直APIでは、推論の裏側にある基盤構成が異なる。
LLMのAPIサービスには「モデル開発元」「推論運用者」「契約窓口」という3つの主体が関わる。同じClaudeを利用する場合でも、Anthropicが直接運用するAPIと、AWSのインフラ上で動くBedrockでは、APIの機能制限、クォータ管理、データの取り扱い、推論プロファイルの割り当て方法が別物だ。
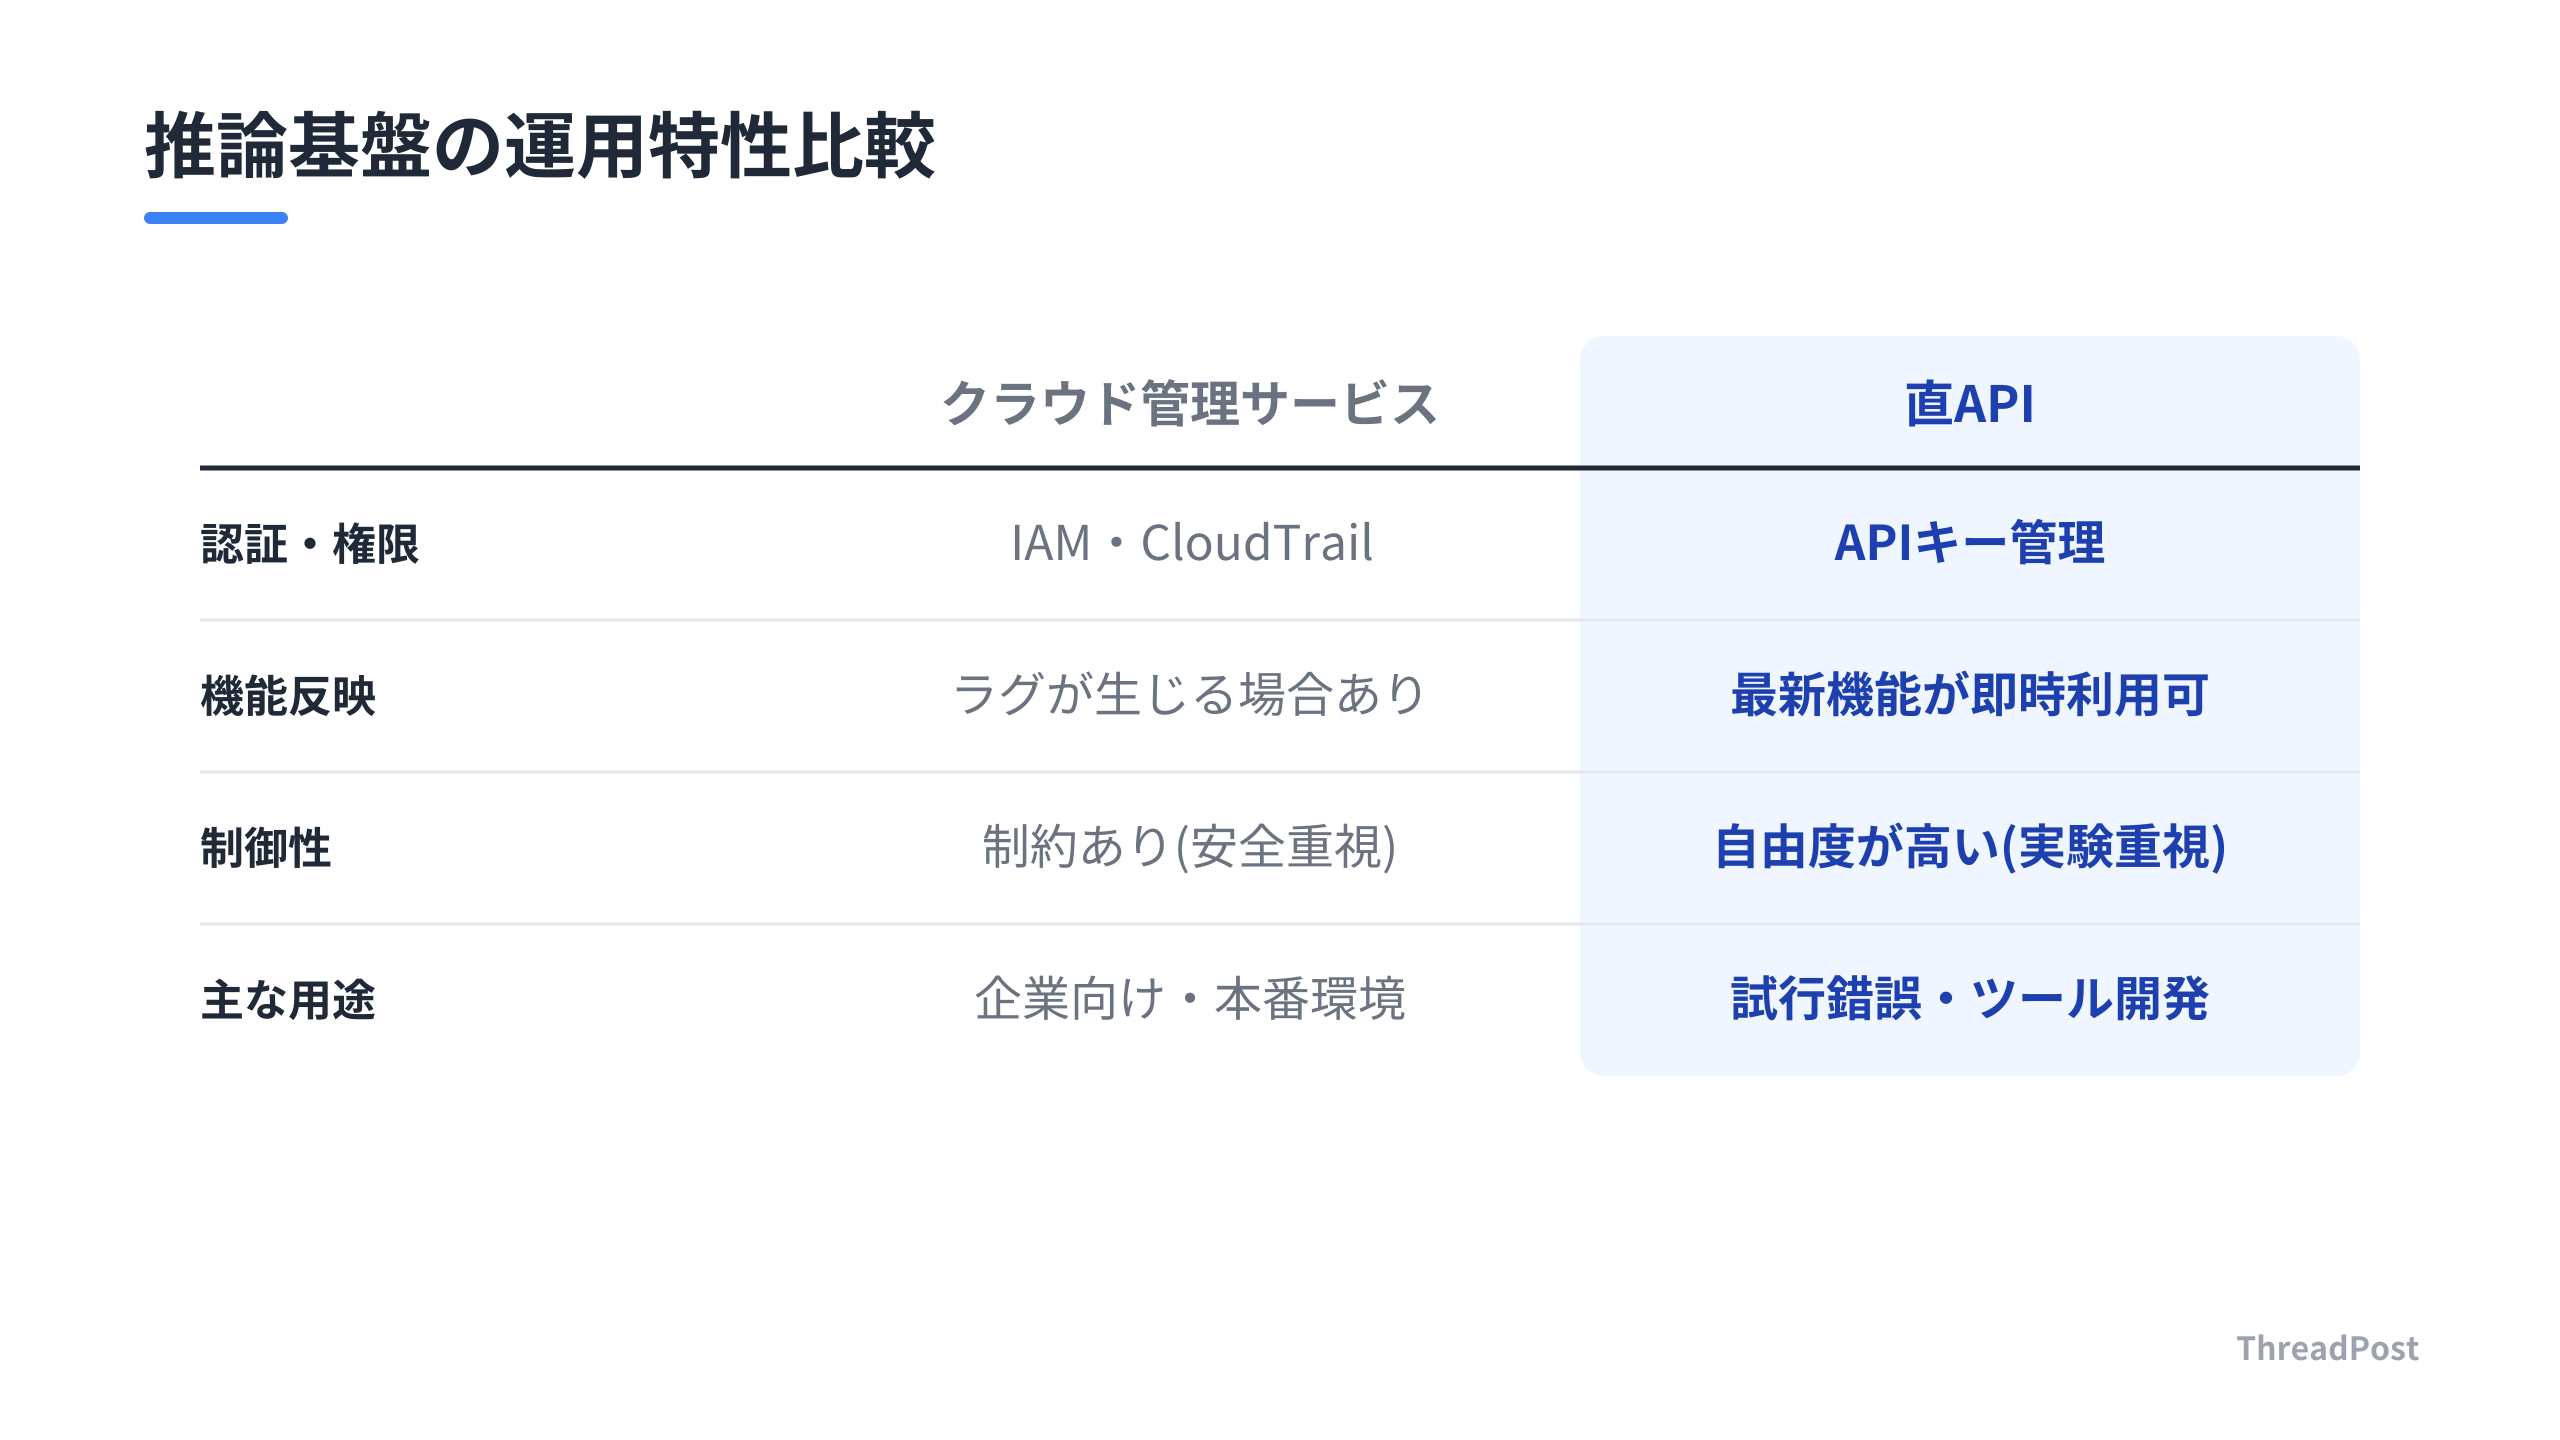
クラウド各社は多様な管理サービスを提供する。Amazon BedrockはIAMによる認証やCloudTrailとの連携など、既存のAWSエコシステムに組み込まれている。Vertex AIのModel Gardenでは、共有APIとして提供されるモデルと、ユーザーのプロジェクト内に専用エンドポイントを作成して配置するモデルが混在する。Microsoft FoundryはOpenAI、Anthropic、Mistralといった複数の開発元モデルをカタログ化し、ホスティング方式や提供地域を用途に応じて選択させる。
しんたろー:
APIの窓口によってFunction Callingの癖やレスポンスの安定感が違う。AWSのIAMで権限管理してる環境と、直APIで動かす環境ではデバッグの難易度が別次元だ。
接続経路と実行形態の分離も存在する。BYOK(Bring Your Own Key)のように、クラウドの管理機能を使いつつ、推論自体は開発元の基盤で行う手法がある。オープンウェイトモデルも特定の接続経路に紐付かず、AI Gateway経由や自社運用のコンテナ環境など、利用者のインフラ構成によって「どこで推論が走っているか」が変動する。
開発者が直面する「挙動が不安定」という問題の多くは、モデル性能の限界ではなく、こうした推論運用のレイヤー構造から生じる。モデル名の一致だけで安心せず、どの事業者が計算資源を管理し、どの認証基盤を通って推論が実行されているのか。全体像の把握がプロダクトの安定性を高める。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
モデル名だけでは制御不能な「推論レイヤー」の罠
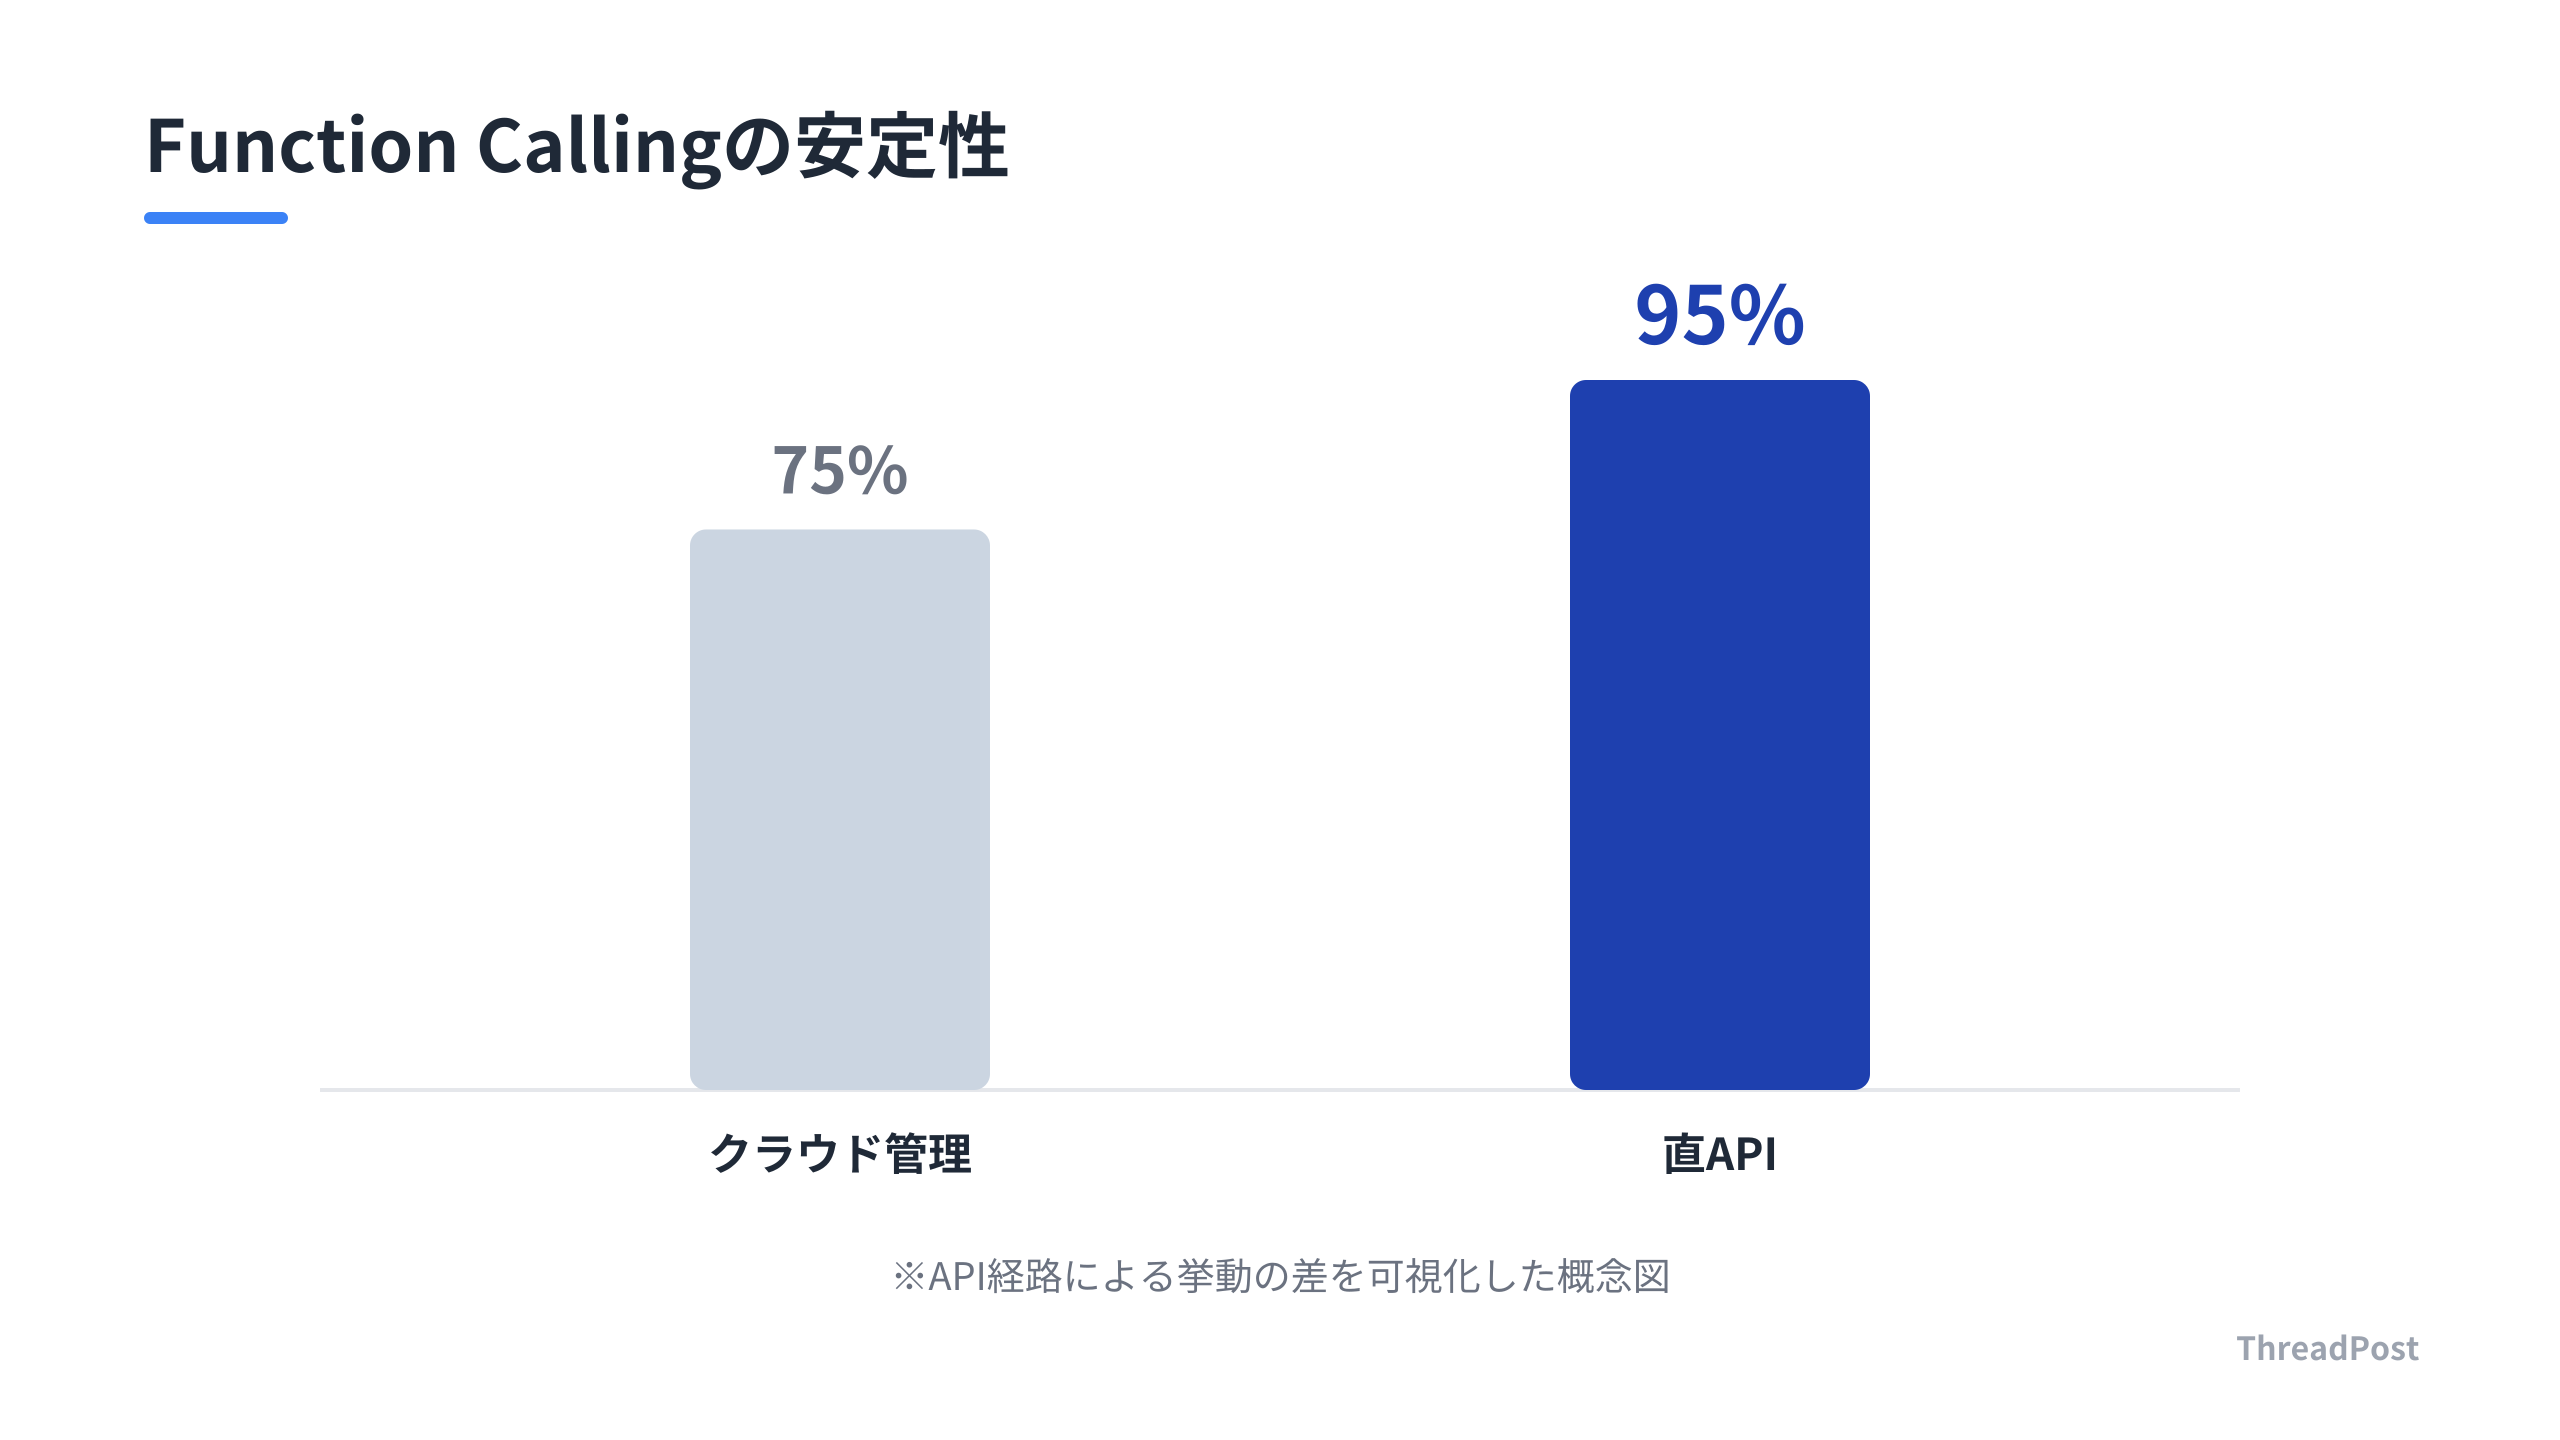
「同じ名前のモデルなら、どこで呼んでも同じ挙動をする」という幻想は捨てる。Amazon Bedrock、Vertex AI、直APIを比較検証すると差は歴然だ。Function CallingやJSON出力の安定性は、モデルのパラメータ数以上に「推論エンジン側の設定」に依存する。
クラウドの管理サービスはセキュリティや請求の一元化に優れる。しかし、モデル開発元が提供する直APIと比較すると、推論のパラメータ調整や最新機能の反映タイミングにラグが生じる。ThreadPost開発でも、特定のAPI経路を通すと複雑なツール呼び出しがエラーを吐くことがあった。モデルの性能を100%引き出すには、そのモデルが「どの推論基盤で、どのような制約条件下で動いているか」というメタデータを意識した設計が不可欠だ。
APIがタイムアウトする原因は、推論基盤のクォータ制限やリージョン間のレイテンシだったりする。モデル名だけで安心せず、インフラの接続経路まで見ないとエージェント開発は詰む。
プロンプトエンジニアリングの有効性も経路によって左右される。モデルが参照する「知識のクラスタ」は、推論基盤の構築方法によって変化する。特定の心理学的なフレームワークを適用する場合、単に指示を並べるだけでなく、出典元や年号をメタデータとして付記することで、回答の質が変わる。これはモデル内部の「真面目な学習データ」を優先的に引き出すためのハックだ。
「制御性と利便性のトレードオフ」も存在する。クラウド側の管理サービスを使えば、IAMによる厳格なアクセス制御やプライベート接続が可能だ。ローカル環境や専用エンドポイントでモデルを動かす場合、制約から解放される代わりに、推論エンジンの更新やModelfileの管理という「運用コスト」を自分で背負う。
開発者は「自分のアプリが何を最優先すべきか」を定義する。セキュリティと運用コストならクラウドの管理サービスだ。最新モデルの自由な試行錯誤とツール呼び出しのチューニングなら直APIだ。APIコストを気にせず自分専用の推論エンジンを育てたいならローカルLLMだ。
このレイヤー構造を理解すれば、接続経路を変えるか、推論基盤の設定を調整するという打ち手が浮かぶ。モデルはただの重みデータではない。それを動かす「環境」そのものがプロダクトの挙動を決める。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
開発者が明日からやるべき「接続経路」の選別と設計
「モデル名」だけで選ぶ時代は終わった。
JSON出力やツール呼び出しを多用するアプリでは、モデルの選択よりも先に「どの推論基盤から叩くか」を固定する。Claude Codeのような自律型エージェントを組むなら、APIの安定性とスループットが全てだ。クラウド管理サービス経由でモデルを叩くのは避ける。クラウド側の管理レイヤーが挟まることで、予期せぬタイムアウトや、モデル開発元が本来意図した挙動とのズレが生じることがあるためだ。
プロンプトの記述方法を見直す。単なる指示出しではなく、モデルが持つ「訓練データ内の知識」をいかに掘り起こすかという視点を持つ。プロンプト内に「研究者名と年号」をメタデータとして埋め込む手法が有効だ。「論理的な回答をしろ」と書く代わりに、心理学の論文を引用しながら「この技法を適用して回答せよ」と指定する。これだけで、モデル内部の「学術的・専門的なテキスト」クラスタが優先的に参照される。
ローカルLLMを試すなら、Dockerコンテナとの境界を意識する。`host.docker.internal` を使った接続を基本とし、Modelfileの更新フローを自動化するスクリプトを書く。コンテナを再起動するたびにモデル作成を手動で叩くのは開発体験を下げる。「なぜか挙動が変わらない」というデバッグ時間を削るために、設定の反映経路を可視化する。
モデルの性能差よりも「環境の制御権」をどこまで握れるかが勝負だ。ThreadPostで複雑な処理を組むときは、APIの経路ごとに挙動をログに出して比較してる。ツール呼び出しがコケる原因の8割は、モデルじゃなくて推論基盤のテンプレート設定だ。
セキュリティ要件とコストのバランスを再定義する。アプリが機密データを扱うなら、クラウドのIAMやプライベート接続が必須だ。個人のサイドプロジェクトなら、直APIやローカル環境で「推論エンジンを育てる」ことに時間を割く。
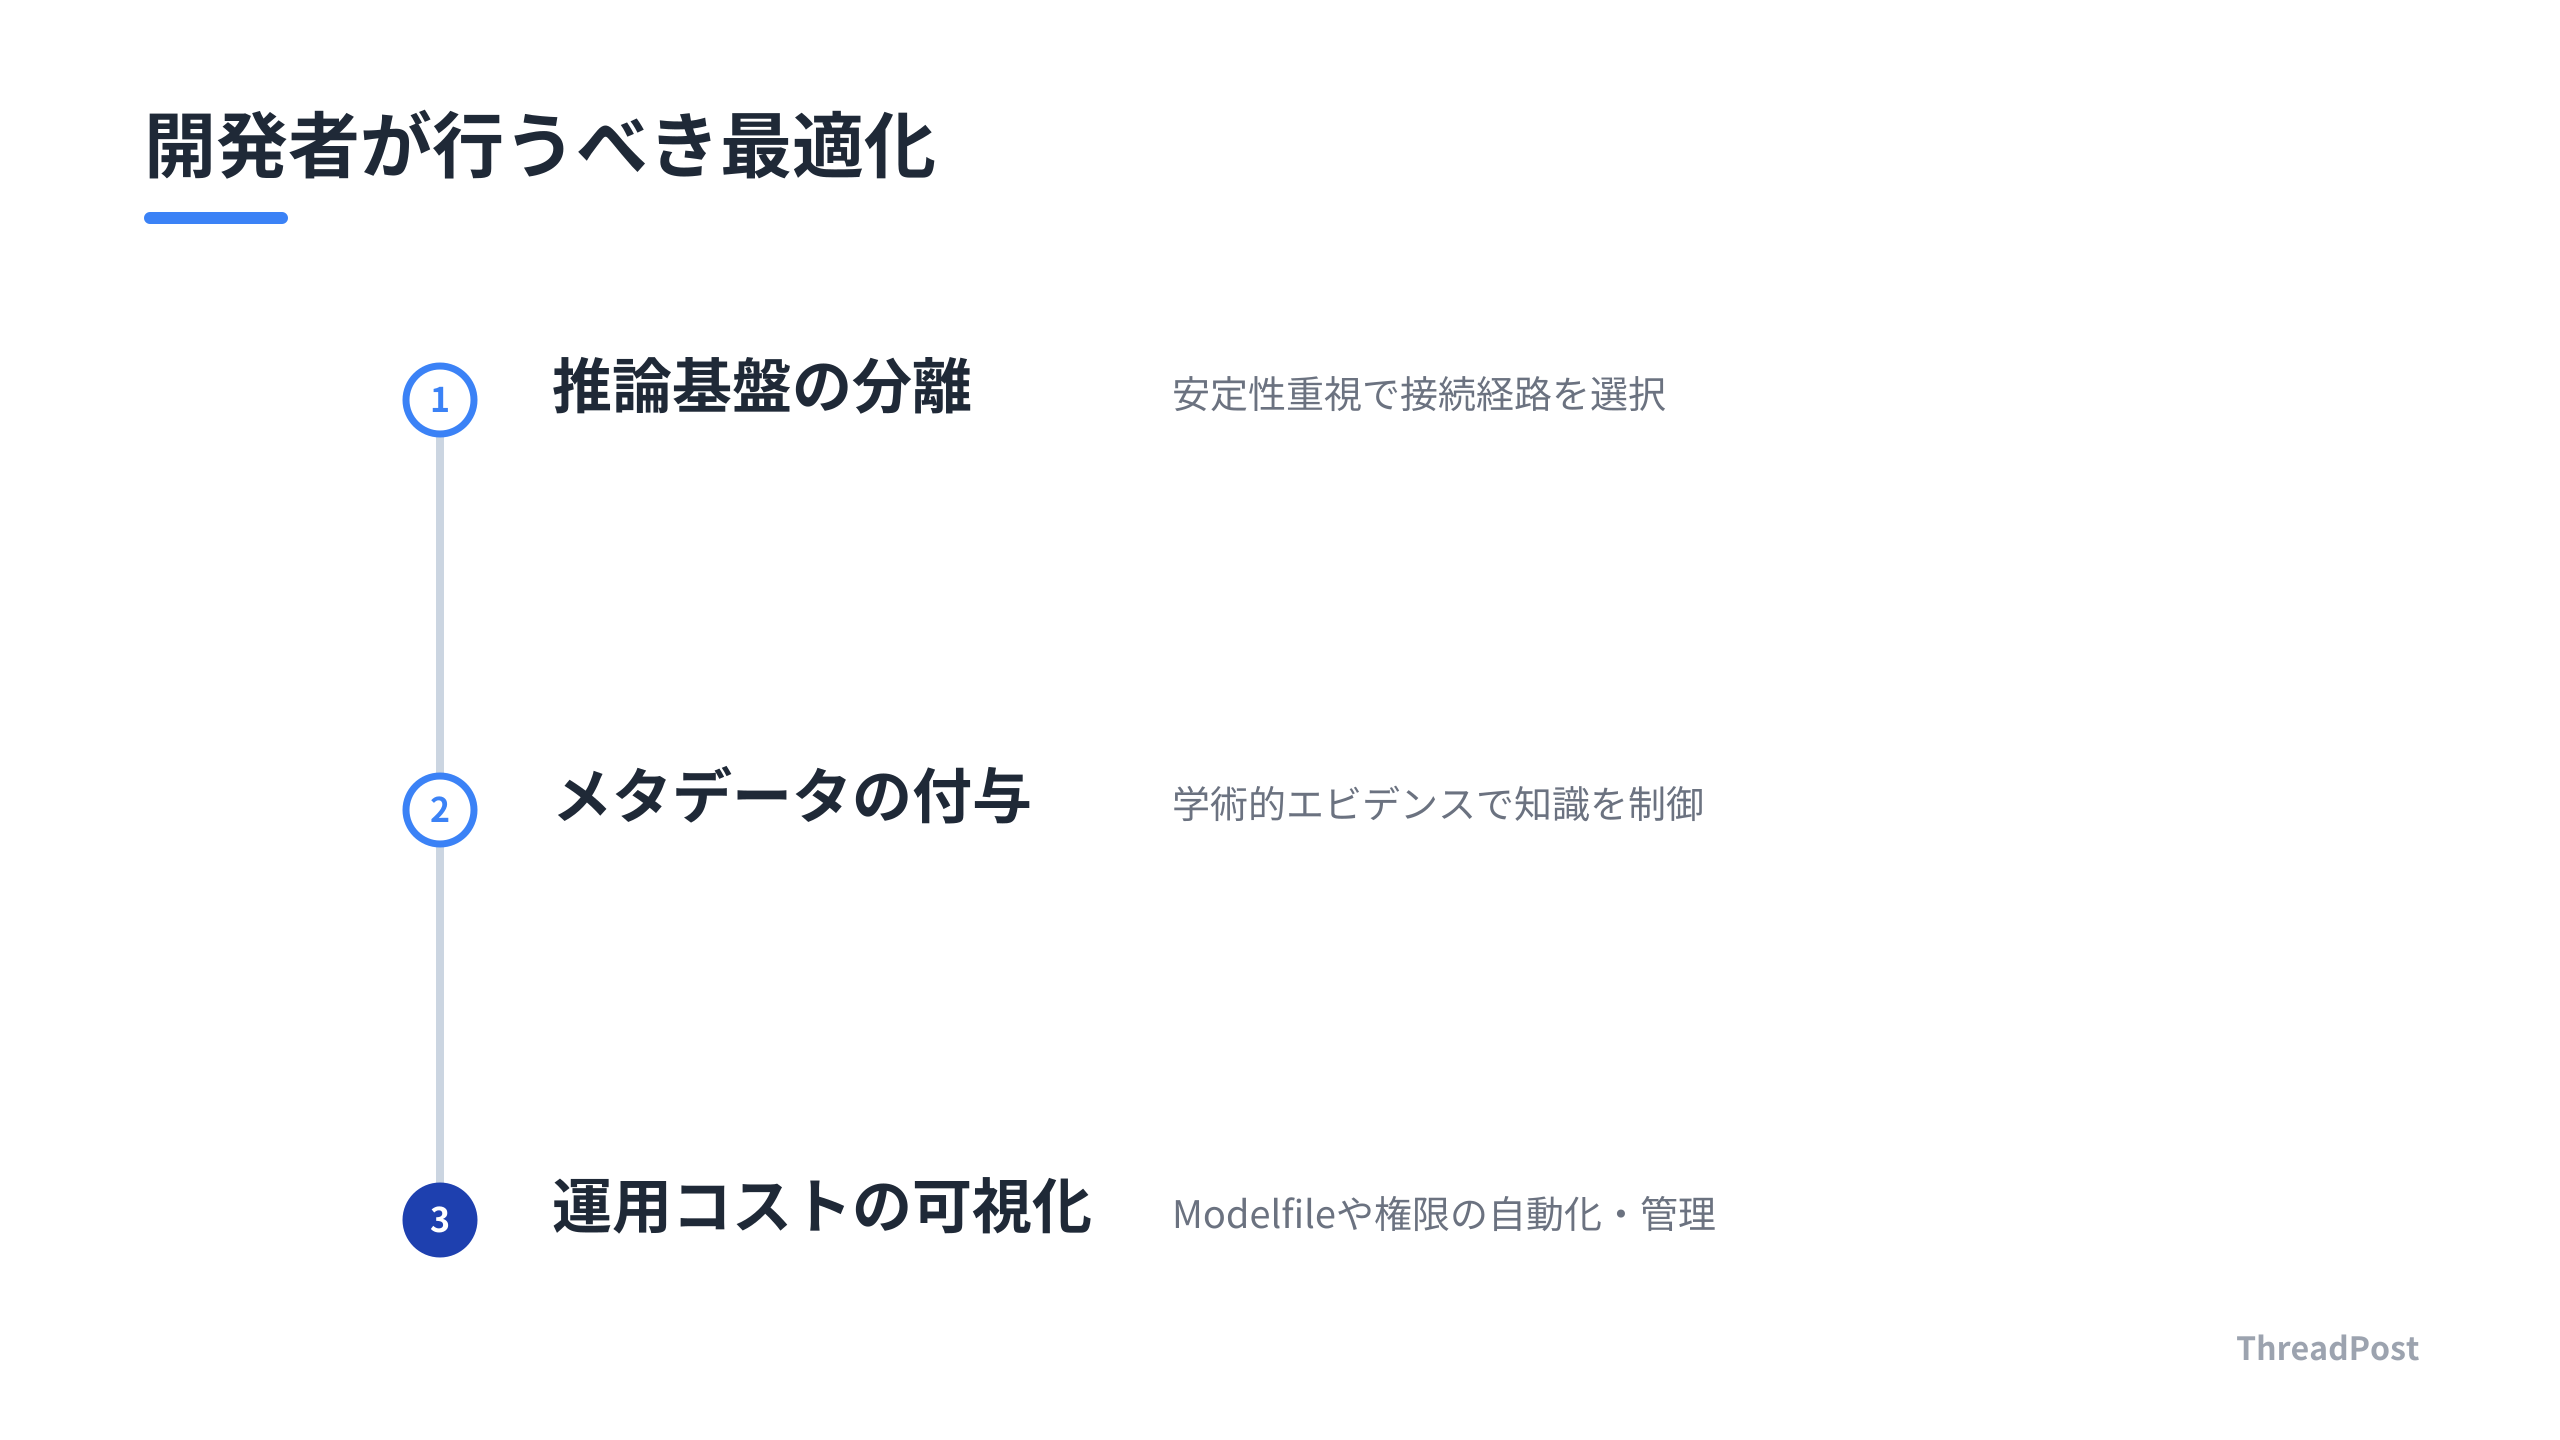
明日からは、以下の3点を意識する。
- 推論基盤の分離: ツール連携が必須な機能は、モデル名だけでなく「推論の安定性」を重視した接続経路を選ぶ。
- メタデータの付与: プロンプトに学術的エビデンスを埋め込み、モデルの知識の参照先を制御する。
- 運用コストの可視化: ローカル環境ならModelfileの更新フローをスクリプト化し、クラウドならIAMの権限範囲をドキュメント化する。
AI開発は魔法の杖を振ることではない。推論という「物理的な計算」を、いかに制御可能なレイヤーに配置するかという、泥臭いエンジニアリングの積み重ねだ。モデル名に踊らされず、自分のアプリの足元を固める。
 あわせて読みたい【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録 →
よくある質問
クラウドのモデルAPIと直API、どちらを選ぶべきですか?
セキュリティ要件と管理コストで判断する。AWS BedrockやAzure Foundryのようなクラウド管理サービスは、既存のIAMやVPC環境との統合が強力で、請求の一元化も可能だ。企業向けアプリやコンプライアンスが厳しい環境ではこちらが適している。一方、最新モデルの機能を即座に試したい場合や、キャッシュ機能、特定のツール連携をフル活用したいなら直APIが有利だ。個人の開発環境や、APIコストを気にせずパラメータ調整の試行錯誤を繰り返したいなら、ローカルLLMという選択肢もある。
Function Callingがうまく動かない原因は何ですか?
モデルのサイズ不足、または推論エンジンの設定不備が主な原因だ。モデルがツール呼び出しに対応していない場合や、プロンプトテンプレート内でツールの定義が構造化されていないと、LLMは正しくJSONを出力できない。解決策として、Function Calling対応を明記しているモデルへの変更、またはプロンプト内でJSONスキーマを具体的に記述する。ローカル環境であれば、Modelfileでプロンプトテンプレートが正しく定義されているか確認する。
プロンプトに学術的エビデンスを書くと何が変わりますか?
LLMが回答を生成する際の「参照先」を、ネット上の一般的な言説から、学術的・専門的なクラスタへと誘導できる。「研究者名と年号」を付記するだけで、モデルは訓練データ内の論文や専門書の内容を優先的に参照し、論理的で質の高い出力を生成する。これは単なる指示出しを超えた、モデルの「知識の引き出し方」を制御する高度なプロンプトエンジニアリングの手法だ。抽象的な指示よりも、具体的な出典メタデータを与える方が回答の質感は向上する。
まとめ
LLMをアプリに組み込む際、「どのモデルを使うか」以上に「どの経路で接続するか」が重要だ。Bedrockのような管理基盤、あるいは直API。それぞれが持つレイヤー構造を理解すれば、Function Callingの安定性や推論のコストは、設計段階でコントロールできる。
開発者がやるべきは「モデルの性能」を信じて待つことではない。推論環境の特性を把握し、プロンプトに学術的なメタデータを仕込んで「知識の引き出し方」を制御することだ。このアーキテクチャの複雑さを楽しめれば、AI開発の解像度は一段階上がる。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
