


AIの進化が止まらない。先日リリースされた「GPT-6 Astra」の登場で、コンテキスト理解の限界が一段引き上げられた。どれほどモデルが賢くなっても、開発者が抱える「RAGの精度が安定しない」という悩みは残る。
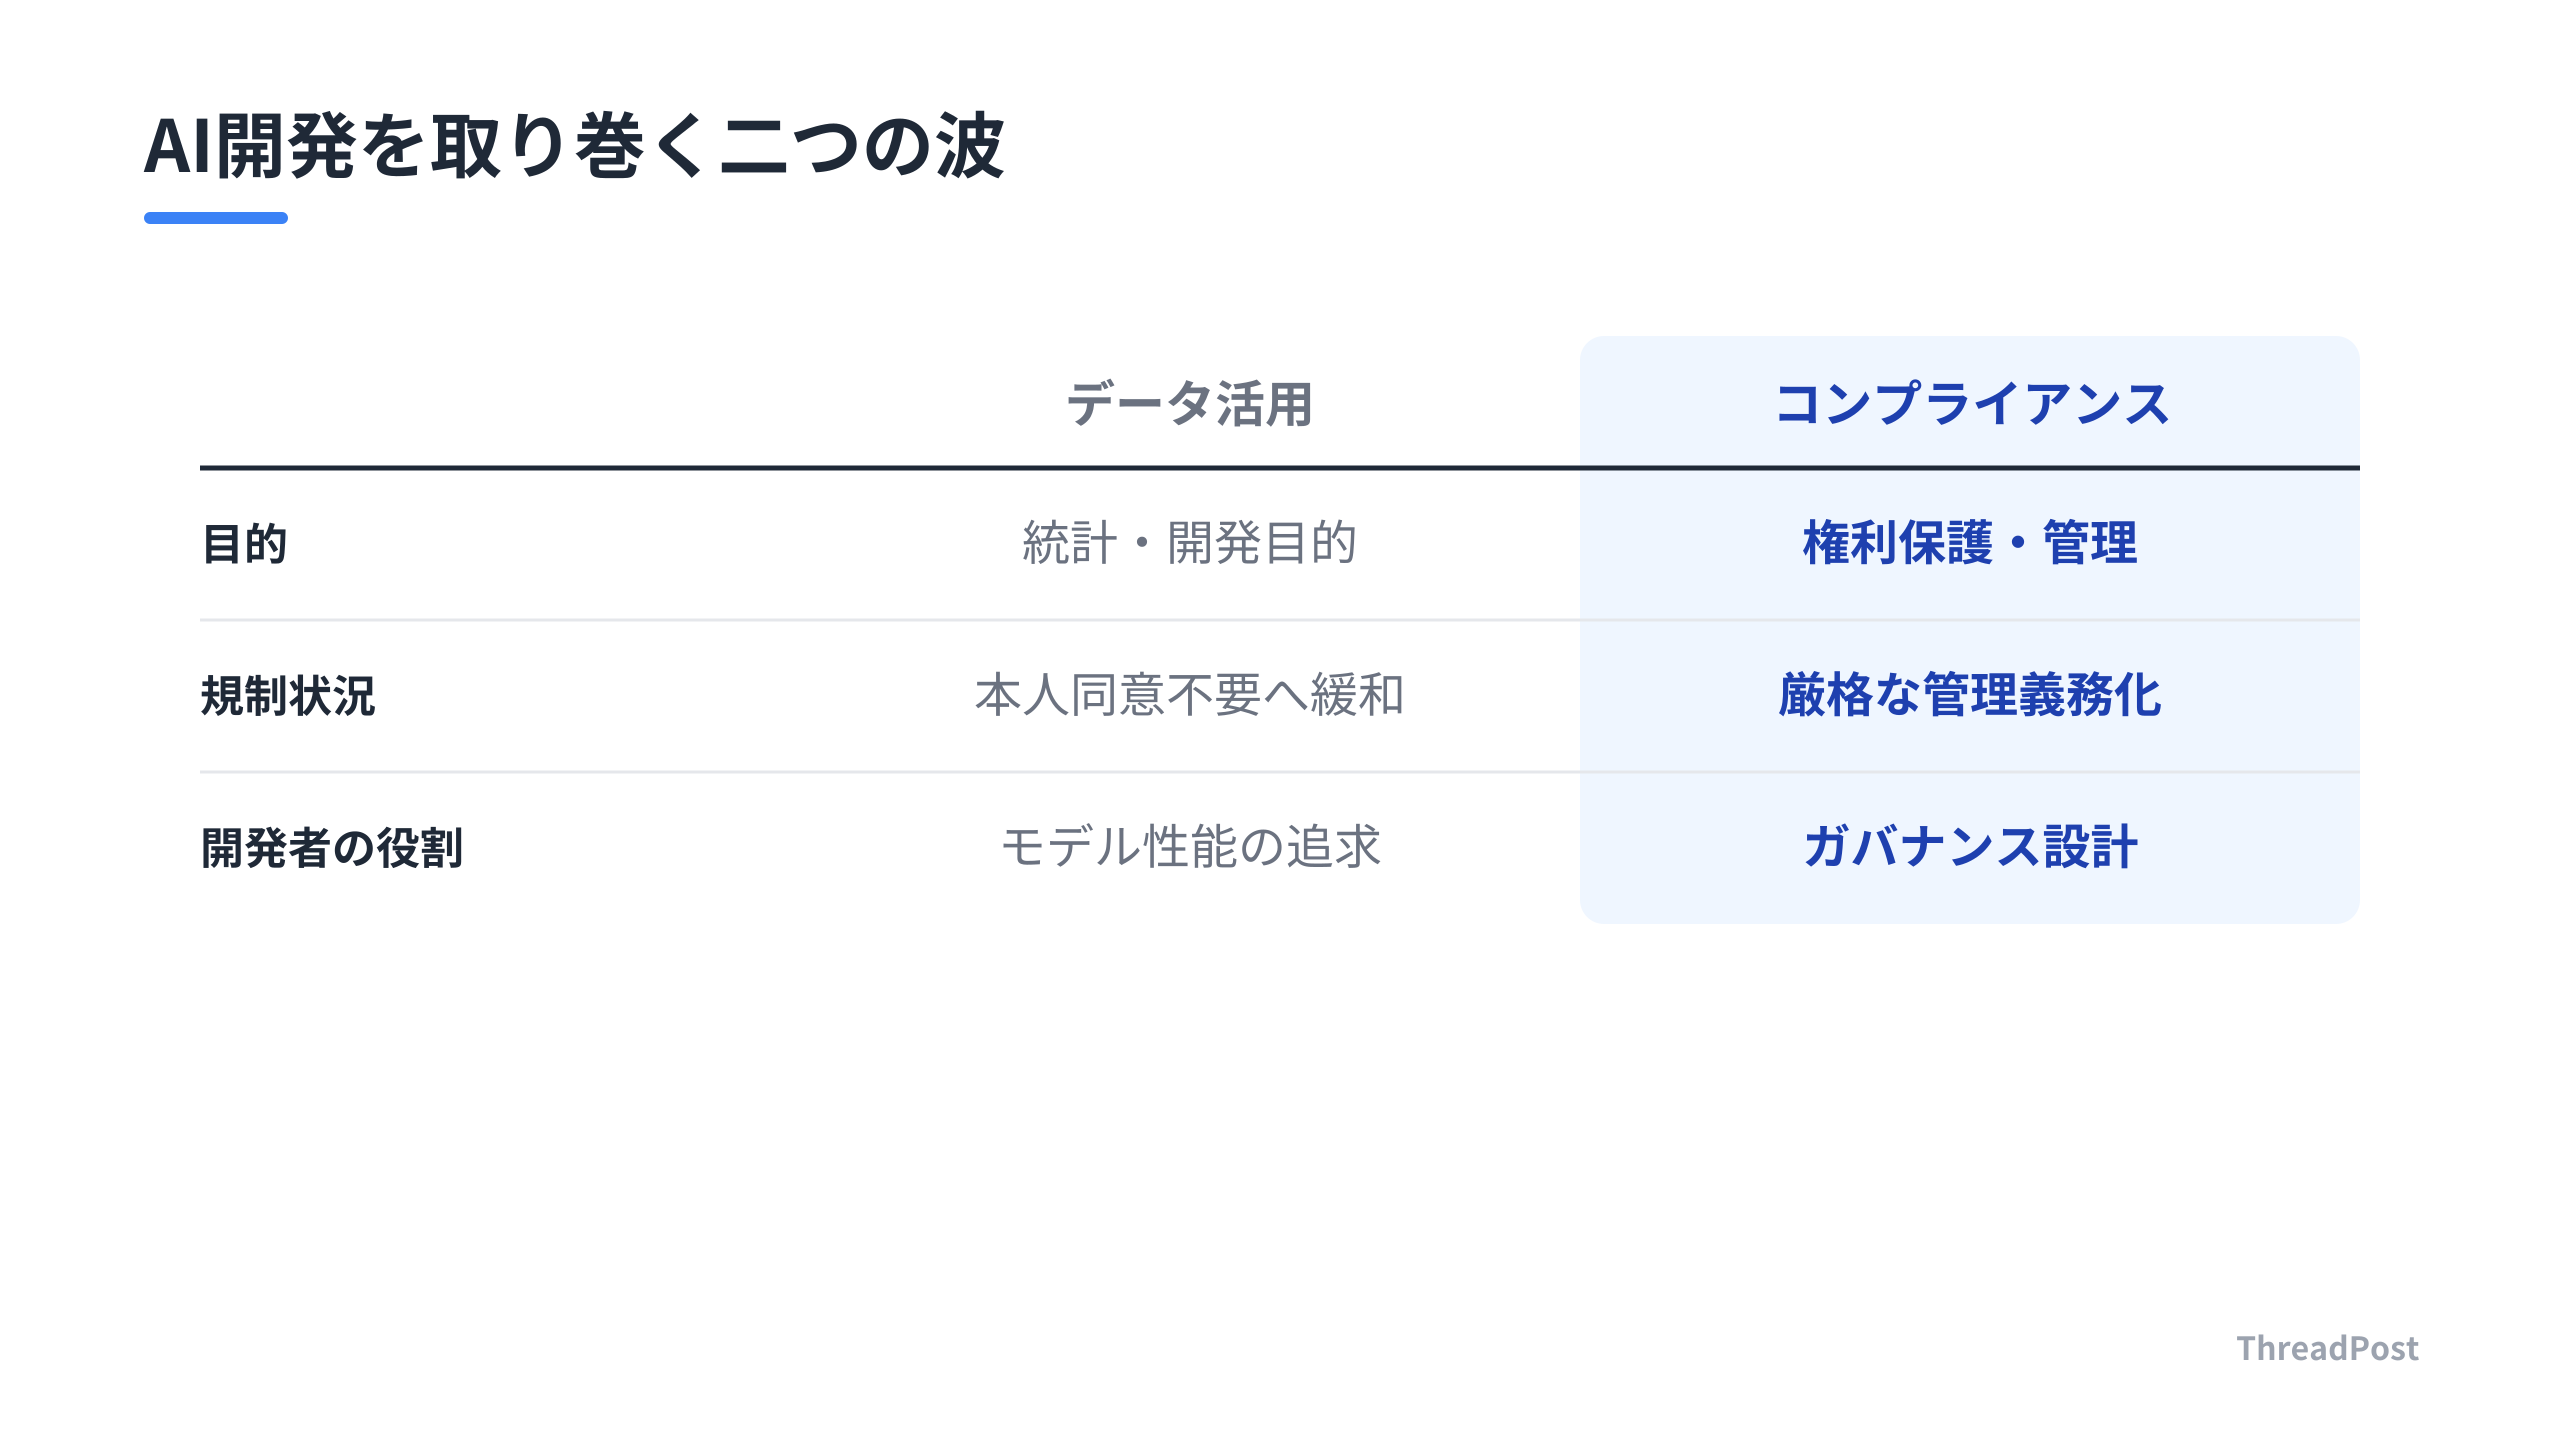
モデルの推論能力以上に、AIに食わせる「データの構造」が結果を左右する。データベースの正規化思想を入力前処理に応用したチームが成果を出している。
GPT-6 Astra時代のAI開発において、なぜ「データエンジニアリング」がプロンプトエンジニアリングを凌駕するのか。自身のSaaS開発で辿り着いた「AIをデータベースとして制御する」ためのデータ構造化の極意を解説する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
AI開発の現場が「GPT-6 Astra」でどう変わったのか
OpenAIが発表した「GPT-6 Astra」は、法務や専門領域のワークフローにおいて、従来のモデルとは一線を画す成果を出している。推論能力の向上以上に、これまでAIが苦手としていた「複雑なドキュメントの構造化」と「文脈の統合」が実務レベルで完結するようになった。
法務テックのスタートアップ「Harvey」は、GPT-6 Astraを導入し、裁判資料や法務文書を統合して構造化されたアウトプットを生成している。単に長いテキストを読み込めるようになっただけではない。ユーザーが「箇条書きで出力してほしい」「特定のソースを優先的に引用してほしい」といった好みを明示的にエンコードできる仕組みを構築し、モデルがそれを正確に反映している。
モデル側が文脈を理解する力を高めたことで、開発者は「AIにどう指示するか」ではなく、「AIが扱いやすい形でどうデータを渡すか」に注力できるようになった。Harveyの事例では、従来のモデルと比較してドキュメントのフォーマット精度が向上しており、弁護士が本来の戦略策定に時間を割いている。
しんたろー:
モデルが賢くなっても、食わせるデータがゴミだと出力もゴミになる。GPT-6 Astraでコンテキストウィンドウが広がったからといって、適当にファイルを突っ込むだけで満足していると、RAGのハルシネーションから抜け出せない。
今回のアップデートで注目すべき事実は以下の通りだ。
* コンテキスト理解の強化: 裁判情報、法律事務所の内部文書、判例研究などの膨大な情報を統合し、完成度の高い文書ドラフトを生成する。
* フォーマット制御の向上: ユーザーが指定したカラーコードや優先ソース、リスト形式などの好みをモデルが正確に学習・反映する。
* ワークフローの短縮: 複雑な文書の統合と整理が自動化され、専門家が手作業で行っていた情報の整理コストが削減されている。
今回のGPT-6 Astraは、入力データの構造を整理すれば、忠実に指示を遂行する。個人開発者がAIを「単なるチャットボット」ではなく、特定のビジネスロジックを処理する「バックエンドエンジン」として組み込む転換点となる。
ドメイン知識が散らばっている複雑なシステムを構築する際、AIに「何を優先すべきか」を明示する仕組みをデータレイヤーで定義できる。テック系スタートアップ各社がGPT-6 Astraへの移行を進めているのは、この「構造化への適応能力」がプロダクトの品質を決定づけるからだ。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
AI開発における「データ構造化」という新たな戦場
GPT-6 Astraの登場で、開発者が理解すべきは「プロンプトエンジニアリングの終焉」ではなく「データエンジニアリングへの回帰」だ。AIの精度が低いシーンの多くは、モデルの能力不足ではなく、入力データの構造がAIにとって読み取りにくい形だったことに起因する。
GPT-6 Astraが法務文書のドラフト作成で高い成果を出している理由は、モデルの賢さだけではない。Harveyのように、法務という構造化しやすいドメインに対して、ユーザーの好みを明示的にエンコードし、AIが処理しやすい形でデータを流し込める環境を整えたことが勝因だ。
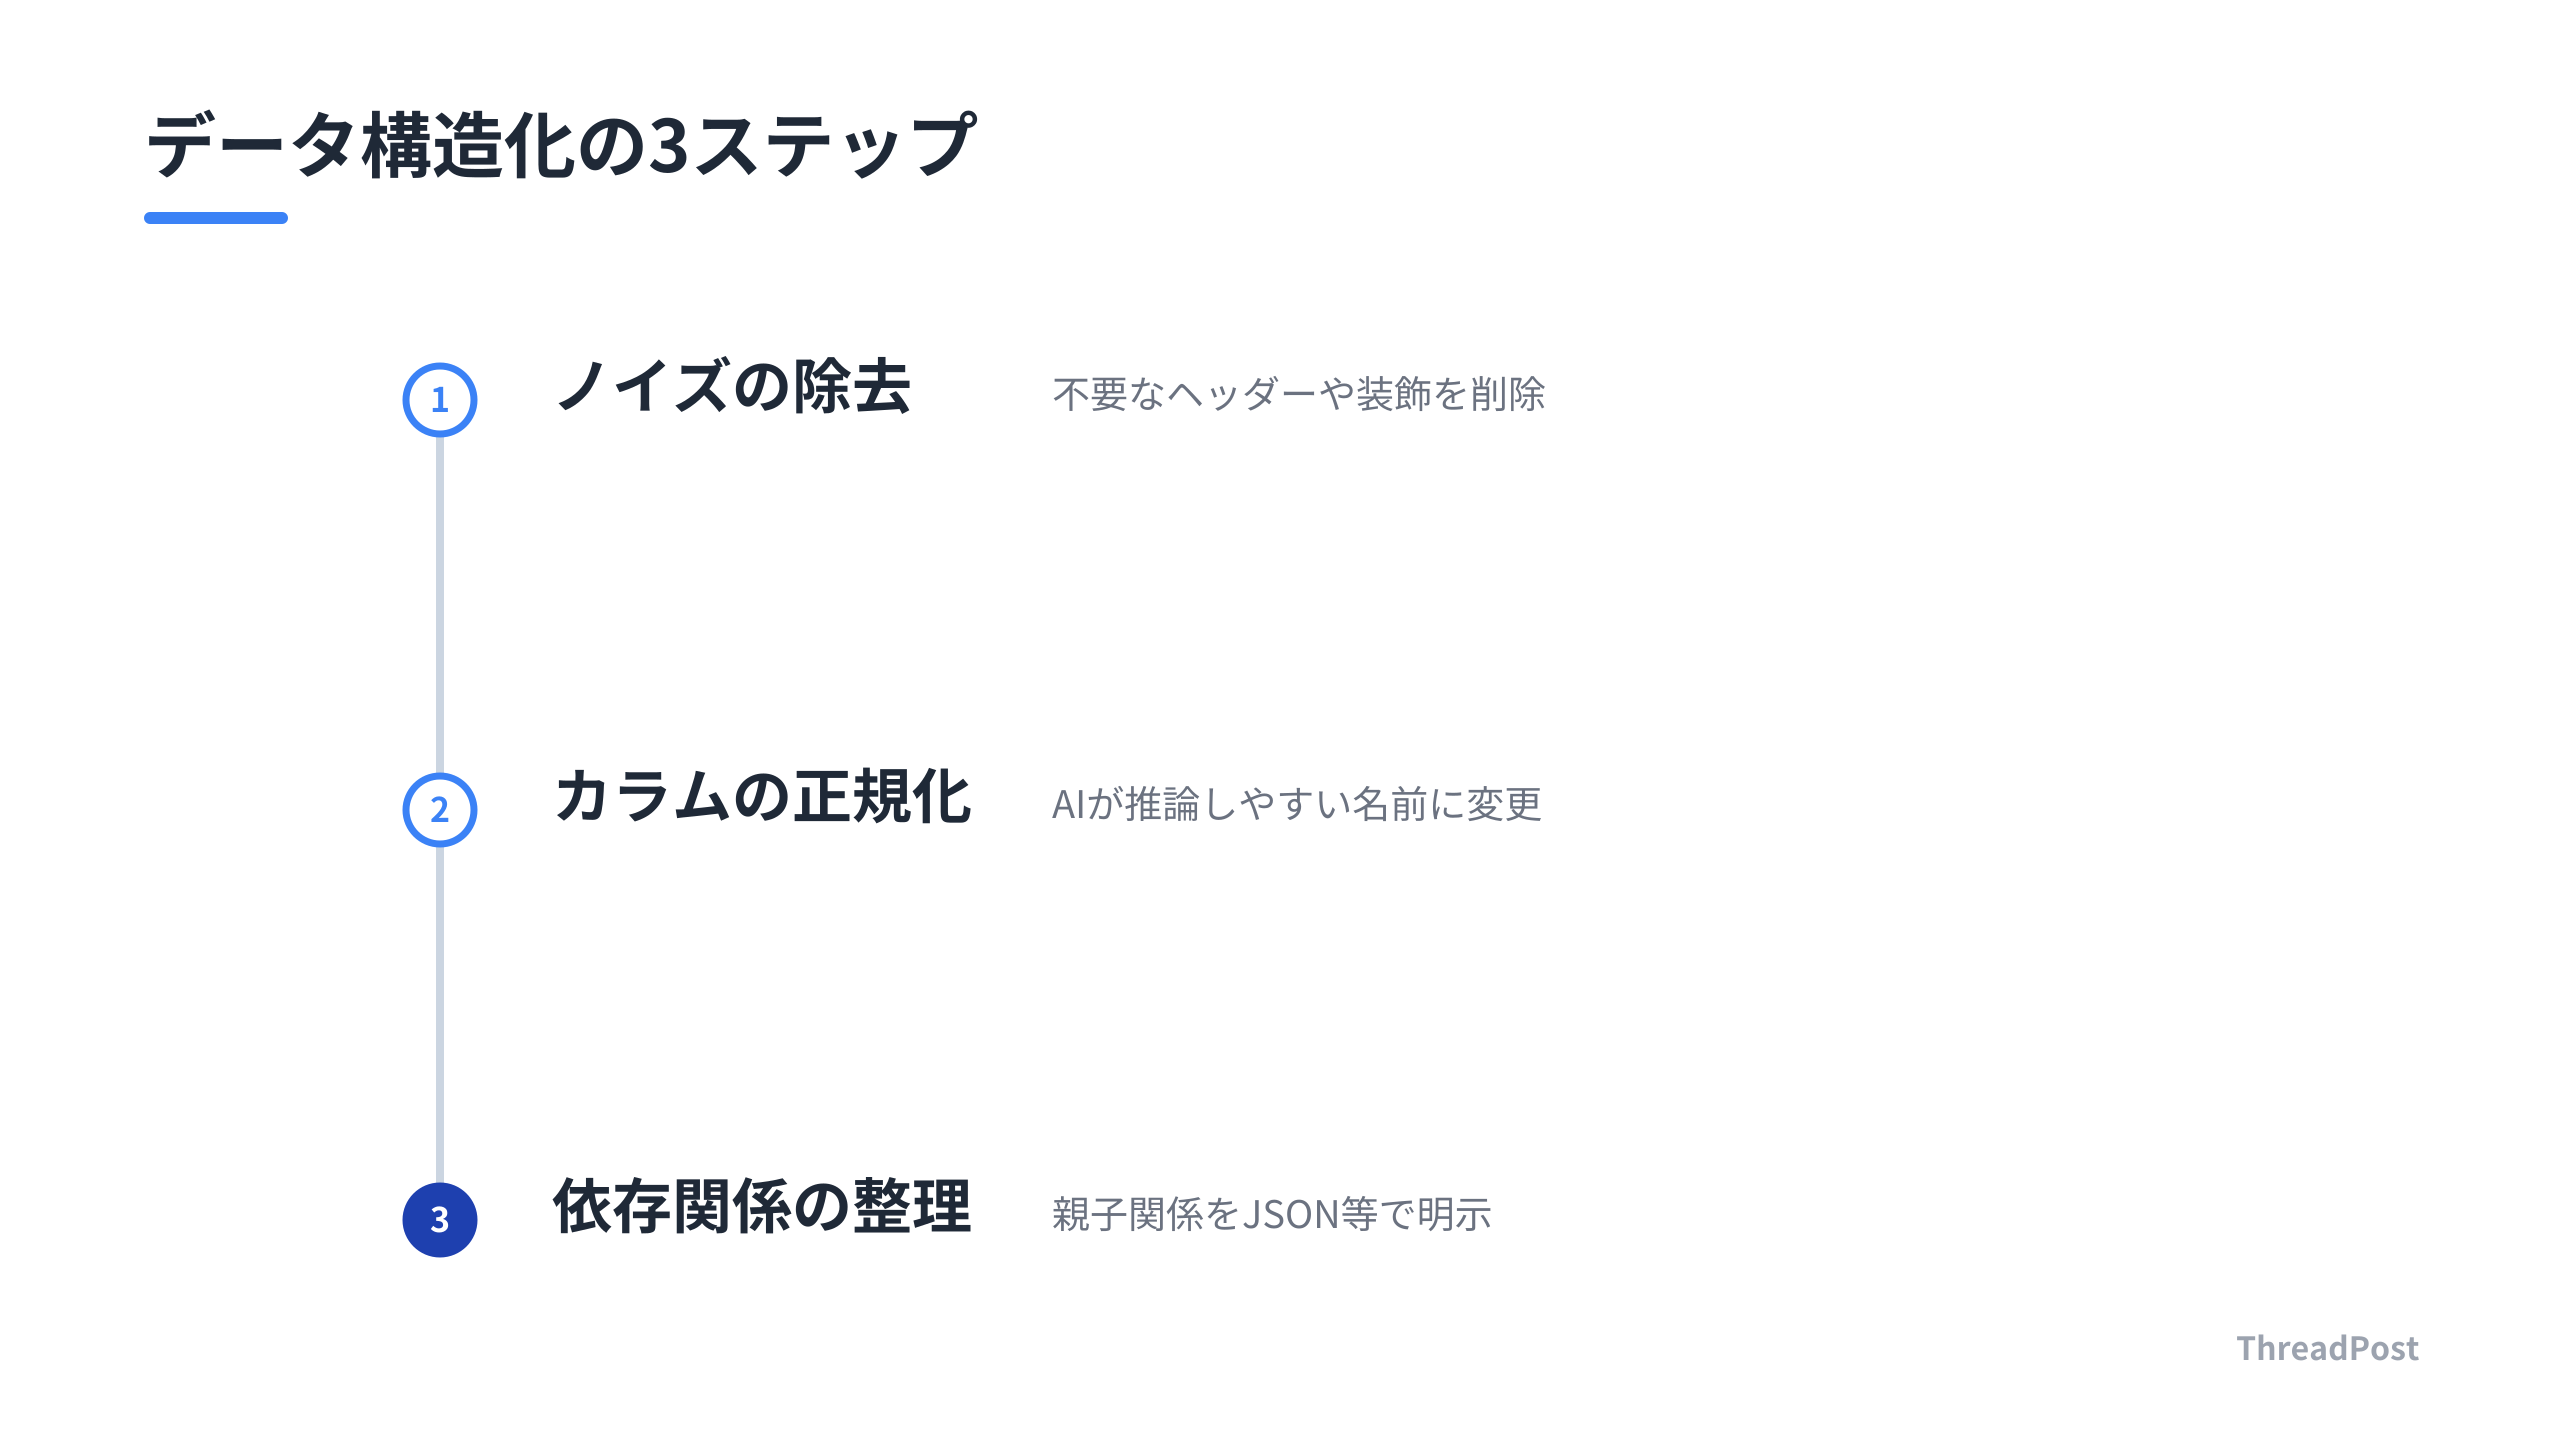
AIをデータベースの設計思想で制御する。AIがどれだけ高度化しても、入力データが人間用の表形式のままであれば、モデルはノイズの海で溺れる。不要なヘッダーを削ぎ落とし、カラム名を正規化し、依存関係を整理する。この作業が今のAI開発においてレバレッジが効くポイントだ。
Claude Codeでコードベースを読み込ませるときも同じだ。全ファイルを突っ込むより、依存関係や主要なデータ構造を整理したドキュメントを添えるだけで、AIの回答精度が変わる。AIに渡す前の下準備が一番の仕事だ。
重要になるのが、AIを疑似的なリレーショナルデータベースとして制御する視点だ。システム開発におけるバリデーションの概念をプロンプトに持ち込む。データが欠損していた場合のフォールバック処理や、計算ルールの優先順位をモジュール化して定義する。AIは「なんとなく良い感じの回答」を出すチャットボットから、特定のビジネスロジックを確実に実行するエンジンへと進化する。
真に勝っているプレイヤーは「AIに何を食わせるか」を磨き込んでいる。GPT-6 Astraのようなモデルは、コンテキストウィンドウが広がるほど、入力されるデータのゴミも忠実に拾い上げる。開発者が行うべきは、AIへの命令から、AIが処理しやすいデータ構造への変換へとスキルセットをシフトさせることだ。
1人SaaS開発者にとって、この事実は追い風だ。大規模なモデルを自前でファインチューニングしなくても、データベース設計の知見をAIの入力前処理に応用するだけで、精度の高いAI機能が実装できる。AIの性能を最大限引き出すためのデータ構造化の技術は、エンジニアにとって必須の教養だ。
AIをブラックボックスとして扱う時代は終わり、AIをいかに効率的にデータベースとして活用するかという、エンジニアリングの基礎体力勝負の時代が来ている。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
AI開発の現場で明日から変えるべき「データエンジニアリング」の習慣
GPT-6 Astraのようなモデルが登場しても、開発者がやるべきことはプロンプトの調整よりもデータ構造の正規化だ。実務においては最もROIが高いアクションだ。
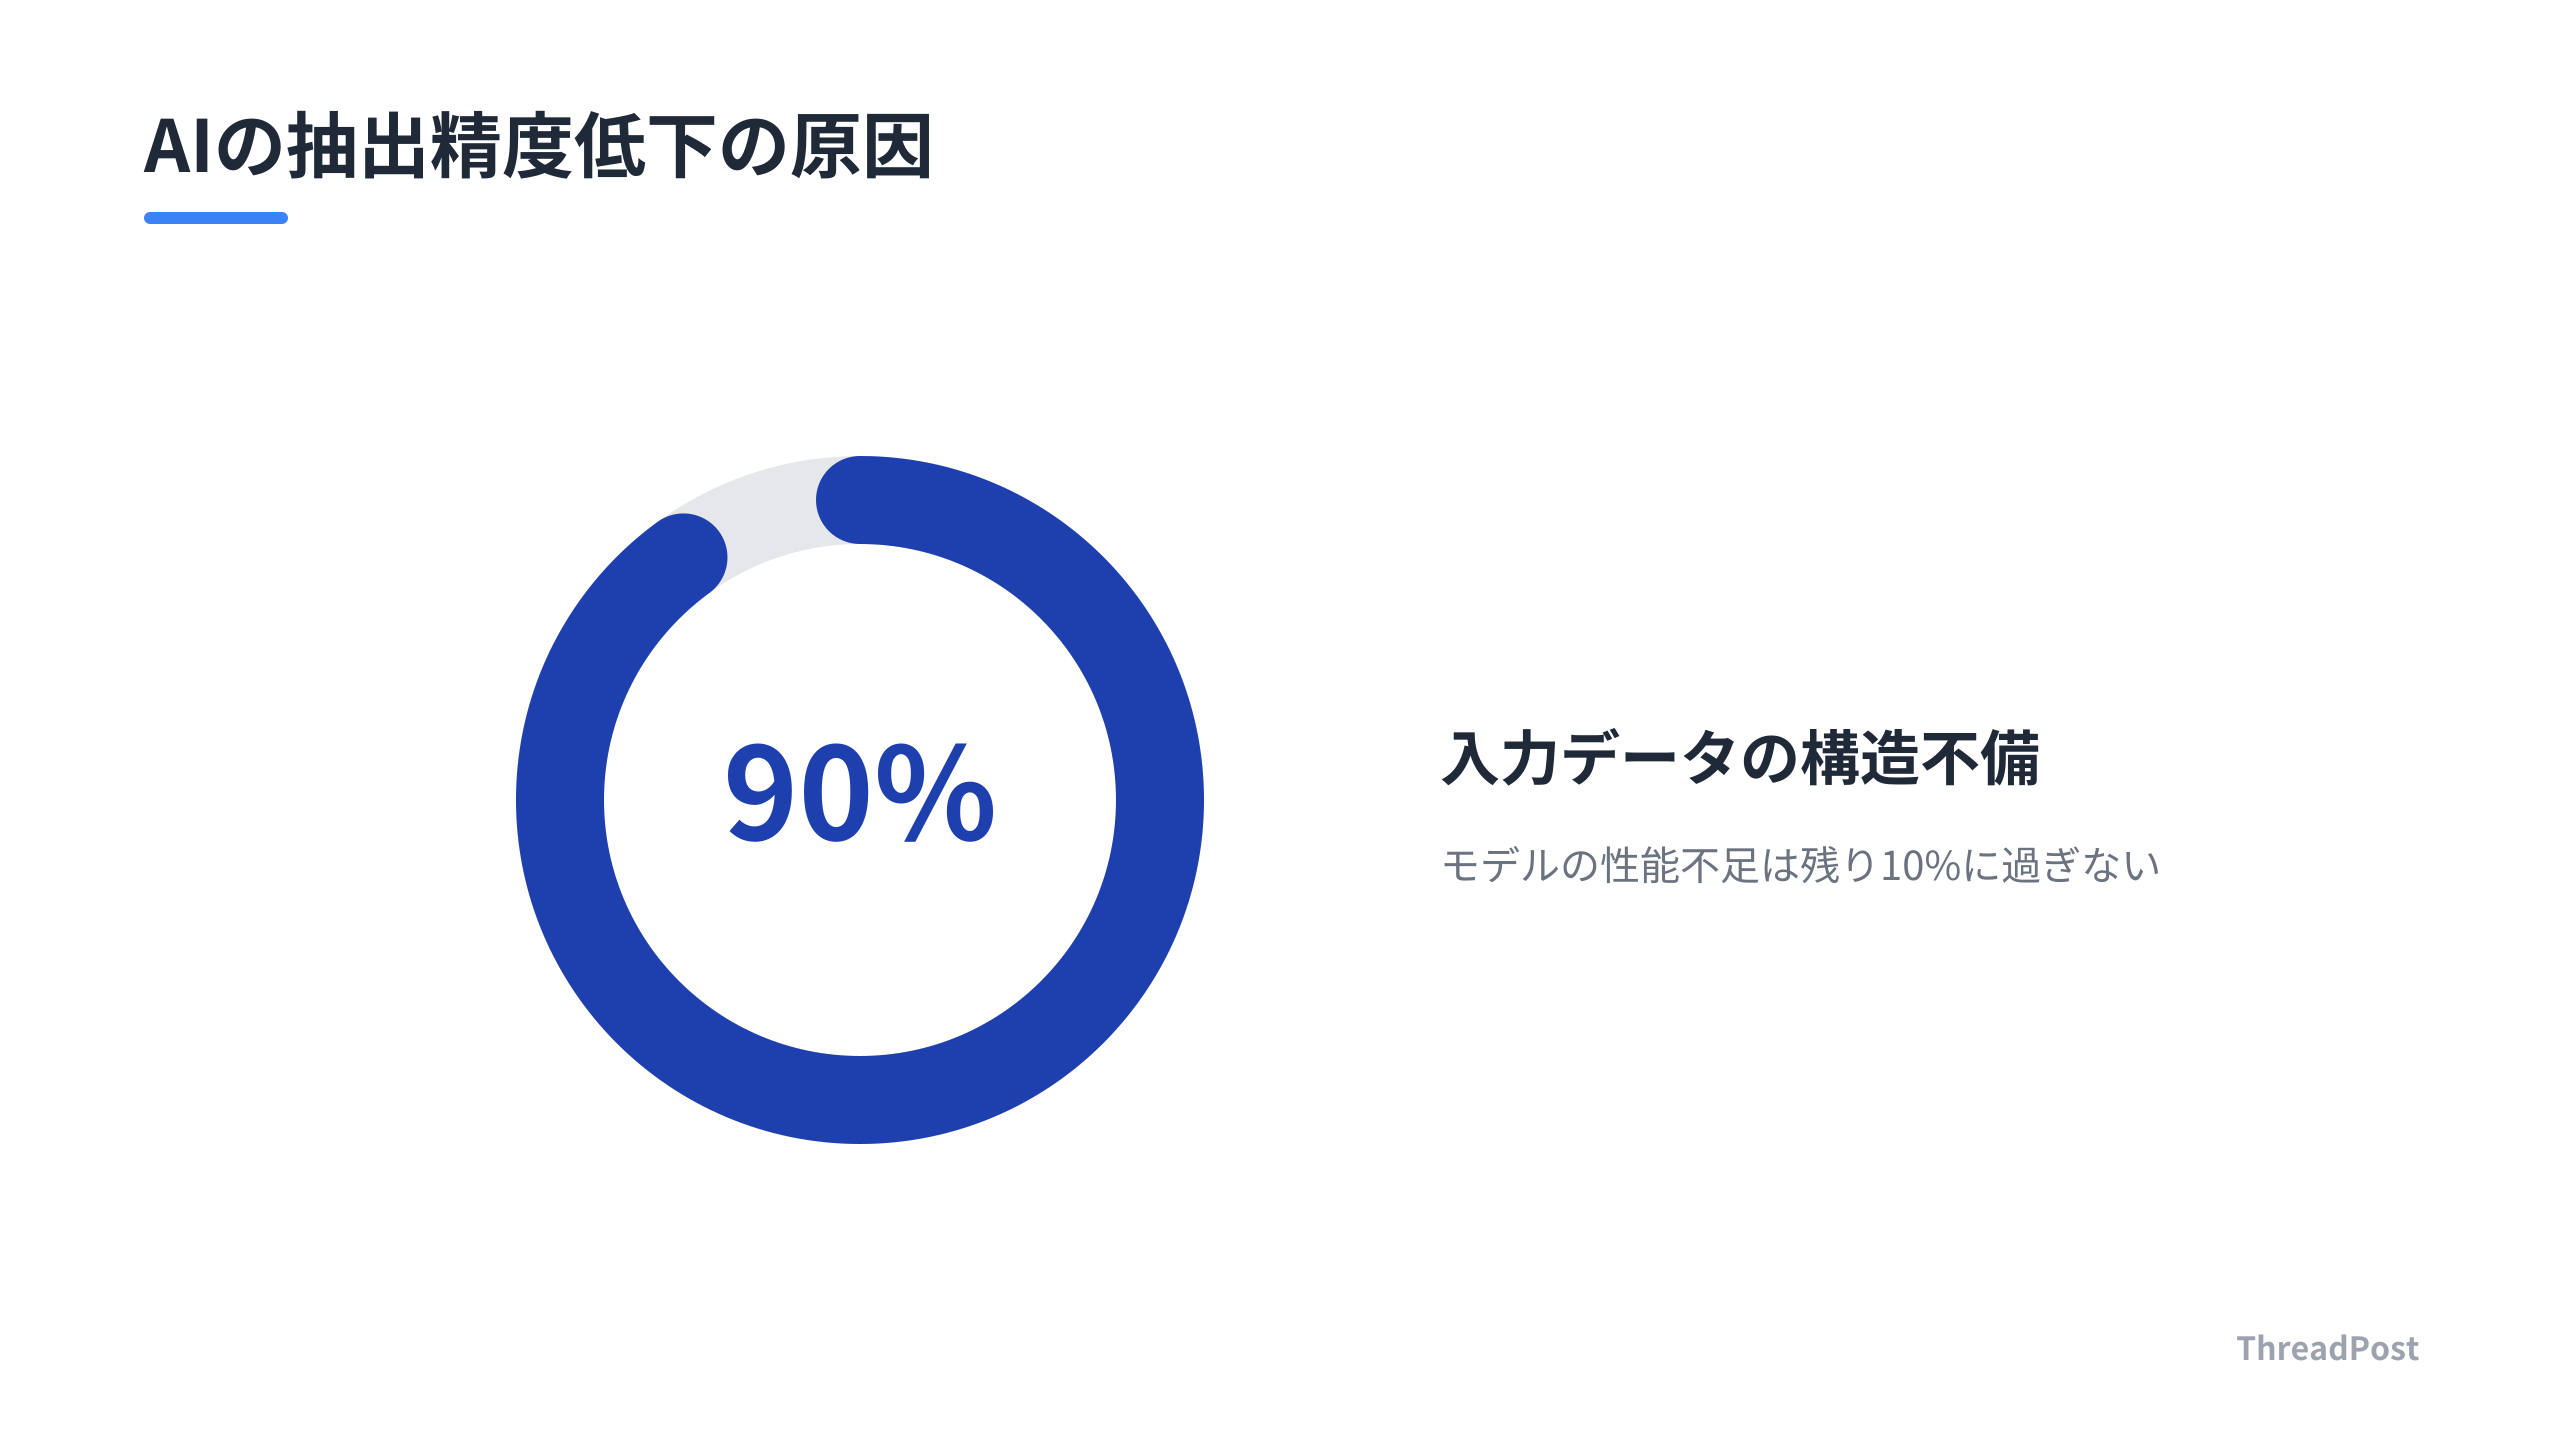
まず、既存のRAGパイプラインを見直す。AIに読み込ませているドキュメントやCSVは、人間が見やすい表形式になっていないか。結合セルや複雑なヘッダーが残っているなら、それはモデルにとってのノイズだ。AIが情報を正確に抽出できない原因の9割は、モデルの性能不足ではなく、入力データの構造にある。
次に、データベース設計の知見をコンテキスト構築に持ち込む。API経由でモデルにデータを渡す際、単にドキュメントをベクター化して投げるのではなく、依存関係や属性を整理した構造化データとして前処理する。JSON形式で親子関係を明示したり、カラム名をAIが推論しやすい具体的な名前にリネームするだけで、回答の精度は安定する。
Claude Codeでコードベースを読み込ませるときも、ゴミファイルを大量に含めるとAIが迷走する。RAGも同じで、いかにノイズを削ぎ落として本質的な構造だけを渡すかが、開発者の腕の見せ所だ。
AIを計算機としてではなく、疑似的なリレーショナルデータベースとして設計する。ハルシネーションを防ぐために、プロンプトで命令するのではなく、値が欠損した場合のデフォルト値や、計算ロジックの優先順位を定義したマスタールールを別ドキュメントとして切り出す。これをシステム的なバリデーションとして組み込むことで、AIの出力は予測可能な範囲に収束する。
最後に、AIの出力を一度アプリケーション層で受け取り、型定義やバリデーションを通す。AIは強力な推論エンジンだが、その出力は不確定要素を孕んでいる。AIからのレスポンスをデータベースのレコードのように扱い、アプリケーション側で整合性をチェックする仕組みを設けるだけで、プロダクトの信頼性は上がる。
これからは、AIの進化を待つよりも、AIが理解しやすいようにデータを整える方が、開発者としての市場価値は高まる。明日からは、プロンプトをいじる前に、まずデータの構造を眺める。そこを整理するだけで、今まで解決できなかった不具合の多くが消え去る。
 あわせて読みたい【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録 →
よくある質問
AIがデータを正しく読み取れない場合、まず何をすべきですか?
モデルの性能を疑う前に、入力データの構造を徹底的に見直す。AIは人間が読みやすい表形式(結合セルや空行を含むPDFやExcel)を苦手とする。まずは不要なヘッダーや装飾を排除し、1行1レコードのCSV形式にフラット化(正規化)する。列名が曖昧な場合は、AIが文脈を推測せずに済むよう、具体的でユニークなカラム名に変更する。
AIのハルシネーションをプロンプトで防ぐには?
抽象的な命令ではなく、システム開発のバリデーションの概念を導入する。具体的には、データが欠損している場合の処理を明記し、ルールをモジュール化して別ドキュメントとして読み込ませる。「値が空の場合は0とみなす」「計算式は〇〇法を優先する」といった厳格な条件分岐を定義することで、AIを疑似的なリレーショナルデータベースとして制御する。
Claude Codeで大規模なコードベースを読み込ませる際のコツは?
全ファイルを投げ込むのではなく、依存関係や構造を整理したマッピング情報を一緒に渡す。AIはファイルの物理的な量よりも、論理的な構造を理解するほうにコンテキストの容量を割く。ディレクトリ構成図や主要な関数定義のインデックスを作成し、それをシステムプロンプトとして認識させることで、Claude Codeは目的のロジックに対して精度の高い修正提案を行う。
まとめ
AIは魔法の箱ではない。出力の質は入力データの構造に依存する。最新モデルがどれだけ賢くなっても、開発者がやるべきデータエンジニアリングの本質は変わらない。
プロンプトを工夫する段階から、AIが処理しやすいデータの形を整える段階へ。この一手間を惜しまないだけで、AI開発の精度は変わる。Claude Codeを使いこなすのも、自分のコードをいかにAIに分かりやすく構造化して渡すかという、基本の積み重ねだ。
AIの性能を最大限引き出すためのデータ構造化の技術を、開発ワークフローに取り入れる。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
