


同じ画像を何度もAPIへ送信し、無駄な通信量とコストを発生させていませんか?
DeepSeekの「Files API」は画像データの使い回しを可能にします。しかし、これが直接的なコスト削減に直結するわけではありません。開発者が注目すべきは、API経由の転送量最適化と、自前ホスティング環境における「推論エンジン側のKVキャッシュ分離」という2つの異なるレイヤーの最適化戦略です。
この記事では、Claude Codeで1人SaaS開発を行う僕が、実務で直面したコスト構造の壁と、それを突破するためのアーキテクチャ最適化の勘所を解説します。推論コストを削るための「賢い使い分け」を紐解いていきましょう。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
ニュースの概要:DeepSeekが提示したマルチモーダルAPIの最適化
今回注目すべきは、DeepSeekが公開したマルチモーダルモデル「deepseek-v4-flash-vision-exp」と、同時にリリースされた「Files API」です。
これまで、GUIエージェントなどでスクリーンショットを解析させる際、APIはステートレスであるため、会話が続くたびに同じ画像を何度もHTTPリクエストボディに含めて送信する必要がありました。この「毎回丸ごと再送」という仕様が、不要な通信帯域を消費していました。
今回登場した「Files API」は、画像を一度だけサーバーにアップロードし、生成された「file_id」を使って後続のターンで参照できる仕組みです。
公式の仕様によれば、このAPIは1ユーザーあたり最大25 GiB、あるいは10,000ファイルまで保存可能です。保存期間は最大30日間まで設定できます。
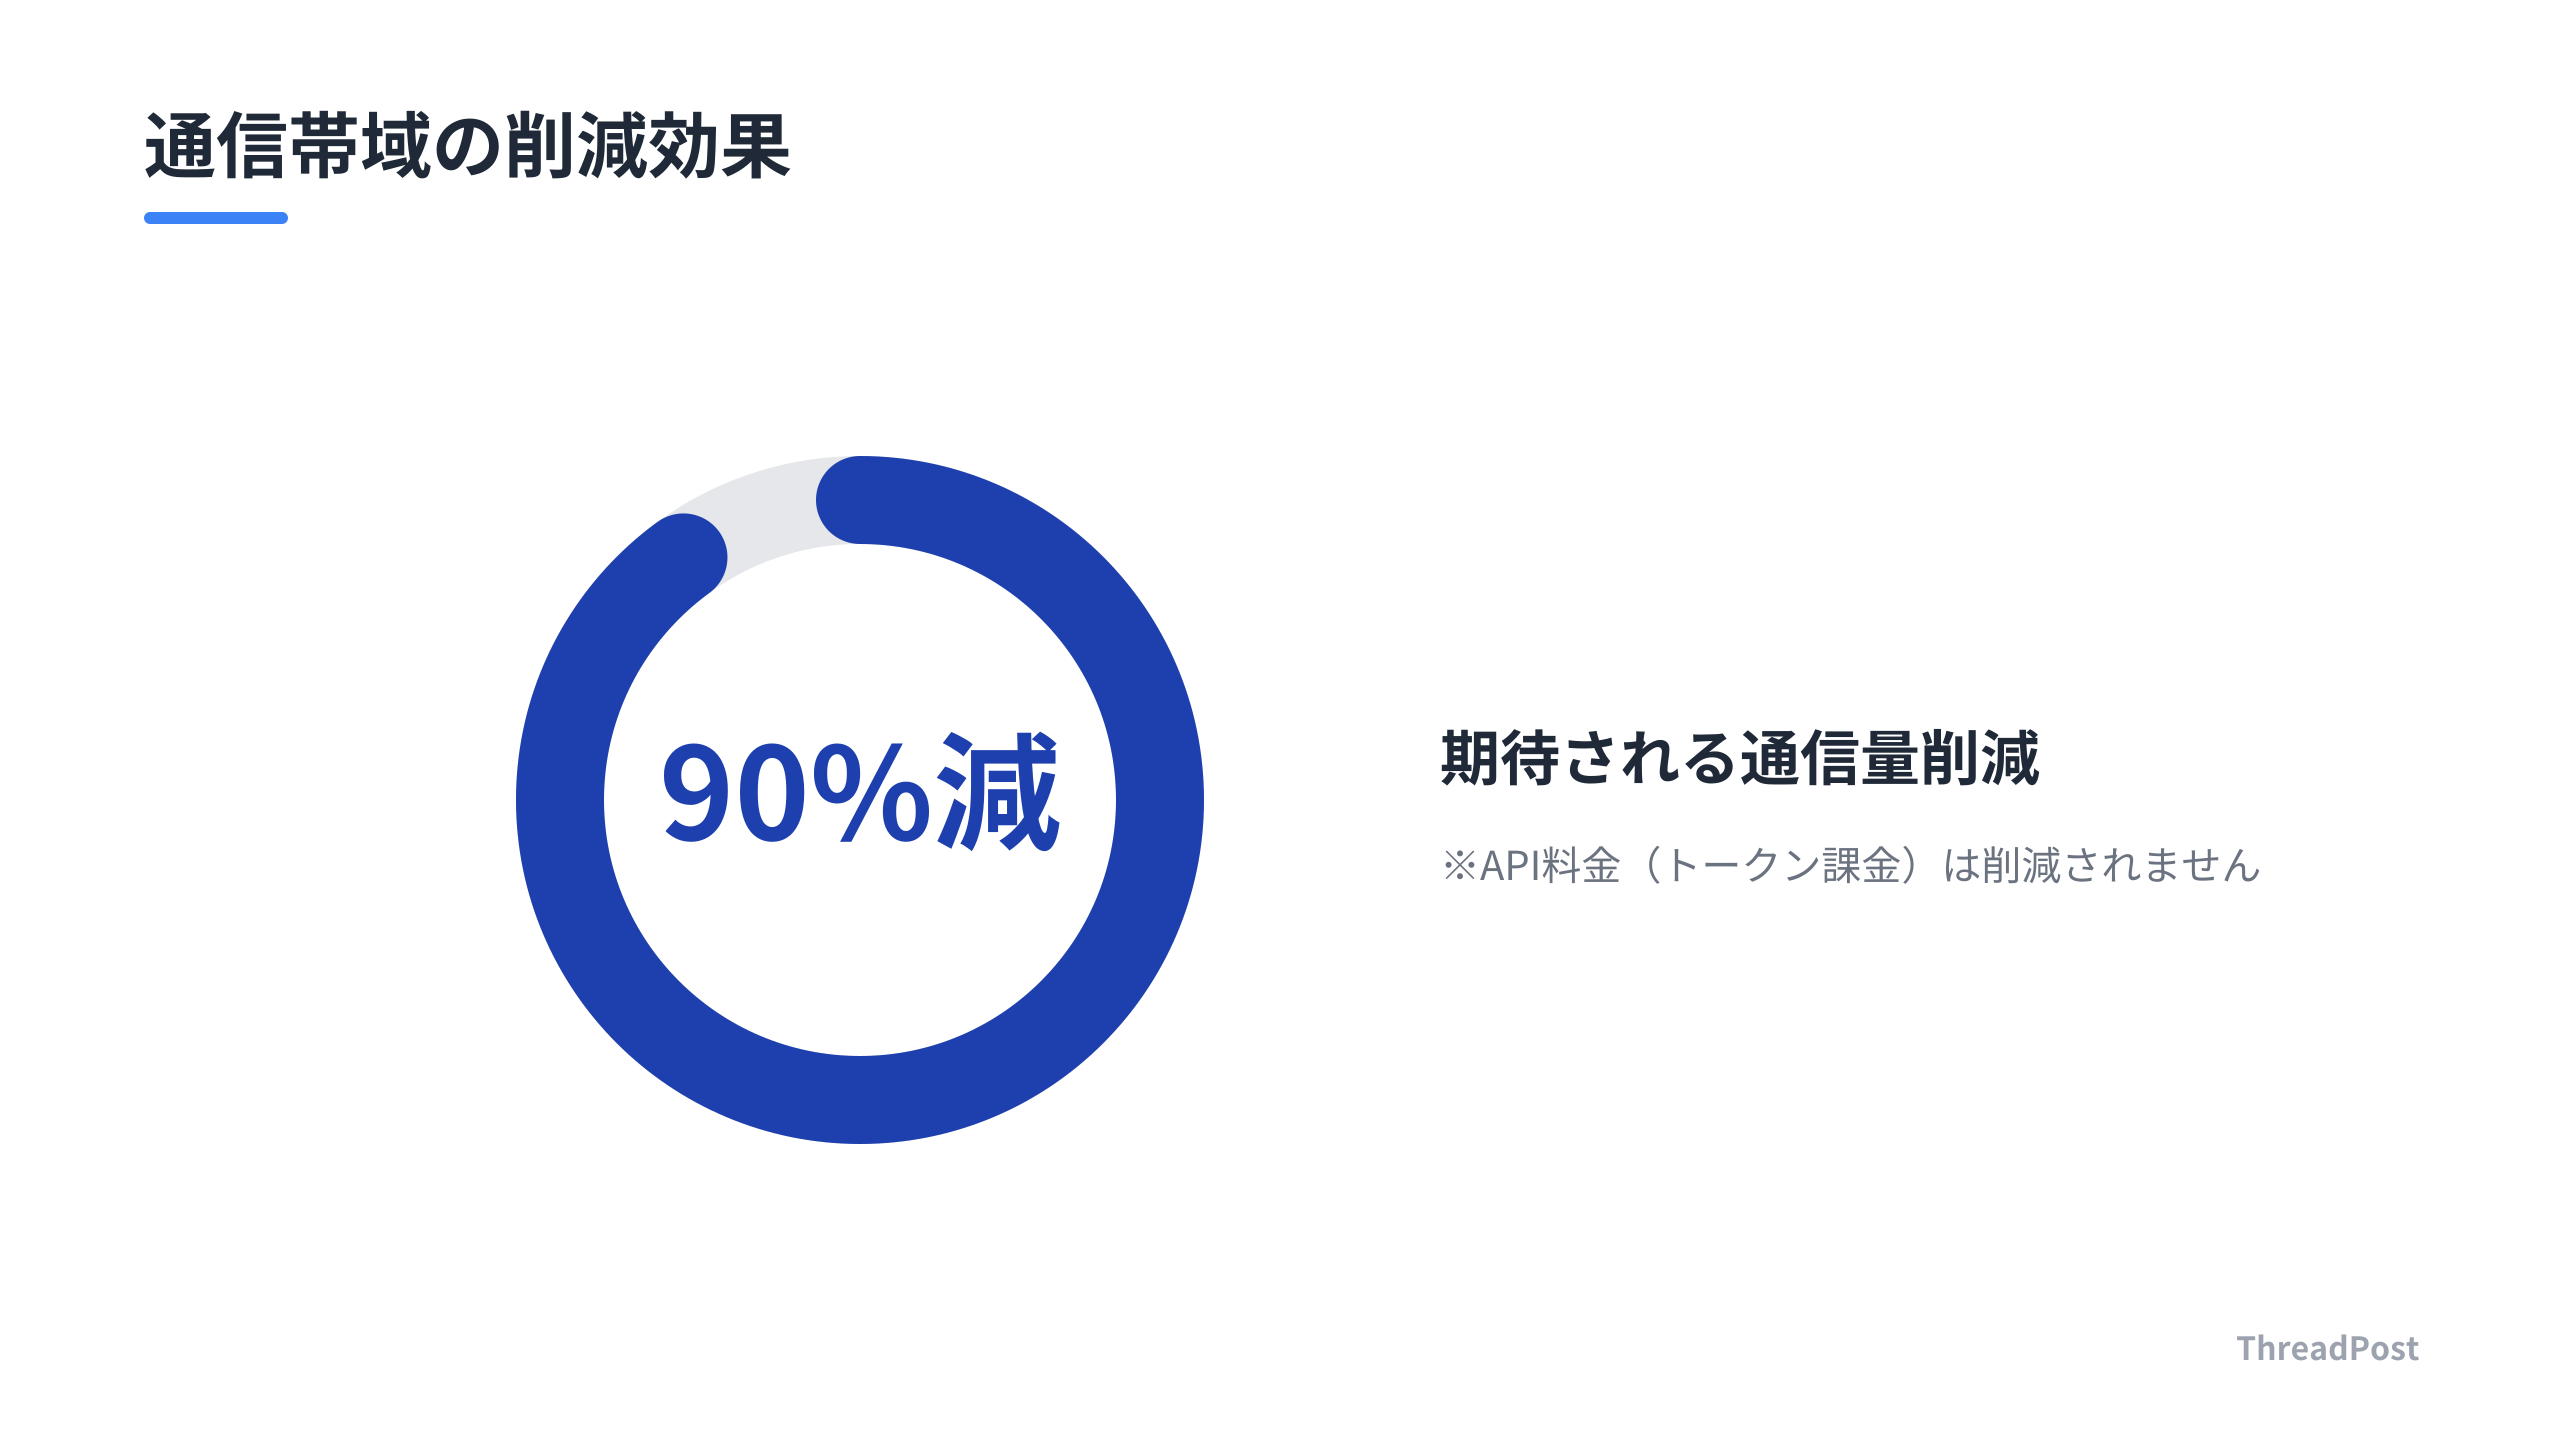
ここで重要な事実があります。公式アナウンスでは「帯域の節約」については言及されていますが、API料金そのものが安くなるとは書かれていません。
画像データは依然として「最大384トークン」として計算され、通常どおりの料金体系で課金されます。Files APIはあくまで「通信量を減らすためのツール」であり、直接的なトークン課金の削減を約束するものではありません。
しんたろー:
「帯域削減」と「コスト削減」を混同すると、請求書を見て驚くことになるね。通信環境が不安定な現場ならまだしも、API課金体系を理解せずに導入しても、トークン消費量が変わらなきゃ意味がない。この「期待と現実のズレ」を冷静に測れるかどうかが、エンジニアの分かれ道だ。
一方で、より高度なインフラ環境では「LMCache」を活用した最適化が進んでいます。
こちらはAPI利用ではなく、vLLMなどの推論エンジンを自前でホスティングする場合のアーキテクチャです。Prefill(入力処理)サーバーとDecode(逐次生成)サーバーの役割を分離し、推論の中間状態である「KVキャッシュ」を外部のストレージを介して共有する手法です。
これにより、同じプロンプトを扱う複数の推論リクエストに対して、キャッシュを再利用することでPrefill時間を短縮できます。
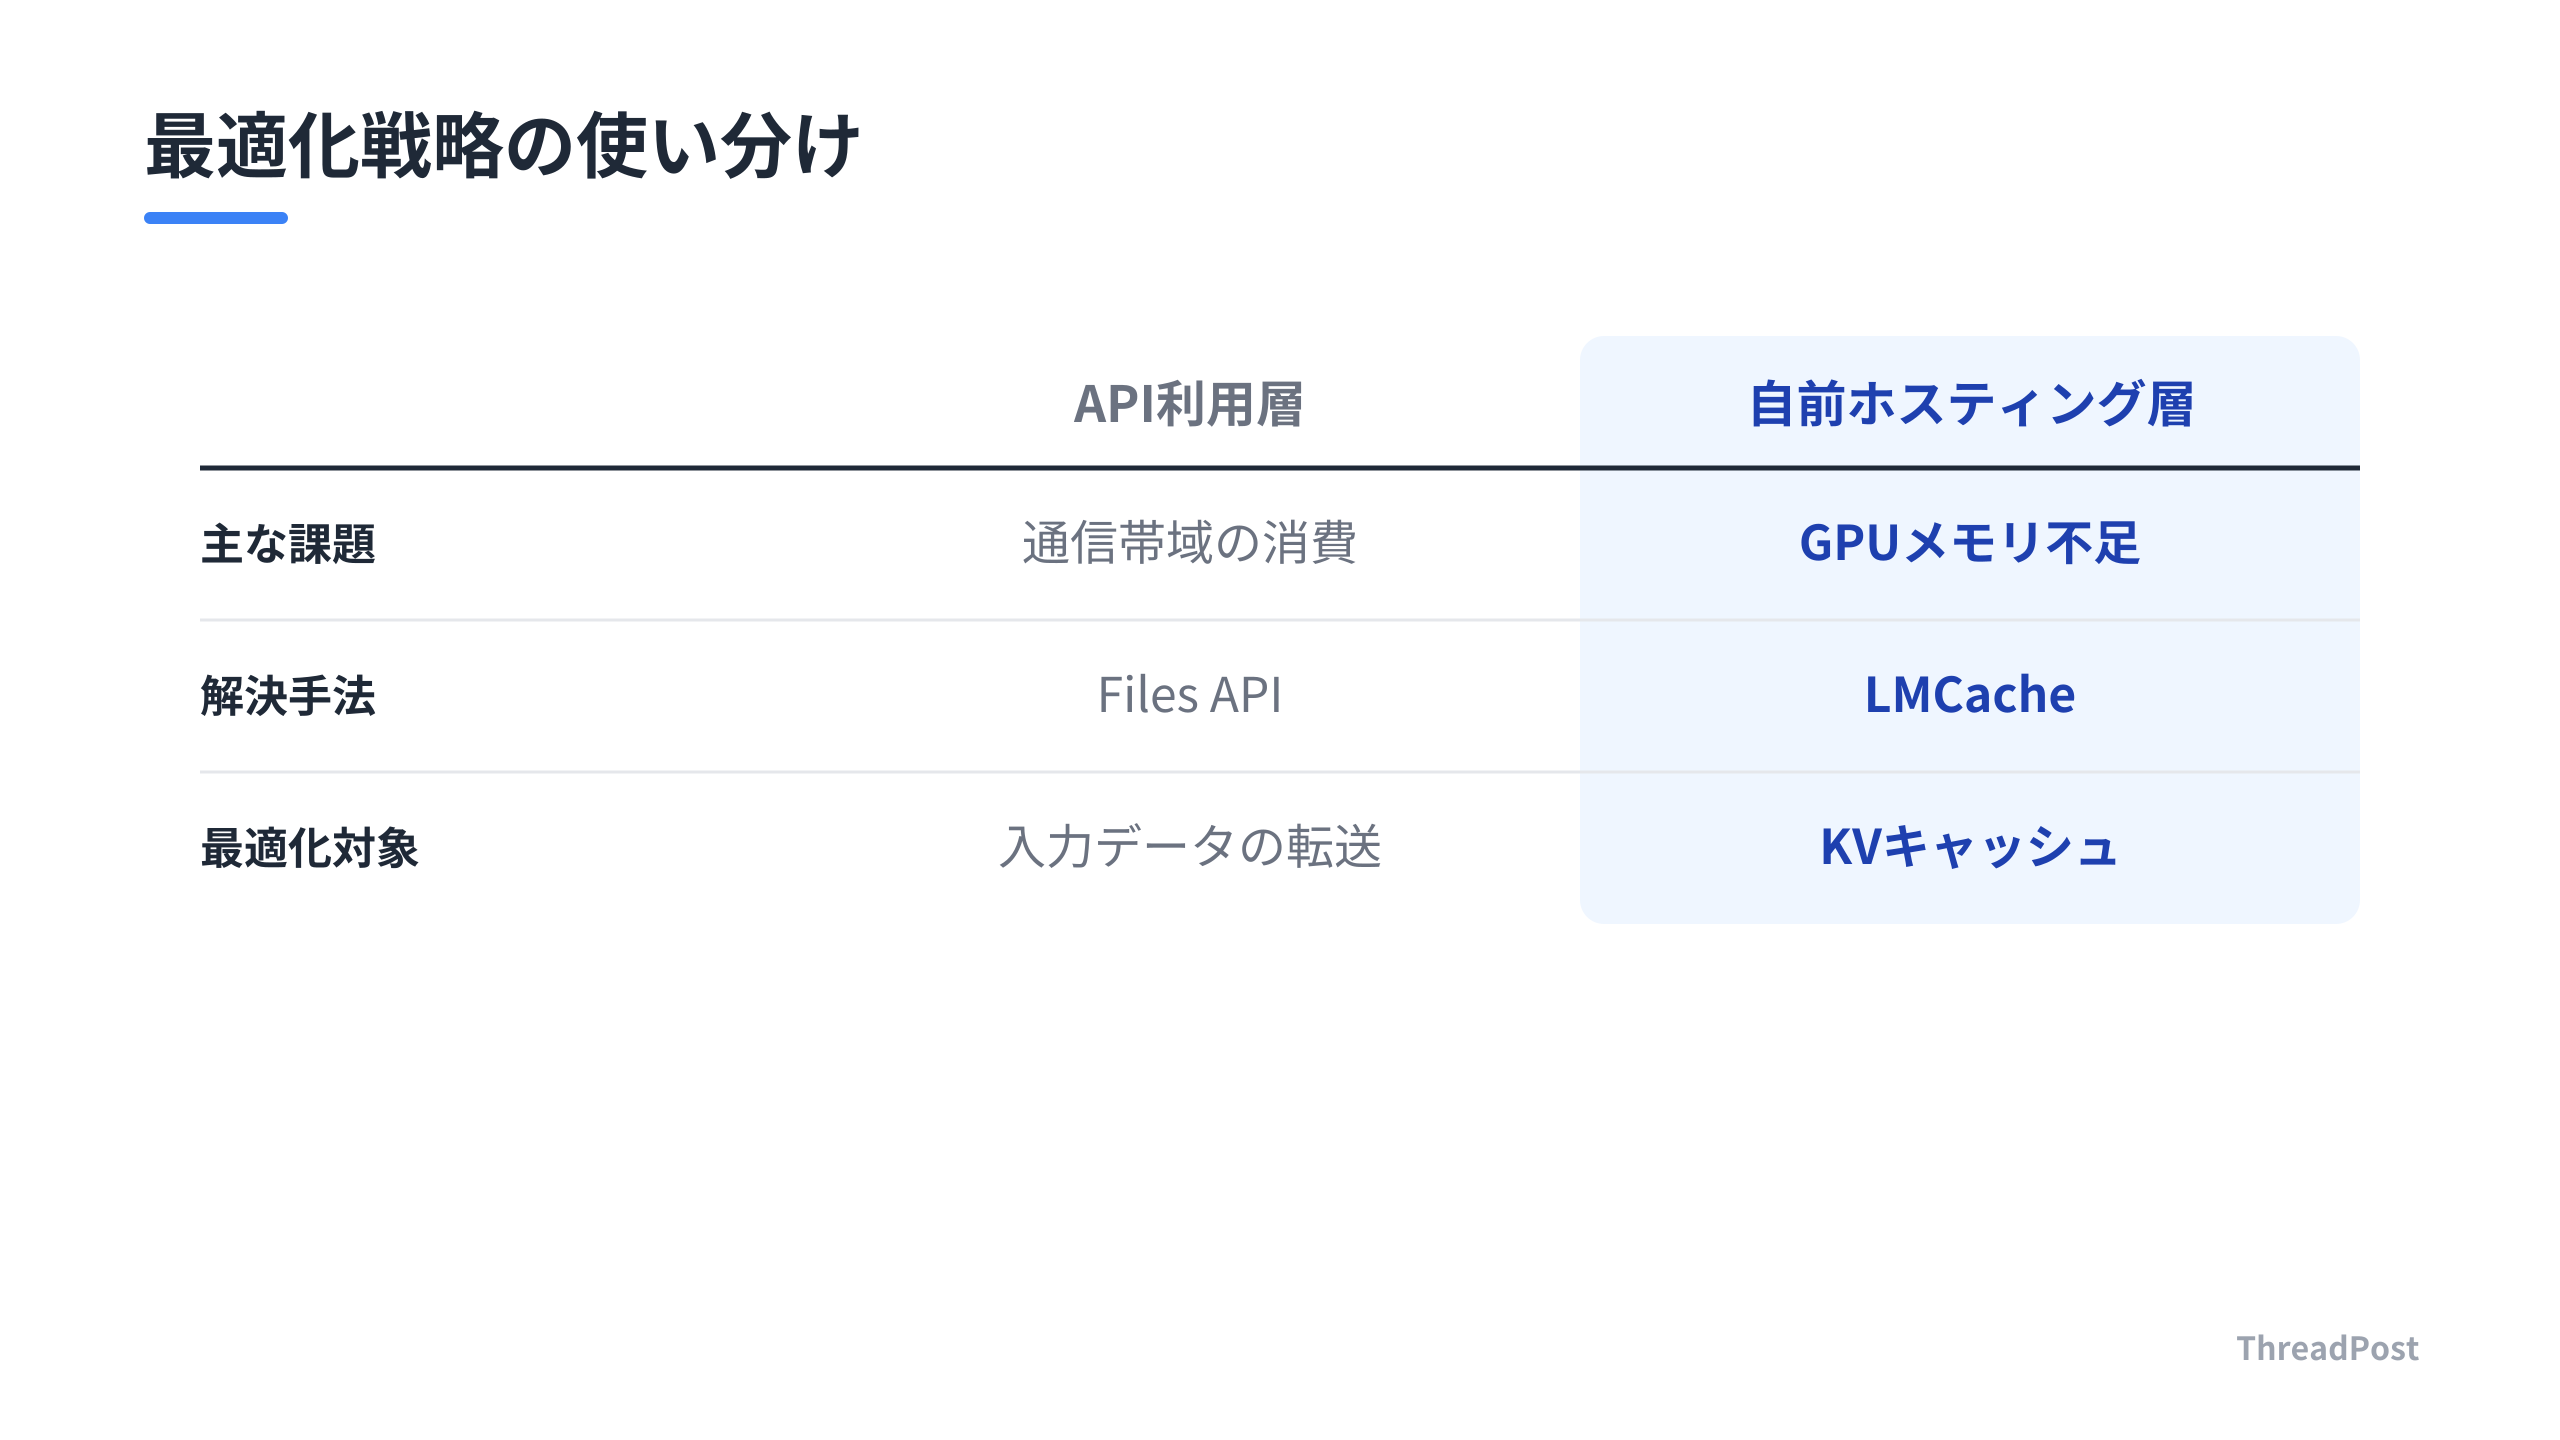
まとめると、現在のAI開発における最適化は以下の2層構造です。
* API利用層: Files APIを活用して、リクエストボディの肥大化を防ぎ、通信リソースを最適化する。
* 自前ホスティング層: LMCache等を用いて、推論エンジン内部のKVキャッシュを外部管理し、スケーラビリティと実行速度を確保する。
これら2つのアプローチを、自分の開発環境のスケールに合わせて使い分けることが、現在のAI開発者に求められています。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
AIアーキテクチャの多層最適化:転送量削減からKVキャッシュ分離へ
今回のDeepSeekによるFiles APIの公開と、自前ホスティング環境でのLMCacheの活用は、開発者の視点で共通しています。それは「推論のステート(状態)をどこに置くか」というアーキテクチャ上の戦略です。
多くの開発者が陥りやすい罠は、APIのコストを単なる「トークン課金」だけで捉えてしまうことです。特にマルチモーダルなエージェントを構築していると、同じスクリーンショットや画像を何度もAPIへ送信する「無駄な帯域消費」が積み重なり、レイテンシとコストを押し上げます。Files APIの本質は、この「入力データの固定化」です。一度アップロードしてしまえば、以降はIDを参照するだけで済みます。これはAPIの課金体系そのものを変えるわけではありませんが、リクエストのオーバーヘッドを削るという意味で、実用的なスケーリングには不可欠なピースです。
一方で、自前でvLLMなどをホスティングする環境では、話はシビアになります。推論エンジンが内部で生成するKVキャッシュは、GPUメモリを消費するボトルネックです。ここでLMCacheのような技術が登場します。これは入力データの効率化というレベルを超え、推論の「計算済み状態」を外部ストアにオフロードします。PrefillとDecodeを分離し、外部ストレージを介してキャッシュを共有する構造は、分散システムにおけるDBの読み書きに近いものです。
Claude Codeでエージェントを作っていると、プロンプトの履歴が長すぎてAPIの制限に引っかかるのがストレスだ。Files APIで画像だけでも外部化できれば、コンテキストウィンドウの節約にもなるし、コードの記述もシンプルになる。この「状態の外部化」という考え方は、1人SaaS開発のインフラ設計にも応用できる。
この2つのアプローチの間には、利用形態による明確な境界線があります。API経由で利用するなら「入力の固定化」による転送帯域の最適化に注力すべきです。自前ホスティングで高負荷なエージェントを動かすなら「推論状態の固定化」によるメモリ管理が勝負になります。
開発者が注意すべきは、これらの最適化が「トレードオフの上に成り立っている」という事実です。例えば、LMCacheでキャッシュを外部ストアに逃がすと、ネットワーク経由の取得レイテンシが発生します。GPUのローカルメモリで完結させるのが最速ですが、それではリクエストが増えた時にサーバーを増やさなければなりません。
大規模な推論基盤を持たない個人開発者にとって、この「キャッシュの場所」を制御できるようになったことは重要です。APIのコスト構造を正確に把握し、どこで転送量を削り、どこで推論状態を保持するか。この解像度が高い開発者ほど、同じAIモデルを使っていても、ユーザー体験とコスト効率の両面で差をつけることができます。
また、技術的な文脈で見ると、これらの最適化手法は「LLMのステートレス性への挑戦」とも言えます。本来ステートレスであるはずのChat APIに対し、能動的に「状態(キャッシュやファイル)」を管理することで、疑似的なステートフル性を実現しています。この設計思想を理解しておけば、今後登場する新しいAIモデルやAPI仕様に対しても、「これはどのレイヤーの最適化を解決するものか?」と判断できるようになります。
今のAI開発は、単にプロンプトを投げて終わりというフェーズを過ぎています。APIのレスポンス速度やコストに不満を感じたら、まずは「何が毎回送られていて、何が毎回計算されているのか」をパケットやログレベルで可視化してください。そうすれば、Files APIやLMCacheのような技術が、なぜ今重要視されているのか、その答えが自ずと見えてくるはずです。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
明日からのAI開発で意識すべき「最適化の解像度」
明日から具体的にどう動くか。まずAPI利用がメインの開発者は、Files APIの導入を過度なコスト削減策と期待してはいけません。これはあくまで「帯域の節約」です。通信環境が不安定なエッジ環境や、画像を含むリクエストを頻繁に投げるGUIエージェントを開発しているなら、通信エラーの削減やレイテンシの安定化という面でメリットがあります。
一方で、自前で推論環境をホスティングしているエンジニアは、LMCacheのようなKVキャッシュ管理をアーキテクチャの標準に据えるべきです。特に推論サーバーと生成サーバーを分離する構成は、スケーラビリティの観点から避けて通れません。
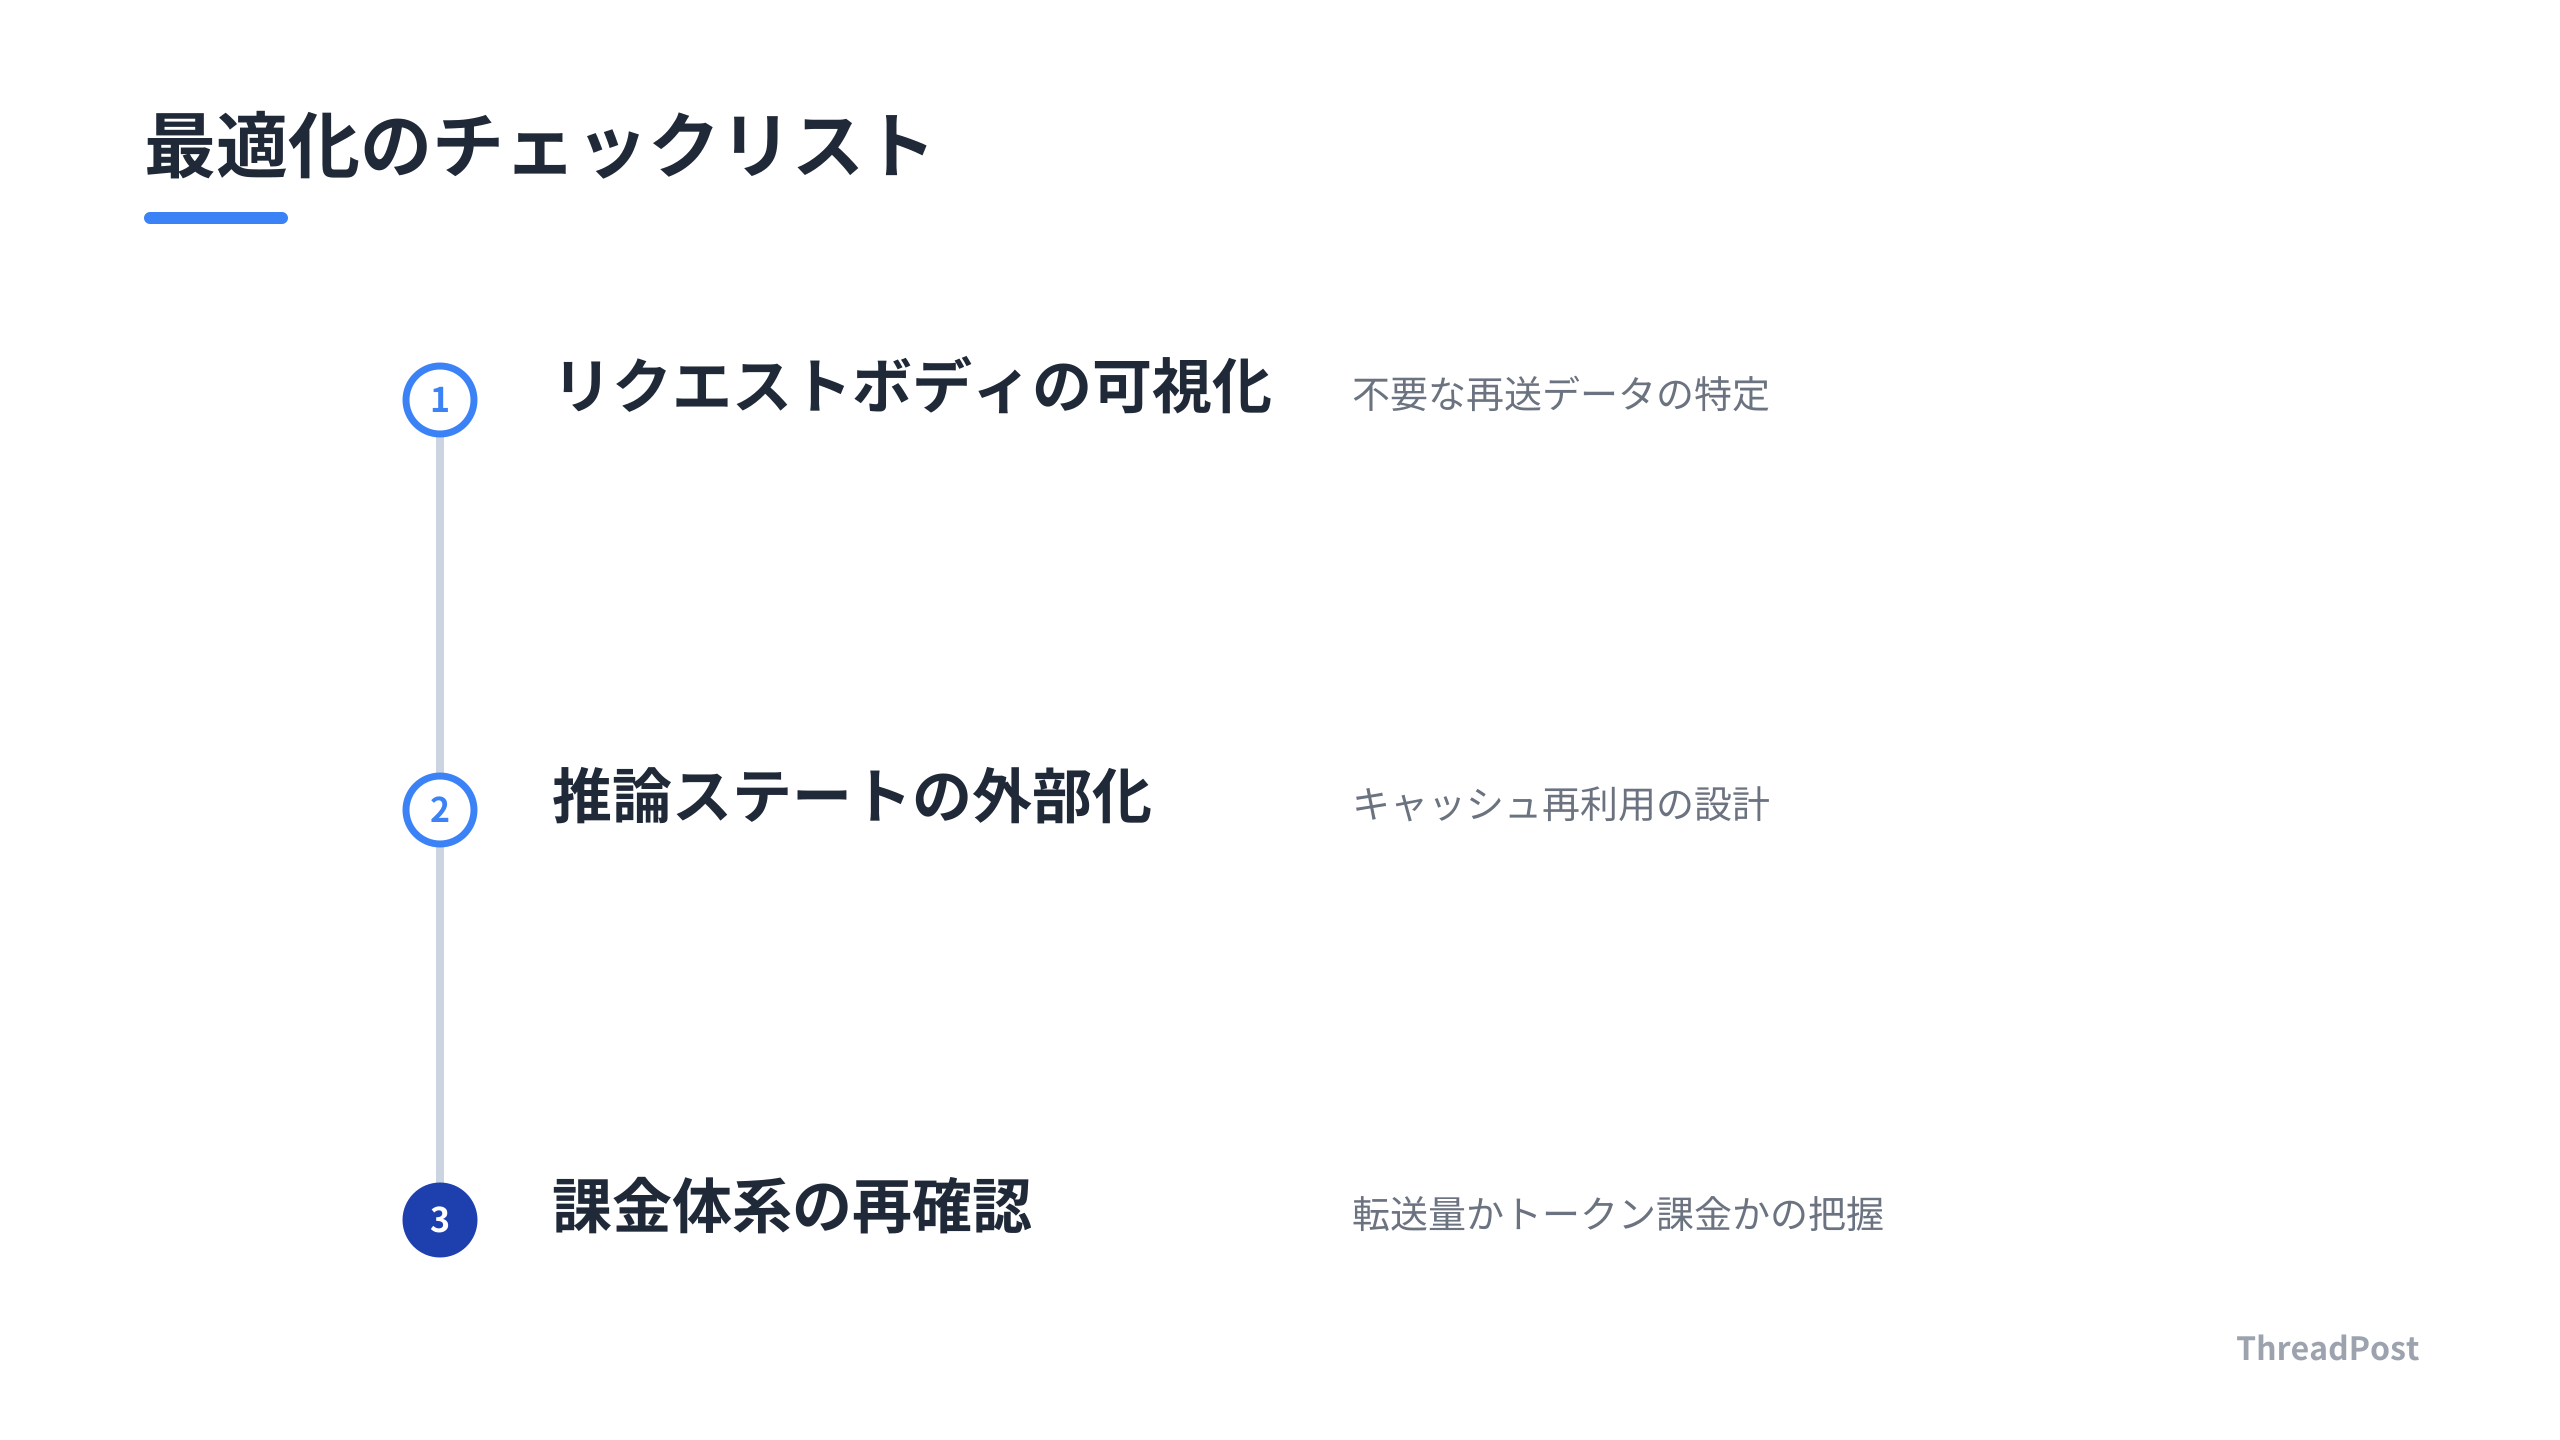
具体的には、以下の3点を開発のチェックリストに加えることを勧めます。
- リクエストボディの可視化: 自分が送っているJSONのバイト数を確認する。特にBase64エンコードされた画像や、長大なコンテキスト履歴が「毎回」再送されていないかチェックする。
- 推論ステートの外部化: 複数のリクエストで同じプロンプトや画像を扱う場合、その処理を「一度だけ」実行し、キャッシュを再利用できる設計になっているか見直す。
- 課金体系の再確認: 自分が使っているAPIが「転送量課金」なのか「トークン課金」なのか、あるいは「推論時間課金」なのかを正確に把握する。この理解が甘いと、最適化のつもりが逆にコストを増やす結果になる。
Claude Codeでエージェントを走らせていると、つい「動けば正義」でAPIを叩きまくってしまう。でも、ふとログを見て「あ、この画像10回も送り直しているわ」と気づいた時の絶望感と言ったら。APIのドキュメントを隅々まで読むのは地味だけど、結局これが一番の近道だ。
僕らの開発において、AIは単なる「賢い道具」から「効率的に使いこなすべきインフラの一部」へと変化しています。プロンプトエンジニアリングでモデルのご機嫌を取る時代は終わり、これからは「データとキャッシュのフロー」をいかに制御するかが、開発者の腕の見せ所です。
特に、Claude CodeのようなCLIツールを活用して開発効率を上げているなら、その背後で動いているAPIのリクエスト構造を理解しておくことは、長期的な開発コストを抑える鍵になります。新しいツールが出たときに飛びつくのもいいけれど、まずは今使っているAPIの「データ転送の無駄」を一つ潰すことから始めてみてください。
「開発速度」と「実行コスト」のバランスは、常にトレードオフです。しかし、今回紹介したような最適化レイヤーを理解していれば、そのバランスを自分好みに調整できるようになります。まずは小さなスクリプトで、リクエストのパケットサイズを測ることから始めてみてください。そこから見える景色は、今までとは少し違って見えるはずです。
 あわせて読みたい【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録 →
よくある質問
DeepSeekのFiles APIを使えばAPI料金は安くなりますか?
Files APIは「リクエストの帯域(通信量)」を節約するためのものであり、APIの利用料金(トークン課金)を直接的に下げるものではありません。公式情報にも画像は通常通りトークンとして課金されると明記されています。したがって、通信環境が悪い場合やリクエストサイズ制限に抵触する場合には有効ですが、コスト削減を主目的とする場合は、トークン消費量そのものを減らすプロンプトエンジニアリングの方が効果的です。
LMCacheを使うと推論そのものは速くなりますか?
LMCacheは推論そのものを高速化するというより、入力処理(Prefill)と生成処理(Decode)を分離し、KVキャッシュを外部ストアで共有することで、推論エンジンのスケーラビリティと柔軟性を高める技術です。特に複数のリクエストで共通のプロンプトを扱う場合、キャッシュの再利用によりPrefill時間を短縮できる可能性があります。ただし、ネットワーク経由のキャッシュ取得にはレイテンシが発生するため、インフラ構成とのトレードオフを考慮する必要があります。
API利用と自前ホスティング、どちらで最適化すべきですか?
利用形態によって最適化すべきレイヤーが異なります。API経由で利用する場合は、今回解説したような「転送データ量」の削減がコストの主戦場です。一方で、vLLM等を使って自前でホスティングしている場合は、GPUメモリを圧迫する「推論中のKVキャッシュ管理」がボトルネックになります。まずは自分がどのレイヤーでコストを払っているのか、パケット可視化等でボトルネックを特定してから対策を打つのが賢いアプローチです。
まとめ
今回の学びを振り返ると、AI開発における「コスト最適化」の解像度が上がりました。API利用なら「転送量」、自前ホスティングなら「推論状態の共有」というように、打つべき手は場所によって異なります。
僕自身、Claude Codeでのエージェント開発において、ただAPIを叩くだけでなく、コンテキストの持ち方やキャッシュ戦略を意識する重要性を痛感しました。技術の進化に合わせて、アーキテクチャも常にアップデートが必要です。
AI開発のコスト構造を解像度高く理解し、最適化の次の一手を打ちたい方は、ぜひThreadPostをフォローして最新の知見を追いかけてください。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
