


Anthropicから「Claude Opus 5.5」が登場した。
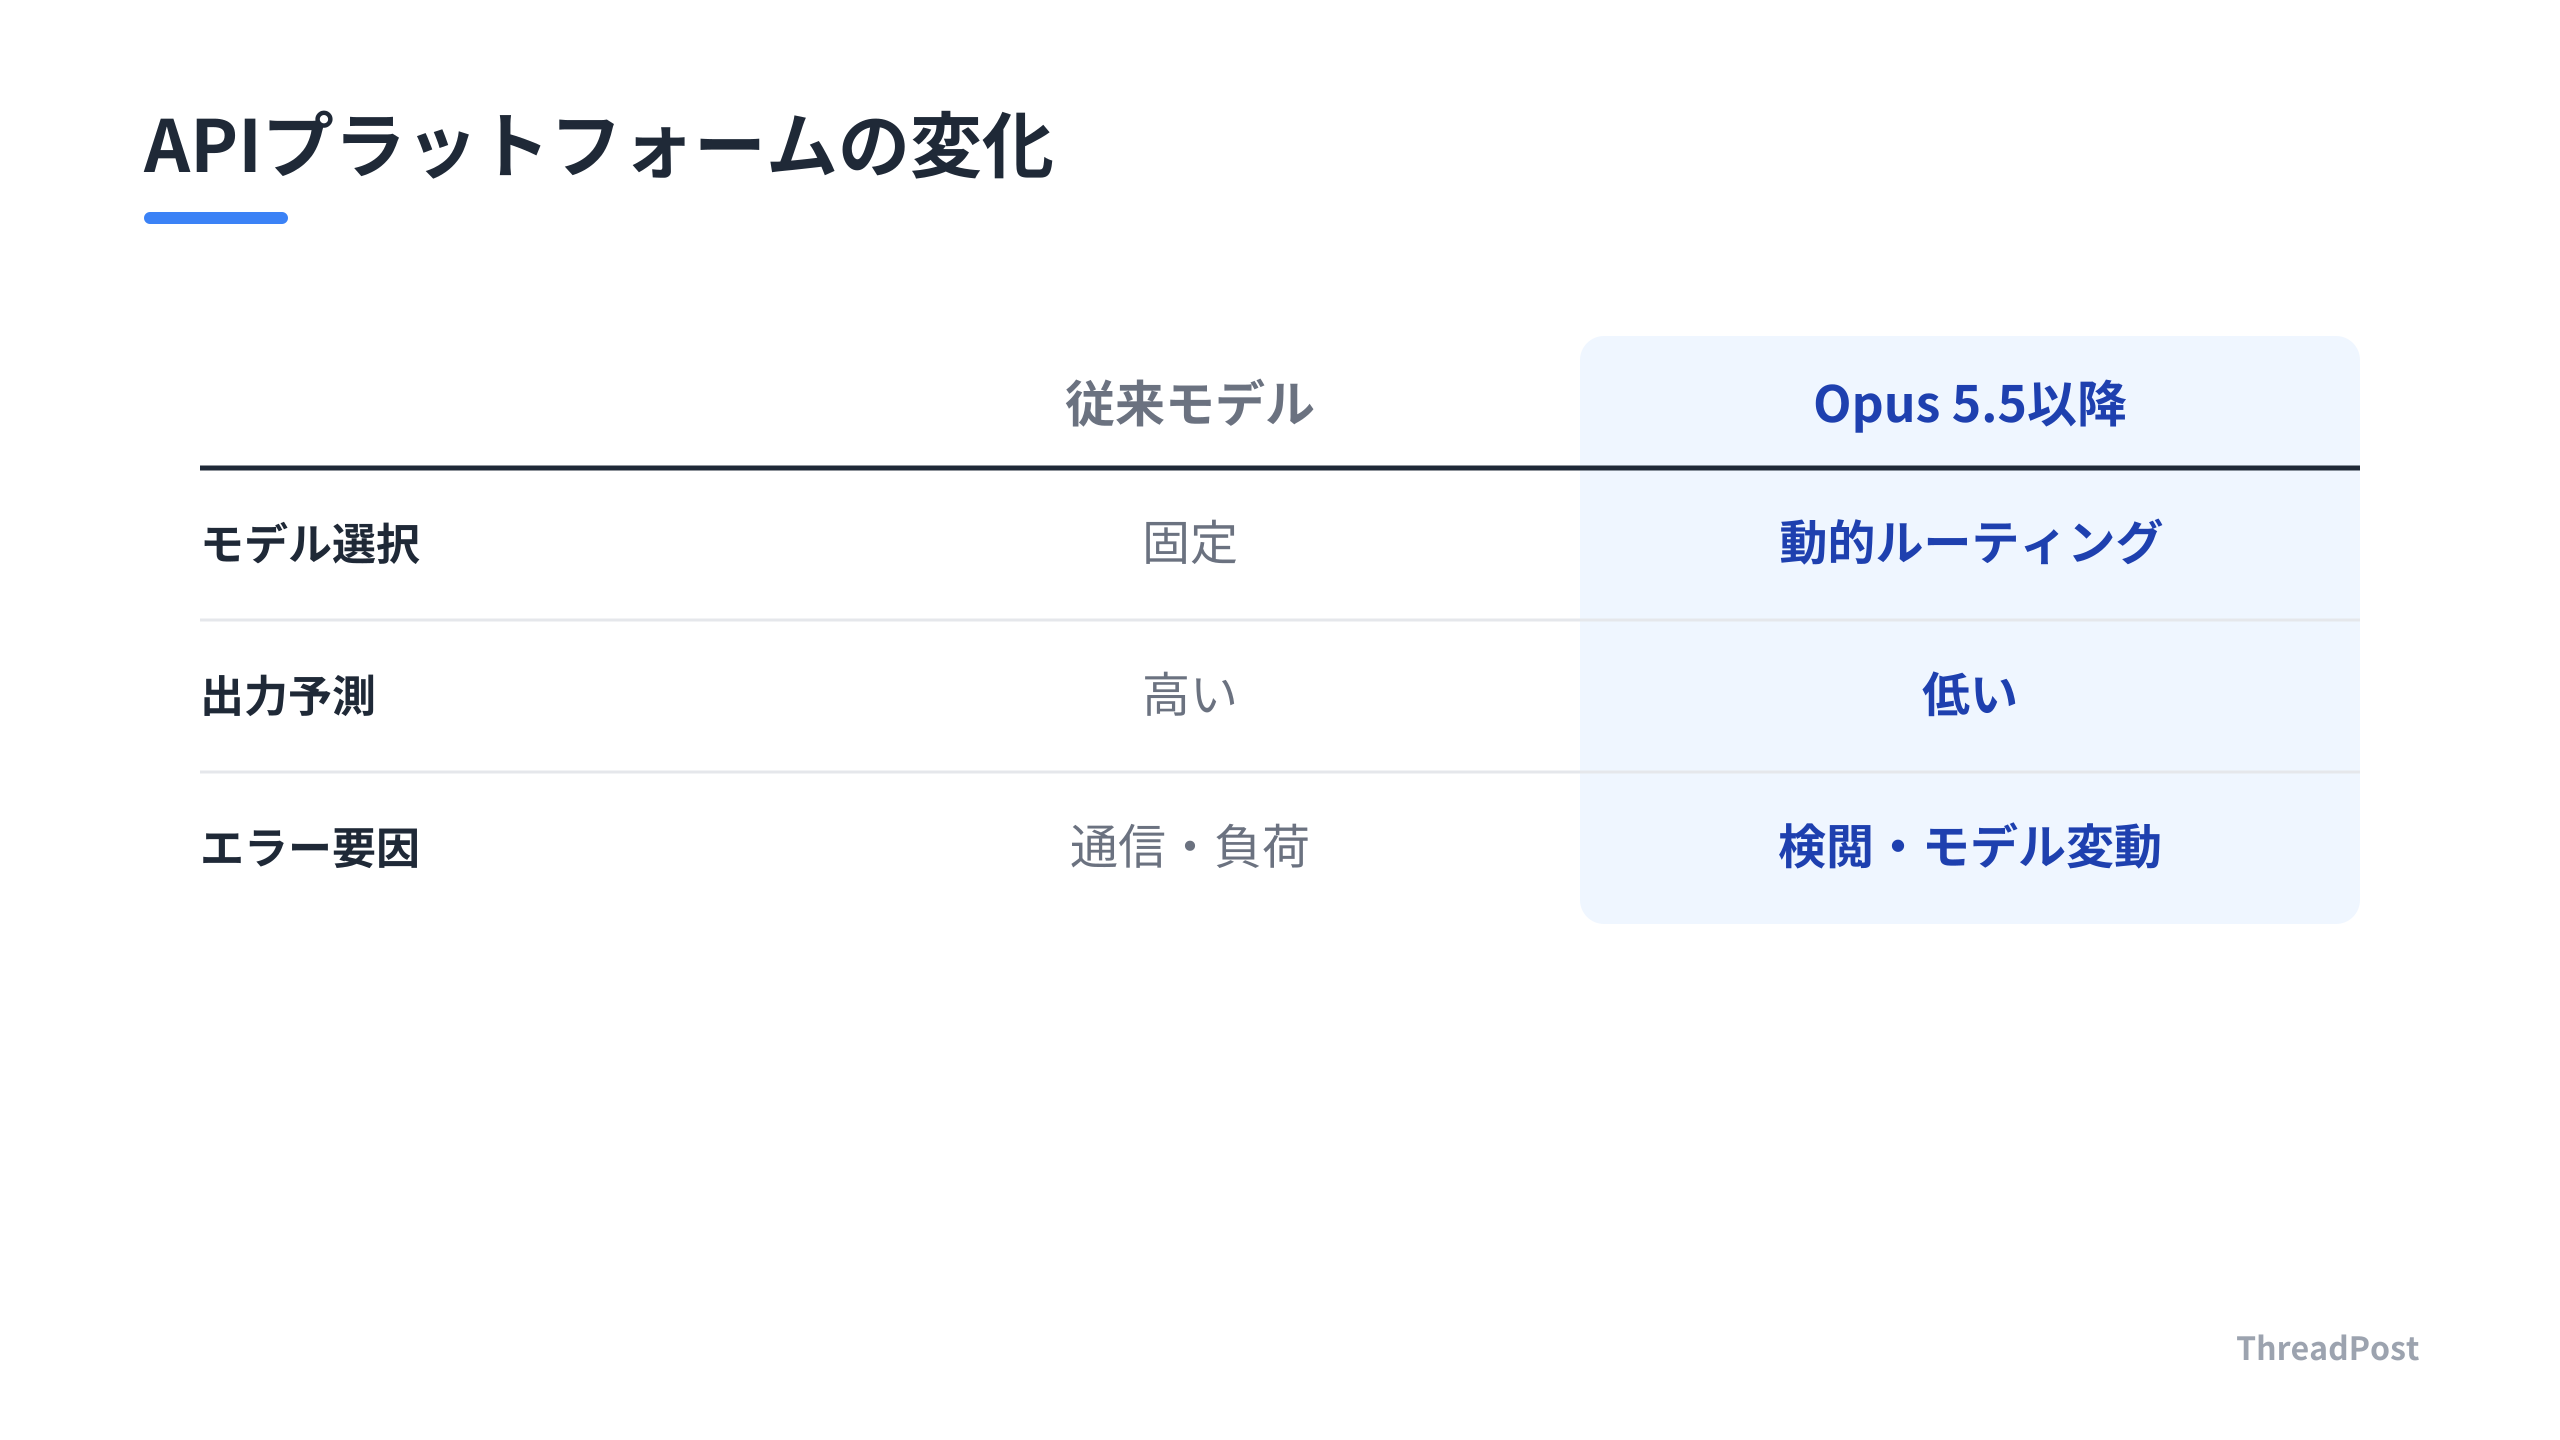
今回注目すべきは性能向上ではない。入力内容に応じてバックエンドでモデルを自動切り替えする「動的ルーティング」の実装だ。
サイバーセキュリティや生物学に関わるリクエストを投げると、API側で制限の強いモデルへ振り分けられる。
これは政府の規制とビジネスの存続を天秤にかけた、AI開発の新たな「生存戦略」だ。
Claude Codeで自律エージェントを組む開発者にとって、この仕様変更は「モデルの揺らぎ」と「フォールバック設計」の必要性を突きつけている。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
Anthropicが仕掛ける「安全性」と「動的ルーティング」の全貌
「Claude Opus 5.5」の最大の特徴は、特定の入力内容を検知し、バックエンドで自動的にモデルを切り替える「動的ルーティング」の導入だ。
具体的には、サイバーセキュリティ関連のリクエストは「Opus 4.8」へ、生物学的なリスクを含むリクエストは「Opus 5」へ自動的に振り分けられる。
これはモデルが危険な情報を出力することを防ぐための、APIレベルでのガードレールだ。
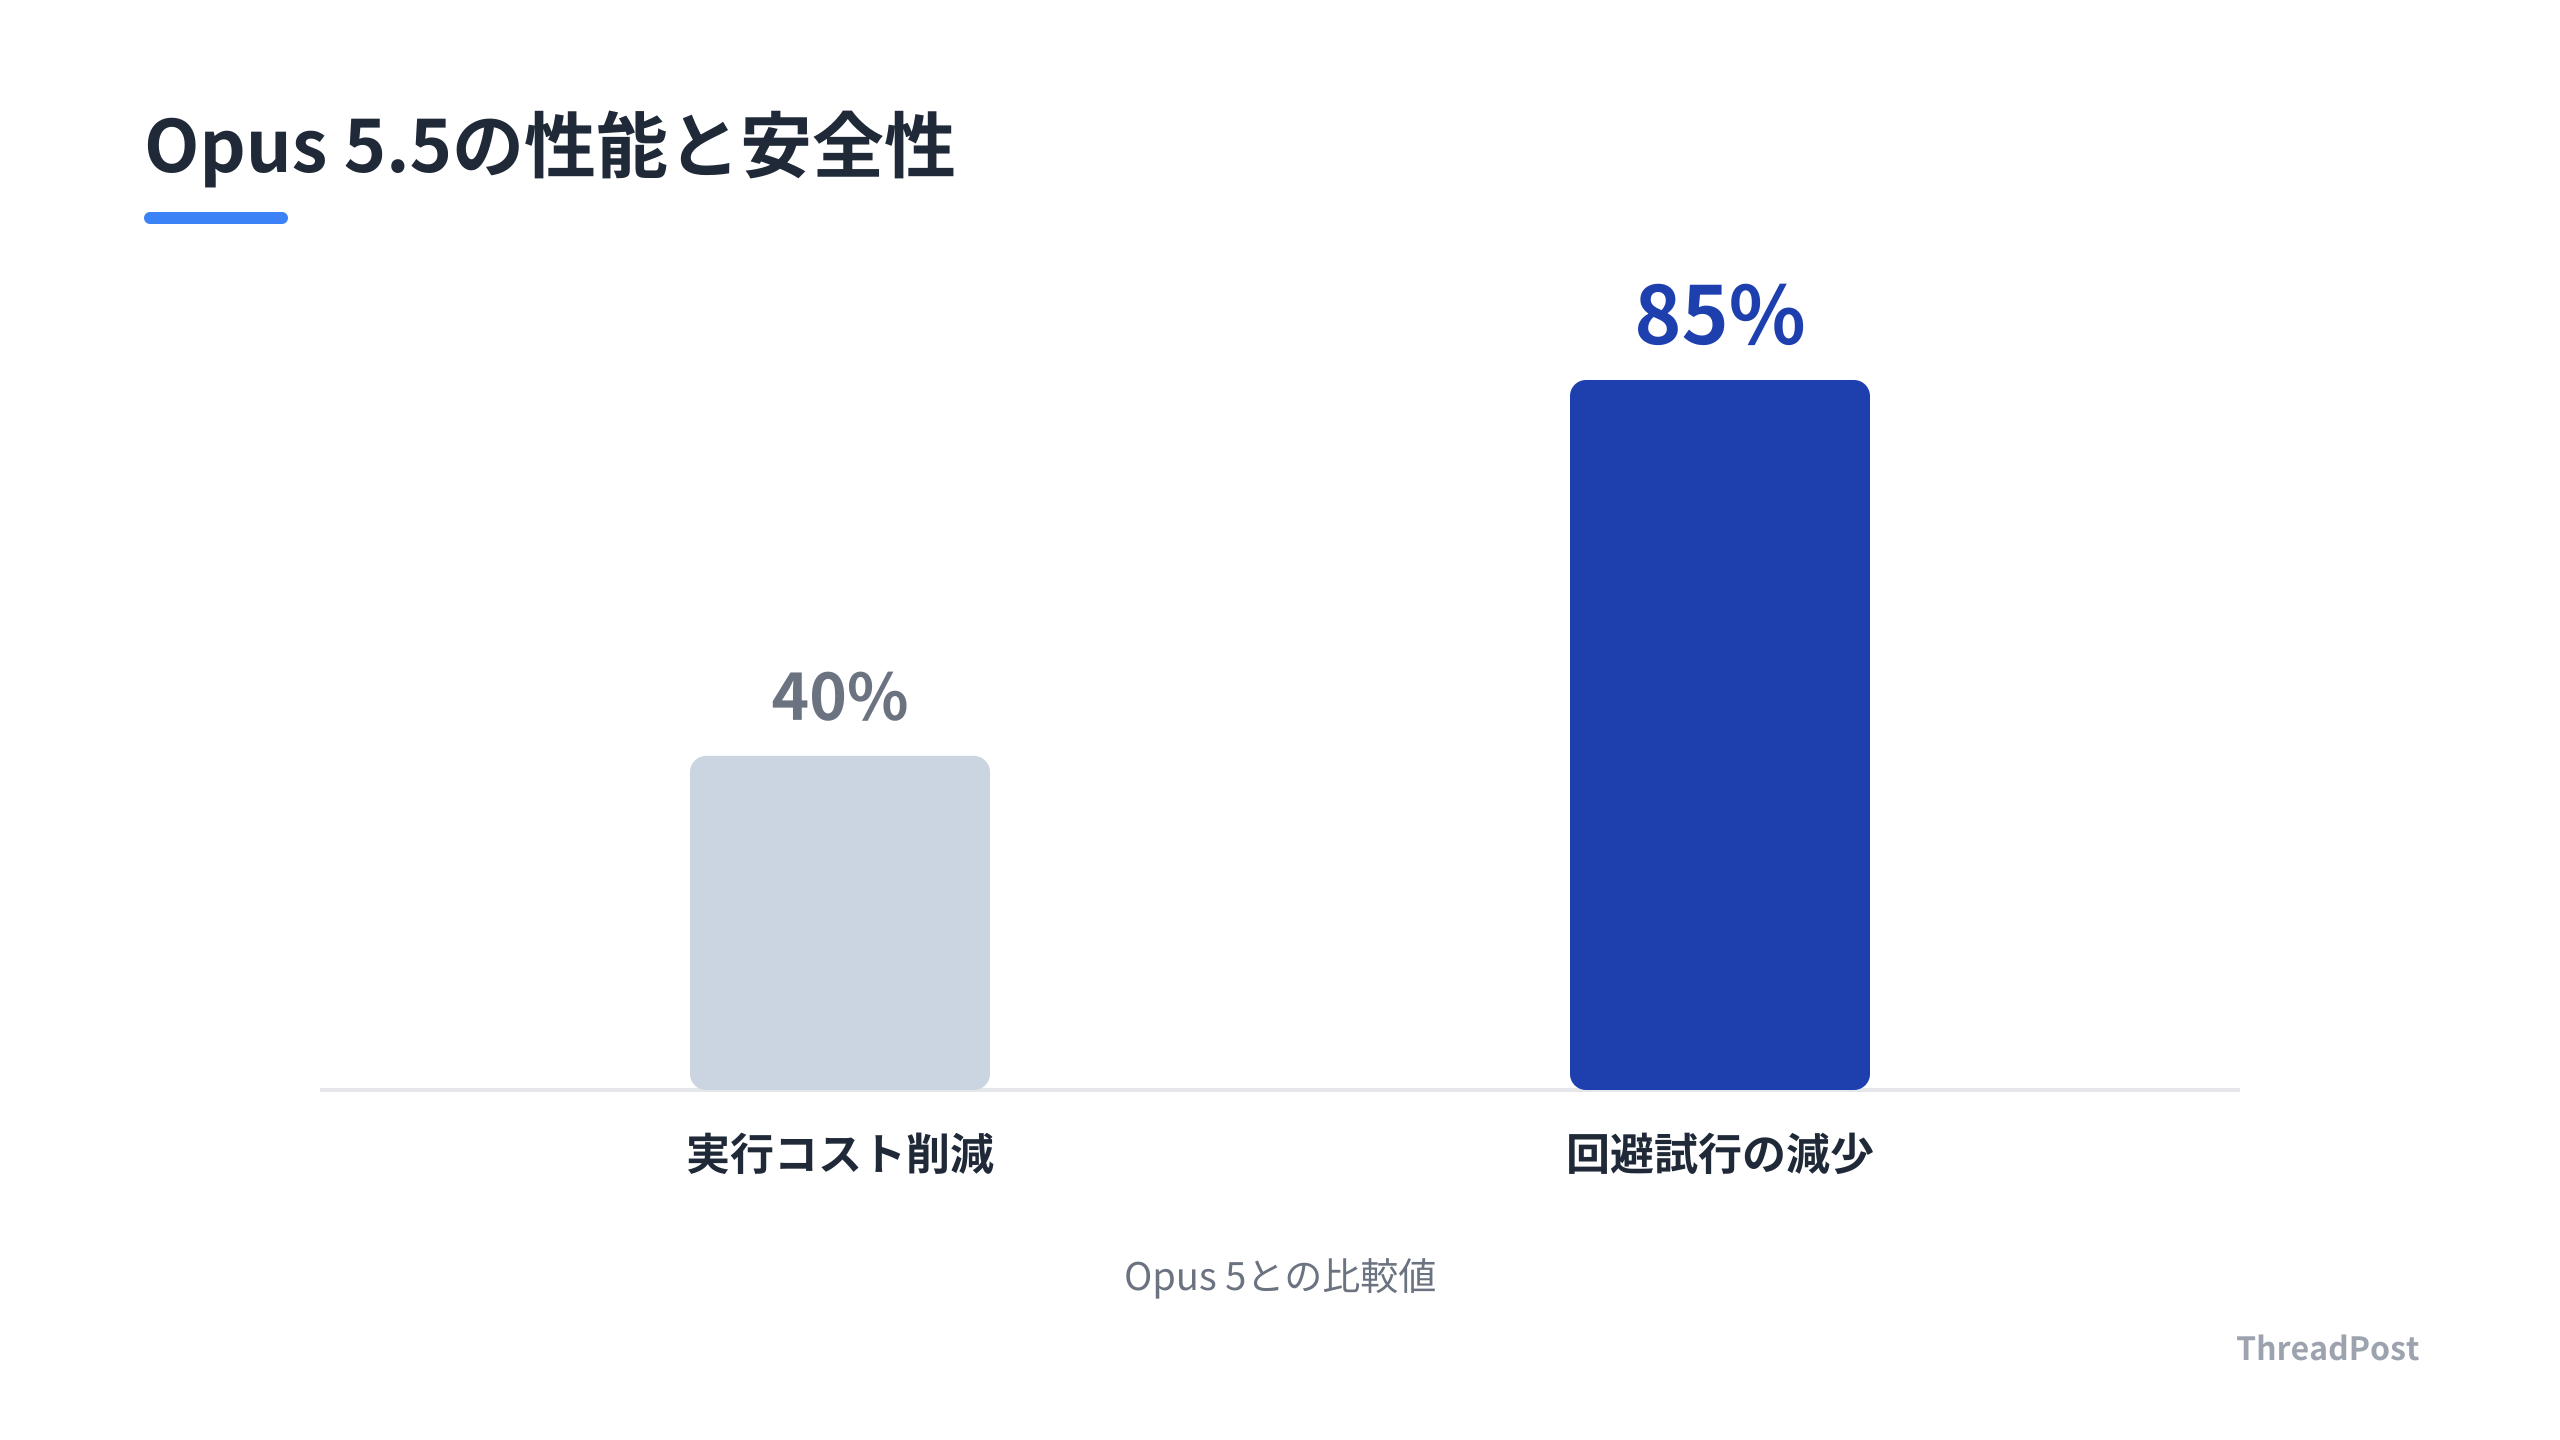
Claude Opus 5.5の性能は「Fable 5.1」に匹敵し、実行コストは「Opus 5」と比較して40パーセント削減されている。
安全性のテストにおいては、境界を回避しようとする試みが「Opus 5」と比較して85パーセント減少した。
しんたろー:
APIの挙動が急に変わるのは開発者にとって頭が痛い問題だ。
「さっきまで通っていたコードが拒否される」事態が頻発しそうで、エラーハンドリングの難易度が上がったと感じる。
CEOのダリオ・アモデイ氏は「モデル開発のペースを落とす」と明言している。
このモデルは「Frontier Design」や「METR」によるテストを経て公開され、政府の監視下で「安全な領域のみを商用化する」フィルタリング体制を象徴している。
数週間以内には「Claude Sonnet 5.5」や「Haiku 5.5」のリリースも予定されている。
Anthropicはモデルの高性能化と引き換えに、特定のユースケースを動的に制限する「検閲・ルーティング環境」を開発者に提供している。
開発者はモデルの性能だけでなく、この「ルーティングによる揺らぎ」を前提としたアーキテクチャを設計する必要がある。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
開発者から見た「動的ルーティング」という名の制約
「動的ルーティング」は、リクエスト内容に応じて裏側のモデルが切り替わる「検閲付きゲートウェイ」だ。
APIを叩く際、同じプロンプトを送っても、ガードレールがリスクを検知すれば即座に下位モデルへ切り替えられる。
これからは「どのモデルで返ってきたか」というレスポンスのメタデータまで考慮した実装が必須になる。
Claude Codeで複雑なリファクタリングやインフラ構築を自動化する場合、セキュリティ関連のロジックに触れるとモデルがダウングレードされる可能性がある。
Claude Codeで開発していると、急に推論能力が落ちたと感じる時がある。
API側で勝手にモデルを切り替えられると、エージェントの思考プロセスを追うのが難しくなる。
モデルの可用性が政治的リスクに依存する不安定なプラットフォーム環境が現実だ。
特定のモデルが輸出規制やセキュリティ懸念で突然使えなくなれば、そのモデルに依存したサービスは停止する。
これを回避するには、特定のモデルに依存しない「フォールバック設計」を組み込む必要がある。
メインで最新モデルを使いつつ、出力が拒絶されたり精度が落ちたりした場合には、別のプロバイダーや古いモデルへ切り替える「マルチモデル・アーキテクチャ」の構築が有効だ。
Claude Opus 5.5の高性能さを享受するためには、常に「モデルの裏切り」を想定した防衛的なコードが必要になる。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
開発者が明日から取るべき防衛的実装
Claude Opus 5.5の登場で、プロダクト開発には「新しい制約」が生まれた。
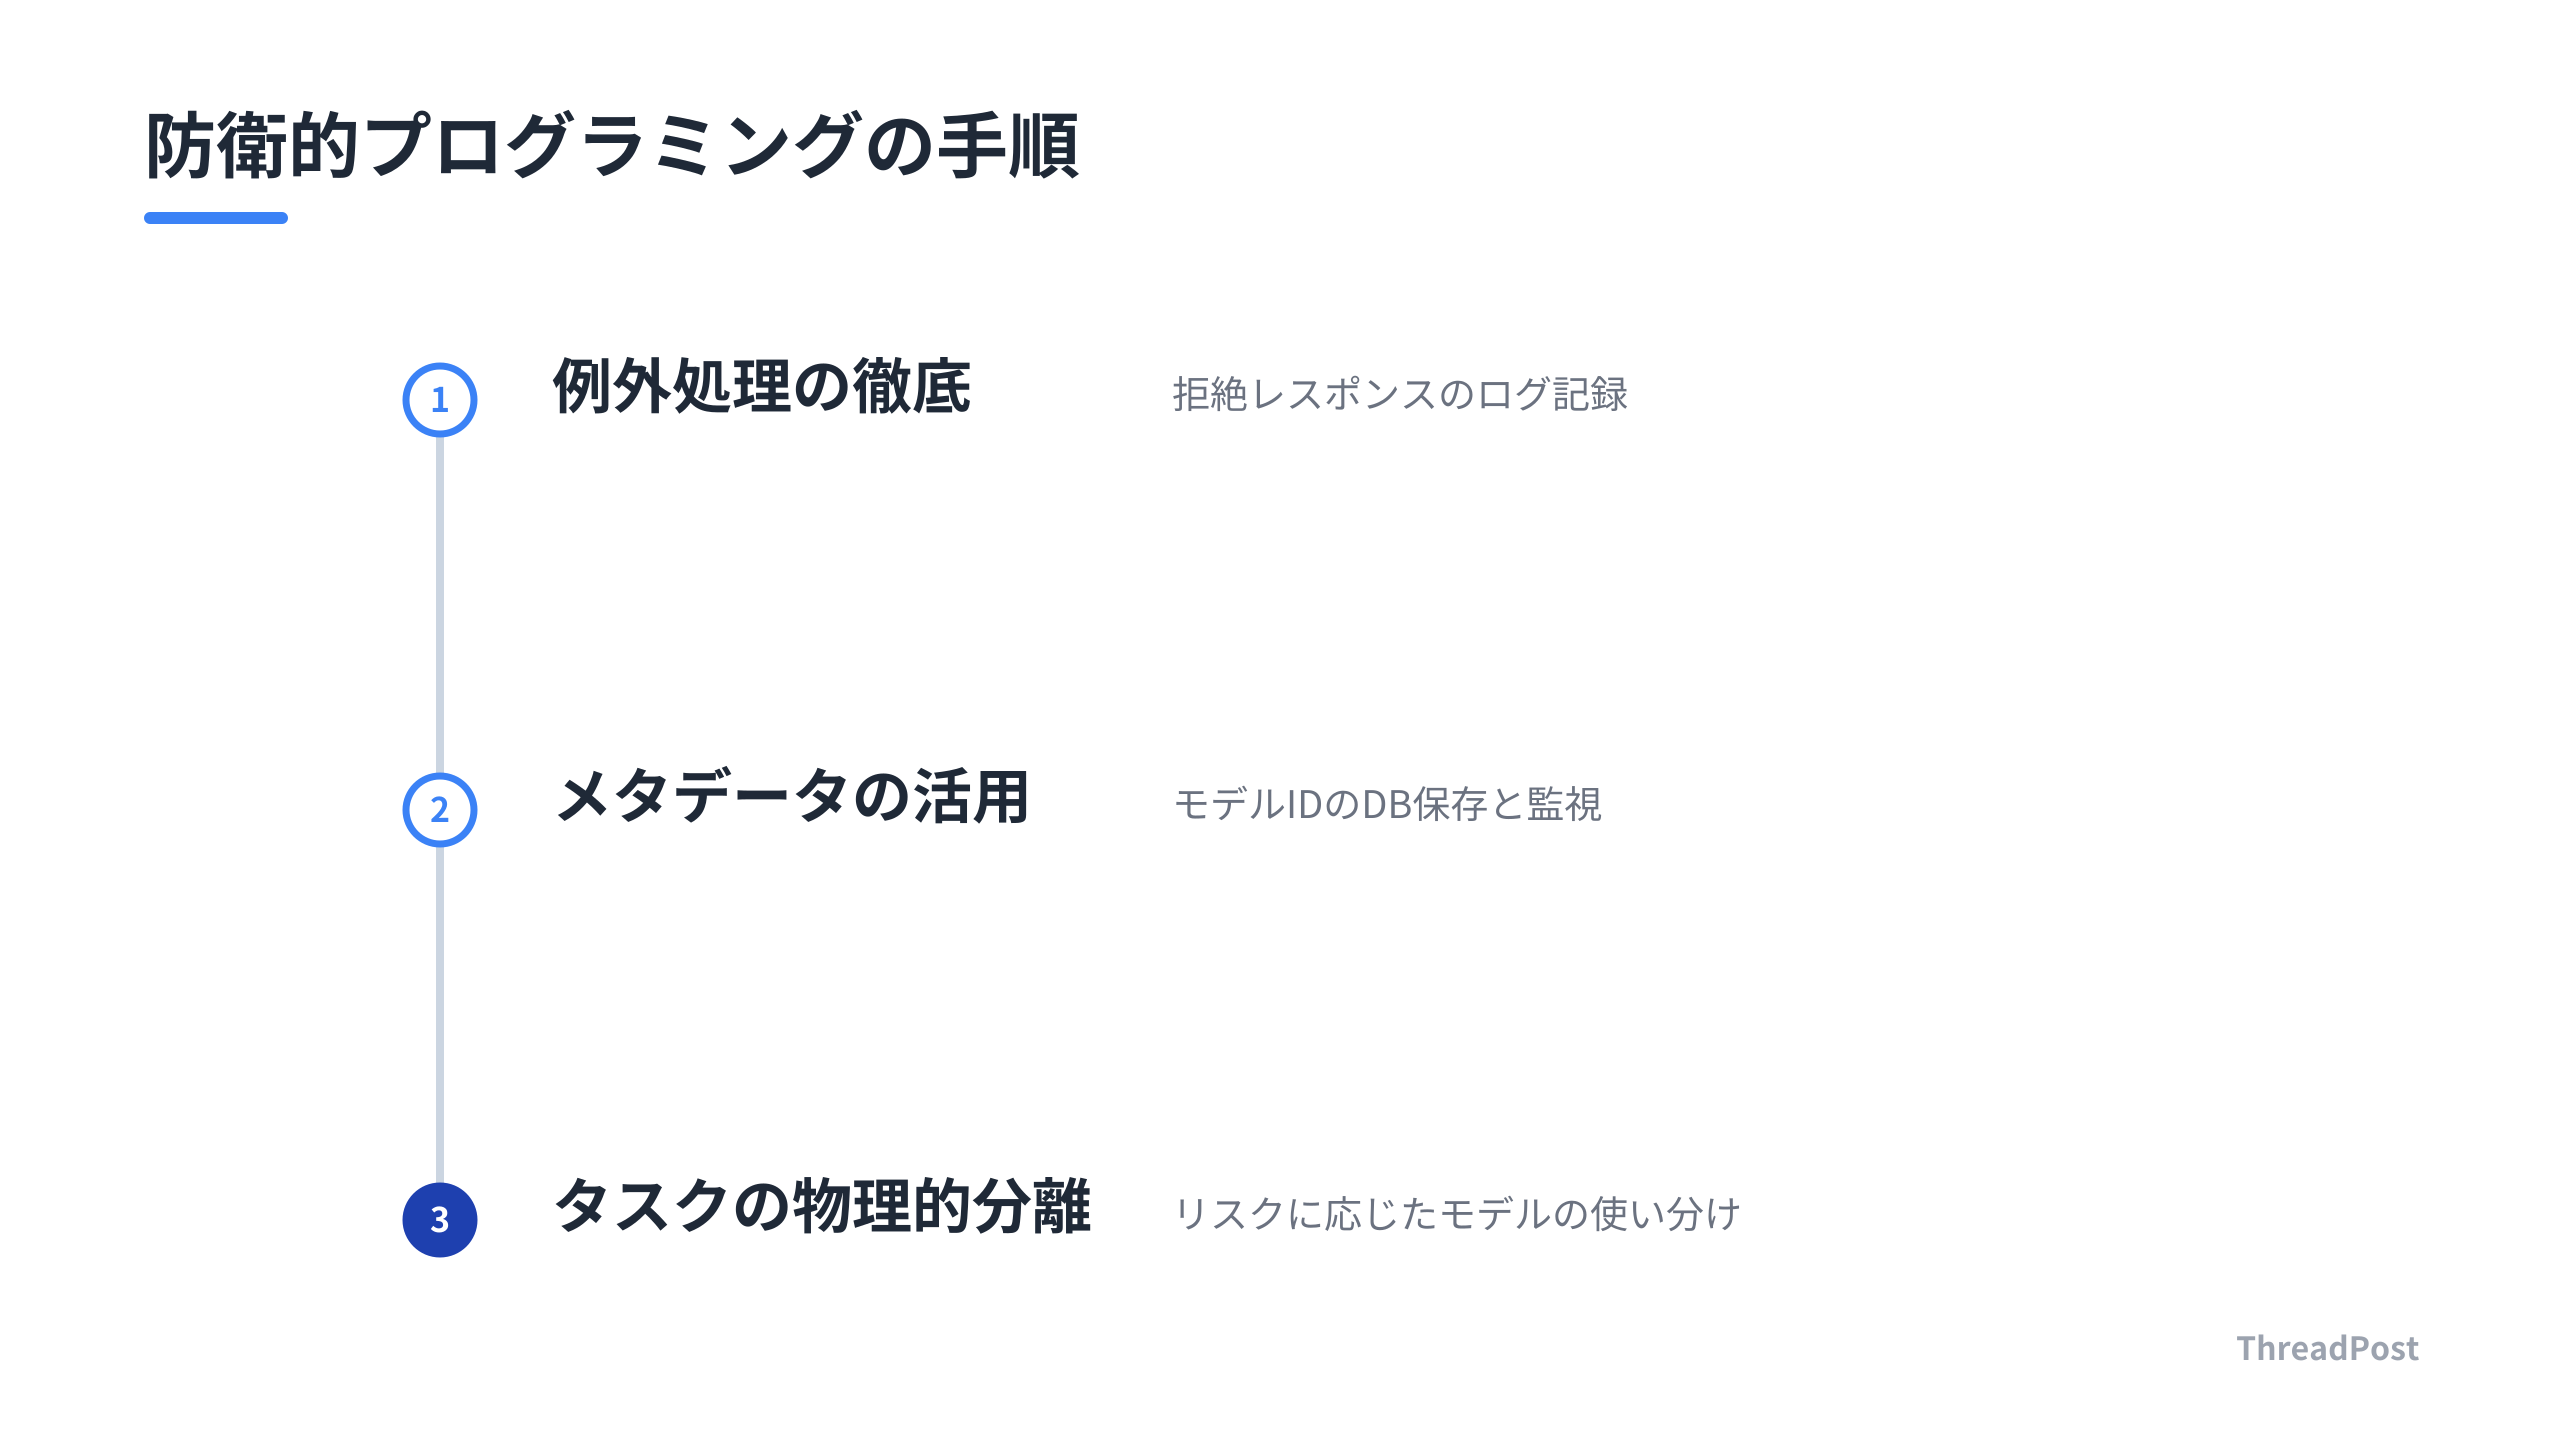
明日からの実務で意識すべきアクションは3つある。
第一に、プロンプトの「検閲リスク」を前提とした例外処理の徹底だ。
サイバーセキュリティや生物学に触れるタスクを自動化する場合、モデルからの拒絶レスポンスをエラーとしてキャッチし、ログに記録するフローが不可欠だ。
第二に、「モデルの切り替わり」を検知するメタデータの活用だ。
APIのレスポンスに含まれるモデルIDを確認し、特定のタスクで精度が落ちた際に「モデルのダウングレード」が起きていないかを確認する仕組みを作る。
第三に、「安全性の高いタスク」と「リスクのあるタスク」の物理的な分離だ。
リスクの高い処理は、制限の少ない別のプロバイダーやローカルLLMに切り出せるような疎結合なアーキテクチャにする。
Anthropicの安全性向上は、APIの仕様が気まぐれに変わるフラグだ。
ガードレールを回避する工夫より、引っかかってもサービスが死なない構造を作る方が開発コストは安くつく。
今後は「高性能なモデルをどう使いこなすか」以上に、「モデルが使えなくなった瞬間に、どうやってサービスを止まらせないか」という視点が重要だ。
まずは現在利用しているAPIのコールスタックを見直し、特定のモデルIDをハードコードしている箇所を環境変数や設定ファイルで切り替えられるようにする。
AI開発は、モデルの進化を追うレースから「モデルの不確実性」をマネジメントする勝負にフェーズが変わった。
 あわせて読みたい【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録 →
よくある質問
Q1: Claude Opus 5.5が特定の入力を拒否するのはなぜですか?
Anthropicの最新モデルは、政府のセキュリティ基準に基づき、サイバーセキュリティや生物学に関するリスクの高いリクエストを検知すると、より制限の強い下位モデルへ自動的にルーティングする仕組みを導入しています。これはモデルが意図せず攻撃的なコード生成や危険な情報提供を行うことを防ぐための安全装置です。
Q2: Anthropicのモデルが政府から規制を受けるリスクはありますか?
はい。過去には投資家がモデルのセキュリティ懸念を政府に報告したことで、特定のモデルが輸出規制の対象となった事例が存在します。Anthropicは政府と連携し、危険性の高いモデルの公開を制限する一方で、商用モデルには厳格なガードレールを設けることでビジネスを継続する戦略を採っています。
Q3: 開発者が「モデルの検閲」を回避する方法はありますか?
モデル内部のガードレールを意図的に無効化する行為は、利用規約違反となるだけでなく、APIの利用停止や将来的なアクセス制限に繋がるリスクがあります。検閲を回避しようとするのではなく、モデルの「制限」を前提としたアプリケーション設計を行うのが賢明です。複数のモデルを使い分けるルーティング層を自前で構築し、フォールバックを自動化することが解決策となります。
まとめ
Anthropicが突き進む「安全性」の追求は、モデルの性能向上と同等にビジネスの存続を左右する課題だ。
政府の監視下で動的ルーティングを実装する今の姿勢は、開発者にとって「信頼の揺らぎ」と「実装の複雑化」を意味する。
モデルが突然、特定のタスクを拒否する世界線はすぐそこだ。
AIが万能であるという前提を捨て、制限や検閲を「機能の一部」として扱う防衛的なアーキテクチャに舵を切る必要がある。
AIの安全性と規制の狭間で、どう生き残るか。最新のモデル動向を深掘りした分析をThreadPostでチェックしてほしい。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
