


AI開発における最大の壁はトークン消費量だ。特にClaude Codeのような高性能なツールを駆使していると、気づかないうちに利用枠を圧迫し、開発がストップしてしまう。この記事では、1人SaaS開発で実践している、トークン消費を劇的に抑えるための最適化設定と運用ルールを7つに絞って解説する。これを取り入れるだけで、同じコストでも開発効率は向上する。
1. ツール出力の「UI用」と「LLM用」を分離する
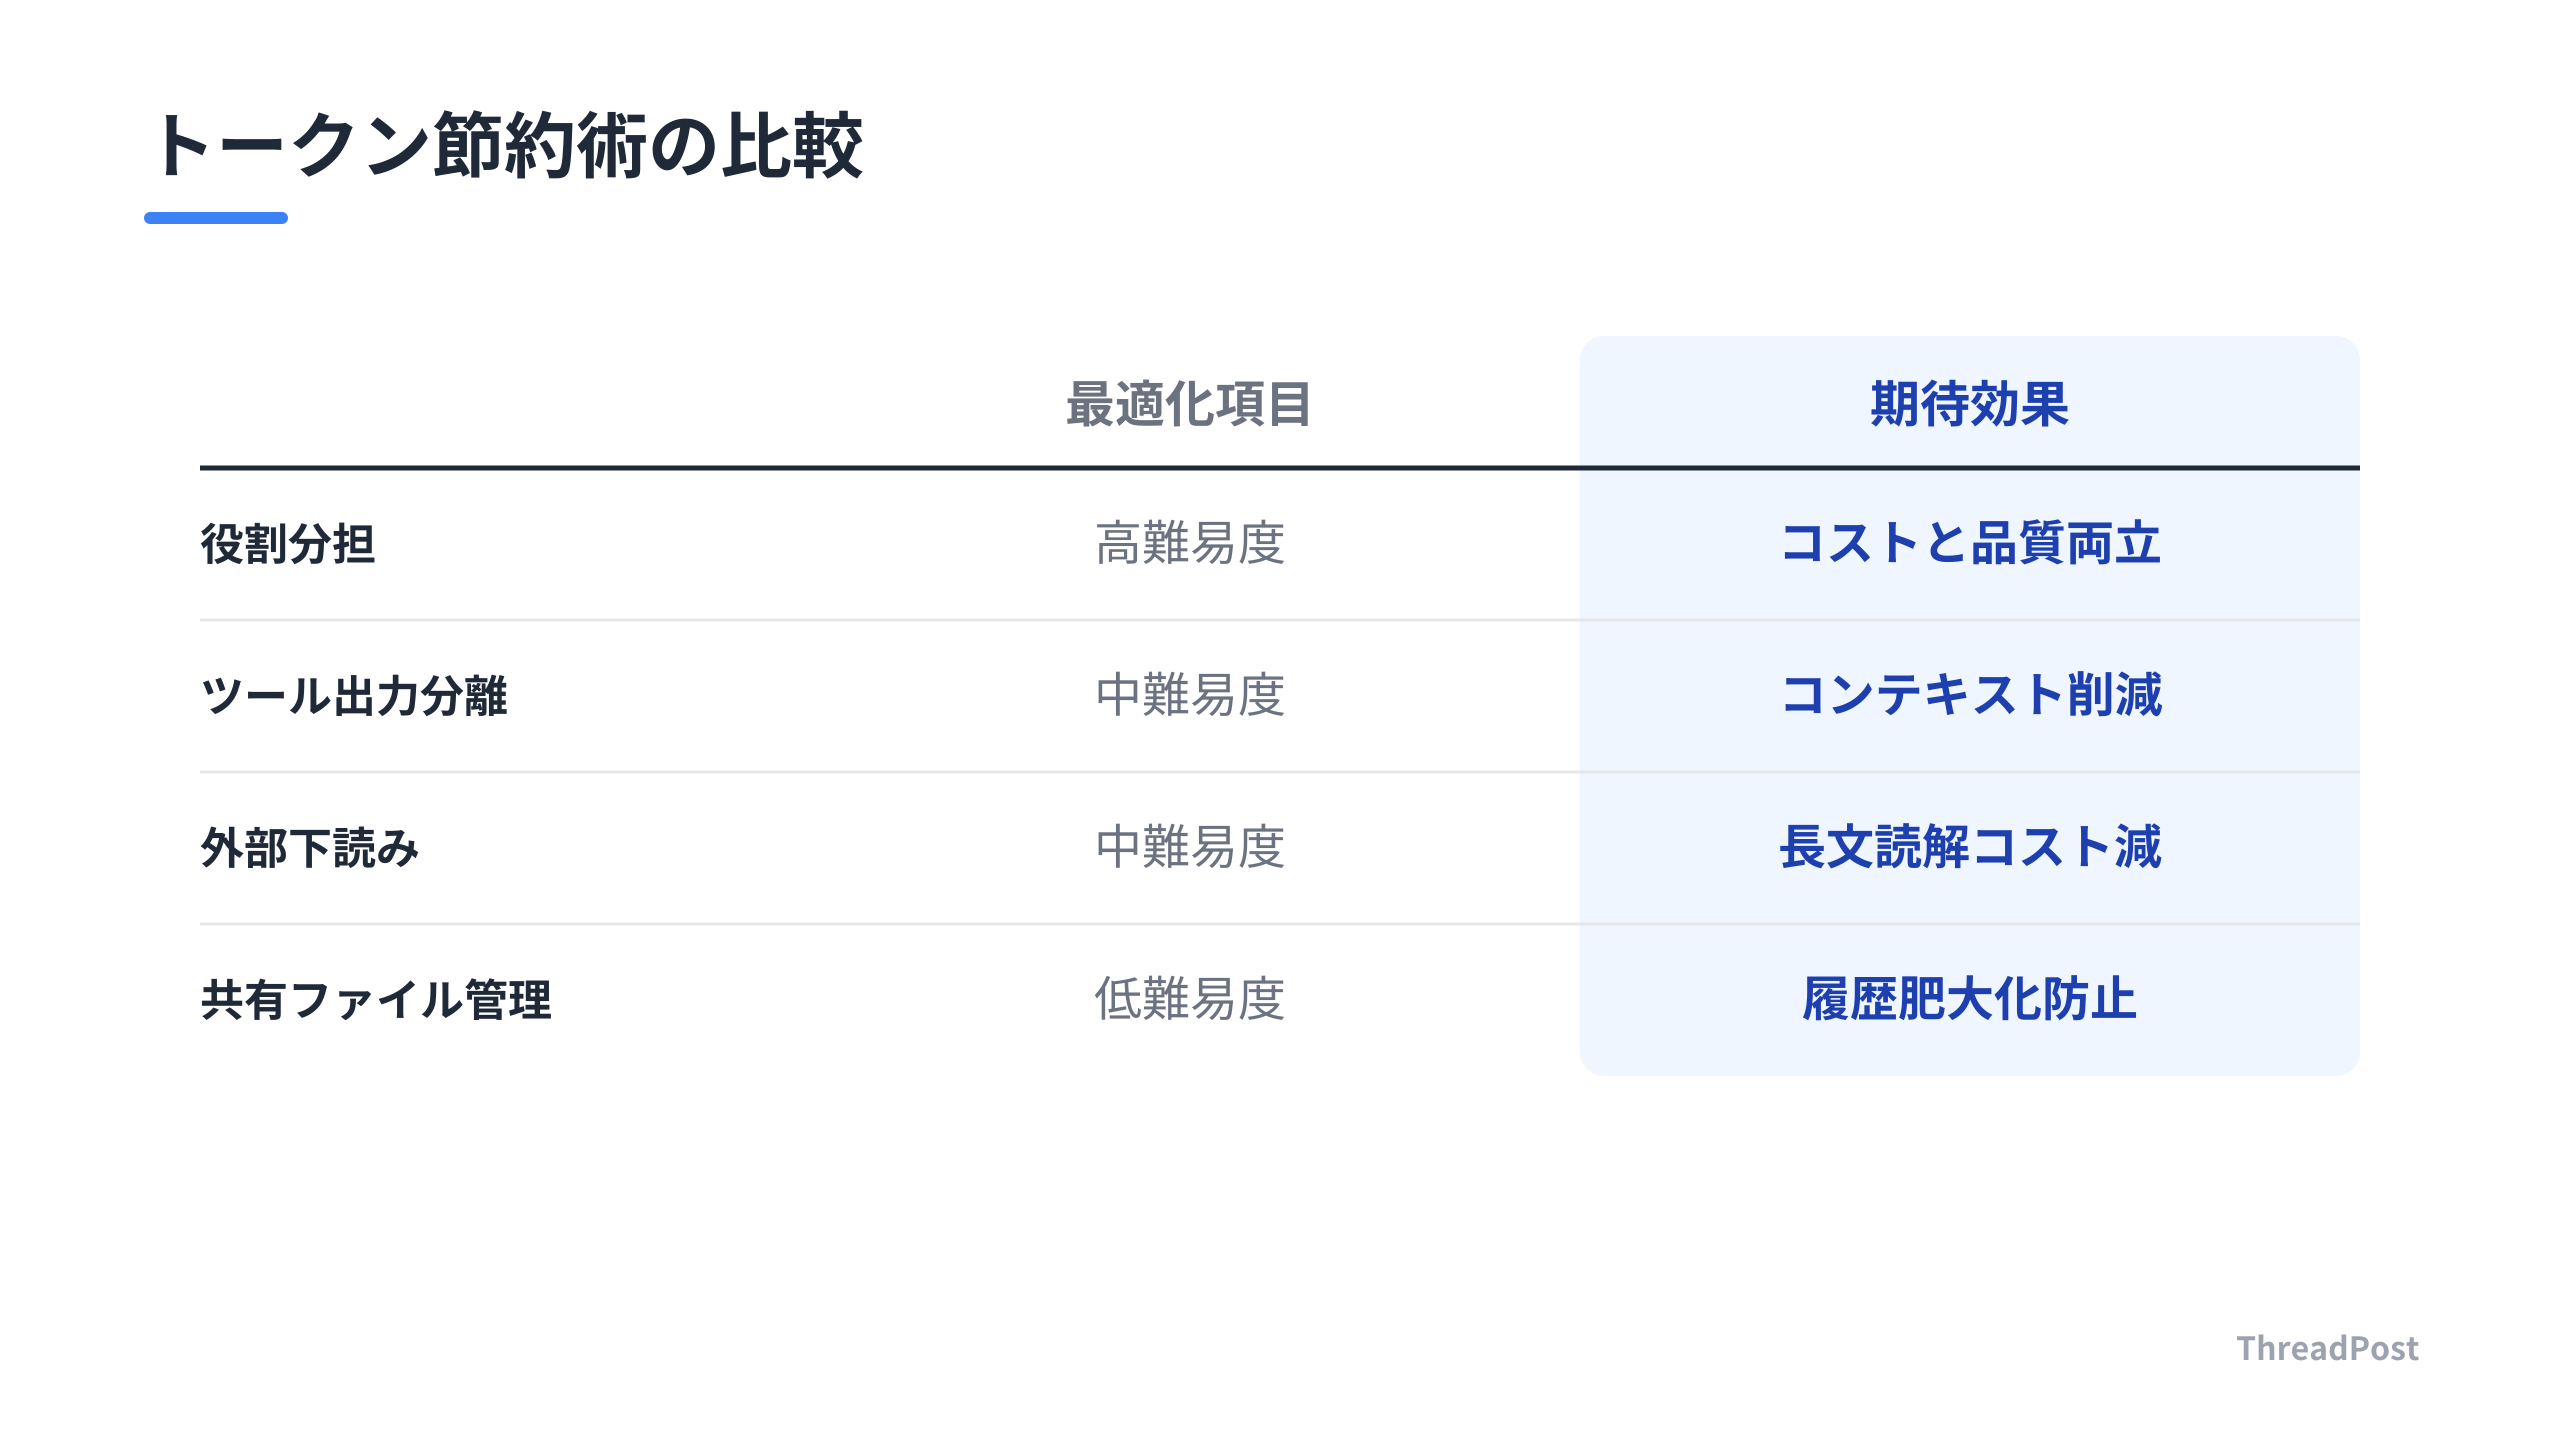
AIエージェントにツールを実行させる際、その結果をすべてLLMに渡すのは無駄だ。ツールが返すデータには、人間が見るための詳細な情報と、AIが判断を下すための最低限の要約が含まれている。UI描画用のフルデータをそのままLLMに食わせると、コンテキストは瞬く間に肥大化する。これを防ぐために、ツール実行結果から不要な情報を削ぎ落とし、代表値や要約のみを抽出するフィルタリング処理を実装する。これだけでコンテキストの圧迫を抑えつつ、推論精度を維持できる。
2. 司令塔とワーカーで役割を明確に分ける
高性能なモデルは高コストだ。すべてを単一の高性能モデルに任せるのではなく、計画やレビューを行う「司令塔」と、実装作業に特化した「ワーカー」に役割を分担させるのが鉄則だ。Claude Codeに専用のスキルを追加し、作業をループさせる運用を組むことで、高コストモデルの過剰な利用を防ぐ。司令塔は目的や品質判断に集中し、ワーカーが淡々とコードを実装する。この分業により、コスト最適化と開発品質の両立が可能になる。
3. プロンプトキャッシュのTTLを最適化する
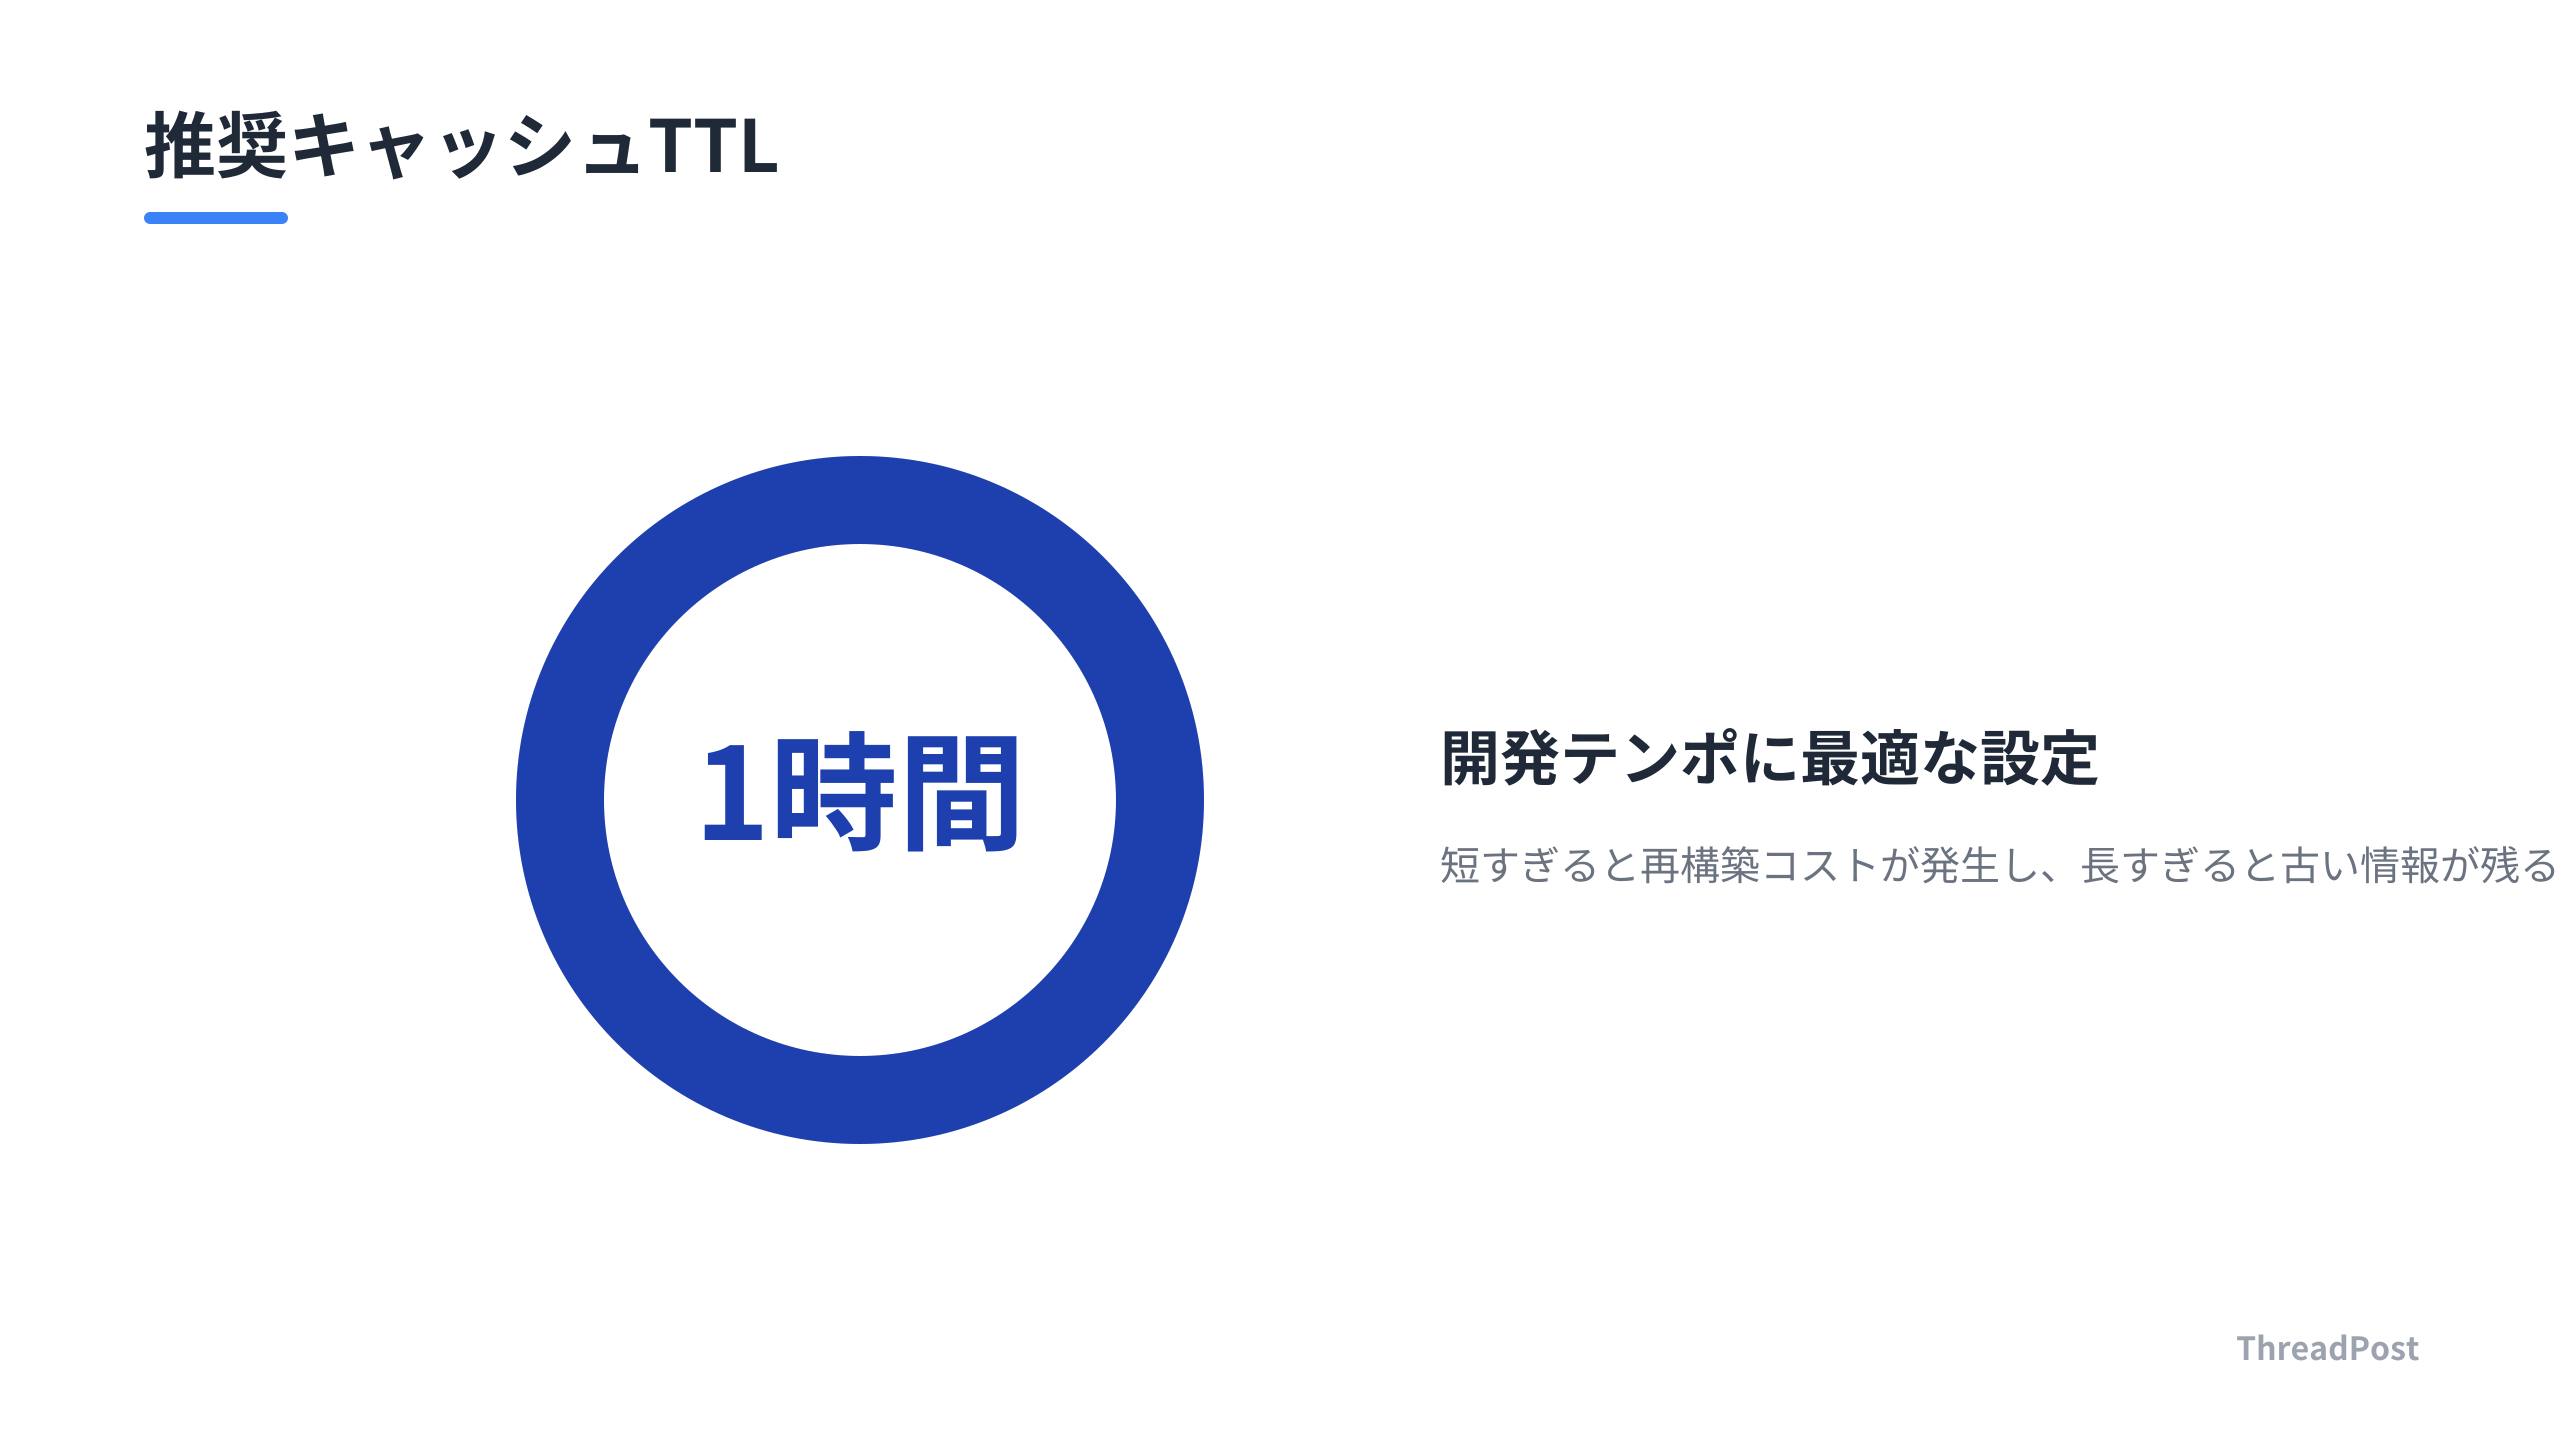
Claude Codeのプロンプトキャッシュ有効期限(TTL)の設定は、コスト管理の要だ。放置によるセッションの再構築は、無駄なトークン消費を招く。開発のテンポに合わせて適切なTTLを設定し、1時間程度を目安に運用する。キャッシュが有効であれば、セッション再開時の読み込みコストを削減できる。設定が適切かどうかは、利用統計を確認し、キャッシュ生成が正しく行われているかチェックする習慣をつける。
4. 不要なプラグインとツールを断捨離する
多くのプラグインやツールを導入すると、セッション開始時に読み込まれるコンテキストが肥大化する。使っていないツールが常駐していると、それだけでセッション開始時のトークンを浪費する。さらに、各プラグインが防衛的なプロンプトを注入し合い、設計思想が衝突して推論の質が下がるケースも多い。定期的にツール一覧を見直し、不要なものは削除する。シンプルで洗練された環境こそが、効率的な開発を生む。
5. 外部の下読みワーカーを活用する
大量のドキュメントを主モデルに読ませるのはコストの無駄遣いだ。安価なモデルを「下読み」として活用し、抽出された要点や証拠レポートのみを主モデルに渡す運用が有効だ。主モデルは、下読みされた情報をもとに最終的な判断を下すだけで済む。これにより、長文コンテキストを何度も読み込むコストを下げられる。モデルごとの単価と得意分野を理解し、適材適所で使い分けるのが賢い開発者のやり方だ。
6. 共有ファイルで状態管理を徹底する
会話履歴に思考プロセスやログを溜め込むのは避けるべきだ。進捗管理はPLAN.mdやWORK_STATE.mdといった外部ファイルに委ねる。LLMには必要な情報だけをファイル経由で参照させ、履歴を肥大化させない。この運用により、会話の一貫性を保ちつつ、コンテキストのクリーンな状態を維持できる。ファイル更新のルールを自分の中に作っておけば、エージェントが迷子になることもない。
7. 推論に効かないノイズデータを排除する
LLMの推論品質に寄与しないノイズは、トークンを食いつぶすだけでなく、AIの集中力を削ぐ要因になる。過剰なログや不要なメタデータは、ツール出力から徹底的に削除する。コンテキストの質を上げることは、推論精度の向上に直結する。何がノイズで何が重要かを見極めるドキュメント読解力は、AI時代においてエンジニアに求められる重要なスキルだ。
| 最適化項目 | 期待できる効果 | 難易度 |
|---|---|---|
| ツール出力の分離 | コンテキストの大幅削減 | 中 |
| 役割分担(司令塔・ワーカー) | コストと品質の両立 | 高 |
| キャッシュTTL最適化 | セッション再開コスト削減 | 低 |
| プラグインの断捨離 | セッション開始時の軽量化 | 低 |
| 外部下読みの導入 | 長文読解コストの削減 | 中 |
| 共有ファイル管理 | 履歴の肥大化防止 | 低 |
| ノイズ排除 | 推論精度の向上 | 中 |
しんたろー:
Claude Codeでコードを書く際、役割分担による司令塔とワーカーの分離が効果的だ。人間がすべてを細かく指示するより、AI同士でタスクを回してもらう方が、コストも時間も節約できる。
ツール出力の分離は、特にデータ量の多いAPIを扱う場合に劇的な効果を発揮する。LLMには「判断に必要な情報」だけを渡すという意識が重要だ。
FAQ
Q1: トークンを節約するとAIの回答精度は落ちるか。
A1: 適切に行えば、むしろ精度は向上する。コンテキストが不要なノイズで埋め尽くされていると、AIは重要な情報を見落とす。必要な情報だけを厳選して渡すことで、モデルが集中すべき対象が明確になり、推論の質が安定する。
Q2: Claude CodeのキャッシュTTLはどれくらいが適切か。
A2: 基本的には1時間の設定が推奨される。短すぎると頻繁にキャッシュが切れて再構築コストが発生し、長すぎると古い情報が残りやすくなる。開発のテンポに合わせて微調整が必要だが、まずは1時間を基準にするのがベストだ。
Q3: 司令塔とワーカーを分けるのは難しくないか。
A3: 最初は設計が複雑に感じるかもしれない。まずは「計画を立てる役割」と「実際にコードを書く役割」を分けるところから始める。Claude Codeのスキル機能や専用の指示ファイルを活用することで、自動化されたワークフローを構築できる。
Q4: ツール出力の要約はどこですればいいか。
A4: ツール実行後に、LLMへ渡す直前の処理としてフィルタリング関数を挟むのが定石だ。JSON形式の不要なフィールドを削除する処理を一行加えるだけで、トークン消費量は変わる。
Q5: どのモデルを使うのが一番コストパフォーマンスが高いか。
A5: 一概には言えないが、調査や単純作業には安価なモデルを使い、最終的な設計判断のみを高性能なモデルに任せるハイブリッド運用が効率的だ。常に最新のモデル性能を確認し、自分の開発スタイルに合う組み合わせを探すのがいい。
AIエージェントのトークン消費に悩んでいるなら、まずは不要なプラグインの削除とキャッシュ設定の確認から始める。小さな最適化の積み重ねが、開発の継続性を左右する。自分の環境を見直し、無駄のない開発環境を構築する。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
