


Claude Codeを使い続けていると、ある日突然「応答の初動が重い」「無関係なコードまでいじり始めた」「指示したルールを無視する」という現象にぶつかる。AIの性能低下の原因はAI本体ではなくコンテキストの肥大化と記憶の管理失敗にある。AIの記憶領域は無限ではない。Claude Codeの作業効率を飛躍的に高める記憶とコンテキストの最適化手順を解説する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
AIの作業机(コンテキスト)と設定ファイルの基礎知識
AIにとってのコンテキストウィンドウは広さに限りのある作業机である。毎セッションごとに、設定ファイルや過去の記憶がその机の上に広げられる。
机の上に無駄な書類が山積みになっていれば、AIは目の前のタスクに必要なコードを広げるスペースを失う。さらに、指示が多すぎると重要なルールを見落とす確率が上がる。設定ファイルの役割を正しく理解し、適切に整理する。
各設定ファイルと記憶の役割比較
| ファイル・仕組み | 主な役割 | 読み込みタイミング | 肥大化のリスク | 最適な管理方針 |
|---|---|---|---|---|
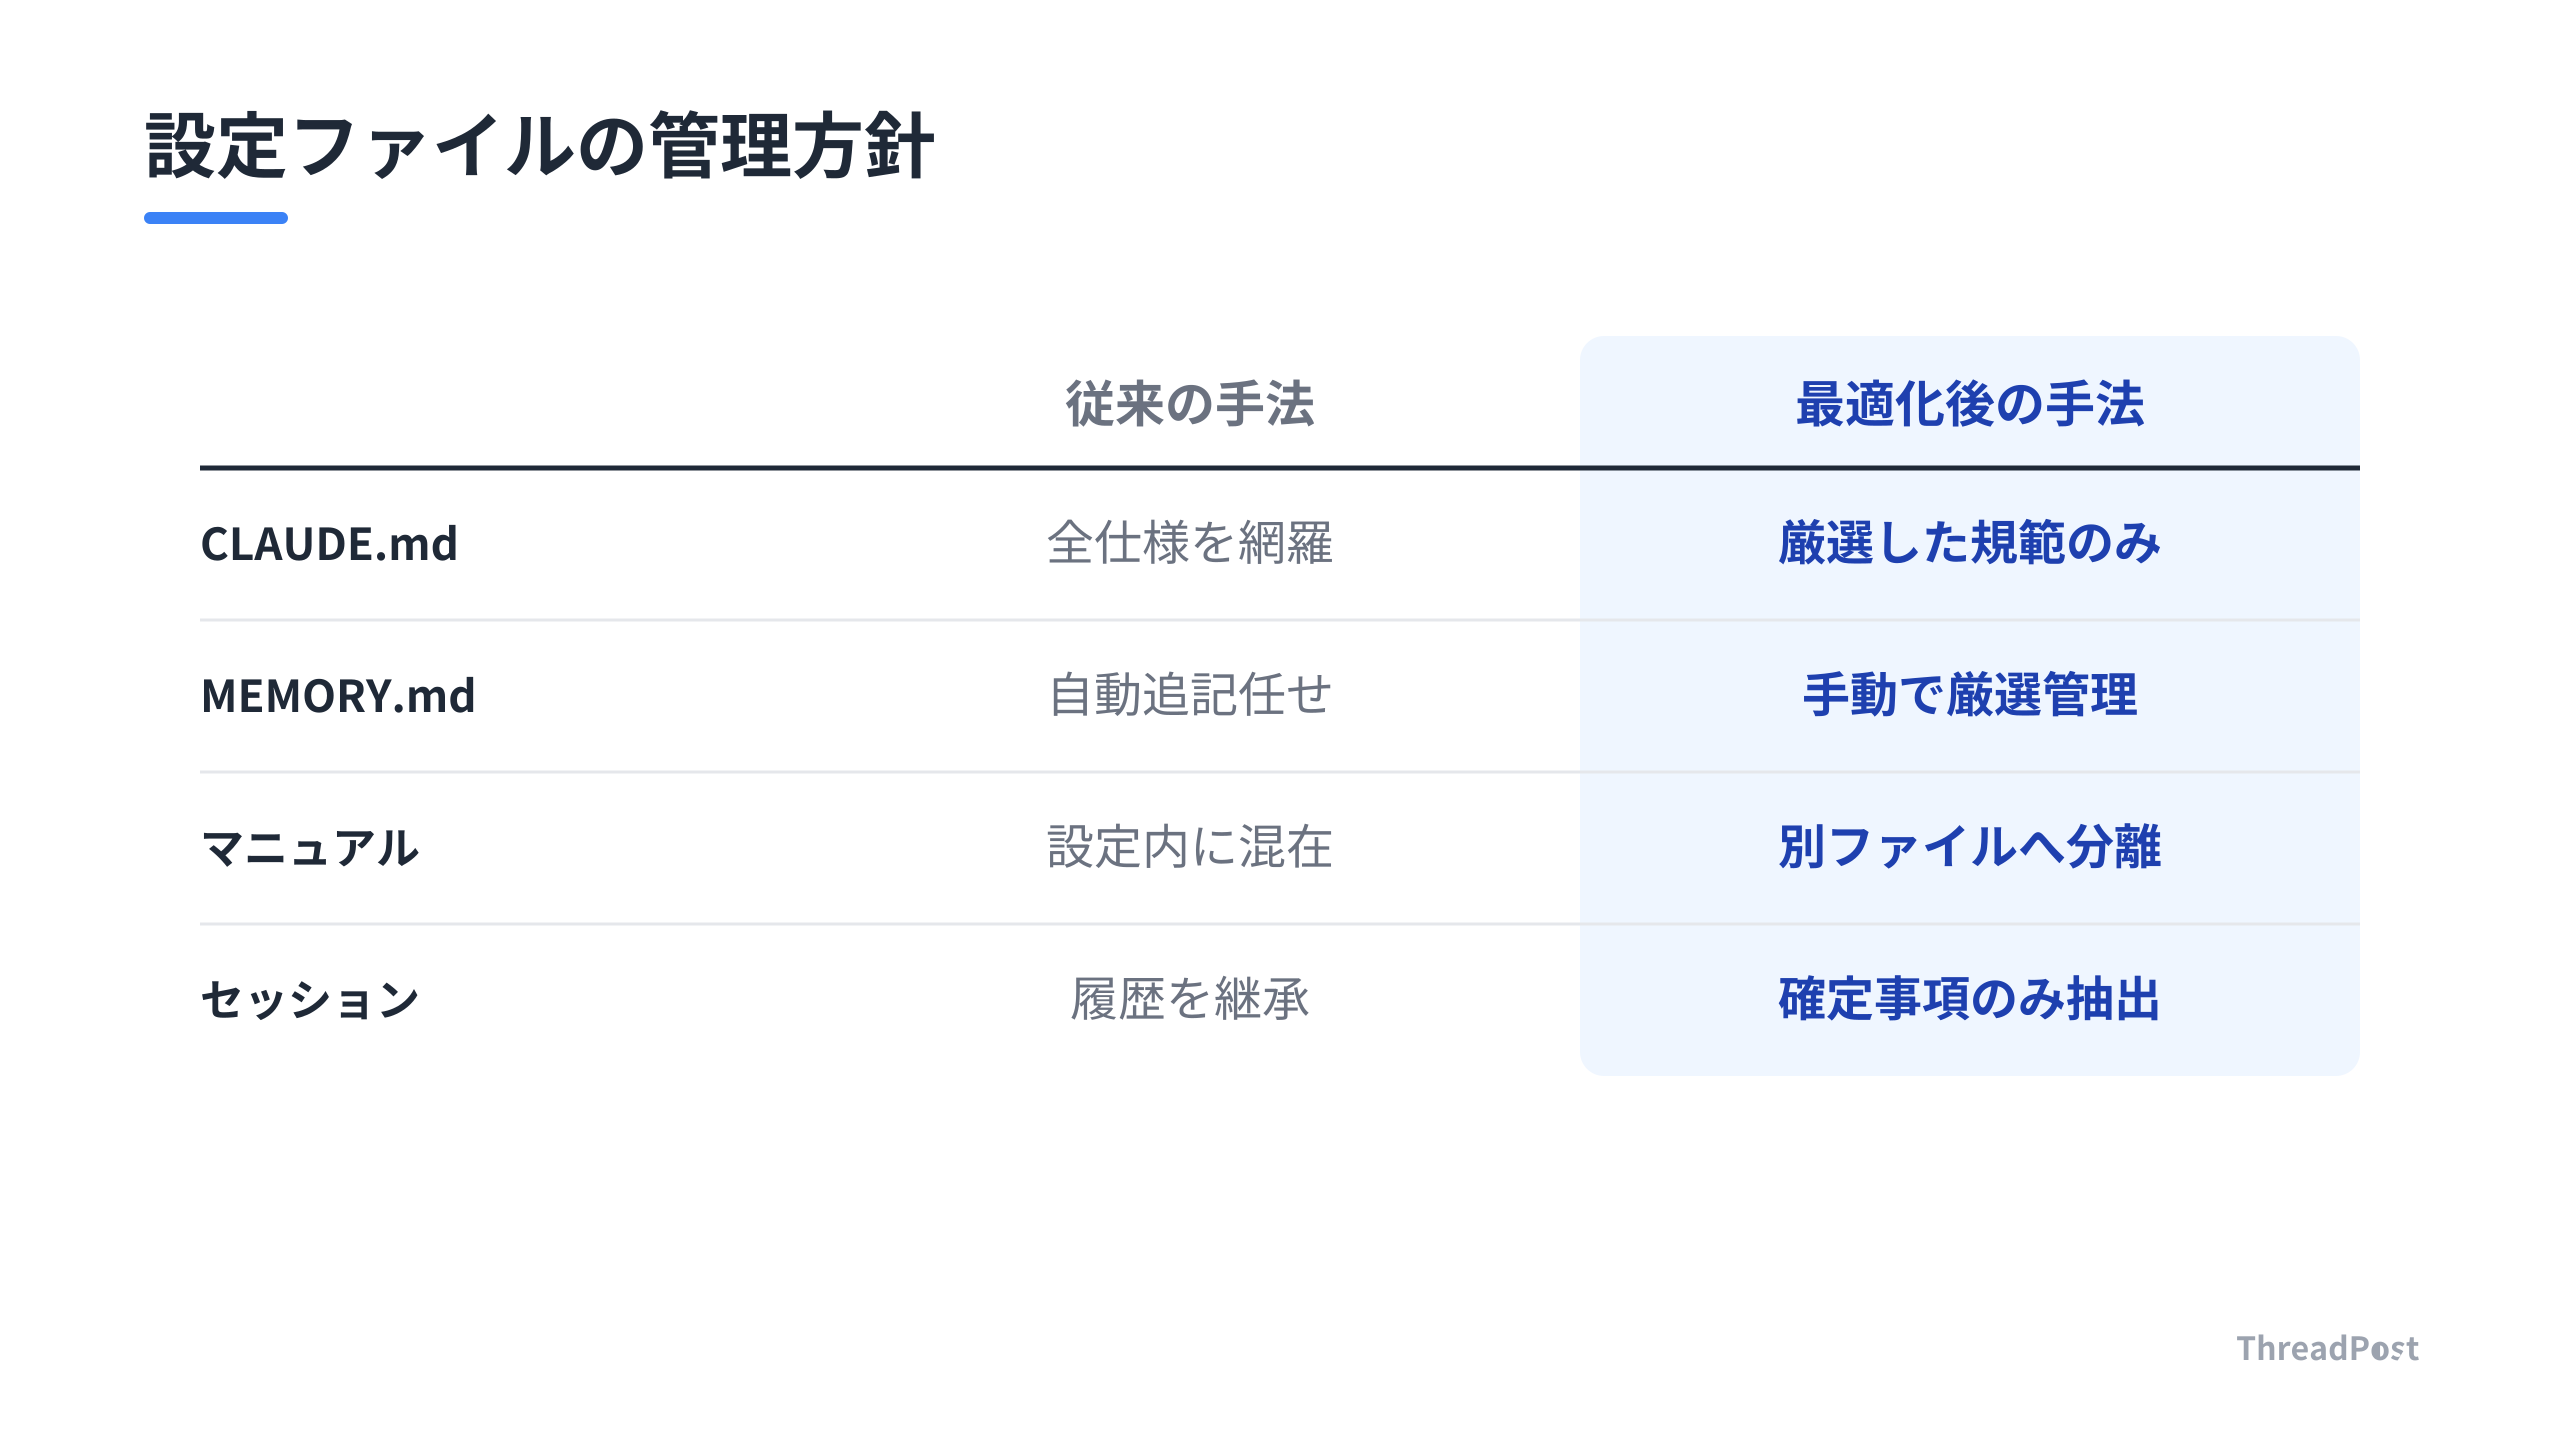
| CLAUDE.md | 毎セッション遵守すべき行動規範 | セッション起動時に毎回全文 | 高(指示遵守率が低下する) | 10件程度の厳選したルールのみ記載 |
| MEMORY.md | AIが自動生成・保存するメモ | セッション起動時に毎回全文 | 極めて高(気づくと数百行化) | 自動追記を禁止し手動で厳選 |
| 別ファイル参照 | 特定作業時のみ読み込むマニュアル | 必要に応じてAIが読み込み | 低(常駐しないため safe) | 細かい手順や仕様書を切り出す |
| 引き継ぎファイル | セッション間の確定事項サマリー | 次回セッション開始時に読み込み | 中(古いログが溜まる) | タスク単位でコンパイルして保存 |
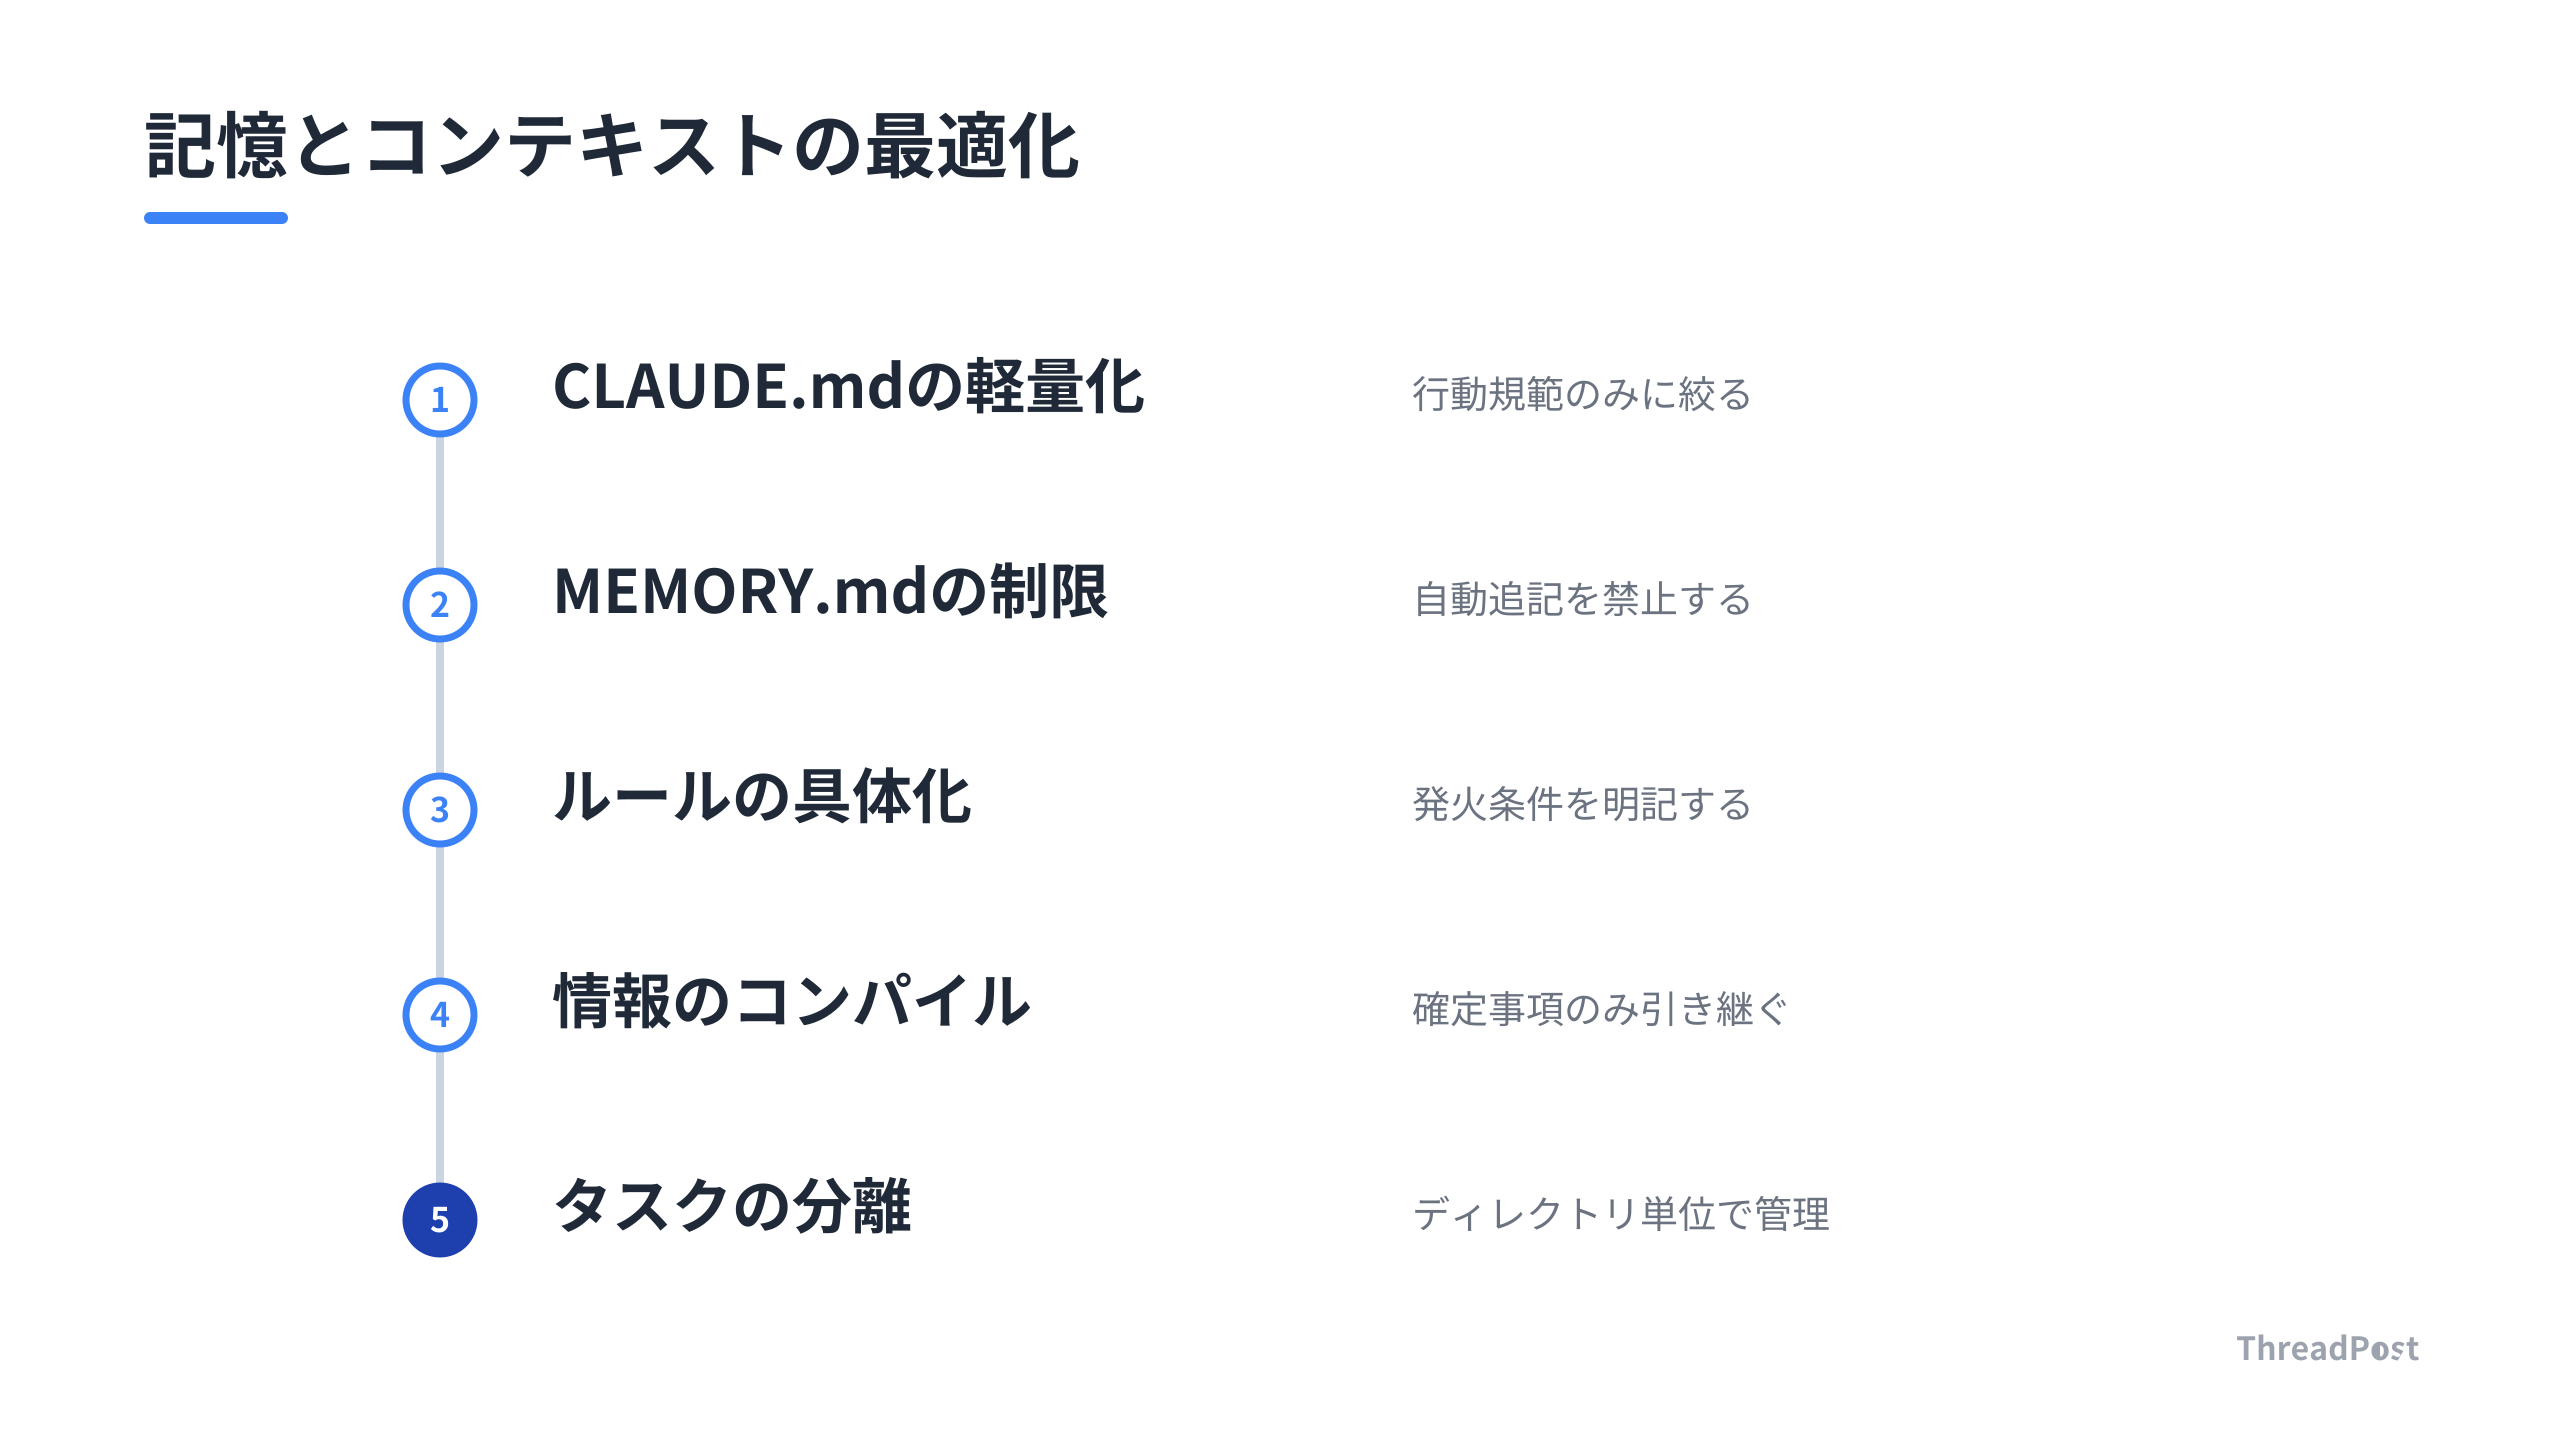
手順1:CLAUDE.mdの「規範」と「参照」を分離する
最初に手をつけるべきは、プロジェクト直下にあるCLAUDE.mdの軽量化である。プロジェクトの仕様、コーディング規約、環境構築の手順などをすべてCLAUDE.mdに詰め込むのは避けるべきだ。
毎セッション必要な「規範」だけを残す
CLAUDE.mdは毎セッション、コンテキストの先頭近くに全文が注入される。ここに500行もの文章が書かれていると、それだけで数千トークンを無駄に消費する。LLMは指示の数が10個から100個に増えると、個々のルールを守る確率が目に見えて下がる。
CLAUDE.mdに書く内容は全セッションで絶対に守らせたい最小限の行動規範だけに絞り込む。「コミットメッセージの形式」や「絶対に使用してはならないライブラリ」といった基本ルールだけを記載する。
詳細なマニュアルは別ファイルへ切り出す
特定作業でしか使わない長文マニュアルは、別ファイルに切り出す。データベースのマイグレーション手順や、特定のコンポーネント作成手順などはdocs/rules/などのディレクトリを作成して個別ファイルとして保存する。
CLAUDE.mdには「データベース変更時は docs/rules/migration.md を参照すること」という1行だけを書いておく。こうすれば常時読み込まれるトークン数を劇的に減らしつつ、必要な場面でのみAIにマニュアルを参照させることができる。
* メリット: 重要なルールが埋もれず、AIの指示遵守率が改善する
* デメリット: ファイル構成を事前に設計する初期コストが発生する
 あわせて読みたいClaude Codeの使い方完全ガイド|インストールから実践まで2年運用の開発者が解説 →
手順2:MEMORY.mdの自動追記を制限し明示的承認を求める
Claude Codeには、会話の中から重要だと判断した情報を自動でMEMORY.mdに追記するauto-memory機能が存在する。これがパフォーマンス低下の最大の原因になりやすい。
放っておくとMEMORY.mdは無限に膨らむ
AIは「ユーザーに指摘されたこと」や「ハマったエラーの回避策」をMEMORY.mdに書き足す。一見便利だが、数週間使うと簡単に数百行に達する。
AIが記憶を圧縮しようとして「詳細は別ファイルを参照」という形式で隠しファイルやリンクを大量生成することもある。表向きの行数は減って見えても、バックグラウンドで大量のファイルを読み込む構造になり、コンテキストが汚染される。
CLAUDE.mdで自動書き込みを明示的に禁止する
この増殖を物理的に遮断するために、CLAUDE.mdにMEMORY.mdへの自動書き込みを禁止するルールを追記する。
「MEMORY.mdへの追記や更新は、必ずユーザーの明示的な許可を得てから行うこと」と明記する。この1行を入れるだけで、勝手な記憶の追加が止まり、コンテキストのクリーンな状態を保てるようになる。定期的にMEMORY.mdのファイルを自分の目で開き、不要になった古い情報は手動で削除する。
* メリット: 意図しないコンテキスト汚染を確実に防げる
* デメリット: 毎回承認のやり取りが発生するため開発のテンポが少し落ちる
手順3:「発火条件」に基づいてルールを記述する
指示ファイルに「気づいたら〜すること」「話が脱線したら戻すこと」のようなルールを書いても、AIにはほとんど機能しない。
「気づいたら」という心構えはAIには届かない
作業に没頭してコードを書いている最中のAIは、自分自身の挙動を客観的に監視する余裕を持たない。「注意深く実装すること」や「推測で進めないと気づいたら質問すること」といった定性的なルールは、肝心の失敗シーンで発火しない。
ルールを守らせるためには、抽象的な心構えを書くのをやめ、モデルの外側から観測可能な出来事をトリガーとして記述する。
観測可能な出来事をトリガーにした書き換え例
「〜するとき」というトリガーを文頭に置く記述に変える。
* 悪い例: 冗長なコードを書かないように注意し、シンプルさを保つこと
* 良い例: ファイルの行数が200行を超えたときは、リファクタリングの提案を行うこと
* 悪い例: 推測で実装せず、不明点があれば質問すること
* 良い例: 外部APIの型定義が存在しない場合は、実装前にユーザーへ確認すること
* 悪い例: 変更前に慎重に影響範囲を確認すること
* 良い例: PRを作成する直前に、既存のテスト全件を実行して成功を確認すること
発火条件を明確にすれば、AIは作業の節目で確実にルールを思い出し、指示を実行できる。
* メリット: 指示が適切なタイミングで確実に実行されるようになる
* デメリット: ルールを具体的なトリガーに変換するための言語化能力が求められる
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
手順4:セッション終了時に情報を「コンパイル」して引き継ぐ
長時間の作業でコンテキストが溢れると、Claude Codeは会話履歴を要約するcompact処理を走らせる。しかし、この自動要約に頼ったり、生の会話履歴をそのまま次のセッションに貼り付けたりすると精度は著しく低下する。
生の履歴はノイズの塊である
作業中の会話履歴には、試行錯誤の過程や、没になった設計案、途中で発生した一時的なエラーログが大量に含まれる。これらをそのまま次のセッションに持ち込むと、新しいAIセッションは「没になった案」を再検討し始めたり、避ける必要のないエラーを回避しようとして遠回りを始めたりする。
セッションを終える際、あるいはコンテキストが重くなってきた際は、一度情報を確定事項だけに凝縮(コンパイル)する作業が必要である。
確定した仕様だけを要約して書き出す
セッションを終了する前に、AIに対して「今日のセッションで確定した仕様」「決定したデータ構造」「次回着手すべき残タスク」の3点だけをファイルに書き出させる。試行錯誤のプロセスや失敗の記録は捨て、確定した結果だけをテキスト化する。翌日作業を再開する際は、その引き継ぎファイルだけを冒頭で読み込ませる。
* メリット: 前日の失敗や没案に引きずられず、常にクリーンな状態で作業できる
* デメリット: セッション終了時に要約を行わせる運用ルーチンが必要になる
手順5:タスク単位のディレクトリ構造で文脈を分離する
プロジェクトが大きくなってくると、複数の機能開発やバグ修正の文脈が混ざり合い、AIの判断を狂わせる。これを防ぐにはタスク単位でのディレクトリ管理が効果的である。
プロジェクト直下にタスク専用フォルダを作る
プロジェクトのルート直下にタスク管理用のディレクトリを用意し、その中に日付やタスク名がついたサブディレクトリを作成する。機能追加を行う際は、専用のディレクトリを作成し、その中にタスクの計画書(plan.md)、残作業リスト(todo.md)、そしてセッションの引き継ぎメモを格納する。セッション開始時には、そのタスクディレクトリだけをAIに読み込ませる。
関連情報だけをピンポイントで注入する
この構造を作っておくと、関係のない他の機能の文脈がAIの作業机に持ち込まれることがなくなる。コンテキストの混線を防ぐことで、AIの処理速度と回答精度は向上する。
* メリット: タスク間のコンテキスト混線を防ぎ、整理された作業が可能になる
* デメリット: ディレクトリ構造を維持管理する運用ルールを徹底する必要がある
しんたろー:
僕もClaude Codeで1人SaaS開発を毎日行っているが、最初は指示ファイルを何百行も書いて自滅していた。情報を詰め込むほどAIが賢くなるというのは勘違いで、実は「何を削るか」が一番大事だと気づいてから開発速度が激変した。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
初心者がハマりやすい3つのつまずきポイント
Claude Codeの記憶管理を始める際、多くの人が同じ罠にハマる。あらかじめ失敗パターンを知っておくことで、無駄な回り道を回避する。
1. 強い言葉を使えばルールが守られるという勘違い
ルールが無視されたとき、「絶対に」「必ず」「IMPORTANT」といった強い言葉をCLAUDE.mdに書き足す人が多い。しかし、どれだけ強調表現を使っても、コンテキストが溢れていればAIはルールを見落とす。言葉を強めるのではなく、指示の総数を減らすことが唯一の解決策である。
2. 古い指示を残したまま新しい指示を追加する
開発が進むと、過去に使っていたライブラリや規約が変更になることがある。このとき古い指示を消さずに新しい指示を追加すると、AIの内部でルールの矛盾が発生する。新しいルールを追加する際は、必ず古くなったルールを削除か更新する。
3. セッションを閉じずにダラダラと会話を続ける
1つのセッションで何日も作業を続けたり、全く別のタスクを連続して行ったりするのは良くない。コンテキストが長く伸びるほど、初期に設定した前提条件が薄れ、AIの挙動が雑になる。タスクの区切りや1日の終わりには必ずセッションを閉じ、要約ファイルを作成してリセットする習慣をつける。
記憶の管理だけでなく、日々のルーチンワークを省力化する環境作りは、AIコーディングの精度向上と同じくらい価値がある。
FAQ(よくある質問)
Q1: CLAUDE.mdが長くなると、なぜAIの性能が落ちる?
LLMにはコンテキストウィンドウという作業机の広さに限界がある。不要な指示で机が埋まると、本当に重要なコードや現在のタスクに関する情報が押し出されたり、注意力が分散して指示の遵守率が下がったりするためである。
Q2: MEMORY.mdを全削除しても問題ない?
まったく問題ない。MEMORY.mdは必要に応じて再生成される。ファイルが肥大化してAIの応答が重くなっている場合は、一度全削除してしまい、本当に必要なルールだけを手動で再構築する方がAIの挙動は安定する。
Q3: ルールの「発火条件」をうまく書くコツは?
文頭に「〜の時は」という条件節を具体的に置くことである。「コードを書くときは」のような曖昧な指定ではなく、「PRを作成する直前に」や「DBマイグレーションを実行するとき」のように、AIが明確に識別できるタイミングを指定すると守られやすくなる。
Q4: セッションの引き継ぎメモには何を書くべき?
今日行ったすべての作業履歴を書く必要はない。「確定した仕様」「決定したデータ構造」「次に着手すべきタスク」の3点だけに絞って記載する。途中で発生したエラーや没案は、次のセッションでAIが迷う原因になるため削るのがコツである。
Q5: ルールが増えすぎたとき、どれを削ればいい?
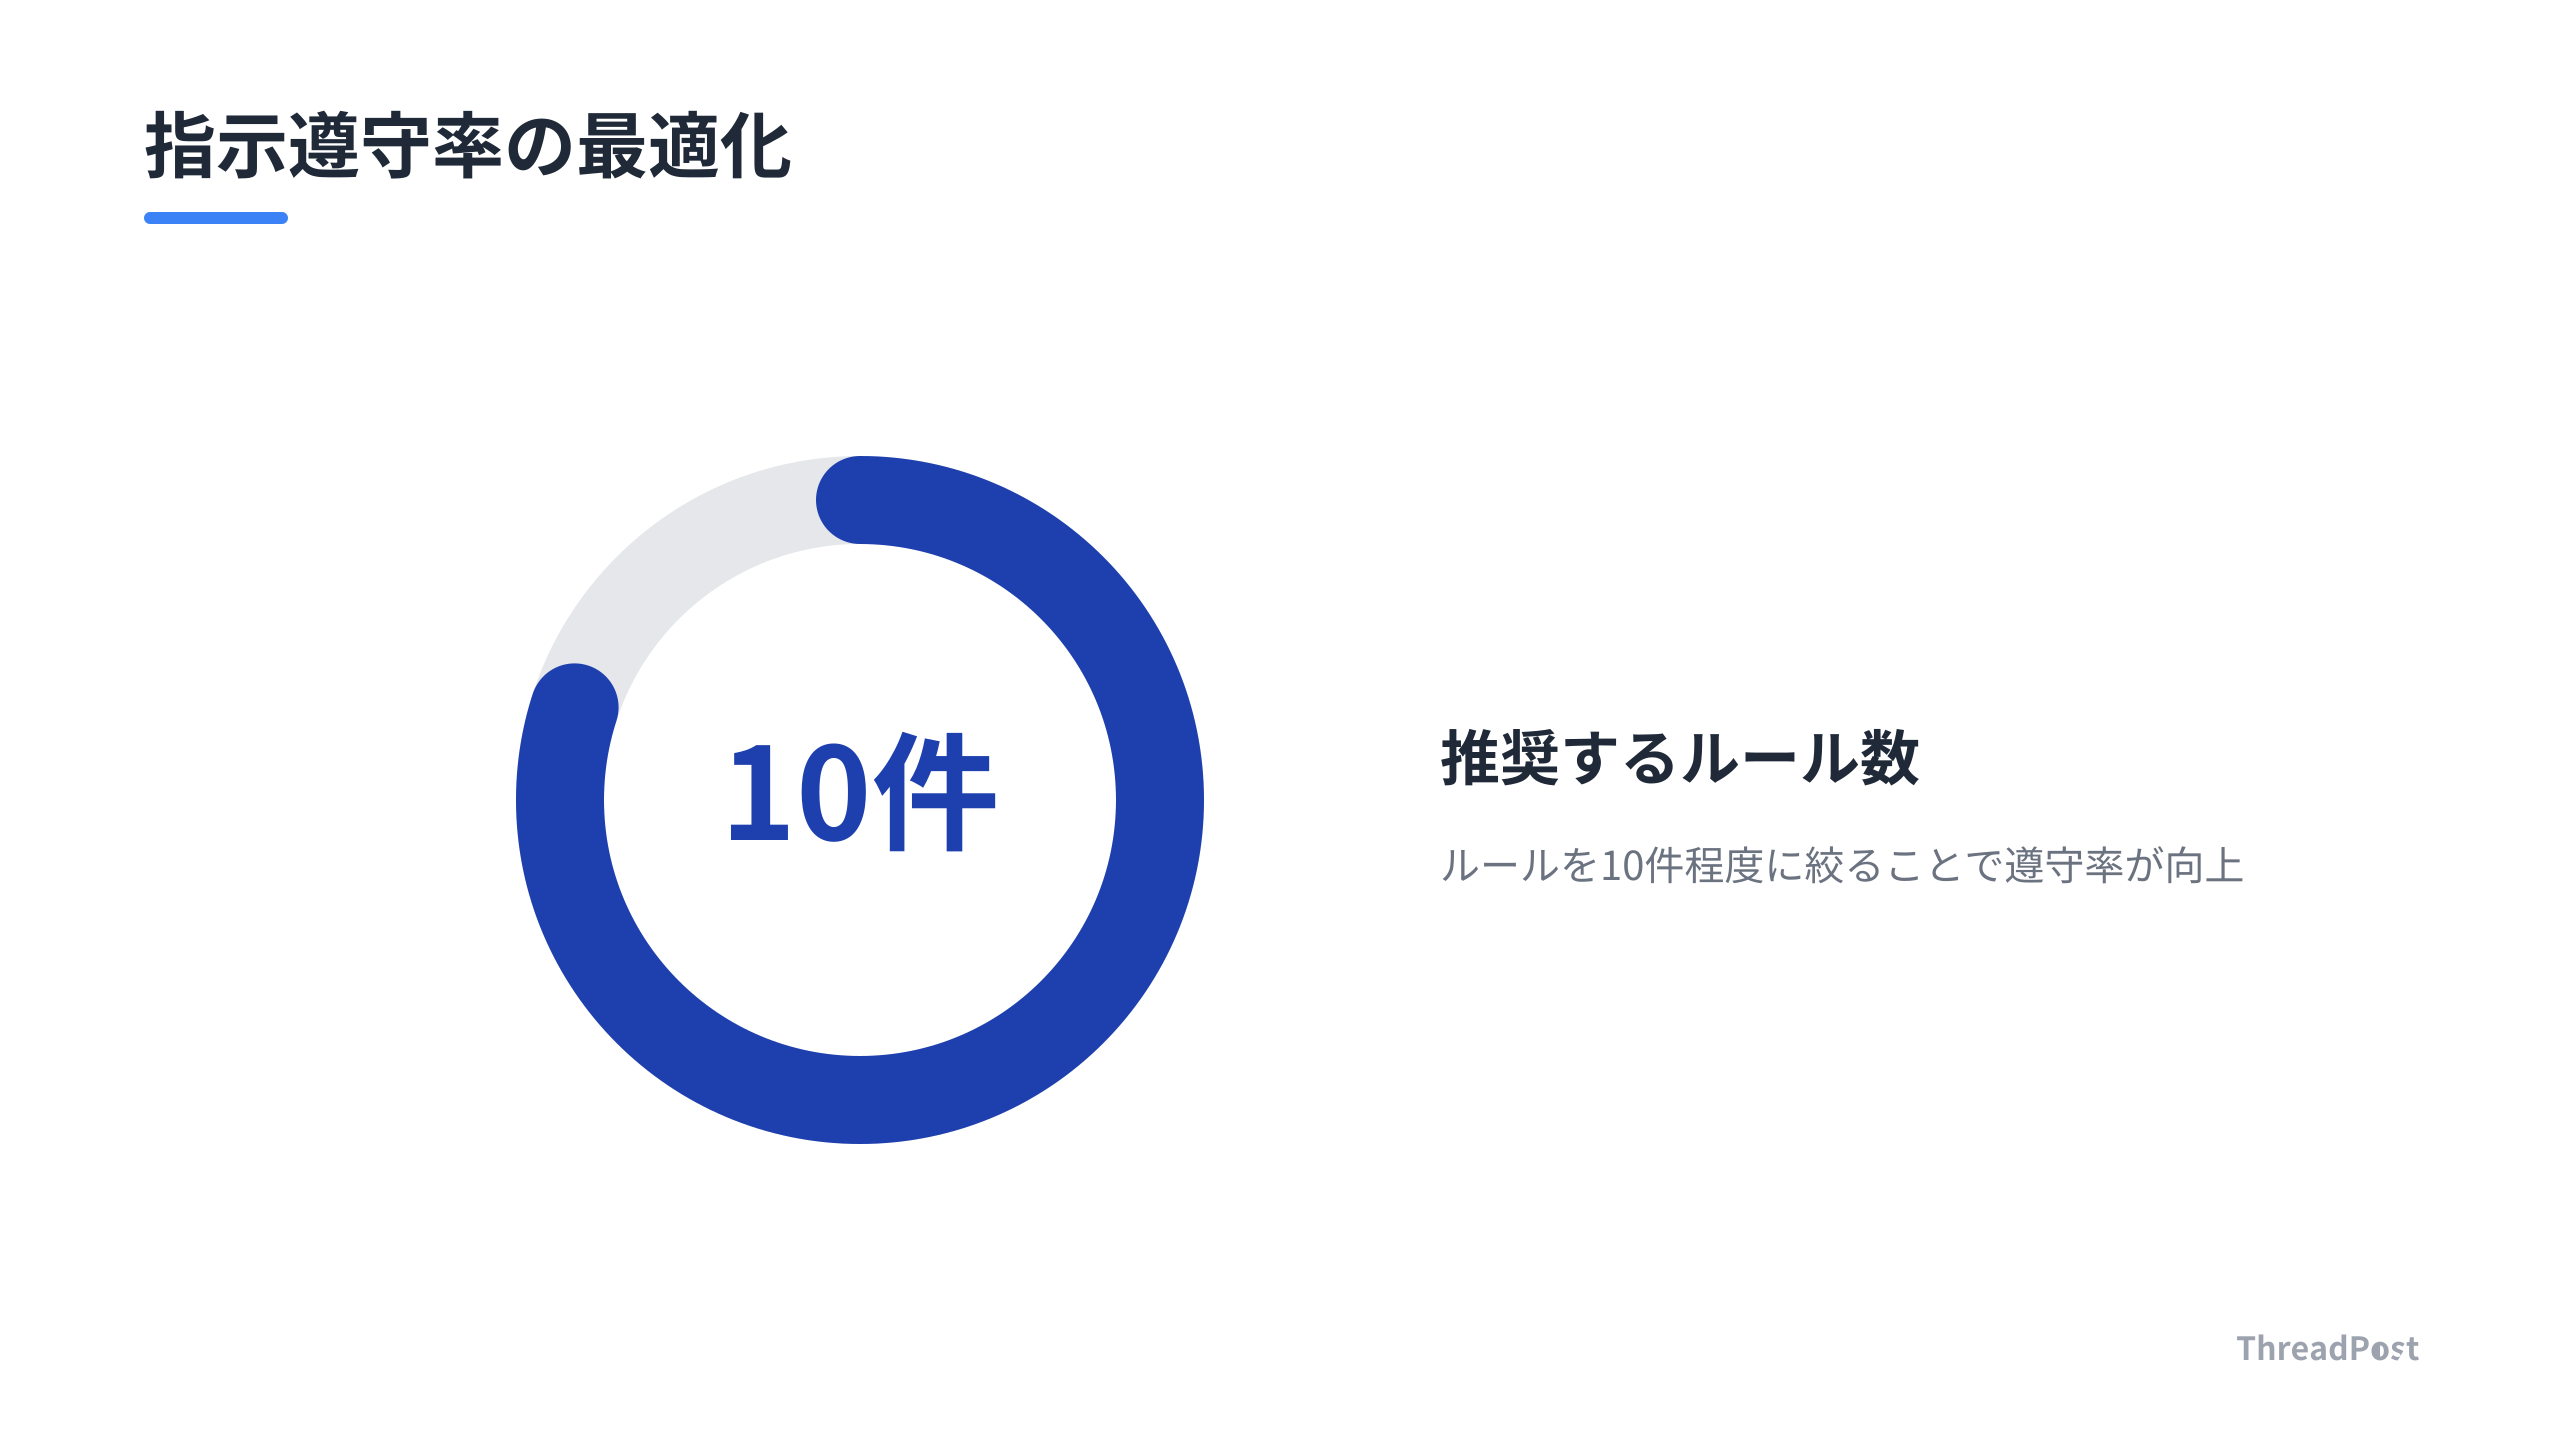
常時読み込ませるルールの限界数を「10個まで」とあらかじめ定めておく運用がおすすめである。新しいルールを追加したい場合は、既存のルールの中で最も優先度の低いものを1つ削除か別ファイルへ移動させ、常に一定の件数を保つようにする。
まとめと次のステップ
Claude Codeの性能を極限まで引き出すキーポイントは、AIに記憶を持たせることではなく、不要な記憶を削ぎ落とすことである。
- CLAUDE.mdは全セッション必須の行動規範10個だけに絞る
- MEMORY.mdへの自動追記を禁止し、勝手な肥大化を防ぐ
- ルールは「〜するとき」という具体的な発火条件で書く
- セッション終了時は確定事項だけをコンパイルして引き継ぐ
- タスク単位のディレクトリで文脈の混線を防ぐ
まずは今日作業しているプロジェクトのCLAUDE.mdを開き、不要な指示を削除するところから始める。無駄な文脈を削ぎ落とすだけで、Claude Codeの応答速度とコード生成精度は向上する。
開発作業の無駄を削ぎ落として自分の時間を作れたら、発信活動も自動化してさらに効率化を進める。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】ローカルLLM環境構築5ステップ|APIコストゼロでAI開発
