


Claude Codeのサブエージェント設定を調整する。エージェント開発は「モデルの賢さ」を追い求めるフェーズを終えた。役割ごとに計算資源を割り当て、出力の検品ゲートを外付けする「ハーネス設計」が主流だ。
「プロンプトを磨く」作業は過去のものだ。ThreadPostの開発では、Planner、Generator、Evaluatorといった役割ごとのeffort調整と、Stopフックによる自動検品を実装する。モデルの気まぐれに頼らず、仕組みで品質を担保する。この設計への切り替えで、開発パイプラインの安定感は向上した。本稿では、AI開発を「賢いモデル任せ」から脱却させる、実戦的なハーネス構築術を解説する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
AIエージェント開発のパラダイムシフト:役割分担と実行環境の最適化
AIエージェント開発において「ハーネス(Harness)設計」という概念が注目されている。モデルの重み以外でエージェントの振る舞いを制御する、開発者側の「実行環境の構築」を指す。
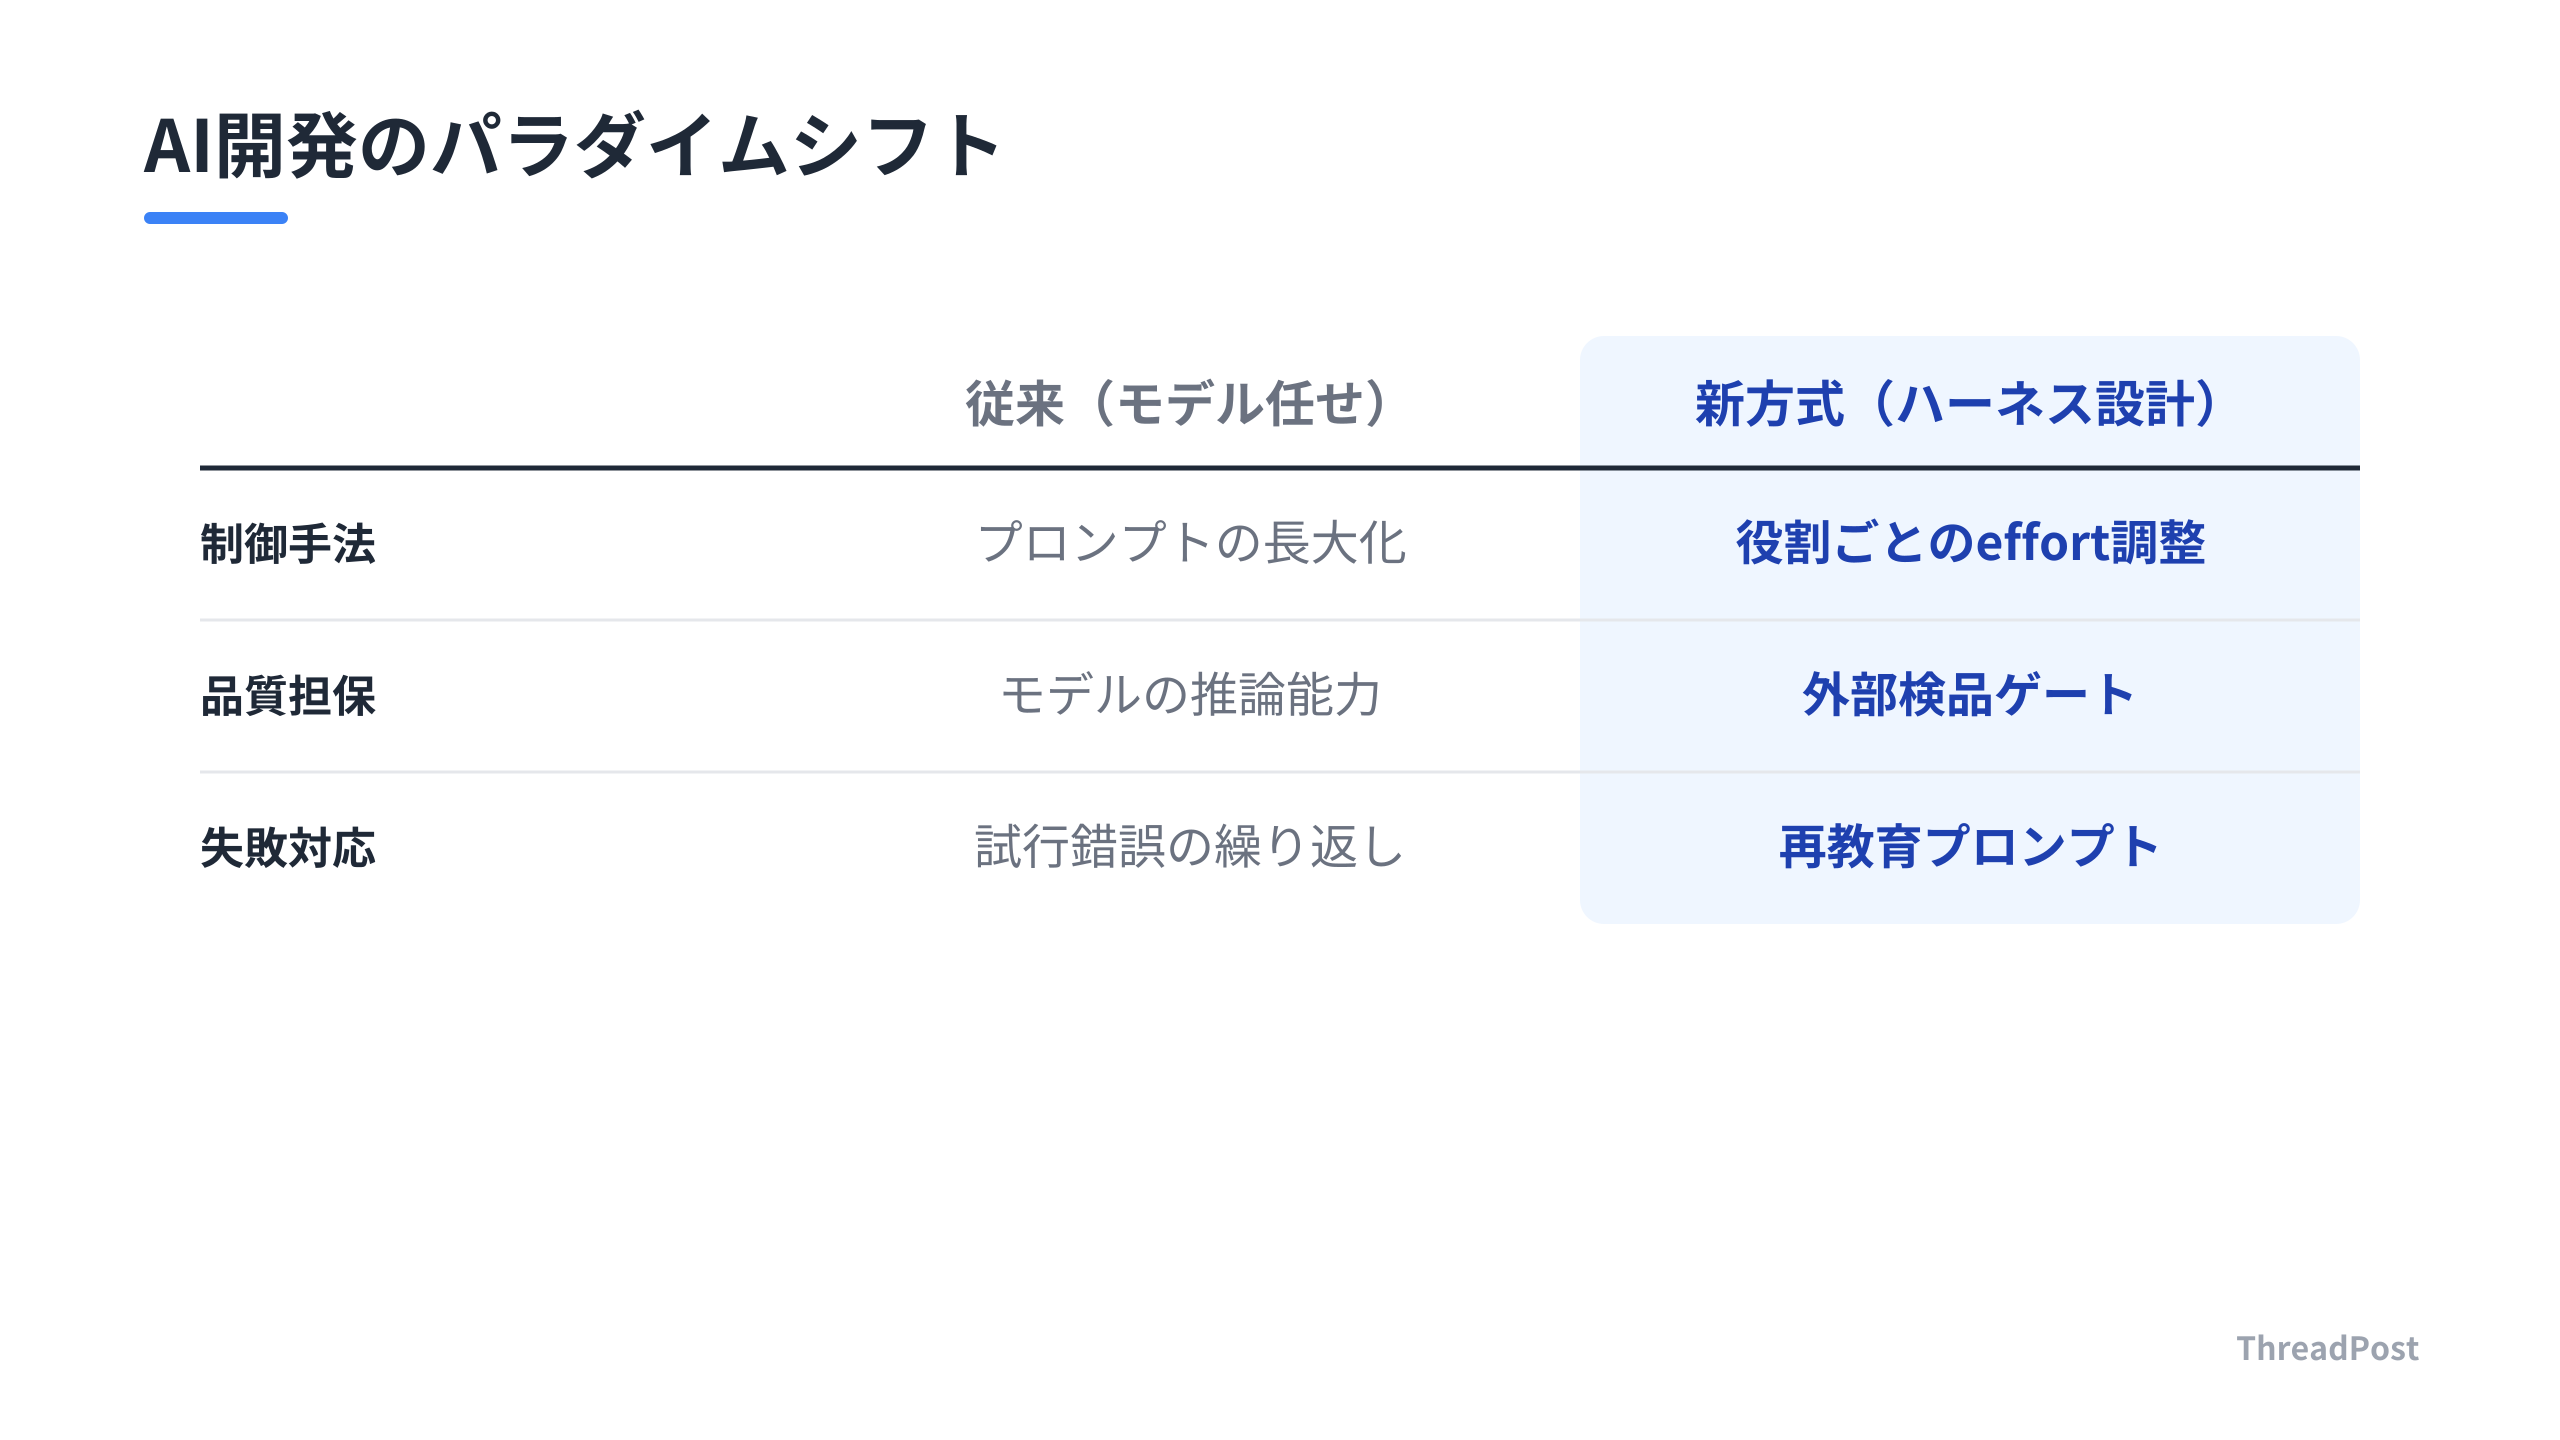
Claude Codeのサブエージェント機能におけるeffort設定を活用する。1つのタスクに対して均一な計算資源を割り当てる手法から、Planner(探索)、Generator(実装)、Evaluator(検証)といった役割ごとに最適なeffortレベルを割り当てる手法へ移行する。
Claude Codeの仕様では、サブエージェントの設定ファイルにおいてeffortフィールドを操作することで、セッションごとの計算強度をlowからmaxまで動的に変更可能だ。探索が主目的のPlannerにはhigh以上のリソースを割き、検証が主目的のEvaluatorにはリソースを絞り、人間への承認フローを介入させる「階層的エージェント制御」を行う。
しんたろー:
役割ごとにeffortを切り分ける発想が現場で機能する。全部のタスクを力技で解かせようとすると、API制限とトークン代が嵩む。Plannerにリソースを集中させ、実装は堅実に行う。このメリハリを仕組み化できるのがClaude Codeの利点だ。
StopフックとSessionStartフックを活用した検品ゲートを構築する。エージェントの出力を外部のPythonプロセスでキャッチし、ルール違反があればその場でブロックして自己修正を促す。
LLMの出力品質を保つためにプロンプトを長くする手法は限界がある。ハーネス設計を導入すれば、独自のコーディング規約や禁止用語を機械的にチェックできる。違反を検知した際は、違反内容をJSONLに追記し、次回のセッション起動時に再教育プロンプトとして差し込むループ構造を確立する。
現在の開発現場では、Anthropic SDKやPydanticのみを使ってエージェントのループ処理を実装する動きがある。モデルの「賢さ」というブラックボックスに依存せず、失敗回復や権限管理をハーネス層で担保する。「エージェント=モデル+ハーネス」という再定義が、最前線のエンジニアの設計の核心だ。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
 あわせて読みたいClaude Codeの使い方完全ガイド|インストールから実践まで2年運用の開発者が解説 →
役割ごとの計算資源割り当てと「ハーネス」による品質担保
多くの開発者が「モデルの賢さ」を追い求めてAPIのパラメータを調整し、プロンプトを長大化させる。しかし、Claude Codeを使い込むエンジニアの間では、エージェントを「賢い単一の脳」として扱うのではなく、役割分担されたサブエージェントと、それらを制御する「ハーネス(Harness)」の集合体として設計する手法が主流だ。
各サブエージェントに一律の能力を割り当てるのではなく、タスクの性質に応じてeffort(計算資源)を動的に変化させる。実装の方針を決定するPlannerには高い探索能力を割り当て、検証を行うEvaluatorには最小限の計算資源を割り当てる。この「役割ごとのeffort最適化」は、モデルの推論能力を、タスクの「機微性」や「後戻りコスト」という物理的な制約に合わせて適材適所に配分する設計だ。
モデルの出力に対する「検品ゲート」を設置する。モデルが生成するコードや日本語には癖や揺らぎが生じる。プロンプトエンジニアリングで修正しようとしても、出力が長くなればモデルは指示を忘れる。モデルの外側で動作するPythonコードによる「検品ハーネス」を導入する。Stopフックで応答を捕捉し、ルールに違反していれば即座にブロックして再生成を促す。このループ構造が、モデルの気まぐれをシステム的に封じ込める。
プロンプトをこねくり回すより、Pythonでif文を書いて「違反したら弾く」と決める方が安定する。Claude Codeのサブエージェント設定をいじりながら、どの層でエラーを拾うかを設計する。
開発者が注力するのは「プロンプトの記述」から「実行環境(Harness)の設計」へのシフトだ。失敗した際の回復処理(Retry)や、権限管理(Permission Layer)をモデルの出力に委ねず、ハーネス側のロジックで完結させる構成が、長期間運用するSaaS開発において信頼性を生む。
Anthropic SDKとPydanticだけでエージェントのループを実装する。「どこでモデルが迷子になるか」が観測可能になる。失敗の境界線を観測すること。それがハーネスエンジニアリングを習得するための道だ。
この設計思想を導入すると、Claude Codeのサブエージェント定義は単なる設定ファイルではなく、システム全体の振る舞いを規定する設計原則となる。役割ごとのeffortレベルを3軸で評価し、検品ロジックを外付けする。AIを「魔法の箱」から「制御可能なツール」へと変える。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
開発現場に持ち込むべき「ハーネス設計」の具体ステップ
実務への落とし込みは、AIエージェントの構成を「役割」と「検品」の2軸で分解することから始まる。
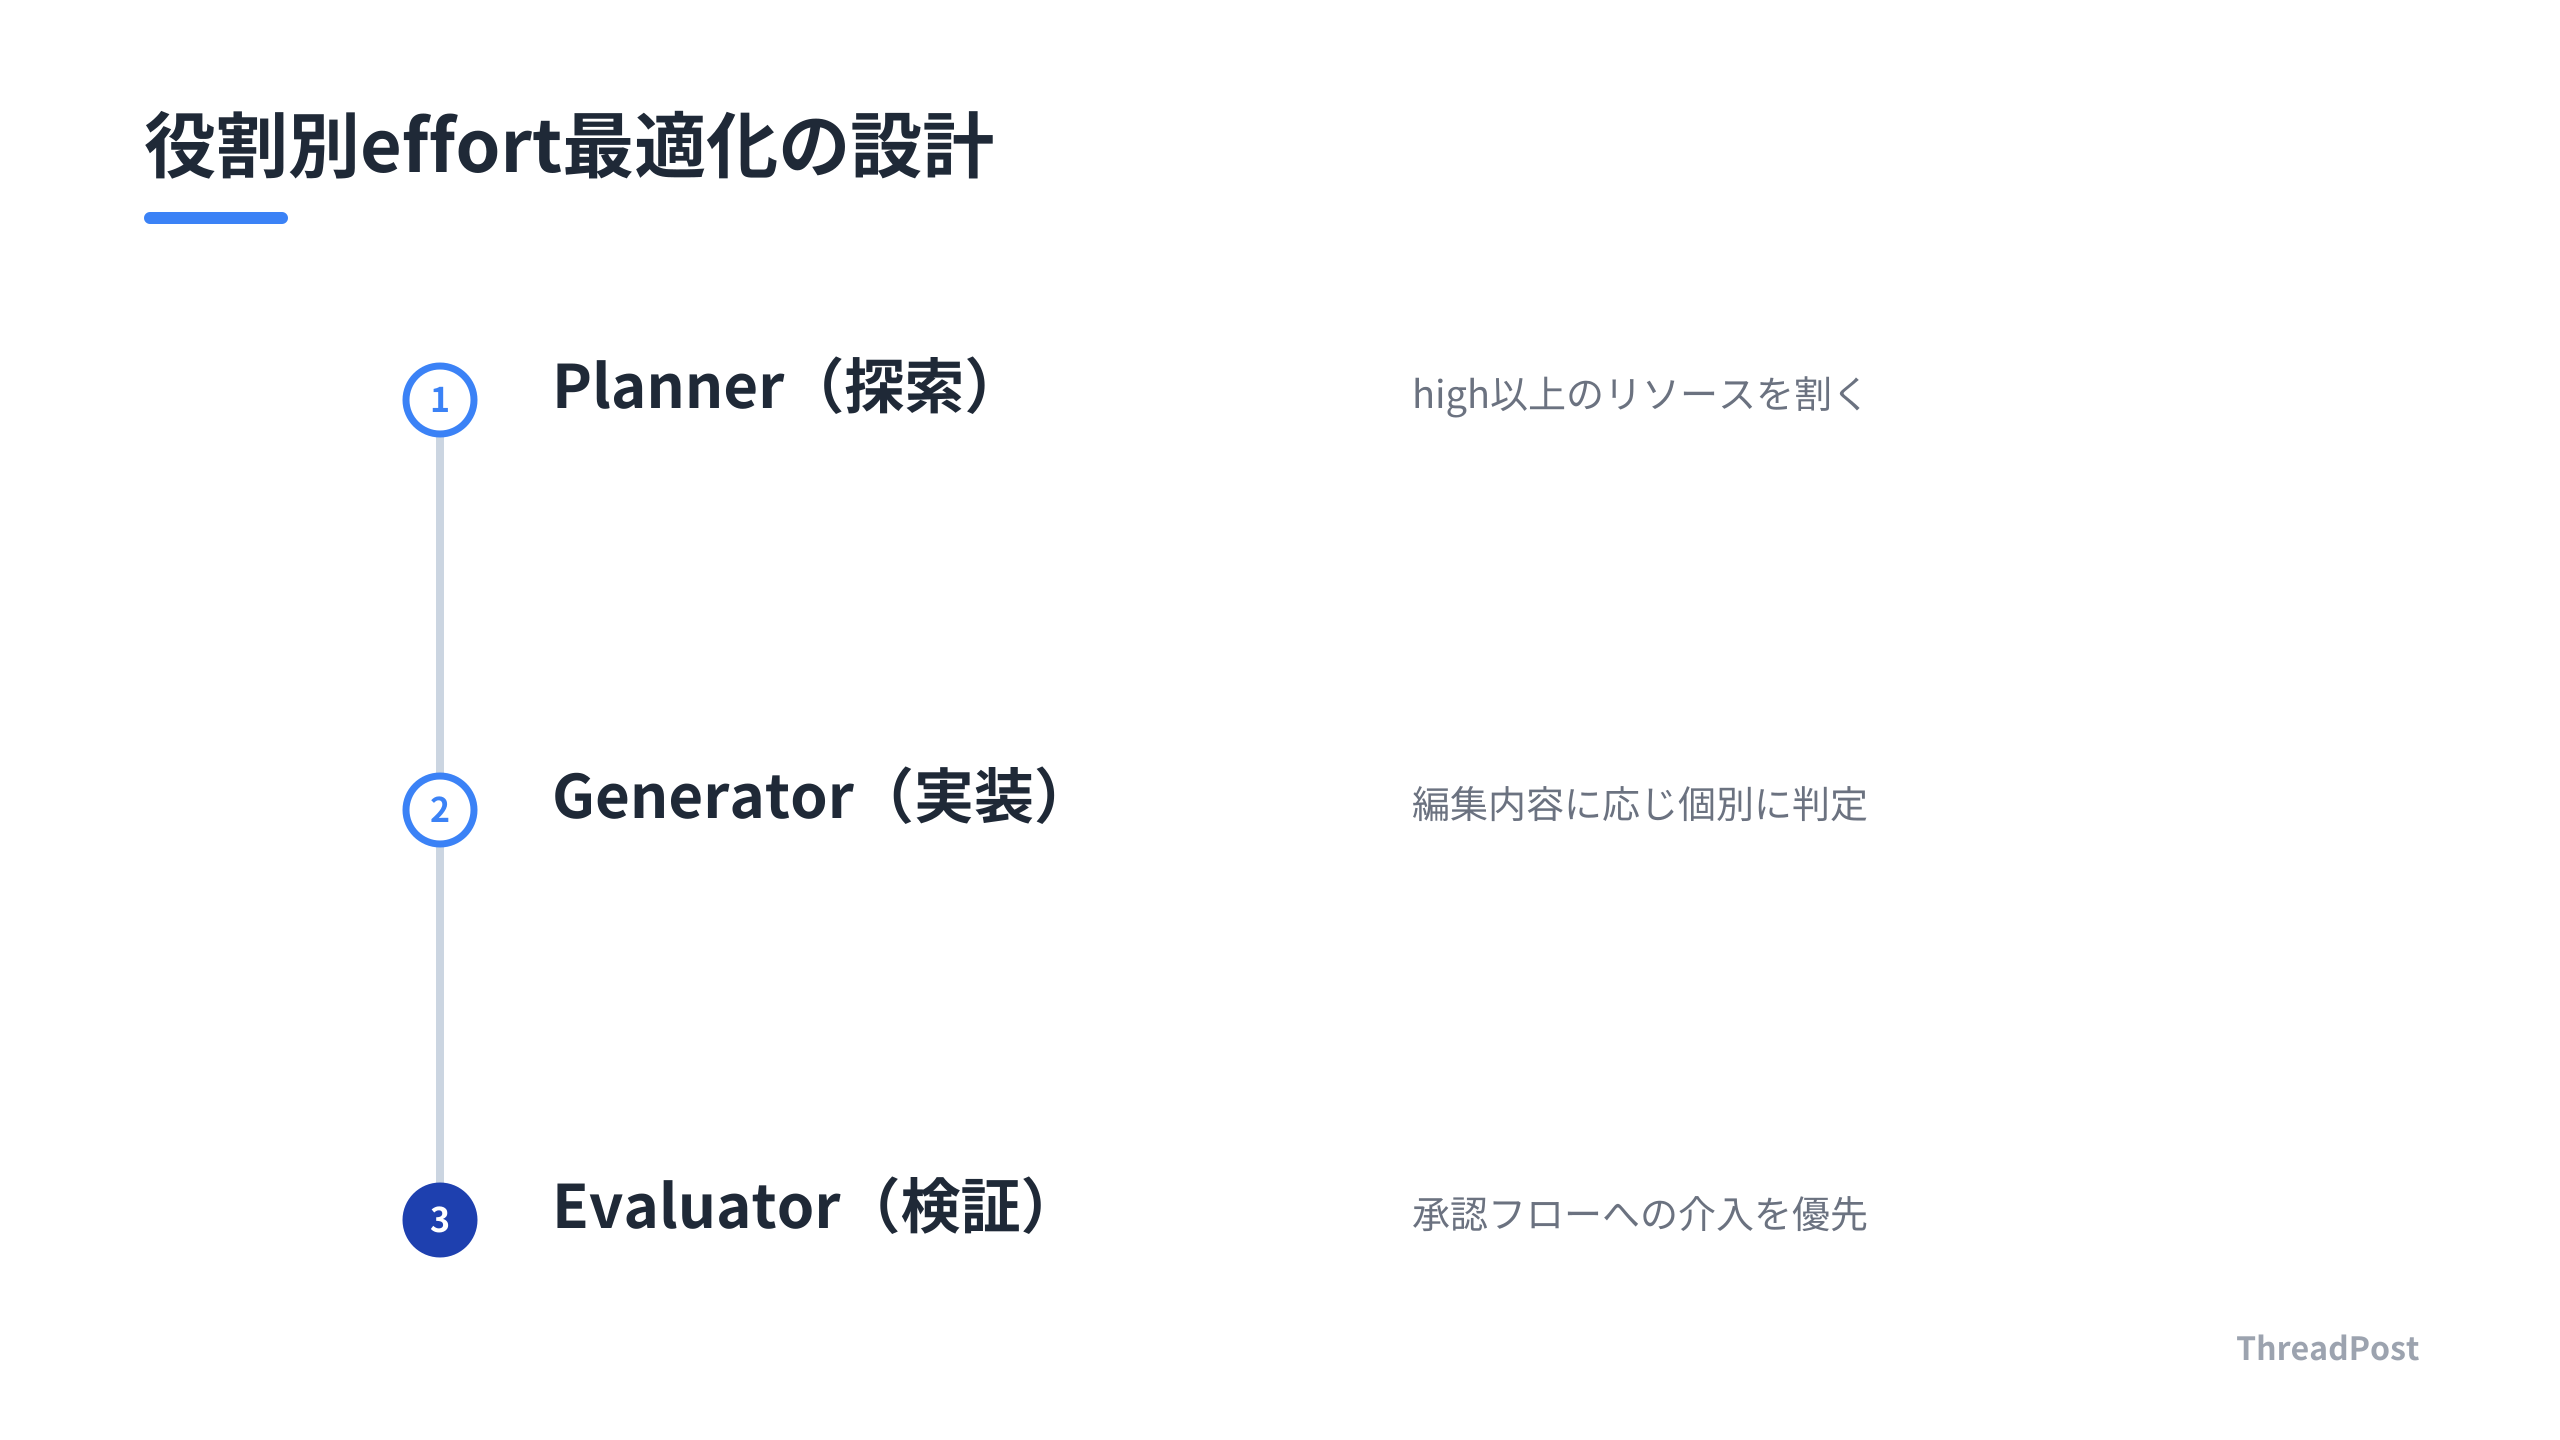
Claude Codeのサブエージェント設定を見直す。「Planner」「Generator」「Evaluator」という役割ごとに切り分ける。
- 探索担当(Planner): 広い視野が必要なため、effort は high 以上に設定する。
- 実装担当(Generator): 編集内容に応じて個別に判定する。機微な修正ならまずは調査のみを許可する。
- 検証担当(Evaluator): 計算資源を割く必要はない。重要なのは「基準を満たさない場合に、どう人間へ戻すか」という承認フローの設計だ。
この構成により、モデルの「賢さ」に頼り切った開発から、システムとしての「信頼性」を担保する開発へシフトする。
役割ごとにeffortを細かく調整すると、APIコストが下がる。検証担当にmaxを割り当てるのは無駄だ。コードの正しさはテストコードで担保し、モデルの推論回数で解決しようとするのは浪費だ。
次に、「検品ゲート」の外付けを行う。プロンプトで指示し続けるのではなく、Pythonスクリプトで検品ロジックを書き、Claude Codeのフック機能に載せる。
- 検品ロジックはLLMの外に置く: Pythonの正規表現やルールベースで十分だ。
- 再教育プロンプトを自動生成する: 違反内容をファイルに書き出し、次のセッション起動時に「前回の違反」として読み込ませる。
- 継続推論を賢く使う: 違反時に無理やり修正させるのではなく、一度ブロックしてcontinuationを走らせ、モデル自身に回答を客観視させる。
これらの実装は、SDKとPydanticだけで完結させる。ブラックボックスを剥がして、どこでエラーが起き、どこでモデルが迷子になるかを観測する。この観測が、AI開発の現場における「実務能力」だ。
検品ゲートを1つ追加するほうが、長期的な開発コストは下がる。ThreadPost開発でも、この「検品による自己修正ループ」を導入してから、バグの発生率が減少した。AIを「魔法」として扱うのではなく、制御可能な「コンポーネントの集合体」として設計する。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
よくある質問
サブエージェントのeffortレベルはどのように決めるべきですか?
タスクの「機微性」「後戻りコスト」「探索の広さ」の3軸で判断する。Plannerのように探索が目的で、やり直しが容易なタスクには high や xhigh を割り当てる。Evaluatorのような検証担当には、計算資源を増やすことよりも、人間への承認フローを組み込む設計を優先する。
LLMの出力品質を上げるために、プロンプトを長くするのとハーネスを作るのはどちらが良いですか?
長期的な運用なら、ハーネス(仕組み)の構築を推奨する。プロンプトによる指示はモデルの気まぐれに左右されるが、Stopフック等で検品ロジックを外付けすれば、違反を機械的にブロックし、モデルに自己修正を強制できる。トークン消費を抑えつつ、プロジェクト固有の用語やコーディング規約を守らせるには、プロンプトよりも検品ゲートが有効だ。
Harness Engineeringを学ぶには何から始めればいいですか?
LangChainのような抽象度の高いライブラリを一度外し、SDKとPydanticのみを使って、エージェントのループ処理を1から実装する。どの層でエラーが起き、どこでモデルが迷子になるかを観測する。失敗回復のロジックや権限管理のレイヤーを自前で書くことで、AIエージェントの信頼性を担保するための「設計原則」が理解できる。
まとめ
AIエージェントを「賢いモデル」としてではなく「制御可能なシステム」として設計するハーネスエンジニアリング。
Claude Codeのサブエージェント設定や検品フックは、この設計思想を現場に落とし込むためのインターフェースだ。
「モデルの賢さ」に頼り切る開発から、役割ごとに計算資源を最適化し、検品ゲートで品質を担保する「仕組み」へシフトする。
皆さんの開発環境では、どのようなハーネスを実装しているか。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
