


SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
資産をAIに預ける時代の幕開け
ChatGPTがユーザーの金融口座と連携を開始した。
12,000以上の金融機関と接続し、資産状況をリアルタイムで把握する。
これは単なる家計簿アプリの進化ではない。
AIが個人の財務という、最も複雑でプライベートな「文脈(コンテキスト)」を手に入れた。
開発者から見れば、これは究極のRAG(検索拡張生成)の商用実装だ。
モデルの性能は前提に過ぎない。
これからのAI活用で差がつくのは、「周辺データの構造化」の徹底度だ。
そこを疎かにすれば、最新のGPTを使っても精度の低い回答しか得られない。
AIに正しい判断をさせるための、残酷なまでの「準備」について深掘りする。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
財務コンテキストを記憶する新しいAI体験
ChatGPTは銀行口座、クレジットカード、投資口座とセキュアに接続する。
ユーザーはChatGPTの中に自分専用の財務ダッシュボードを持つ。
資産の推移や支出状況を一目で確認できる。
最大の特徴は、AIがユーザーの「財務的な背景」を理解した上で対話する点だ。
「来年、新しい車を買いたいんだけど、今の収支でローンは組める?」という質問にも対応する。
AIは実際の預金残高、月々の固定費、過去の支出パターンを把握している。
「今の支出ペースだと、あと3ヶ月は貯金が必要だ」といったパーソナライズされた回答を出す。
連携できる金融機関は12,000以上だ。
接続には信頼性の高い外部基盤が使われている。
ユーザーは自分のデータをAIに「記憶」させるかどうかをコントロールできる。
「親に借金がある」「近いうちに大きな買い物を予定している」といった事情を伝えれば、AIはそれを「長期メモリ」として保持する。
将来のあらゆるアドバイスにその文脈を反映させる。
AIは単なる「物知りな機械」から、真の意味での「パーソナルアシスタント」へ進化した。
AIが参照するデータが、曖昧なテキストから「構造化された生データ」に変わった。
この変化が、推論の精度を劇的に引き上げている。
AIは同期されたデータを自動でカテゴリ分けし、分析の土台を作る。
この「魔法のような体験」の裏側には、緻密なデータの整理整頓が存在する。
しんたろー:
ついに来たかという感想だ。
銀行口座をAIに晒すのは怖いけれど、この便利さを知ったら戻れない気がする。
開発者目線で見ると、膨大な金融データをどうやって「AIが読みやすい形」で保持しているのか、その設計思想が気になる。
※この記事は、Claude Codeで1人SaaS開発しているしんたろーが、海外AI最新情報を開発者目線で解説する「AI活用Tips」です。
開発者が直面する「周辺環境」という名の壁
今回の金融連携を見て、開発者が学ぶべきことがある。
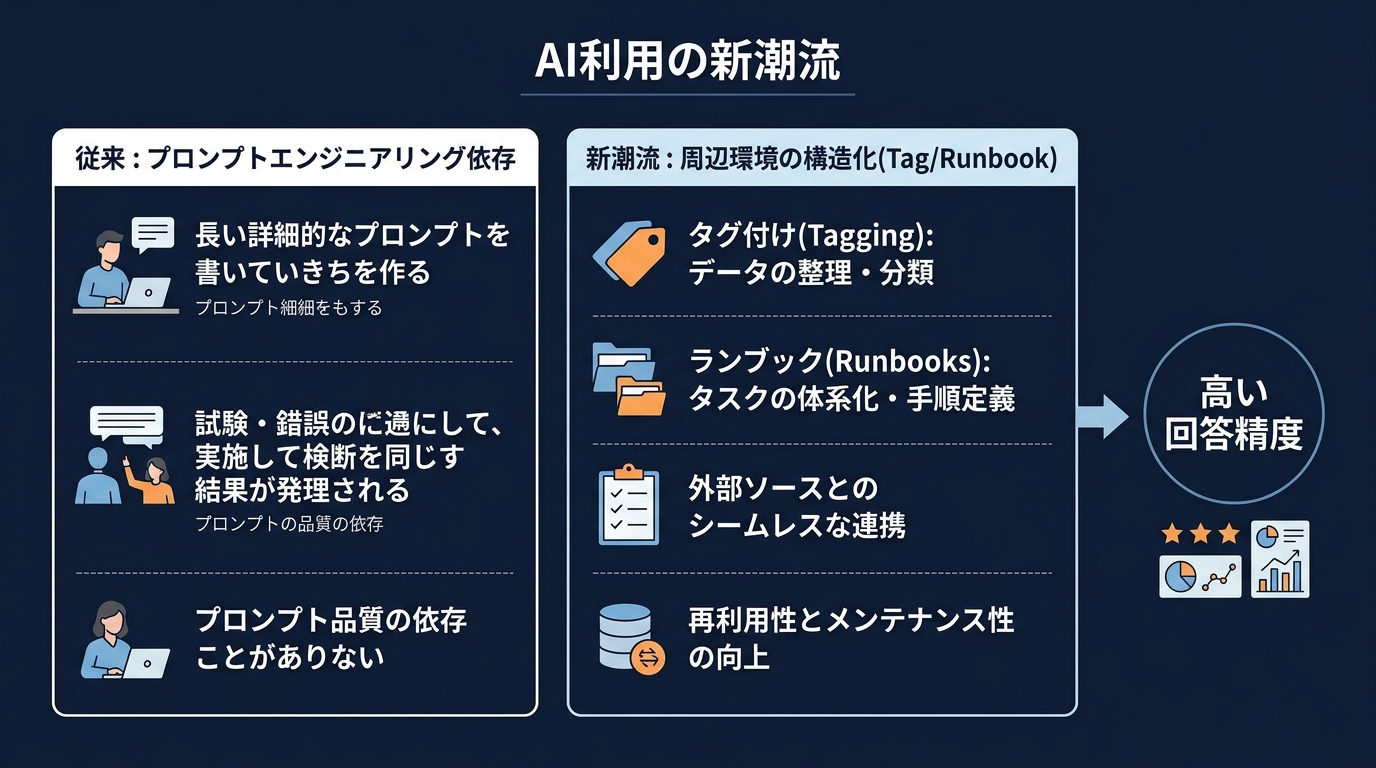
「AIの回答品質は、モデルの推論能力以上に、周辺環境の整備状況に依存する」という事実だ。
最新のモデルを使っても、食わせるデータがバラバラならAIは嘘をつく。
データが美しく構造化されていれば、一世代前のモデルでも正確に動く。
これはシステムの運用監視や障害対応をAIに行わせる検証でも明らかだ。
AIにシステムの異常を調査させる際、ただログを流し込むだけでは不十分だ。
そこに「Tag(タグ)設計」が加わると話が変わる。
環境、サービス名、担当チームなどのメタデータがすべてのログに正しく付与されているか。
この「軸」が揃っているだけで、AIは関連する情報を横断的に探し出せる。
さらに重要なのが、「Runbook(手順書)」の存在だ。
「このアラートが出たら、まずこのログを確認し、次にこのコマンドを打て」といった手順が自然文で整理されていると、AIはそのレールに乗って推論を進める。
AIの自律性を高めるのは、モデルの賢さではない。
「AIが迷わないためのインデックス」の整理状況だ。
これはClaude Codeでも同じだ。
ローカルのコードベースを理解させる際、フォルダ構造がぐちゃぐちゃだとAIは必要なファイルを見つけられない。
ドキュメントが古いままだと、AIは間違った仕様に基づいてコードを生成する。
「AIが読みやすい構造」を僕らが提供できるかが、エンジニアの腕の見せ所だ。
具体的には、ハイブリッドメモリという考え方が重要だ。
意味の近さで探すベクトル検索と、特定の単語で探すキーワード検索を組み合わせる。
さらにAIが使える「ツール」を適切に配置する。
このモジュール化されたアーキテクチャこそが、AIエージェントの正解だ。
OpenAIが提供する金融体験も、この構造を大規模に実装したものだ。
ユーザーの生の財務データを、AIが扱いやすいメタデータと共にインデックス化する。
だからこそ、複雑な個人の事情を踏まえた回答が可能になる。
本当にやるべきは、「AIが参照する情報の海を、どうやって整理されたライブラリに変えるか」だ。
Claude Codeで毎日コードを書いていて、結局「整理整頓」がすべてだと感じる。
フォルダ名ひとつ、コメントひとつで、AIの打率が10倍変わる。
プロンプトをこねくり回すより、READMEを1枚丁寧に書くほうが生産的だ。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
プロンプトを捨ててデータエンジニアリングに戻る
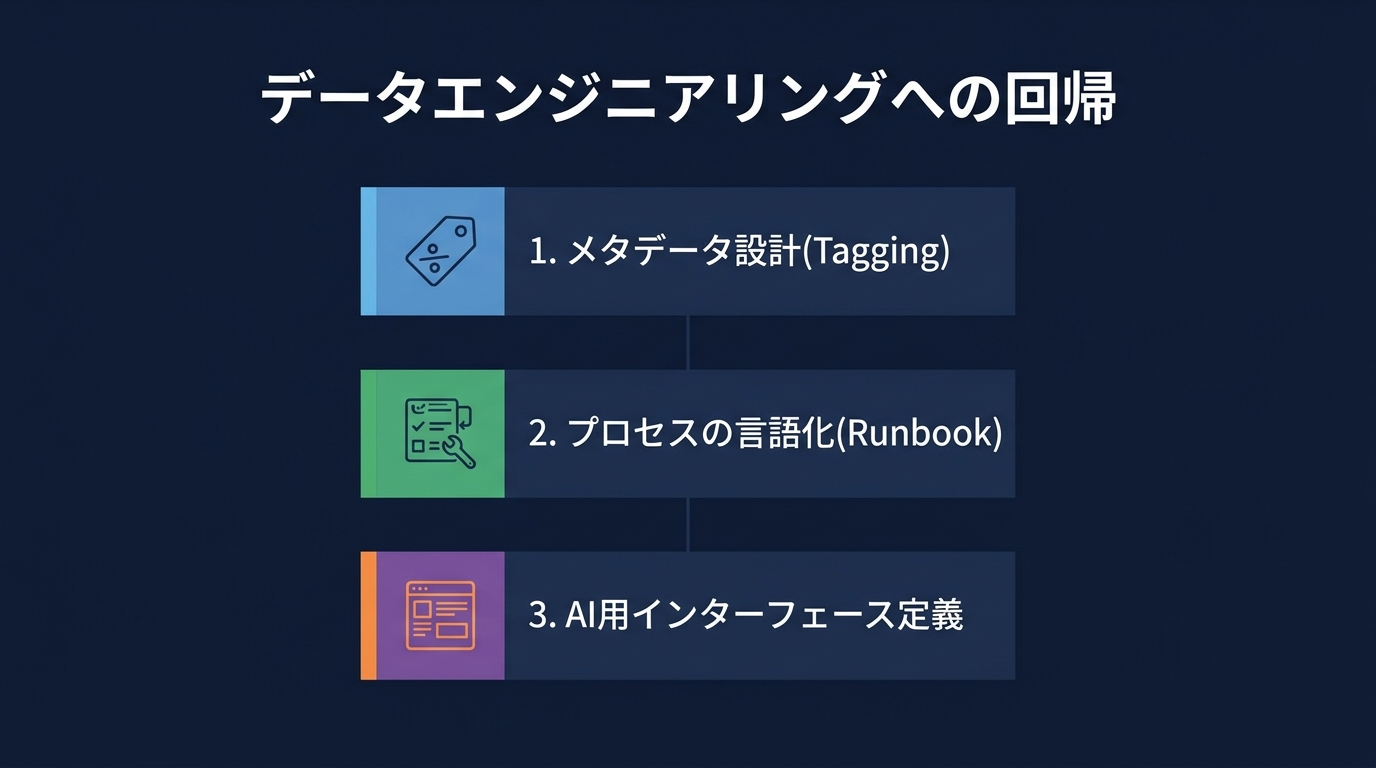
これからの本流は、データエンジニアリングへの回帰だ。
AIを実務で使いこなすなら、以下の3つのアクションを検討する。
第一に、「徹底的なメタデータ設計」だ。
自社のプロダクトや社内ドキュメント、あらゆるデータにAIが検索のフックにできるタグを付ける。
「これはどのプロジェクトの、いつの時点の、どんな性質のデータか」をデータベースのスキーマレベルで実装する。
第二に、「プロセスの言語化(Runbook化)」だ。
業務の手順、判断基準、過去の失敗事例をAIが参照できるテキストとして整理し、コンテキストとして流し込む。
AIは、定義された「レールの上の推論」において、人間を凌駕する。
第三に、「AIのためのインターフェース定義」だ。
AIが外部のツールやAPIを叩く際、その引数や戻り値がどうあるべきかを設計する。
これからの開発工数の大半は、モデルの選定ではなく、この「周辺環境の構築」に割かれる。
AIは魔法の杖ではない。
僕らが用意したデータの質を増幅する、高性能な「増幅器」だ。
元のデータがゴミなら、AIが生成するのも高度に装飾されたゴミだ。
逆に、データ構造が完璧なら、AIは想像を超えるパフォーマンスを発揮する。
自分の開発しているプロダクトを、一度AIの目線で見直す。
そのデータベースは、AIにとって「読みやすい地図」になっているか。
この視点を持つだけで、AI活用は次のステージへ進む。
結局、地味な作業が最強の武器になる。
綺麗なスキーマ、一貫性のある命名規則、最新のドキュメント。
昔から「良いエンジニア」の条件だったものが、AI時代になってさらに重要度が増した。
楽をするために、今は泥臭くデータを整えるしかない。
 あわせて読みたい【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録 →
AI活用の疑問に答える
Q1: AIの回答精度が低い場合、モデルを最新にする以外に何ができるか?
AIが参照しているデータの「構造化」を徹底してください。
具体的には、情報の関連性を明確にするためのTag設計を見直すことが効果的です。
また、AIが次に取るべき行動を迷わないよう、具体的な手順を記したRunbook(手順書)を整備し、それをAIがいつでも参照できる環境を作ってください。
さらに、ベクトル検索に頼りすぎず、キーワード検索を組み合わせたハイブリッドな検索手法を導入することで、特定の固有名詞や数値に対する回答精度は向上します。
Q2: 金融連携のような機能を自社アプリに実装する際の注意点は?
最大の壁は、セキュリティと「データの整合性」の両立です。
機密性の高い情報を扱う場合、生のデータをそのままAIに渡すのではなく、推論に必要なメタデータだけを抽出して分離する設計が求められます。
また、AIが記憶した内容をユーザー自身が確認・修正・削除できる「メモリ管理UI」を必ず提供してください。
ユーザーが「AIが自分の何を覚えているか」を透明に管理できる状態を作ることが、長期的な信頼関係を築く鍵となります。
Q3: AIに学習させるデータは、すべてJSONなどの形式にすべきか?
必ずしも厳密な形式にこだわる必要はありませんが、AIが「検索の軸」にできる情報を付与することは必須です。
むしろ、数値やコードの羅列に加えて、「なぜこのデータが重要か」という背景を自然文で添えるほうが、AIの推論の質は高まります。
構造化データ(JSON等)で情報の骨組みを作り、非構造化データ(自然文)で肉付けをしてください。
この両方のバランスを保ちながら、AIが文脈を正しく拾える「インデックス」を整備することが、実務上のボトルネックを解消する近道です。
整理整頓がAIを最強にする
AIの賢さは、僕らが用意した「周辺環境」で決まる。
モデルの進化を待つだけでは、本当の価値は生まれない。
今あるデータをどう構造化し、AIが迷わないためのレールをどう敷くか。
その地味で泥臭いデータエンジニアリングこそが、AI時代の勝者を決める。
プロンプトに凝る前に、まずは自分のドキュメントとデータベースを掃除する。
整理整頓こそが、最強のAI活用術だ。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

【2026年版】Claude Codeのセキュリティ対策12選|1人開発者が実践する防御策

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】ローカルLLM環境構築5ステップ|APIコストゼロでAI開発
