


クラウド上のAIサービスに頼らず、手元のマシンでAI開発エージェントを動かす時代が到来した。RTX 5090や最新のMacBook Proがあれば、プライバシーを保護しつつ、無制限の試行錯誤が可能になる。自分のマシンを最強のAI開発環境へと進化させる。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
前提知識と必要な準備
ローカルLLMの運用にはPCのスペックがすべてだ。特にVRAMやユニファイドメモリの容量が足りないと、モデルの読み込みすらできない。最低でもRTX 5090(32GB VRAM)か、128GBメモリを搭載したMacBook Proが必要だ。さらに、Ollamaのようなランタイムを導入し、モデルの挙動を制御する知識も求められる。
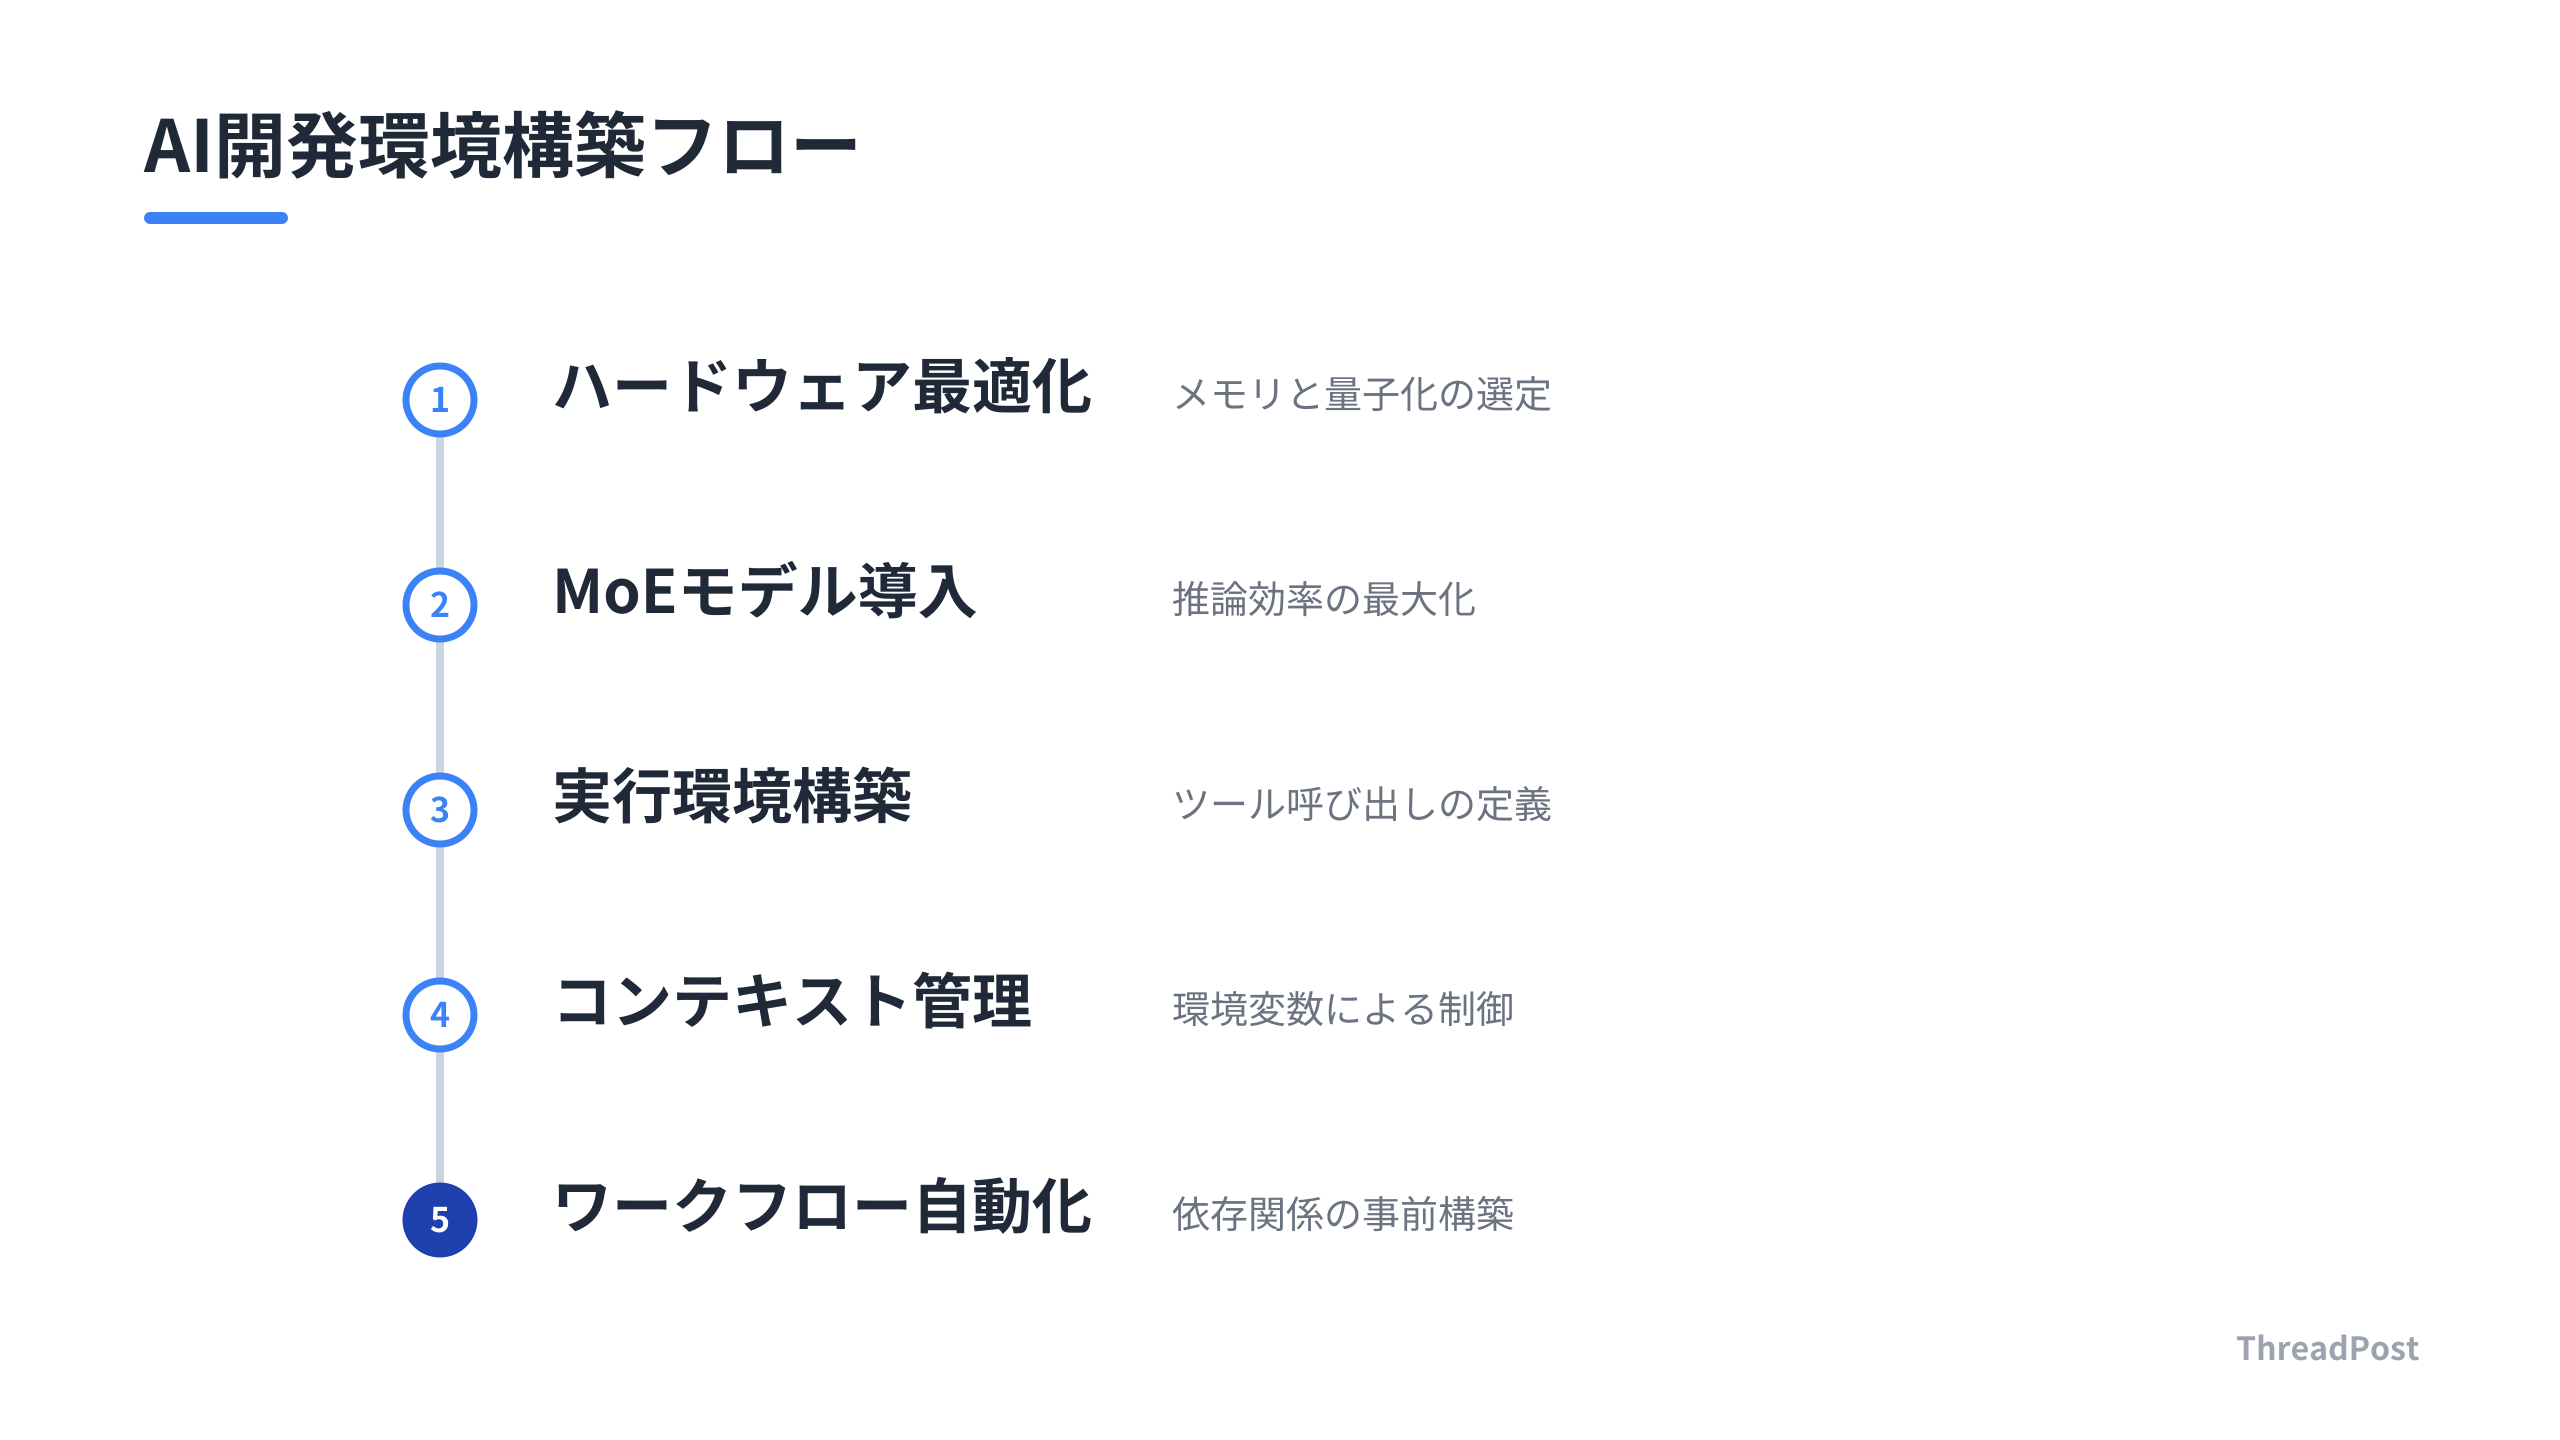
ステップ1:ハードウェアの最適化とメモリ戦略
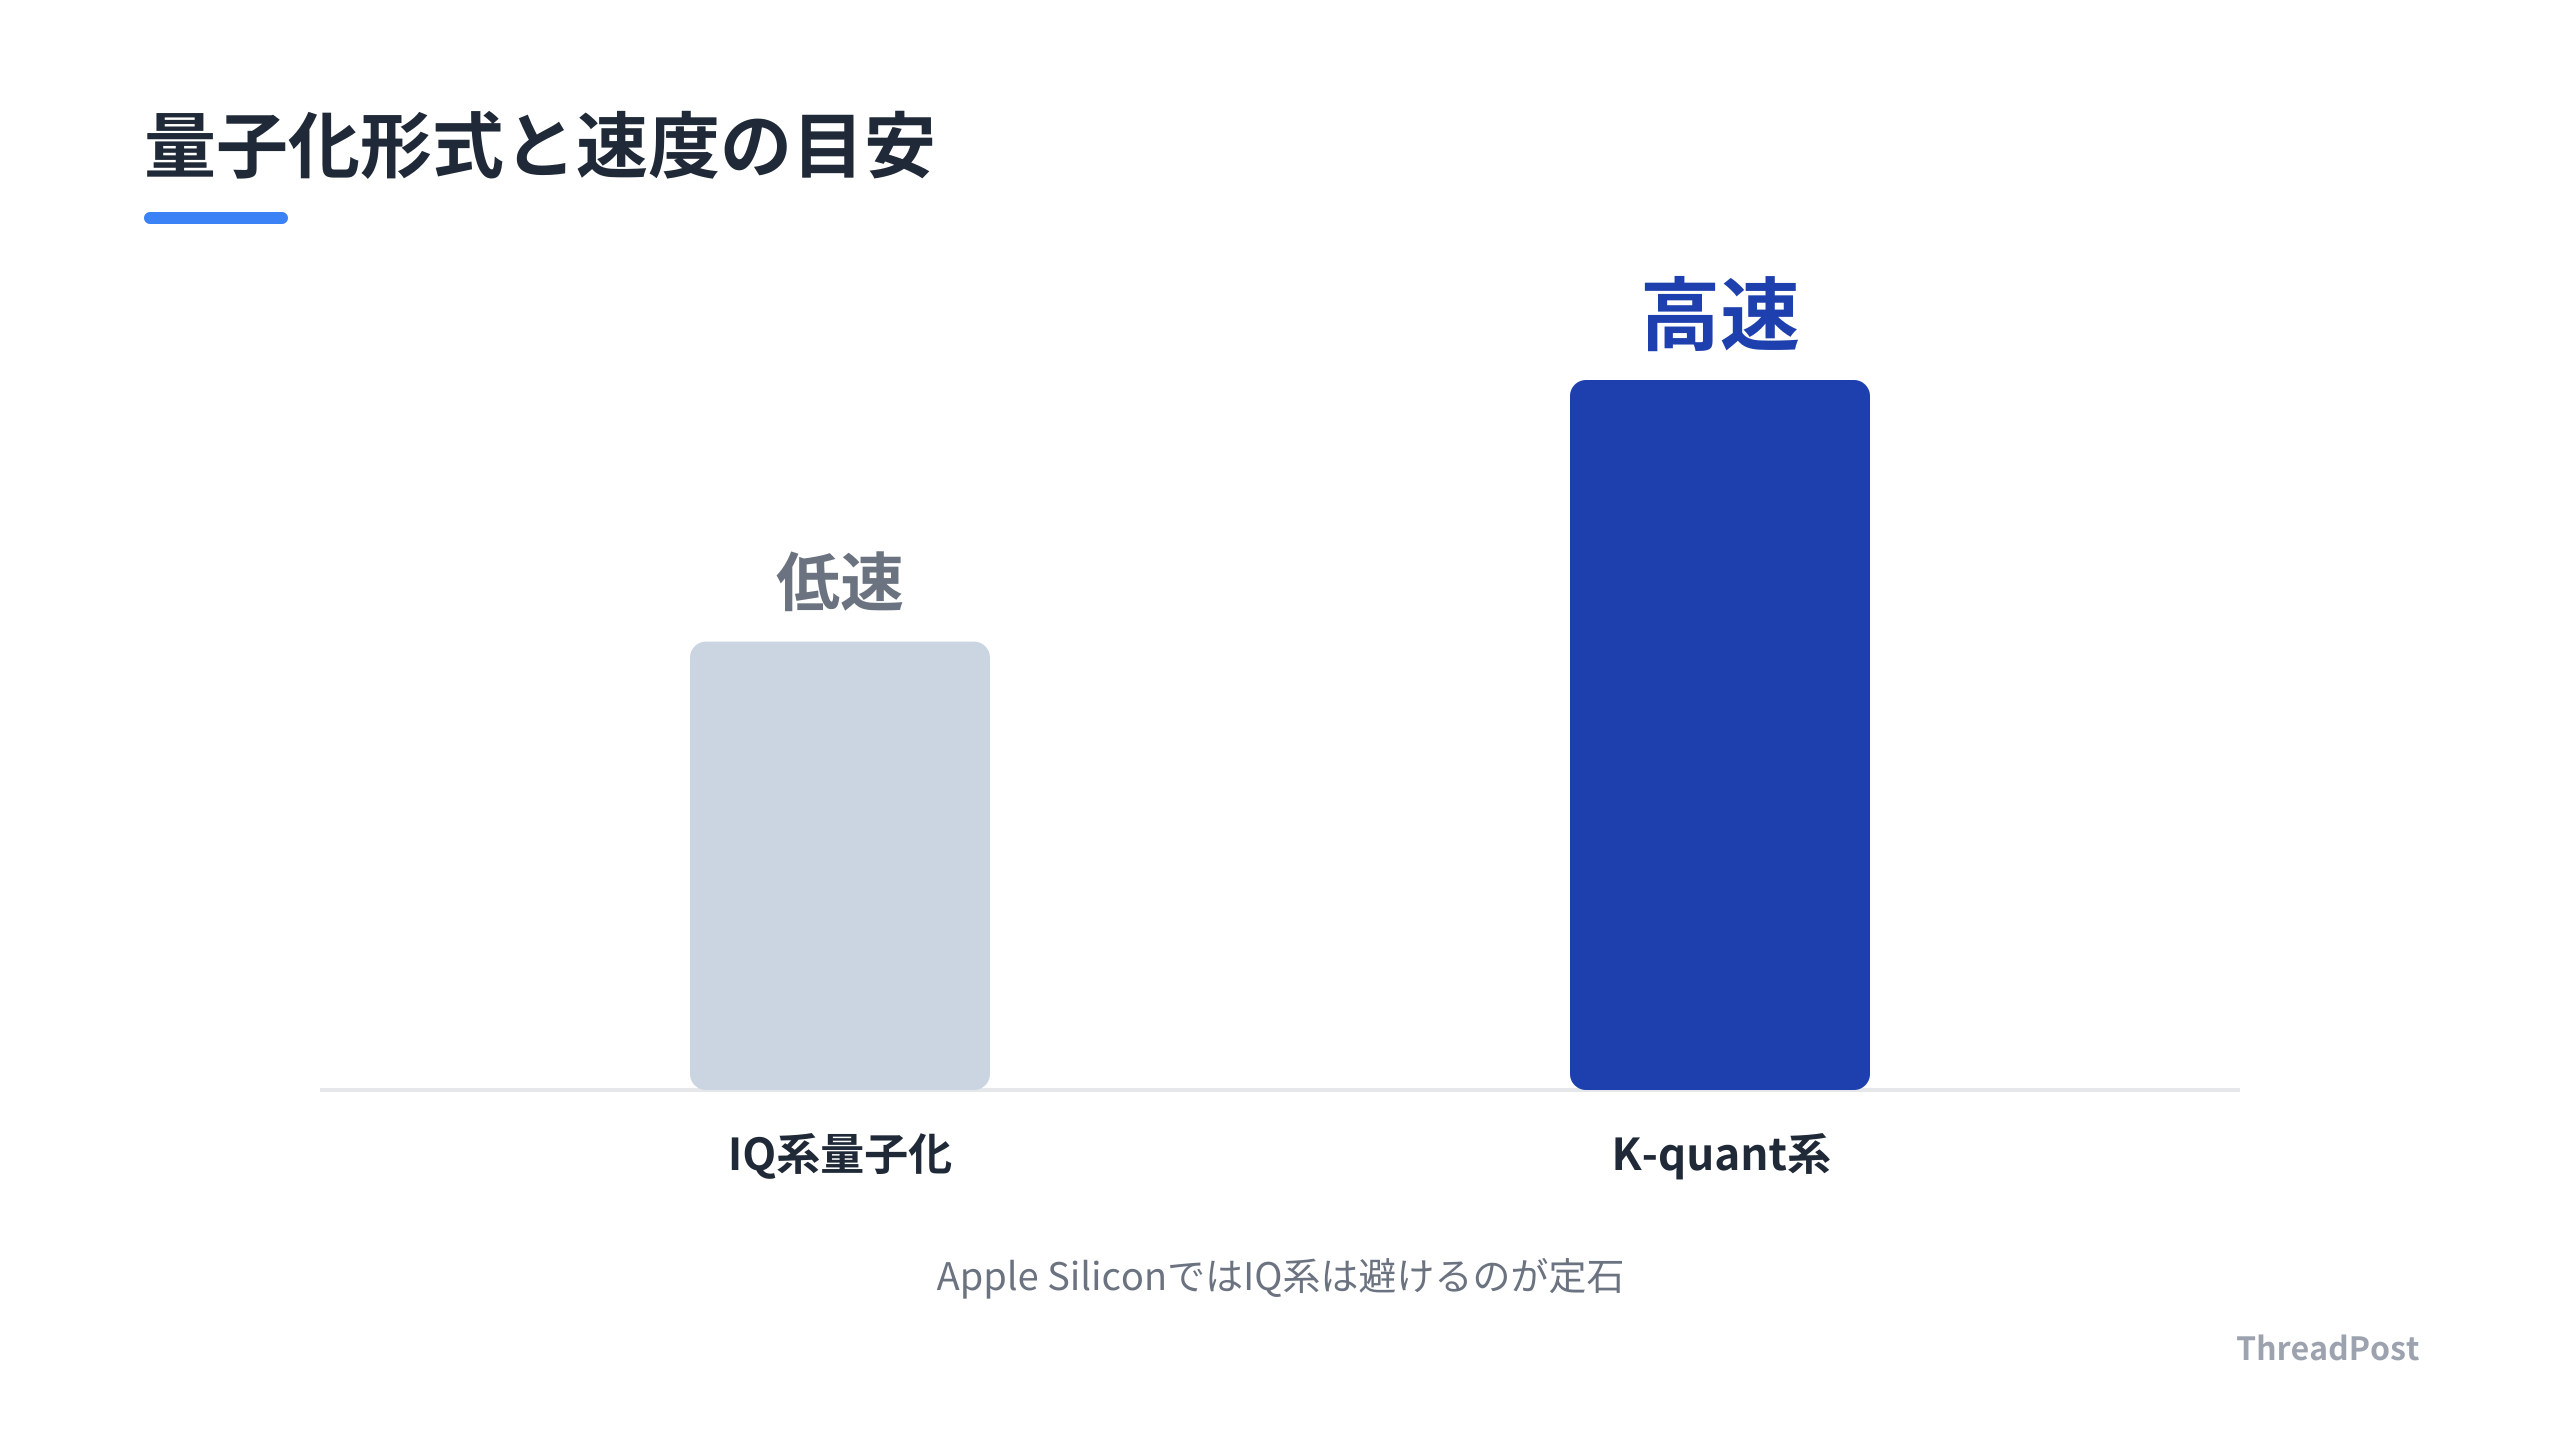
ローカルLLM運用における最大の壁はメモリ容量だ。RTX 5090の32GBやMacBook Proの128GBは、大規模パラメータを搭載するための最低ラインといえる。特にMacで動かす場合、量子化手法の選択が推論速度を大きく左右する。Apple Siliconのアーキテクチャでは、特定の量子化形式がボトルネックになり、速度が著しく低下するケースがある。標準的な量子化形式を選び、モデルサイズと速度のバランスを調整することが成功への第一歩だ。
 あわせて読みたいローカルLLMのおすすめ構成2026|モデルと実行ツールを実測で選ぶ完全ガイド →
ステップ2:MoEモデルによる推論効率の向上
大コンテキストを扱いながら実用的な速度を出すには、DenseモデルよりもMoE(混合エキスパート)モデルが適している。総パラメータ数が多くても、実行時に使用されるアクティブパラメータが少ないため、メモリ制限内での高速動作が可能だ。Qwen系モデルのように、ネイティブで長大なコンテキストに対応したものを選ぶと、エージェントとしての実用性が飛躍的に高まる。
しんたろー:
ローカル環境でエージェントを動かす際のモデル選びは重要だ。MoEモデルはメモリ効率と速度のバランスが絶妙で、快適に動作するはずだ。
ステップ3:エージェント実行環境の構築
既存ツールは特定のAPIに最適化されていることが多い。ローカルLLMを動かすなら、ツール呼び出しプロトコルを柔軟に定義できる環境が不可欠だ。OpenCodeのようなフレームワークを使うと、ローカルLLMの特性に合わせた設定が可能になる。設定ファイルを記述し、モデルごとのツール呼び出し形式を吸収させることで、エージェントが意図通りに動くようになる。
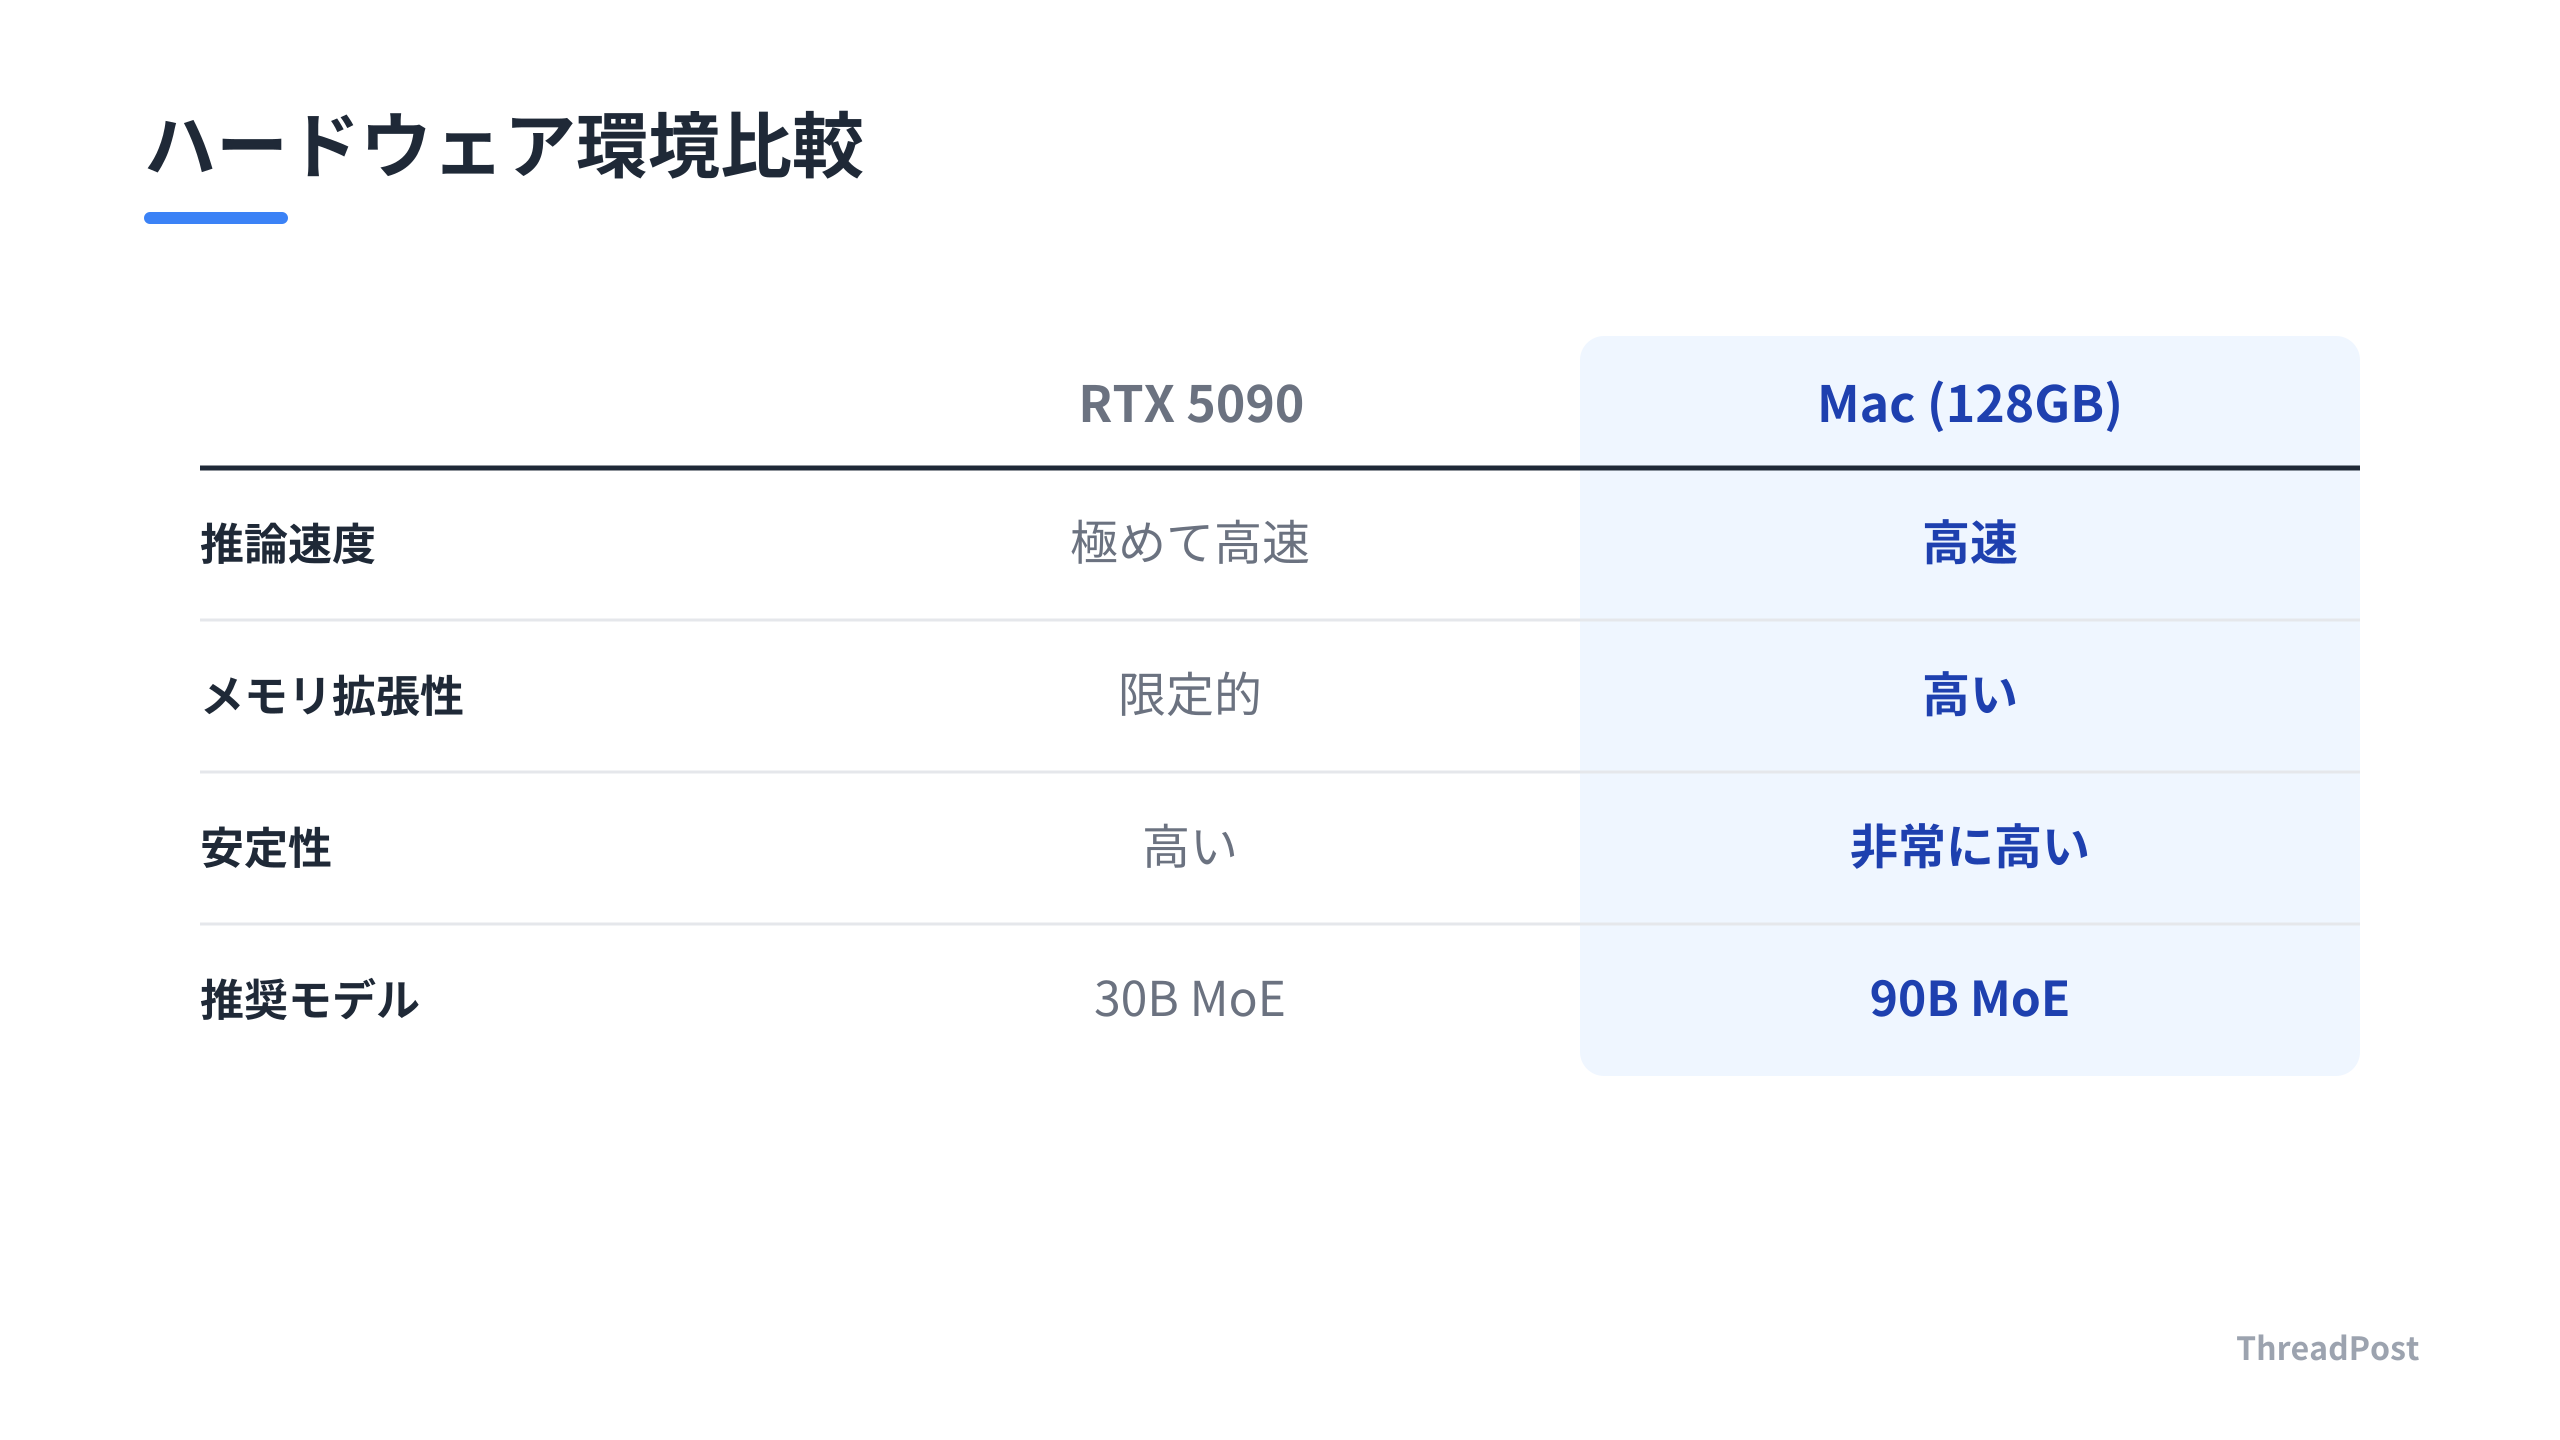
| 項目 | RTX 5090 環境 | Mac (128GB) 環境 |
|---|---|---|
| 推論速度 | 極めて高速 | 高速 |
| メモリ拡張性 | 限定的 | 高い |
| 安定性 | 高い | 非常に高い |
| 推奨モデル | 30BクラスMoE | 90BクラスMoE |
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
ステップ4:コンテキスト管理と環境変数の設定
ローカルLLMで大コンテキストを扱うには、ランタイム側の設定が鍵となる。コンテキスト長の上限を明示的に指定し、モデルの窓を正しく認識させることが、エージェントの誤動作を防ぐ唯一の手段だ。設定を怠ると、モデルは本来の性能を発揮できず、途中で回答が途切れるといったトラブルが発生する。環境変数を適切に設定し、モデルの能力を最大限に引き出す。
ステップ5:ワークフローの自動化
エージェントを実用化するには、モデルの賢さだけでなく、環境の準備速度も無視できない。Cursorのビルド機能のように、依存関係のインストールを事前に行う仕組みを取り入れるとよい。起動時の待ち時間を短縮し、タスクを実時間内で完結させることが、開発体験を向上させる秘訣だ。
エージェントが即座に起動する環境は正義だ。ローカル環境でも同様の自動化を取り入れることで、効率は劇的に変わる。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
つまずきポイント
初心者が陥りやすい罠は3つある。1つ目は、モデルの量子化形式を深く考えずに選んでしまうことだ。不適切な量子化は推論速度を劇的に低下させる。2つ目は、コンテキスト長の設定ミスだ。モデルが扱える範囲を超えた指示を出すと、エージェントは混乱する。3つ目は、ツール呼び出し形式の不一致だ。モデルが理解できない形式の命令を送ると、エージェントは機能しなくなる。
FAQ
Q1: なぜローカルLLMだとツール呼び出しがうまくいかないのか。
A1: 多くのエージェントツールはOpenAI等の特定のAPI形式を前提に設計されているからだ。ローカルLLMはモデルごとに出力形式が微妙に異なるため、ツール側が指示を誤解する。OpenCodeのように、モデルごとのツール呼び出し形式をカスタマイズできる環境を使うことで解決できる。
Q2: MacでローカルLLMを動かす際、量子化形式はどう選ぶべきか。
A2: Apple SiliconではIQ系の量子化は避けるのが賢明だ。行列積の変換処理がボトルネックとなり、速度が低下する。標準的なK-quant系を選択し、まずはQ4から試し、メモリに余裕があればQ5に上げるのが定石だ。
Q3: RTX 5090の32GB VRAMで256Kコンテキストは実現可能か。
A3: モデルのパラメータ数とコンテキスト長(KVキャッシュ)の合計がVRAMに収まれば可能だ。30BクラスのMoEモデルであれば、ランタイムでコンテキストを適切に制限・管理することで実現できる。必要に応じてコンテキストの自動圧縮設定を併用する。
Q4: ローカルLLMでエージェントを動かす最大のメリットは何か。
A4: 機密性の高いコードを外部に送信しないプライバシー保護と、API利用料を気にせず試行錯誤できるコスト効率だ。クラウドの制限を受けず、自分の環境を自由に構築できるため、長期的には開発体験が向上する。
Q5: エージェントが途中で止まってしまう原因は何か。
A5: コンテキスト長の上限超過か、ツール呼び出しの無限ループが主な原因だ。環境変数でコンテキスト長を明示的に指定し、モデルが扱える範囲内に収まっているか確認する。複雑なタスクは小分けにして指示を出す工夫も有効だ。
まとめ
ローカルLLM環境の構築は、ハードウェア選定からモデルの微調整まで奥が深いが、一度構築すれば最強の開発環境が手に入る。RTX 5090やMacBook Proのパワーを活かし、自分だけのAIエージェントを育て上げる。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
