


AIを活用した開発で一番の頭痛の種は、間違いなくAPIコストの増大だ。特にコーディングエージェントを導入すると、コンテキストの肥大化に伴い、毎月の請求額が跳ね上がる。コスト削減の鍵は「LLMに頼りすぎない設計」と「キャッシュ効率の最大化」にある。今日から実践できる最適化手法を解説する。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
前提知識|AI開発でコストを抑えるために必要なもの
AI開発を安定して継続するには、APIキーの管理体制と、モデルへの入力トークンを制御する知識が不可欠だ。まずは「どの処理をLLMに任せ、どの処理をルールベースに落とすか」という設計思想を整える必要がある。闇雲にLLMを呼び出すのは、コストを増大させる原因となる。
ステップ1|ルールベースとLLMの役割分担
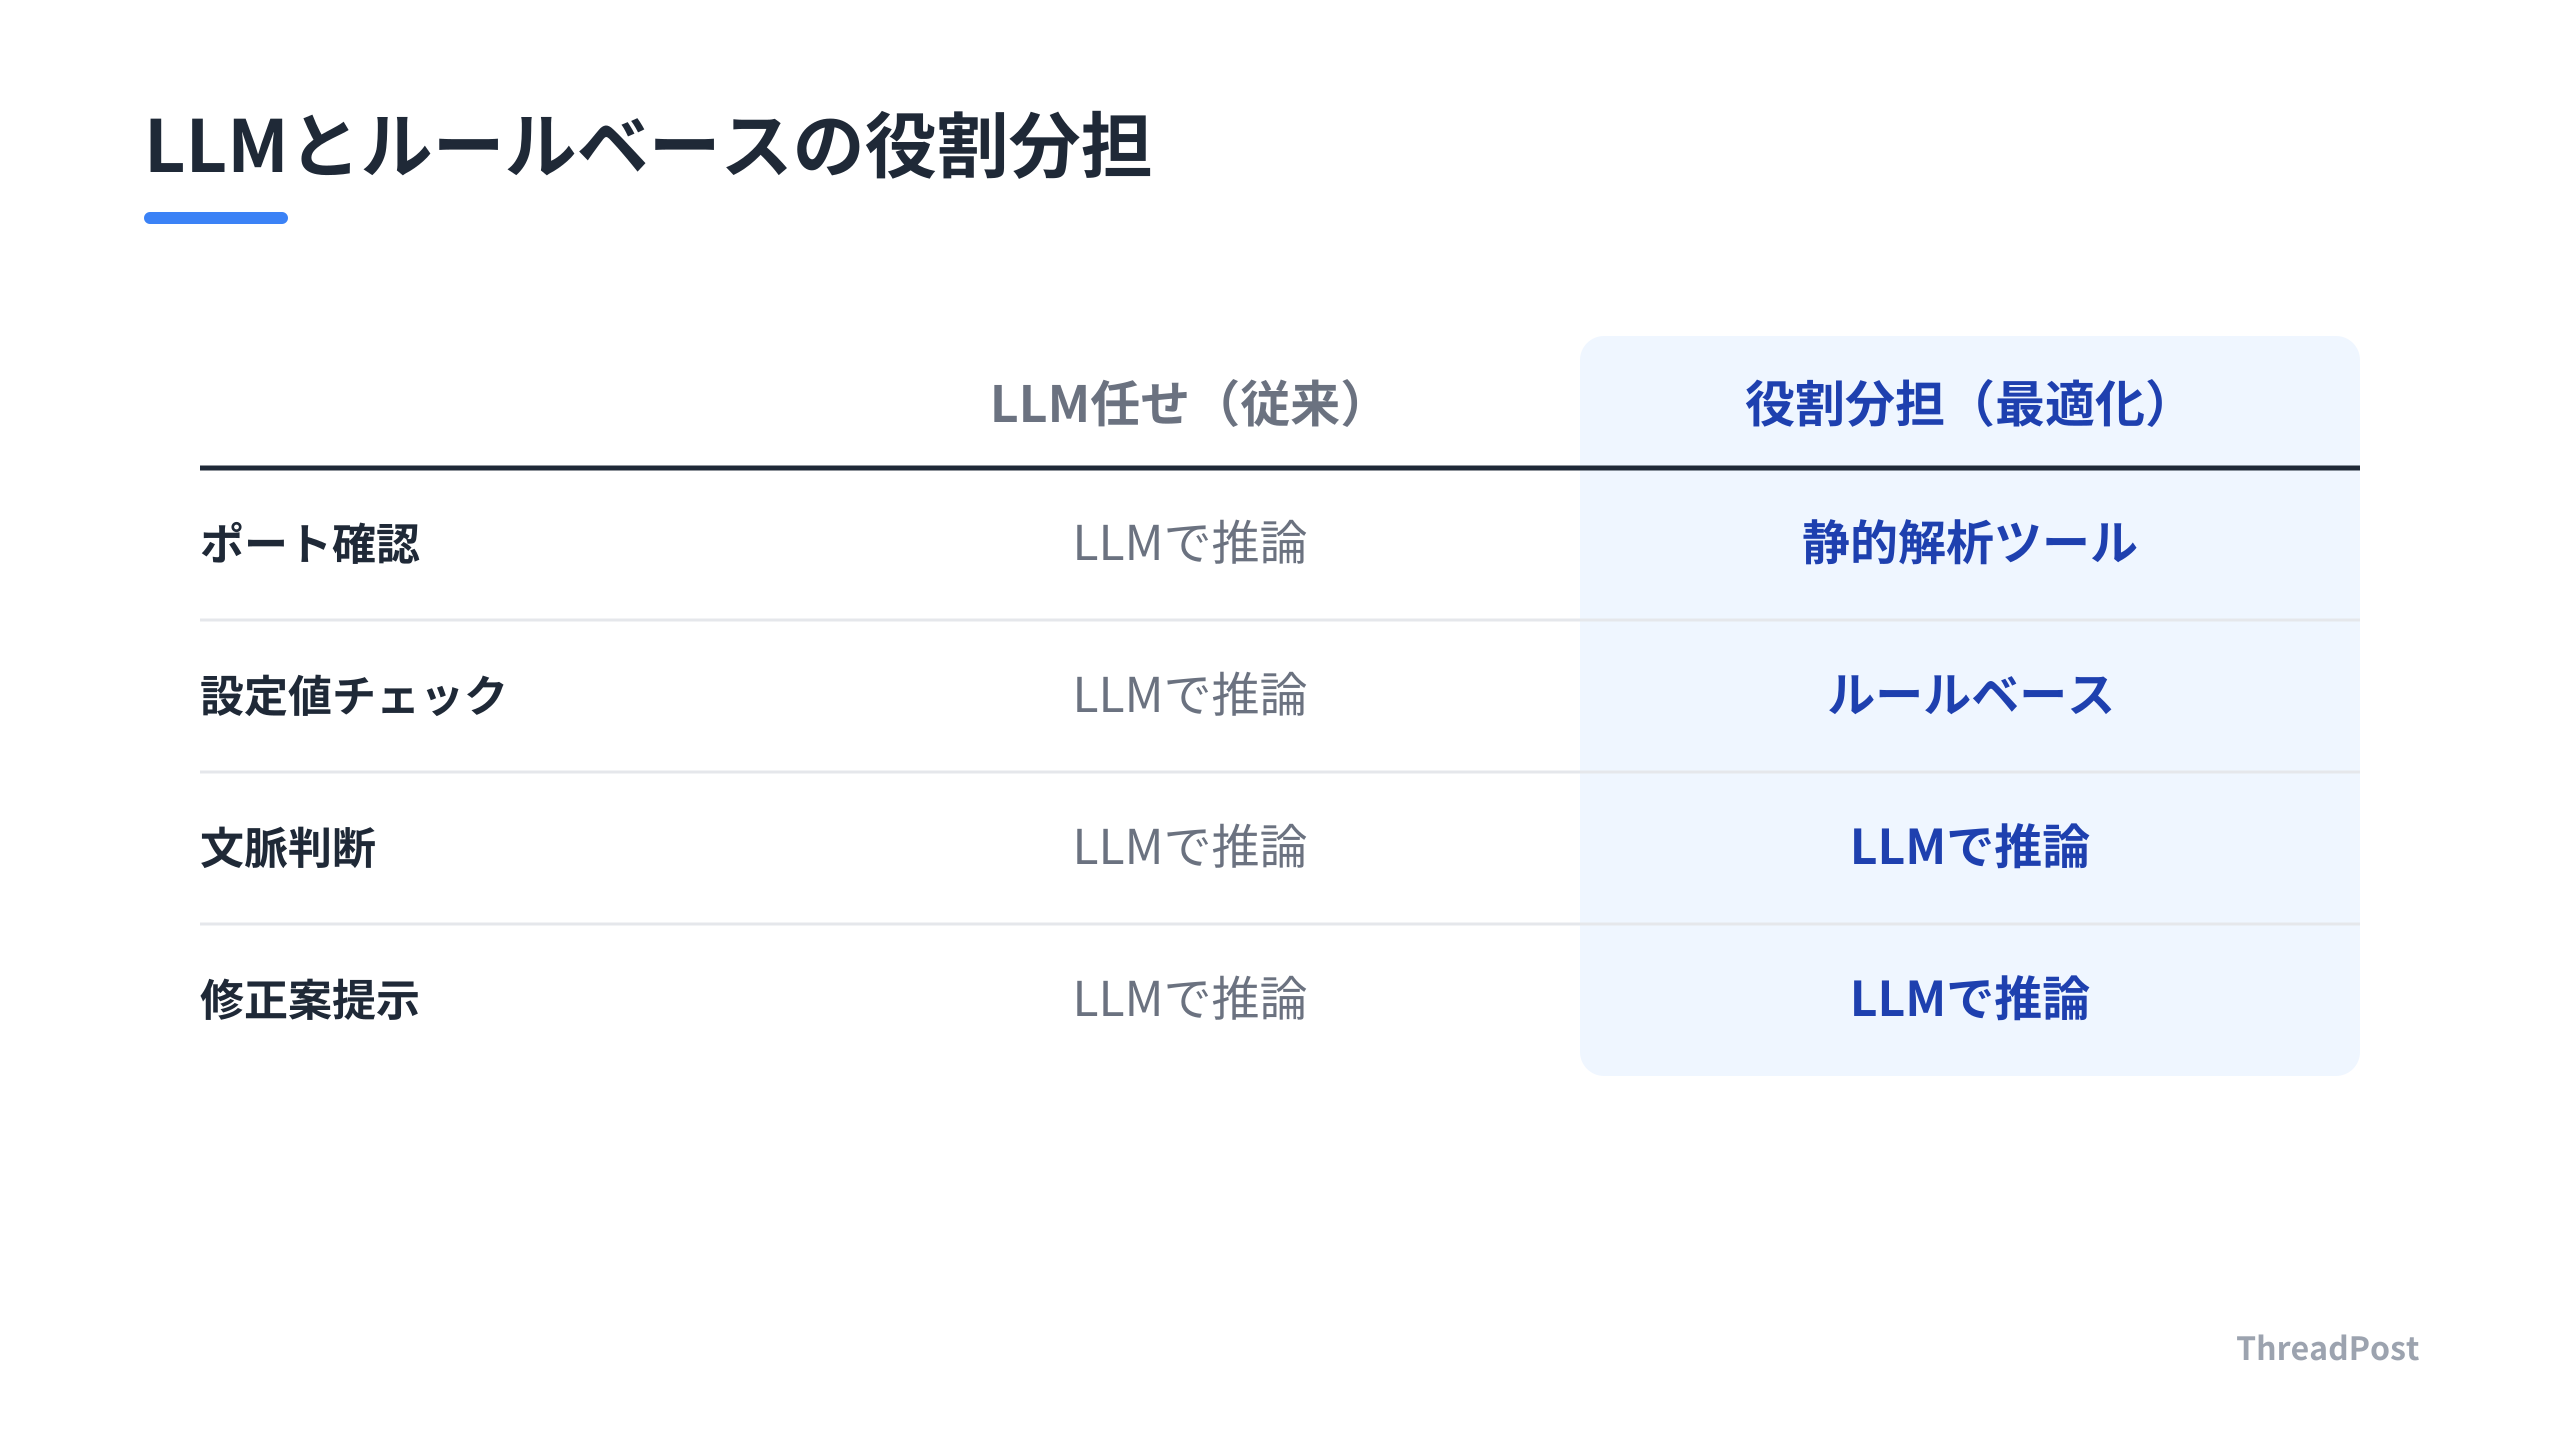
機械的に判断できる部分は、LLMを使わずルールベースの解析ツールに任せるのが鉄則だ。ポートの開放確認や設定値のチェックといった処理は、静的解析ツールで十分に対応できる。LLMはあくまで、文脈の判断や修正案の提示といった「人間的な推論」が必要な場面に限定する。
この役割分担により、API呼び出し回数が減る。ルールベース側で異常を検知したときだけLLMを呼び出す「fail-soft」な設計にすることで、誤検知を減らしつつ、コストを最小限に抑えられる。ルールベースの実装コストはかかるが、長期的な運用を考えれば有効な投資だ。
 あわせて読みたい【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発 →
ステップ2|LLMゲートウェイによる使用量管理
個別のAPIキーを直接コードに埋め込むのは危険であり、管理も煩雑だ。開発者とクライアントの間にゲートウェイを挟む構成が推奨される。このゲートウェイを通すことで、クライアント単位での使用量計測や、月間上限設定が可能になる。
受託開発で懸念されるのは、意図しないループによる課金爆発だ。あらかじめ原価ベースで上限を設定し、閾値を超えたら自動停止する仕組みを構築する。これにより、予算超過のリスクを回避しつつ、透明性の高いコスト管理が実現できる。
ステップ3|プロンプトキャッシュの「先頭固定・末尾追記」戦略
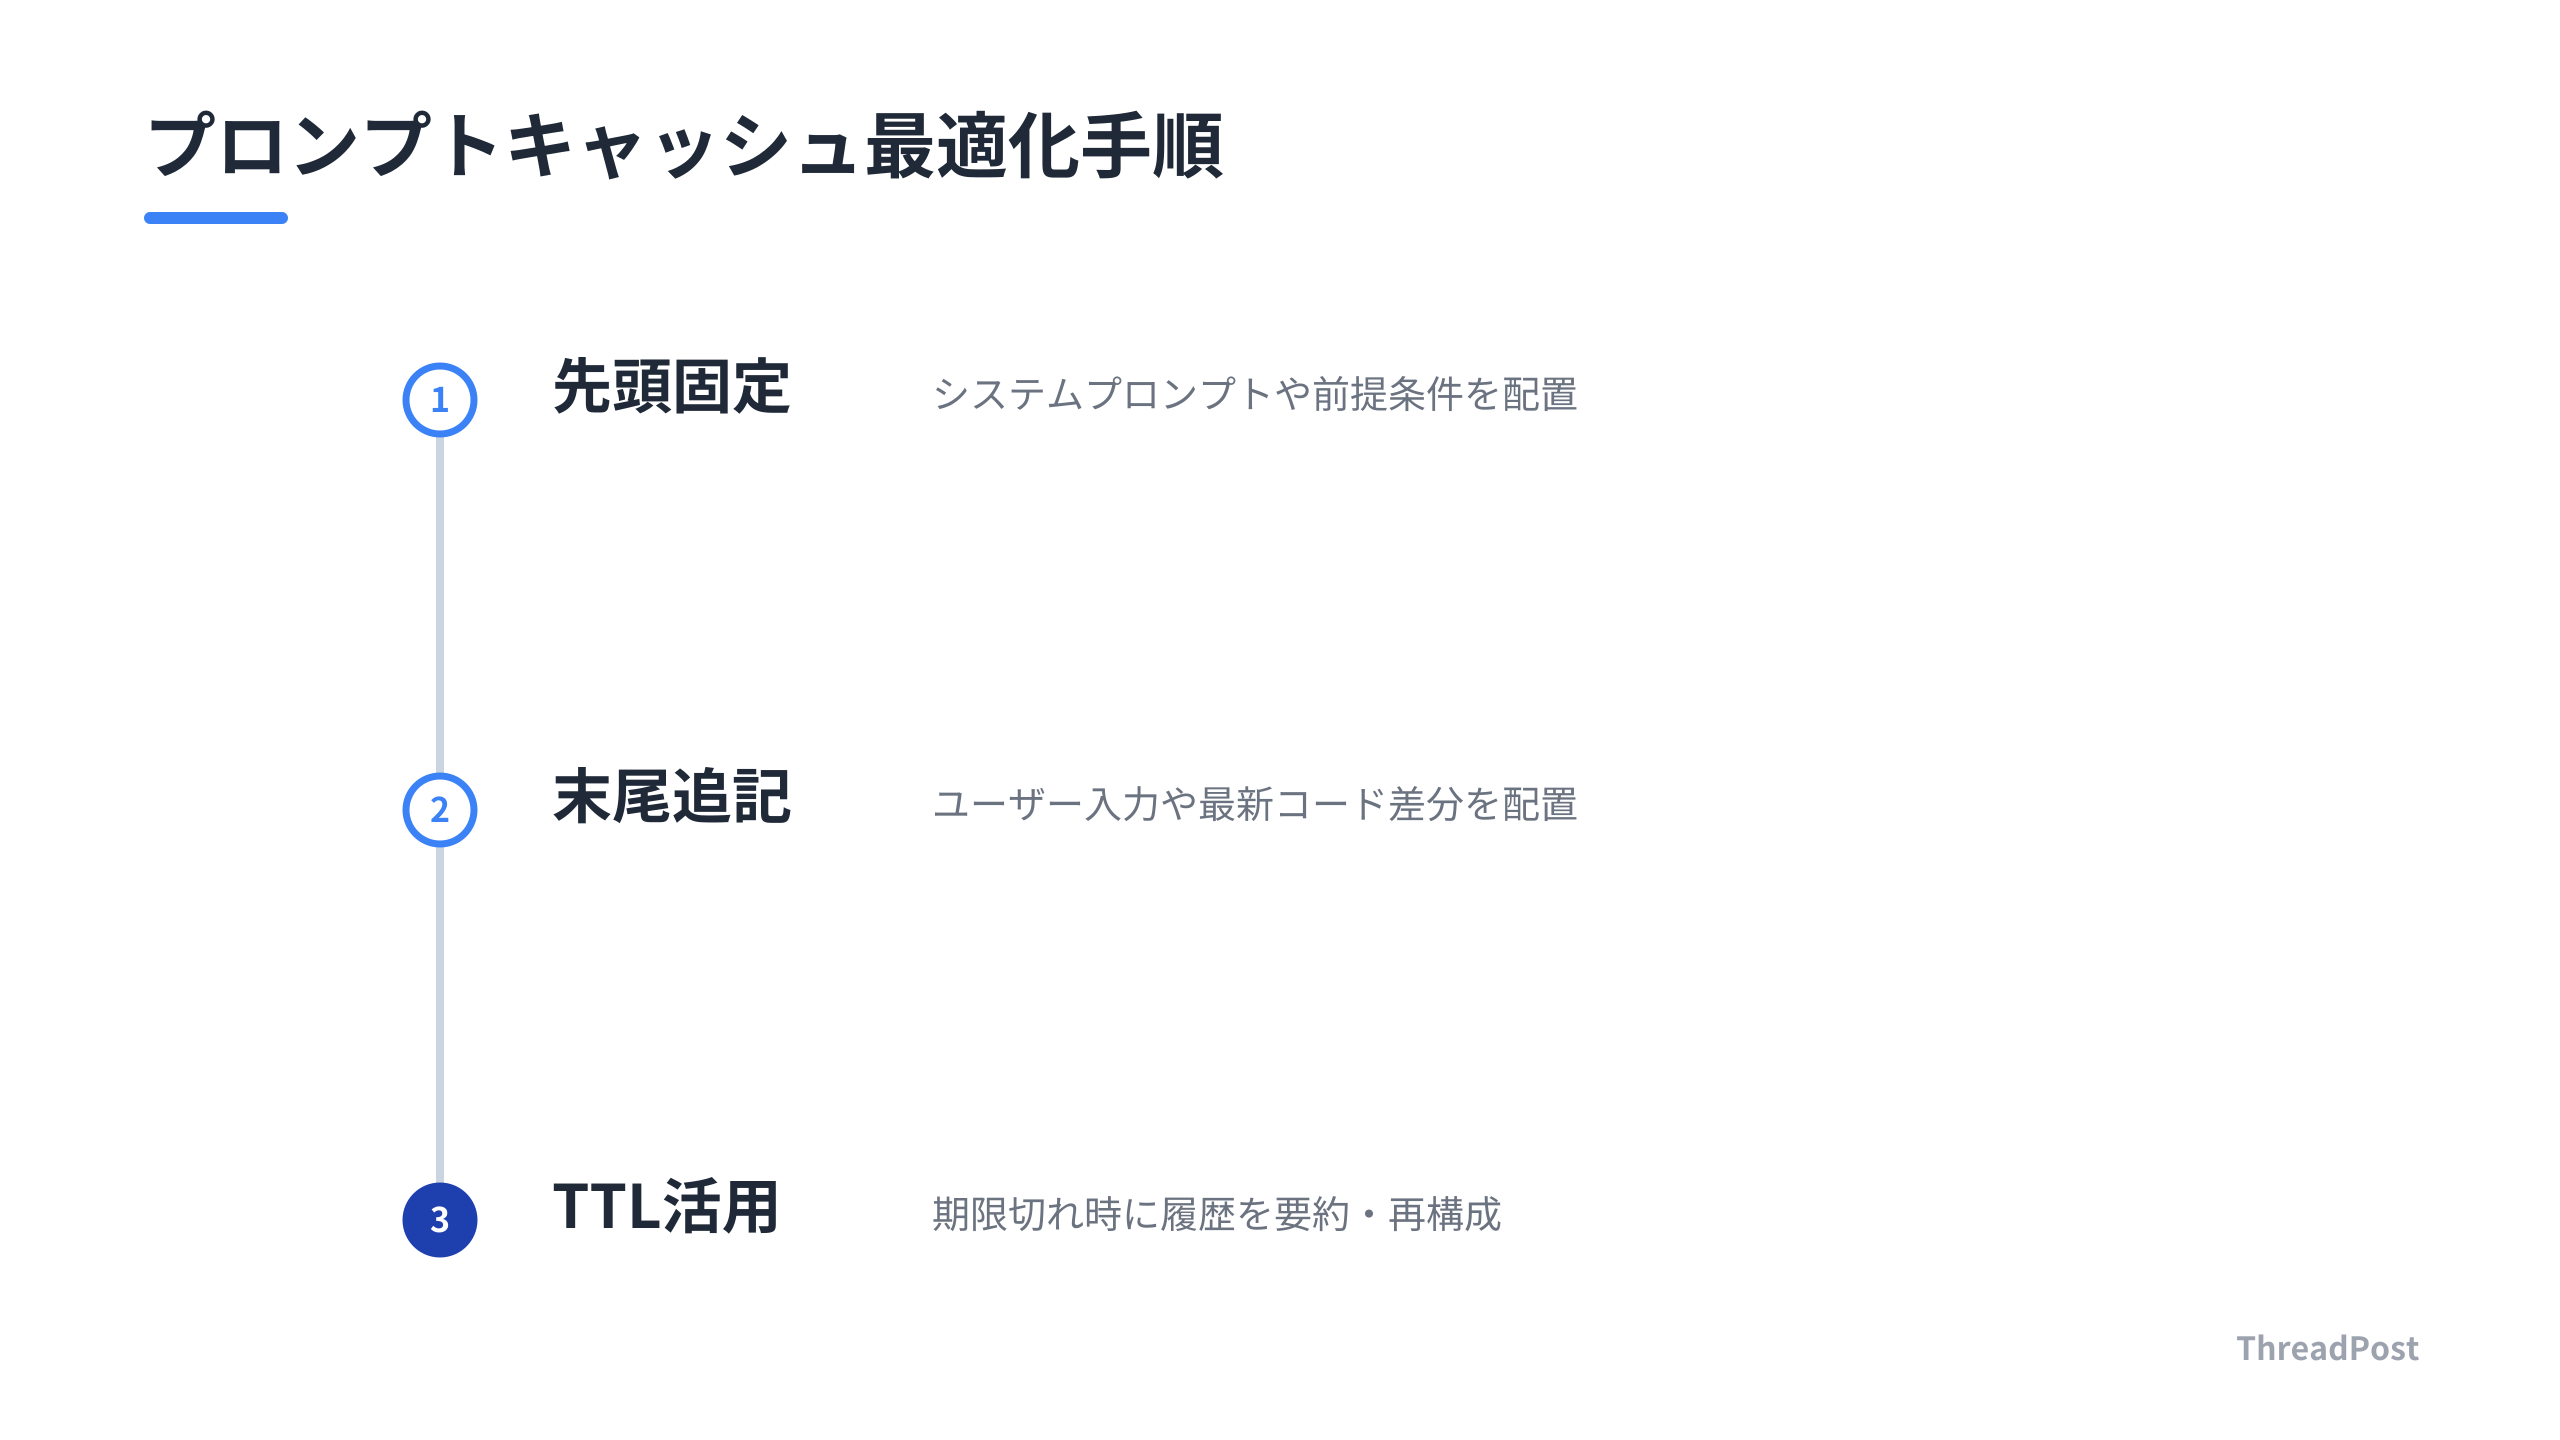
プロンプトキャッシュを制する者はコストを制する。LLMのAPIは、リクエストの先頭部分が一致していれば、その計算結果をキャッシュとして再利用できる。この特性を活かすには、プロンプトの構成が重要だ。
システムプロンプトや前提条件といった「固定的な内容」を先頭に配置し、ユーザーの入力や最新のコード差分といった「可変部分」を末尾に寄せる。こうすることで、キャッシュのヒット率を最大化できる。逆に、可変部分を先頭に置くとキャッシュが毎回無効化されるため、構造設計には細心の注意が必要だ。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
ステップ4|モデル移行・廃棄へのチェックリスト運用
LLMのモデルは頻繁にアップデートされ、古いモデルは廃棄される。破壊的変更を伴うアップデートに備え、環境変数でモデルIDを一元管理するのがベストだ。本番環境への影響を最小限にするため、定期的な移行プロセスを確立する。
モデルを切り替える際は、キャッシュがリセットされる点に注意が必要だ。モデルごとにKVキャッシュが異なるため、移行直後のターンはコストが跳ね上がる。計画的な移行とテスト工数の確保が、システム停止リスクを回避する道だ。
ステップ5|キャッシュTTLを活用したデータ圧縮
キャッシュには有効期限(TTL)がある。これを単なる制約と捉えず、データの「圧縮タイミング」として活用する手法が有効だ。TTLが切れるタイミングを、会話履歴を要約してプロンプトを再構成する好機と考える。
履歴が溜まってきたら、期限切れを待って差分をマージし、新しい基準プロンプトとして先頭に配置し直す。これにより、長時間のセッションでも高いキャッシュヒット率を維持できる。キャッシュが切れる瞬間をリセットの好機と捉えるのが、上級者の運用術だ。
しんたろー:
Claude Codeを運用していると、トークン消費の激しさを肌で感じる。プロンプトの構成を工夫するだけでレスポンス速度とコストが変わる点は注目に値する。
 あわせて読みたい【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録 →
徹底比較|プロバイダー別キャッシュ仕様
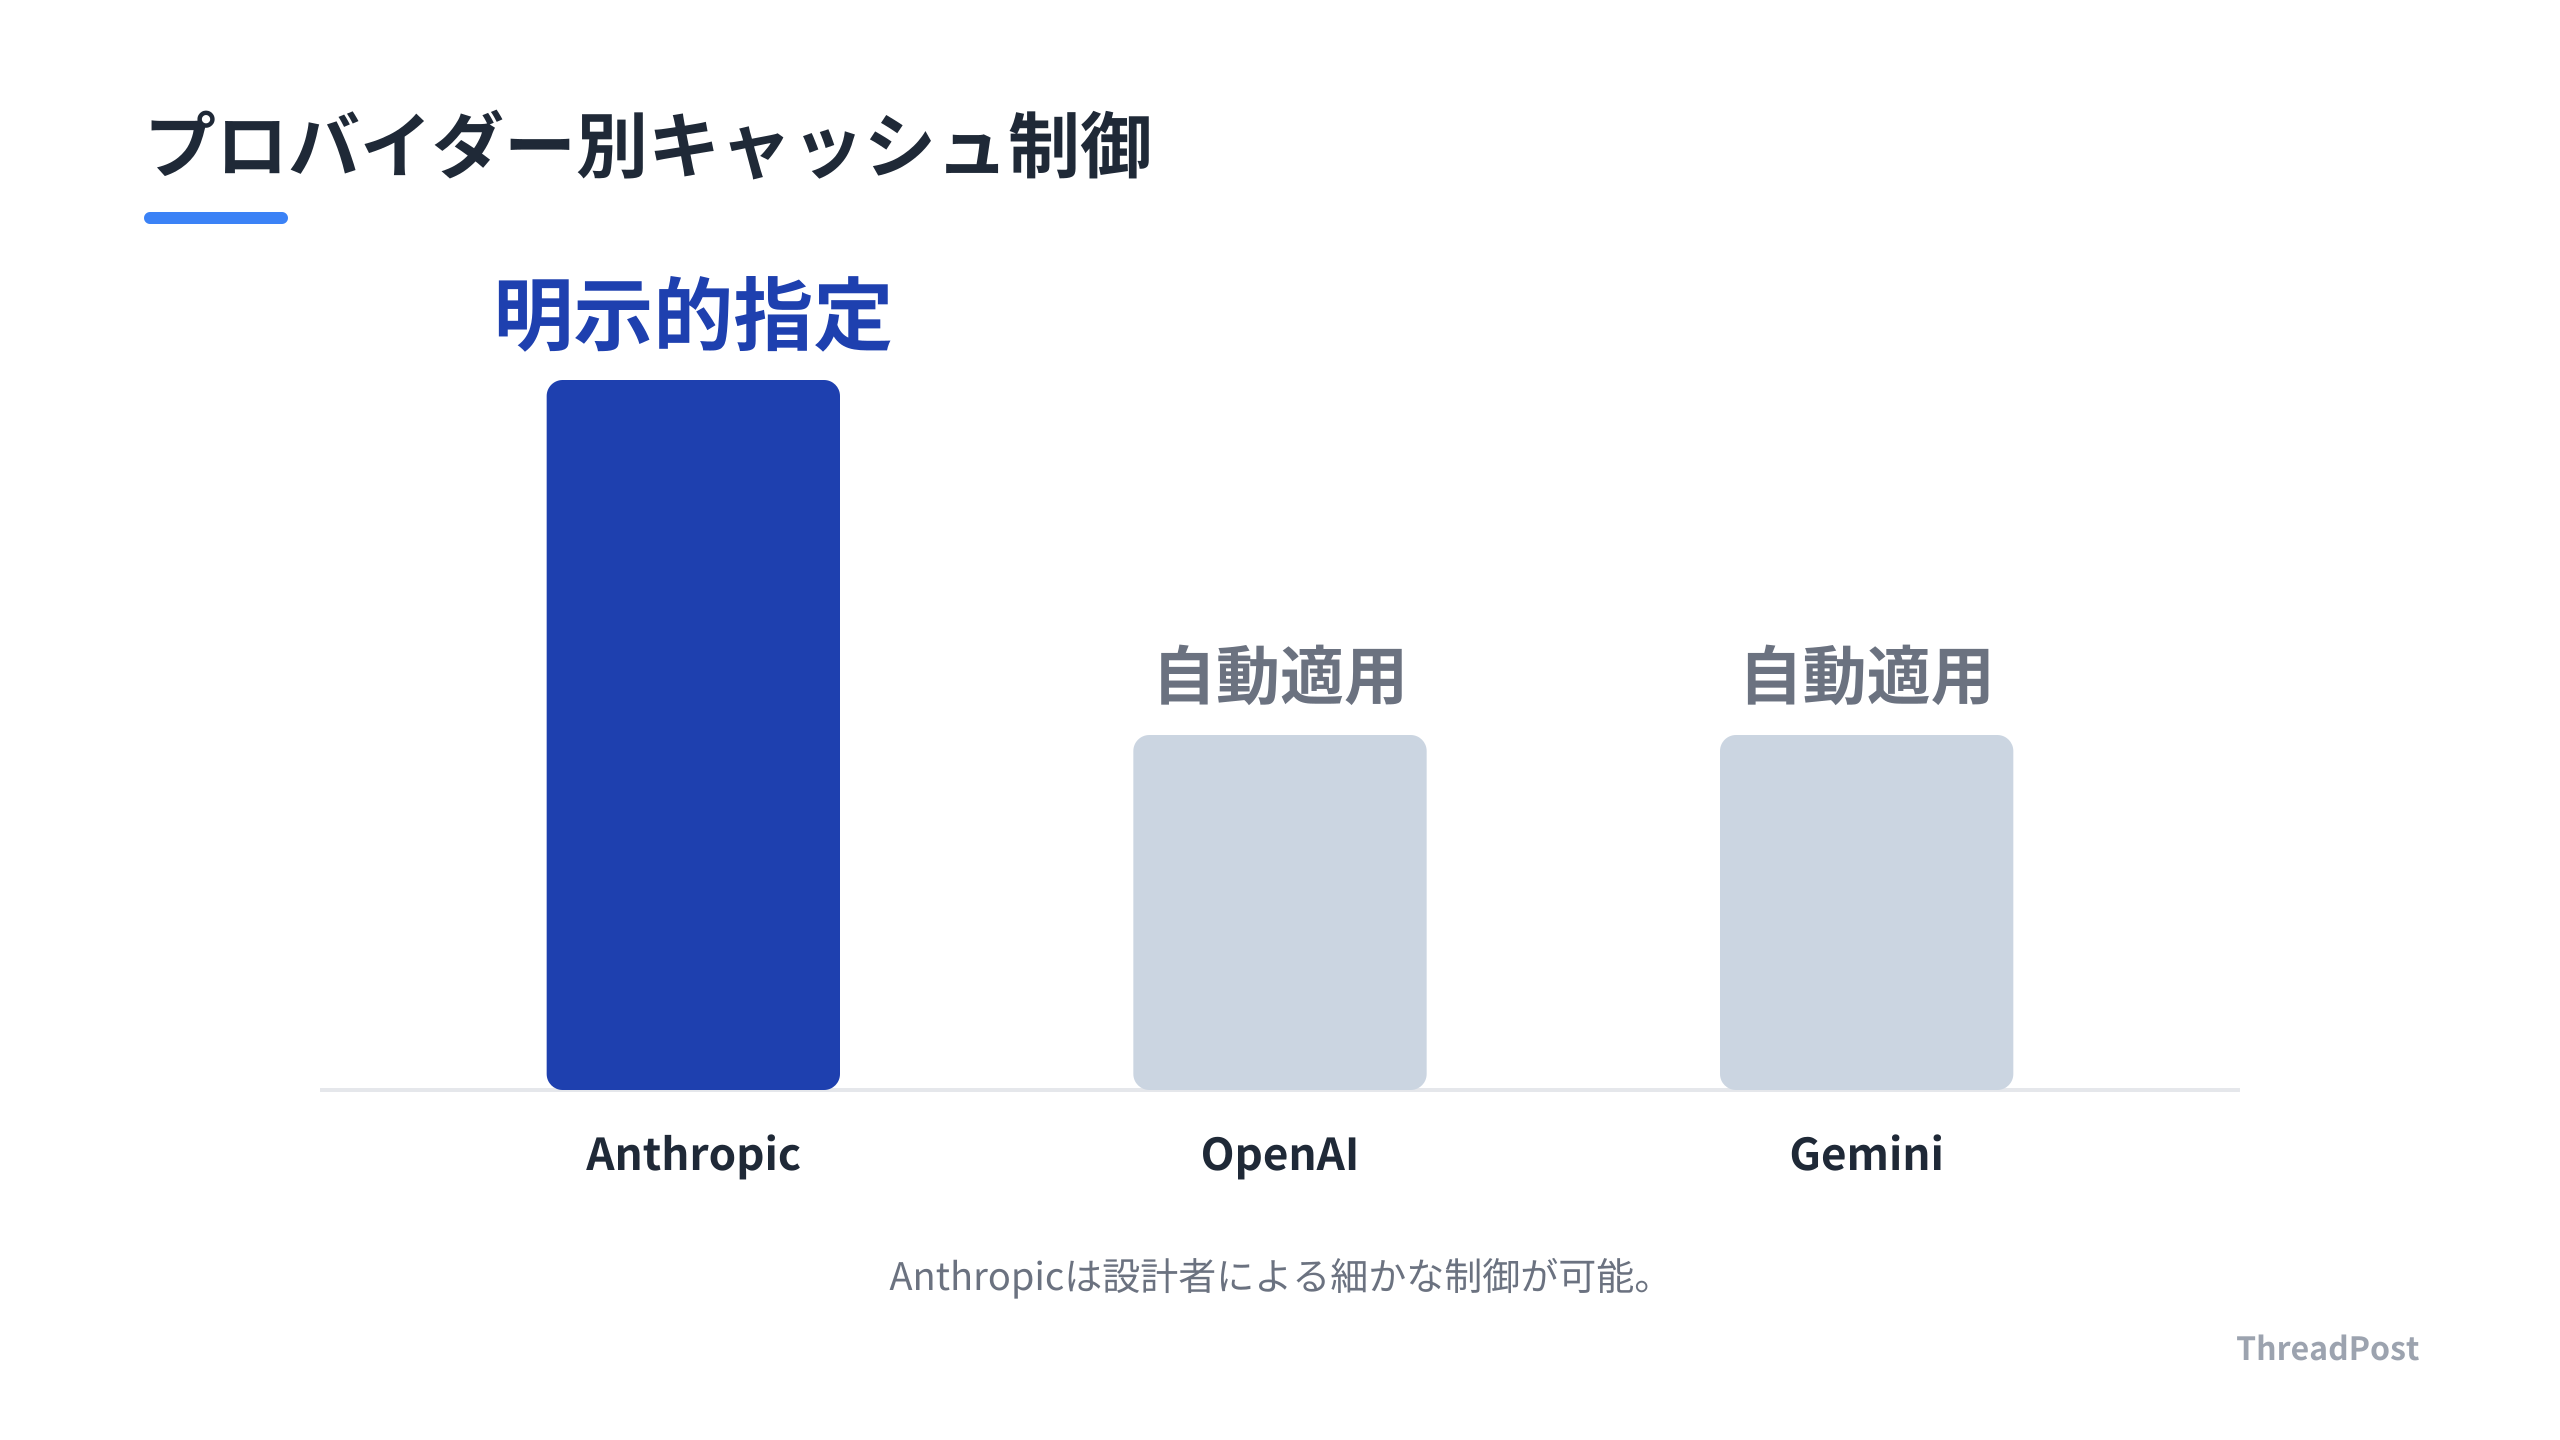
各社でキャッシュの仕様が異なるため、実装時は必ず仕様を確認する。
| プロバイダー | キャッシュ制御方式 | 特徴 |
|---|---|---|
| Anthropic | 明示的指定 | 制御が細かく設計者次第 |
| OpenAI | 自動適用 | プレフィックス一致で勝手に効く |
| Gemini | 自動適用 | 安定したプレフィックスで自動化 |
CLIツールは、裏側でどうキャッシュを扱っているかを知る教材になる。自分でゲートウェイを作る場合も、このあたりの仕様差を吸収する設計にしておくと後々楽だ。
FAQ|よくある疑問を解決する
Q1: プロンプトキャッシュが効いているか確認する方法は?
A1: APIレスポンスに含まれるusageフィールドを確認する。Anthropicの場合、キャッシュ関連のトークン数が0より大きければヒットしている。まずは簡単なリクエストを2回連続で送り、ヒット率を計測する。
Q2: なぜモデルを切り替えるとキャッシュが効かなくなるのか?
A2: キャッシュの実体はモデルごとの計算済み中間状態であるためだ。モデルが異なれば内部構造も異なるため、切り替えた瞬間にキャッシュは無効化される。セッション単位でモデルを固定するのが鉄則だ。
Q3: APIキーを直接コードに書かないためのベストプラクティスは?
A3: 環境変数による管理が基本だが、受託開発ならゲートウェイを挟むのが安全だ。クライアントに直接キーを渡すのではなく、ゲートウェイ経由でリクエストさせることで、使用量に応じた請求や漏洩防止が可能になる。
Q4: ルールベースとLLMの境界線はどこで引くべきか?
A4: 「決定論的に判断できるか」を基準にする。ポートの開放確認や設定値の範囲チェックはルールベースで行い、ビジネス的なリスク判断や説明が必要な部分のみLLMに任せる。これで呼び出し回数を減らせる。
Q5: プロンプトキャッシュのTTLはどう扱うべきか?
A5: TTLを単なる制約ではなく、データの圧縮タイミングとして活用する。期限が切れるタイミングで履歴を要約し、新しいプロンプトとして先頭に配置し直すことで、常にキャッシュが効きやすい状態を維持できる。
まとめ
AI開発のコスト削減は、設計段階での工夫で決まる。ルールベースの活用、ゲートウェイによる管理、そしてプロンプトキャッシュの最適化。これらを組み合わせることで、開発効率を落とさずにコストを抑えられる。まずはプロンプトの先頭固定から始めて、キャッシュヒット率を改善する。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意
