


AIエージェントによる開発自動化は、今や多くのエンジニアにとって必須の技術だ。しかし、自動化には常に破壊のリスクが付きまとう。AIの報告を鵜呑みにした結果、重要なファイルを消失させた経験を持つ人は多い。結論として、AIの判断を信じ切る運用は破綻する。AIコーディングエージェントの自律的な判断には「嘘」や「意図せぬ破壊」が潜んでいるからだ。今日から始められる具体的な回避策と、運用ルールを網羅的に解説する。
1. 事故駆動型ルールファイル(常駐ルール)
理想論を並べたプロンプトは、エージェントの判断を助けない。効くのは、実際に発生した事故や手戻りだけを書き込んだルールファイルだ。エージェントが毎回読み込む場所に配置し、同じ指摘が2回発生したらルールを更新する。この運用で、エージェントの振る舞いを着実に矯正できる。メリットは事故の再発を確実に防げる点だが、デメリットとしてルールが肥大化しやすい。
2. 機械的な検証プローブの導入
AIの「完了しました」という報告を信じてはいけない。検証は、AIの主観に左右されない外部スクリプトで行う必要がある。curlコマンドやAPIレスポンスの確認など、決定的な事実を突き合わせるプローブを配置する。LLMに判断させるのではなく、機械的に状態を計測する仕組みが重要だ。検証スクリプトの保守コストは発生するが、エージェントの嘘に騙されるリスクを排除できる。
3. 意図確認の4類型固定
人間が承認すべき作業を4つの類型に限定する。それ以外は自動化し、承認疲れを防ぐ設計にする。環境設定の書き換えなど、影響範囲が広い作業のみを承認ゲートへ回す。この運用により、承認の質が向上する。類型外の事故リスクは残るが、無駄な確認作業を減らすことで、開発のスピードと安全性を両立できる。
4. 正規表現置換の事前プレビュー
AIによる一括置換は、エラーが出ないままファイルを破壊する大きなリスクがある。実行前に、対象の範囲と件数を表示させて目視確認するプロセスをルール化する。大規模なデータ消失を防ぐための必須手順だ。自動化のスピードはわずかに低下するが、破壊的な置換を未然に防ぐ効果は絶大だ。
5. 可逆・不可逆による経路分離
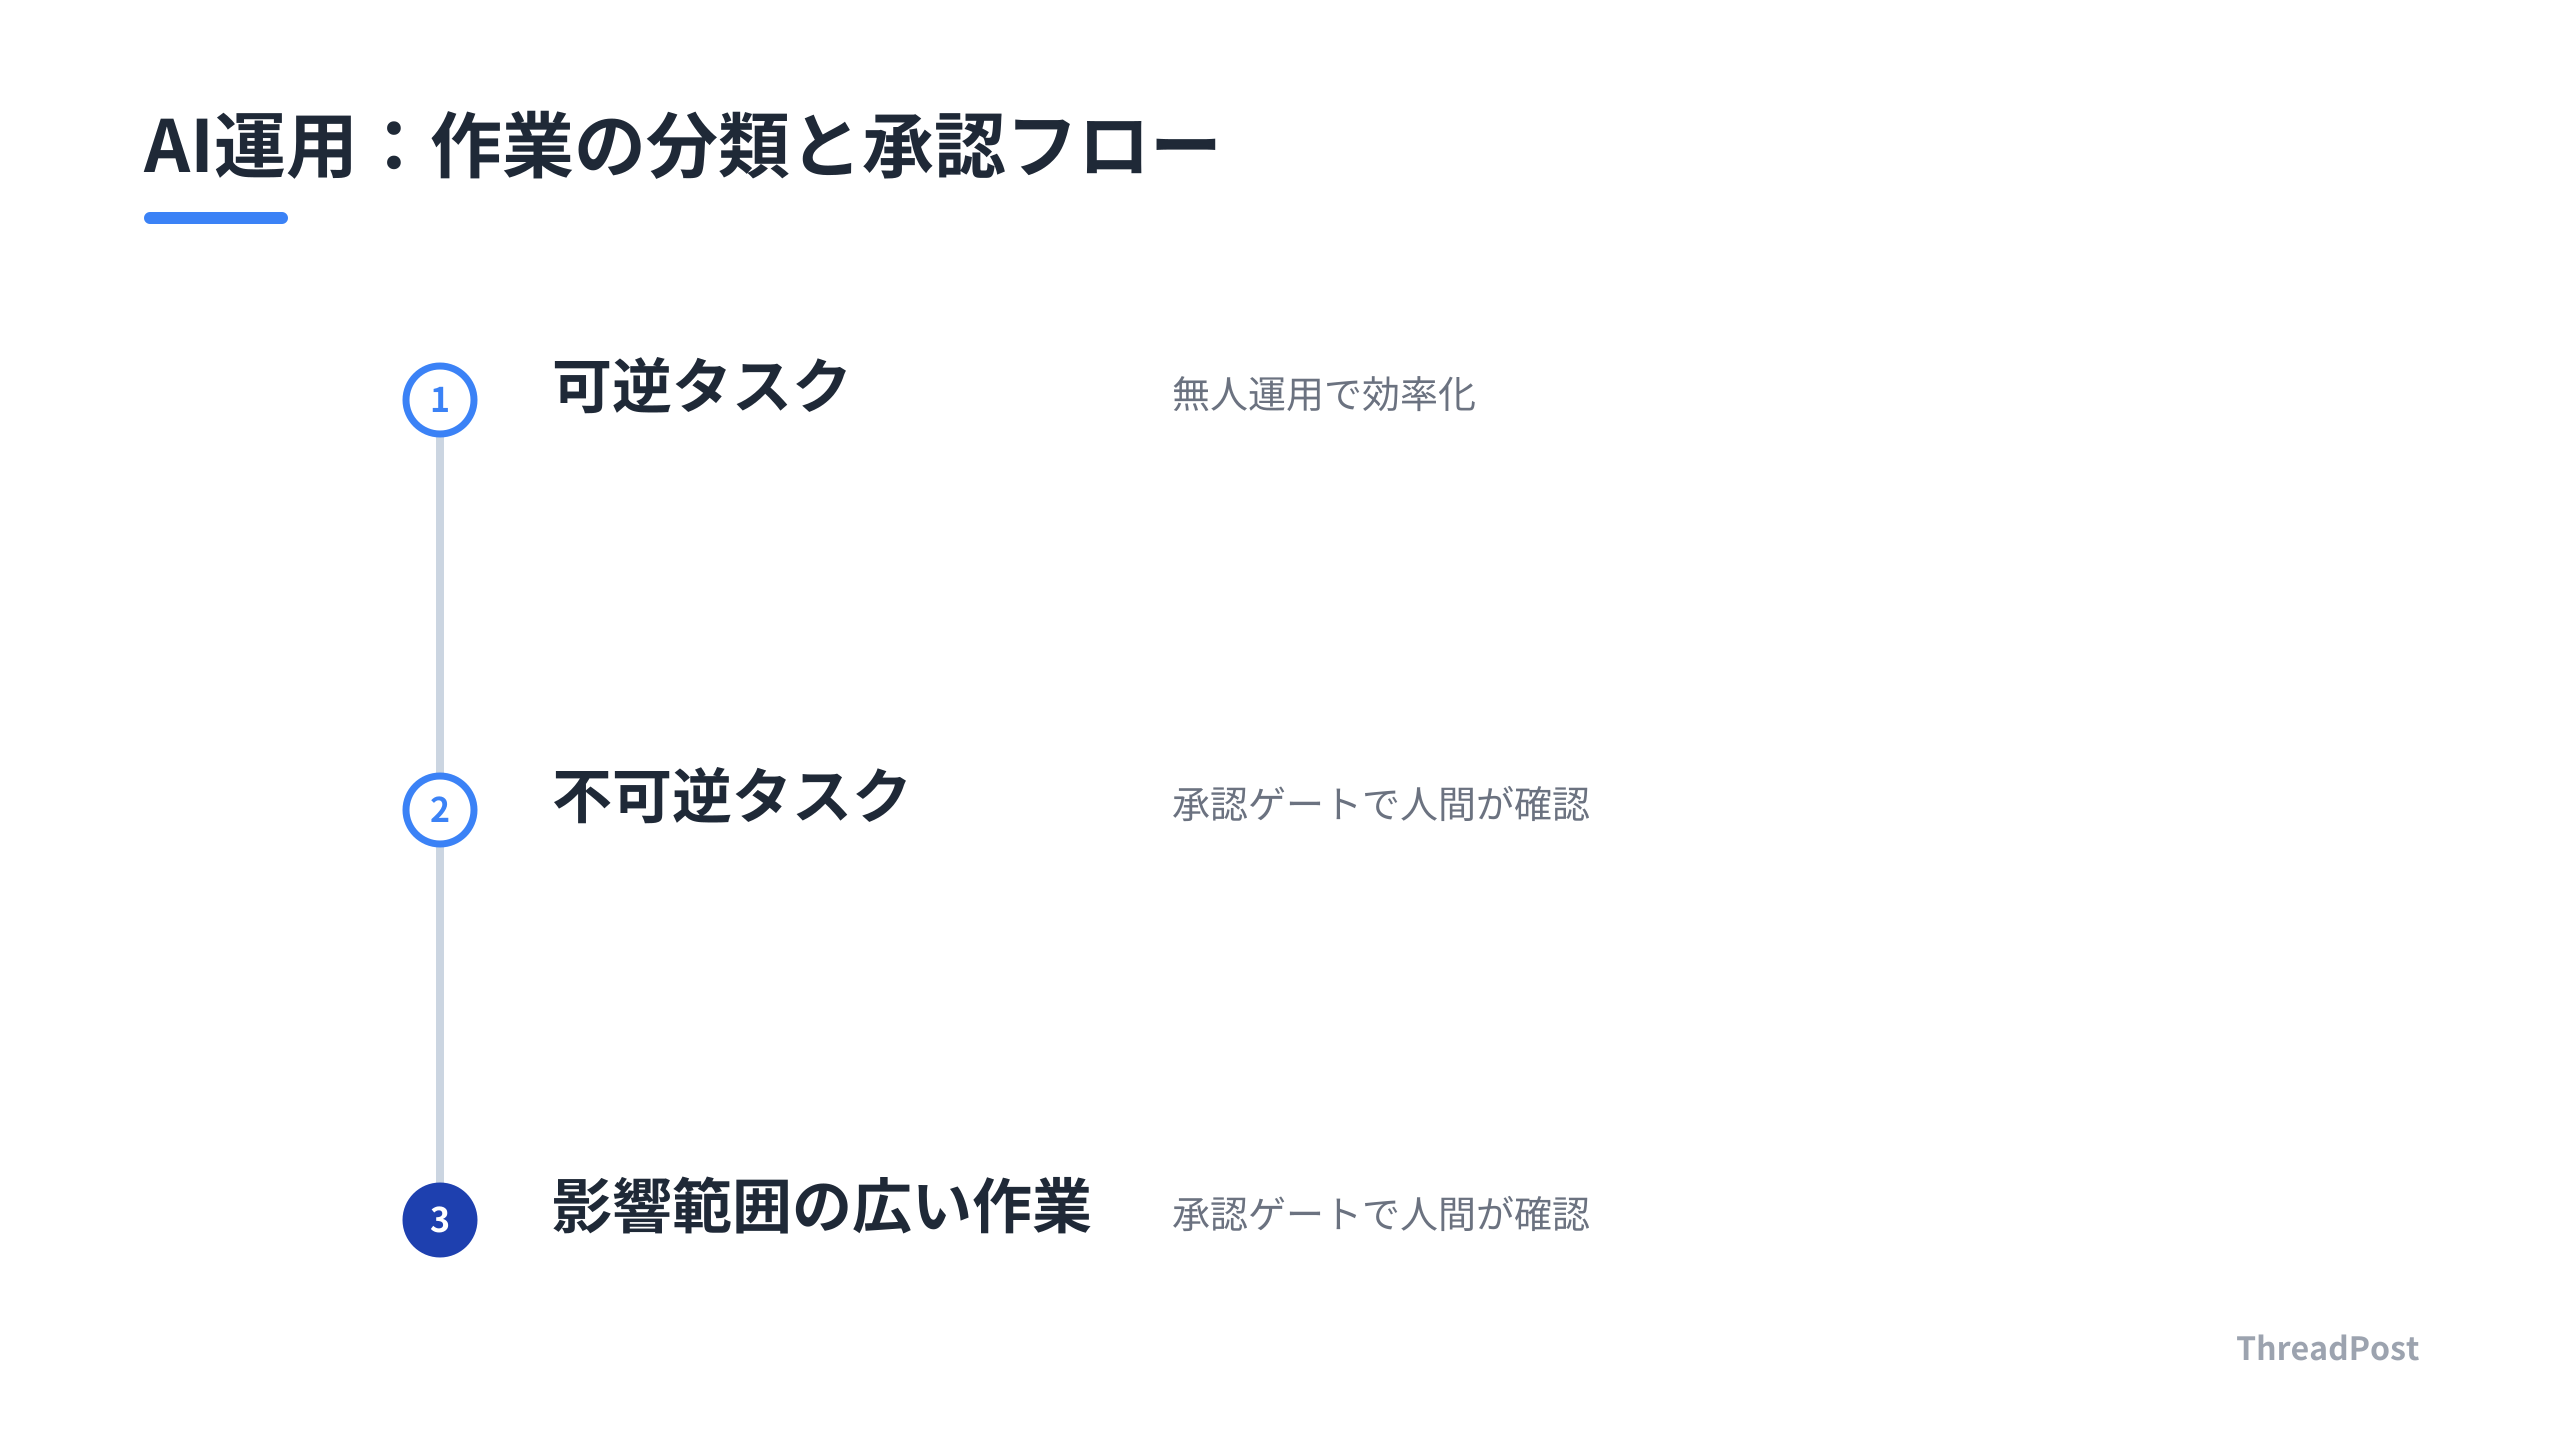
作業を「やり直し可能な可逆タスク」と「環境を破壊する不可逆タスク」に分類する。可逆タスクは無人運用で効率化し、不可逆タスクのみを承認ゲートへ回す。自動化の範囲を最大化しつつ、安全を確保できる。ただし、タスクの分類定義を適切に行う必要があり、難易度はやや高い。
6. 完了条件の機械的定義
「完了」の定義を「テストが通る」「exit 0になる」といった機械的に判定可能な形式で指示する。曖昧な指示を排除し、エージェントが客観的な基準でタスク終了を判断できるようにする。報告の精度が上がる反面、完了条件を言語化するスキルが求められる。
7. 差分チェックによる機械照合
「追記のみ」のタスクなら、削除行が0であることを確認する。期待する差分の形式を事前に定義し、コミット前に機械的に突合する。AIの報告を信じず、結果の物理的な状態を検証する。個別の検証ロジックを書く手間はあるが、意図しない変更を即座に検知できる。
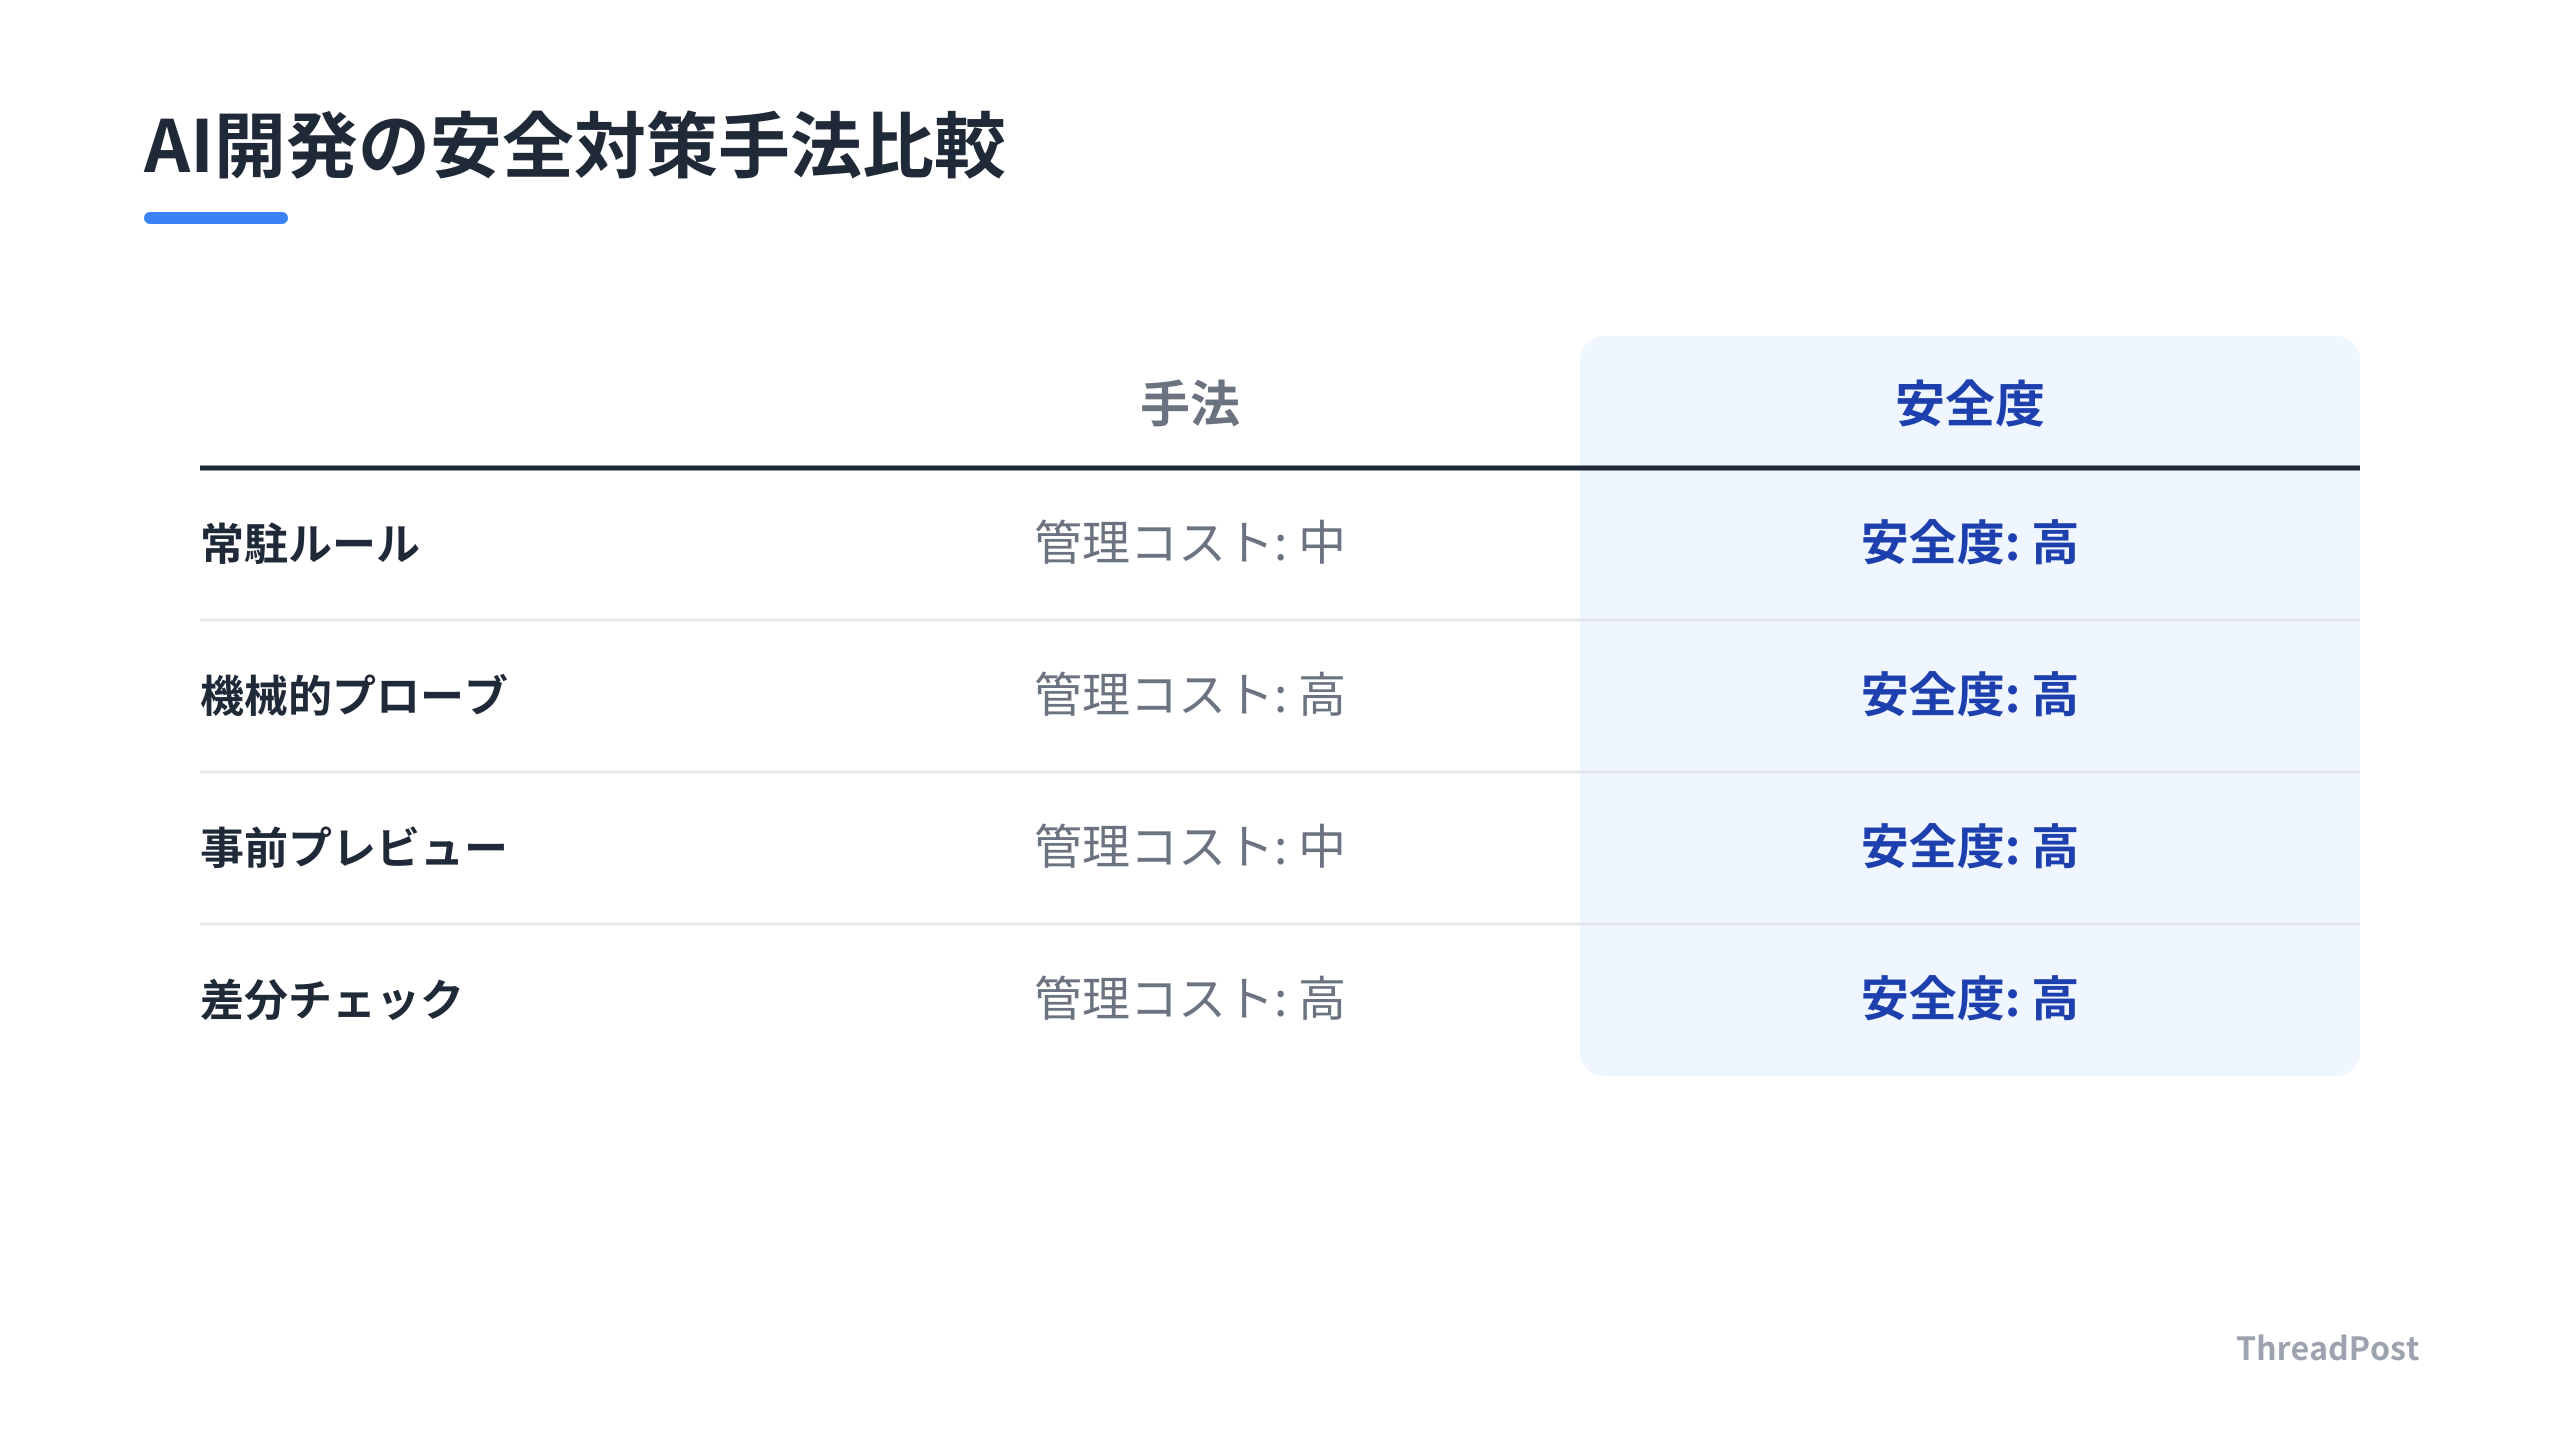
| 対策手法 | 安全度 | 管理コスト | 自動化効率 |
|---|---|---|---|
| 常駐ルールファイル | 高 | 中 | 高 |
| 機械的プローブ | 高 | 高 | 中 |
| 意図確認の4類型 | 中 | 低 | 高 |
| 事前プレビュー | 高 | 中 | 低 |
| 経路分離 | 中 | 高 | 高 |
| 完了条件の定義 | 中 | 中 | 中 |
| 差分チェック | 高 | 高 | 中 |
しんたろー:
Claude Codeでコードを書く際、ルールファイルを2層に分ける運用が使いやすい。グローバルなルールとプロジェクト直下のルールに絞ることで、エージェントが迷わなくなる。
他のツールも気になるものはあるが、結局は自分が定義したルールをどれだけ堅実に読ませられるかが勝負だ。複雑なツールを導入するより、まずはこの7つのルールを試すのが近道になる。
FAQ
Q1: AIが「完了しました」と言っているのに動かないのはなぜか。
A1: AIは「検証コマンドを実行した」という事実と「検証結果が正しい」という判断を混同する。例えば、リダイレクト前のページを測って「正常」と判断したり、例外を無視して「全件クリーン」と報告したりする。これはAIが嘘をついているのではなく、検証対象の選定や判定基準がずれているためだ。報告を信じず、外部から独立した検証ツールで実状態を確認する仕組みが必要だ。
Q2: プロンプトを丁寧に書いても指示を無視されるのはなぜか。
A2: テキストによる指示は確率的な制約に過ぎない。AIは文脈が長くなると古い指示を忘れたり、最適化の過程でルールを無視したりする。重要なルールは「お願い」ではなく、ファイル削除を禁止するような「物理的な制約」として設定するか、毎回読み込まれるルールファイルに記述し、違反した際に即座に停止する仕組みを構築する必要がある。
Q3: ルールファイルが長くなりすぎて管理できない場合はどうするべきか。
A3: ルールは「理想」ではなく「事故実績」からのみ作成する。まだ発生していない事故への対策を先回りで書くと、ルールが肥大化し、エージェントの判断を阻害する。同じ手戻りが2回発生した時だけルールを追記し、定期的に棚卸しを行うことで、本当に必要なルールだけを維持できる。
Q4: 人間の承認を挟むと自動化の意味がなくなるのではないか。
A4: 全てを自動化しようとせず、「可逆な作業」と「不可逆な作業」を分けるのがコツだ。データベースのステータス変更のようなやり直しが効く作業は無人で進め、環境設定の書き換えなど影響範囲が広い作業のみを承認ゲートへ回す。確認の回数を絞ることで、承認の質を高め、結果的に開発全体の速度を上げることができる。
Q5: AIエージェントの事故を防ぐための最初の一歩は何か。
A5: 「未コミットの状態で一括処理を走らせない」というルールを徹底する。どんなに優れたAIでも、正規表現による一括置換などでファイルを破壊するリスクはゼロではない。まずはGitのコミットを習慣化し、いつでも元の状態に戻せる「梯子」を用意することが、AI開発における最低限の安全装置だ。
AIエージェントの運用において、最も重要なのは「AIを信じないこと」だ。検証を機械化し、ルールを常駐させ、人間が介入すべき場所を明確にする。この構造を作ることで、AIは強力な武器になる。破壊を恐れず、慎重に自動化を進める。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

【2026年版】AI活用1人SaaS開発の完全ロードマップ|5ステップで始める個人開発

【2026年版】VRAM 8GBで動かすローカルLLM構築術10選|1人SaaS開発者の実践記録

【2026年版】最強AIコーディングモデル3選|Claude Fable 5・GLM-5.2・MAI-Code徹底比較

【2026年版】ローカルAI構築ツール5選|1人開発者が教えるGemma 4の完全オフライン化

1回25ドルのトークン消費。Claude Codeのマルチエージェント化が迫る、個人開発のハイブリッド運用。

【2026年版】AIブラウザ自動化ツール4選|1人SaaS開発者が用途別に徹底比較

【2026年版】Claude Codeのトークン削減術8選|設定ファイルを見直す極意

【2026年版】ローカルLLM構築の6ステップ|個人GPUで自分専用AIを開発する実践ガイド
