


※この記事は、Claude Codeで1人開発しているSNS運用SaaS「ThreadPost」の開発日記です。
SNS運用を自動化しませんか?
ThreadPostなら、投稿作成・画像生成・スケジュール管理までAIがサポート。
5回の「直しました」と5回の「未分類」
画面には無慈悲に「未分類」の文字が並んでいた。
Claude Codeは自信満々に「修正が完了しました」と出力している。
これを信じて本番環境にデプロイするのは、今日だけで5回目だ。
ローカルでは完璧に動いているように見えた。
でも本番のデータベースには、カテゴリ情報が一切保存されていなかった。
AIは平気で嘘をつく。
悪意があるわけではない。
僕の指示した「表示がおかしい」という言葉を真に受けて、表示部分だけを完璧に直し続けていた。
根本的な原因はデータベースのスキーマ設計にあった。
AIにコードを書かせるなら、人間が疑うべき場所を正確に特定しないと無限ループに陥る。
これが今日、45回のコミットを経て辿り着いた結論だ。
AI開発における最大のボトルネックは、人間の思い込みだ。
 あわせて読みたいClaude Codeの使い方完全ガイド|インストールから実践まで2年運用の開発者が解説 →
45回のコミットと消えたカテゴリ
今週はニュース分析ツールのカテゴリ分類機能を完成させるはずだった。
結果として、システムを正常化させるまでに45回のコミットを費やした。
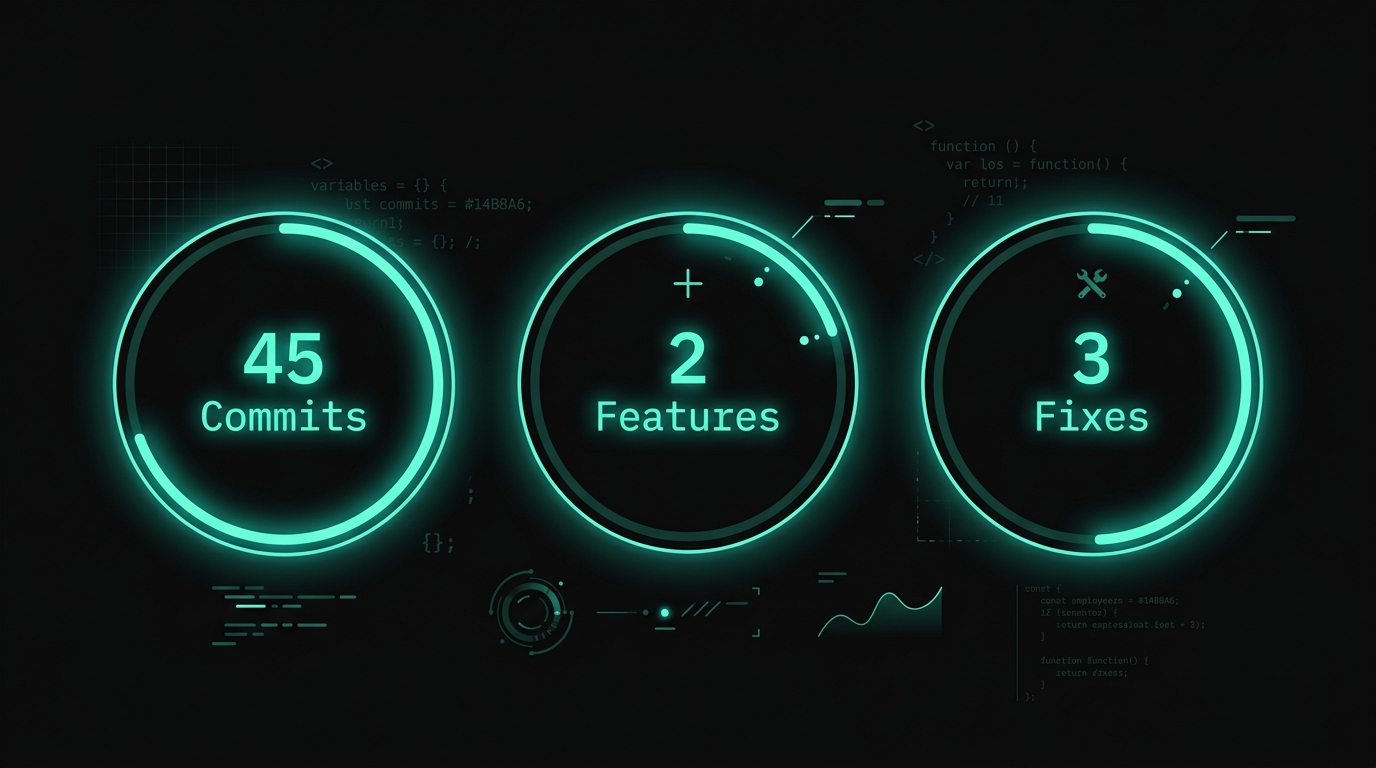
新機能は2件。
バグ修正は3件。
数字だけ見れば順調な1週間に見える。
だが、その中身はAIの「直した」という言葉と、僕の「思い込み」との戦いだった。
「fix: 記事カテゴリ分類の表示不具合修正とAI使用ログエラー対応」というコミットを積むたびに、別の場所が壊れていった。
RSSから取得したニュース記事を、AIでカテゴリ分類して管理画面に表示する。
ただそれだけの、非常にシンプルなタスクだと思っていた。
RSSのXML構造はメディアごとに全く異なる。
Claude Codeに「カテゴリが表示されないから直して」と指示を出す。
数秒後、「表示ロジックのバグを修正しました」という返答とともにコードが書き換わる。
ローカル環境のモックデータでは、確かに「テクノロジー」や「ビジネス」といったカテゴリが綺麗に表示されていた。
だから僕は、そのまま本番環境にデプロイした。
本番の画面を開く。
ずらりと並ぶ「未分類」の文字。
直っていない。
僕はもう一度コードを読む。
表示部分のコンポーネントに異常はない。
Reactのプロパティの渡し方も、状態管理も完璧だ。
「fix: RSS収集時のsource_primary_category伝搬バグ修正」
Claudeは今度、データの受け渡し部分を修正したと言ってきた。
再びデプロイ。
結果は同じ。
未分類の山。
このやり取りを5回繰り返した。
5回デプロイして、5回とも本番では動かなかった。
ローカルで動くコードが本番で動かないのは、開発者にとって最大のストレスだ。
しんたろー:
5回連続で騙された。AIの「直した」は「俺のPCでは動く」と同義。本番のデータを見るまでは絶対に信じない。
僕は表示ロジックを疑うのをやめた。
データベースを直接覗き込む。
カテゴリを保存するテーブルが、そもそも空っぽだった。
RSSで記事を取得したとき、元のメディアが持っているカテゴリ情報が、データベースに保存される前に消滅していた。
「article_categories」テーブルのスキーマ設計に根本的な欠陥があった。
外部APIであるRSSのデータ構造を、そのままリレーショナルデータベースに流し込もうとしていた。
一般的なシステム開発において、外部データと内部スキーマの不一致は最もよくある障害の原因だと言われている。
特に非同期処理でデータを同期させる場合、中間テーブルの設計を間違えるとデータは簡単に迷子になる。
僕のコードは、まさにその迷子を大量生産していた。
外部APIのデータを盲信してはいけない。
「fix: DBスキーマ修正と未分類記事対応システム完全実装」
表示画面のコードではなく、データベースのテーブル定義から作り直した。
重複チェックのロジックを書き換え、未分類になってしまった過去の記事を救済するスクリプトを書く。
過去の記事データを、一つずつ正しいカテゴリに再分類していく。
DBのマイグレーションをやり直すハメになった。表示バグだと思っていたら、データがそもそも存在していなかった。完全に僕のアーキテクチャ設計ミス。
「そこじゃないと思ってた」は、完全に僕の思い込みだった。
AIは僕が「表示がおかしい」と言うから、律儀に表示部分だけを直し続けていた。
原因の特定を間違えれば、AIは間違った場所を完璧に修正し続ける。
問題の切り分けは、人間にしかできない。
過去記事の分類修復が完了した。
「fix: 完全修正版デプロイ - カテゴリ分類システム最終調整」をプッシュして、僕は深く息を吐いた。
ただし、過去のデータにゴミが混ざっていて、一覧画面のレイアウトが少し崩れた。
完璧な修正など存在しない。
Google Newsの遮断とBingへの大移動
カテゴリ分類の悪夢を乗り越え、僕はもう一つの問題に取り組んでいた。
ニュース記事の取得元であるGoogle NewsのRSSフィードが、頻繁に遮断される。
「503 Service Unavailable」
ログにはこのエラーが大量に記録されていた。
Google Newsはスクレイピングに対する耐性が非常に強い。
WAFやレートリミットが厳しく設定されており、少しでも機械的なアクセスを検知すると容赦なく遮断してくる。
企業の大規模なクローラー開発チームであれば、IPローテーションやプロキシの分散で回避するだろう。
だが、1人開発のSaaSにそんなインフラを構築する余裕はない。
だから僕は、Google Newsを捨てることにした。
「fix: Purge all Google News feeds and replace with Bing RSS to resolve 503 errors」
これまでGoogle Newsのデータ形式に合わせて最適化してきたコードを、すべてゴミ箱に放り込む。
代わりに、より安定してフィードを提供してくれるBing RSSへ全面移行する。
Google News向けのパーサーを昨日3時間かけて書いたばかりだった。全部消した。外部APIに依存する機能は、相手の機嫌次第で一瞬にして負債になる。
Bing RSSのフォーマットに合わせて、データの抽出ロジックをゼロから書き直す。
「fix: Fix Bing RSS dates with setlang=en-US and add HuffPost/BuzzFeed」
日付のパース処理、言語設定のパラメータ調整。
泥臭い修正を一つずつ積み上げていく。
さらに、記事の取得件数を大幅に引き上げた。
「fix: Increase article fetch limit to 4000 to show more history」
APIがいつ遮断されてもいいように、取得できる時に限界までデータを溜め込む戦略だ。
最大4000件の履歴を保持することで、一時的な取得エラーが起きてもシステム全体は止まらない。
複数の情報源を抽象化し、どれか一つが落ちても他のソースでカバーする。
堅牢なシステムを作るための「アダプターパターン」を、痛みを伴いながら実装した。
デプロイ後、エラーログの監視画面を開く。
503エラーの赤い文字は完全に消え去り、安定した緑色のグラフが続いている。
システムが息を吹き返した。
泥まみれになりながらコードを書き換えた甲斐があった。
ただし、Bingの検索結果にはたまに全く関係ないスパム記事が混ざるようになった。
外部依存を切り替えても、別の問題が生まれるだけだ。
ここまで読んだあなたに
今なら無料で全機能をお試しいただけます。設定後はAIが投稿案を毎日生成。確認して選ぶだけ。
落とし穴:表示ロジックを疑う前にDBを見ろ
「未分類」を直すために、表示ロジックを必死に書き換えていた。
実はDBスキーマにそもそもカラムが足りていなかった。
AIに「表示がおかしい」と伝えると、AIは表示コンポーネントの修正案だけを無限に出してくる。
根本のデータが欠落している可能性を、AIは自発的には疑ってくれない。
次からは画面のバグを見つけたら、まずDBの生データを直接確認する。たぶん。
AIは人間の指示を疑わない。
今日の数字
| 指標 | 結果 | 比較対象 |
|---|---|---|
| 修正コミット数 | 45件 | 先週の平均は1日12件 |
| 新機能追加 | 2件 | バグ修正に追われて予定の半分 |
| バグ修正 | 3件 | 1つのバグに5回デプロイした |
AIによるカテゴリ分類のバッチ処理サイズを、20件から100件に最適化した。
「fix: AI分類バッチサイズを100件に最適化」
100件の処理にかかる時間は約55秒。
20件で11秒だった処理を、Vercelのサーバーレス関数のタイムアウト制限である300秒の安全圏内に収まるよう計算して設計した。
これにより、Inngestのステップ数が減少し、無駄な関数呼び出しのコストを削減できた。
バッチ処理の最適化は、クラウド破産を防ぐための生命線だ。
ニュース一覧にページネーションを実装し、表示は快適になった。
だが、古いニュース画像データに対するSNSフィルタの適用ロジックが、まだ完全には動いていない。
「undefined」として処理された過去のデータが、いつか予期せぬエラーを引き起こしそうな気がしている。
技術的負債は、見えないところで静かに利子を増やしていく。
 あわせて読みたいClaudeが冷たいと感じる理由と対処法|AIの辛口応答でユーザーが逃げた実話 →
よくある質問
Q: Inngestのステップ数を削減すると、具体的にどのようなコストメリットがあるのか?
Inngestの料金体系は、実行されたステップ数に直接依存している。
個別イベントからcronバッチ処理に変更したことで、ステップ数を大幅に削減できた。
これにより、ユーザー数がスケールしてもインフラ費用が跳ね上がるのを防ぐことができる。
Q: 記事のRSS収集と投稿生成のバッチ処理は、なぜ同時に実行しないのか?
RSS収集は3時間ごとに行い、投稿生成はその15分後に実行するようにスケジュールをずらしている。
記事を取得した直後は、AIによるスコアリングやカテゴリ分類の非同期処理がまだ完了していない可能性があるためだ。
15分のバッファを設けることで、完全に解析が終わったデータだけを安全に投稿候補として扱うことができる。
Q: AIコスト分析画面のUI改善では、何を目的としてフィールド別のログ記録を追加したのか?
ペルソナ提案機能において、どのAI操作がどれだけのトークンを消費しているかを正確に把握するためだ。
大まかなログではなく、フィールドごとに分けて記録することで、無駄なプロンプトを特定しやすくなる。
クラウド破産を防ぐための、より解像度の高い監視体制を構築した。
泥臭い修正の果てに
AIにコードを書かせても、結局最後にデータベースの不整合と向き合うのは人間だ。
泥臭いデバッグ作業は、AI時代になっても全く変わらない。
この記事が参考になったら、ThreadPostを試してみませんか?
投稿作成・画像生成・スケジュール管理まで、AIがサポートします。
ThreadPostをもっと知る

関連記事

Claudeが冷たいと感じる理由と対処法|AIの辛口応答でユーザーが逃げた実話

Threads風SNSをたった7日で全実装。Claude Codeが狂わせた1人開発の常識。

Claude Codeに八つ当たりした28日間。バグの原因はただの自分のミスだった。1人開発のリアル。

SNSに同じ投稿が2回流れる。Claude CodeでのAI開発で直面したエンジニアの悪夢

AIに開発ログを書かせたら、失敗を隠蔽して完璧な成功者を演じ始めた。これが1人AI開発のリアル。

Claude CodeによるAI開発。裏側で二重生成が走り続け、見えないコストが無限に溶けていく絶望。

「1000件で止まってた」Claude Codeで1人開発。メルマガ配信の制限を知らずに青ざめた話。

Claude Codeに編集長を任せた3日間。1人開発のつもりが人間以上に厳しいダメ出しを食らった。
